

Apache Fory는 왜 그렇게 빠른가? Java 직렬화 프레임워크 5종 프로파일링
JDK 설계자들이 Java 직렬화를 몹시 싫어한다는 것은 공공연한 사실입니다. Java 직렬화는 보안상의 악몽이고, 새로운 언어 기능이 추가될 때마다 상당한 복잡성을 더하며, 게다가 속도까지 매우 느립니다. 그렇기 때문에 다른 직렬화 프레임워크들이 존재합니다. 최근에는 인상적인 성능을 내놓는 새로운 프레임워크가 등장했습니다. 바로 Apache Fory입니다. 이 블로그 포스트에서는 Fory가 이전 이름(예전에는 "Fury"였습니다)에 어울리는 성능을 내는지 살펴보고 기존 프레임워크들과 비교해 보겠습니다.
비교를 위해 다섯 가지 프레임워크로 현실적인 객체 그래프의 직렬화 및 역직렬화 왕복을 프로파일링했습니다:
- Java 직렬화
- Kryo
- Apache Fory
- Jackson - JSON과 CBOR 백엔드 모두 포함
이 프로파일링 데이터는 Apache Fory가 선두에 있는 이유, 그리고 Java 직렬화가 하는 일의 대부분은 사실 직렬화가 아니라는 점을 설명해 줍니다.
설정 및 수치
테스트 데이터셋은 고객, 주소, 주문 항목, 제품, 카테고리가 포함된 200개의 주문으로 구성되어 있습니다. 직렬화되는 클래스에는 직렬화와 관련된 다양한 기능이 고루 들어 있습니다: 공유 참조, 컬렉션, 맵, 열거형, BigDecimal, Date, 긴 문자열, 바이트 배열 등입니다. 각 테스트는 워밍업 단계 이후 200만 번의 직렬화 및 역직렬화 왕복을 수행하며, equals 비교로 모든 프레임워크가 데이터를 정확하게 왕복시키는지 검증합니다. 전체 프로젝트는 GitHub에서 공개되어 있습니다.
테스트는 JDK 25에서 200만 회의 왕복으로 실행되었습니다. JVM은 오프라인 모드의 JProfiler Gradle 플러그인으로 프로파일링했으며, CPU 샘플링 또는 할당 기록을 사용해 프레임워크마다 하나의 스냅샷을 생성했습니다. Java 직렬화의 경우 java.* 클래스를 명시적으로 프로파일링했습니다. 기본적으로 이 클래스들은 JProfiler에 의해 필터링되어 제외되기 때문입니다.
| 프레임워크 | 왕복당 시간 | 페이로드 크기 | 총 할당량 |
|---|---|---|---|
| Fory 1.6 | 3.5 µs | 7,502 바이트 | 4.5 GB |
| Kryo 5.6 | 8.9 µs | 7,257 바이트 | 4.2 GB |
| Jackson CBOR | 12.0 µs | 7,819 바이트 | 6.5 GB |
| Jackson JSON | 28.7 µs | 9,814 바이트 | 8.8 GB |
| java.io | 46.8 µs | 9,152 바이트 | 18.4 GB |
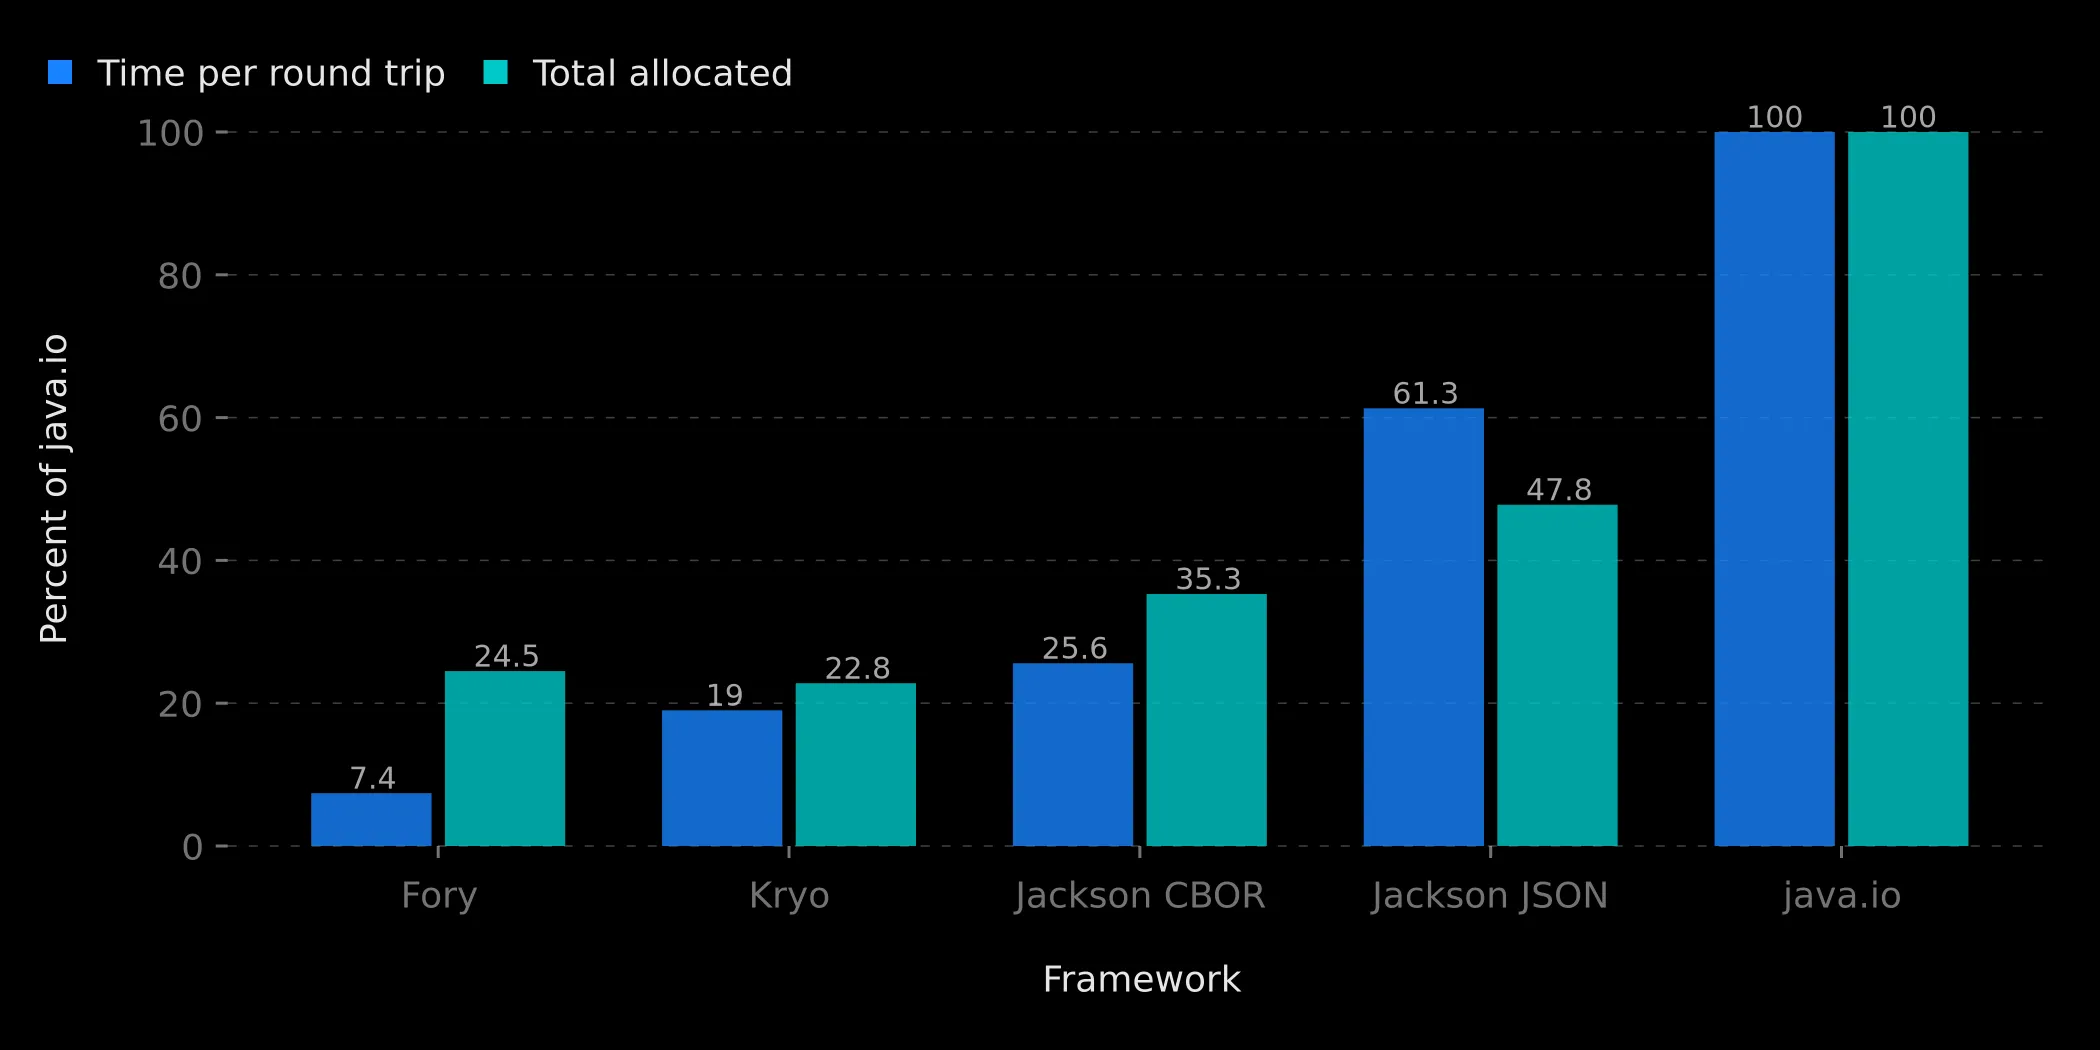
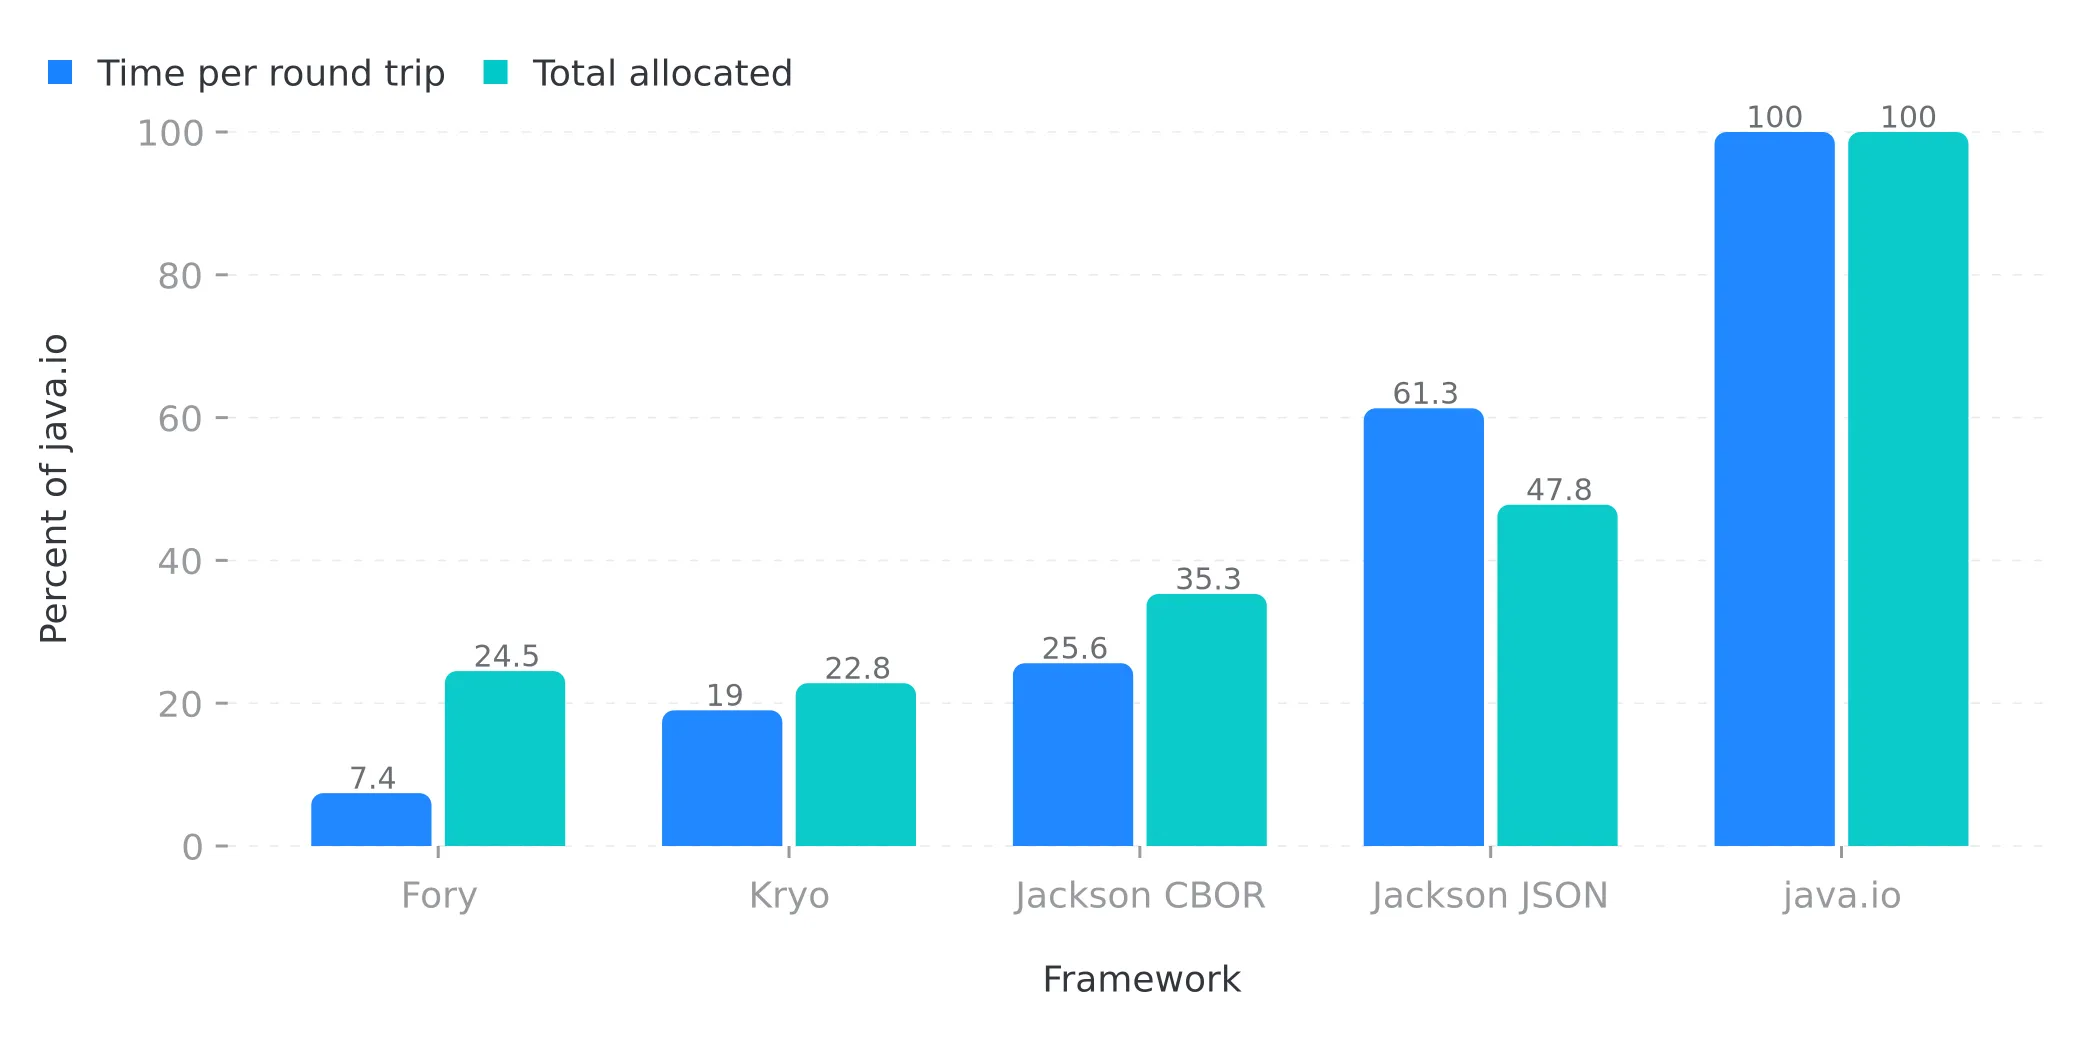
Java 직렬화는 Fory보다 13배 느리고 메모리는 4배 더 할당합니다. 이는 공개된 벤치마크 결과와도 일치합니다. 차트는 두 컬럼 사이에 상관관계가 있음도 보여줍니다. Kryo의 왕복 시간은 할당량에 거의 비례합니다. Jackson JSON은 많은 텍스트를 파싱하느라 더 많은 CPU를 소모하기 때문에 할당 비율에서 기대되는 것보다 느립니다. Fory는 이 상관관계로 예측되는 수준을 크게 벗어납니다. 시간은 7%에 불과하지만 할당량은 25%입니다. 이 부분은 아래에서 다시 다루겠습니다. 먼저 시간이 실제로 어디에 쓰이는지 살펴보겠습니다.
Java 직렬화가 느린 이유
흥미롭게도 Java 직렬화는 읽기와 쓰기 사이에서 매우 비대칭적입니다. CPU 시간의 73%가 deserialize에 소요되고 serialize에는 26%만 소요됩니다.
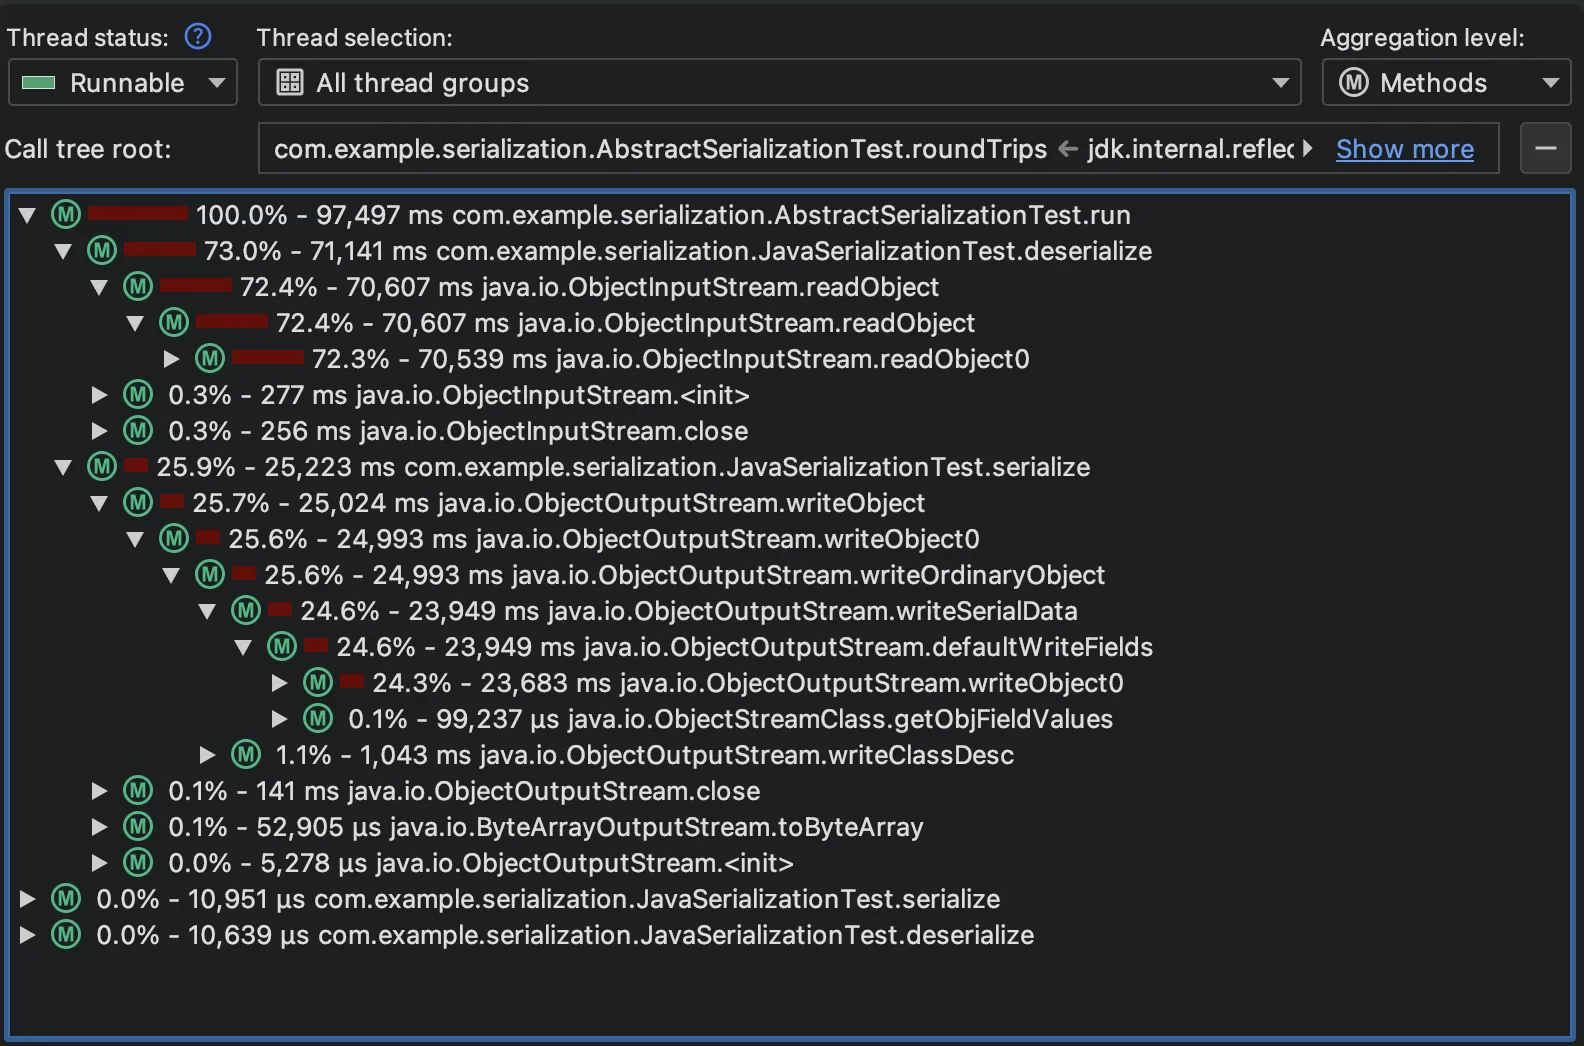
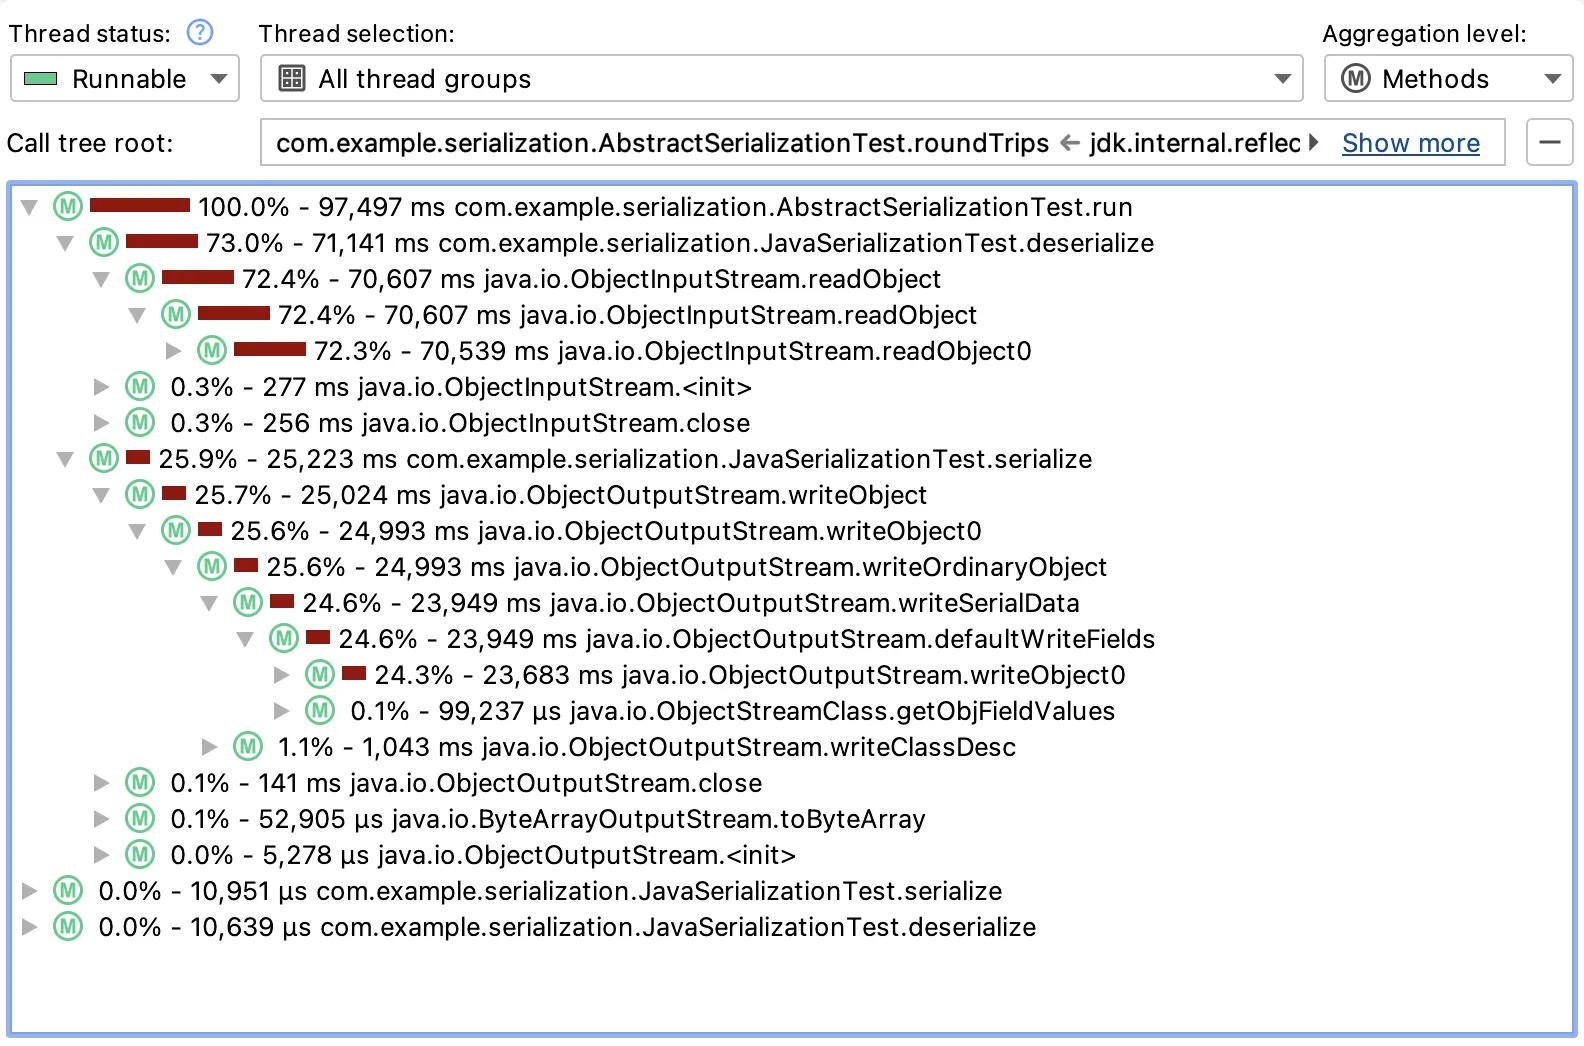
실행의 주요 핫스팟을 보면 시간이 무엇에 소요되었는지 알 수 있습니다:
jdk.internal.misc.VM.latestUserDefinedLoader0(18%): 스트림의 모든 클래스 디스크립터마다 JDK가 네이티브 코드에서 호출 스택을 순회하며 해당 클래스를 resolve할 클래스 로더를 찾습니다.Class.forName0(8%)와String.intern(6%): 클래스들을 resolve하고 스트림의 타입 디스크립터에서 필드 이름을 intern하는 작업입니다. 클래스 로더 탐지까지 합치면 전체 실행의 거의 3분의 1이 "이것이 어떤 클래스이고 어떤 필드를 갖는가"라는 질문에 답하는 데 소요됩니다.ObjectInputStream$PeekInputStream.readFully(13%): 바이트를 이리저리 옮기는 작업입니다.ObjectOutputStream$HandleTable.lookup(5%): 공유 참조를 추적합니다.BlockDataInputStream.readUTFSpan과readUTFBody(합계 8%): 스트림 형식의 수많은 작은 UTF 문자열을 파싱합니다.
할당 데이터는 메모리 측면에서도 같은 그림을 보여줍니다. 200만 번의 왕복 동안 Java 직렬화 실행에서 할당된 항목은 다음과 같습니다:
ObjectStreamClass인스턴스 800만 개 (844 MB). 클래스 디스크립터는 JDK가 소프트 참조로 캐시하는데, 할당 압박 속에서 가비지 컬렉터가 캐시 엔트리 상당수를 제거한 것으로 보입니다.- 메타데이터와 필드 값을 저장하기 위한
ObjectStreamField인스턴스 1,000만 개와FieldValues인스턴스 1,060만 개. - 대부분 디스크립터 파싱에서 비롯된
StringBuilder인스턴스 2,600만 개.
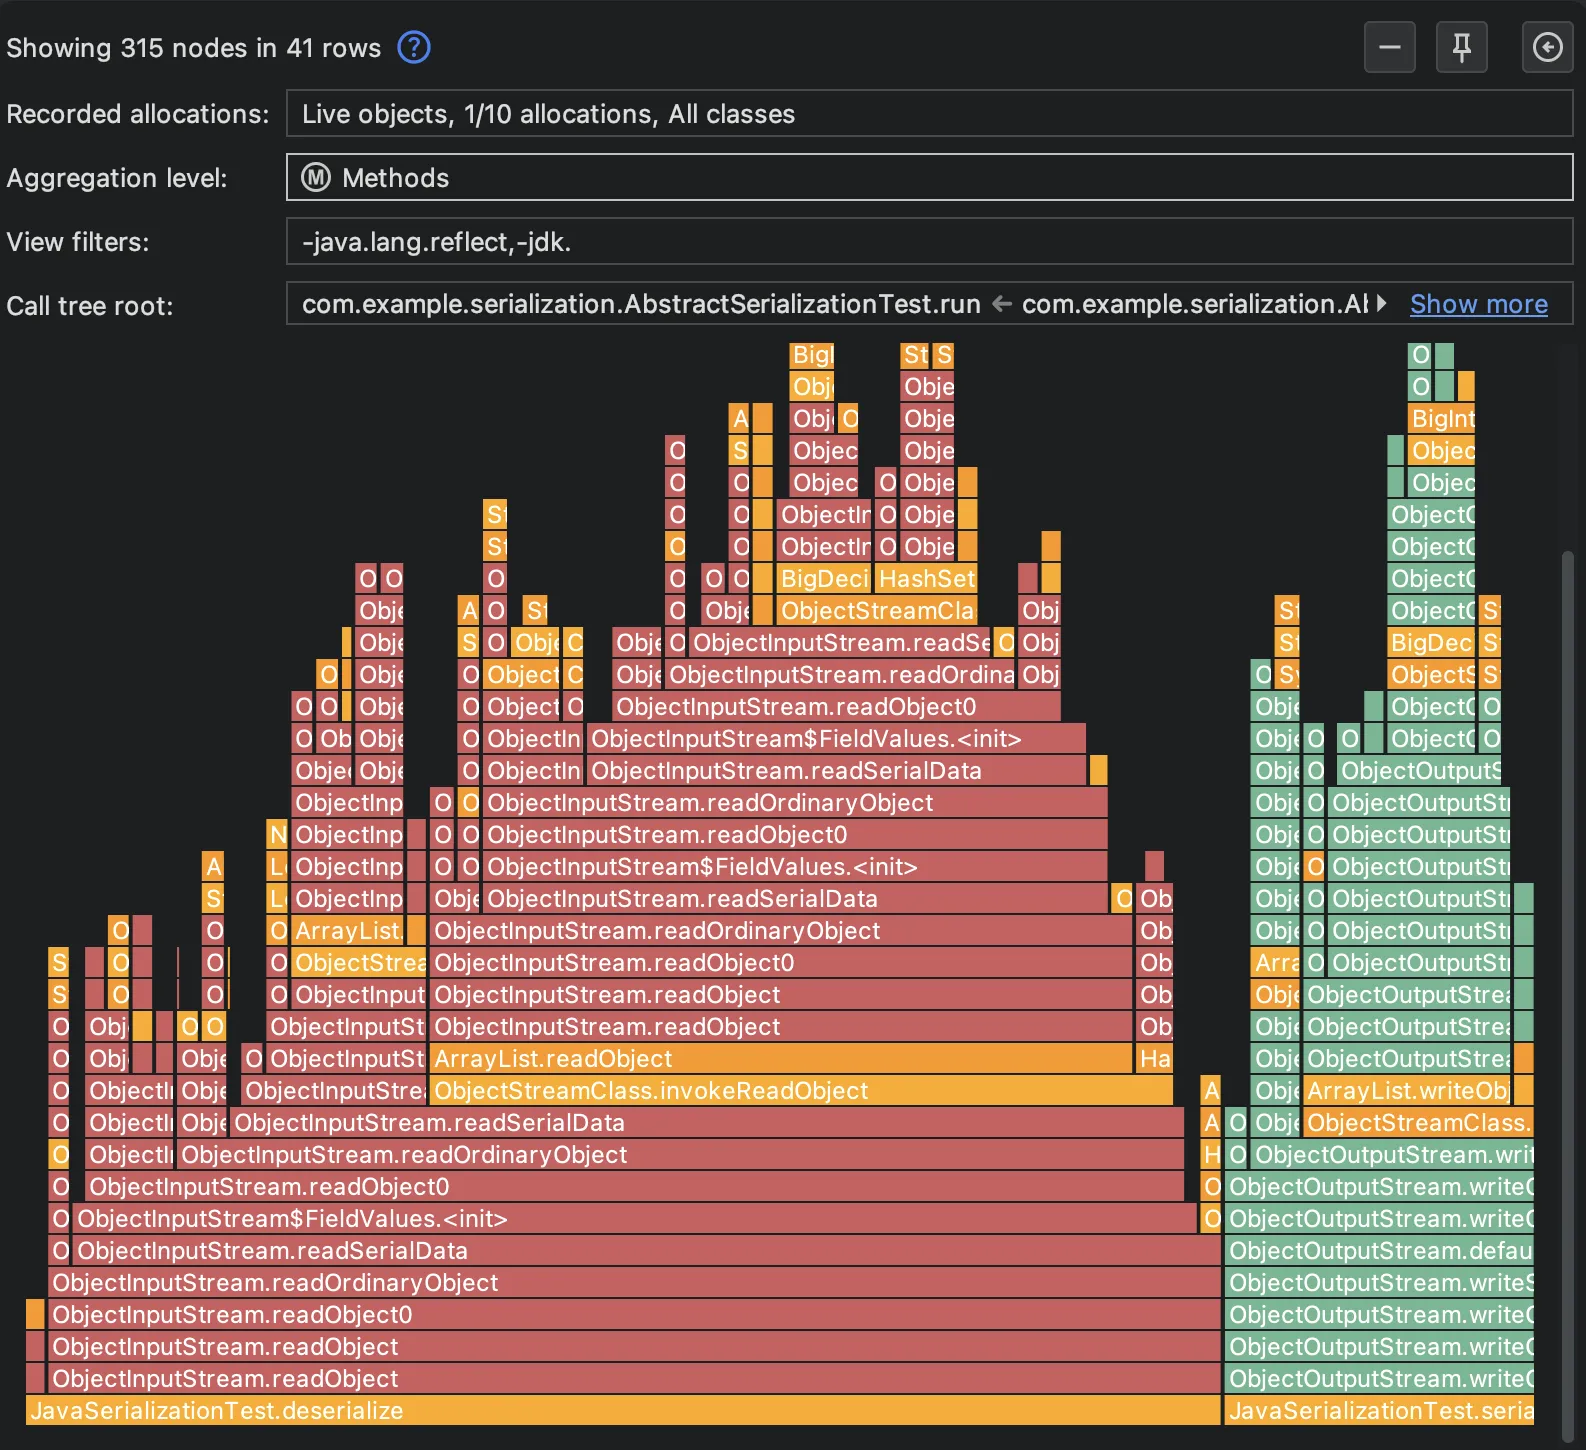
이 작업의 대부분은 직렬화되는 데이터와는 무관합니다. 대부분은 형식 자체를 위한 내부 관리 작업, 즉 타입 디스크립터, 필드 메타데이터, 객체 참조를 추적하는 identity 테이블에 관한 것입니다. 왕복마다 새로운 ObjectInputStream을 만드는 것이 이 API의 표준적인 사용 방식이며, 그럴 때마다 클래스 디스크립터를 다시 resolve합니다.
Fory와 Kryo가 빠른 이유
Fory와 Kryo는 이러한 내부 관리 작업을 완전히 생략합니다. 파싱할 타입 디스크립터도 없고, 읽는 시점에 resolve할 클래스도 없으며, 리플렉션도 없습니다(적어도 핫 패스에서는). 프로파일링 데이터에 남는 것은 대부분 실제로 결과를 만들어 내는 작업입니다.
Fory 스냅샷에서는 전체 시간의 3분의 1 이상이 Fory가 런타임에 생성한 직렬화기 클래스에서 직접 소요되며, ProductForyRefCodecCompatible4_0.readFields$ 같은 메서드로 나타납니다. 또 다른 14%는 역직렬화된 주문의 속성 맵을 다시 구축하는 HashMap.putVal에, 6%는 VarHandle을 통한 필드 설정에 소요됩니다. 프로파일링 데이터를 보면 Fory가 하는 일은 본질적으로 대부분 바이트를 객체에 채워 넣는 작업임을 알 수 있습니다.
Kryo의 프로파일링 데이터는 모양이 다릅니다. readObject와 writeObjectOrNull 메서드에 27%, 문자열을 읽고 쓰는 데 23%, 참조를 추적하는 identity 맵에 12%, FieldSerializer에 7%, 클래스 이름 쓰기에 5%가 소요됩니다. Kryo가 빠른 이유는 Java 직렬화처럼 디스크립터를 관리하지 않기 때문이지만, 여전히 객체별·필드별 디스패치 계층은 자체적으로 갖고 있습니다.
Fory가 특히 빠른 이유
정말 흥미로운 것은 Kryo가 모든 프레임워크 중 할당량이 가장 적은데도 Fory보다 2.5배 느리다는 점입니다. 물론 할당량은 바이트 수만 셀 뿐, 바이트당 소요되는 명령어 수까지는 세지 않습니다.
Kryo는 사실상 인터프리터 루프와 다름없는 방식으로 직렬화합니다. 객체마다 직렬화기를 조회하고, 필드마다 FieldSerializer를 통해 디스패치하며, 클래스 이름마다 문자열을 스트림에 기록합니다. 이 디스패치 메서드들 중 어느 하나만으로는 병목이 아니지만, 모두 합치면 데이터와 바이트 사이에서 전체 실행의 40% 이상을 차지합니다.
Fory가 생성한 코드에는 이런 계층이 없습니다. Fory가 런타임에 컴파일하는 클래스는 그저 읽기와 쓰기가 정해진 순서로 나열된 것일 뿐입니다. 버퍼 접근은 바이트 단위 읽기가 아닌 벌크 메모리 연산으로 이루어지고, 필드 접근은 VarHandle로 이루어집니다. 핫스팟 뷰가 이를 분명하게 보여줍니다. 최상위 항목은 속성 맵 재구축에서 비롯된 HashMap.putVal이고, 그 아래 순위들은 생성된 ForyRefCodec 클래스들이 대부분입니다.
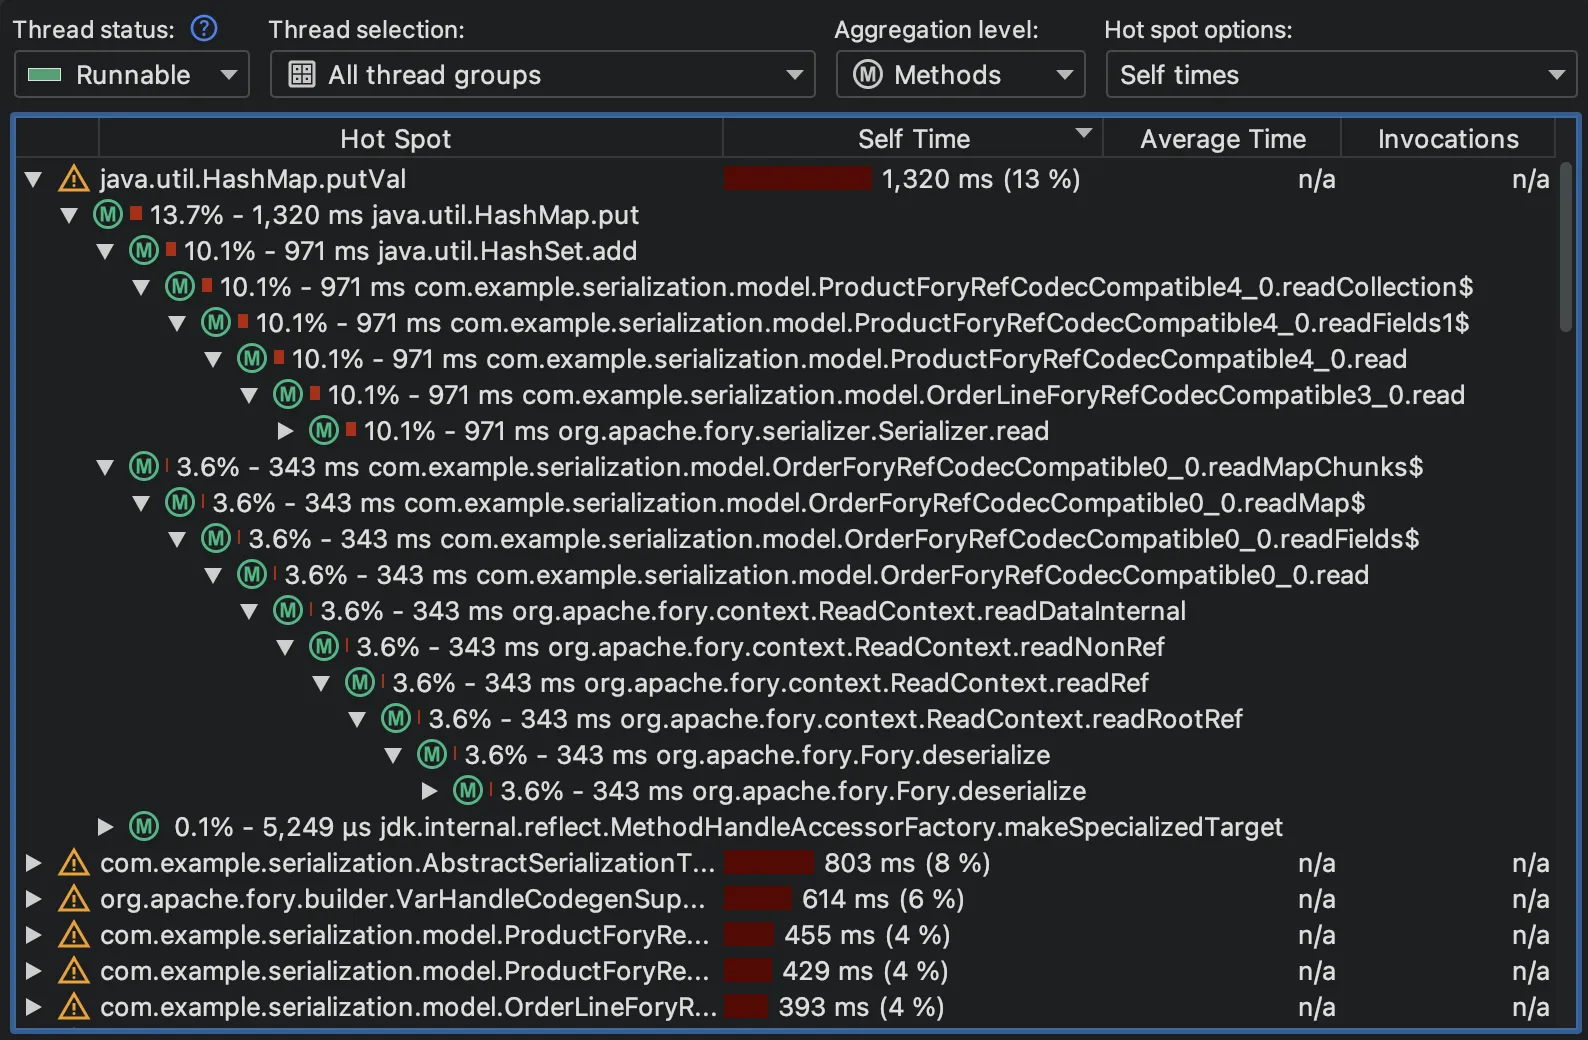
결국 여기서 핵심 교훈은 Fory를 남들과 격이 다른 수준으로 만드는 것은 코드 생성이라는 점입니다.
Jackson의 다른 트레이드오프
Jackson은 가장 널리 쓰이는 직렬화 프레임워크지만, 그 강점은 속도만이 아닙니다. Jackson은 클래스를 JSON으로 변환하는 표준적인 선택지이며 그 용도를 위한 기능도 매우 많이 갖추고 있습니다.
JSON 같은 텍스트 형식은 비용이 큰 기능입니다. byte[] 썸네일을 base64로 인코딩하는 데 전체 시간의 24%가 들고 디코딩에도 23%가 들어서, 실행 시간의 거의 절반이 JSON에 바이너리 타입이 없다는 사실 하나에 소요됩니다. 여기에 리플렉션 기반 메서드 호출이 13%를 더합니다.
다만 Jackson에는 바이너리 백엔드도 있고, 예를 들어 CBORMapper를 쓰면 전환은 아주 간단합니다. 예제 워크로드에서 CBOR은 JSON보다 2.4배 빠르고 Fory에 버금할 만큼 컴팩트한 페이로드를 만들어 냅니다. 프로파일링 데이터는 이제 형식이 더 이상 문제가 아님을 확인해 줍니다. CBOR 파서와 제너레이터를 합치면 시간의 약 4분의 1을 차지하는 반면, 리플렉션 기반 데이터 바인딩 계층이 이제 약 40%를 차지합니다. 데이터 바인딩 계층을 여전히 거쳐야 하기 때문에 Fory보다 약 3.4배 느립니다.
프레임워크 선택
- 순수한 속도만 따지면 Fory가 이 비교에서 압도적으로 승리합니다. Fory는 여러 다른 언어용 구현체와 스키마 변경을 허용하는 타입 호환 모드도 갖추고 있어서, 여러 언어가 섞인 시스템과 오래 보관하는 데이터에 잘 맞습니다.
- Kryo는 캐시 엔트리나 신뢰할 수 있는 서비스 간 RPC 같은 페이로드에는 여전히 실용적인 선택입니다. 성숙했고 의존성 부담도 최소 수준이지만, 예제 워크로드에서는 Fory보다 2.5배 느립니다.
- 사람이나 다른 도구가 읽어야 하는 모든 용도에는 JSON과 함께 쓰는 Jackson이 실용적인 기본값입니다. 통신 파이프라인의 양쪽 끝을 모두 제어할 수 있다면 한 줄만 바꿔 CBOR 백엔드로 전환할 수 있습니다.
- Java 직렬화는 기존 시스템과의 호환성이 필요할 때만 사용하는 것입니다.
프로파일링 방법
이 포스트의 모든 내용은 명령줄에서 생성되었습니다. 스냅샷은 오프라인 모드의 JProfiler Gradle 플러그인이 기록했으며, 프레임워크마다 하나의 태스크를 사용했습니다:
tasks.create<com.jprofiler.gradle.TestProfile>("profileFory") {
    useJUnitPlatform()
    filter { includeTestsMatching("com.example.serialization.ForySerializationTest") }
    offline = true
    callTreeMode = CallTreeMode.SAMPLING
    profile = listOf("com.", "org.", "java.", "javax.", "jdk.", "sun.")
    recording = listOf("cpu") // or listOf("allocation")
    snapshotFile = file("build/snapshots-cpu/fory.jps")
}
한 가지 중요한 참고 사항: CPU 데이터와 할당 데이터를 동시에 측정하는 것은 바람직하지 않습니다. 할당 기록은 10개 객체마다 한 번씩 샘플링하므로 절대적인 할당 값은 그 비율만큼 작게 나오지만, 프레임워크 간 비율은 영향을 받지 않습니다. 다만 이 샘플링 비율로도 할당 기록은 여전히 비용이 크고 측정된 CPU 시간을 왜곡합니다.
분석 그 자체는 JProfiler MCP 서버를 구동한 코딩 에이전트가 수행했습니다.
직접 확인해 보기
전체 프로젝트는 GitHub에 공개되어 있습니다. 스냅샷을 직접 살펴보려면 JProfiler를 다운로드한 뒤 build/snapshots-cpu와 build/snapshots-allocation에 있는 .jps 파일을 열면 됩니다.