

JProfiler MCP 서버를 더 약한 모델에서도 견고하게 만들기
플래그십 모델이 모든 코딩 작업에 이상적인 것은 아닙니다. 이 모델들은 느리고 비용도 많이 듭니다. 따라서 많은 작업, 특히 단순 반복 작업은 더 민첩하게 동작하며 훨씬 적은 비용으로 작업을 처리하는 하위 등급 모델이 더 적합합니다. 다만 이러한 모델들의 도구 호출 동작은 최상위 모델이 보여주는 수준보다 불안정할 수 있습니다.
JProfiler 16.1에서는 AI 코딩 에이전트가 Java 애플리케이션을 프로파일링하고 그 결과를 분석할 수 있도록 MCP 서버를 추가했습니다. 이 기능은 고객들로부터 많은 호평을 받았기 때문에, 앞으로의 릴리스에서 이 분야를 더욱 확장해 나갈 계획입니다.
초기 릴리스에서는 대부분의 테스트를 주로 Claude Code로 진행했습니다. JProfiler 16.2에서는 다른 AI 모델에서도 훨씬 견고하게 동작하도록 MCP 서버를 개선했습니다. 다른 모델들이 어떤 부분에서 실수를 했는지, 그리고 이러한 단점에 대비해 프로파일링 워크플로를 어떻게 견고하게 만들었는지 계속 읽어 보시기 바랍니다.
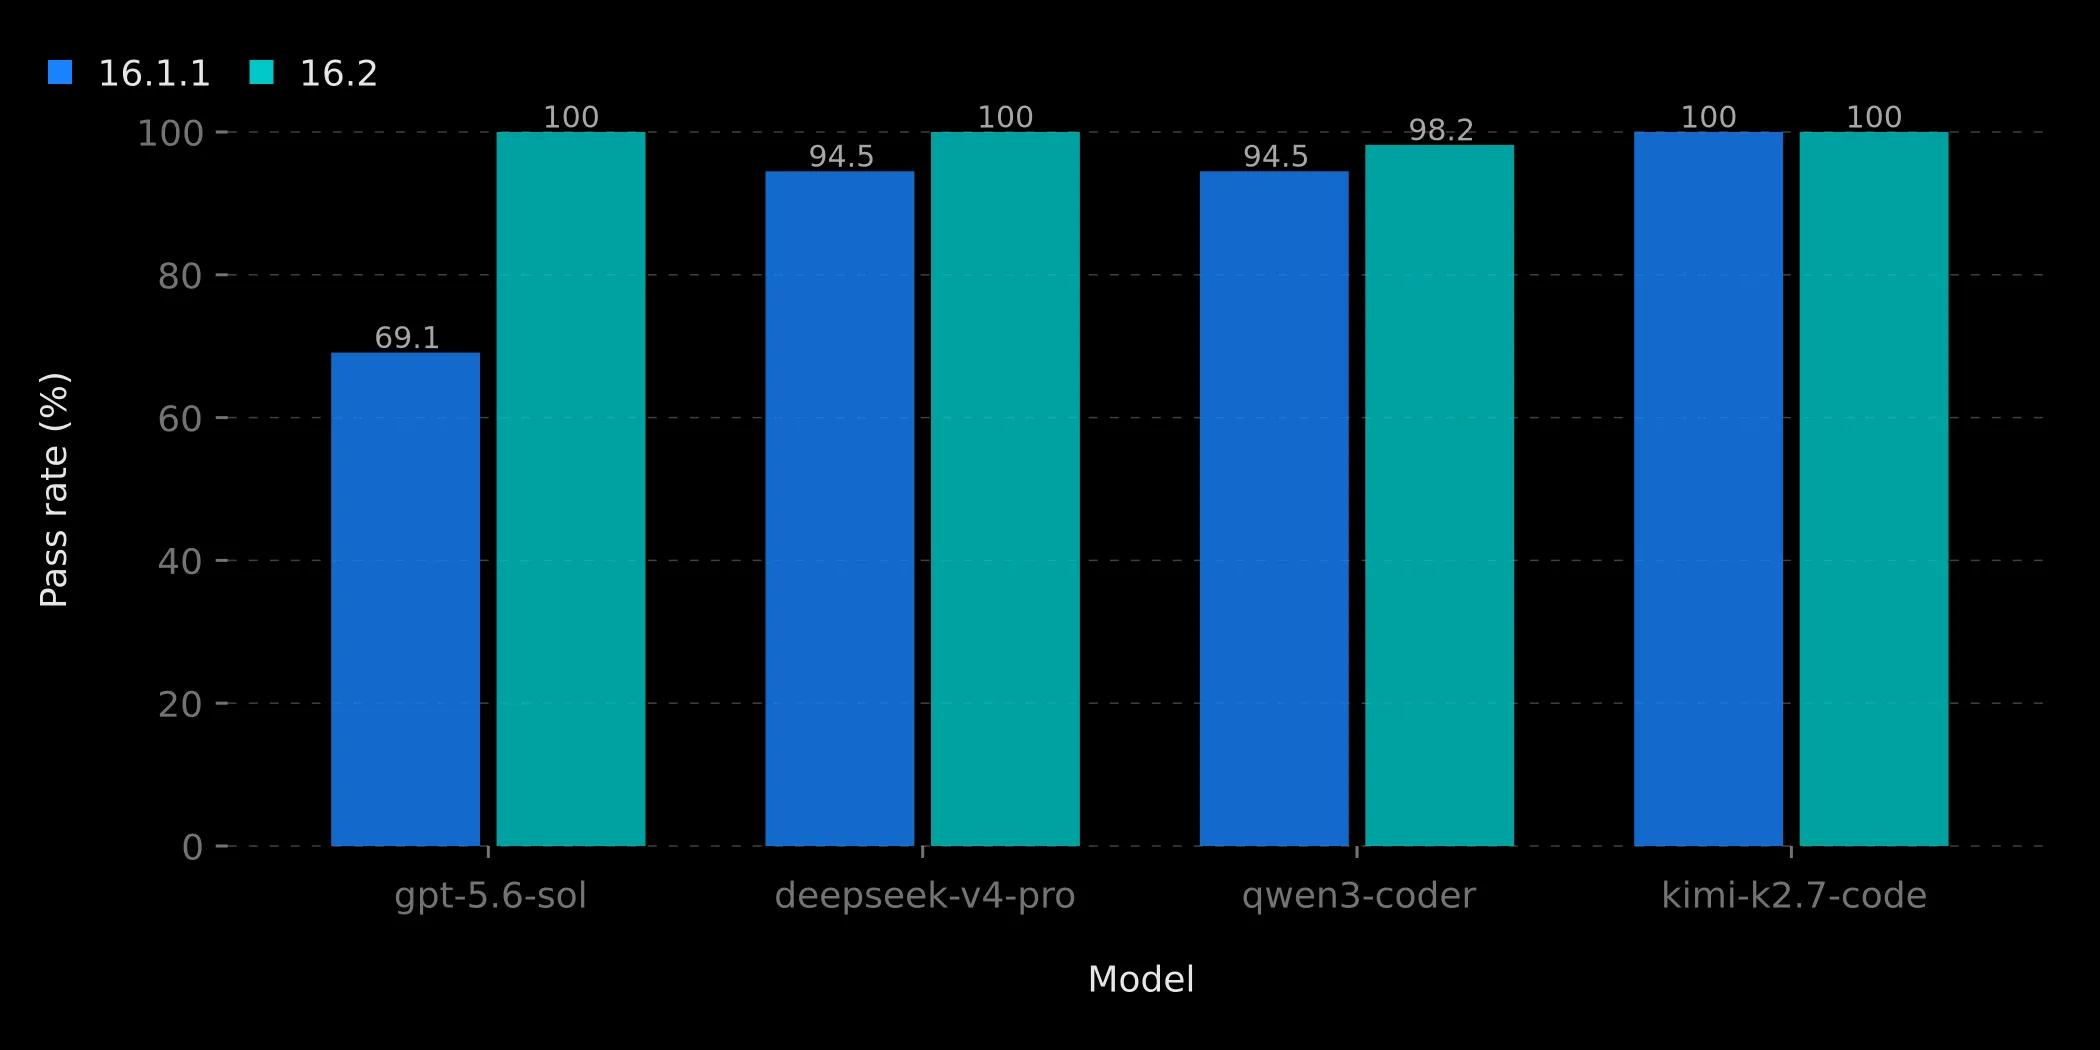
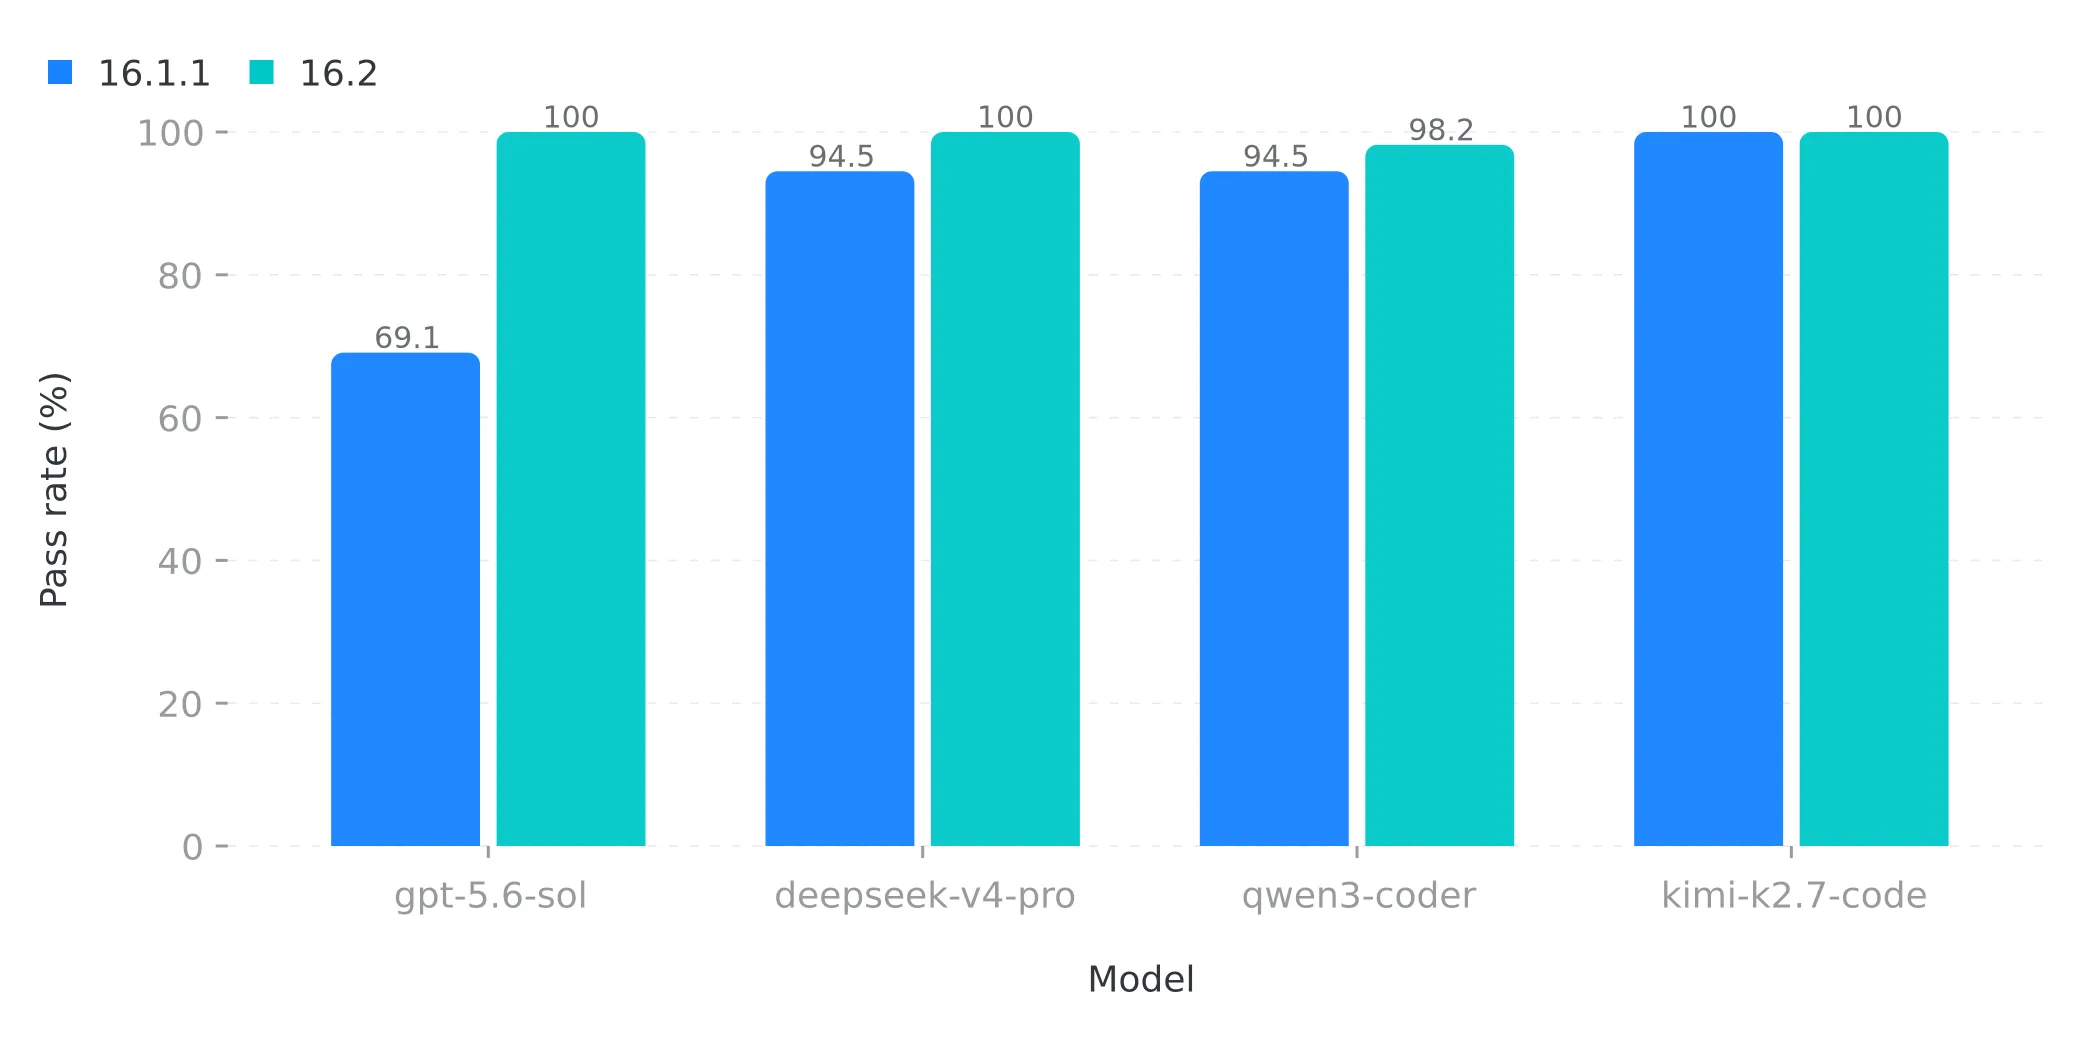
결론부터 확인하고 싶은 독자를 위해 결과를 차트 하나로 정리하면 다음과 같습니다. 네 가지 모델이 열한 가지 프로파일링 시나리오를 16.1.1 서버와 16.2 서버 양쪽 모두에 대해 수행한 결과입니다.
도구 설명은 어디까지나 제안일 뿐이다
MCP 서버는 호출자가 언어 모델인 API입니다. 일반적인 API에서 호출자는 계약을 준수하거나 오류를 받습니다. 반면 언어 모델은 도구 설명을 제안 정도로 읽고, 상황이 불분명하거나 자신의 목표에 잘 맞는 도구가 없으면 즉흥적으로 행동합니다. 모델이 강력할수록 이런 일은 줄어듭니다. 16.1 서버를 다른 모델로 테스트했을 때 프로파일링 워크플로가 여러 가지 방식으로 실패하는 것을 확인했습니다:
- 프로파일링용으로 준비된 JVM 매개변수를 JVM 실행에 추가하는 대신, 모델이 자체 구성 파일을 만들거나 기존 파일을 수정했고 기록은 끝내 시작되지 않았습니다.
- 테스트 실행 후, 모델이 MCP 서버에 세션 상태를 문의하는 대신 저장된 JProfiler 스냅샷 파일을 직접 불러왔으며, 이는 서버의 세션 관리를 우회하는 행동이었습니다.
- JVM 매개변수에 MCP 서버의 내부 구성 파일이 읽을 수 있는 경로로 나타났기 때문에, 모델들이 이 파일을 들여다보았고 일부는 수정을 시도하기도 했습니다.
이는 JProfiler만의 문제가 아닙니다. τ-bench 벤치마크는 시뮬레이션된 고객 서비스 도메인에서 도구를 사용하는 에이전트를 평가하며, 최고 수준의 모델조차 과제의 절반 미만에서만 성공하고 동일한 과제를 반복 수행할 때도 일관되지 않은 결과를 낸다는 사실을 밝혔습니다.
도구에 내장된 가드레일
16.2에서는 워크플로가 여러 방면으로 강화되었습니다. 예를 들면 다음과 같습니다:
- 도구 설명이 이제는 지시문처럼 작성되었습니다.
prepare_profiling도구는 에이전트에게 JVM 매개변수를 "그대로 추가하고 어떤 파일도 생성하거나 수정하지 말 것"을 지시하며, 실행이 끝나면check_status를 호출하고 "저장된 스냅샷 파일을 직접 불러오지 말 것"을 요구합니다. - 도구가 워크플로를 강제합니다.
load_snapshot도구는 MCP 서버의 내부 기록 파일 열기를 거부하고, 오류 메시지에서 올바른 다음 단계를 안내합니다. - JVM 매개변수에 포함된 내부 구성 파일의 경로는 난독화되어 있어, 모델이 시도하더라도 파일을 읽거나 덮어쓸 수 없습니다.
기본 원칙은 오류 메시지도 프롬프트의 일부라는 것입니다. 모델이 잘못된 동작을 하면, MCP 서버가 돌려주는 응답이 대신 무엇을 해야 하는지 알려줍니다. 다시 말해, 길을 벗어난 모델은 다음 도구 응답을 통해 다시 올바른 방향으로 이끌립니다. Anthropic의 에이전트를 위한 효과적인 도구 작성 글이 이 이야기를 자세히 다루고 있습니다. 도구 설명은 곧 프롬프트 엔지니어링이며, 도구는 그것을 사용할 에이전트와 함께 평가해야 한다는 것입니다.
에이전트가 워크플로를 따르는지 테스트하기
언어 모델이 워크플로를 따르는지 어떻게 회귀 테스트할 수 있을까요? 우리는 코딩 에이전트에게 자연어로 된 프로파일링 작업을 부여하는 엔드투엔드 테스트를 만들었습니다. 예를 들어 "이 프로그램을 시작 시점부터 기록하고 시간이 어디에 쓰이는지 알려줘"와 같은 작업입니다. 그런 다음 테스트는 두 가지를 검증합니다: 에이전트가 예상된 MCP 도구를 호출했는지, 그리고 답변이 실제 프로파일링 데이터에 기반하는지입니다.
시나리오는 주요 프로파일링 작업을 다룹니다:
- 스냅샷에서 CPU 핫스팟 찾기와 핫스팟을 파고들어 호출자 찾기
- JDBC 데이터가 있는 스냅샷에서 가장 느린 SQL 문 찾기
- 두 스냅샷을 비교하여 성능 저하의 원인 찾기
prepare_profiling으로 프로그램을 시작 시점부터 기록하기- PID 또는 JVM 목록을 통해 실행 중인 JVM에 연결하기
- 힙 덤프와 HPROF 파일에서 메모리 누수 찾기
동일한 시나리오를 여러 모델에 대해 실행합니다. OpenCode와 OpenRouter를 통해 DeepSeek, Gemini, GLM, GPT, Grok, Kimi, Mistral, Qwen 등의 모델을 테스트하며, Claude Code, Codex, Cursor, Antigravity의 네이티브 CLI는 각각 자체 테스트 클래스를 가집니다.
광범위한 모델과 함께 사용할 수 있을 만큼 충분한 품질 수준을 유지하려면 이처럼 엄격한 테스트 하네스가 반드시 필요하다는 것을 확인했습니다. 도구 호출 분야에서 가장 널리 사용되는 벤치마크인 Berkeley Function Calling Leaderboard도 최신 버전에서 같은 전환을 단행했습니다. 단일 도구 호출에서 완전한 작업에 대한 에이전틱 평가로 말입니다.
효과 측정
이 블로그 포스트를 위해 개선 효과를 정량화하고자, 테스트한 모델 중 네 가지를 에이전트 하네스로 OpenCode CLI를 사용하여 열한 가지 시나리오 전부에 대해 각각 다섯 번씩 실행했습니다. 한 번은 16.1.1 서버에 대해, 또 한 번은 16.2 서버에 대해 실행한 것입니다. 각 시나리오는 어서션에 따라 점수가 매겨집니다. 예상된 순서로 호출된 예상 MCP 도구, 그리고 프로파일링 데이터에 근거한 답변이 그것입니다.
| 모델 | 16.1.1 | 16.2 |
|---|---|---|
gpt-5.6-sol |
38/55 | 55/55 |
deepseek-v4-pro |
52/55 | 55/55 |
qwen3-coder |
52/55 | 54/55 |
kimi-k2.7-code |
55/55 | 55/55 |
가장 눈에 띄는 사례는 GPT입니다. gpt-5.6-sol은 오늘날 사용할 수 있는 가장 강력한 모델 중 하나이지만, 16.1.1 서버에서 가장 고전한 모델이었습니다. 문제는 분명히 모델의 지능이 아니라, 16.1 워크플로가 Claude가 도구 설명을 읽는 방식에 맞춰 보정되어 있었다는 점이었습니다. 지시에 해석의 여지가 남아 있으면 다른 모델들은 저마다 다른 방식으로 즉흥적으로 행동하므로, 그 워크플로는 이들에게는 최적이 아니었습니다.
16.1.1에서 GPT는 매번 반복마다 동일한 세 가지 시나리오에서 실패했습니다. 트랜스크립트를 보면, 워크플로를 진행하는 대신 load_snapshot을 열 번 연속으로 호출하거나, 기존 스냅샷을 분석해야 할 때 새 기록을 시작하는 모습이 나타납니다. 16.2에서는 모든 테스트를 통과합니다. DeepSeek와 Qwen은 16.1.1에서도 대부분의 경우 이미 신뢰할 수 있었고, Kimi는 처음부터 끝까지 안정적이었습니다. 16.2에서 남은 유일한 실패는 한 시나리오에서 세 번 연속 실패한 단 한 번의 Qwen 실행입니다.
도구 호출 실패는 큰 비용을 수반합니다. 16.1.1 실행에서 실패한 GPT 시나리오는 포기하기까지 평균 42번의 도구 호출과 4분이 걸렸으며, 이는 통과한 실행 비용의 약 8배에 해당합니다. GPT 전체 매트릭스를 통틀어 보면, 16.1.1 서버는 69%의 통과율에 $13.21이 들었고 16.2 서버는 100%의 통과율에 $3.13이 들었습니다.
시작하기
커밋이 성능에 미치는 영향을 확인하기 위해 야간에 돌리는 정기 프로파일링 작업에 JProfiler MCP 서버를 활용해 보시기 바랍니다. 서버는 다운로드 페이지에서 구할 수 있으며, MCP 설정 페이지를 이용하면 1분 안에 에이전트를 연결할 수 있습니다.