

Apache Fory JSON을 4.5배 더 빠르게 만든 방법
최근 필자는 Java 직렬화 프레임워크들을 비교해 왔습니다. 바이너리 페이로드에 관한 한, 웹 사이트에서 "blazingly-fast"(번개처럼 빠르다)를 내세우는 Apache Fory의 확고한 팬이 되었는데, 실제로도 정말 그렇습니다. 이번 비교에서는 JSON 페이로드와 바이너리 페이로드를 구분해서 다루었습니다. Jackson은 (Kotlin에서도) JSON 직렬화의 왕이었고, 바이너리 페이로드에서는 Apache Fory가 압도적이었습니다.
최근 Apache Fory 1.7.0 릴리스에서는 주요 신규 기능으로 JSON 지원이 추가되었습니다. 그래서 자연스럽게도 궁금해진 필자는 직렬화 데모에 Fory JSON을 추가했습니다. 이 페이로드에 대한 수치를 보고는 도저히 믿을 수 없었습니다. Fory가 실제로 Jackson보다 2.8배나 느렸습니다. 뭔가 잘못된 것이 분명했고, 그 근본 원인을 끝까지 파고들기로 했습니다.
원인 분석
페이로드 크기만으로도 원인을 짐작할 수 있었습니다. Fory는 20,999바이트의 페이로드를 기록한 반면 Jackson은 9,814바이트였습니다. 이 페이로드에는 바이트 배열 형태의 썸네일이 포함되어 있는데, Fory는 이를 다음과 같이 직렬화하기로 결정했습니다:
"thumbnail":[-77,-1,99,-104,...]
이 방식은 극도로 비효율적입니다. 바이트 하나가 최대 5문자로 늘어나며, 무작위 데이터에서는 평균 3.5문자가 넘습니다. 쓰기 시에는 부호 검사와 10진수 변환이 필요하고, 읽기 시에는 자릿수를 훑어 수를 다시 조립해야 합니다. 이 방식은 RFC 7493, protobuf JSON 매핑, Jackson, Gson, Moshi, kotlinx.serialization 등 다른 직렬화 프레임워크와도 어긋납니다. JSON에는 바이너리 타입이 없으며, base64 문자열이 이를 처리하는 표준 방식입니다. 즉, 3바이트마다 4문자가 기록됩니다.
같은 바이트를 base64로 인코딩하면 다음과 같습니다:
"thumbnail":"s/9jmA==..."
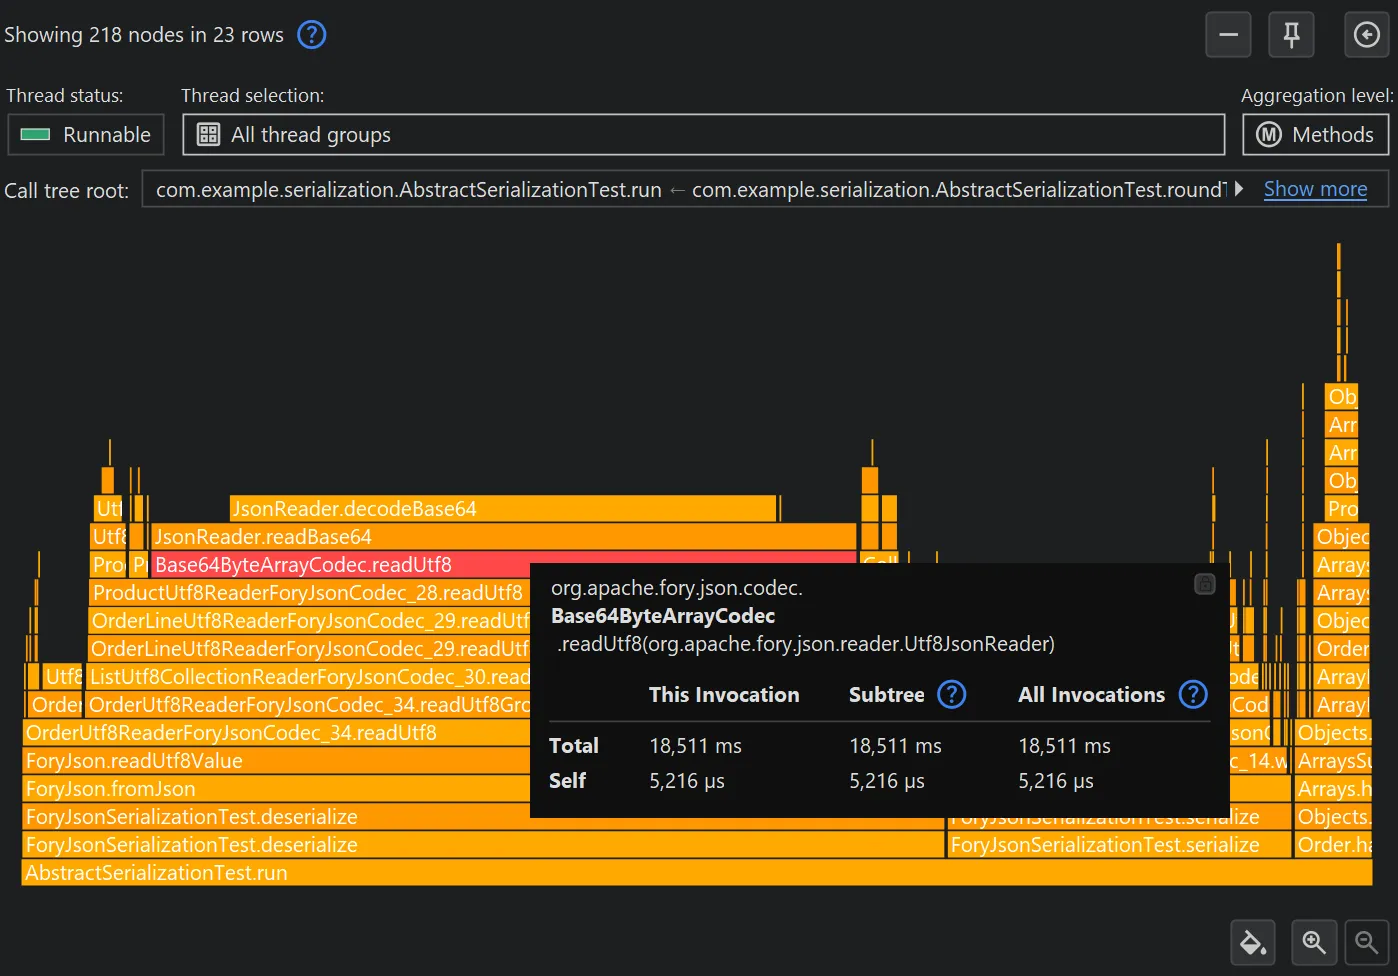
이전 비교에서 base64 처리는 JSON 엔진들 간에 차이가 가장 컸던 지점이었는데, Fory의 새 모듈도 사실상 같은 함정에 빠져 있었습니다. 그렇다면 이 비효율적인 인코딩이 속도 저하의 전부일까요? 이를 확인할 방법은 프로파일링뿐입니다. 데이터는 명확했습니다. 바이트 배열 디코딩이 콜 트리 전체를 지배하고 있었습니다.
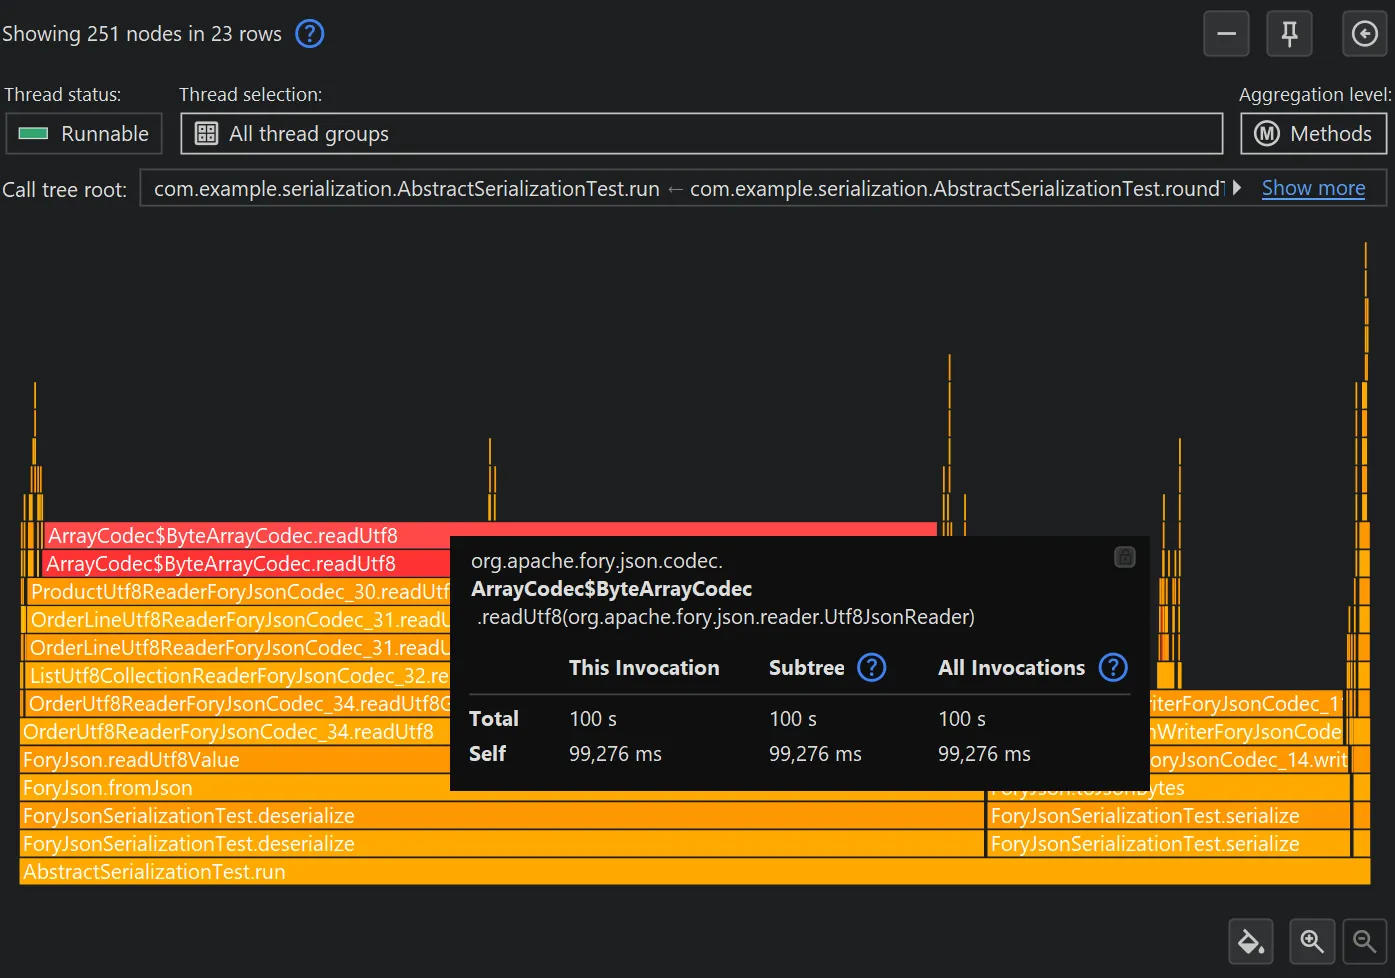
썸네일을 제외하면 Fory JSON은 같은 왕복을 3.5 µs 만에 처리했습니다. 새 모듈 자체는 전반적으로 문제가 없었습니다. 문제의 전부는 바이트 배열의 기본 코덱이었습니다.
알고 보니 Fory에는 이미 Base64ByteArrayCodec이 존재했지만, 이를 사용하려면 @JsonBase64 애노테이션이 필요했습니다. 필자가 처음 시도한 것은 byte[]의 기본 코덱을 바꾸는 것이었습니다. 그러나 이 변경으로도 개선은 16%에 불과했고 수치는 여전히 형편없었습니다.
다음 프로파일링 실행에서 개선 폭이 왜 그렇게 작았는지가 드러났습니다. 쓰기와 읽기가 서로 반대 방향으로 움직인 것입니다. base64 인코더는 테이블 기반으로 동작하면서 출력 버퍼에 곧바로 기록하기 때문에 10진수 숫자를 기록할 때보다 약 6배 빠릅니다. 그러나 base64 디코더는 10진수 파싱보다도 느렸습니다. 이 디코더는 전체 문자열에 대해 분기가 많은 검증 스캔을 수행한 뒤, 두 번째 패스에서 모든 문자를 다시 읽으며 문자별 이스케이프 처리와 숫자 하나당 4방향 분기를 거쳤습니다. 직렬화되는 주문 하나당 약 7 KB의 base64 데이터가 있었기 때문에, 디코더 하나만으로 전체 실행의 85%를 차지했습니다.
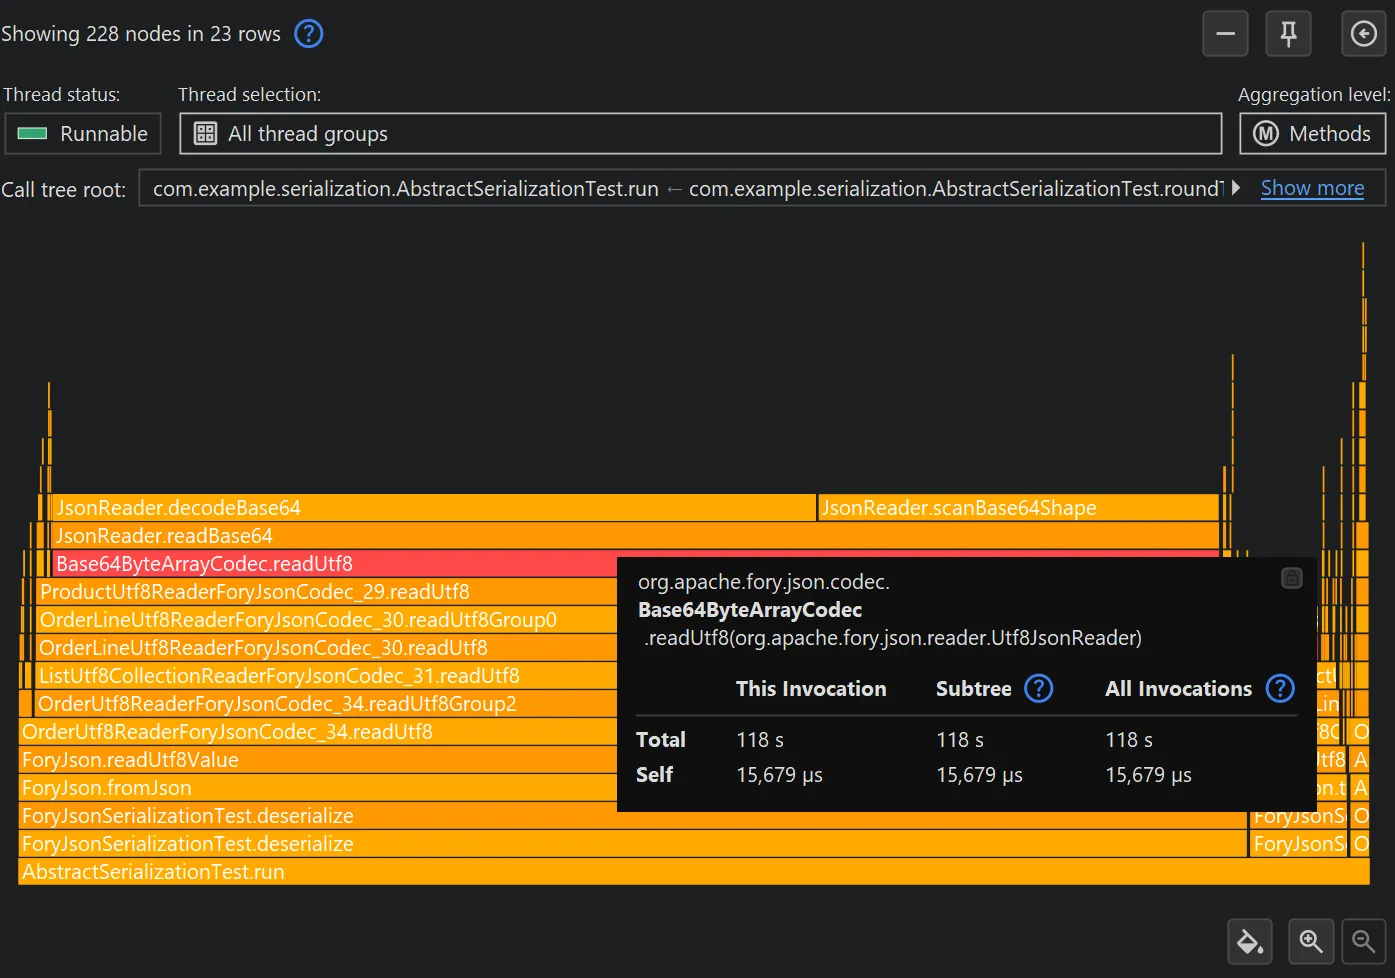
이 문제를 수정하는 일은 조금 더 복잡했습니다. 이제 검증은 128개 항목으로 이루어진 테이블을 이용한 단일 스캔으로 수행됩니다. 이 테이블은 각 ASCII 문자를 해당 6비트 값에 매핑하고, 유효하지 않은 문자는 -1에 매핑합니다. 디코딩 패스는 같은 테이블을 통해 반복당 4문자를 소비하여 3바이트를 출력하며, 분기는 전혀 없습니다. JSON 문자열에는 Unicode 이스케이프 시퀀스가 합법적으로 포함될 수 있으므로, 역슬래시가 포함된 base64 본문은 여전히 기존 검증 경로로 폴백합니다. 인코더는 base64 문자를 이스케이프하지 않으므로, 실제로는 항상 빠른 경로가 실행됩니다.
마침내 Fory JSON의 수치가 크게 낮아져, 왕복당 75.9 µs에서 16.8 µs로 줄어들었습니다:
| 바이트 배열 처리 | 왕복당 시간 | 페이로드 크기 |
|---|---|---|
| 10진수 숫자 배열 (Fory 1.7.0) | 75.9 µs | 20,999바이트 |
| base64 기본값, 기존 디코더 | 64.0 µs | 9,742바이트 |
| base64 기본값, 테이블 기반 디코더 | 16.8 µs | 9,742바이트 |
첫 번째 단계에서는 1.16배, 두 번째 단계에서는 3.8배의 개선이 있었고, 두 개를 합치면 4.5배가 됩니다. 바이트 배열 처리는 처음 두 상태에서 실행 시간의 약 90%를 차지했으며, 수정 후에도 여전히 66%이지만 이는 훨씬 작아진 전체 기준에서의 비율입니다.
이제 이 페이로드에서는 Fory JSON이 Jackson보다 빨라졌으며, 이전처럼 2.8배 느리지 않습니다:
| 구성 | 왕복당 시간 |
|---|---|
| Fory JSON, 수정 후 | 16.8 µs |
| Jackson 3.2.2 | 25.7 µs |
| Jackson 2.22.1 | 27.0 µs |
Jackson 2에는 Fory JSON이 1.6배 빠르고, Jackson 3에는 1.5배 빠릅니다.
뜻밖에도, base64 기본값은 정확성과 상호 운용성, 그리고 2.2배 작은 페이로드라는 이점을 제공했지만 속도 면에서는 큰 개선을 가져오지 못했습니다. 결정적인 차이를 만들어낸 것은 개선된 base64 디코더였습니다.
수정 사항 반영하기
이 이야기의 주인공은 Fory 메인테이너들입니다. 이들은 몇 시간 만에 필자의 PR을 검토해 주었고, 기존 10진수 형식을 옵트인 방식으로 계속 선택할 수 있게 해주는 @JsonByteArray 형식 애노테이션으로 API를 개선한 뒤, 다음 날 이를 main 브랜치에 병합해 주었습니다.
Fory는 데이터를 직렬화하는 속도만큼이나 빠르게 개발되고 있는 것 같습니다. 대단합니다! 그리고 이 이야기의 교훈은 무엇일까요? 빠른 라이브러리의 새 모듈에도 최적화되지 않은 구석이 있을 수 있습니다. 프로파일러라면 그런 부분을 몇 분 만에 찾아냅니다.
측정 방법
측정 환경은 이전 글들과 동일했습니다. JProfiler Gradle 플러그인이 오프라인 모드에서 구성별로 스냅샷을 하나씩 기록했으며, CPU 샘플링과 할당 기록은 별도의 실행에서 진행했습니다. 핫스팟 분석에는 코딩 에이전트가 JProfiler MCP 서버를 구동했습니다. 전체 프로젝트는 GitHub에서 볼 수 있습니다.
스냅샷을 직접 살펴보려면 JProfiler를 다운로드한 뒤 build/snapshots-cpu의 .jps 파일들을 열면 됩니다.