

我是如何让 Apache Fory JSON 提速 4.5 倍的
最近,我一直在对比各类 Java 序列化框架。在二进制负载方面,我已成为 Apache Fory 的忠实拥趸——它在官方网站上宣称“快如闪电”,事实也确实如此。在这些对比中,我区分了 JSON 和二进制负载两类场景:Jackson 是 JSON 序列化(Kotlin 亦然)的王者,而 Apache Fory 则在二进制负载上称雄。
在 Apache Fory 最近发布的 1.7.0 版本中,JSON 支持作为主打新特性加入。自然而然,我满怀好奇,把 Fory JSON 加进了我的序列化演示项目。看到自己负载的测试数字时,我简直不敢相信:Fory 竟然比 Jackson 慢 2.8 倍。这里面一定有问题,我决定追查到底。
排查过程
负载大小本身已经暗示了可能的原因:Fory 写出的负载为 20,999 字节,而 Jackson 只有 9,814 字节。我们的负载中以字节数组的形式包含缩略图,而 Fory 选择这样序列化它们:
"thumbnail":[-77,-1,99,-104,...]
这种做法极其低效。每个字节会变成至多五个字符,随机数据的平均值超过三个半。写入时需要符号判断和十进制转换,读取时则需要扫描数字并重新拼出数值。它同样与 RFC 7493、protobuf 的 JSON 映射、Jackson、Gson、Moshi、kotlinx.serialization 及其他序列化框架的做法相悖。JSON 没有二进制类型,base64 字符串才是标准处理方式:每三个字节只写出四个字符。
同样这批字节,base64 编码后是这样的:
"thumbnail":"s/9jmA==..."
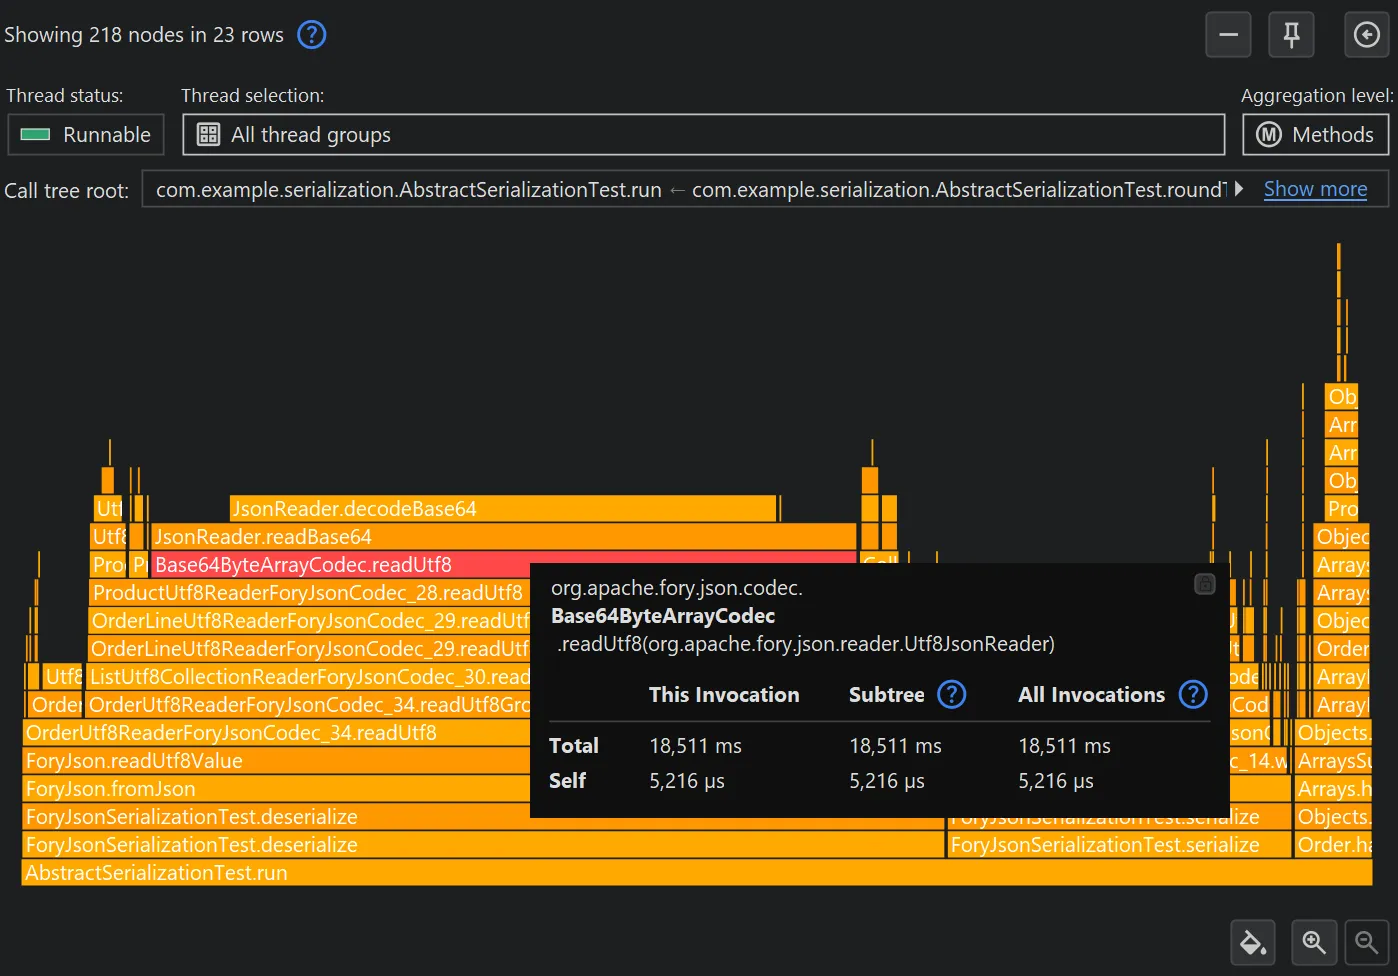
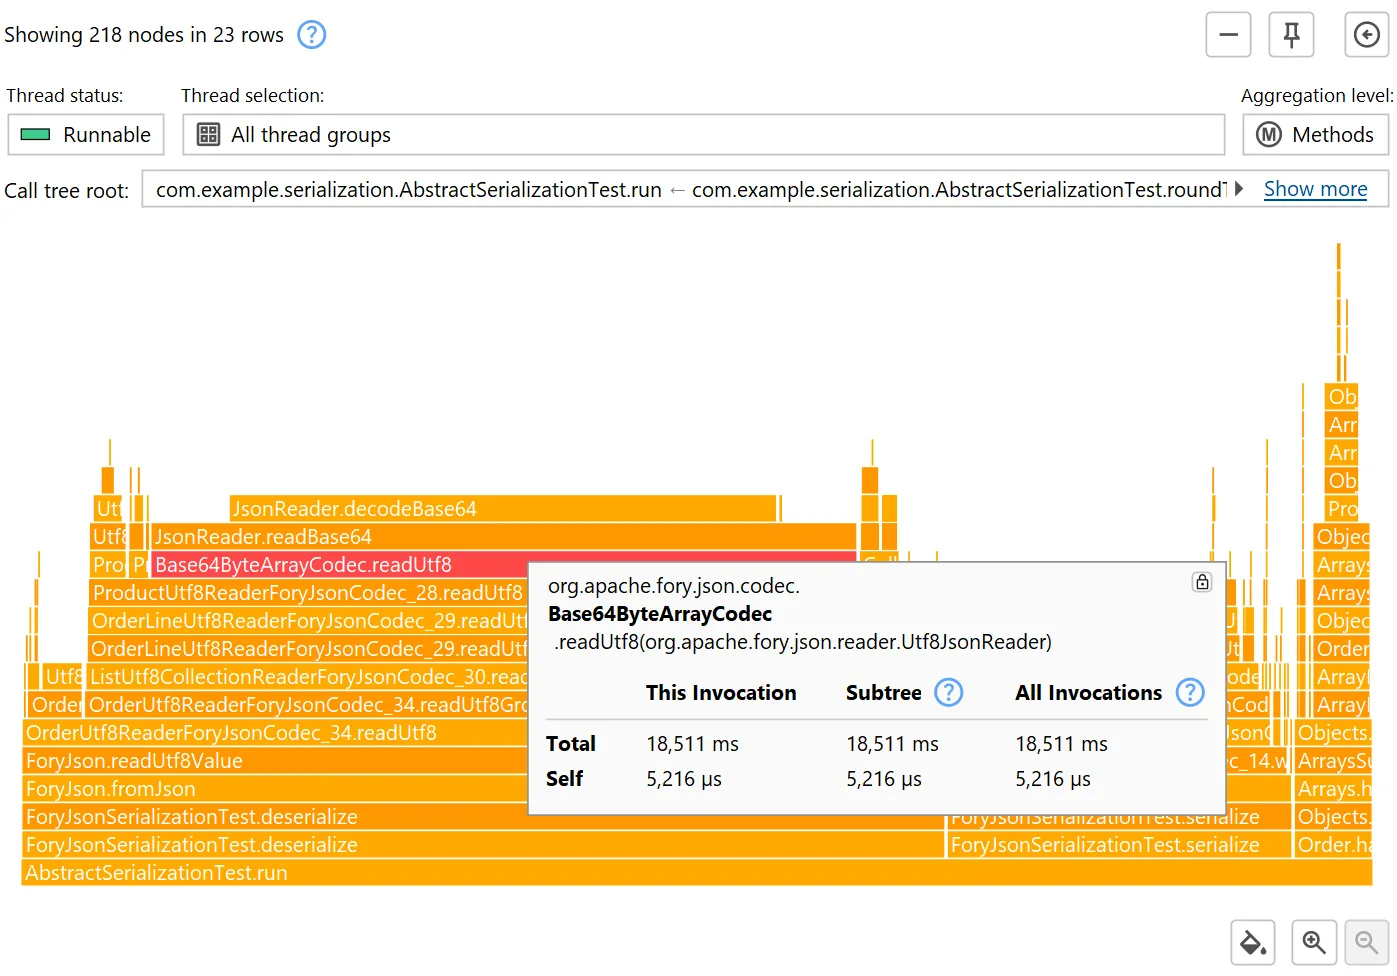
在之前的对比中,base64 处理正是各 JSON 引擎差异最大的地方,而 Fory 的新模块多少也算踩中了同一个陷阱。不过,低效的编码是速度变慢的全部原因吗?只有一种办法能弄清楚,那就是性能分析。数据给出了明确的答案:字节数组的解码在调用树中占据主导。
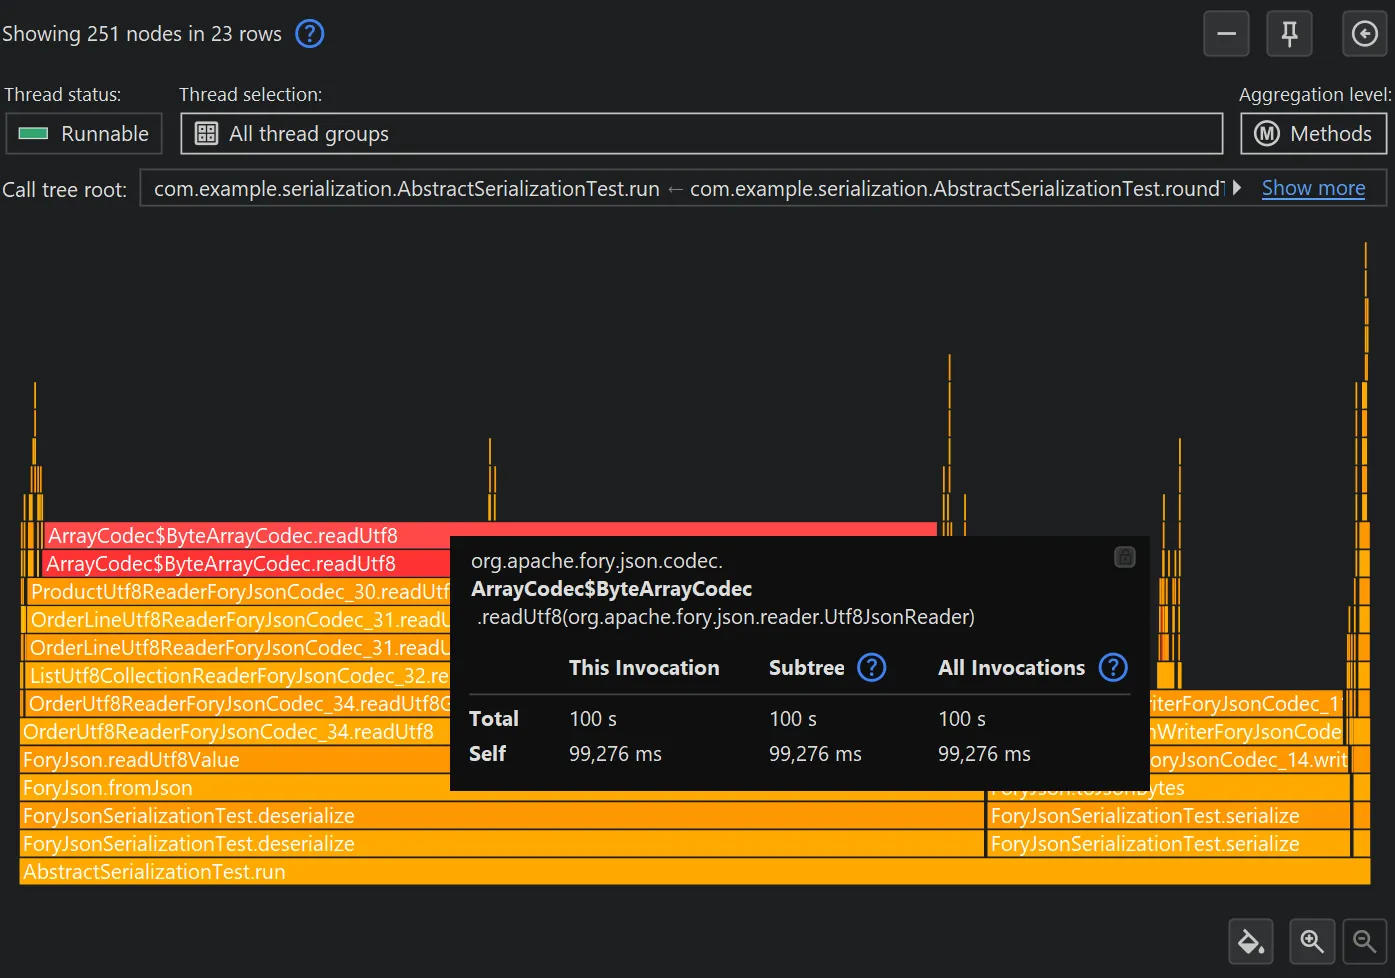
去掉缩略图之后,Fory JSON 完成同样的往返只需 3.5 µs。新模块本身总体上没有问题,症结恰恰全部出在字节数组的默认编解码器上。
原来,Fory 其实已有 Base64ByteArrayCodec,只是需要加上 @JsonBase64 注解才会启用。我的第一个动作就是把 byte[] 的默认编解码器切换成它。但即便做了这一改动,数字依然很难看,只提升了 16%。
下一轮性能分析说明了收益为何如此有限:写入和读取朝相反方向变化。base64 编码器是表驱动的,直接写入输出缓冲区,比写十进制数字快约 6 倍。而 base64 解码器却比十进制解析还要慢:它先对整个字符串做一遍分支密集的校验扫描,然后再做第二遍处理,逐字符重新读取,每个字符都要处理转义,每个数字还要经过四路分支。由于每条序列化订单约含 7 KB 的 base64 数据,仅解码器就占掉了整个运行时间的 85%。
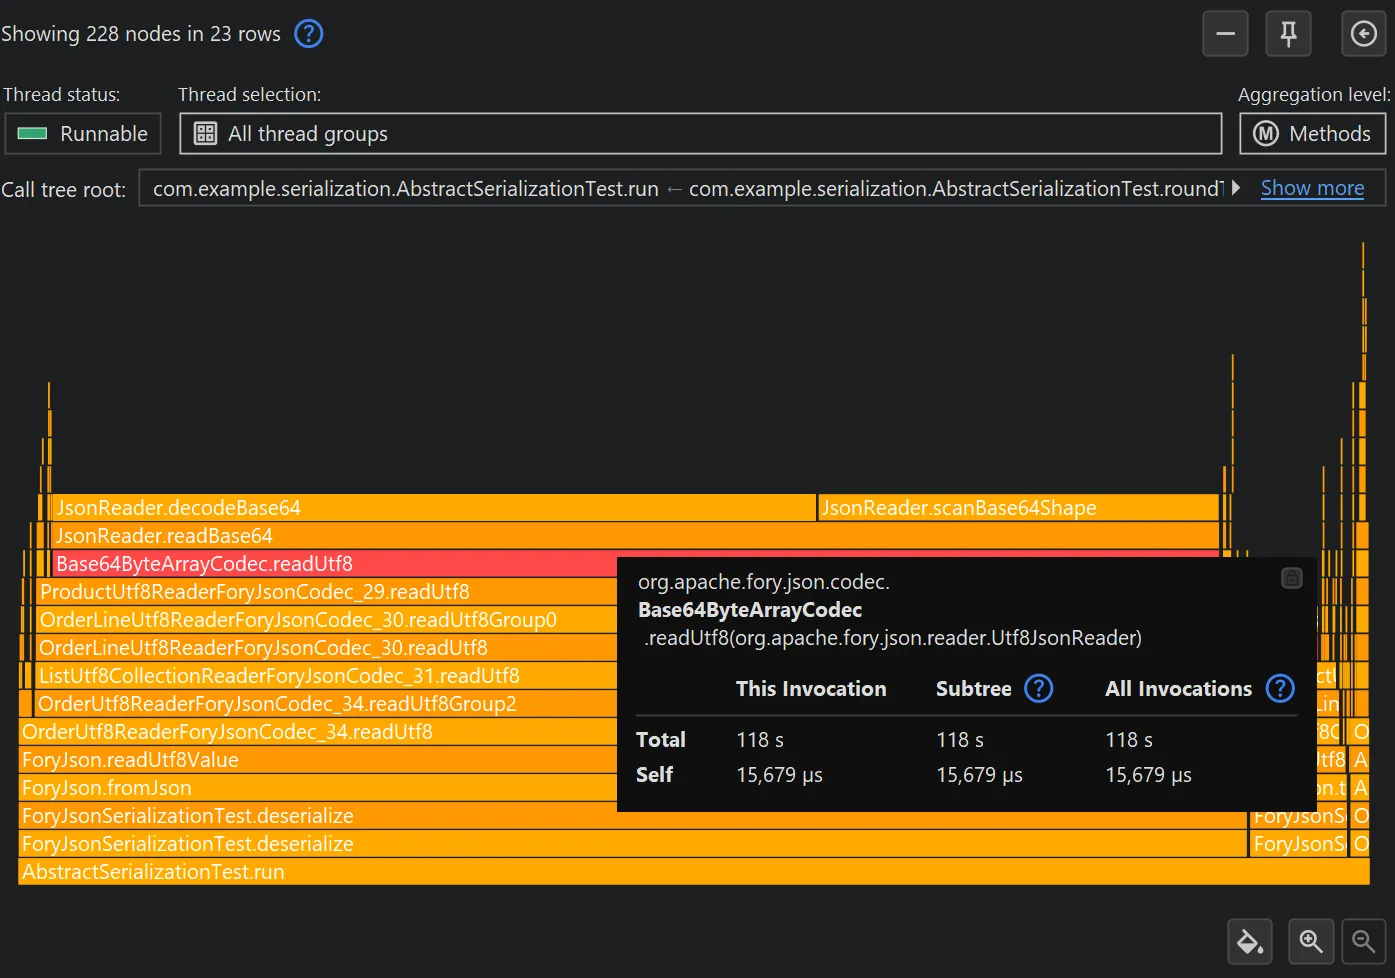
修好这里要稍微费些工夫。现在的校验只需一次扫描:用一张 128 项的表把每个 ASCII 字符映射到对应的 6 位取值,无效字符则映射为 -1。解码过程同样借助这张表,每轮迭代消费四个字符、输出三个字节,不含任何分支。JSON 字符串中允许出现 Unicode 转义序列,因此若 base64 正文里含有反斜杠,仍会回退到旧的校验路径。由于编码器不会转义 base64 字符,快速路径在实践中始终生效。
最终,Fory JSON 的数字大幅下降,每次往返从 75.9 µs 降到 16.8 µs:
| 字节数组处理方式 | 每次往返耗时 | 负载大小 |
|---|---|---|
| 十进制数字数组(Fory 1.7.0) | 75.9 µs | 20,999 字节 |
| base64 默认编码,原始解码器 | 64.0 µs | 9,742 字节 |
| base64 默认编码,表驱动解码器 | 16.8 µs | 9,742 字节 |
第一步带来 1.16 倍的提升,第二步带来 3.8 倍,合计 4.5 倍。在前两种状态下,字节数组处理约占运行时间的 90%;修复后仍占 66%,只是基数已经小得多。
对这个负载而言,Fory JSON 如今也快于 Jackson,不再是之前慢 2.8 倍的情形:
| 测试配置 | 每次往返耗时 |
|---|---|
| 修复后的 Fory JSON | 16.8 µs |
| Jackson 3.2.2 | 25.7 µs |
| Jackson 2.22.1 | 27.0 µs |
相比 Jackson 2,Fory JSON 快 1.6 倍;相比 Jackson 3,快 1.5 倍。
出人意料的是,base64 默认编码带来了正确性、互操作性以及缩小 2.2 倍的负载,速度却没能好多少。真正带来决定性差异的,是改进后的 base64 解码器。
让修复落地
这个故事的主角是 Fory 的维护者们:他们在短短几个小时内就评审了我的 PR,通过 @JsonByteArray 格式注解改进了 API,让旧的十进制格式仍可作为可选项使用,并在第二天将改动合并进了 main 分支。
Fory 的开发速度似乎和它序列化数据的速度一样快。为他们点赞!这个故事的启示是什么?高性能库中的新模块也可能存在未经优化的角落,而性能分析器几分钟就能把它们找出来。
测量方法
测量设置与之前的文章相同:JProfiler Gradle 插件以离线模式为每个配置各记录一份快照,CPU 采样与分配记录分别在单独的运行中完成。热点分析则由一个编码智能体驱动 JProfiler MCP 服务器进行。完整项目见 GitHub。
若想亲自查看这些快照,请下载 JProfiler,然后打开 build/snapshots-cpu 目录中的 .jps 文件。