

Apache Fory 为什么如此之快?剖析 5 种 Java 序列化框架
JDK 架构师非常不喜欢 Java 序列化,这早已不是什么秘密。它是一场安全噩梦,让每一项新语言特性的实现都变得相当复杂,而且速度还非常慢。这正是其他序列化框架存在的原因。如今有一个新秀声称具备令人瞩目的性能:Apache Fory。在这篇博文中,我们将检验它是否名副其实(它以前名为 "Fury"),并将其与现有的主流框架进行比较。
为了进行比较,我用五种不同的框架剖析了一个真实对象图的序列化与反序列化往返过程:
- Java 序列化
- Kryo
- Apache Fory
- Jackson(同时使用 JSON 和 CBOR 后端)
剖析数据解释了为什么 Apache Fory 遥遥领先,以及 Java 序列化所做的大部分工作为什么其实并不是序列化本身。
测试设置与数据
测试数据集由 200 个订单组成,包含客户、地址、订单行、产品和类别。被序列化的类包含许多与序列化相关的不同特性:共享引用、集合、映射、枚举、BigDecimal、Date、长字符串和字节数组。每个测试在预热阶段之后执行两百万次序列化与反序列化往返,并通过 equals 比较来验证每个框架都能正确地往返数据。完整项目可在 GitHub 上获取。
测试在 JDK 25 上运行,共进行 200 万次往返。JVM 通过 JProfiler Gradle 插件以离线模式进行剖析,分别使用 CPU 采样或分配记录,为每个框架生成一个快照。对于 Java 序列化,java.* 类被显式纳入剖析,因为默认情况下 JProfiler 会过滤掉这些类。
| 框架 | 每次往返耗时 | 有效负载大小 | 总分配内存 |
|---|---|---|---|
| Fory 1.6 | 3.5 µs | 7,502 字节 | 4.5 GB |
| Kryo 5.6 | 8.9 µs | 7,257 字节 | 4.2 GB |
| Jackson CBOR | 12.0 µs | 7,819 字节 | 6.5 GB |
| Jackson JSON | 28.7 µs | 9,814 字节 | 8.8 GB |
| java.io | 46.8 µs | 9,152 字节 | 18.4 GB |
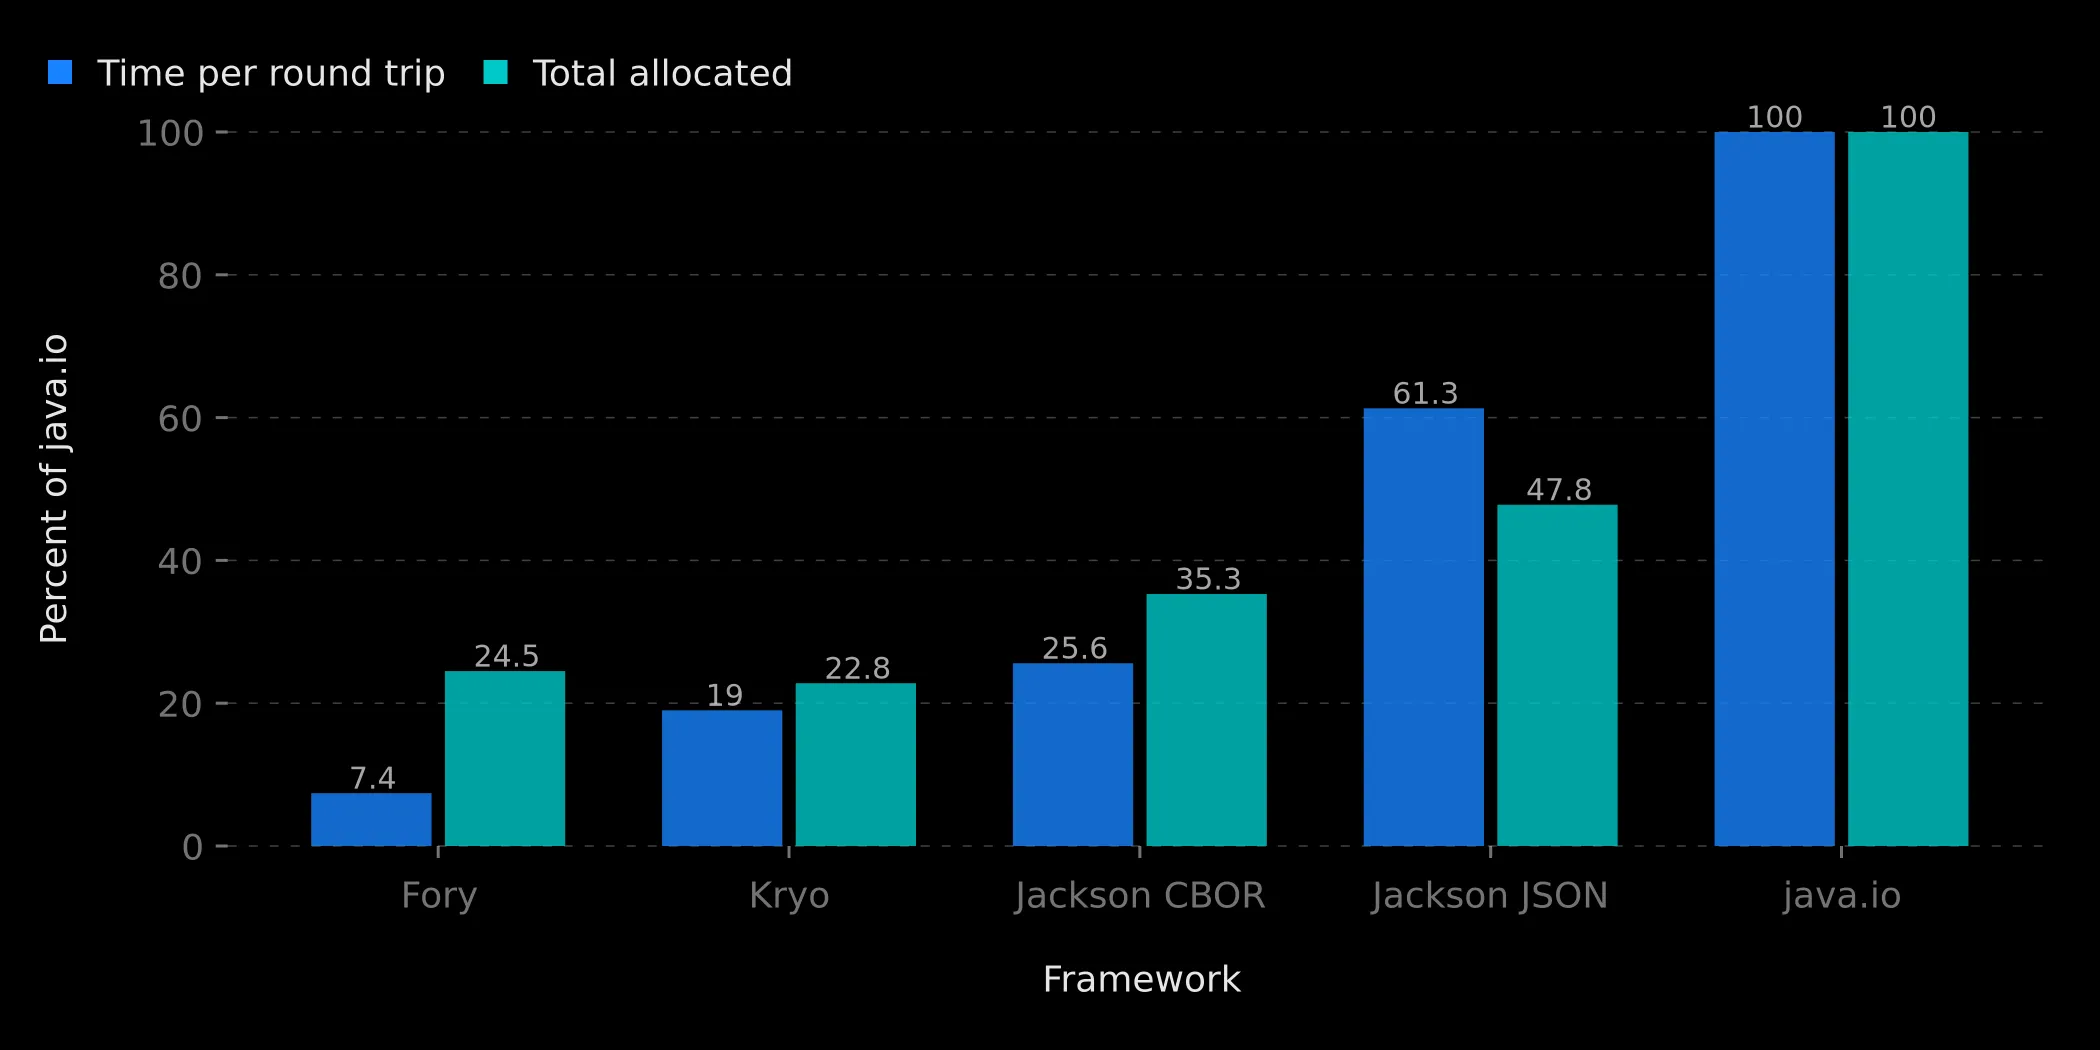
Java 序列化的耗时是 Fory 的 13 倍,内存分配量是其 4 倍。这与已发表的基准测试结果一致。图表还显示,这两列数据是相互关联的:Kryo 的往返耗时与其分配量几乎成正比。Jackson JSON 比分配比例所预示的更慢,因为它要解析大量文本,而这会消耗更多 CPU。Fory 则以巨大幅度超越了这种相关性:耗时仅占 7%,分配量却达 25%。下文我会再回到这一点。首先,让我们看看时间究竟花在了哪里。
Java 序列化为什么慢
有趣的是,Java 序列化在读取和写入之间非常不对称:73% 的 CPU 时间花在 deserialize 上,而 serialize 仅占 26%。
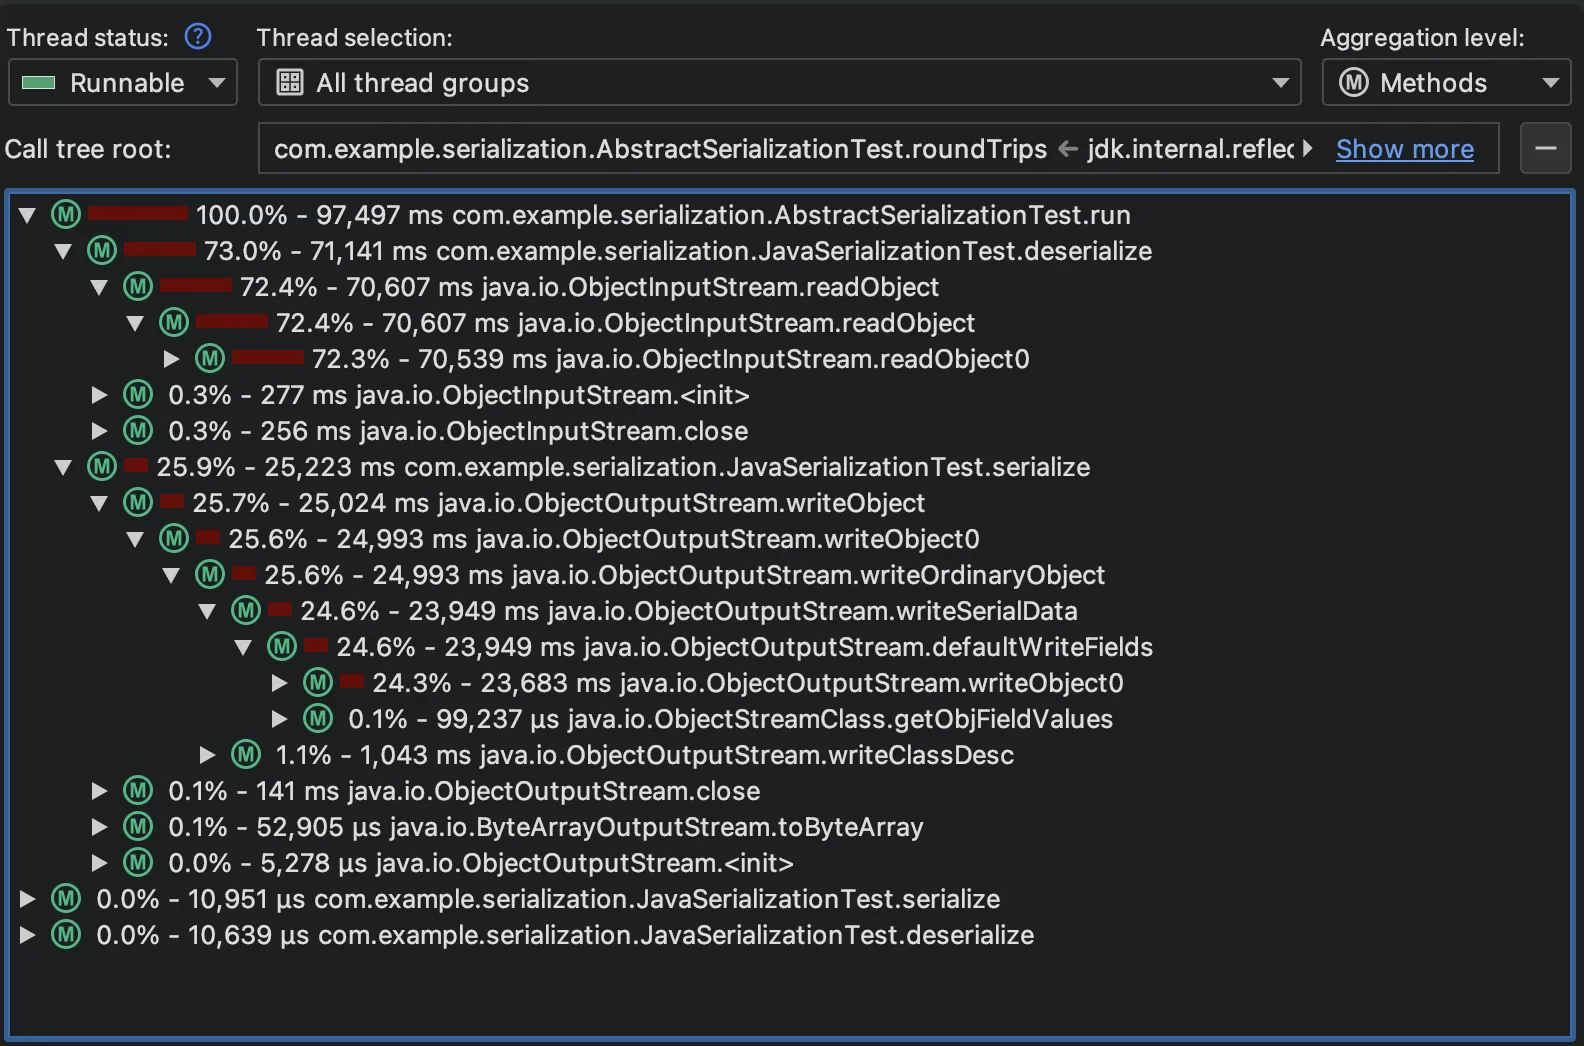
本次运行的主要热点显示了时间的去向:
jdk.internal.misc.VM.latestUserDefinedLoader0(18%):对于流中的每个类描述符,JDK 都会在原生代码中遍历调用栈,以找到应该解析该类的类加载器。Class.forName0(8%)和String.intern(6%):解析这些类,并对来自流类型描述符的字段名执行内部化。加上类加载器检测,整个运行有近三分之一的时间用于回答"这是哪个类,它有哪些字段"这个问题。ObjectInputStream$PeekInputStream.readFully(13%):搬运字节。ObjectOutputStream$HandleTable.lookup(5%):跟踪共享引用。BlockDataInputStream.readUTFSpan和readUTFBody(合计 8%):解析流格式中的大量小 UTF 字符串。
分配数据从内存角度呈现出同样的情形。在两百万次往返期间,Java 序列化运行分配了:
- 800 万个
ObjectStreamClass实例(844 MB)。类描述符由 JDK 以软引用缓存,因此在分配压力下,垃圾回收器显然逐出了大量条目。 - 用于元数据和字段存储的 1000 万个
ObjectStreamField与 1060 万个FieldValues实例。 - 2600 万个
StringBuilder实例,主要来自描述符解析。
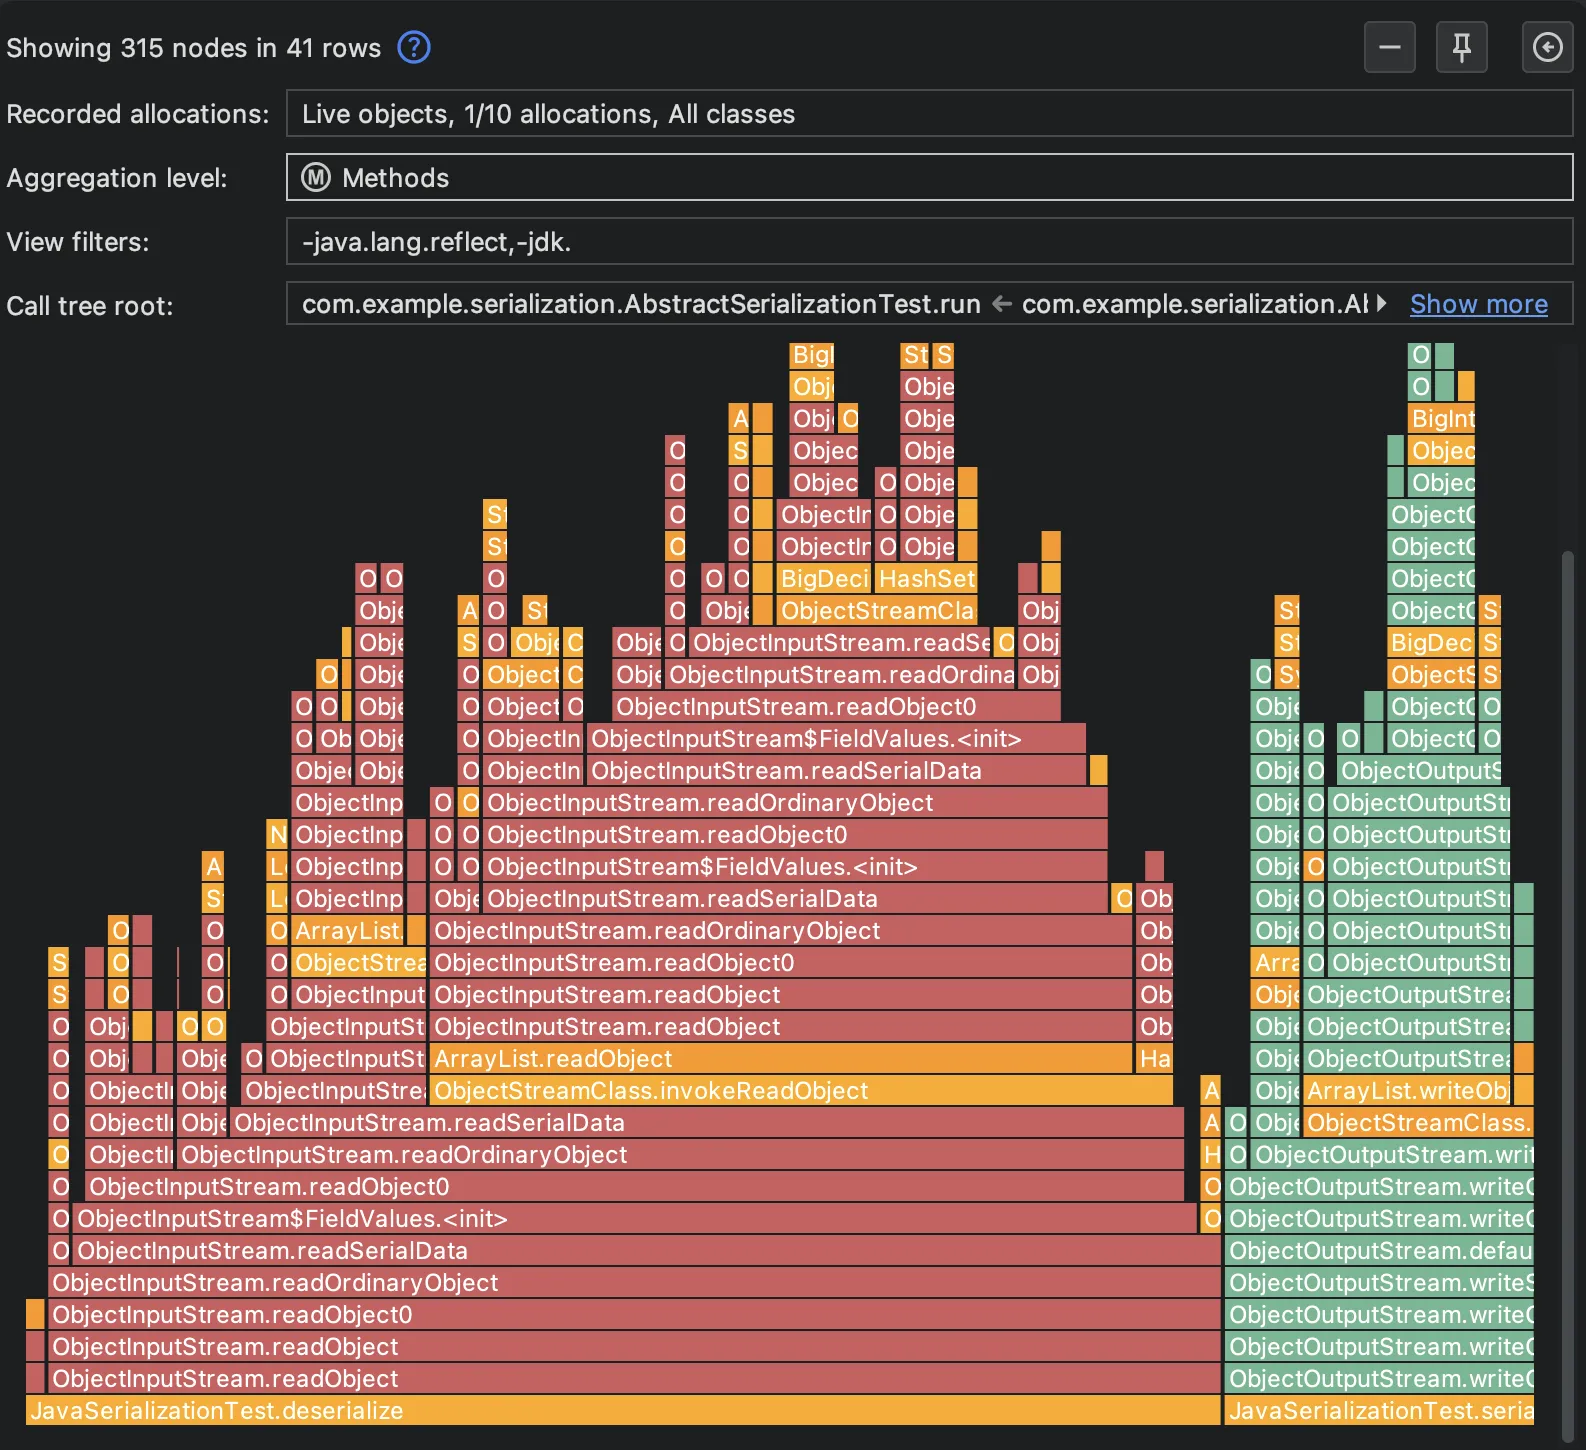
这些工作大部分与被序列化的数据无关,只是格式本身的簿记:类型描述符、字段元数据,以及跟踪对象引用的标识表。为每次往返都新建一个 ObjectInputStream 是该 API 的常规用法,而它每次都会重新解析类描述符。
Fory 和 Kryo 为什么快
Fory 和 Kryo 完全跳过了这些簿记工作:没有需要解析的类型描述符,没有需要在读取时解析的类,也没有反射(至少在热路径上如此)。剖析数据中剩下的,主要是实际构建结果的工作。
在 Fory 快照中,超过三分之一的时间直接花在 Fory 在运行时生成的序列化器类中,表现为诸如 ProductForyRefCodecCompatible4_0.readFields$ 这样的方法。另有 14% 花在 HashMap.putVal 上,用于重建反序列化后订单的属性映射,还有 6% 用于通过 VarHandle 设置字段。剖析数据表明,Fory 的工作本质上主要是把字节搬入对象。
Kryo 的剖析数据则有所不同。它有 27% 花在 readObject 和 writeObjectOrNull 方法上,23% 用于读写字符串,12% 花在跟踪引用的标识映射上,7% 花在 FieldSerializer 上,还有 5% 用于写入类名。Kryo 之所以快,是因为它不像 Java 序列化那样管理描述符,但它仍然拥有自己的按对象、按字段分发的层。
Fory 为什么如此之快
真正有趣的是,Kryo 的内存分配量在所有框架中最少,耗时却达到 Fory 的 2.5 倍。当然,分配只统计字节数,并不统计每个字节所花费的指令数。
Kryo 的序列化方式相当于一个解释器循环。对每个对象,它都要查找序列化器;对每个字段,它都要经由 FieldSerializer 分发;对每个类名,它都要向流写入一个字符串。这些分发方法单独来看都不是瓶颈,但加在一起,它们占了数据与字节之间超过 40% 的运行时间。
Fory 中生成的编解码器没有这样的层。Fory 在运行时编译出的类只是一段固定的读取与写入序列。缓冲区访问通过批量内存操作进行,而非逐字节读取;字段访问则通过 VarHandle 完成。热点视图清楚地展示了这一点:榜首是重建属性映射带来的 HashMap.putVal,其后的名次则由生成的 ForyRefCodec 类占据。
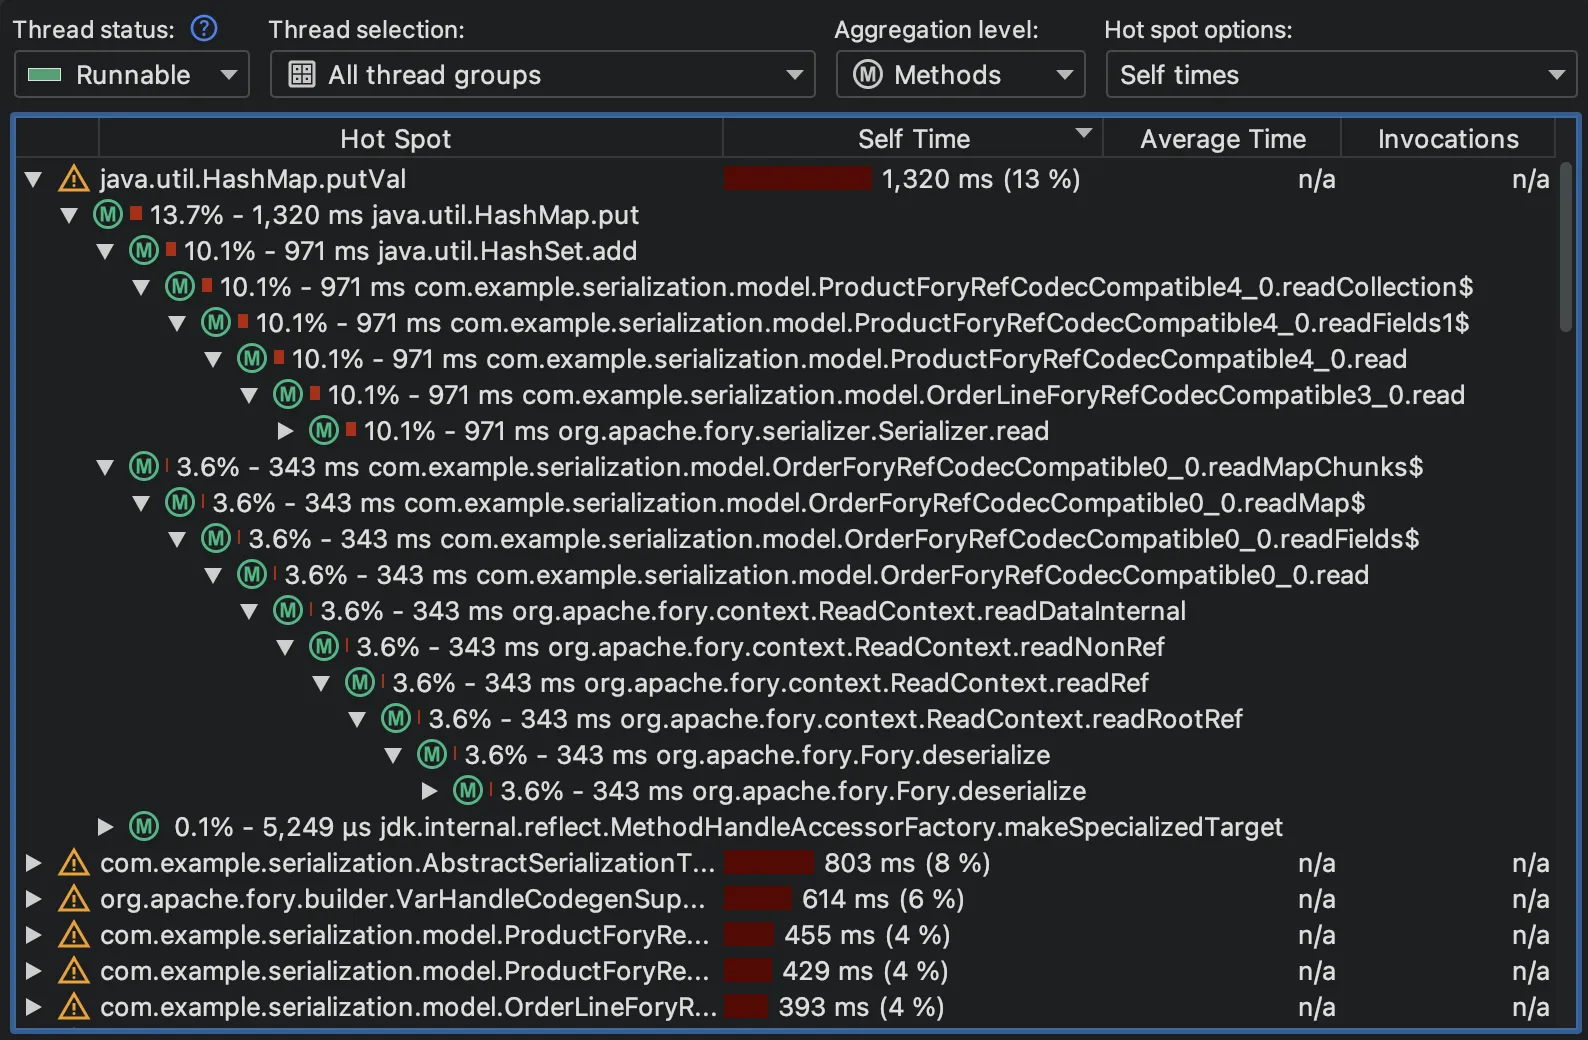
因此,这里的主要结论是:正是代码生成让 Fory 拥有了无可匹敌的优势。
Jackson 的不同权衡
Jackson 是使用最广泛的序列化框架,但它的卖点并不只有速度。Jackson 是将类转换为 JSON 的默认首选方案,并为此提供了大量功能。
像 JSON 这样的文本格式本身就是一项代价高昂的特性。将 byte[] 缩略图编码为 base64 占总时间的 24%,解码又占 23%,因此整个运行几乎有一半时间花在 JSON 没有二进制类型这一事实上。反射方法调用又占 13%。
不过,Jackson 也提供二进制后端,而且切换起来相当简单,例如使用 CBORMapper。在示例工作负载中,CBOR 的速度是 JSON 的 2.4 倍,产生的有效负载几乎与 Fory 一样紧凑。剖析数据证实,格式已不再是问题所在:CBOR 解析器和生成器合计约占四分之一的时间,而基于反射的数据绑定层现在约占 40%。正是仍然存在数据绑定层这一事实,使其耗时约为 Fory 的 3.4 倍。
框架选型
- 就纯速度而言,Fory 在本次比较中以巨大优势胜出。它还提供多种其他语言的实现,以及一种可容忍模式变更的类型兼容模式,因此非常适合多语言系统以及需要长期存储的数据。
- 对于缓存条目或受信任服务之间的 RPC 这类负载,Kryo 仍然是一个务实的选择。它成熟且依赖极简,但在我们的示例工作负载中,其耗时是 Fory 的 2.5 倍。
- 凡是需要供人类或其他工具读取的场景,采用 JSON 的 Jackson 都是务实的默认选择。如果您能控制通信管道的两端,只需一行代码的改动即可切换到 CBOR 后端。
- Java 序列化仅用于兼容现有系统。
剖析方法
本文中的所有内容均通过命令行生成。快照由 JProfiler Gradle 插件以离线模式记录,每个框架对应一个任务:
tasks.create<com.jprofiler.gradle.TestProfile>("profileFory") {
    useJUnitPlatform()
    filter { includeTestsMatching("com.example.serialization.ForySerializationTest") }
    offline = true
    callTreeMode = CallTreeMode.SAMPLING
    profile = listOf("com.", "org.", "java.", "javax.", "jdk.", "sun.")
    recording = listOf("cpu") // or listOf("allocation")
    snapshotFile = file("build/snapshots-cpu/fory.jps")
}
一个重要提示:同时测量 CPU 和分配数据并不可取。分配记录每十个对象采样一次,因此绝对分配值被低估了十倍,而框架之间的比率不受影响。不过,即便采用这样的采样比例,分配记录的开销依然很大,并且会使测得的 CPU 时间失真。
分析工作本身由一个编码智能体完成,它驱动了 JProfiler MCP 服务器。
亲自尝试
完整项目见 GitHub。若要亲自查看快照,请下载 JProfiler,并打开 build/snapshots-cpu 和 build/snapshots-allocation 目录中的 .jps 文件。