

なぜApache Foryはこれほど高速なのか? 5つのJavaシリアライズフレームワークをプロファイリング
JDKの設計者たちがJavaシリアライズをひどく嫌っているのは、周知の事実です。シリアライズはセキュリティ上の悪夢であり、新しい言語機能が追加されるたびにその実装を大幅に複雑にしたうえで、動作も非常に遅い。だからこそ、他のシリアライズフレームワークが存在するのです。そんな中、印象的なパフォーマンスを謳う新顔が登場しました。Apache Foryです。このブログ記事では、旧名(かつては「Fury」)にふさわしい性能を持つのかを確かめ、既存のフレームワークと比較します。
比較にあたっては、現実的なオブジェクトグラフのシリアライズとデシリアライズのラウンドトリップを、5つの異なるフレームワークでプロファイリングしました。
- Javaのシリアライズ
- Kryo
- Apache Fory
- JSONとCBORの両方のバックエンドを備えたJackson
このプロファイリングデータは、Apache Foryがなぜ首位に立つのかを説明するとともに、Javaシリアライズが行っていることの大半はシリアライズではないことも明らかにしています。
セットアップと測定結果
テストデータセットは、顧客、住所、注文明細、製品、カテゴリを含む200件の注文で構成されています。シリアライズ対象のクラスには、シリアライズに関係するさまざまな要素が多く含まれています。共有参照、コレクション、マップ、列挙型、BigDecimal、Date、長い文字列、バイト配列です。各テストでは、ウォームアップフェーズの後に200万回のシリアライズとデシリアライズのラウンドトリップを実行し、equalsによる比較で、すべてのフレームワークがデータを正しくラウンドトリップしていることを検証します。完全なプロジェクトはGitHubで入手できます。
テストはJDK 25上で200万回のラウンドトリップで実行しました。JVMのプロファイリングには、オフラインモードのJProfiler Gradleプラグインを使用し、CPUサンプリングまたはアロケーション記録を有効にして、フレームワークごとに1つのスナップショットを取得しました。Javaシリアライズについては、デフォルトではJProfilerによってこれらのクラスがフィルタリングで除外されるため、java.*クラスを明示的にプロファイリング対象にしました。
| フレームワーク | 1回のラウンドトリップあたりの時間 | ペイロードサイズ | 合計アロケーション量 |
|---|---|---|---|
| Fory 1.6 | 3.5 µs | 7,502バイト | 4.5 GB |
| Kryo 5.6 | 8.9 µs | 7,257バイト | 4.2 GB |
| Jackson CBOR | 12.0 µs | 7,819バイト | 6.5 GB |
| Jackson JSON | 28.7 µs | 9,814バイト | 8.8 GB |
| java.io | 46.8 µs | 9,152バイト | 18.4 GB |
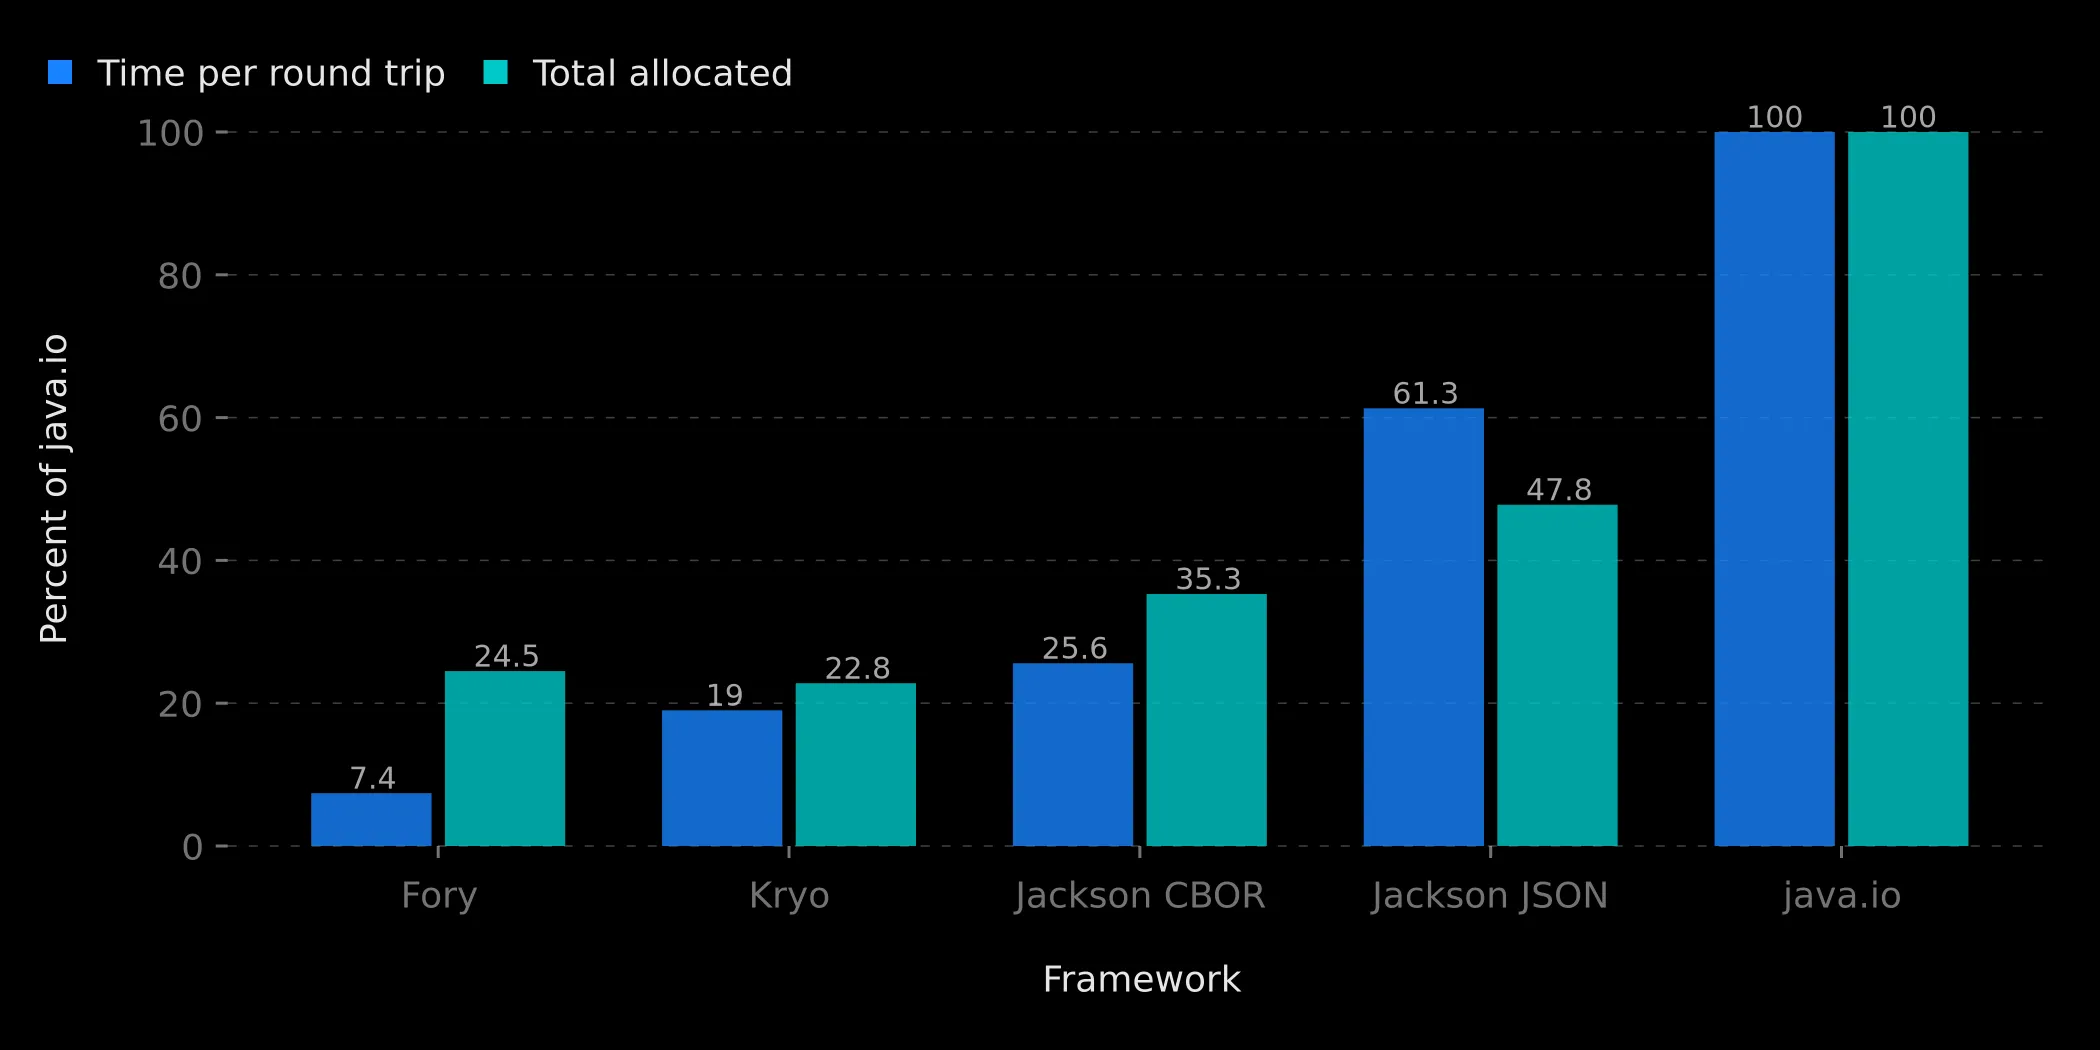
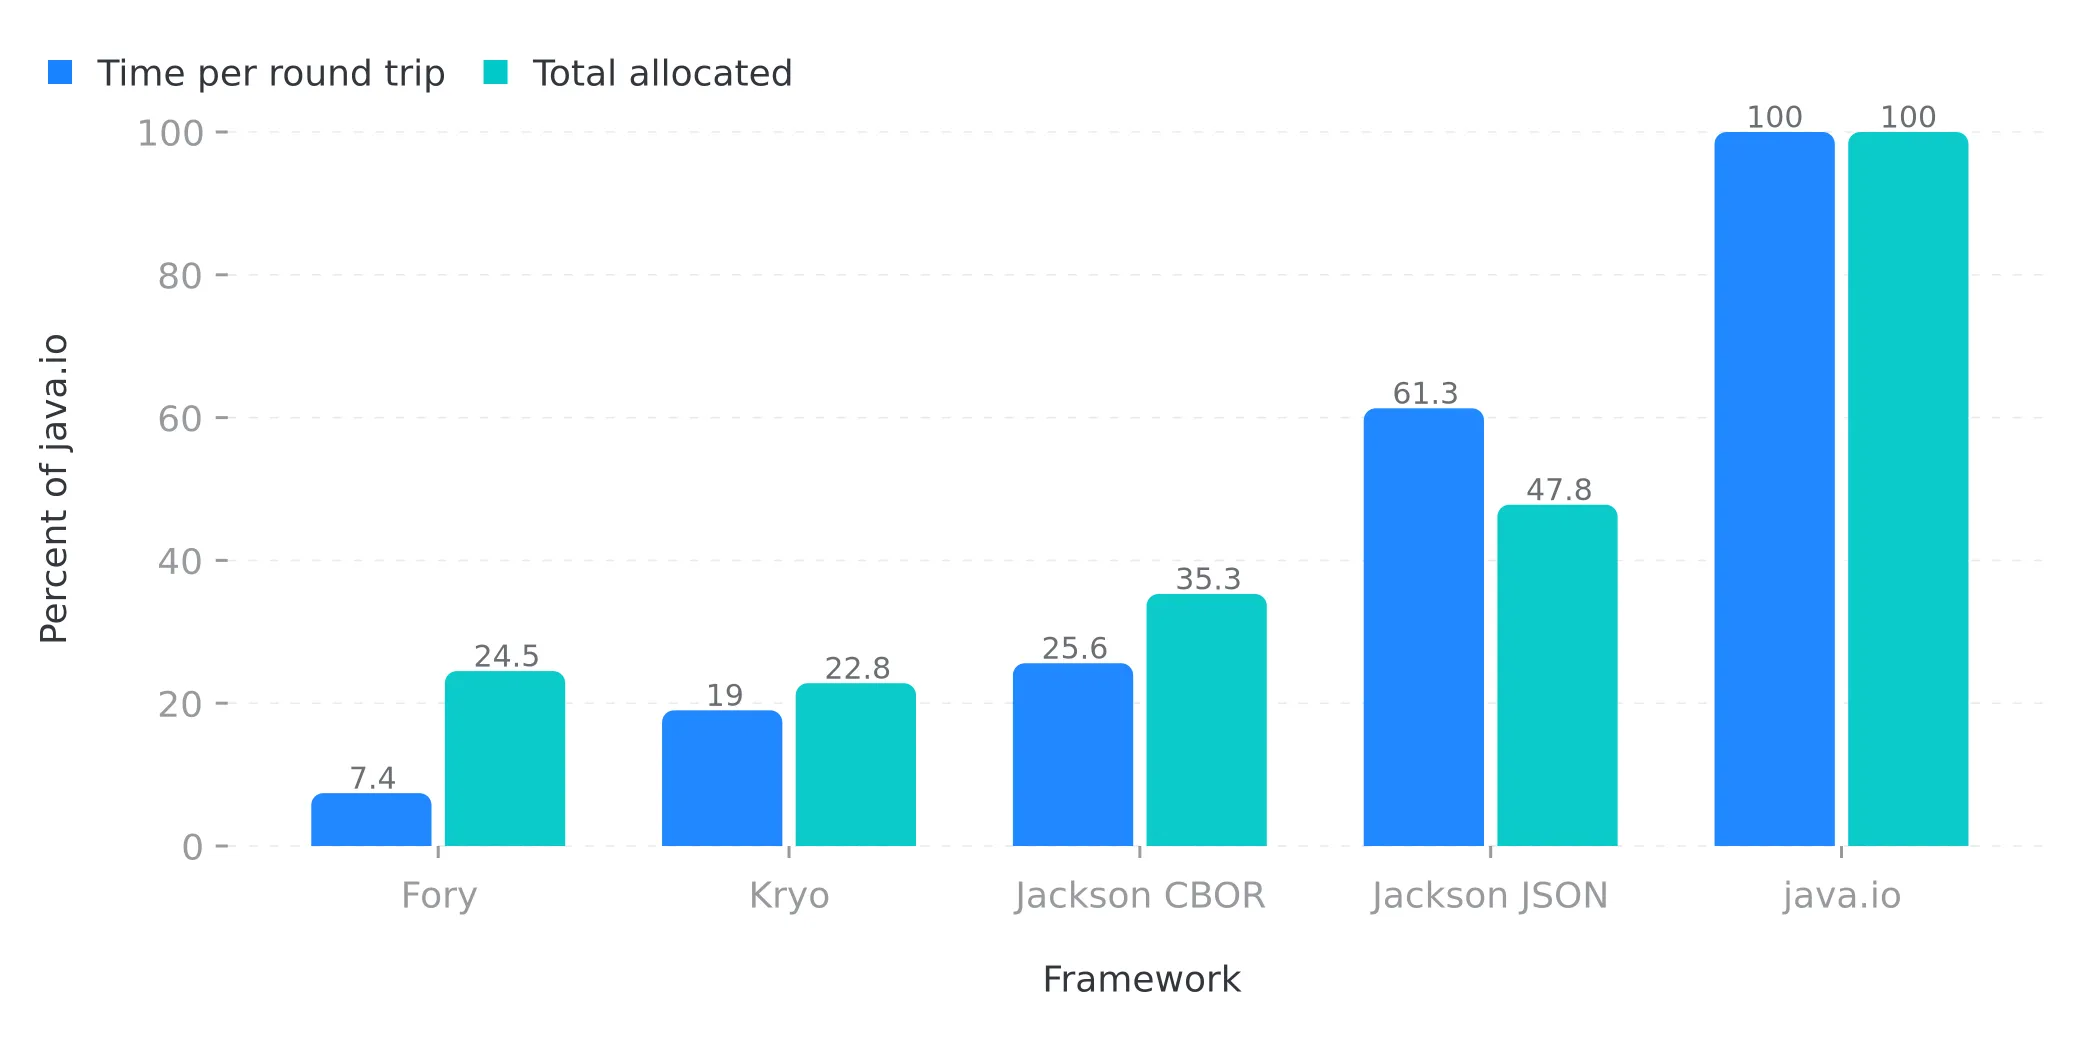
JavaシリアライズはForyの13倍遅く、メモリのアロケーションは4倍に達します。これは公表されているベンチマーク結果とも一致しています。このチャートからは、2つの列に相関があることも読み取れます。Kryoのラウンドトリップ時間はアロケーション量にほぼ比例しています。Jackson JSONは、多くのテキストを解析してより多くのCPUを消費するため、アロケーションの割合から予想されるより遅くなっています。Foryはこの相関を大きく上回っており、時間は7%なのに対しアロケーションは25%です。この点については後述します。まずは、時間が実際にどこへ費やされているのかを見ていきましょう。
Javaシリアライズが遅い理由
興味深いことに、Javaシリアライズは読み取りと書き込みの間で非常に非対称です。CPU時間の73%がdeserializeに費やされ、serializeに費やされるのはわずか26%です。
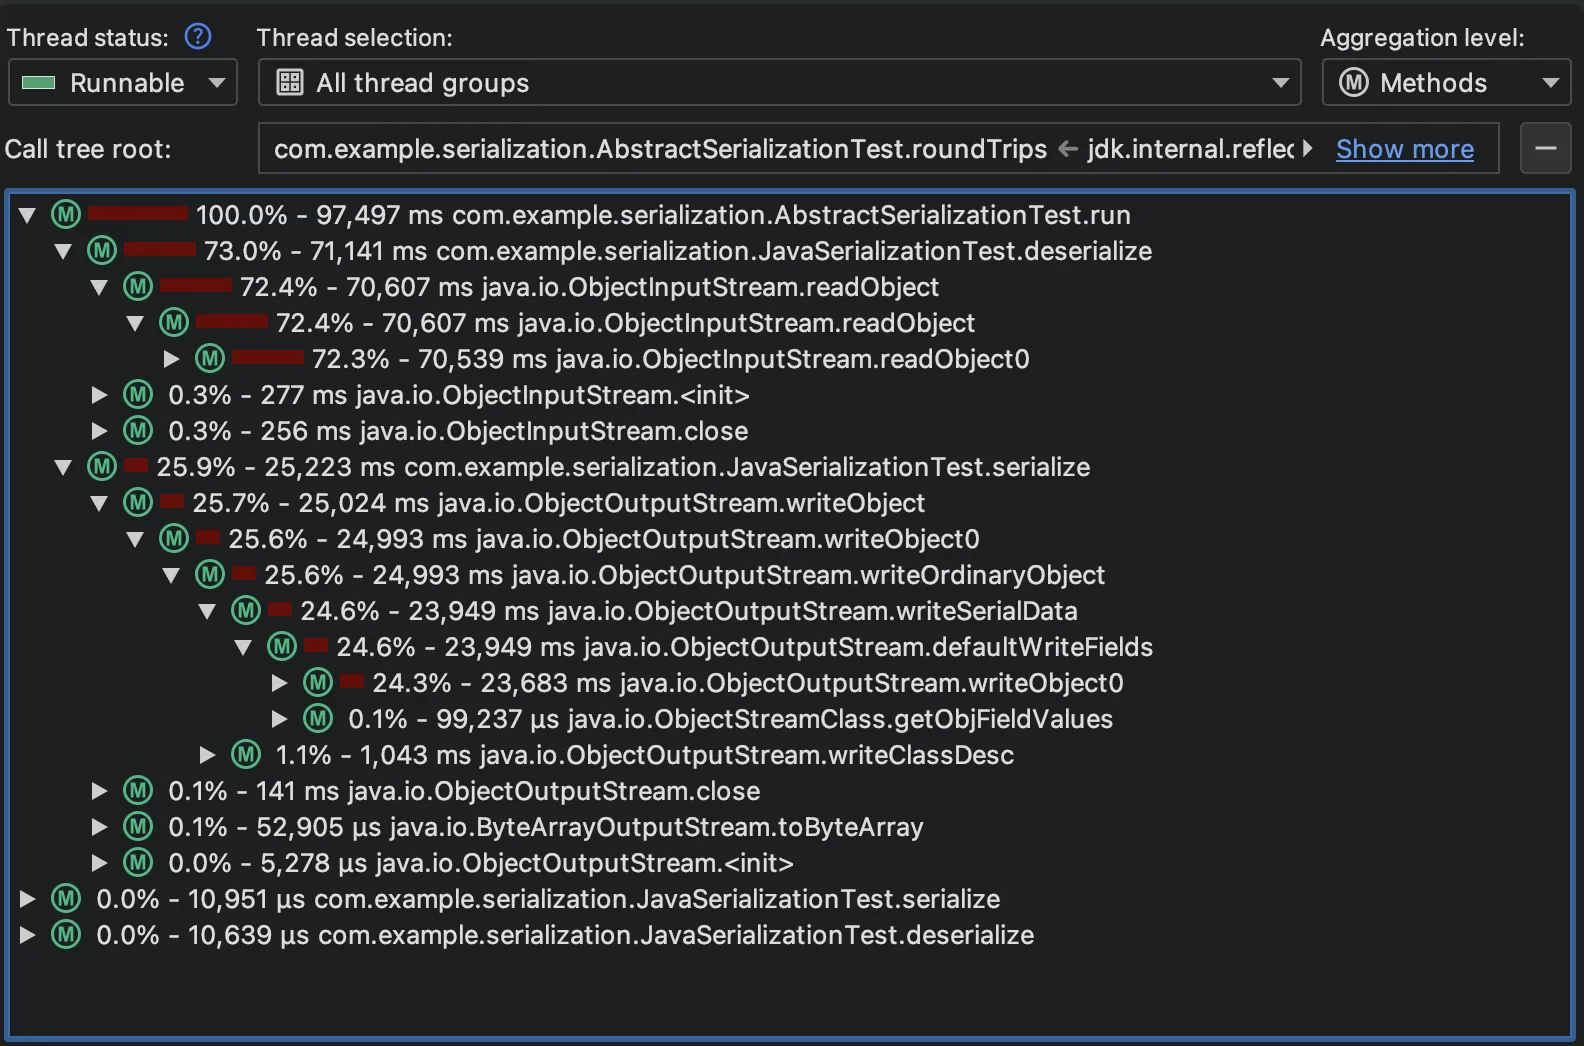
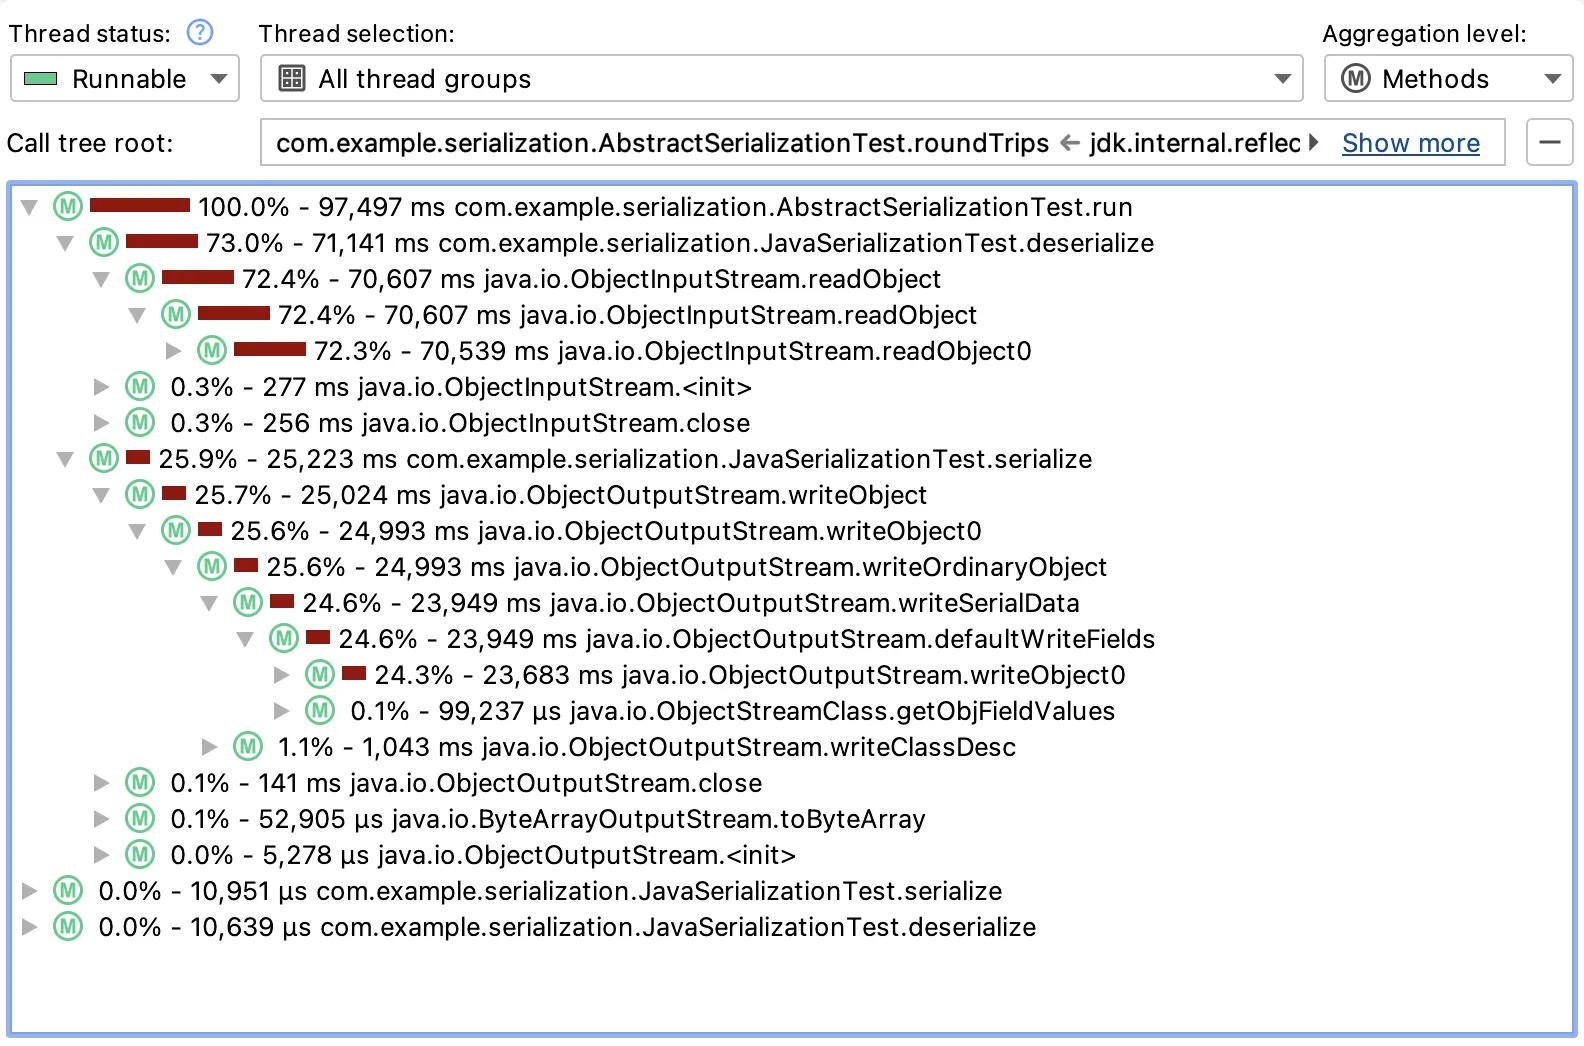
実行の主なホットスポットからは、時間が何に費やされているかがわかります。
jdk.internal.misc.VM.latestUserDefinedLoader0(18%):ストリーム内のクラス記述子ごとに、JDKがネイティブコードでコールスタックを辿り、そのクラスを解決すべきクラスローダーを見つけ出します。Class.forName0(8%)とString.intern(6%):クラスの解決と、ストリームの型記述子に含まれるフィールド名のインターンです。クラスローダーの検出と合わせると、実行全体の約3分の1が「このクラスは何で、どんなフィールドを持っているのか」という問いに答えることに費やされています。ObjectInputStream$PeekInputStream.readFully(13%):バイトの移動です。ObjectOutputStream$HandleTable.lookup(5%):共有参照の追跡です。BlockDataInputStream.readUTFSpanとreadUTFBody(合計8%):ストリーム形式に含まれる多数の小さなUTF文字列の解析です。
アロケーションデータは、同じ状況をメモリの側から示しています。200万回のラウンドトリップの間に、Javaシリアライズの実行がアロケーションしたのは次のとおりです。
ObjectStreamClassインスタンス800万個(844 MB)。クラス記述子はJDKによってソフト参照でキャッシュされているため、アロケーション圧力の中でガベージコレクタが多くのエントリを破棄したようです。- メタデータとフィールド値の格納のための
ObjectStreamFieldインスタンス1,000万個と、FieldValuesインスタンス1,060万個。 StringBuilderインスタンス2,600万個。その大半は記述子の解析によるものです。
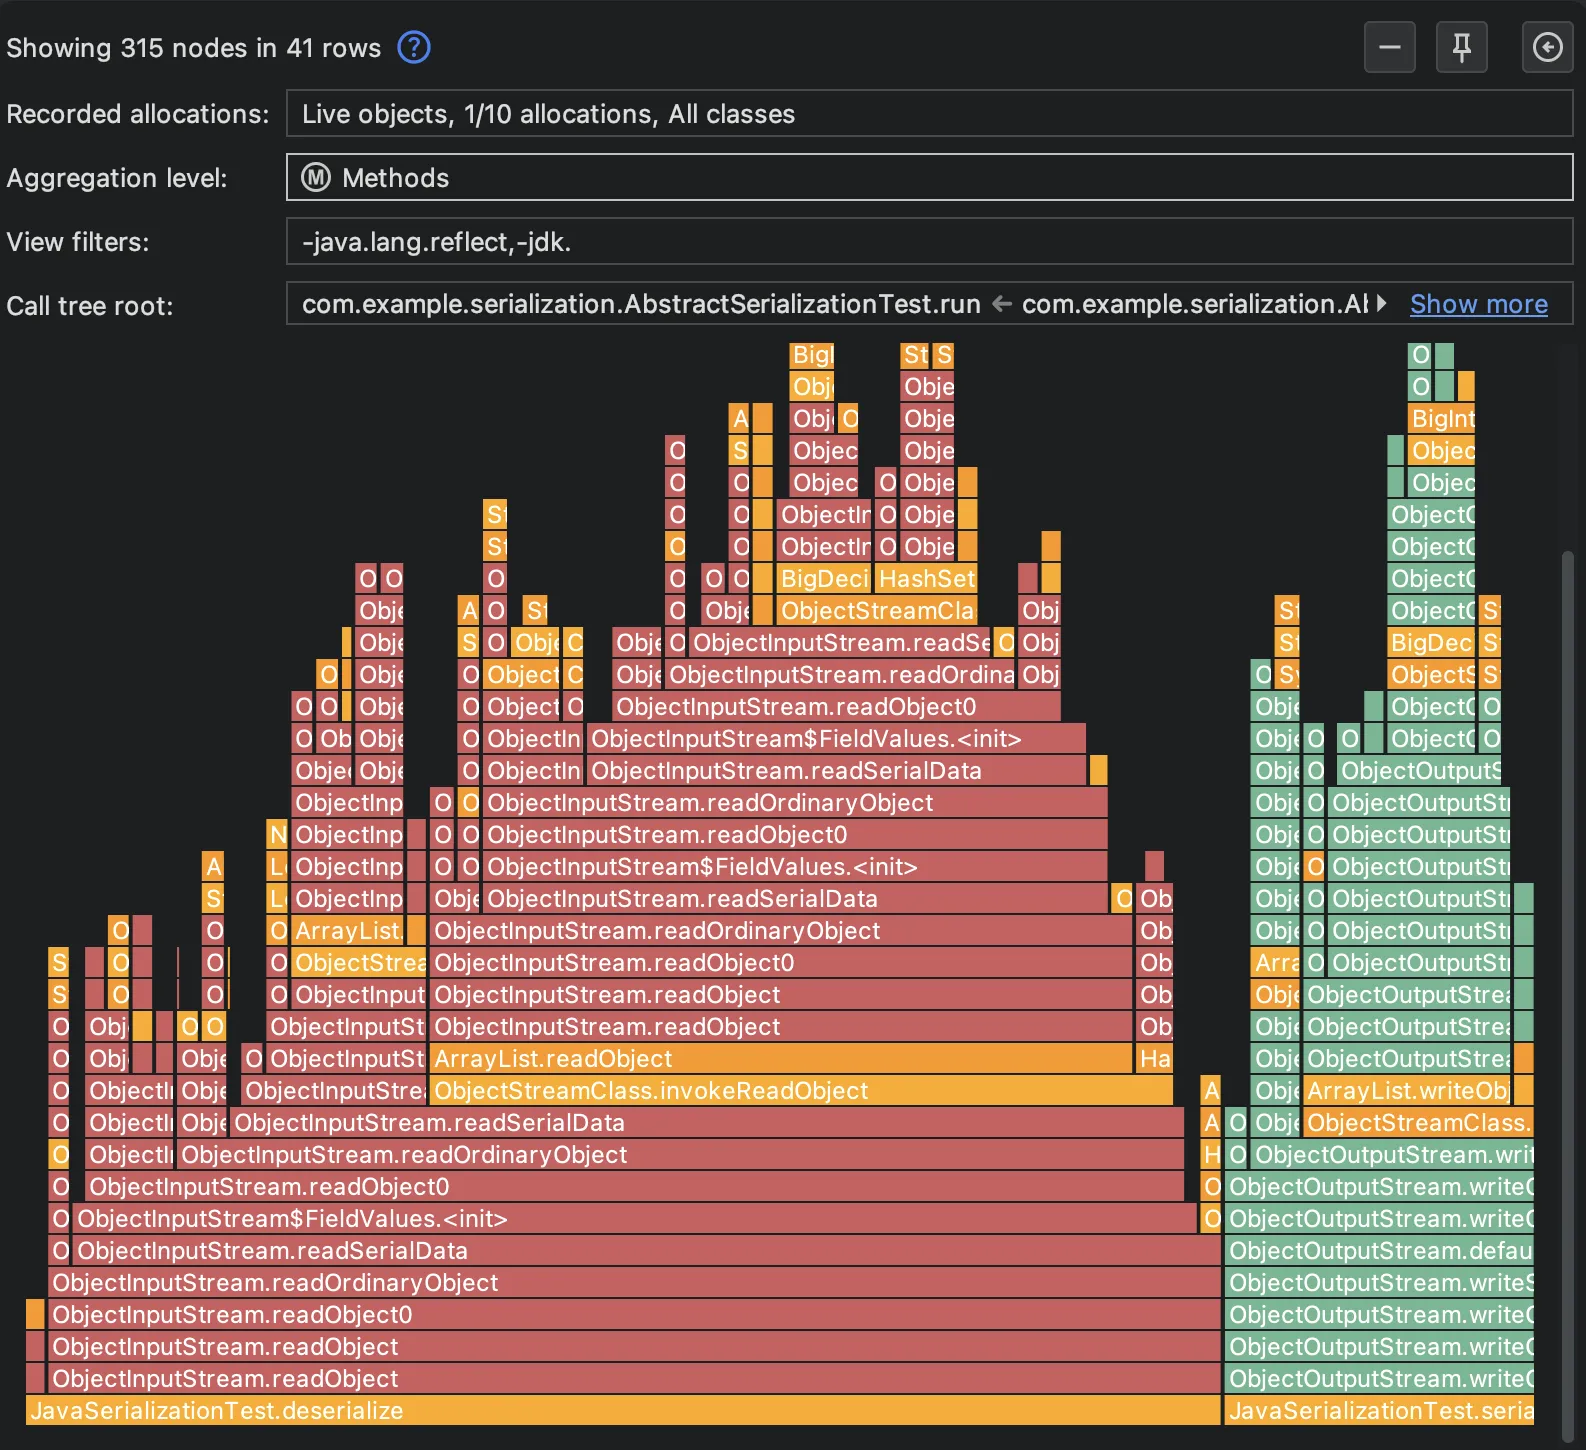
この処理の大半は、シリアライズ対象のデータとは無関係です。フォーマット自体の管理処理、つまり型記述子、フィールドのメタデータ、オブジェクト参照を追跡するIDテーブルの処理にすぎません。ラウンドトリップごとに新しいObjectInputStreamを作成するのはAPIの標準的な使い方であり、そのたびにクラス記述子が再解決されます。
ForyとKryoが高速な理由
ForyとKryoは、そうした管理処理を完全に省いています。解析すべき型記述子はなく、読み取り時に解決すべきクラスもなく、リフレクションもありません(少なくともホットパスでは)。プロファイリングデータに残っているのは、結果を実際に組み立てる作業がほとんどです。
Foryのスナップショットでは、3分の1を超える時間が、Foryが実行時に生成するシリアライザクラスそのものに直接費やされており、ProductForyRefCodecCompatible4_0.readFields$のようなメソッドとして現れています。さらに14%は、デシリアライズされた注文の属性マップを再構築する際のHashMap.putValに、6%はVarHandlesを通じたフィールド設定に費やされています。プロファイリングデータが示しているのは、Foryが本質的に行っていることの大部分は、オブジェクトへのバイトの書き込みだということです。
Kryoのプロファイリングデータは様子が異なります。27%がreadObjectメソッドとwriteObjectOrNullメソッド、23%が文字列の読み書き、12%が参照を追跡するIDマップ、7%がFieldSerializer、5%がクラス名の書き込みに費やされています。Kryoが高速なのは、Javaシリアライズのように記述子を管理していないためですが、それでもオブジェクトごと、フィールドごとのディスパッチという独自のレイヤーを持っています。
Foryがこれほど高速な理由
本当に興味深いのは、Kryoがすべてのフレームワークの中で最もアロケーション量が少ないにもかかわらず、Foryの2.5倍遅いという点です。もちろんアロケーションはバイト数だけを数えるものであり、1バイトあたりに費やされる命令数は数えていません。
Kryoのシリアライズは、いわばインタプリタループのようなものです。オブジェクトごとにシリアライザを検索し、フィールドごとにFieldSerializerを通じてディスパッチし、クラス名ごとにストリームへ文字列を書き込みます。これらのディスパッチメソッドはどれも単独ではボトルネックではありませんが、合計すると実行全体の40%を超え、データ処理とバイト書き込みの間に割り込んでいます。
Foryの生成コーデックには、こうしたレイヤーはありません。Foryが実行時にコンパイルするクラスは、読み書きの固定シーケンスそのものです。バッファアクセスはバイト単位の読み出しではなく一括メモリ操作を通じて行われ、フィールドアクセスはVarHandlesを通じて行われます。ホットスポットビューはこれをはっきりと示しています。最上位のエントリは属性マップの再構築によるHashMap.putValで、その下の順位は生成されたForyRefCodecクラスが占めています。
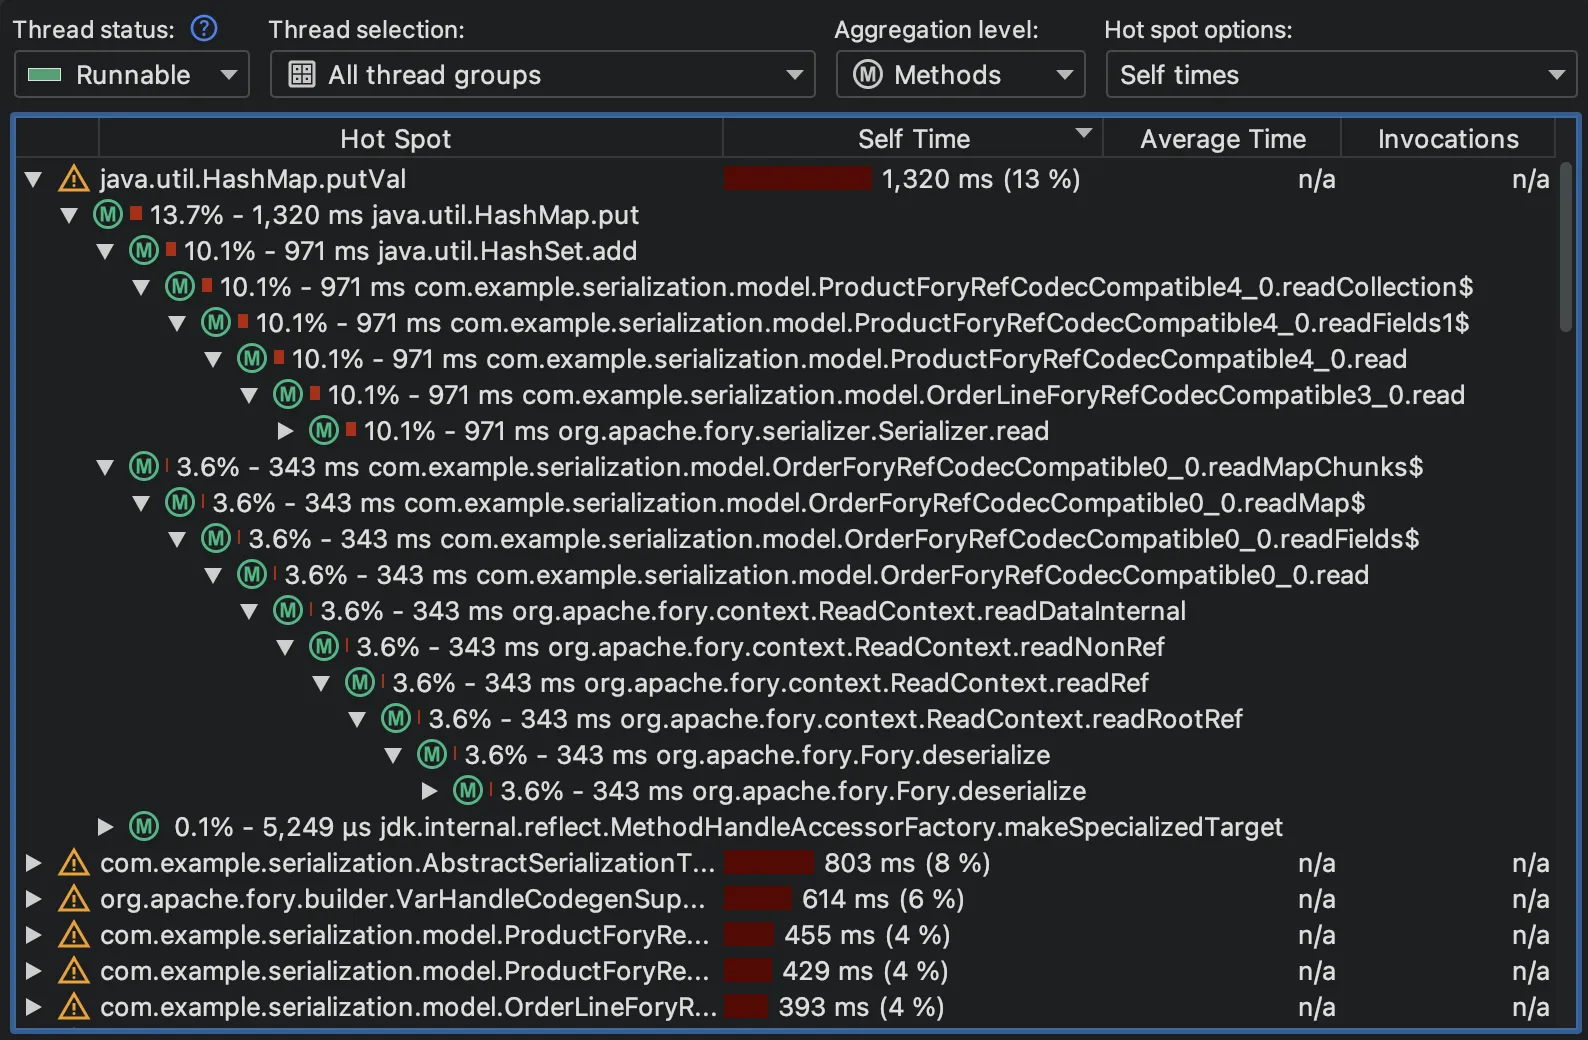
つまり、ここでの主要な結論は、Foryを他のフレームワークとは一線を画す存在にしているのはコード生成だということです。
Jacksonにおける異なるトレードオフ
Jacksonは最も広く使われているシリアライズフレームワークですが、そのセリングポイントは速度だけではありません。JacksonはクラスをJSONへ変換する際のデフォルトの定番ソリューションであり、その目的のために多くの機能を備えています。
JSONのようなテキスト形式は、コストの高い機能です。byte[]のサムネイルをbase64でエンコードする処理が全体時間の24%を占め、デコードがさらに23%を占めます。つまり、実行時間のほぼ半分が、JSONにバイナリ型がないという事実そのものに費やされているのです。さらに、リフレクションによるメソッド呼び出しが13%を加算します。
ただし、Jacksonにはバイナリのバックエンドもあり、たとえばCBORMapperを使えば切り替えは非常に簡単です。このサンプルワークロードでは、CBORはJSONの2.4倍高速で、Foryにほぼ匹敵するコンパクトなペイロードを生成します。プロファイリングデータは、フォーマットがもはや問題ではなくなったことを裏付けています。CBORのパーサとジェネレータを合わせると時間の約4分の1を占めるのに対し、リフレクションベースのデータバインディング層が約40%を占めるようになっています。データバインディング層が依然として存在することが、Foryの約3.4倍遅い原因です。
フレームワークの選択
- 純粋な速度を求めるなら、この比較で大差をつけて勝つのはForyです。多くの他の言語向けの実装もあり、スキーマ変更に耐えられる型互換モードも備えているため、複数言語が混在するシステムや、長期間保存されるデータに適しています。
- Kryoは、キャッシュエントリのようなペイロードや、信頼できるサービス間のRPCには、依然として現実的な選択肢です。成熟しており依存関係のフットプリントも最小限ですが、このサンプルワークロードではForyの2.5倍遅くなります。
- 人や他のツールが読む必要のあるデータには、JSONのJacksonが現実的なデフォルトです。通信パイプラインの両端を自分で管理できるのであれば、1行の変更でCBORバックエンドに切り替えられます。
- Javaシリアライズは、既存システムとの互換性のためだけのものです。
プロファイリングの方法
この記事の内容はすべてコマンドラインから生成しました。スナップショットは、オフラインモードのJProfiler Gradleプラグインによって、フレームワークごとに1つのタスクを使用して記録しました。
tasks.create<com.jprofiler.gradle.TestProfile>("profileFory") {
    useJUnitPlatform()
    filter { includeTestsMatching("com.example.serialization.ForySerializationTest") }
    offline = true
    callTreeMode = CallTreeMode.SAMPLING
    profile = listOf("com.", "org.", "java.", "javax.", "jdk.", "sun.")
    recording = listOf("cpu") // or listOf("allocation")
    snapshotFile = file("build/snapshots-cpu/fory.jps")
}
重要な注意点が1つあります。CPUとアロケーションのデータを同時に測定するのは得策ではありません。アロケーション記録は10個に1個の割合でオブジェクトをサンプリングするため、アロケーションの絶対値はその分過小評価されますが、フレームワーク間の比率は影響を受けません。ただし、このサンプリング比率であっても、アロケーション記録は依然としてコストが高く、測定されるCPU時間に歪みをもたらします。
分析そのものは、JProfiler MCPサーバーを操作するコーディングエージェントが実行しました。
自分で試す
完全なプロジェクトはGitHubにあります。スナップショットを自分で見るには、JProfilerをダウンロードし、build/snapshots-cpuとbuild/snapshots-allocationにある.jpsファイルを開いてください。