

JProfiler がヒープダンプを AI エージェントにとって有用なものにする
JProfiler 16.3 では、MCP サーバーを通じて、JProfiler の主要なすべてのサブシステムを AI エージェントから利用できるようになりました。その中で最も有用な追加機能のひとつがヒープダンプ分析です。エージェントはヒープ内のオブジェクトを調べ、その参照をたどり、ガベージコレクションされなかった理由を突き止められるようになりました。
ランタイムデータがなければ、AI エージェントはどのオブジェクトが生存しているのか、何がそれらを到達可能な状態に保っているのかを知ることができません。JProfiler がそのギャップを埋めることで、エージェントは実際の証拠から分析を始め、それを手がかりに関連するソースコードを見つけられるようになります。
実際のサポート事例
16.3 のリリース直後、弊社のもうひとつの製品である install4j について、アップデートチェック中のメモリリークを報告するサポートチケットが届きました。顧客は、JVM がメモリを使い果たした時点で書き出された HPROF ヒープダンプを添付していました。弊社はエージェントに問題の調査と、可能であれば修正を依頼しました。このエージェントには、新しい JProfiler MCP サーバーを含む複数の MCP サーバーが用意されていました。
このアプリケーションは、install4j のアップデートダウンローダーをインプロセスで呼び出すことによって繰り返しアップデートチェックを行うバックグラウンドプロセスでした。最大ヒープサイズは 64 MB でした。最終的に、繰り返されるアップデートチェックが利用可能なメモリを使い果たし、アプリケーションは障害を起こしました。
よくあることですが、修正自体は小さなものでしたが、見つけるのは容易ではありませんでした。今回の調査は、ランタイムデータを使ってソースコードの調査を導く教科書的な事例です。この経緯は 5 つのステップで語ることができます。
技術的な詳細
エージェントが必要とした MCP ツールは、load_snapshot、check_status、query の 3 つだけでした。最初の 2 つはスナップショットをロードし、利用可能なデータセットを報告します。query ツールは、プロファイリングデータを扱うためのローコードモードを提供します。各データセットは JSON として表現されます。エージェントは、JSON 用のクエリ言語である jq の式を指定して、必要なデータを選択し、コンパクトな結果へと変換します。フィルタリング、ソート、射影は JProfiler 側で行われるため、エージェントにはこの結果だけが返されます。
ヒープダンプのロード
load_snapshot は、JProfiler スナップショット、HPROF ヒープダンプ、JFR レコーディングを受け付けます。スナップショットのロードは非同期で行われます。エージェントは check_status を呼び出して、データの準備ができたかどうか、どのデータセットと操作が利用可能かを確認します。
HPROF ヒープダンプは、アプリケーションの実行中にプロファイリングエージェントを必要としないため、特に有用です。jcmd を使って実行中の HotSpot JVM からヒープダンプを生成したり、アプリケーションのコマンドラインに -XX:+HeapDumpOnOutOfMemoryError VM 引数を追加して、OutOfMemoryError 発生時に自動的に書き出させたりすることができます。
この HPROF ファイルのカタログには、クラスヒストグラム、最大オブジェクト、インスタンス、サイズ、インスペクションといったヒープデータセットが含まれていました。ダンプには合計 63 MiB の 1,385,451 個のオブジェクトが含まれていました。プレーンな HPROF ファイルにはアロケーションのスタックトレースやパフォーマンスの記録は含まれないため、分析はダンプに記録されたオブジェクトグラフから始める必要がありました。
繰り返されるインストーラー実行の発見
エージェントはまず heap.classes データセットを、com.install4j パッケージにフィルタリングして調べました。初期の結果とそれに続くヒープ全体へのクエリにより、インストーラーの UI オブジェクトと設定オブジェクトが驚くほど蓄積していることがわかりました。
| クラス | インスタンス数 |
|---|---|
InstallerWizardScreenExecutor |
34 |
InstallerContextImpl |
34 |
DeferredDocumentImpl |
34 |
FormPanel |
198 |
ActionBeanConfig |
2,686 |
一致したインスタンス数から、これらのオブジェクトが繰り返されるインストーラー実行に由来するものであることがわかりました。インプロセスでの起動ごとに、エグゼキューター、インストーラーコンテキスト、解析済みの設定ドキュメントが生成されます。残っているべきは現在の起動のオブジェクトだけです。しかし実際には、34 回分の完全なインストーラー実行がまだ保持されていました。
heap.biggestObjects データセットがもうひとつの手がかりを与えてくれました。多くのインストーラーコンテキストの保持サイズが、ちょうど 74,800 バイトだったのです。このような同一の保持サイズは、同じオブジェクトグラフのコピーが繰り返されていることを示すことがよくあります。さらに、解析された 34 個の XML ドキュメントのそれぞれが 700〜750 KB を保持していました。
GC ルートへのパスをたどる
疑わしいオブジェクトを見つけることは、ほんの第一歩にすぎません。次の疑問は、それらがなぜまだ到達可能なのかです。エージェントは heap.instances で InstallerContextImpl のインスタンスを選択し、jq 式の中で pathToRoot ビルトインを呼び出しました。
query({
  dataset: "heap.instances",
  class: "com.install4j.runtime.installer.InstallerContextImpl",
  expression: `
    .instances[0]
    | {
        id,
        keptAliveBy:
          pathToRoot(.id).paths[0].path
          | map({class, via, root})
      }
  `
})
返されたパスには、リークの連鎖全体が含まれていました。
LookAndFeelChangeUtil.lookAndFeelChangeHandlers (static)
  → WeakHashMap entry value
  → look-and-feel handler registration
  → captured lambda
  → WidgetStyleHandlerImpl
  → FormEnvironmentImpl
  → FormPanel
  → InstallerContextImpl
LookAndFeelChangeUtil の静的フィールドがこのマップを保持していました。マップの値はハンドラーの登録であり、そのラムダはフォーム環境とインストーラーコンテキストを参照していました。arg$1 という名前の生成されたラムダフィールドは、キャプチャされた変数を特定できるため特に有用でした。この時点で、ヒープの証拠により、調査すべきソースコード上の構成要素が正確に特定されていました。
WeakHashMap がリークを防げなかった理由
他の解析済みドキュメントやトップレベルのエグゼキューターからのパスも、同じ静的マップに行き着きました。さらに、referrersByClass が入力参照をクラスごとに集計しました。これにより、ルックアンドフィールの登録がこれらすべてのオブジェクトに共通する保持元であることが確認できました。
WeakHashMap のエントリーが削除されるのは、そのキーが強く到達可能でなくなったときだけです。このオブジェクトグラフでは、各エントリーの値が間接的にそのキー自身を参照していました。
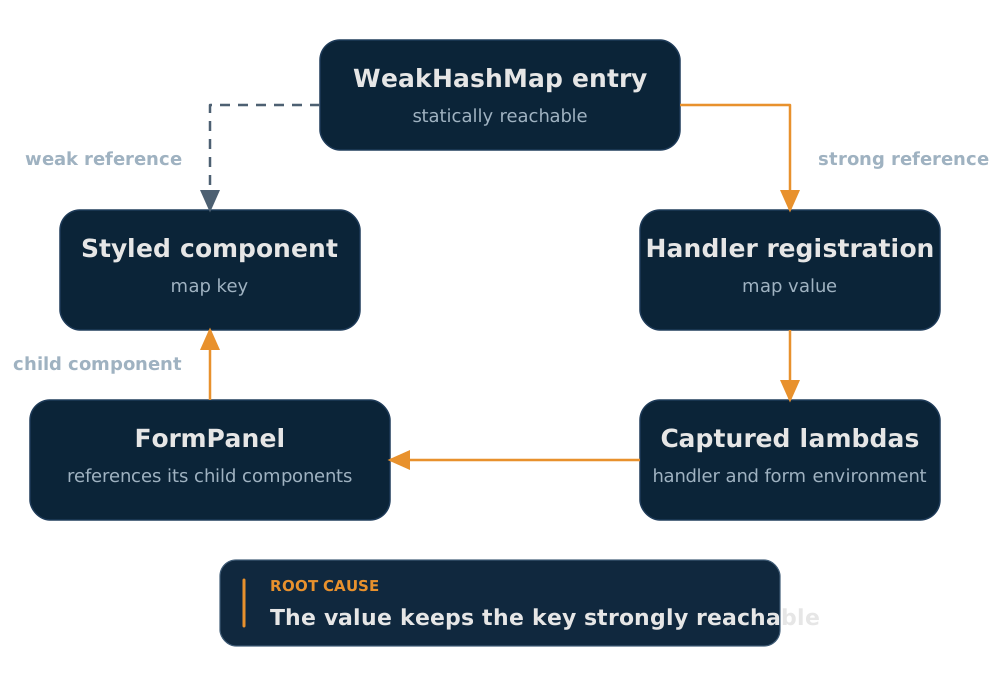
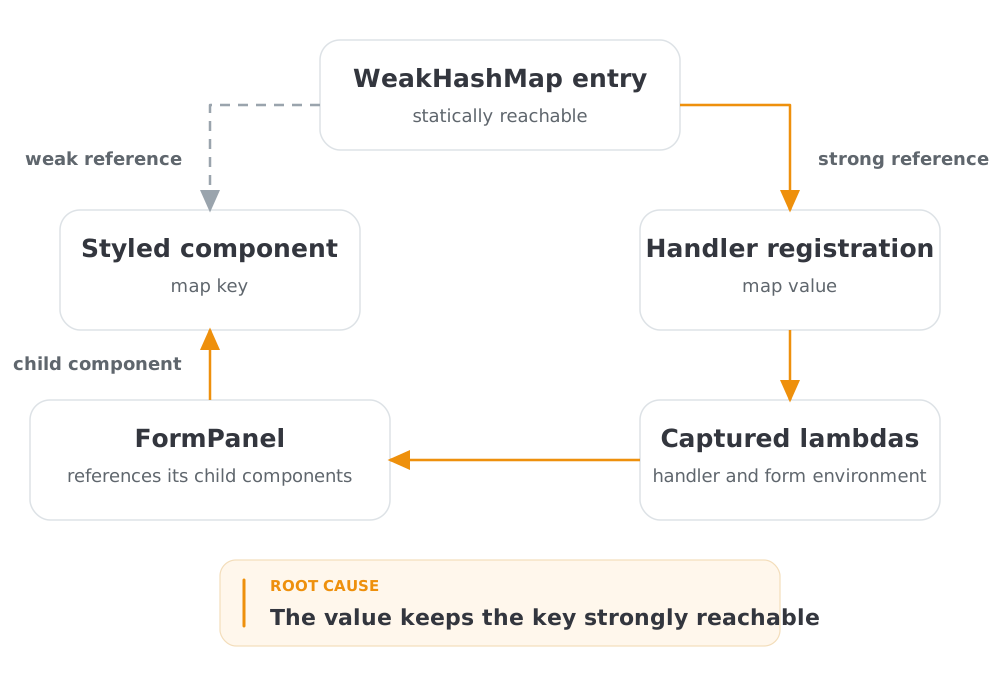
マップのキーはスタイルが適用された Swing コンポーネントで、マップの値はハンドラーの登録でした。登録の中でキャプチャされたラムダがフォームパネルを保持し、フォームパネルはさらに、マップのキーを含む子コンポーネントを保持していました。マップが静的フィールドによって保持されていたため、マップの値からマップのキーへと戻るこの強参照のパスにより、すべてのエントリーが削除されなくなっていました。
ソースコードを見ると、WidgetStyleHandlerImpl にこのキャプチャのパターンが現れていました。スタイリングのラムダが addStyleColor などのインスタンスメソッドを呼び出しており、これらのメソッドがハンドラーのインスタンスとそのフォーム環境をキャプチャしていました。
リークの修正
スタイル関連のヘルパーメソッドを static にしたことで、スタイリングのラムダはハンドラーをキャプチャしなくなりました。ハンドラーへの強参照がなくなったため、登録はフォームパネルもマップのキーも保持しなくなりました。
エージェントは、WeakReference を使ってルックアンドフィールの登録がハンドラーを保持しないことを検証するリグレッションテストを追加しました。このテストは元のコードでは失敗し、修正後には成功しました。テストスイート全体もすべて成功し、修正は完了しました。
エージェントはソースコードだけでもリークを見つけられたのか?
AI エージェントはソースコードを読み、パフォーマンス問題やリソースリークの原因になり得る異常を認識することが非常に得意です。しかし、コードベースがエージェントのコンテキストウィンドウよりも大きくなると、この手法は通用しなくなります。そのような場合、エージェントにはランタイムデータを調査できるツールが必要です。
今回のケースでは、アップデートチェックが疑わしい原因でした。しかし、アップデートチェックのソースコードを読んでも、実際のリークは見つからなかったはずです。リークは、インプロセスでの起動ごとに初期化されるウィジェットのスタイリングにありました。エージェントは保持されたオブジェクトとその参照チェーンを手がかりに、関連するソースコードを特定しました。
これこそが、AI エージェントにプロファイラーへのアクセスを与えることの主な利点です。プロファイラーはアプリケーションからの証拠を提供するため、エージェントは実際に問題を引き起こしたコードにソース分析を集中させることができます。
使い始めるには
AI エージェント向けのヒープダンプ分析は JProfiler 16.3 で利用可能です。エージェントにこの機能を与えるには、JProfiler agents ページにアクセスし、ターミナルで 1 行のコマンドを実行してください。