

Apache Fory JSON を 4.5 倍高速化した方法
最近、Java シリアライゼーションフレームワークの比較を行っています。バイナリペイロードについては、ウェブサイトで「blazingly-fast(圧倒的に速い)」をうたっており、実際にその通りである Apache Fory の大ファンになりました。比較では、JSON とバイナリペイロードを区別しています。JSON シリアライゼーションの王者は Jackson でした(Kotlin においても同様)。一方で、バイナリペイロードでは Apache Fory が支配的でした。
最近の Apache Fory 1.7.0 リリースでは、主要な新機能として JSON サポートが追加されました。当然、興味をそそられ、シリアライゼーションのデモに Fory JSON を追加しました。自分のペイロードでの数値を見たときは、にわかには信じられませんでした。Fory は実際に Jackson より 2.8 倍遅かったのです。何かがおかしい。そこで、根本原因を突き止めることにしました。
調査
ペイロードサイズは、すでに考えられる原因を示唆していました。Fory は 20,999 バイトのペイロードを書き出したのに対し、Jackson では 9,814 バイトでした。このペイロードにはバイト配列としてサムネイルが含まれていますが、Fory はそれを次のようにシリアライズしたのです。
"thumbnail":[-77,-1,99,-104,...]
これは極めて非効率です。1 バイトが最大 5 文字になり、ランダムなデータでは平均して 3.5 文字を超えます。書き込みには符号判定と 10 進変換が必要で、読み込みでは数字を走査して数値を再構築しなければなりません。さらに、この方式は RFC 7493、protobuf の JSON マッピング、Jackson、Gson、Moshi、kotlinx.serialization など、他のシリアライゼーションフレームワークとも相容れません。JSON にはバイナリ型が存在せず、base64 文字列が標準的な扱い方です。3 バイトごとに 4 文字を書き出します。
同じバイト列を base64 にすると、次のようになります。
"thumbnail":"s/9jmA==..."
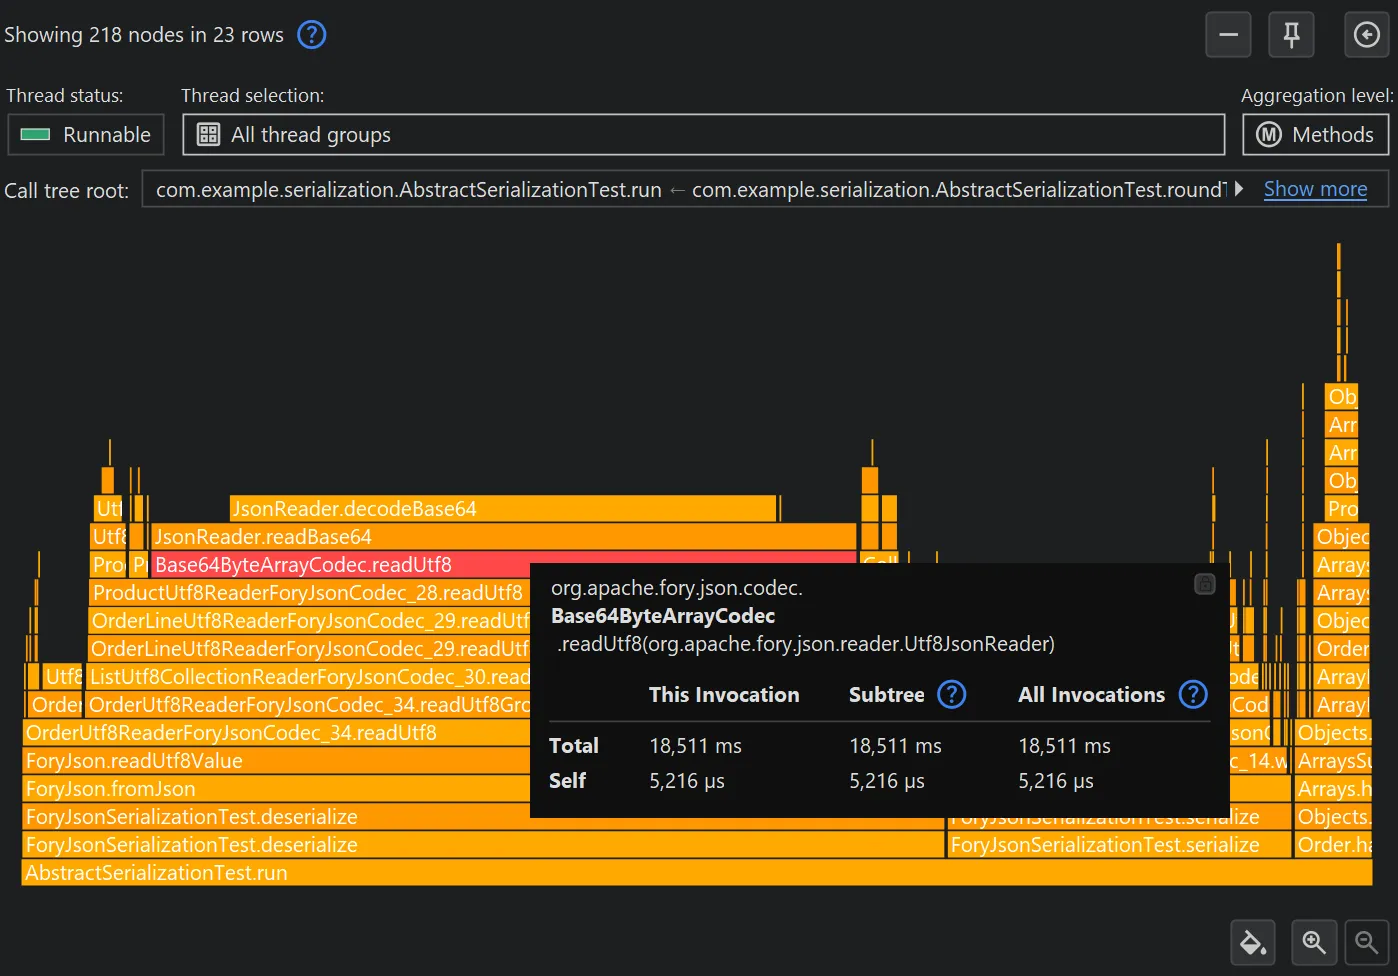
前回の比較では、base64 の処理が JSON エンジン間で最も差がついた箇所でした。Fory の新モジュールは、いわば同じ罠にはまり込んでいたのです。しかし、この非効率なエンコードこそが遅さの原因のすべてなのでしょうか。確かめる方法は一つ、プロファイリングです。データは明白で、バイト配列のデコードがコールツリーを支配していました。
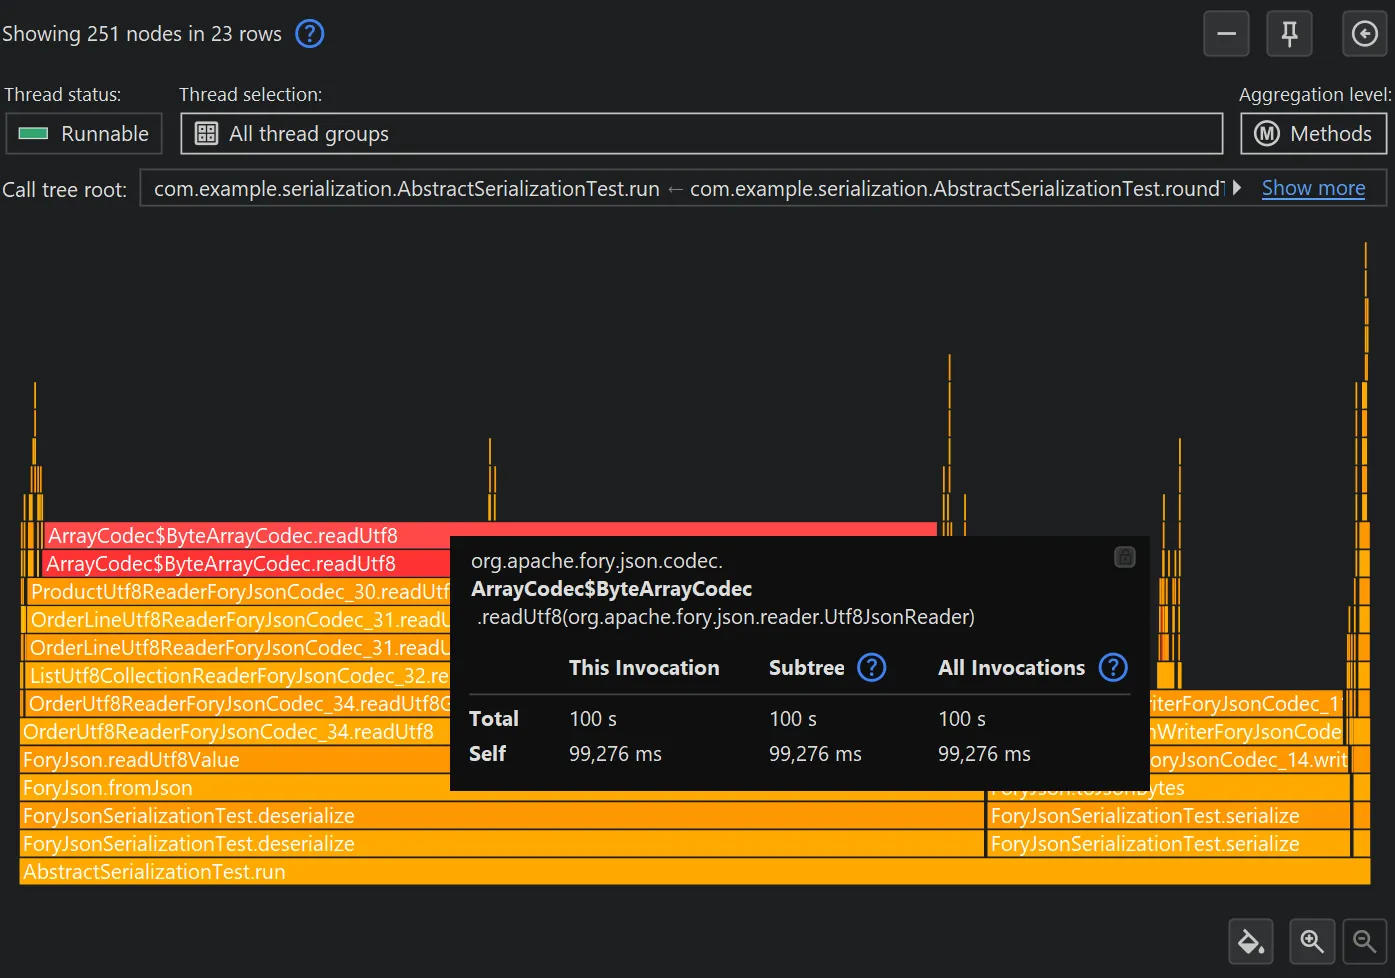
サムネイルを除けば、Fory JSON は同じラウンドトリップを 3.5 µs で実行しました。新モジュール自体は概ね良好で、問題は完全にバイト配列のデフォルトコーデックにありました。
調べてみると、Fory にはすでに Base64ByteArrayCodec が用意されていますが、これを使うには @JsonBase64 アノテーションが必要でした。まず取りかかったのは、byte[] のデフォルトコーデックを切り替えることです。ところが、その変更を行っても数値は依然としてひどく、改善は 16% にとどまりました。
次のプロファイリング実行で、改善がわずかにとどまった理由が明らかになりました。書き込みと読み込みが正反対の方向に動いたのです。base64 エンコーダーはテーブル駆動で出力バッファに直接書き込むため、10 進数の数字を書き出す場合の約 6 倍の速さがあります。一方、base64 デコーダーは 10 進数のパースよりもさらに遅いままでした。デコーダーは、文字列全体に対して分岐の多い検証スキャンを行い、続く第 2 パスでは、文字ごとのエスケープ処理と数字ごとの 4 方向分岐を伴いながらすべての文字を再読みしていました。シリアライズされた注文ごとに約 7 KB の base64 データがあるため、デコーダーだけで実行全体の 85% を占めていたのです。
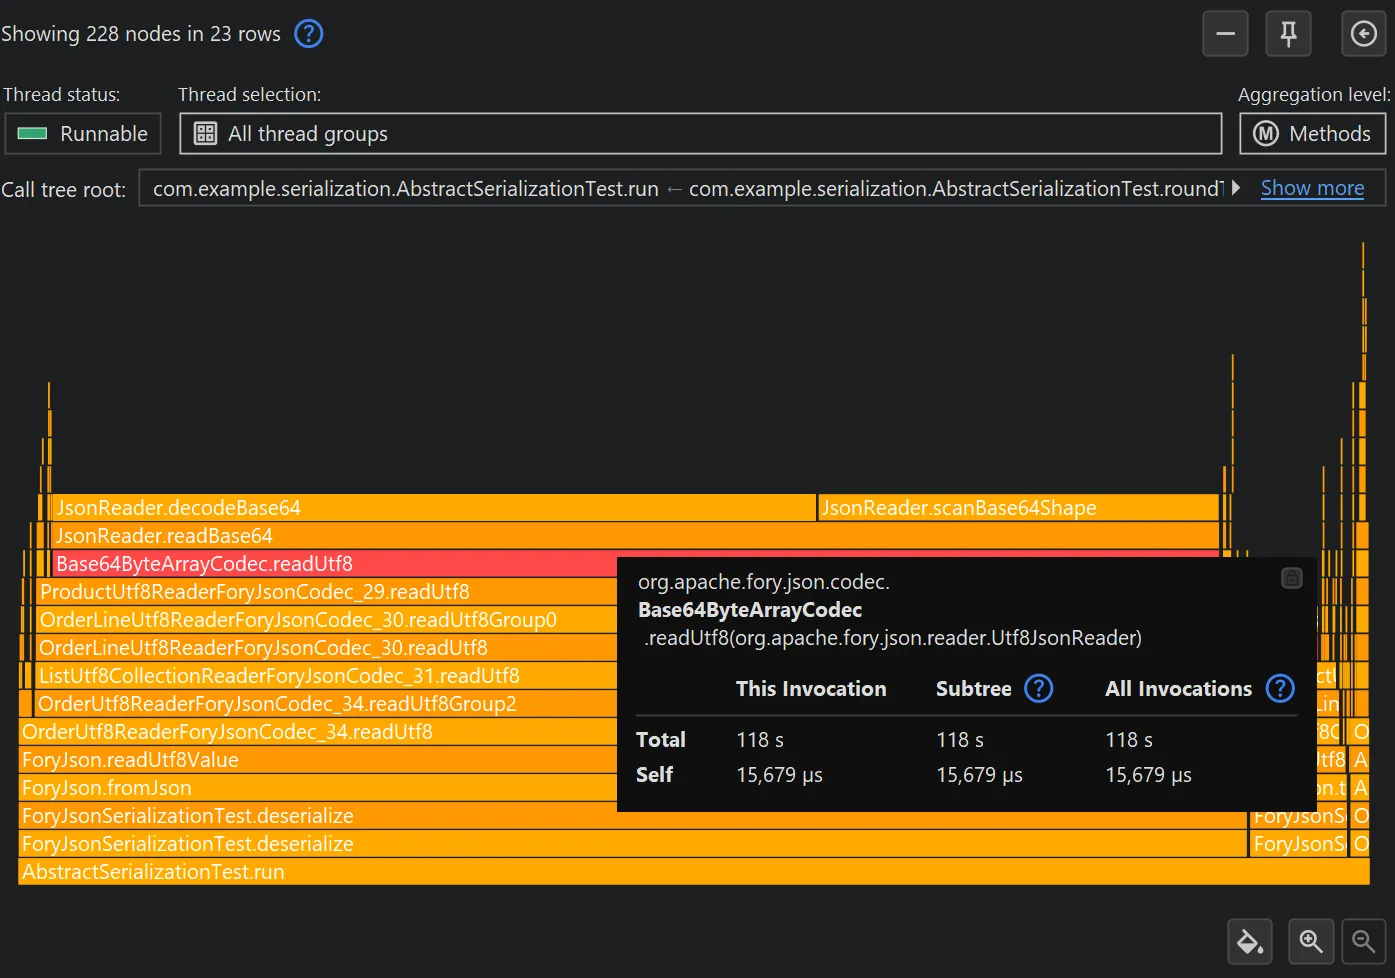
この修正にはもう少し手間がかかりました。検証は、各 ASCII 文字を対応する 6 ビット値にマッピングし、無効な文字には -1 を割り当てる 128 エントリのテーブルを使った単一のスキャンとして実行するようにしました。デコードのパスは、同じテーブルを通じて 1 回の反復ごとに 4 文字を消費して 3 バイトを生成します。分岐は一切ありません。JSON 文字列には Unicode エスケープシーケンスが正当に含まれ得るため、バックスラッシュを含む base64 本体は引き続き従来の検証パスにフォールバックします。ただし、エンコーダーは base64 文字をエスケープしないため、実際には常に高速パスが実行されます。
最終的に、Fory JSON の数値はラウンドトリップあたり 75.9 µs から 16.8 µs へと大幅に減少しました。
| バイト配列の処理 | ラウンドトリップあたりの時間 | ペイロードサイズ |
|---|---|---|
| 10 進数の数値配列(Fory 1.7.0) | 75.9 µs | 20,999 バイト |
| base64 デフォルト、元のデコーダー | 64.0 µs | 9,742 バイト |
| base64 デフォルト、テーブル駆動のデコーダー | 16.8 µs | 9,742 バイト |
最初の修正で 1.16 倍、次の修正で 3.8 倍の速度向上が得られ、合わせて 4.5 倍になりました。バイト配列の処理は最初の 2 つの状態では実行時間の約 90% を占め、修正後も 66% を占めていますが、それははるかに小さくなった総時間における 66% です。
このペイロードでは、Fory JSON は以前のように 2.8 倍遅いのではなく、今では Jackson よりも速くなっています。
| セットアップ | ラウンドトリップあたりの時間 |
|---|---|
| Fory JSON(修正後) | 16.8 µs |
| Jackson 3.2.2 | 25.7 µs |
| Jackson 2.22.1 | 27.0 µs |
Jackson 2 に対しては Fory JSON が 1.6 倍速く、Jackson 3 に対しては 1.5 倍速い結果となりました。
つまり、予想に反して、base64 をデフォルトにしたことで正しさと相互運用性、そして 2.2 倍小さなペイロードは得られましたが、速度はあまり向上しませんでした。決定的な差をもたらしたのは、改善した base64 デコーダーでした。
修正の提供
この物語の英雄は Fory のメンテナーたちです。彼らは数時間のうちに私の PR をレビューし、古い 10 進形式をオプトインで利用できるまま保つ @JsonByteArray 形式アノテーションで API を改良し、最終的に翌日には main ブランチへマージしてくれました。
Fory は、データをシリアライズするのと同じスピードで開発されているようです。素晴らしい!そしてこの話の教訓とは何でしょうか。高速なライブラリの新モジュールには、最適化されていない隅が潜んでいることがあります。プロファイラーなら、それを数分で見つけ出せます。
測定方法
測定のセットアップはこれまでの記事と同じです。JProfiler Gradle プラグインがオフラインモードでセットアップごとに 1 つのスナップショットを記録し、CPU サンプリングとアロケーション記録はそれぞれ別の実行で行いました。ホットスポット解析では、コーディングエージェントが JProfiler MCP サーバーを操作しました。プロジェクト一式は GitHub で公開されています。
スナップショットをご自身で確認するには、JProfiler をダウンロードし、build/snapshots-cpu の .jps ファイルを開いてください。