

Java vs. Kotlin: どちらが(デ)シリアライズをより高速に行えるのか?
前回の記事では、Javaのシリアライズフレームワークをプロファイリングし、Apache ForyがJavaシリアライズおよび他の競合を大きく引き離していることを確認しました。これを受けて、Kotlinのフレームワーク同士を比較するとどうなるのかという問いに関心が集まりました。Kotlinエコシステムには独自のシリアライズライブラリがあり、とりわけコンパイル時コード生成を行うJetBrains公式ライブラリのkotlinx.serializationと、KSPベースのアダプタ生成を行うMoshiが有名です。生成されたコードなら、Jacksonのようなリフレクション中心のJava陣営を確実に上回るのではないでしょうか?
それを確かめるために、比較プロジェクトに同等のKotlinデータモデルを追加し、JProfilerでラウンドトリップをプロファイリングしました。その答えは、モデルクラスの言語はそれほど大きな影響を与えないというものです。ただし、実に驚くべき発見もいくつかあります。
計測結果
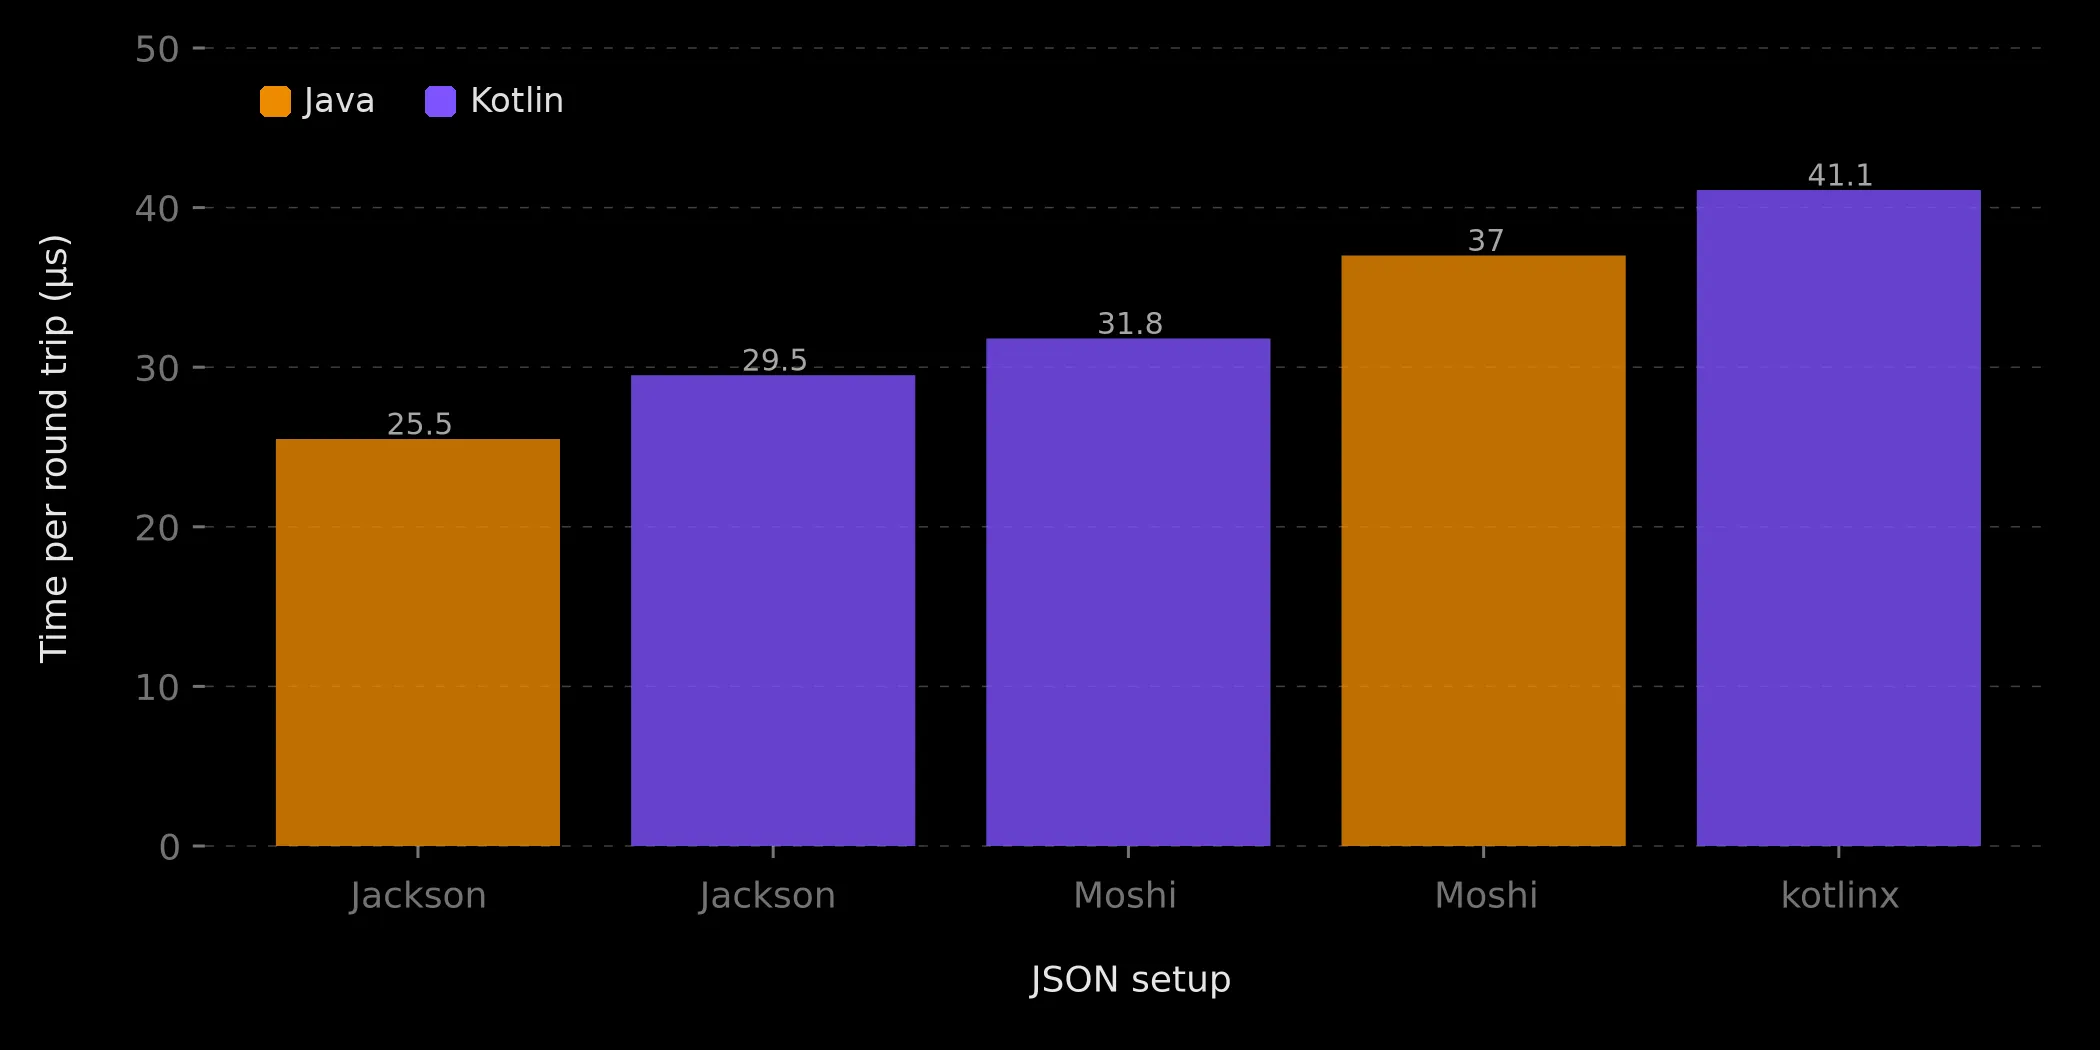
ペイロードは前回と同じです。共有参照、コレクション、マップ、列挙型、BigDecimal、バイト配列を含む現実的なオブジェクトグラフを用い、JDK 25上で200万回のシリアライズ/デシリアライズのラウンドトリップを実行します。KotlinライブラリはKotlinデータクラスを対象とし、Jackson Kotlinの行にはjackson-module-kotlinを追加し、Javaの行は同等のJava Beanモデルを使用します。まずはJSONのセットアップからです:
| セットアップ | 言語 | 1ラウンドトリップあたりの時間 | ペイロードサイズ | コメント |
|---|---|---|---|---|
| Jackson JSON | Java | 25.5 µs | 9,814バイト | 最速のJSONエンジン |
| Jackson JSON | Kotlin | 29.5 µs | 9,814バイト | Kotlinのコンストラクタバインディングによる16%のオーバーヘッド |
| Moshi JSON | Kotlin | 31.8 µs | 9,760バイト | KSP生成のアダプタ |
| Moshi JSON | Java | 37.0 µs | 9,760バイト | リフレクションベースのアダプタ |
| kotlinx JSON | Kotlin | 41.1 µs | 9,769バイト | フォーマット非依存のプロトコル |
次に、バイナリフォーマットです:
| セットアップ | 言語 | 1ラウンドトリップあたりの時間 | ペイロードサイズ | コメント |
|---|---|---|---|---|
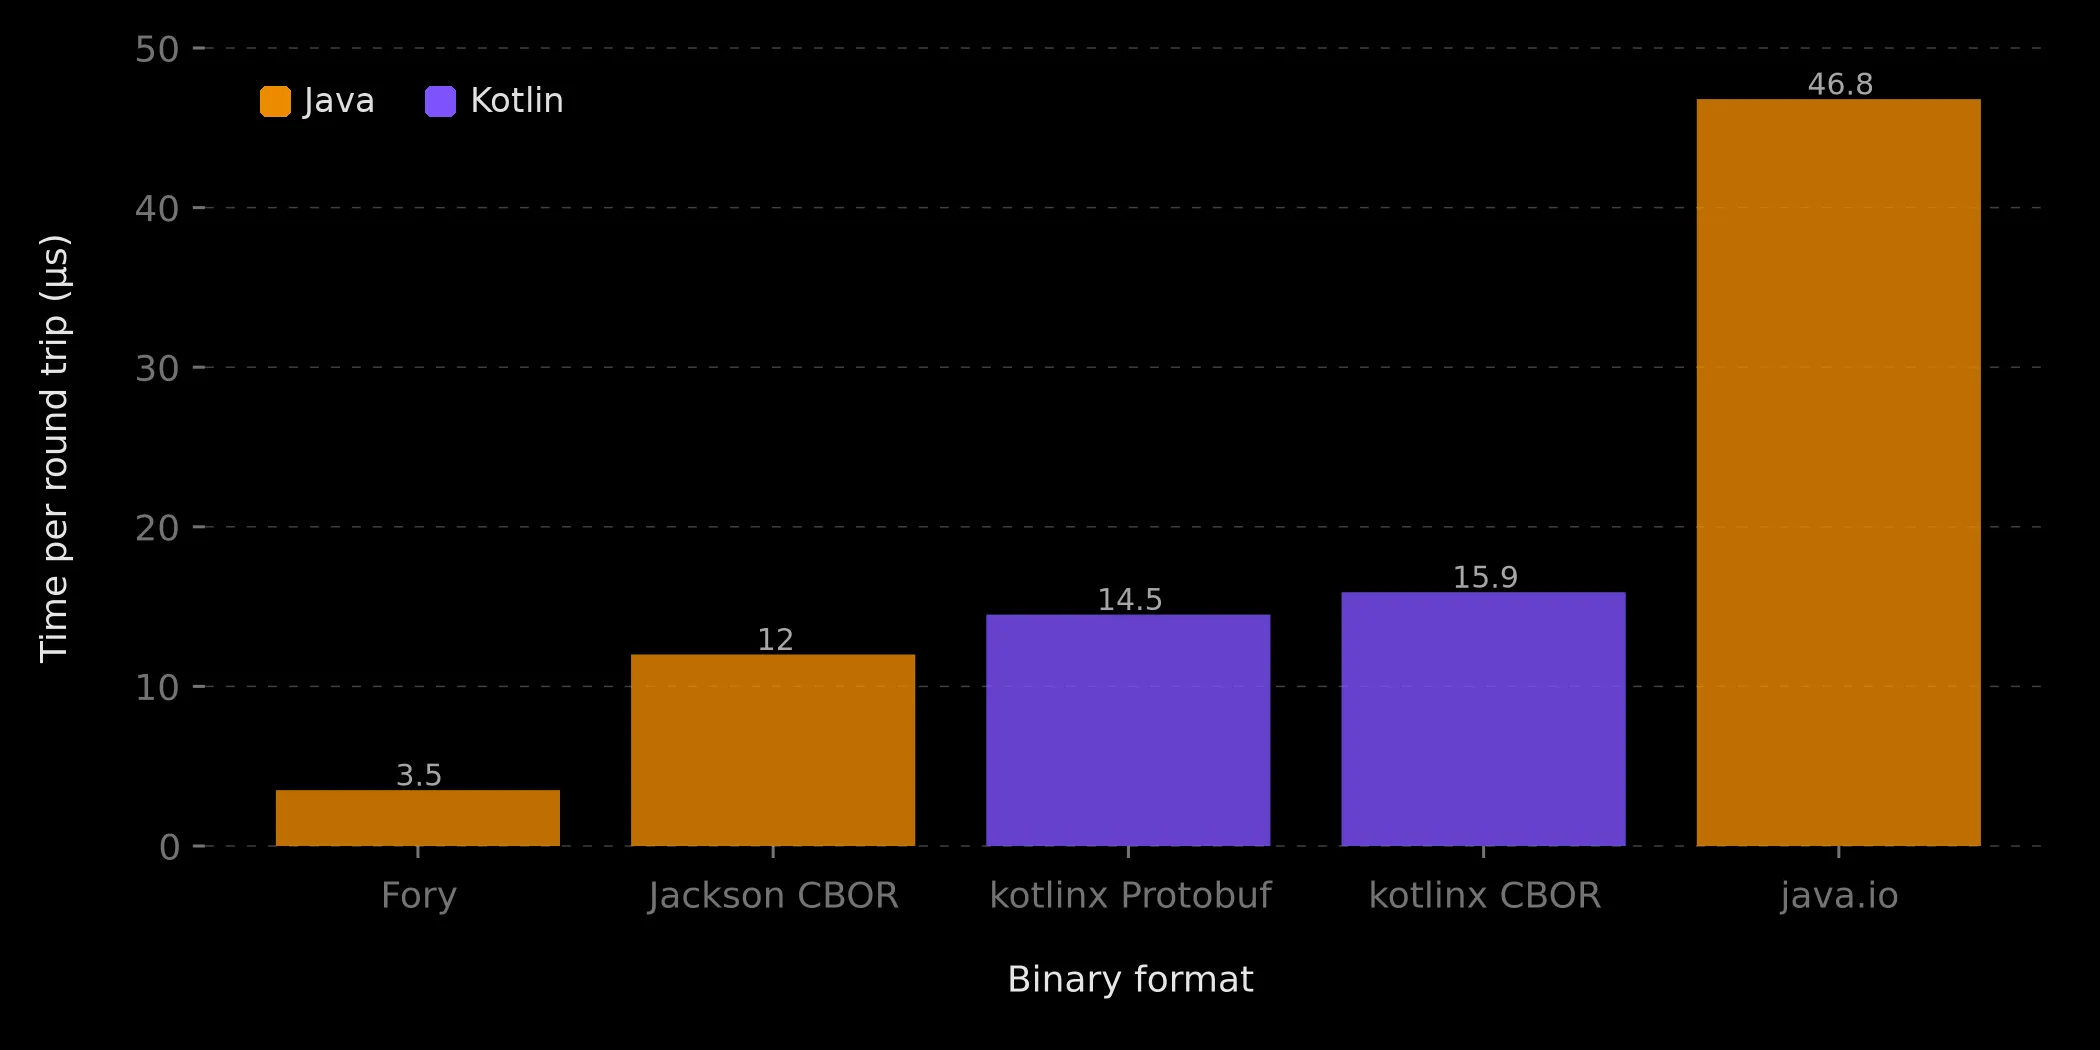
| Fory | Java / Kotlin | 3.5 µs / 3.6 µs | 7,502 / 7,620バイト | Kotlinではテストクラス名がいくらか長くなります |
| Jackson CBOR | Java | 12.0 µs | 7,819バイト | |
| kotlinx Protobuf | Kotlin | 14.5 µs | 7,155バイト | 最小のペイロード。名前の代わりにフィールド番号を使用 |
| kotlinx CBOR | Kotlin | 15.9 µs | 7,797バイト | |
| java.io | Java | 46.8 µs | 9,152バイト | JDKのデフォルトバイナリフォーマット |
JacksonがJSONの王者
本当に意外だったのは、コンパイル時コード生成を備えたkotlinx.serializationが、この比較全体の中で最も遅いJSONバックエンドだったという点です。Jacksonのリフレクションベースのデータバインディングに敗れており、jackson-kotlinの実行と比べた場合でさえそうなのです。
2つ目の予想外の結果:Kotlin(JVM)でJSONにシリアライズする必要がある場合、jackson-kotlinモジュールを介してJacksonが最善の選択となります。その理由はKotlinValueInstantiator.createFromObjectWith(7.3%)とValueCreator.getValueParameters(3.3%)であり、Javaモデルより約16%遅くなっています。これは、パラメータ名、null安全性、デフォルト値を使ってKotlin流のやり方でインスタンス化を行うことの代償です。
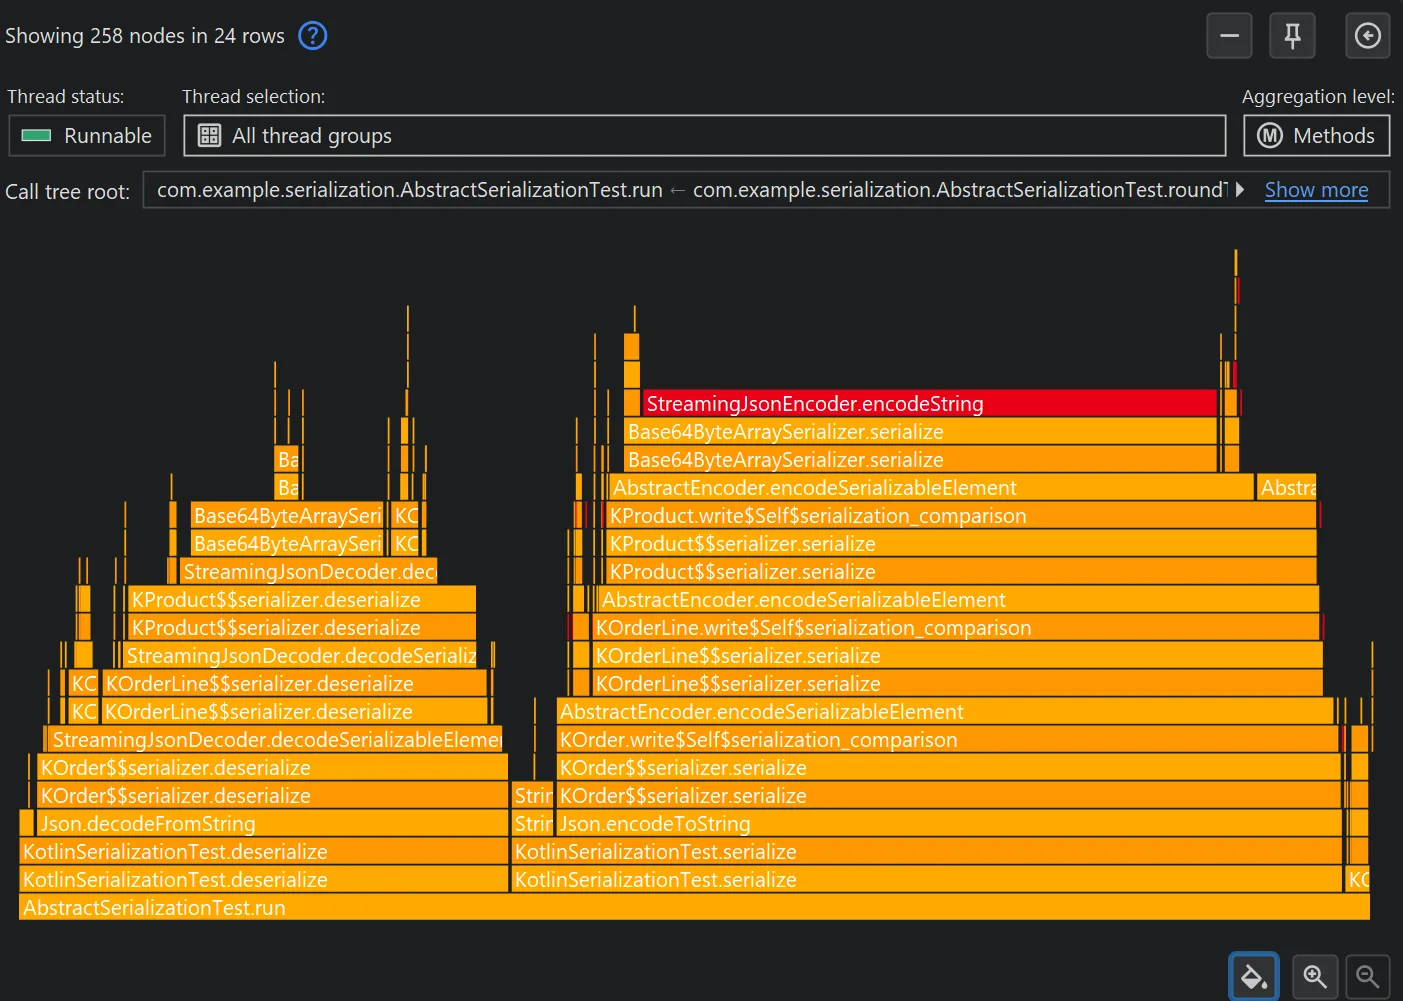
なぜJacksonはこれほど速いのでしょうか?この結果をもたらす理由がいくつか重なっています。その一つは、テストで使用するペイロードの種類に関わるものです:JSONにはバイナリ型がないため、テストデータ中のバイト配列はbase64でエンコードしなければなりません。JSONエンジン間で最も差がつくのはまさにこの点です:
- Jacksonはbase64をUTF-8出力バッファに直接エンコードします。
- Moshiはbase64文字列を生成し、それを走査してエスケープ処理を行ってからUTF-8に書き出します。
- kotlinx.serializationも同じ多段階の処理を行い、まずJSONドキュメント全体を
Stringとして構築し、その後それをバイトに変換します。
コード生成だけでは不十分
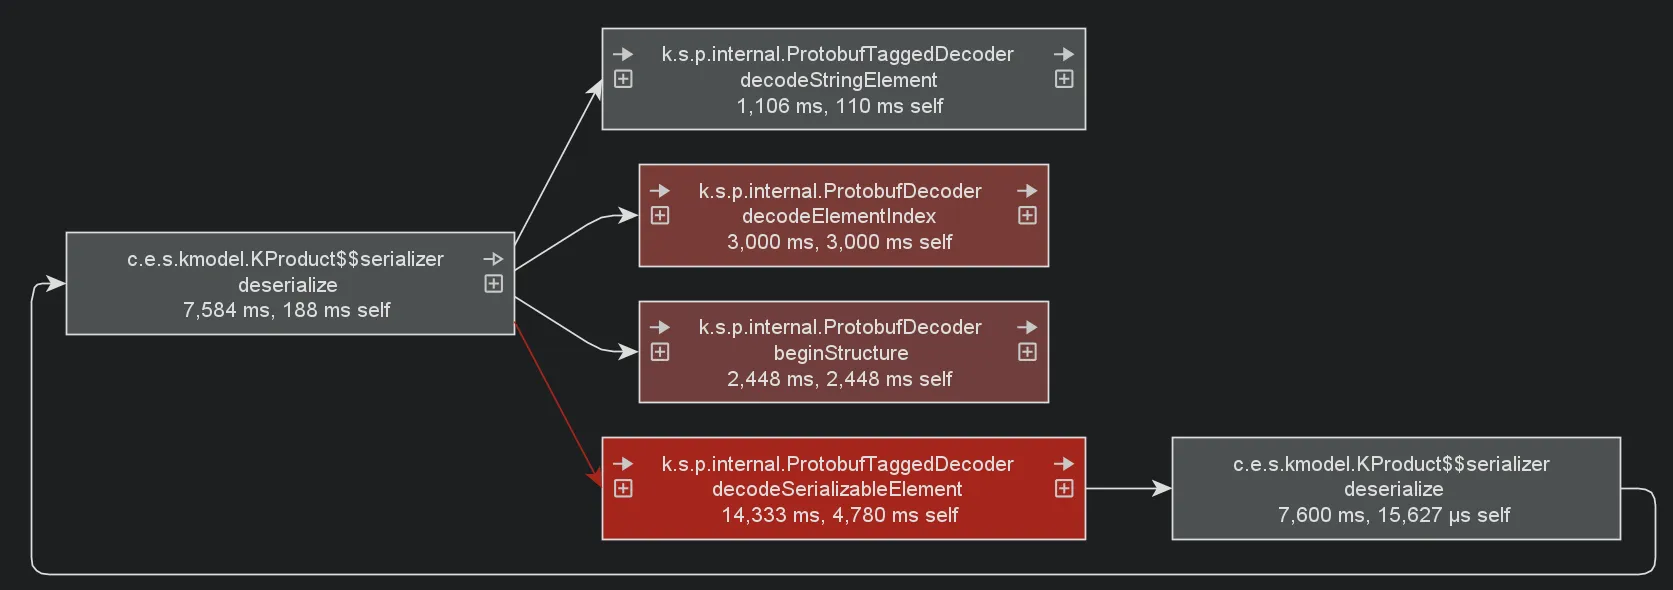
kotlinx.serializationはコンパイル時にクラスごとのシリアライザを生成しますが、それでも遅いのです。その理由はプロファイリングデータにはっきりと現れています:生成されるシリアライザは、フォーマット非依存のEncoderおよびDecoderプロトコル向けのものです。すべてのオブジェクトはディスクリプタを伴うbeginStructureを経由し、すべてのフィールドはdecodeElementIndexと要素ごとのエンコード/デコード呼び出しを経由します。さらに、ラウンドトリップごとに新しいエンコーダとデコーダのインスタンスがアロケートされます。
このプロトコルコストを最も素直に計測できるのはProtobufバックエンドです。protobufのワイヤフォーマットはフィールド番号とネイティブなバイナリデータだけという最小限のものだからです。この実行では、生成されたデシリアライザで費やされた時間の約40%がデコーダの機構に起因します:decodeElementIndexだけで24.7%、beginStructureが15.5%を占めます。実際のデータ移動そのものは、Foryの水準まで下がります。
つまり、kotlinx.serializationはコンパイル時にコードを構築し、Foryは実行時に構築しますが、パフォーマンスにとってそれは重要ではありません。重要な違いは、kotlinx.serializationが抽象的なシリアライザを構築するのに対し、Foryはフォーマット固有のシリアライザを構築するという点です。ワイヤフォーマットを直接生成することが、すべての違いを生み出しています。
とはいえ、コード生成がパフォーマンスにとってまったく重要でないと言っているわけではありません。コード生成かリフレクションかだけが違いである場合には、確かに重要になります。
Kotlinモデルでは、MoshiはKSP生成のアダプタを使ってJSONを直接書き出します。Javaモデルでは、Moshiはリフレクションベースのフィールドアダプタを使用しており、これはKotlinモデルの生成されたアダプタより16%遅くなります。
kotlinx.serializationの利点
これらの数字はkotlinx.serializationにとってあまり有利なものではありませんが、それでも多くの魅力があり、私自身もその理由からヘビーユーザーです。
kotlinx.serializationには、はるかに優れたパフォーマンスを持つCBORとProtobufのバックエンドが含まれています。Protobufは14.5 µsで比較全体の中で最小のペイロード(7,155バイト)を誇り、CBORは15.9 µsです。CBORデコーダはフィールド名ごとにHashMapルックアップ(実行の11%)を行います。CBORは自己記述型でフィールド名を書き込むのに対し、protobufはフィールド番号を使うだけだからです。
第一に、フォーマット非依存のプロトコルはバグではなく、機能です。@Serializableでクラスに注釈を付ければ、JSON、CBOR、Protobufやその他のサードパーティフォーマットで動作します。第二に、JVM、Android、iOS、ブラウザ、さらにはネイティブコード上でも動作します。Foryの実行時コード生成はJVM固有の機構です。
Kotlin Multiplatformが必要で、モデルを変更せずにフォーマットを切り替えたいのであれば、kotlinx.serializationが唯一の選択肢であり、そのバイナリバックエンドも十分に高速です。ただし、純粋な速度を求めるなら、そのJSONバックエンドは選ばないでください。
Kotlin向けライブラリの選択
- JVM上で純粋な速度を求めるなら、ForyはJavaクラスとまったく同じようにKotlinデータクラスで動作します。しかもアノテーションは一切不要です。
- JVM上でJSONを扱うなら、
jackson-module-kotlinを使ったJacksonが最速の選択肢ですが、null安全性とデフォルト値のために16%のKotlinオーバーヘッドがかかります。KSPコード生成を使ったMoshiが僅差で健闘する第2位です。 - Kotlin Multiplatformでは、kotlinx.serializationがデフォルトの選択肢です。該当する場合には、より高速なCBORおよびProtobufバックエンドを利用できます。
計測方法
計測のセットアップは前回の記事と同じです。JProfiler Gradleプラグインがオフラインモードでセットアップごとに1つのスナップショットを記録し、CPUサンプリングとアロケーション記録はそれぞれ別の実行で行いました。ホットスポット分析には、コーディングエージェントがJProfiler MCPサーバーを操作しました。プロジェクト全体はGitHubで公開されています。
スナップショットを自分で確認するには、JProfilerをダウンロードし、build/snapshots-cpuにある.jpsファイルを開いてください。