

JProfiler MCPサーバーを弱いモデルに対して堅牢にする
フラッグシップモデルは、すべてのコーディングタスクに理想的というわけではありません。この種のモデルは低速で、コストも非常に高くつきます。そのため、多くのタスク、特に雑務は、より機敏に動いてわずかなコストでタスクをこなす下位ティアのモデルの方が適しています。ただし、こうしたモデルのツール呼び出しの挙動は、最上位モデルのそれよりも不安定になりがちです。
JProfiler 16.1では、AIコーディングエージェントがJavaアプリケーションのプロファイリングとその結果の分析を行えるようにするためのMCPサーバーを追加しました。お客様からは多くの好意的なフィードバックをいただいており、今後のリリースでこの分野をさらに拡充していく予定です。
初回リリースでは、テストは主にClaude Codeを用いて行われていました。JProfiler 16.2では、MCPサーバーを他のAIモデルに対してはるかに堅牢なものにしました。他のモデルがどのような間違った動作をしたのか、そしてプロファイリングのワークフローをそれらの弱点に対してどのように堅牢化したのか、以下で解説します。
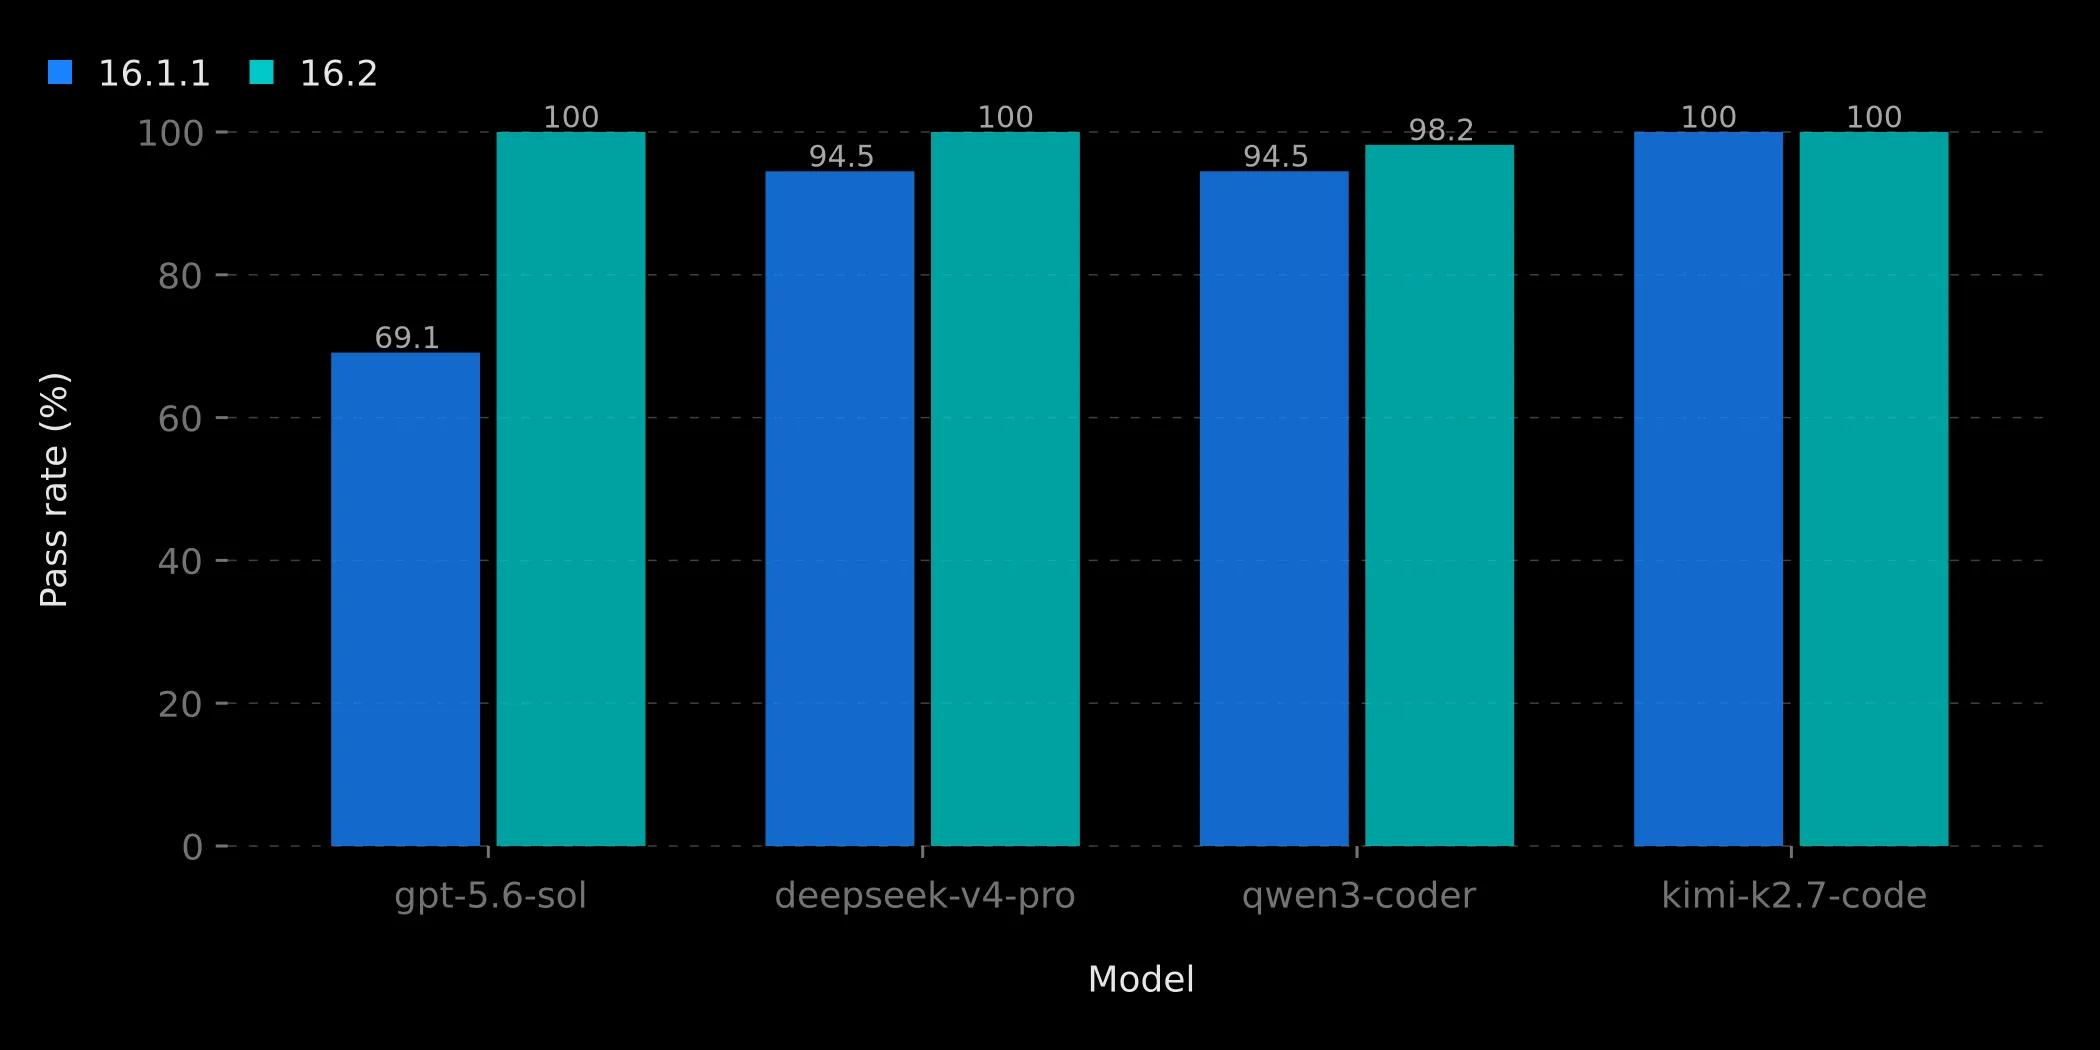
結果を先に知りたい方のために、1枚のチャートで結果をお見せします。4つのモデルが、16.1.1と16.2の両方のサーバーに対して、私たちの11のプロファイリングシナリオを実行したものです。
ツールの説明は提案にすぎない
MCPサーバーは、呼び出し側が言語モデルであるAPIです。通常のAPIでは、呼び出し側は契約に従うか、エラーを受け取るかのどちらかです。言語モデルはツールの説明を提案として読み、状況が不明確な場合や自分の目標に合うものが見つからない場合には即興で振る舞います。モデルが強力であるほど、こうした事態は少なくなります。16.1のサーバーを他のモデルでテストしたところ、プロファイリングのワークフローがいくつもの異なる形で失敗するのを目にしました。
- プロファイリング用に用意されたJVMパラメータをJVMの起動に追加する代わりに、モデルは独自の設定ファイルを作成したり既存のファイルを修正したりして、記録はまったく開始されませんでした。
- テスト実行の後、MCPサーバーにセッションの状態を問い合わせる代わりに、モデルは保存されたJProfilerスナップショットファイルを直接読み込みました。これはサーバーのセッション管理を迂回するものです。
- MCPサーバーの内部設定ファイルがJVMパラメータ内に読み取り可能なパスとして現れるため、モデルはそれを調べ、一部は変更を試みました。
これはJProfilerに固有の話ではありません。τ-benchベンチマークは、カスタマーサービスをシミュレートしたドメインでツールを使用するエージェントを評価するもので、最良のモデルでさえタスクの半分以下しか成功せず、同じタスクを繰り返すと一貫性のない結果を返すことを明らかにしています。
ツールに組み込まれたガードレール
16.2では、ワークフローは多くの面で強化されています。たとえば:
- ツールの説明は規範的になりました。
prepare_profilingツールは、エージェントに対し、JVMパラメータは「一字一句そのまま追加すること。ファイルの作成や修正は一切行わないこと」と指示し、実行後にはcheck_statusの呼び出しと「保存されたスナップショットファイルを自分で読み込まないこと」を指示します。 - ツールはワークフローを強制します。
load_snapshotツールは、MCPサーバーの内部記録ファイルを開くことを拒否し、エラーメッセージで正しい次のステップを説明します。 - JVMパラメータ内の内部設定ファイルのパスは難読化されているため、モデルは試みてもファイルを読み取ったり上書きしたりすることができません。
根本的な原則は、エラーメッセージがプロンプトの一部だということです。モデルが誤った動作をしたとき、MCPサーバーからの応答が、代わりに何をすべきかをモデルに伝えます。つまり、脱線したモデルは次のツール応答によって軌道修正されるのです。Anthropicによるエージェント向け効果的なツールの書き方の記事は、この話を詳しく扱っています。ツールの説明はプロンプトエンジニアリングであり、ツールはそれを使用するエージェントとともに評価されなければならない、というのがその趣旨です。
エージェントがワークフローに従うことのテスト
言語モデルがワークフローに従うことをリグレッションテストするには、どうすればよいのでしょうか。私たちは、自然言語で記述されたプロファイリングタスクをコーディングエージェントに与えるエンドツーエンドテストを構築しました。たとえば「このプログラムを起動時から記録して、時間がどこに使われているか教えて」といった具合です。テストでは2つのことを検証します。エージェントが期待どおりのMCPツールを呼び出したことと、その回答が実際のプロファイリングデータに基づいていることです。
シナリオは主要なプロファイリングタスクをカバーしています:
- スナップショット内のCPUホットスポットと、その呼び出し元を突き止めるためのホットスポットの掘り下げ
- JDBCデータを含むスナップショットにおける最も遅いSQLステートメント
- リグレッションの原因を突き止めるための2つのスナップショットの比較
prepare_profilingを使用したプログラムの起動時からの記録- PIDまたはJVMリスト経由による実行中のJVMへのアタッチ
- ヒープダンプと、HPROFファイルからメモリリークを見つけること
同じシナリオを多数のモデルに対して実行します。OpenCodeとOpenRouterではDeepSeek、Gemini、GLM、GPT、Grok、Kimi、Mistral、Qwenなどのモデルをテストします。また、Claude Code、Codex、Cursor、AntigravityのネイティブCLIには、それぞれ専用のテストクラスが用意されています。
幅広いモデルでMCPサーバーを使用できるだけの十分な品質水準を維持するためには、このような厳格なテストハーネスが不可欠であることがわかりました。ツール呼び出しで最も広く利用されているベンチマークであるBerkeley Function Calling Leaderboardも、最新バージョンで同じ方向に進みました。単一のツール呼び出しから、タスク全体のエージェンティックな評価への移行です。
効果の測定
このブログ記事のために改善を定量化するため、テストした4つのモデルで、OpenCode CLIをエージェントハーネスとして使用し、11のシナリオすべてを各5回ずつ、16.1.1のサーバーに対してと16.2のサーバーに対しての両方で実行しました。各シナリオはアサーションによって採点されます。期待どおりのMCPツールが期待どおりの順序で呼び出されたこと、そして回答がプロファイリングデータに裏付けられたものであることです。
| モデル | 16.1.1 | 16.2 |
|---|---|---|
gpt-5.6-sol |
38/55 | 55/55 |
deepseek-v4-pro |
52/55 | 55/55 |
qwen3-coder |
52/55 | 54/55 |
kimi-k2.7-code |
55/55 | 55/55 |
最も印象的なケースはGPTです。gpt-5.6-solは今日利用できる最も強力なモデルの1つでありながら、16.1.1のサーバーに最も苦戦したモデルでした。問題は明らかにモデルの知能ではなく、16.1のワークフローがClaudeのツール説明の読み方に合わせて調整されていたことにありました。指示に解釈の余地がある場合、他のモデルはそれぞれ異なる形で即興の対応をするため、あのワークフローは他のモデルにとっては最適ではなかったのです。
16.1.1では、GPTは毎回の繰り返しで同じ3つのシナリオに失敗していました。トランスクリプトを見ると、ワークフローを先に進める代わりにload_snapshotを10回連続で呼び出したり、既存のスナップショットを分析すべき場面で新しい記録を開始したりしています。16.2ではすべてのテストに合格します。DeepSeekとQwenは16.1.1でもすでにほとんどの場合で安定しており、Kimiは終始安定していました。16.2で残った唯一の失敗は、Qwenのある1回の実行がシナリオに3回連続で失敗したものです。
ツール呼び出しの失敗は高くつきます。16.1.1の実行では、失敗したGPTのシナリオは諦めるまでに平均42回のツール呼び出しと4分を要し、成功した実行の約8倍のコストでした。GPTのマトリックス全体では、16.1.1のサーバーは69%の成功率で13.21ドル、16.2のサーバーは100%の成功率で3.13ドルかかりました。
始めてみよう
コミットがパフォーマンスに与える影響を確認するため、夜間のルーチンプロファイリングジョブにJProfiler MCPサーバーを使ってみてください。MCPサーバーはダウンロードページから入手でき、MCPセットアップページを使えば1分でエージェントを接続できます。