

让 JProfiler MCP 服务器对较弱模型更加稳健
旗舰模型并不适合所有编码任务。它们速度慢,而且成本高昂。因此许多任务,尤其是琐事类任务,更适合交给响应更敏捷、成本只有其零头的较低档模型。然而,这些模型的工具调用行为可能比顶级模型更加不稳定。
在 JProfiler 16.1 中,我们添加了一个 MCP 服务器,让 AI 编码代理能够对 Java 应用程序进行性能分析并分析结果。这一功能收到了客户的大量积极反馈,因此这是我们打算在即将发布的版本中继续拓展的一个领域。
在初始发布时,我们的测试主要使用 Claude Code 完成。对于 JProfiler 16.2,我们已经使 MCP 服务器对其他 AI 模型更加稳健。请继续阅读,了解其他模型出了哪些问题,以及我们如何让性能分析工作流能够抵御它们的缺陷。
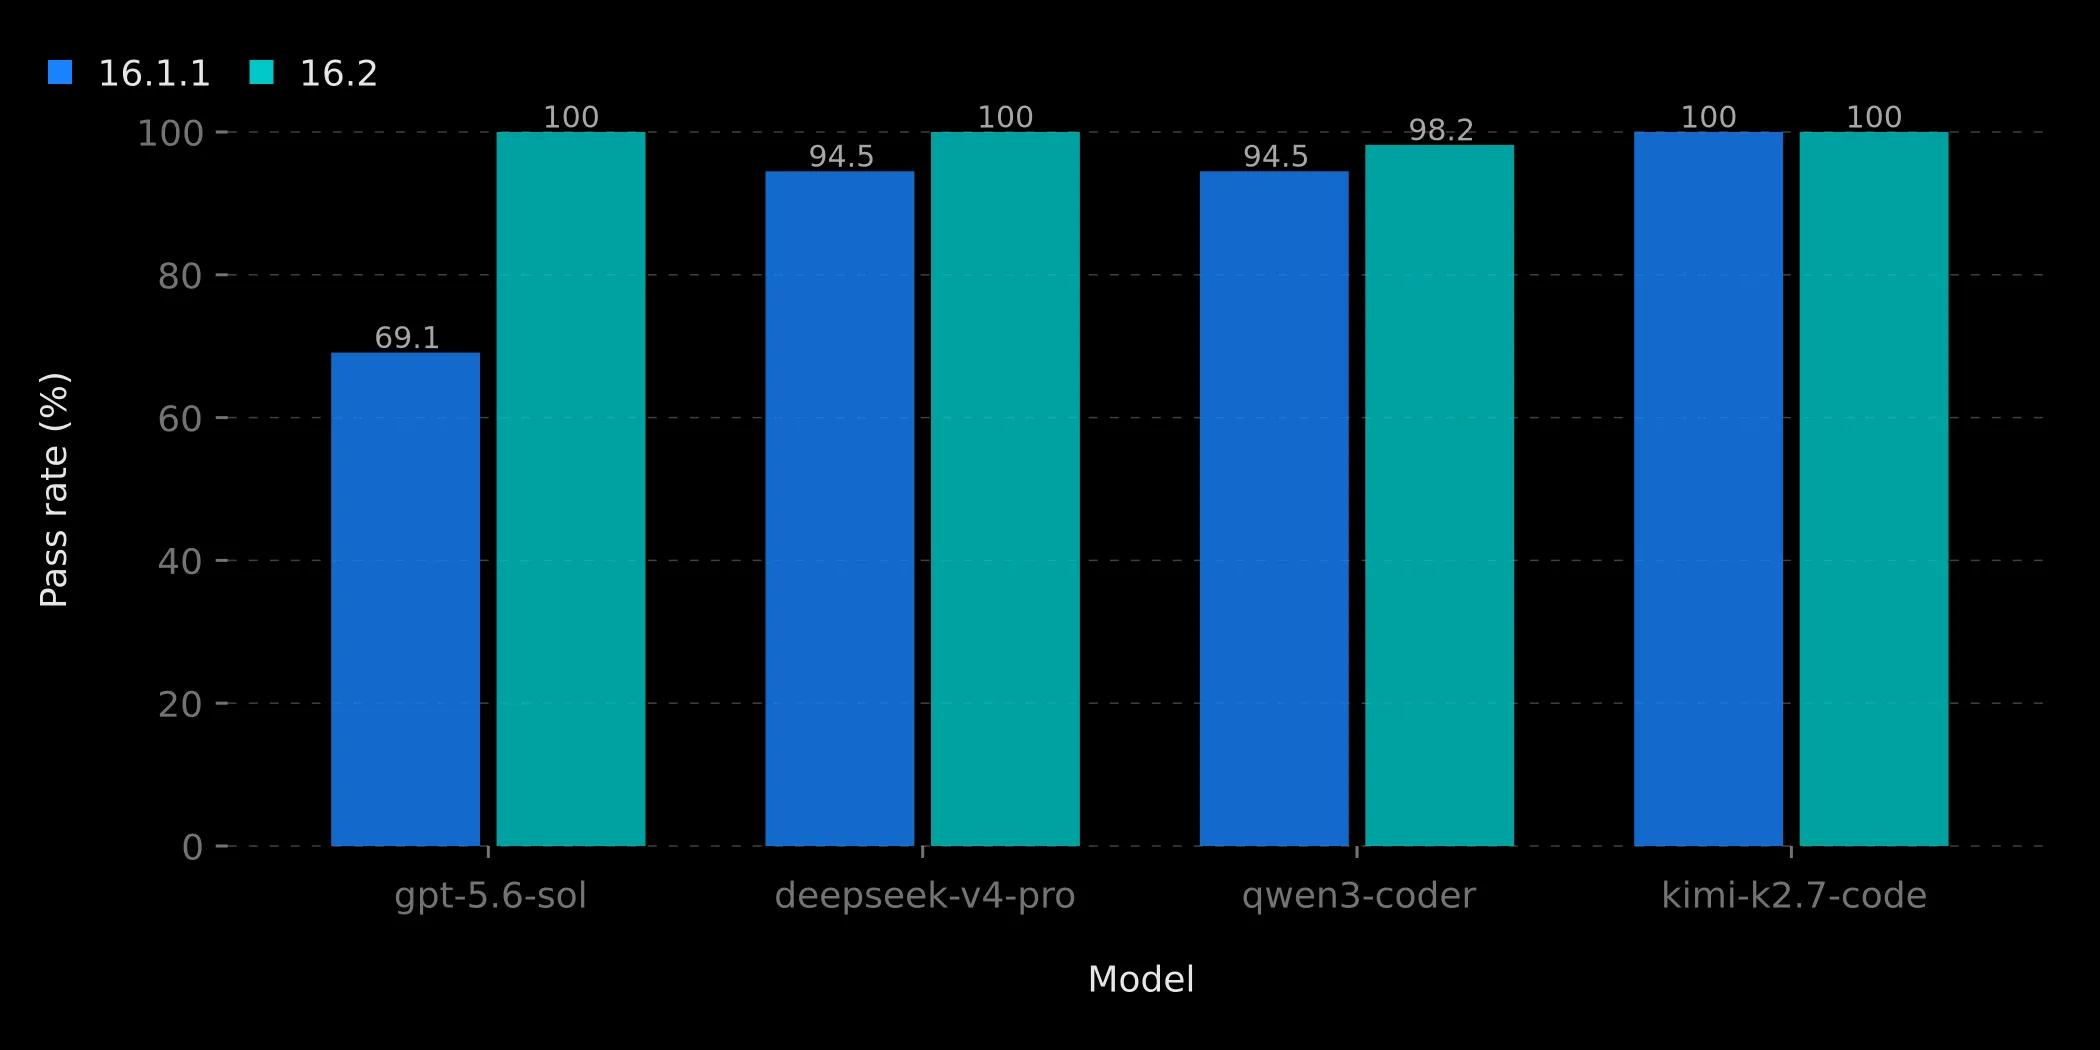
为便于急于了解结果的读者,这里用一张图表给出结果:四个模型分别针对 16.1.1 和 16.2 服务器运行我们的十一个性能分析场景。
工具描述只是建议
MCP 服务器是一种调用方为语言模型的 API。对于普通 API,调用方要么遵循契约,要么收到错误。而语言模型会把工具描述当作建议来阅读,当情况不明确、或与其目标没有很好的匹配时,它就会即兴发挥。模型越强,这种情况就越少发生。当我们用其他模型测试 16.1 服务器时,我们看到性能分析工作流以几种不同的方式失败:
- 模型没有把为性能分析准备好的 JVM 参数添加到 JVM 调用中,而是创建自己的配置文件或修改现有文件,导致录制从未启动。
- 测试运行结束后,模型直接加载已保存的 JProfiler 快照文件,而不是向 MCP 服务器查询会话状态,这绕过了服务器的会话管理。
- 由于 MCP 服务器的内部配置文件在 JVM 参数中以可读路径的形式出现,模型会去查看该文件,有些模型甚至试图修改它。
这并非 JProfiler 特有的问题。τ-bench 基准测试在模拟客服领域中对使用工具的代理进行评估,发现即使是最好的模型,成功率也不到一半,并且在重复同一任务时会给出不一致的结果。
工具中的护栏机制
在 16.2 中,工作流在许多方面得到了强化,例如:
- 工具描述现在具有规定性。
prepare_profiling工具告诉代理"逐字添加 JVM 参数,不要创建或修改任何文件",并在运行结束后调用check_status,同时"不要自行加载已保存的快照文件"。 - 工具强制执行工作流。
load_snapshot工具拒绝打开 MCP 服务器的内部录制文件,并在其错误消息中解释正确的下一步操作。 - JVM 参数中内部配置文件的路径经过混淆处理,因此即使模型尝试读取或覆盖该文件也无法做到。
总的原则是,错误消息是提示词的一部分。当模型做错事情时,它从 MCP 服务器得到的响应会告诉它应该怎么做。换句话说,偏离正轨的模型会被下一个工具响应引导回来。Anthropic 关于为代理编写高效工具的文章详细讲述了这一点:工具描述就是提示工程,工具必须与将要使用它们的代理一起进行评估。
测试代理是否遵循工作流
如何对语言模型是否遵循工作流进行回归测试?我们构建了端到端测试,向编码代理下达自然语言形式的性能分析任务,例如"从启动时开始录制这个程序,并告诉我时间都花在了哪里"。随后测试断言两件事:代理调用了预期的 MCP 工具,并且其回答基于实际的性能分析数据。
这些场景涵盖了主要的性能分析任务:
- 快照中的 CPU 热点,以及深入某个热点以找出其调用者
- 包含 JDBC 数据的快照中最慢的 SQL 语句
- 比较两个快照以找出性能退化的原因
- 使用
prepare_profiling从启动时录制程序 - 通过 PID 或 JVM 列表附加到正在运行的 JVM
- 堆转储,以及在 HPROF 文件中查找内存泄漏
相同的场景会针对多个模型运行。通过 OpenCode 和 OpenRouter,我们测试了包括 DeepSeek、Gemini、GLM、GPT、Grok、Kimi、Mistral 和 Qwen 在内的模型,而 Claude Code、Codex、Cursor 和 Antigravity 的原生 CLI 各自有自己的测试类。
我们发现,要维持足够的质量水准、使 MCP 服务器适合与广泛的模型配合使用,这样一套严格的测试框架是必不可少的。Berkeley Function Calling Leaderboard 是工具调用领域使用最广泛的基准,其最新版本也做出了同样的转变:从单次工具调用转向对完整任务的代理式评估。
衡量成效
为了在本文中量化改进效果,我们让四个受测模型在全部十一个场景中各运行五次,以 OpenCode CLI 作为代理框架,分别针对 16.1.1 服务器和 16.2 服务器各运行一轮。每个场景根据其断言来评分:按预期顺序调用了预期的 MCP 工具,以及回答立足于性能分析数据。
| 模型 | 16.1.1 | 16.2 |
|---|---|---|
gpt-5.6-sol |
38/55 | 55/55 |
deepseek-v4-pro |
52/55 | 55/55 |
qwen3-coder |
52/55 | 54/55 |
kimi-k2.7-code |
55/55 | 55/55 |
最引人注目的案例是 GPT。gpt-5.6-sol 是当今最强大的模型之一,但它却是在 16.1.1 服务器上表现最挣扎的模型。问题显然不在于模型智能,而在于 16.1 的工作流是按照 Claude 阅读工具描述的方式来校准的。当指令留有解释空间时,其他模型会以不同的方式即兴发挥,因此该工作流对它们来说并非最优。
在 16.1.1 上,GPT 在每一次重复中都失败在相同的三个场景上。对话记录显示,它连续调用 load_snapshot 十次而不是在工作流中继续推进,或者在应当分析现有快照时却开始新的录制。在 16.2 上,它通过了所有测试。DeepSeek 和 Qwen 在 16.1.1 上大多数时候已经相当可靠,而 Kimi 则自始至终都很可靠。16.2 上仅存的一次失败是单个 Qwen 运行连续三次未能通过其场景。
工具调用失败的代价高昂。在 16.1.1 的运行中,一个失败的 GPT 场景在放弃之前平均要进行 42 次工具调用、耗时 4 分钟,约为成功运行成本的八倍。在整个 GPT 测试矩阵中,16.1.1 服务器花费 13.21 美元换来 69% 的通过率,而 16.2 服务器花费 3.13 美元就达到了 100% 的通过率。
开始使用
不妨尝试将 JProfiler MCP 服务器用于每夜例行性能分析作业,以检查你的提交对性能的影响。它可在下载页面获取,而MCP 设置页面可以让你的代理在一分钟内完成连接。