

Claude 仅靠阅读代码永远无法找到的热点
CommaFeed 是我日常使用的 RSS 阅读器。它是开源的,其作者在 commafeed.com 上运行着一个免费的公共实例。每次我刷新订阅源时,都是别人的服务器在承担这些工作。因此,当我想弄清楚这些工作究竟消耗在哪里时,我把 Claude Code 和 JProfiler MCP 指向了它。
最终,一项数据库优化被合并进了 CommaFeed。这个修复本身并不复杂,但 Claude 仅凭源代码是不可能想出它的。事后我问过它,它也证实了这一点:它的第一直觉本会修错地方。请继续阅读,看看连接到 JProfiler MCP 服务器的 Claude Code 如何带我从好奇心走向一个已合并的 PR。
寻找热点
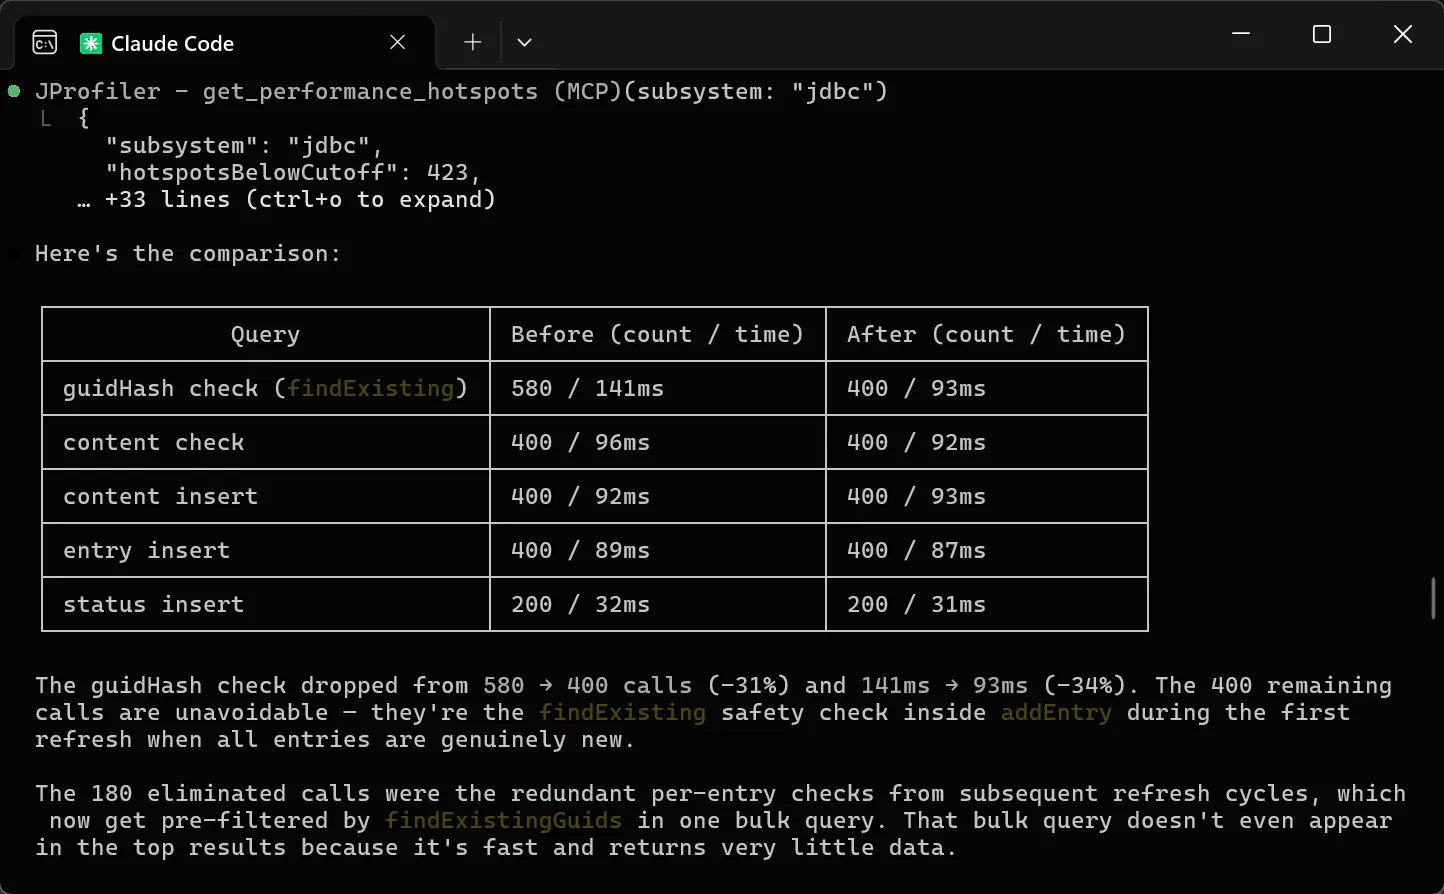
我在本地启动了 CommaFeed,并将 Claude Code 指向这个运行中的进程。然后我运行了一个单元测试来建立订阅源并刷新它们。代理做的第一件事就是查询 JDBC 热点。有一个查询在排名中遥遥领先:FeedEntryDAO.findExisting 中针对每条条目的 guidHash 存在性检查。
其累积时间为 141 毫秒。单看这个数字并不算异常。引人注意的是次数:400 次检查却产生了 580 次 JDBC 查询。有什么东西被重复检查了。调用者是 FeedRefreshUpdater.addEntry,它在每次订阅源刷新期间对每条条目各执行一次。
没有任何静态分析工具会标记出"400 次检查却对应 580 次 JDBC 查询",因为这个比例只在运行时才存在。代理阅读 FeedRefreshUpdater 时,看到的是一个看似合理的循环调用着一个看似合理的 DAO 方法。单看源码,没有任何明显的问题。
修复方案
代理诊断出了一个经典的 N+1 查询模式。解析出的订阅源中的每一条条目都会触发一次独立的数据库往返来检查其是否存在。提出的修复方案是:用单个查询预先获取某个订阅源所有已存在的 GUID,在内存中过滤出新条目,然后只对新条目进入逐条循环。原有的逐条检查保留在原处,作为并发情况下的安全保障。
随后,代理重新进行了性能分析以验证效果。guidHash 检查的调用次数从 580 次降到 400 次(-31%),耗时从 141 毫秒降到 93 毫秒(-34%)。剩下的 400 次调用是在初始刷新期间对真正的新条目不可避免的兜底调用。我以拉取请求的形式提交了这个改动。
代码评审
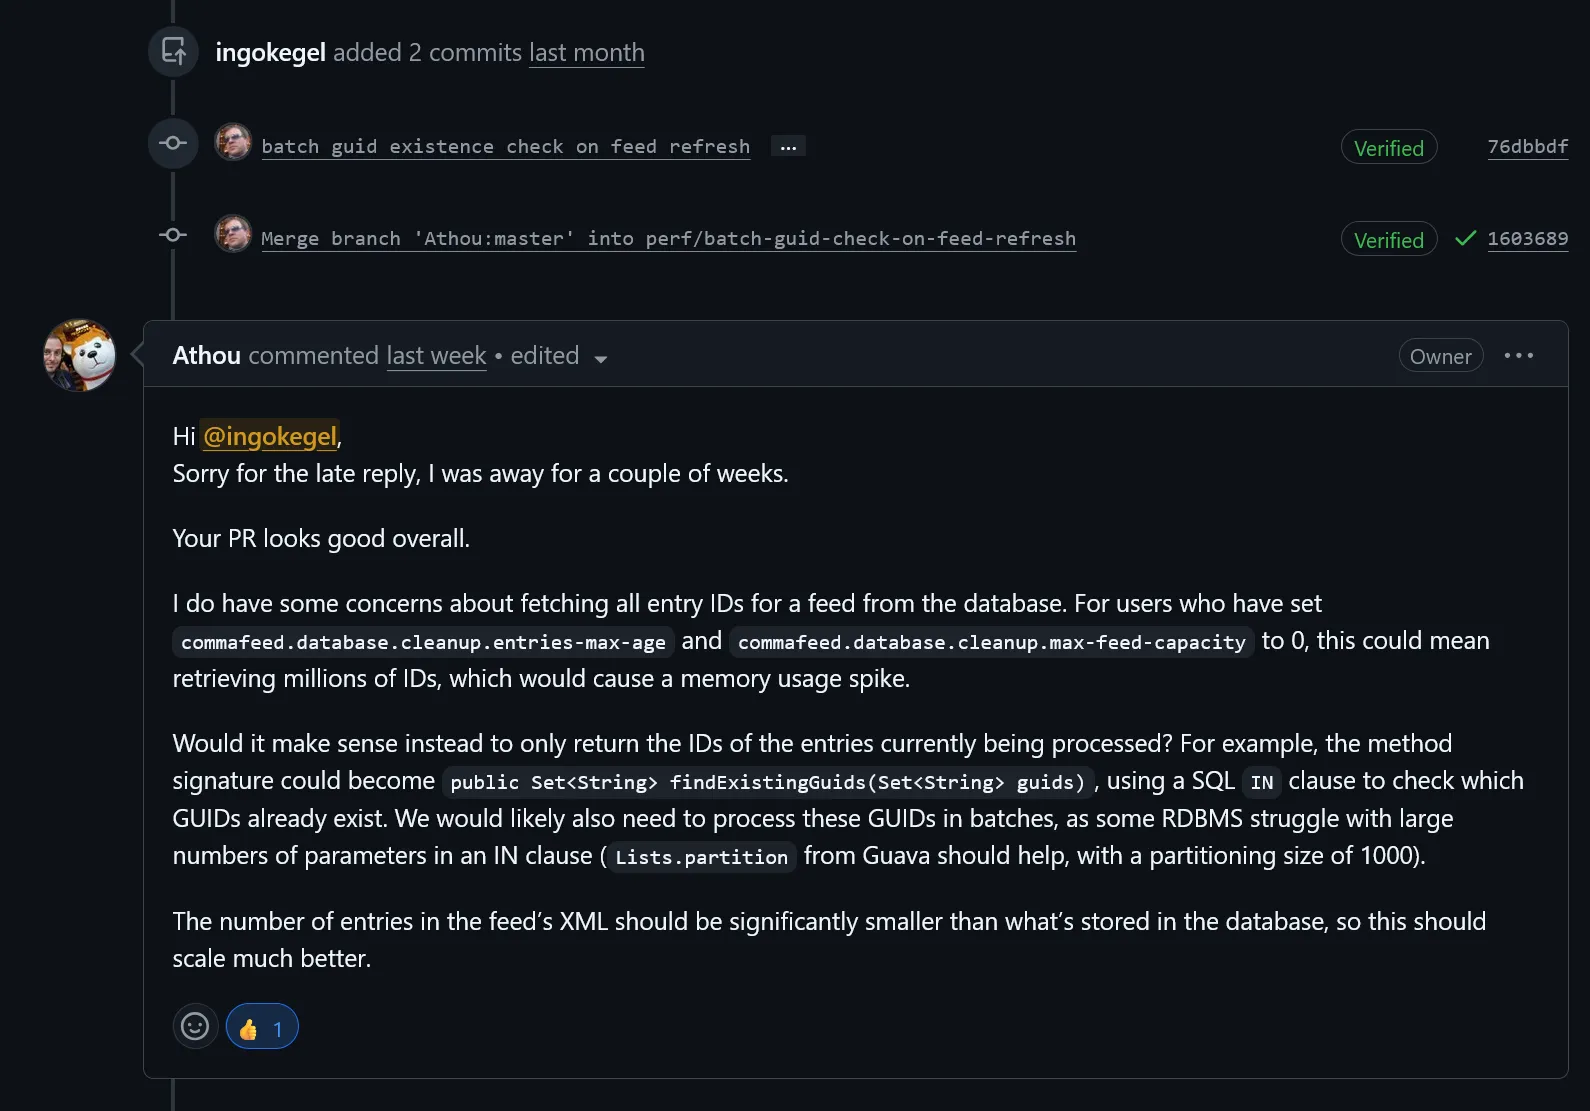
维护者 Athou 提出了一个疑虑。CommaFeed 允许用户通过将 commafeed.database.cleanup.entries-max-age 和 max-feed-capacity 设置为零来完全禁用条目清理。对这类用户来说,一个订阅源经年累月可能积累数百万条条目。每次刷新都预先获取全部条目会导致内存峰值。
他的建议是:不要获取所有已存在的 GUID,而只获取当前订阅源 XML 中实际存在的 GUID,使用 SQL IN 子句,并按每批 1000 条条目进行分批处理。
性能分析数据在这里同样发挥了作用。这个修复基于测量结果而非对代码的猜测,因此评审的重点是如何安全地扩展这一方案,而不是诊断是否正确。内存峰值方面的疑虑是一个需要维护者领域知识的约束条件,PR 流程也因此发挥了它应有的作用。
第二轮
我把维护者的评审意见反馈给了 Claude Code。代理将方法签名从 findExistingGuids(Feed feed) 改为 findExistingGuids(Feed feed, Set<String> guidHashes),添加了带 Lists.partition 分批处理的 IN 子句,并更新了调用方,传入当前正在处理的条目的哈希值。它还添加了一个集成测试,刷新一个已有数据的订阅源,并验证不会创建重复条目。
public Set<String> findExistingGuids(Feed feed, Set<String> guidHashes) {
    if (guidHashes.isEmpty()) {
        return Set.of();
    }
    Set<String> result = new HashSet<>();
    for (List<String> batch : Lists.partition(new ArrayList<>(guidHashes), IN_CLAUSE_BATCH_SIZE)) {
        result.addAll(query().select(ENTRY.guidHash)
            .from(ENTRY)
            .where(ENTRY.feed.eq(feed), ENTRY.guidHash.in(batch))
            .fetch());
    }
    return result;
}
在推送更新之前,代理对测试重新进行了性能分析。将单个查询拆分为分批的 IN 查询,有可能重新引入开销,抵消最初的收益。测量结果表明并没有:在我测试的订阅源上,分批版本与原来的单查询方案相比差距保持在几个百分点以内,逐条检查的调用次数也维持在新的低基线上。只有运行时数据才能确认这一点。
这个 PR 在当天就被合并了。
如果没有 MCP 会怎样
PR 合并之后,我问代理,如果它手头只有源代码,它会尝试什么。它的回答是:最自然的尝试会是启用 Hibernate 批量插入,一个能加快单条插入速度的设置。这对这个问题毫无帮助。瓶颈在于查询的数量,而不是查询速度。代理本会推荐一个错误的修复方案。
随后我请它写了一段简短的评价。以下是代理的原话:
JProfiler 的 JDBC 探针和持久化探针揭示了一个仅凭计时永远无法发现的模式:在每次刷新周期中都会触发的冗余逐条数据库检查,即使什么都没有变化。如果没有这些探针数据,我优化的方向会完全错误。
commafeed.com 上的每一次订阅源刷新都在消耗其创建者的资源。刷新期间最昂贵的查询得到大幅削减,意味着同样的硬件可以支撑更多用户。
在你的代码上试试看
同样的方法适用于任何 Java 应用程序。每个代码库都有仅靠阅读源码无法发现的热点:藏在 DAO 背后的 N+1 查询,分配数百万短生命周期对象的序列化器,埋在 HTTP 客户端中悄悄将出站调用增加到三倍的重试策略。阅读代码找不到它们,运行时数据可以。
设置只需一条命令。把你的 AI 代理指向你的应用程序,问它时间都花在了哪里。JProfiler MCP 页面提供了 Claude Code、Cursor、Codex 以及任何其他兼容 MCP 的工具的使用说明。