

Claude가 코드를 읽고서는 절대 찾을 수 없었던 핫스팟
CommaFeed는 제가 매일 사용하는 RSS 리더입니다. 오픈 소스이며, 개발자가 commafeed.com에서 무료 공개 인스턴스를 운영하고 있습니다. 피드를 새로 고칠 때마다 다른 누군가의 서버가 그 작업을 대신 처리해 줍니다. 그래서 그 작업이 실제로는 어디로 가는지 궁금해졌을 때, Claude Code와 JProfiler MCP를 여기에 연결해 보았습니다.
그 결과 데이터베이스 최적화 하나가 CommaFeed에 병합되었습니다. 수정 자체는 복잡하지 않았지만, Claude는 소스 코드만으로는 절대 이 수정을 떠올리지 못했을 것입니다. 나중에 물어보니 실제로 그렇다고 확인해 주었는데, 자연스럽게 시도했을 첫 번째 방법은 엉뚱한 곳을 고치는 것이었을 거라고 했습니다. JProfiler MCP 서버에 연결된 Claude Code가 어떻게 저의 단순한 호기심을 병합된 PR까지 이끌었는지 계속 읽어 보시기 바랍니다.
핫스팟 찾기
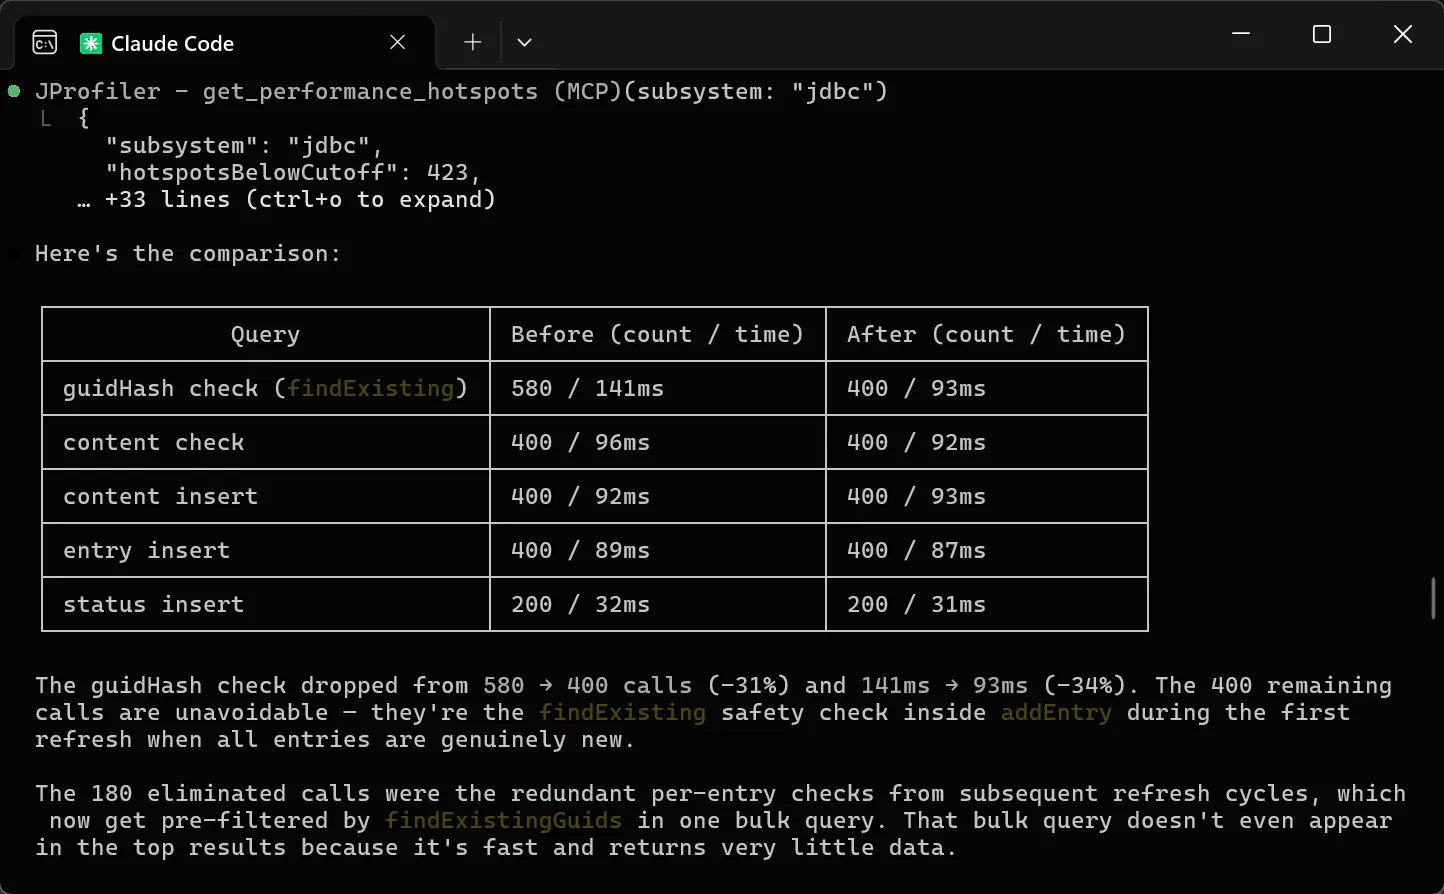
CommaFeed를 로컬에서 시작하고 Claude Code를 실행 중인 프로세스에 연결했습니다. 그런 다음 피드를 설정하고 새로 고치는 단위 테스트를 실행했습니다. 에이전트가 가장 먼저 한 일은 JDBC 핫스팟을 조회하는 것이었습니다. 랭킹에서 한 쿼리가 압도적이었습니다. 바로 FeedEntryDAO.findExisting 내부의 항목별 guidHash 존재 여부 확인이었습니다.
누적 시간은 141 ms였습니다. 그 자체로는 놀랄 만한 수치가 아닙니다. 눈에 띄는 것은 호출 횟수였습니다. 400회의 확인에 580건의 JDBC 쿼리. 무언가가 반복해서 확인되고 있던 것입니다. 호출자는 FeedRefreshUpdater.addEntry였으며, 이는 피드를 새로 고칠 때마다 항목마다 한 번씩 실행됩니다.
어떤 정적 분석기도 "400회의 확인에 580건의 JDBC 쿼리"라는 사실을 지적하지 못합니다. 이 비율은 런타임에만 존재하기 때문입니다. FeedRefreshUpdater를 읽는 에이전트의 눈에는 그럴듯해 보이는 루프가 그럴듯해 보이는 DAO 메서드를 호출하는 것으로 보일 뿐입니다. 소스를 읽어서는 명백히 잘못된 곳이 어디에도 없습니다.
수정 방법
에이전트는 전형적인 N+1 쿼리 패턴이라고 진단했습니다. 파싱된 피드의 모든 항목이 존재 여부 확인을 위해 각자 자신만의 데이터베이스 왕복을 유발하고 있었던 것입니다. 제안된 수정은 피드의 기존 GUID를 단일 쿼리로 미리 가져오고, 새 항목은 메모리에서 필터링하며, 항목별 루프는 새 항목에 대해서만 진입하도록 하는 것이었습니다. 기존의 항목별 확인은 동시성을 위한 안전망으로 그대로 유지되었습니다.
에이전트는 이어서 검증을 위해 다시 프로파일링했습니다. guidHash 확인은 호출 횟수가 580회에서 400회로(-31%) 감소했고, 시간은 141 ms에서 93 ms로(-34%) 감소했습니다. 남은 400회의 호출은 초기 새로 고침 시 실제로 새로운 항목에 대한 불가피한 안전망 호출입니다. 저는 이 변경 사항을 풀 리퀘스트로 제출했습니다.
리뷰
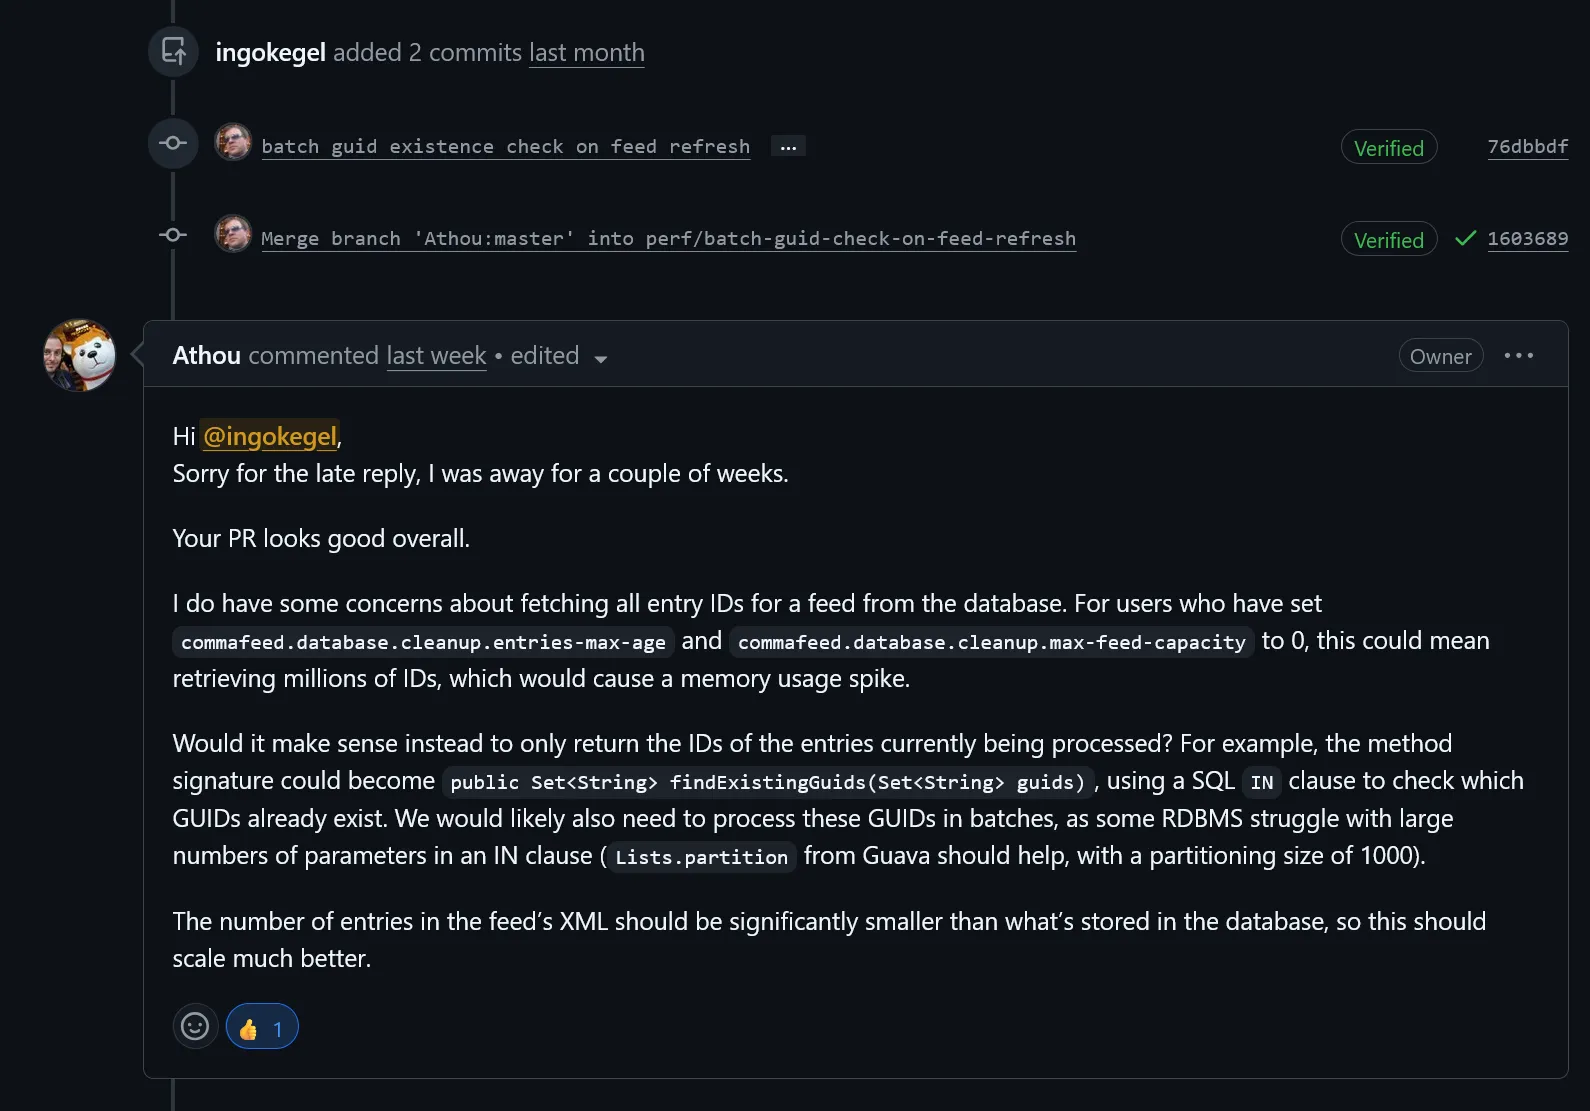
메인테이너인 Athou가 우려 사항을 제기했습니다. CommaFeed에서는 commafeed.database.cleanup.entries-max-age와 max-feed-capacity를 0으로 설정하면 항목 정리를 완전히 비활성화할 수 있습니다. 이러한 사용자의 경우 하나의 피드가 수년에 걸쳐 수백만 개의 항목을 누적할 수 있습니다. 새로 고칠 때마다 그 전부를 미리 가져오면 메모리 스파이크가 발생할 것입니다.
그의 제안은 기존 GUID 전부를 가져오는 대신, SQL IN 절을 사용해 현재 피드 XML에 실제로 포함된 GUID만 가져오고, 한 배치당 1000개 항목으로 배치 처리하자는 것이었습니다.
프로파일링 데이터가 여기서도 중요한 역할을 했습니다. 수정이 코드에 대한 추측이 아닌 측정에 기반했기 때문에, 리뷰는 진단이 올바른지 여부가 아니라 이 접근 방식을 어떻게 안전하게 확장할 것인가에 관한 것이었습니다. 메모리 스파이크 우려는 메인테이너의 도메인 지식이 필요한 제약 조건이었고, 그래서 PR 프로세스는 의도된 대로 작동했습니다.
두 번째 라운드
저는 메인테이너의 리뷰를 Claude Code에 다시 전달했습니다. 에이전트는 메서드 시그니처를 findExistingGuids(Feed feed)에서 findExistingGuids(Feed feed, Set<String> guidHashes)로 변경하고, Lists.partition 배치 처리와 함께 IN 절을 추가했으며, 현재 처리 중인 항목들의 해시를 전달하도록 호출부를 업데이트했습니다. 또한 이미 채워진 피드를 새로 고쳐 중복 항목이 생성되지 않는지 검증하는 통합 테스트도 추가했습니다.
public Set<String> findExistingGuids(Feed feed, Set<String> guidHashes) {
    if (guidHashes.isEmpty()) {
        return Set.of();
    }
    Set<String> result = new HashSet<>();
    for (List<String> batch : Lists.partition(new ArrayList<>(guidHashes), IN_CLAUSE_BATCH_SIZE)) {
        result.addAll(query().select(ENTRY.guidHash)
            .from(ENTRY)
            .where(ENTRY.feed.eq(feed), ENTRY.guidHash.in(batch))
            .fetch());
    }
    return result;
}
업데이트를 푸시하기 전에 에이전트는 테스트를 다시 프로파일링했습니다. 단일 쿼리를 배치 처리된 IN 조회로 분할하면 원래의 개선 효과를 되돌리는 오버헤드가 다시 생길 수도 있었습니다. 측정 결과는 그렇지 않았습니다. 테스트한 피드에서 배치 버전은 원래의 단일 쿼리 방식과 비교해 몇 퍼센트 이내의 차이를 유지했고, 항목별 확인 횟수도 새로 더 낮아진 기준선을 그대로 유지했습니다. 이것은 런타임 데이터만이 확인해 줄 수 있는 부분이었습니다.
PR은 같은 날 병합되었습니다.
MCP가 없었다면 어떻게 되었을까
PR이 병합된 후 저는 에이전트에게 소스 코드만 가지고 작업했다면 무엇을 시도했을 것인지 물었습니다. 대답은 이렇습니다. 자연스러운 시도는 개별 삽입의 속도를 높이는 설정인 Hibernate 배치 삽입을 활성화하는 것이었을 것이라고 했습니다. 하지만 이 문제에는 아무런 효과가 없었을 것입니다. 병목은 쿼리 횟수였지 쿼리 속도가 아니었기 때문입니다. 에이전트는 잘못된 수정을 권했을 것입니다.
그다음 저는 짧은 사용 후기를 부탁했습니다. 에이전트의 표현을 그대로 인용하면 다음과 같습니다:
JProfiler의 JDBC 및 퍼시스턴스 프로브는 시간 측정만으로는 절대 드러나지 않는 패턴을 밝혀냈습니다. 바로 아무것도 변경되지 않았는데도 모든 새로 고침 주기마다 실행되는 항목별 중복 데이터베이스 확인이었습니다. 그 프로브 데이터가 없었다면 저는 완전히 엉뚱한 대상을 최적화하고 있었을 것입니다.
commafeed.com에서 피드를 새로 고칠 때마다 개발자의 리소스가 소모됩니다. 새로 고침 중 가장 비용이 큰 쿼리를 크게 줄이면 동일한 하드웨어에서 더 많은 사용자를 수용할 수 있습니다.
여러분의 코드에서 직접 시도해 보기
동일한 접근 방식은 모든 Java 애플리케이션에 적용됩니다. 모든 코드베이스에는 소스를 읽어서는 볼 수 없는 핫스팟이 있습니다. DAO 뒤에 숨어 있는 N+1 쿼리, 수백만 개의 수명이 짧은 객체를 할당하는 직렬화기, HTTP 클라이언트 깊숙이 숨어 있어 외부 호출을 조용히 세 배로 늘려 버리는 재시도 정책이 그 예입니다. 코드를 읽어서는 찾을 수 없고, 런타임 데이터만이 찾아 줍니다.
설정은 명령 하나로 끝납니다. 여러분의 AI 에이전트를 애플리케이션에 연결하고 시간이 어디에 소모되는지 물어보시기 바랍니다. JProfiler MCP 페이지에 Claude Code, Cursor, Codex 및 기타 모든 MCP 호환 도구를 위한 안내가 있습니다.