

Java vs. Kotlin: 누가 (역)직렬화를 더 빠르게 할 수 있을까?
이전 포스트에서 저는 Java 직렬화 프레임워크들을 프로파일링했고, Apache Fory가 Java 직렬화와 그 밖의 경쟁 기술들을 큰 격차로 앞선다는 사실을 확인했습니다. 이 덕분에 Kotlin 프레임워크들은 어떤 비교 결과를 보일지에 대한 관심이 생겼습니다. Kotlin 생태계에는 자체적인 직렬화 라이브러리들이 있는데, 가장 대표적인 것은 컴파일 타임 코드 생성을 제공하는 JetBrains의 공식 라이브러리인 kotlinx.serialization과 KSP 기반 어댑터 생성을 제공하는 Moshi입니다. 과연 생성된 코드가 Jackson 같은 리플렉션 중심의 Java 방식들을 능가할까요?
이를 알아보기 위해 비교 프로젝트에 동등한 Kotlin 데이터 모델을 추가하고 JProfiler로 왕복 처리를 프로파일링했습니다. 결론부터 말하면 모델 클래스의 언어는 그다지 중요하지 않습니다. 다만 정말 놀라운 발견들이 몇 가지 있었습니다.
측정 결과
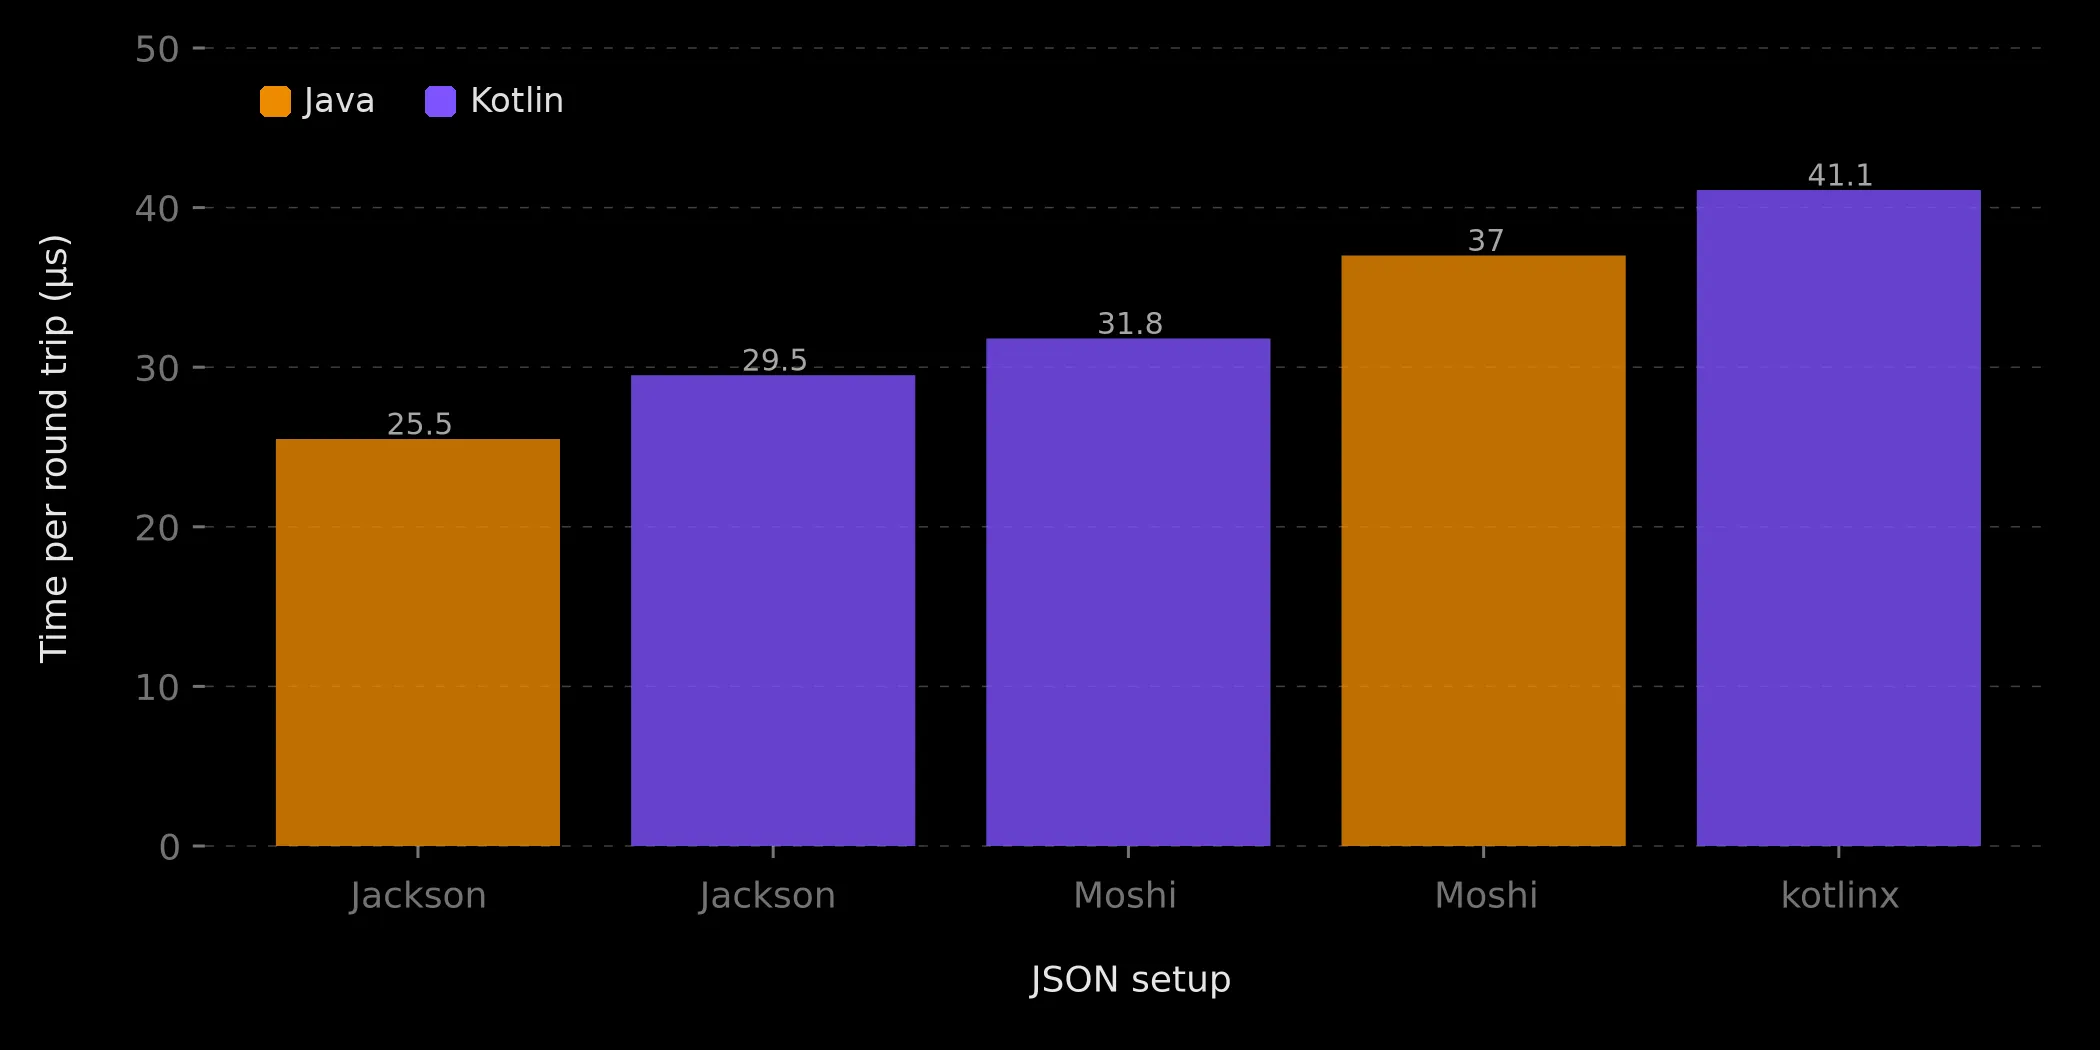
페이로드는 지난번과 동일합니다. 공유 참조, 컬렉션, 맵, enum, BigDecimal, 바이트 배열을 포함하는 현실적인 객체 그래프이며, JDK 25에서 200만 회의 직렬화 및 역직렬화 왕복을 수행했습니다. Kotlin 라이브러리들은 Kotlin 데이터 클래스를 대상으로 작동하고, Jackson Kotlin 행에는 jackson-module-kotlin이 추가되며, Java 행들은 동등한 Java 빈 모델을 사용합니다. 먼저 JSON 설정들입니다:
| 설정 | 언어 | 왕복당 소요 시간 | 페이로드 크기 | 비고 |
|---|---|---|---|---|
| Jackson JSON | Java | 25.5 µs | 9,814바이트 | 가장 빠른 JSON 엔진 |
| Jackson JSON | Kotlin | 29.5 µs | 9,814바이트 | Kotlin 생성자 바인딩에 따른 16% 오버헤드 |
| Moshi JSON | Kotlin | 31.8 µs | 9,760바이트 | KSP로 생성된 어댑터 |
| Moshi JSON | Java | 37.0 µs | 9,760바이트 | 리플렉션 기반 어댑터 |
| kotlinx JSON | Kotlin | 41.1 µs | 9,769바이트 | 포맷 중립적 프로토콜 |
두 번째는 바이너리 포맷입니다:
| 설정 | 언어 | 왕복당 소요 시간 | 페이로드 크기 | 비고 |
|---|---|---|---|---|
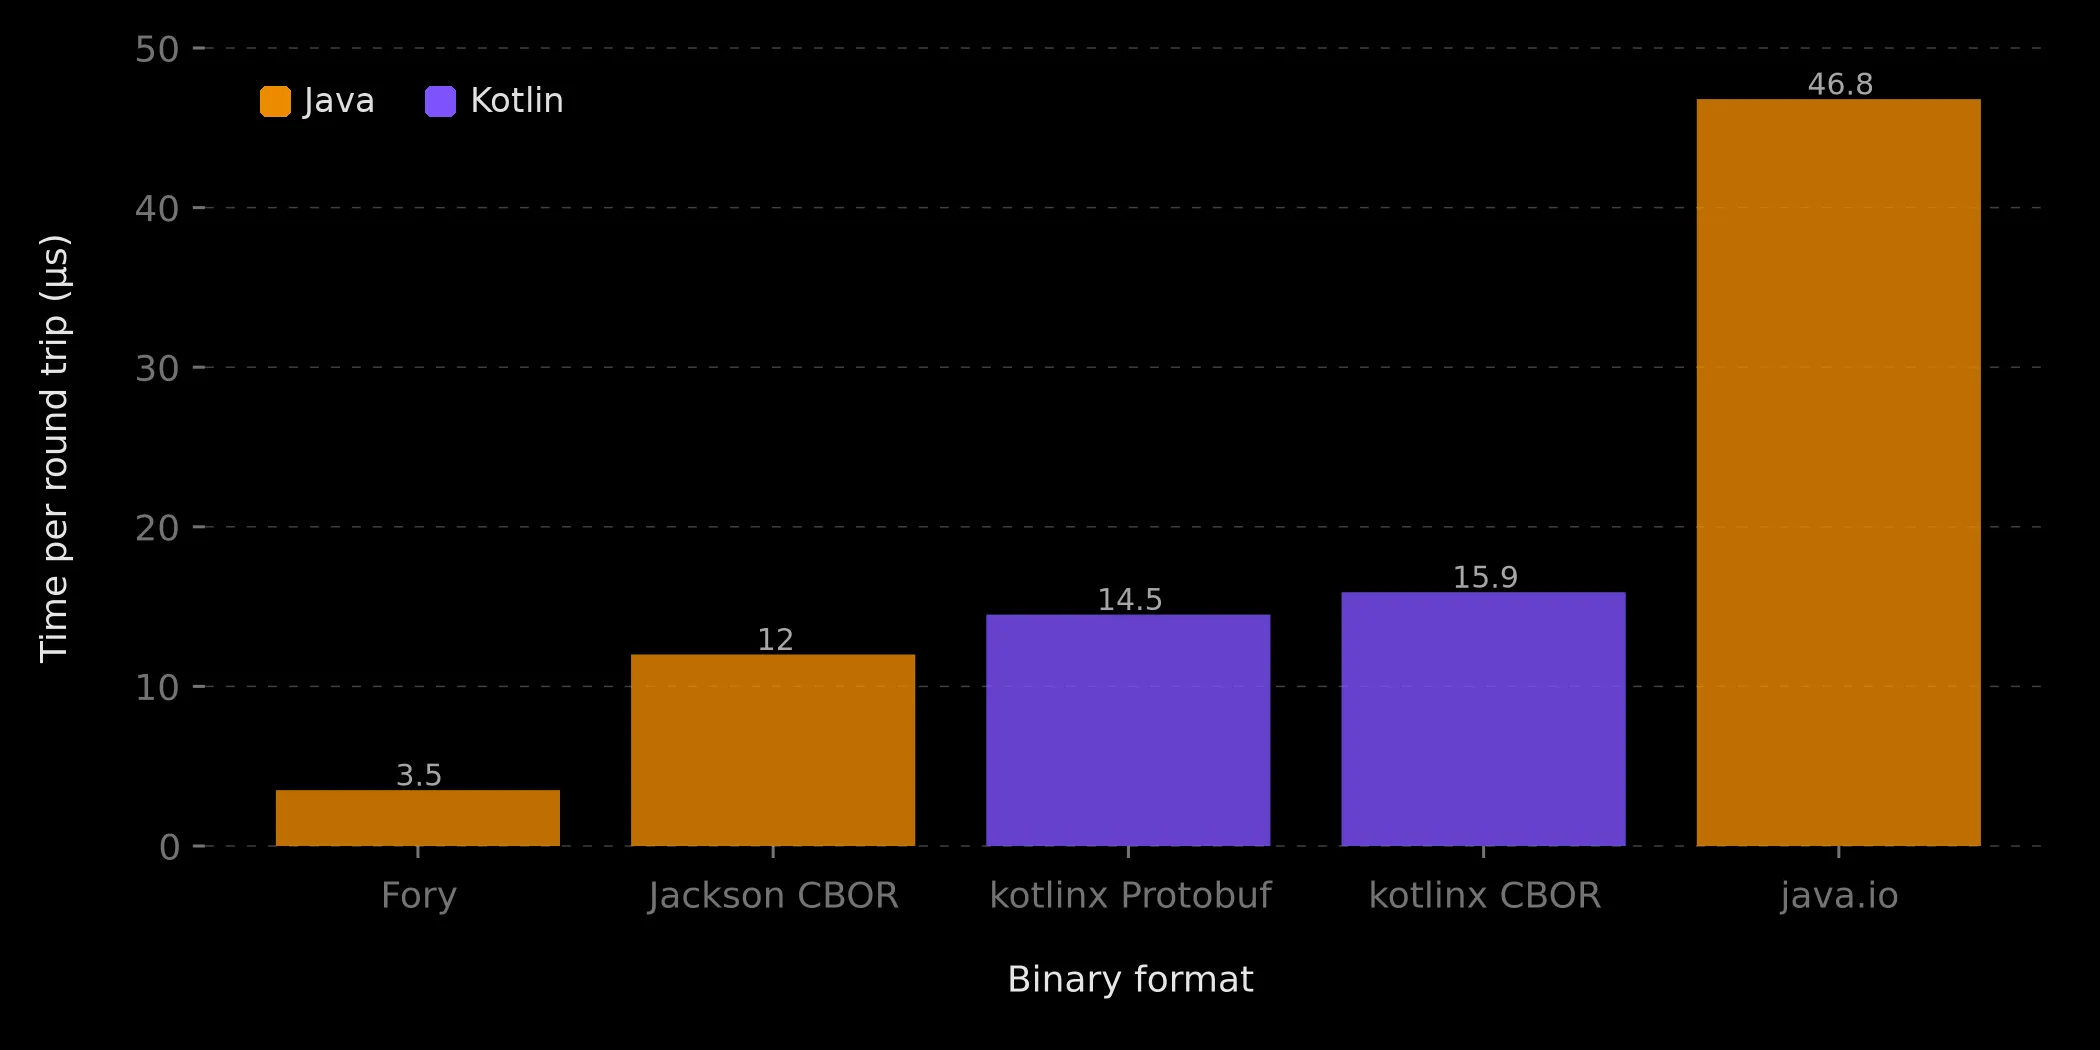
| Fory | Java / Kotlin | 3.5 µs / 3.6 µs | 7,502 / 7,620바이트 | Kotlin은 테스트 클래스 이름이 약간 더 깁니다 |
| Jackson CBOR | Java | 12.0 µs | 7,819바이트 | |
| kotlinx Protobuf | Kotlin | 14.5 µs | 7,155바이트 | 가장 작은 페이로드, 이름 대신 필드 번호 사용 |
| kotlinx CBOR | Kotlin | 15.9 µs | 7,797바이트 | |
| java.io | Java | 46.8 µs | 9,152바이트 | JDK의 기본 바이너리 포맷 |
JSON 챔피언은 Jackson
정말 놀라웠던 점은 컴파일 타임 코드 생성을 갖춘 kotlinx.serialization이 이번 비교 전체에서 가장 느린 JSON 백엔드를 기록했다는 것입니다. 심지어 jackson-kotlin 실행과 비교했을 때조차, Jackson의 리플렉션 기반 데이터 바인딩에 밀렸습니다.
두 번째 예상 밖의 결과: Kotlin(JVM)에서 JSON 직렬화가 필요하다면 jackson-kotlin 모듈을 통한 Jackson이 최선의 선택입니다. KotlinValueInstantiator.createFromObjectWith(7.3%)와 ValueCreator.getValueParameters(3.3%) 때문에 Java 모델보다 약 16% 느립니다. 이는 파라미터 이름, null 안전성, 기본값을 활용하는 Kotlin 방식의 인스턴스화에 따르는 대가입니다.
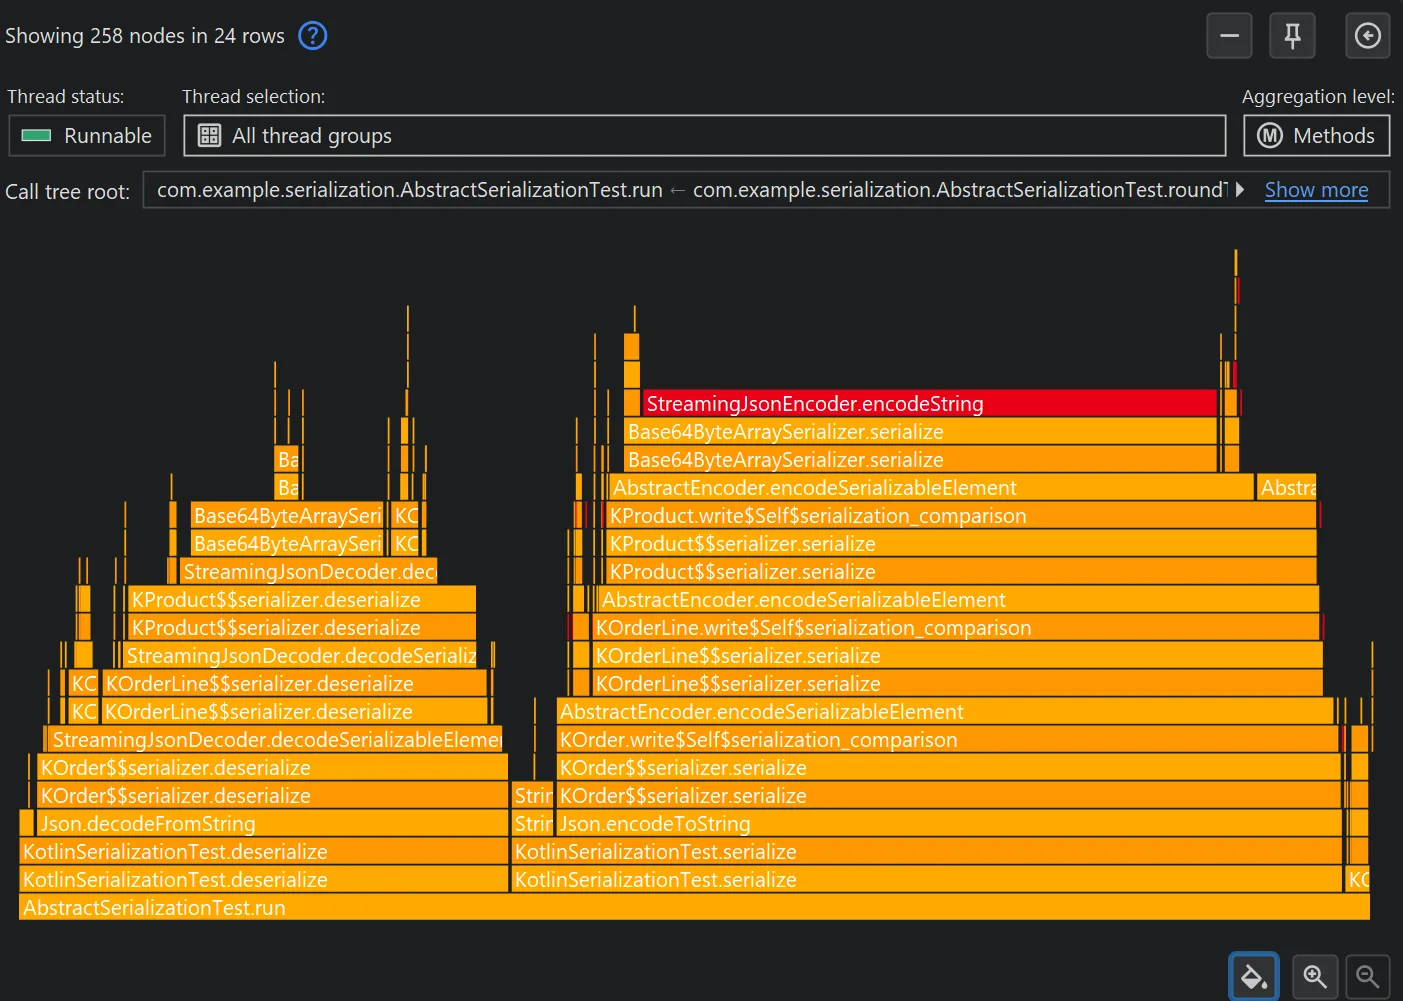
Jackson은 왜 그렇게 빠를까요? 몇 가지 이유가 합쳐져 이러한 결과를 만들어냅니다. 그중 하나는 테스트에서 사용하는 페이로드의 성격과 관련이 있습니다. JSON에는 바이너리 타입이 없으므로 테스트 데이터의 바이트 배열은 base64로 인코딩되어야 합니다. JSON 엔진들이 가장 크게 갈리는 지점이 바로 여기입니다:
- Jackson은 base64를 UTF-8 출력 버퍼에 직접 인코딩합니다.
- Moshi는 base64 문자열을 만든 뒤 이스케이프 처리를 위해 이를 검사하고, 그다음 UTF-8로 씁니다.
- kotlinx.serialization도 같은 다중 패스 작업을 수행하며, 먼저 전체 JSON 문서를
String으로 만든 후 바이트로 변환합니다.
코드 생성만으로는 부족합니다
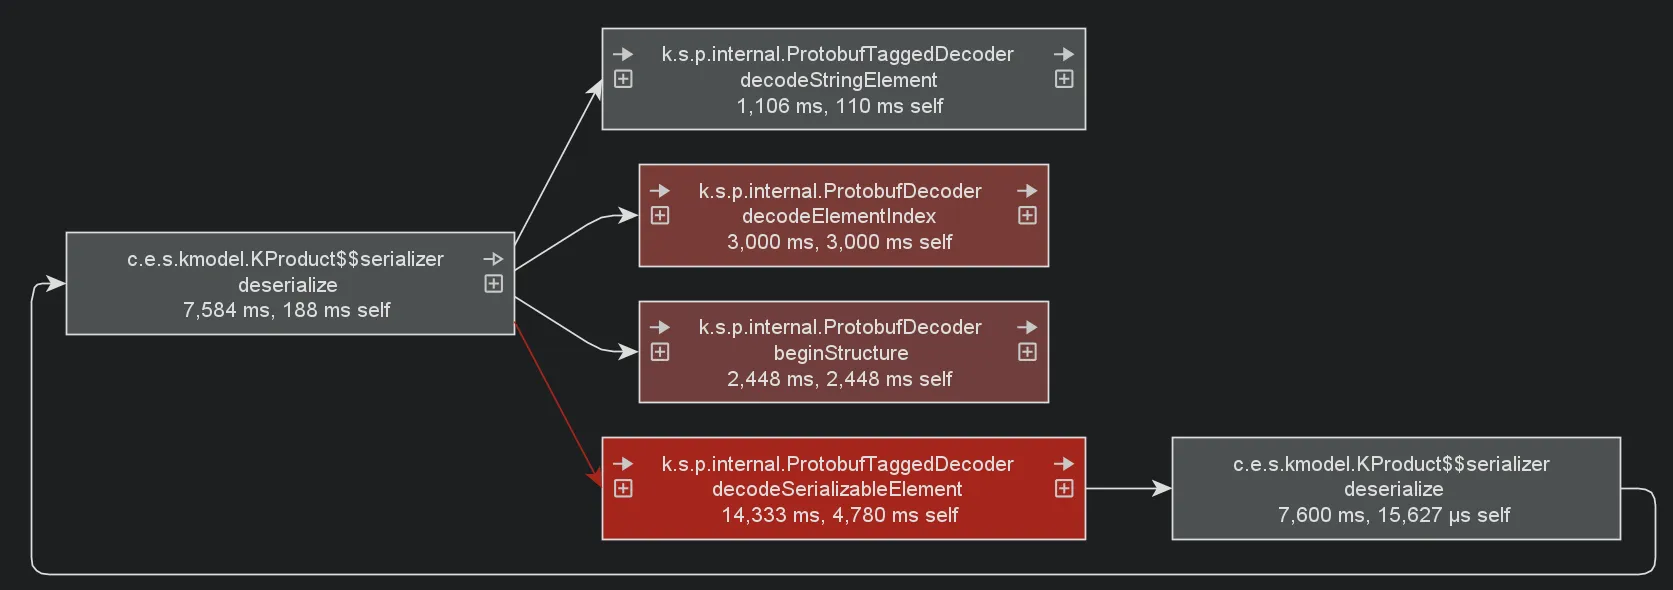
kotlinx.serialization은 컴파일 타임에 클래스마다 직렬화기를 생성하는데도 느립니다. 프로파일링 데이터에서 그 이유를 분명히 확인할 수 있습니다: 생성된 직렬화기는 포맷 중립적인 Encoder와 Decoder 프로토콜을 대상으로 작성됩니다. 모든 객체는 디스크립터를 동반한 beginStructure를 거치고, 모든 필드는 decodeElementIndex와 요소별 인코딩 및 디코딩 호출을 거칩니다. 또한 매 왕복마다 새로운 인코더와 디코더 인스턴스가 할당됩니다.
이 프로토콜 비용을 가장 깔끔하게 측정할 수 있는 것은 Protobuf 백엔드입니다. protobuf의 와이어 포맷은 최소한이기 때문입니다: 필드 번호와 네이티브 바이너리 데이터만 있을 뿐입니다. 이 실행에서 생성된 역직렬화기에 소요된 시간의 약 40%는 디코더 메커니즘에서 비롯됩니다: decodeElementIndex만으로 24.7%를 차지하고 beginStructure가 15.5%를 차지합니다. 실제 데이터 이동은 그 이후에는 Fory 수준까지 내려옵니다.
그러므로 kotlinx.serialization은 컴파일 타임에, Fory는 런타임에 코드를 만들지만, 이는 성능에는 큰 영향을 주지 않습니다. 중요한 차이는 kotlinx.serialization은 추상적인 직렬화기를 만드는 반면 Fory는 포맷 특화 직렬화기를 만든다는 점입니다. 와이어 포맷을 직접 생성하느냐가 결정적인 차이를 만듭니다.
물론 이렇게 말한다고 해서 코드 생성이 성능에 전혀 중요하지 않다는 뜻은 아닙니다. 유일한 차이가 코드 생성이냐 리플렉션이냐라면, 그 차이는 실제로 중요합니다.
Kotlin 모델에서 Moshi는 KSP로 생성된 어댑터를 사용해 JSON을 직접 작성합니다. Java 모델에서 Moshi는 리플렉션 기반 필드 어댑터를 사용하며, 이는 Kotlin 모델의 생성된 어댑터보다 16% 느립니다.
kotlinx.serialization의 장점
이런 수치들이 kotlinx.serialization에 크게 유리하지는 않지만, 이 라이브러리에는 매력적인 점이 많고 저 역시 그런 이유로 애용하는 사용자입니다.
kotlinx.serialization에는 훨씬 나은 성능의 CBOR 및 Protobuf 백엔드가 포함되어 있습니다: Protobuf는 14.5 µs로 이번 비교 전체에서 가장 작은 페이로드(7,155바이트)를 기록했고 CBOR는 15.9 µs입니다. CBOR 디코더는 필드 이름마다 HashMap 조회를 수행하고(실행 시간의 11%), 이는 CBOR가 자기 서술형 포맷이라 필드 이름을 기록하는 반면 protobuf는 필드 번호만 사용하기 때문입니다.
첫째, 포맷 중립적 프로토콜은 버그가 아니라 기능입니다. 클래스에 @Serializable을 붙이면 JSON, CBOR, Protobuf와 그 밖의 서드파티 포맷에서 모두 작동합니다. 둘째, JVM, Android, iOS, 브라우저, 심지어 네이티브 코드에서도 작동합니다. Fory의 런타임 코드 생성은 JVM 전용 메커니즘입니다.
Kotlin Multiplatform이 필요하고 모델을 바꾸지 않은 채 포맷을 전환하고 싶다면 kotlinx.serialization이 유일한 선택지이며, 그 바이너리 백엔드들도 상당히 빠릅니다. 다만 순수한 속도를 위해서라면 JSON 백엔드는 선택하지 마세요.
Kotlin을 위한 라이브러리 선택
- JVM에서 순수한 속도를 원한다면, Fory는 Kotlin 데이터 클래스에서 Java 클래스에서와 똑같이 잘 작동합니다. 그리고 어떤 어노테이션도 전혀 필요하지 않습니다.
- JVM에서 JSON을 사용한다면
jackson-module-kotlin을 갖춘 Jackson이 가장 빠른 선택으로, null 안전성과 기본값에 대해 16%의 Kotlin 오버헤드가 붙습니다. KSP 코드 생성을 갖춘 Moshi는 근소한 차이로 뒤따르는 훌륭한 대안입니다. - Kotlin Multiplatform이라면 kotlinx.serialization이 기본 선택입니다. 해당되는 경우 더 빠른 CBOR와 Protobuf 백엔드를 활용할 수 있습니다.
측정 방법
측정 환경은 이전 포스트와 동일했습니다: JProfiler Gradle 플러그인이 오프라인 모드에서 설정별로 스냅샷을 하나씩 기록했고, CPU 샘플링과 할당 기록은 별도의 실행에서 진행되었습니다. 코딩 에이전트가 핫 스팟 분석을 위해 JProfiler MCP 서버를 구동했습니다. 전체 프로젝트는 GitHub에서 확인할 수 있습니다.
스냅샷을 직접 살펴보려면 JProfiler를 다운로드한 후 build/snapshots-cpu의 .jps 파일을 열면 됩니다.