

Java 与 Kotlin:谁能更快地(反)序列化?
在上一篇文章中,我对 Java 序列化框架进行了性能分析,发现 Apache Fory 以巨大优势击败了 Java 原生序列化和其他竞争者。这让一些人开始关注一个问题:Kotlin 的框架相比之下表现如何。Kotlin 生态拥有自己的序列化库,最著名的是具备编译期代码生成能力的 JetBrains 官方库 kotlinx.serialization,以及采用基于 KSP 的适配器生成的 Moshi。生成代码想必会胜过 Jackson 这类重度依赖反射的 Java 方案吧?
为了弄清答案,我扩展了这个对比项目,加入了一个等价的 Kotlin 数据模型,并用 JProfiler 对序列化往返进行了性能分析。结论是:模型类使用哪种语言编写,影响并不大。不过,其中有一些非常出人意料的发现。
具体数据
负载与上次相同:一个贴近真实场景的对象图,包含共享引用、集合、映射、枚举、BigDecimal 和字节数组,在 JDK 25 上进行两百万次序列化与反序列化往返。各 Kotlin 库作用于 Kotlin 数据类,Jackson Kotlin 行额外加入了 jackson-module-kotlin,Java 行则使用等价的 Java bean 模型。首先是各 JSON 配置:
| 配置 | 语言 | 单次往返耗时 | 负载大小 | 说明 |
|---|---|---|---|---|
| Jackson JSON | Java | 25.5 µs | 9,814 字节 | 最快的 JSON 引擎 |
| Jackson JSON | Kotlin | 29.5 µs | 9,814 字节 | Kotlin 构造器绑定带来的 16% 开销 |
| Moshi JSON | Kotlin | 31.8 µs | 9,760 字节 | KSP 生成的适配器 |
| Moshi JSON | Java | 37.0 µs | 9,760 字节 | 反射式适配器 |
| kotlinx JSON | Kotlin | 41.1 µs | 9,769 字节 | 与格式无关的协议 |
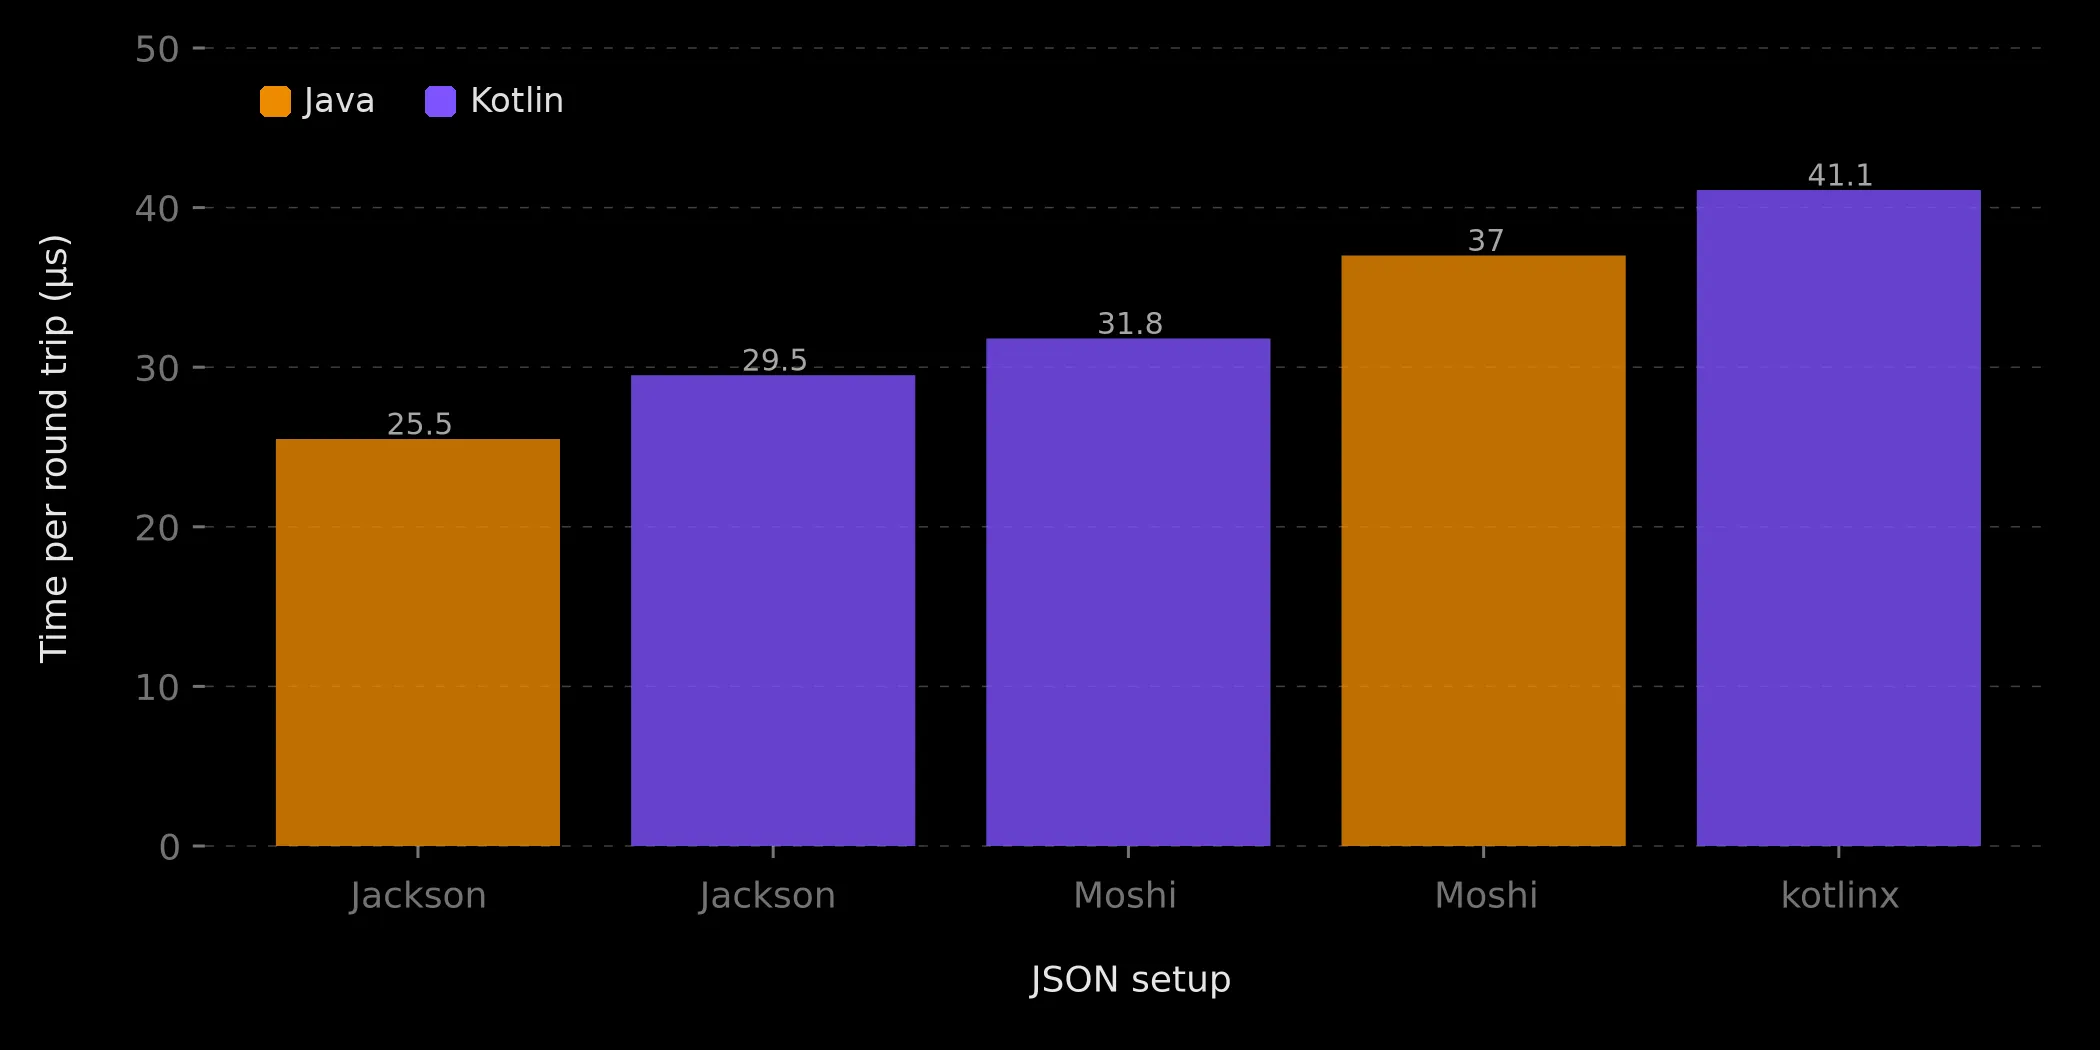
其次是二进制格式:
| 配置 | 语言 | 单次往返耗时 | 负载大小 | 说明 |
|---|---|---|---|---|
| Fory | Java / Kotlin | 3.5 µs / 3.6 µs | 7,502 / 7,620 字节 | Kotlin 的测试类名稍长一些 |
| Jackson CBOR | Java | 12.0 µs | 7,819 字节 | |
| kotlinx Protobuf | Kotlin | 14.5 µs | 7,155 字节 | 负载最小,以字段编号代替字段名 |
| kotlinx CBOR | Kotlin | 15.9 µs | 7,797 字节 | |
| java.io | Java | 46.8 µs | 9,152 字节 | JDK 默认的二进制格式 |
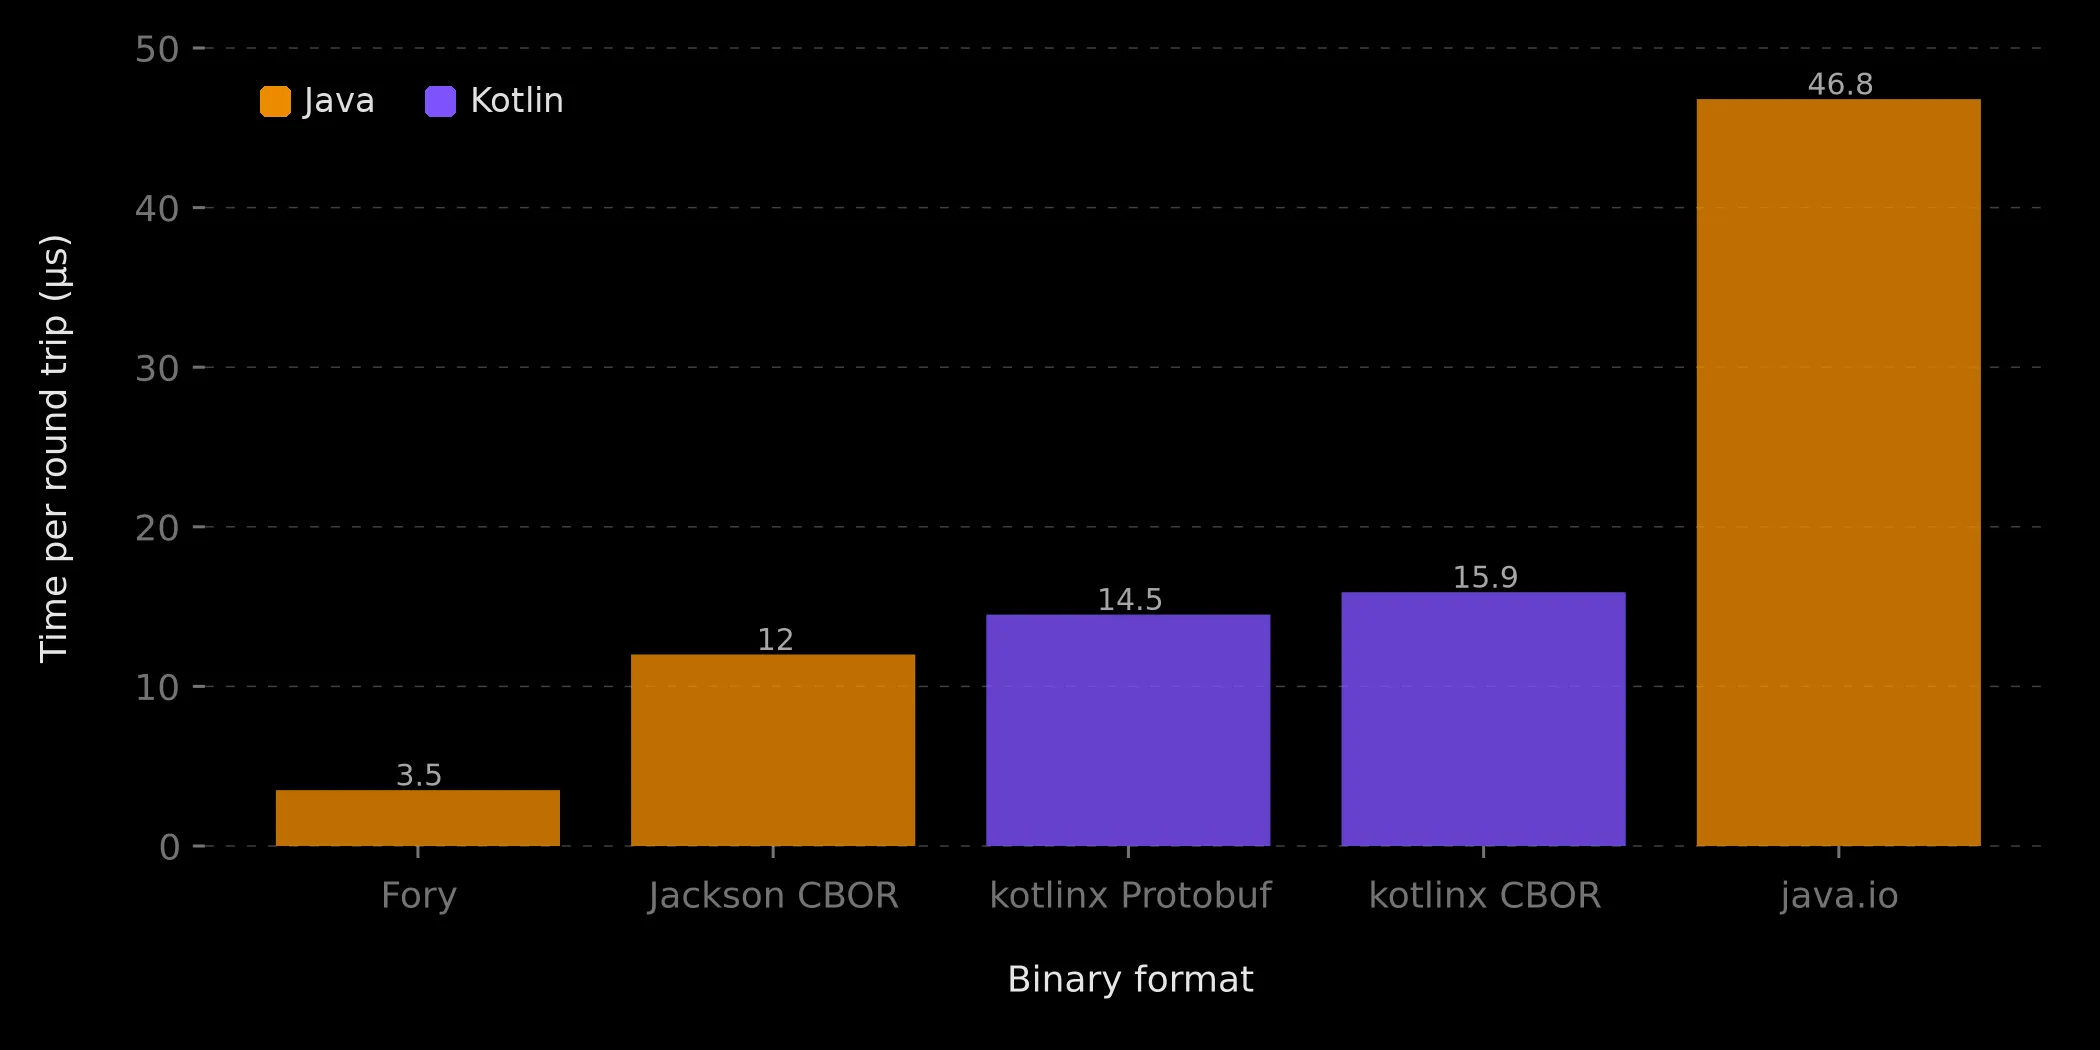
Jackson 是 JSON 冠军
真正让我感到意外的是,拥有编译期代码生成能力的 kotlinx.serialization,竟然是整个对比中最慢的 JSON 后端。它输给了 Jackson 基于反射的数据绑定,甚至不及 jackson-kotlin 那一轮的运行结果。
第二个意外结果:如果你需要在 Kotlin(JVM)上进行 JSON 序列化,那么 Jackson 借助其 jackson-kotlin 模块便是首选。它比 Java 模型慢约 16%,原因在于 KotlinValueInstantiator.createFromObjectWith(7.3%)和 ValueCreator.getValueParameters(3.3%)。这就是按照 Kotlin 的方式——利用参数名、空安全和默认值——进行实例化的代价。
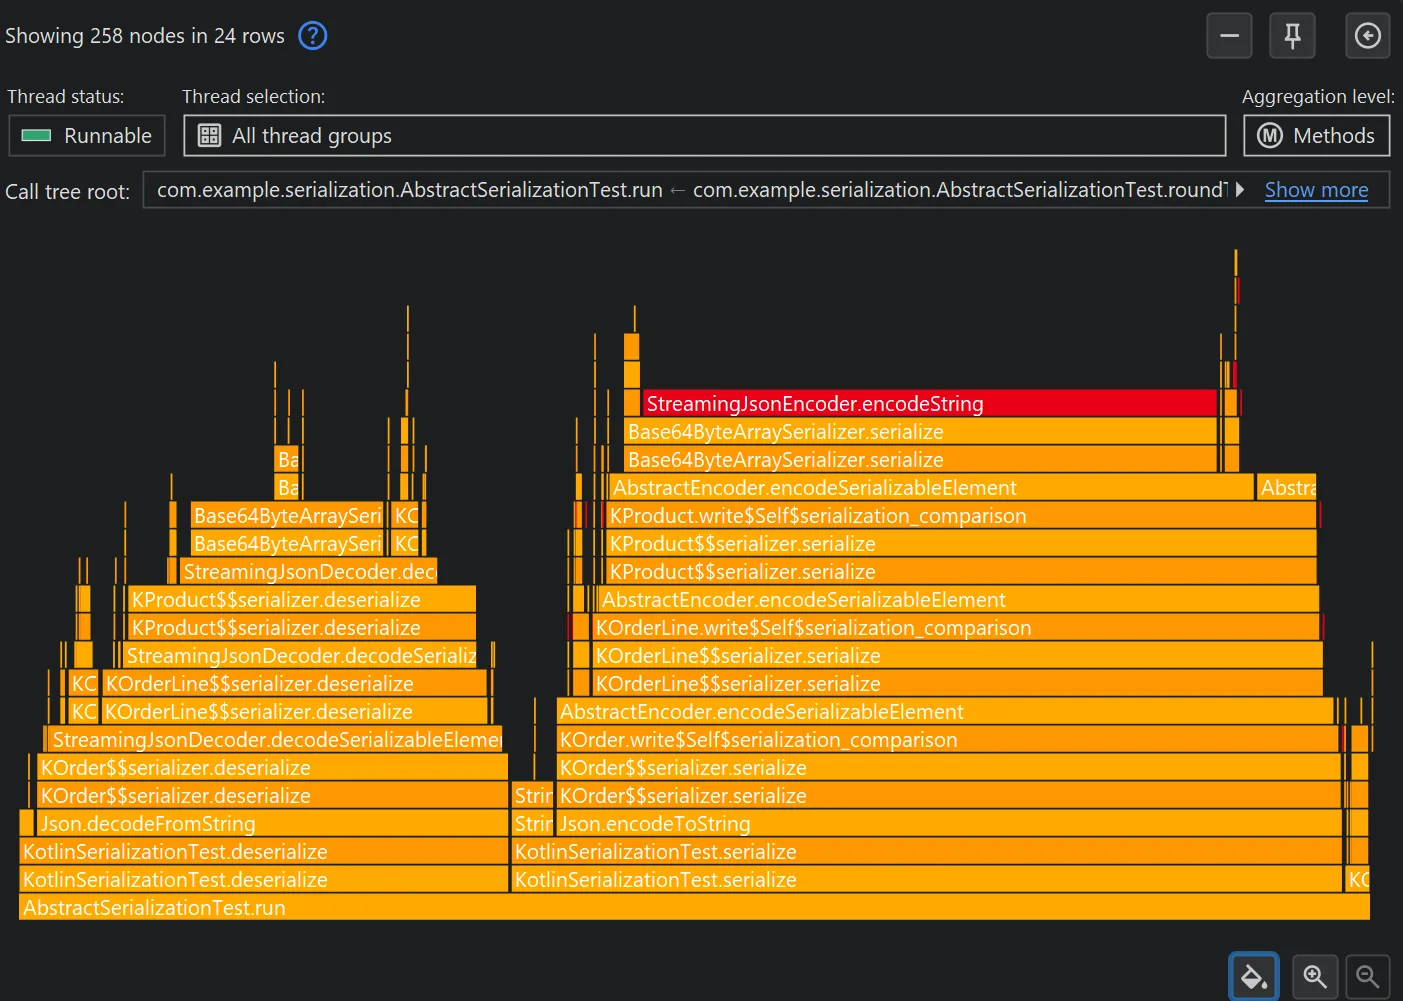
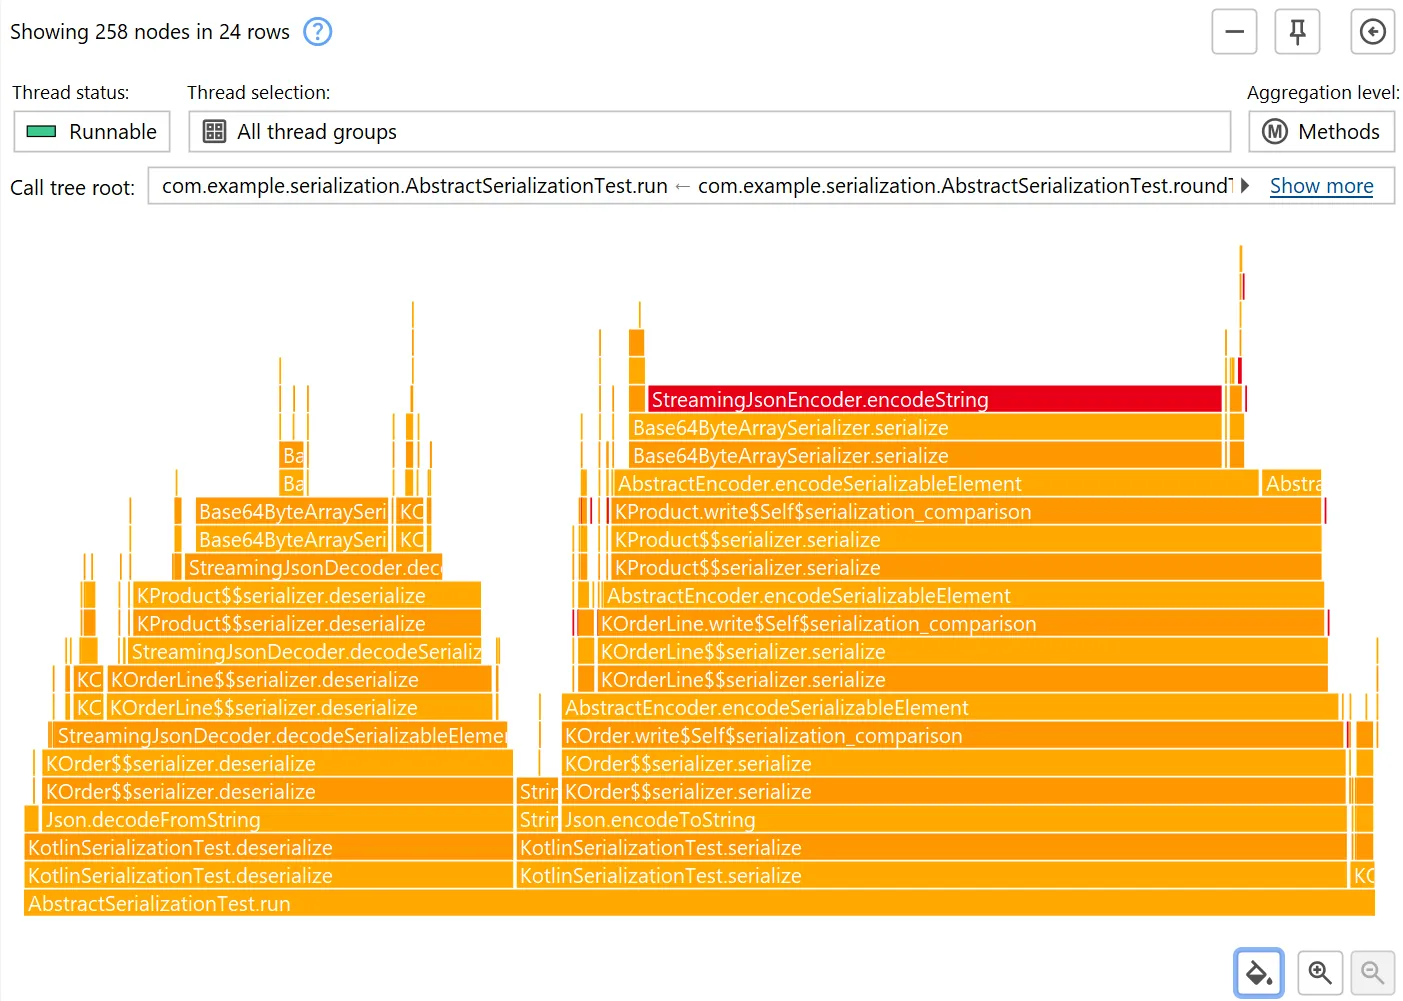
Jackson 为什么这么快?有几个原因叠加起来造就了这一结果。其中一点与我们在测试中使用的负载类型有关:JSON 没有二进制类型,因此测试数据中的字节数组必须进行 base64 编码。这正是各 JSON 引擎差异最大的地方:
- Jackson 将 base64 直接编码进其 UTF-8 输出缓冲区。
- Moshi 先创建 base64 字符串,再扫描它以处理转义,然后写入 UTF-8。
- kotlinx.serialization 做了同样的多趟处理,而且首先将整个 JSON 文档构建为一个
String,之后再转换成字节。
仅有代码生成还不够
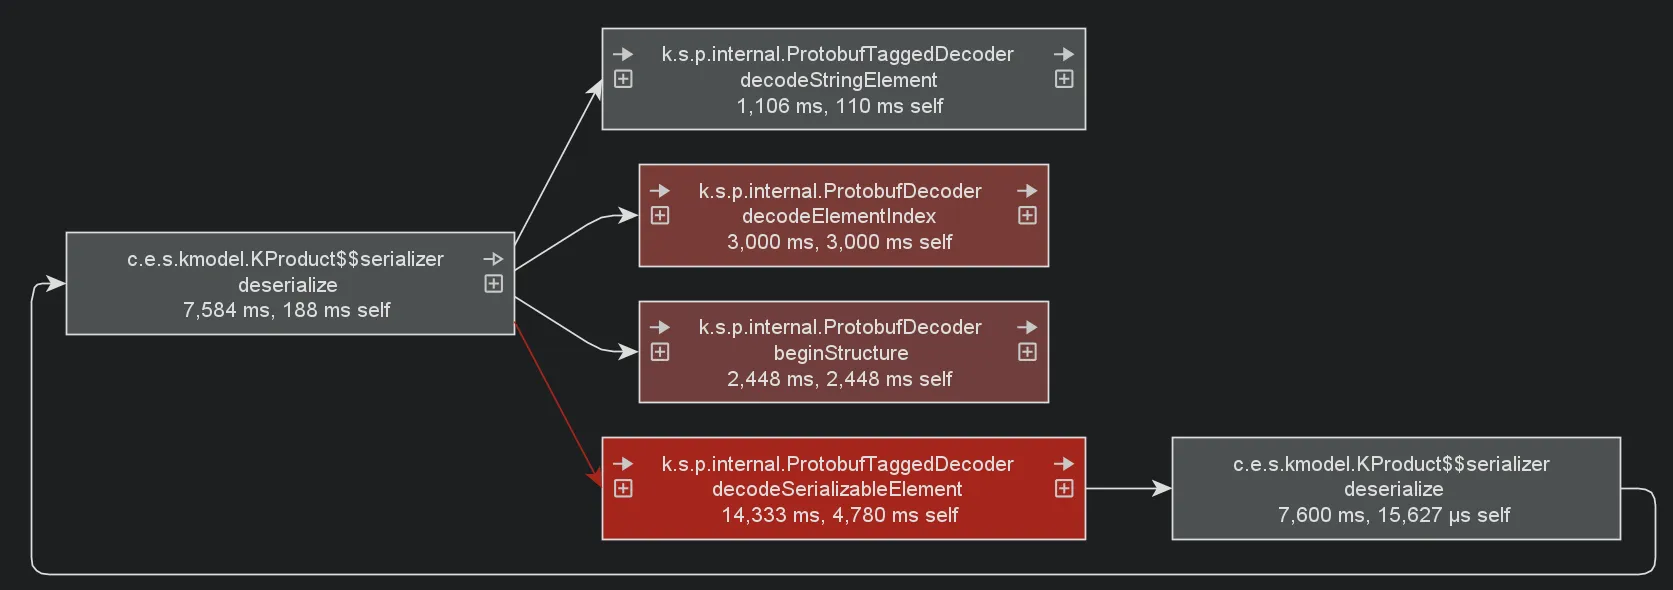
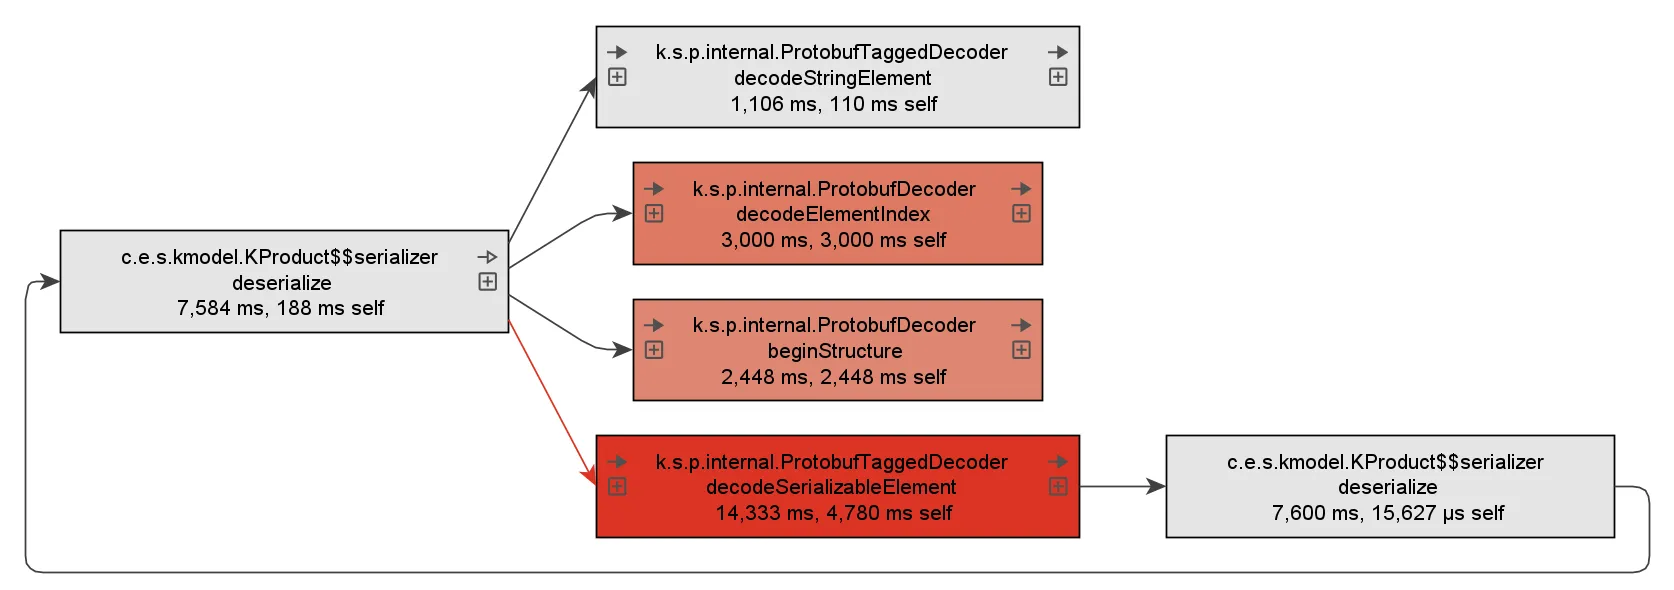
kotlinx.serialization 在编译期为每个类生成序列化器,但它仍然很慢。性能分析数据清楚地揭示了原因:生成的序列化器面向的是与格式无关的 Encoder 和 Decoder 协议。每个对象都要经过带有描述符的 beginStructure,每个字段都要经过 decodeElementIndex 以及逐元素的编码和解码调用。此外,每次往返都会重新分配全新的编码器和解码器实例。
衡量这项协议开销最干净的方式是看 Protobuf 后端,因为 protobuf 的传输格式极其精简:只有字段编号和原生二进制数据。在该轮运行中,生成的反序列化器所耗费的时间约有 40% 来自解码器机制:仅 decodeElementIndex 一项就占 24.7%,beginStructure 占 15.5%。实际的数据搬运则降到了 Fory 的量级。
所以说,kotlinx.serialization 在编译期构建代码,Fory 在运行期构建代码,但这一点对性能并无影响。关键区别在于:kotlinx.serialization 构建的是抽象序列化器,而 Fory 构建的是面向特定格式的序列化器。直接生成传输格式,才是决定性的差别。
这并不是说代码生成对性能毫不重要。如果唯一的差别就是代码生成与反射,那么它确实会有影响。
在 Kotlin 模型中,Moshi 使用 KSP 生成的适配器直接写入 JSON。在 Java 模型中,Moshi 使用反射式字段适配器,比 Kotlin 模型中的生成适配器慢 16%。
kotlinx.serialization 的优势
虽然这些数字对 kotlinx.serialization 并不有利,但它确实有不少过人之处,正因如此,我自己就是它的重度用户。
kotlinx.serialization 自带性能好得多的 CBOR 和 Protobuf 后端:Protobuf 以 14.5 µs 取得了整个对比中最小的负载(7,155 字节),CBOR 则为 15.9 µs。CBOR 解码器要为每个字段名执行一次 HashMap 查找(占该轮运行的 11%),因为 CBOR 是自描述格式,会写入字段名,而 protobuf 只使用字段编号。
首先,与格式无关的协议不是缺陷,而是特性。只要用 @Serializable 注解一个类,它就能配合 JSON、CBOR、Protobuf 以及其他第三方格式使用。其次,它可以运行在 JVM、Android、iOS、浏览器中,甚至可以在原生代码中运行。Fory 的运行期代码生成则是 JVM 专属的机制。
如果你需要 Kotlin Multiplatform,并且希望在不改动模型的前提下切换格式,kotlinx.serialization 是唯一的选择,而且其二进制后端的速度也相当可观。只是不要为了追求极致速度而选择它的 JSON 后端。
为 Kotlin 选择序列化库
- 如果追求 JVM 上的纯粹速度,Fory 处理 Kotlin 数据类的效果与处理 Java 类完全相同,而且完全不需要任何注解。
- 如果要在 JVM 上使用 JSON,搭配
jackson-module-kotlin的 Jackson 是最快的选项,只需为空安全和默认值支付 16% 的 Kotlin 代价。采用 KSP 代码生成的 Moshi 紧随其后,表现同样不俗。 - 对于 Kotlin Multiplatform,kotlinx.serialization 是默认选择。在适用的情况下,还可以选用更快的 CBOR 和 Protobuf 后端。
测量方法
测量设置与上一篇文章相同:JProfiler Gradle 插件在离线模式下为每种配置各记录一个快照,CPU 采样和内存分配记录分别在不同运行中进行。热点分析由一个编码代理驱动 JProfiler MCP 服务器 完成。完整项目见 GitHub。
如果想亲自查看这些快照,请下载 JProfiler,然后打开 build/snapshots-cpu 目录中的 .jps 文件。