

JProfiler, 힙 덤프를 AI 에이전트에 유용하게 만들다
JProfiler 16.3은 자체 MCP 서버를 통해 모든 주요 JProfiler 서브시스템을 AI 에이전트에 제공합니다. 그중 가장 유용한 추가 기능 중 하나가 힙 덤프 분석입니다. 이제 에이전트는 힙 내 객체들을 검사하고 참조를 따라가며 가비지 컬렉션되지 않은 이유를 파악할 수 있습니다.
런타임 데이터가 없으면 AI 에이전트는 어떤 객체가 살아 있는지, 무엇이 그 객체들을 도달 가능한 상태로 유지하는지 볼 수 없습니다. JProfiler는 이 간극을 메워서 에이전트가 실제 증거에서 출발해 관련 소스 코드를 찾아낼 수 있게 해 줍니다.
실제 지원 사례
16.3 출시 직후, 다른 제품인 install4j에 대해 업데이트 확인 중 메모리 누수가 발생한다는 지원 티켓을 접수했습니다. 고객은 JVM이 메모리를 모두 사용했을 때 기록된 HPROF 힙 덤프를 첨부했습니다. 우리는 에이전트에게 이 문제를 조사하고 가능하면 수정해 달라고 요청했습니다. 이 에이전트는 새로운 JProfiler MCP 서버를 포함해 여러 MCP 서버를 사용할 수 있었습니다.
이 애플리케이션은 프로세스 내에서 install4j 업데이트 다운로더를 호출하는 방식으로 반복적인 업데이트 확인을 수행하는 백그라운드 프로세스였습니다. 최대 힙 크기는 64 MB였습니다. 결국 반복된 업데이트 확인이 가용 메모리를 소진시켜 애플리케이션이 실패했습니다.
흔히 그렇듯이, 수정 자체는 작았지만 찾아내기는 어려웠습니다. 이번 조사는 런타임 데이터로 소스 코드 검토의 방향을 잡아 가는 전형적인 사례였습니다. 이 이야기는 다섯 단계로 나누어 볼 수 있습니다:
기술적 세부 사항
에이전트에게 필요한 MCP 도구는 load_snapshot, check_status, query 세 가지뿐이었습니다. 처음 두 도구는 스냅샷을 로드하고 사용 가능한 데이터셋을 알려 줍니다. query 도구는 프로파일링 데이터를 다루기 위한 로우코드 모드를 제공합니다. 각 데이터셋은 JSON으로 표현됩니다. 에이전트는 JSON용 쿼리 언어인 jq 표현식을 지정해 필요한 데이터를 선택하고 간결한 결과로 변환합니다. 필터링, 정렬, 프로젝션은 JProfiler에서 수행되므로 이 결과만 에이전트에 반환됩니다.
힙 덤프 로드하기
load_snapshot은 JProfiler 스냅샷, HPROF 힙 덤프, JFR 기록을 지원합니다. 스냅샷 로드는 비동기적으로 수행됩니다. 에이전트는 check_status를 호출해 데이터가 준비되었는지, 어떤 데이터셋과 작업을 사용할 수 있는지 확인합니다.
HPROF 힙 덤프는 애플리케이션 실행 중 프로파일링 에이전트가 필요 없다는 점에서 특히 유용합니다. 실행 중인 HotSpot JVM에서 jcmd로 힙 덤프를 생성하거나, 애플리케이션 명령줄에 -XX:+HeapDumpOnOutOfMemoryError VM 인자를 추가해 OutOfMemoryError 발생 시 힙 덤프가 자동으로 기록되게 할 수 있습니다.
이 HPROF 파일의 카탈로그에는 클래스 히스토그램, 가장 큰 객체, 인스턴스, 크기, 검사용 힙 데이터셋이 들어 있었습니다. 덤프에는 총 크기 63 MiB의 객체 1,385,451개가 담겨 있었습니다. 일반 HPROF 파일에는 할당 스택 트레이스나 성능 기록이 없으므로, 분석은 덤프에 캡처된 객체 그래프에서 출발해야 했습니다.
반복된 인스톨러 실행 찾기
에이전트는 heap.classes 데이터셋에서 시작해 com.install4j 패키지로 필터링했습니다. 초기 결과와 이어진 전체 힙 쿼리에서 인스톨러 UI 객체와 구성 객체가 놀랄 만큼 많이 축적되어 있음이 드러났습니다:
| 클래스 | 인스턴스 수 |
|---|---|
InstallerWizardScreenExecutor |
34 |
InstallerContextImpl |
34 |
DeferredDocumentImpl |
34 |
FormPanel |
198 |
ActionBeanConfig |
2,686 |
일치하는 개수들은 이 객체들이 반복된 인스톨러 실행에서 비롯된 것임을 보여 주었습니다. 프로세스 내 실행마다 executor, 인스톨러 컨텍스트, 파싱된 구성 문서가 생성됩니다. 현재 실행의 객체만 남아 있어야 했지만, 실제로는 34회분의 완전한 인스톨러 실행이 여전히 보존되어 있었습니다.
heap.biggestObjects 데이터셋이 또 하나의 단서를 제공했습니다: 다수의 인스톨러 컨텍스트가 정확히 74,800바이트의 리테인드 크기를 가지고 있었습니다. 이렇게 동일한 리테인드 크기가 반복되면 보통 동일한 객체 그래프가 여러 번 복사되었음을 나타냅니다. 또한 파싱된 XML 문서 34개 각각이 700~750 KB를 보존하고 있었습니다.
GC 루트까지의 경로 추적
수상한 객체를 찾는 것은 첫 번째 단계일 뿐입니다. 다음 질문은 이 객체들이 여전히 도달 가능한 이유입니다. 에이전트는 heap.instances로 InstallerContextImpl 인스턴스를 하나 선택하고 jq 표현식에서 pathToRoot 빌트인을 호출했습니다:
query({
  dataset: "heap.instances",
  class: "com.install4j.runtime.installer.InstallerContextImpl",
  expression: `
    .instances[0]
    | {
        id,
        keptAliveBy:
          pathToRoot(.id).paths[0].path
          | map({class, via, root})
      }
  `
})
반환된 경로에는 누수 체인 전체가 담겨 있었습니다:
LookAndFeelChangeUtil.lookAndFeelChangeHandlers (static)
  → WeakHashMap entry value
  → look-and-feel handler registration
  → captured lambda
  → WidgetStyleHandlerImpl
  → FormEnvironmentImpl
  → FormPanel
  → InstallerContextImpl
LookAndFeelChangeUtil의 정적 필드가 이 맵을 보유하고 있었습니다. 맵의 값들은 핸들러 등록이었고, 그 람다들이 폼 환경과 인스톨러 컨텍스트를 참조하고 있었습니다. arg$1이라는 이름의 생성된 람다 필드들은 캡처된 변수를 식별해 주었기 때문에 특히 유용했습니다. 이 시점에서 힙 증거는 검토해야 할 정확한 소스 코드 구조를 짚어 주었습니다.
WeakHashMap이 누수를 막지 못한 이유
다른 파싱된 문서들과 최상위 executor에서 나온 경로들도 모두 같은 정적 맵으로 이어졌습니다. 또한 referrersByClass가 들어오는 참조를 클래스별로 집계해 주었습니다. 이를 통해 룩앤필 등록이 이 모든 객체의 공통 보유자임이 확인되었습니다.
WeakHashMap의 엔트리는 키가 더 이상 강하게 도달 가능하지 않을 때만 제거됩니다. 이 객체 그래프에서는 각 엔트리의 값이 간접적으로 자기 자신의 키를 참조하고 있었습니다:
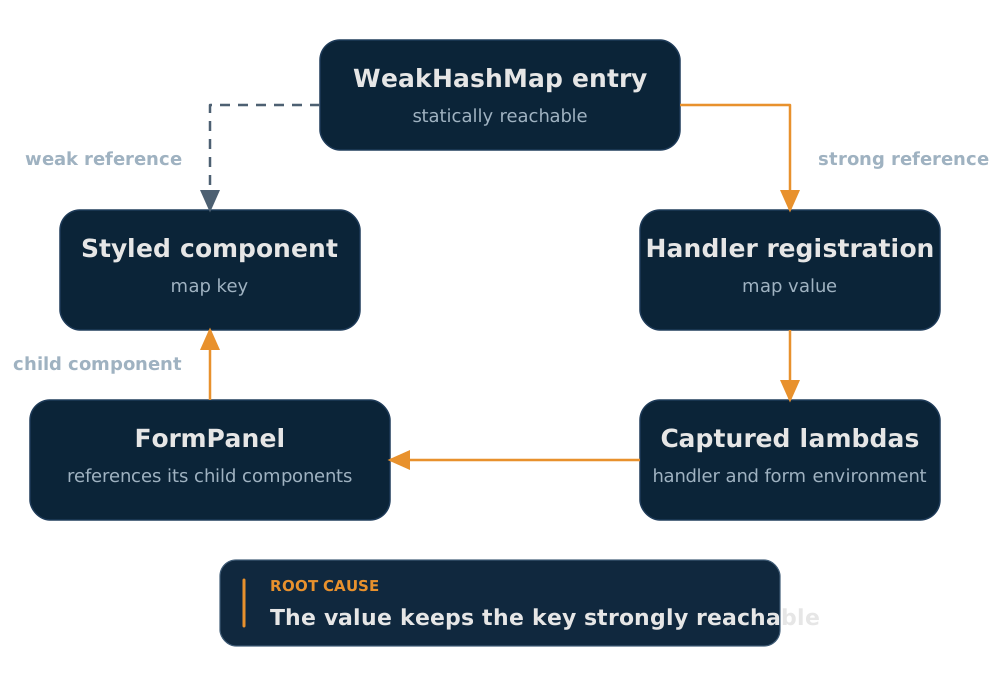
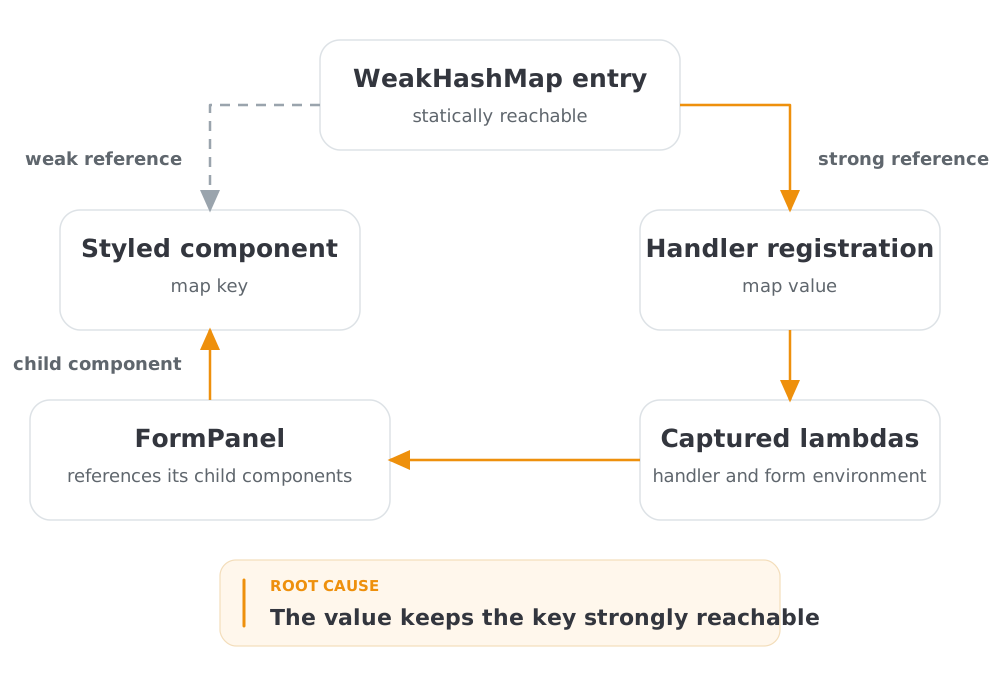
맵 키는 스타일이 적용된 Swing 컴포넌트였고, 맵 값은 핸들러 등록이었습니다. 등록 안의 캡처된 람다들이 폼 패널을 보존했고, 폼 패널은 다시 맵 키를 포함한 자식 컴포넌트들을 보존했습니다. 맵이 정적 필드에 의해 보유되고 있었기 때문에, 맵 값에서 맵 키로 되돌아오는 이 강한 참조 경로가 모든 엔트리의 제거를 막았습니다.
소스 코드에서는 WidgetStyleHandlerImpl의 캡처 패턴이 드러났습니다: 스타일링 람다는 addStyleColor 같은 인스턴스 메서드를 호출했고, 이 메서드들이 핸들러 인스턴스와 그 폼 환경을 캡처했습니다.
누수 수정
스타일 헬퍼 메서드들이 static으로 변경되어 스타일링 람다가 더 이상 핸들러를 캡처하지 않게 되었습니다. 핸들러에 대한 강한 참조가 사라지자 등록은 더 이상 폼 패널이나 맵 키를 보존하지 않았습니다.
에이전트는 WeakReference를 사용해 룩앤필 등록이 핸들러를 보존하지 않는지 검증하는 회귀 테스트를 추가했습니다. 이 테스트는 원래 코드에서는 실패하고 수정 후에는 통과했습니다. 전체 테스트 스위트도 모두 통과하면서 수정이 마무리되었습니다.
에이전트는 소스 코드만으로 누수를 찾아낼 수 있었을까?
AI 에이전트는 소스 코드를 읽고 성능 문제나 리소스 누수를 일으킬 수 있는 이상 징후를 인식하는 데 매우 뛰어납니다. 하지만 코드베이스가 에이전트의 컨텍스트 윈도우보다 커지면 이 접근 방식은 한계에 부딪힙니다. 이때 에이전트에는 런타임 데이터를 검사할 수 있는 도구가 필요합니다.
이 사례에서 업데이트 확인이 원인으로 의심되었습니다. 업데이트 확인의 소스 코드를 읽는 것만으로는 실제 누수를 발견할 수 없었을 것입니다. 누수는 프로세스 내 실행마다 초기화되던 위젯 스타일링에 있었습니다. 에이전트는 보존된 객체들과 그 참조 체인을 활용해 관련 소스 코드의 위치를 찾아냈습니다.
이것이 AI 에이전트에 프로파일러 접근 권한을 부여할 때의 가장 큰 이점입니다. 프로파일러는 애플리케이션에서 나온 증거를 제공하므로, 에이전트는 실제로 문제를 일으킨 코드에 소스 분석을 집중할 수 있습니다.
시작하기
AI 에이전트를 위한 힙 덤프 분석은 JProfiler 16.3에서 제공됩니다. 에이전트에 이 기능을 부여하려면 JProfiler 에이전트 페이지로 이동해 터미널에서 한 줄을 실행하면 됩니다.