CPU 和内存 profiling 主要关注对象和方法调用 (method call),它们是 JVM 上应用程序的基本构建块。对于某些技术,需要一种更高级别的方法,从运行中的应用程序中提取语义数据并将其显示在 profiler 中。
其中最典型的例子是使用 JDBC 分析对数据库的调用。调用树 (call tree) 显示了您何时使用 JDBC API 以及这些调用花费了多长时间。然而,每次调用可能会执行不同的 SQL 语句,您无法得知其中哪些调用导致了性能瓶颈。此外,JDBC 调用通常源自应用程序中的许多不同位置,拥有一个显示所有数据库调用的单一视图 (view) 非常重要,而不是必须在通用调用树中搜索它们。
为了解决这个问题,JProfiler 为 JRE 中的重要子系统提供了许多探针 (probe)。探针将 instrumentation 添加到特定类中以收集其数据,并将它们显示在“Databases”、“HTTP, RPC & AI”和“JVM & Custom Probes”视图区域的专用视图中。此外,探针还可以将数据标注到调用树 (call tree) 中,以便您可以同时查看通用 CPU profiling 以及高级数据。
如果您有兴趣获取有关 JProfiler 未直接支持的技术的更多信息,您可以为其编写自定义探针。某些库 (library)、容器 (container) 或数据库驱动程序可能会随附其自带的嵌入 (embedding) 式探针,当您的应用程序使用它们时,这些探针会在 JProfiler 中可见。
探针事件
由于探针 (probe) 会增加开销,因此默认情况下不会记录它们,您必须手动或自动分别为每个探针启动记录。
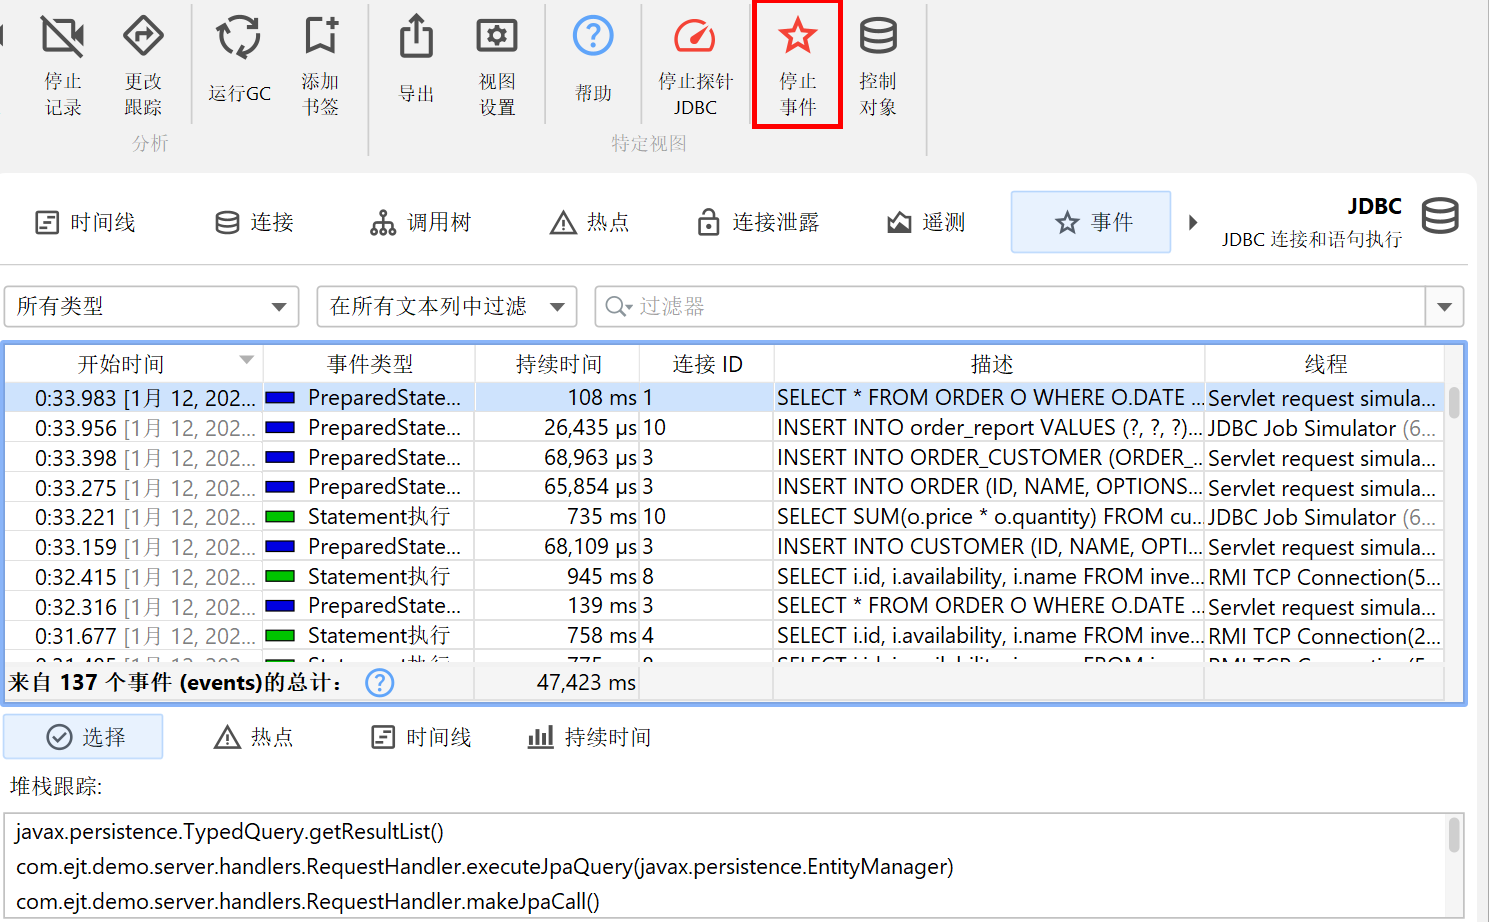
根据探针的功能,探针数据会显示在多个视图 (view) 中。最低层级是探针事件。其他视图显示累积探针事件的数据。默认情况下,即使正在记录探针,探针事件也不会保留。当单个事件变得重要时,您可以在探针事件视图中记录它们。对于某些探针(例如文件探针),这通常是不可取的,因为它们通常以高频率生成事件。其他探针(例如“HTTP server”探针或 JDBC 探针)生成事件的频率可能要低得多,因此记录单个事件可能是合适的。
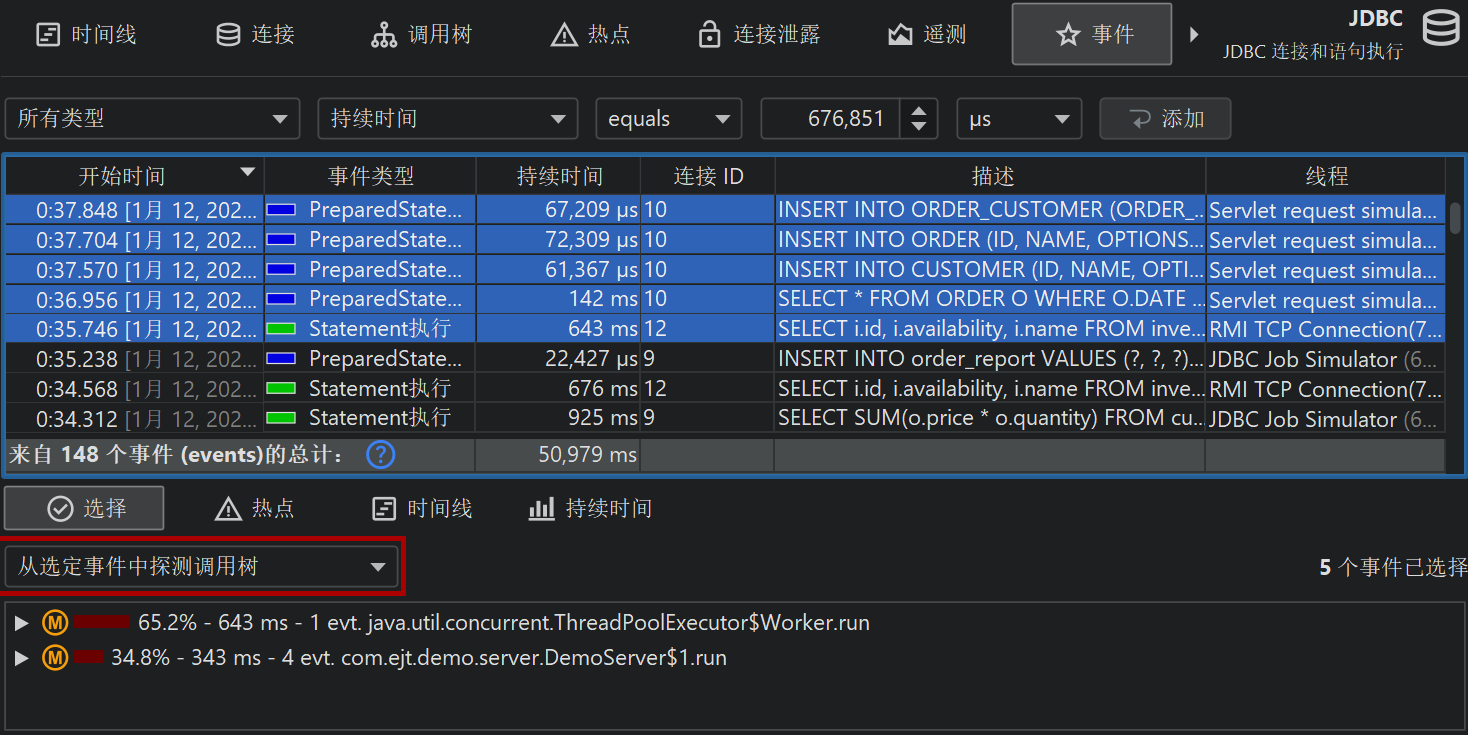
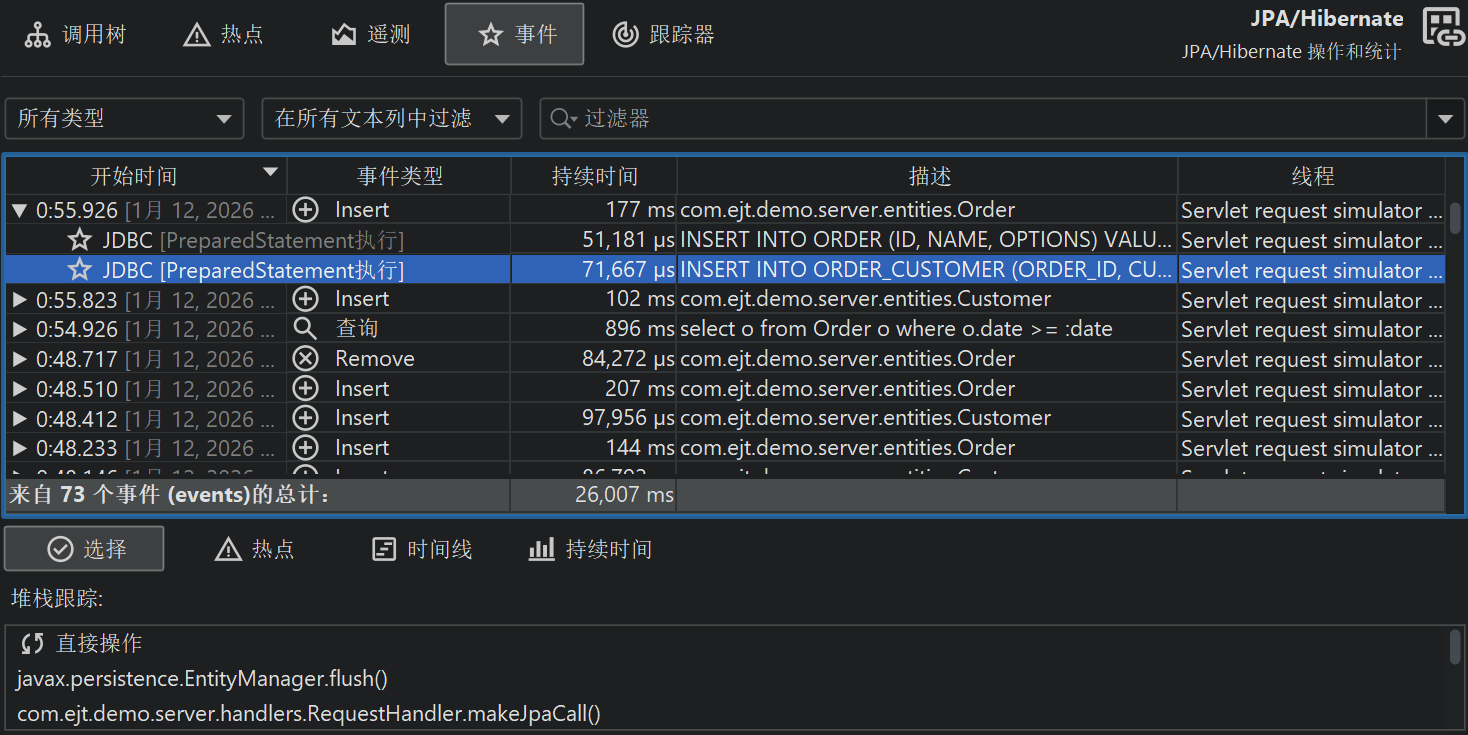
探针事件从各种源捕获探针字符串,包括方法参数、返回值、被检测对象以及抛出的异常 (exception)。探针可能会从多个方法调用 (method call) 中收集数据,例如 JDBC 探针必须拦截 PreparedStatement 的所有 setter 调用,以便构造实际的 SQL 字符串。探针字符串是有关由探针测量的更高级子系统的基本信息。此外,事件还包含开始时间、可选的持续时间、关联的线程和堆栈跟踪。
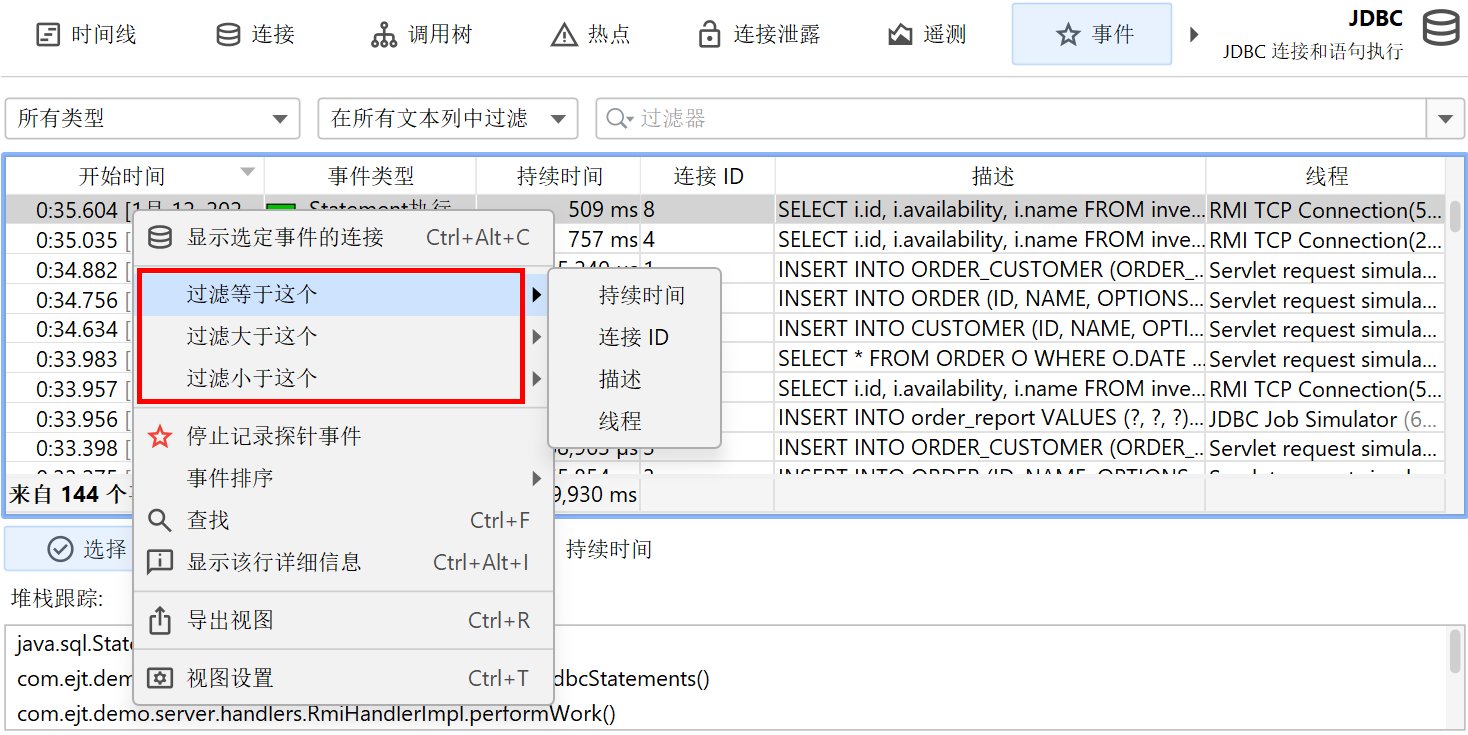
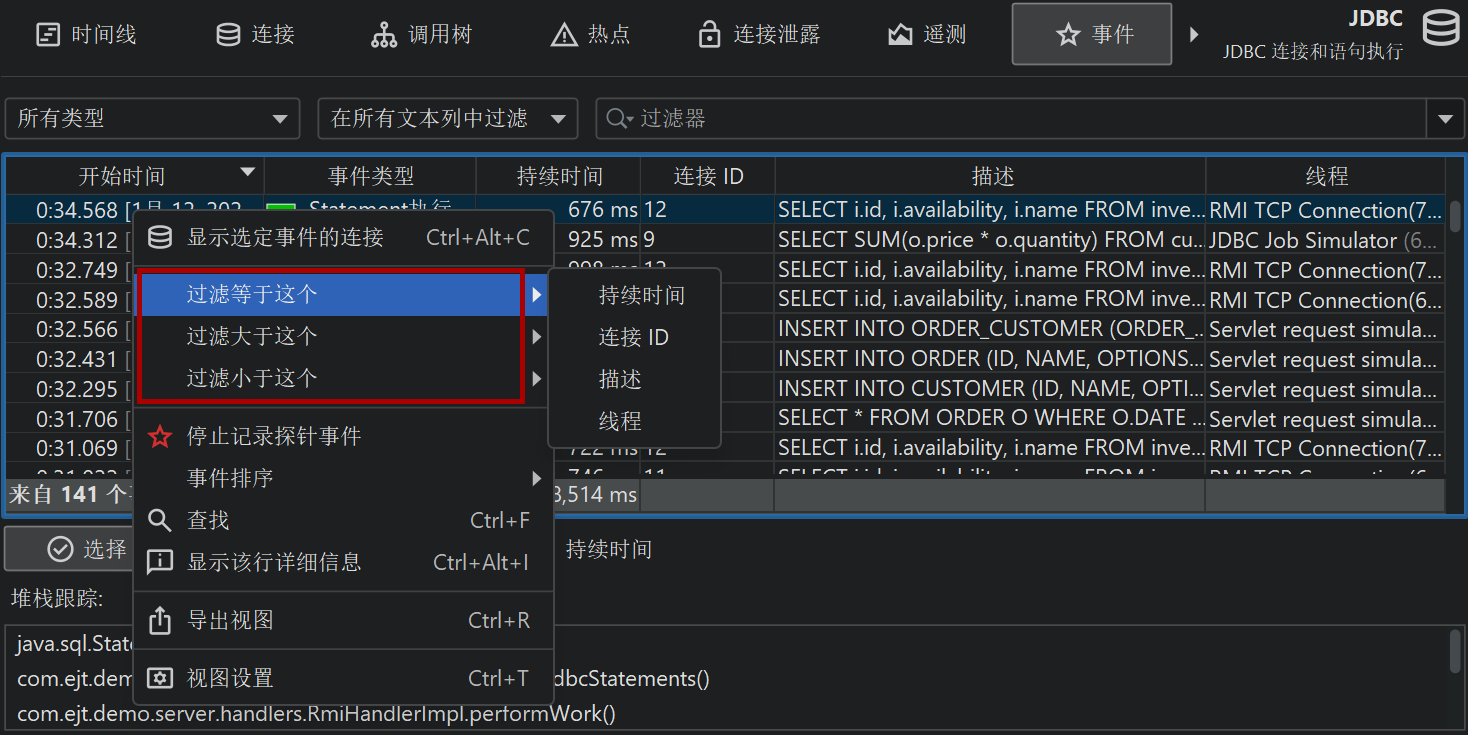
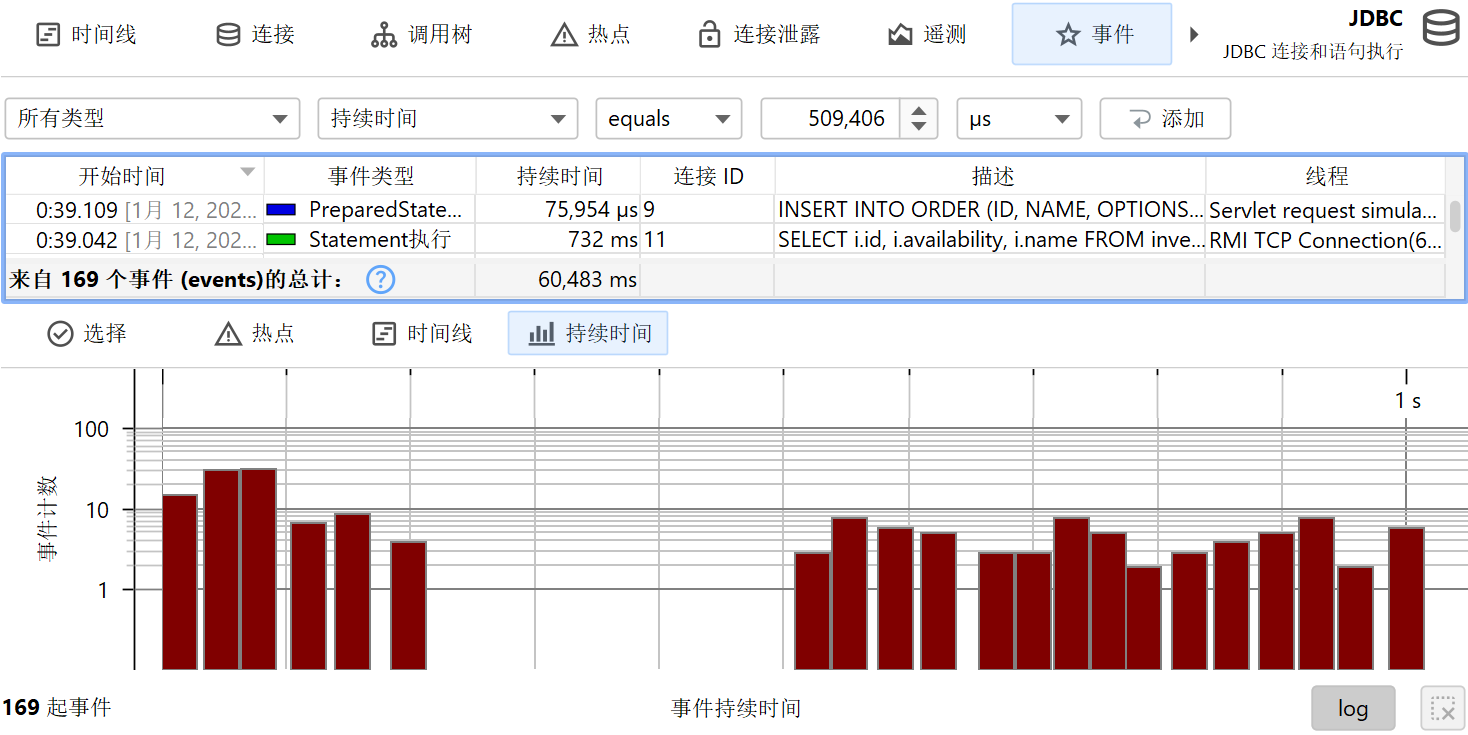
表格底部有一个特殊的行,用于显示所显示事件的总数并对表格中的所有数字列求和。对于默认列,这仅包括 Duration 列。结合表格上方的过滤器选择器,您可以针对所选的事件子集分析收集到的数据。默认情况下,文本过滤器适用于所有文本字段列,但您可以从文本字段前面的下拉列表中选择特定的排序列。右键菜单中也提供过滤选项,例如,过滤持续时间大于所选事件持续时间的所有事件。
其他探针视图 (view) 也提供了过滤探针事件的选项:在探针遥测 (telemetry) 视图中,您可以选择时间范围;在探针调用树 (call tree) 视图中,您可以过滤来自所选调用栈 (call stack) 的事件;探针热点 (hot spot) 视图提供基于所选反向跟踪或热点的探针事件过滤器;控制对象 (control object) 和时间线视图提供用于过滤所选控制对象的探针事件的操作。
所选探针事件的堆栈跟踪显示在底部。如果选择了多个探针事件,则堆栈跟踪将被累积并显示为调用树 (call tree)、带反向跟踪的探针热点 (hot spot) 或带反向跟踪的 CPU 热点。
堆栈跟踪视图旁边显示了事件持续时间以及可选的记录吞吐量的直方图视图 (view)。您可以在这些直方图中使用鼠标选择持续时间范围,以过滤上方表格中的探针事件。
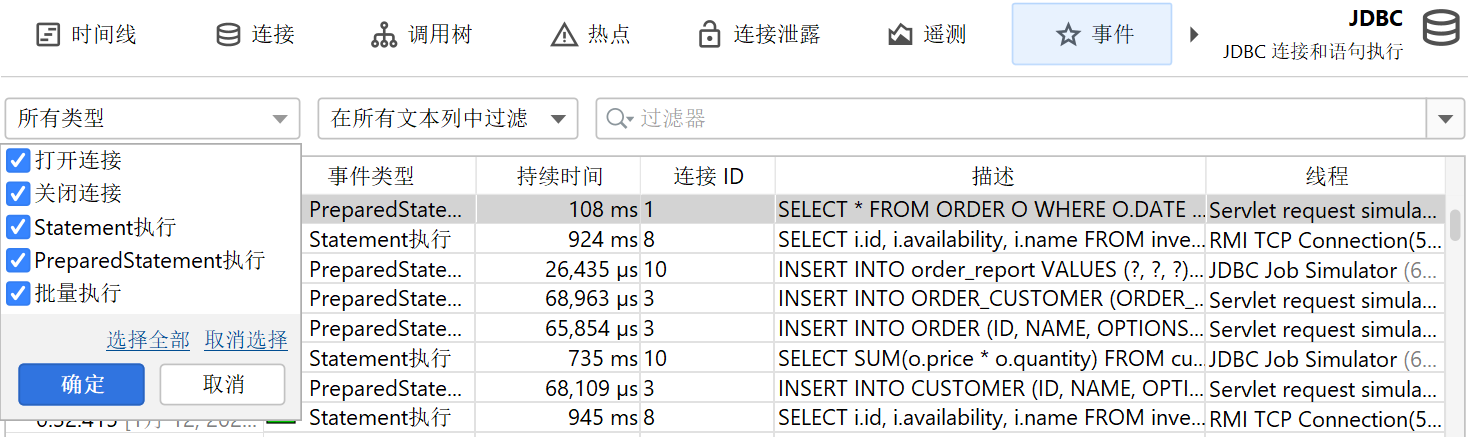
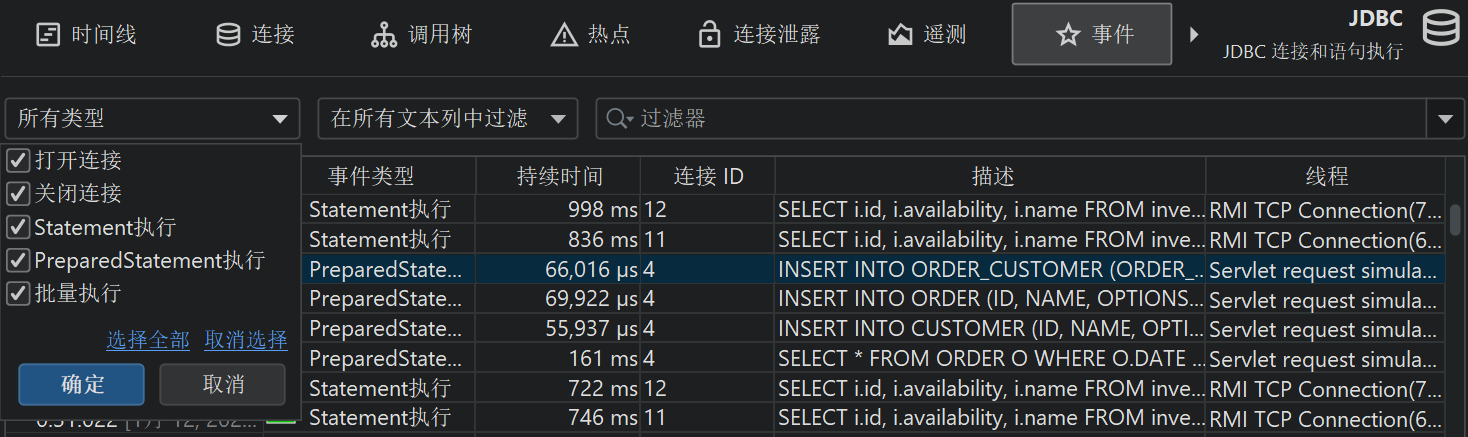
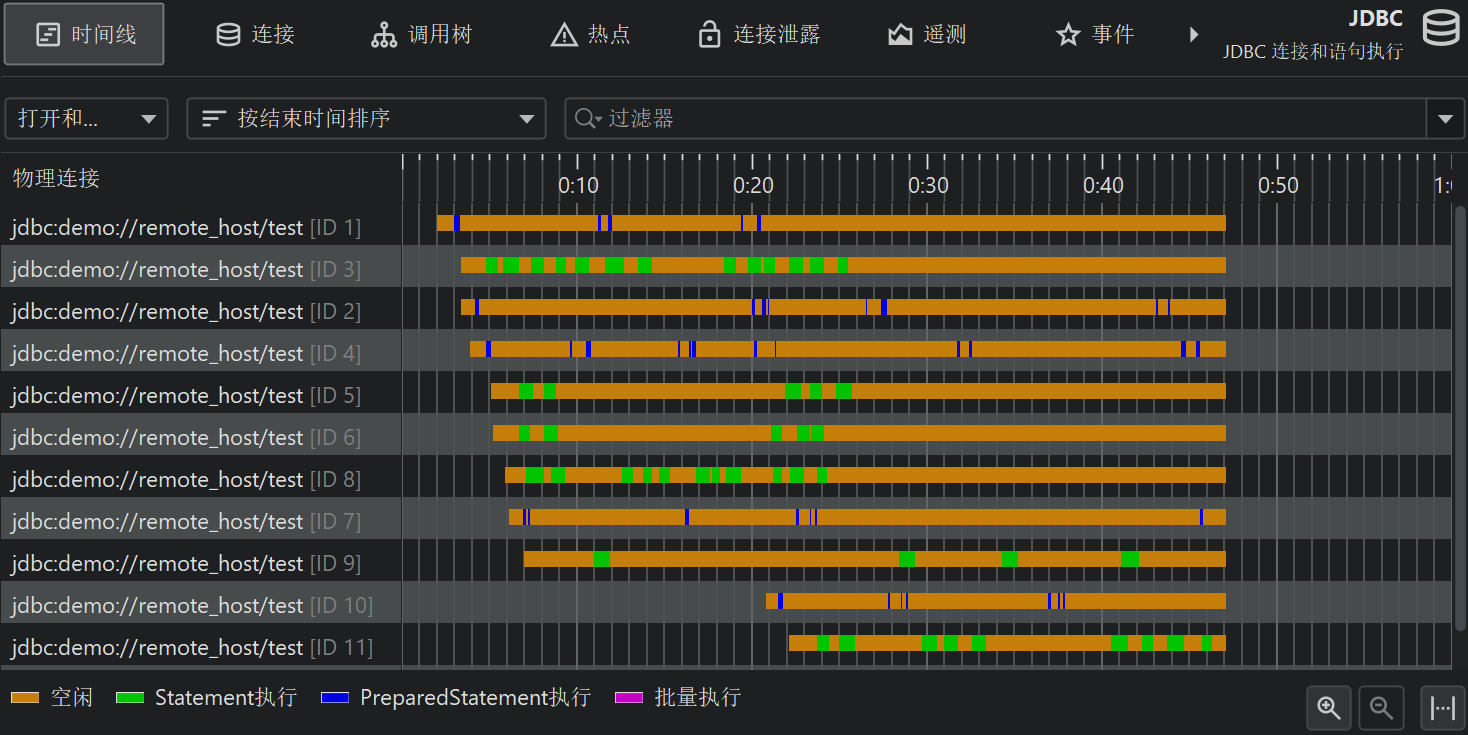
探针 (probe) 可以记录不同类型的活动,并将事件类型与其探针事件关联。例如,JDBC 探针将 statement、prepared statement 和批量执行显示为具有不同颜色的事件类型。
为了防止在记录单个事件时占用过多内存,JProfiler 会合并整理事件。事件上限在配置文件设置 (profiling setting) 中配置,并应用于所有探针。仅保留最新的事件,较旧的事件将被丢弃。此合并整理不会影响更高级别的视图 (view)。
探针调用树和热点
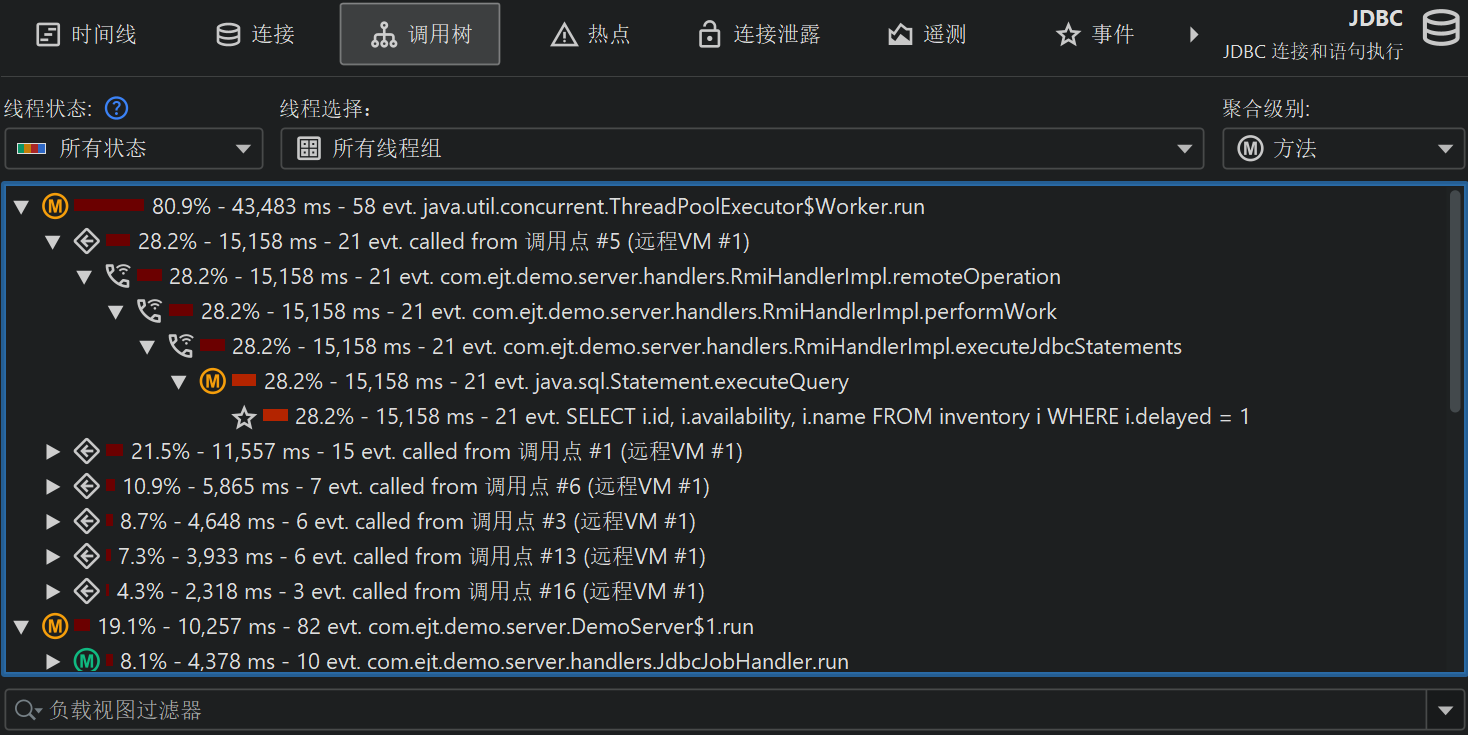
探针记录与 CPU 记录紧密配合工作。探针事件被聚合到探针调用树 (call tree) 中,其中探针字符串是叶节点,称为“有效负载 (payload)”。只有创建了探针事件的调用栈 (call stack) 才会包含在该树中。方法节点上的信息指的是记录的有效负载名称。例如,如果一个 SQL 语句在特定调用栈上执行了 42 次,总时间为 9000 毫秒,则会向所有祖先调用树节点添加 42 的事件计数和 9000 毫秒的时间。所有记录的有效负载的累积构成了调用树,它向您显示哪些调用路径消耗了大部分特定于探针的时间。探针树的重点是有效负载,因此视图 (view) 过滤器默认搜索有效负载,尽管其上下文菜单也提供了过滤类的模式。
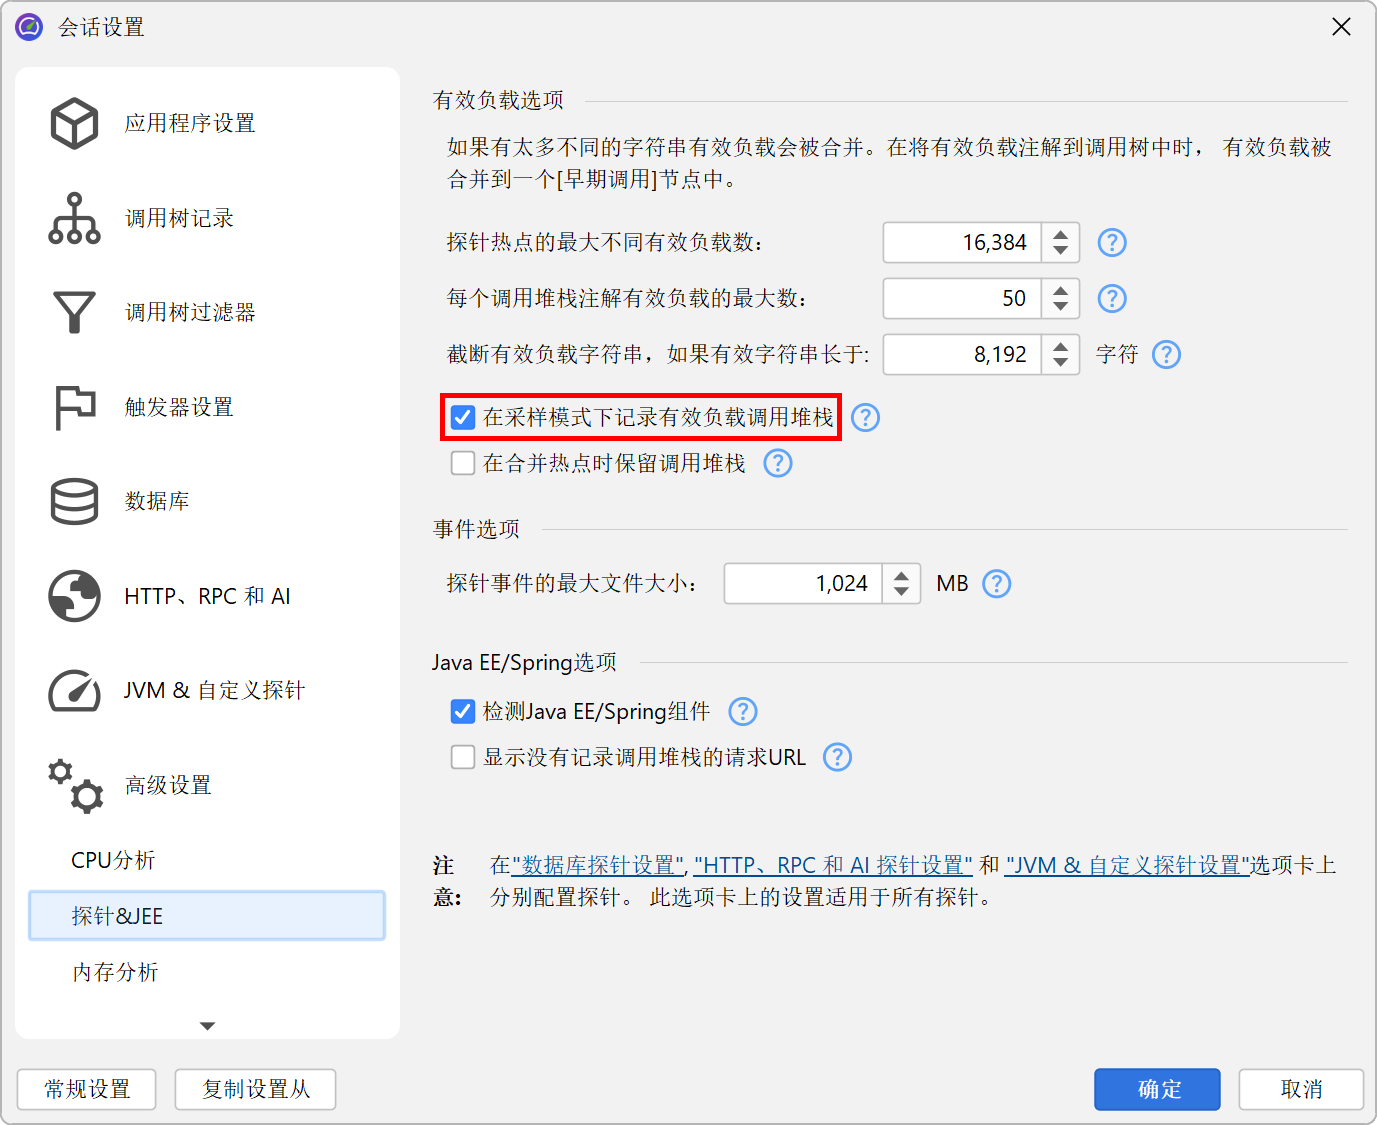
如果关闭 CPU 记录,反向跟踪将仅包含“No CPU data was recorded”节点。如果 CPU 数据仅被部分记录,则这些节点可能会与实际反向跟踪混合在一起。即使启用了抽样,JProfiler 默认情况下也会记录探针有效负载 (payload) 的精确调用跟踪 (call trace)。如果您想避免这种开销,可以在配置文件设置 (profiling setting) 中将其关闭。还有其他几个用于探针记录的调整选项,可以进行微调以增加数据收集或减少开销。
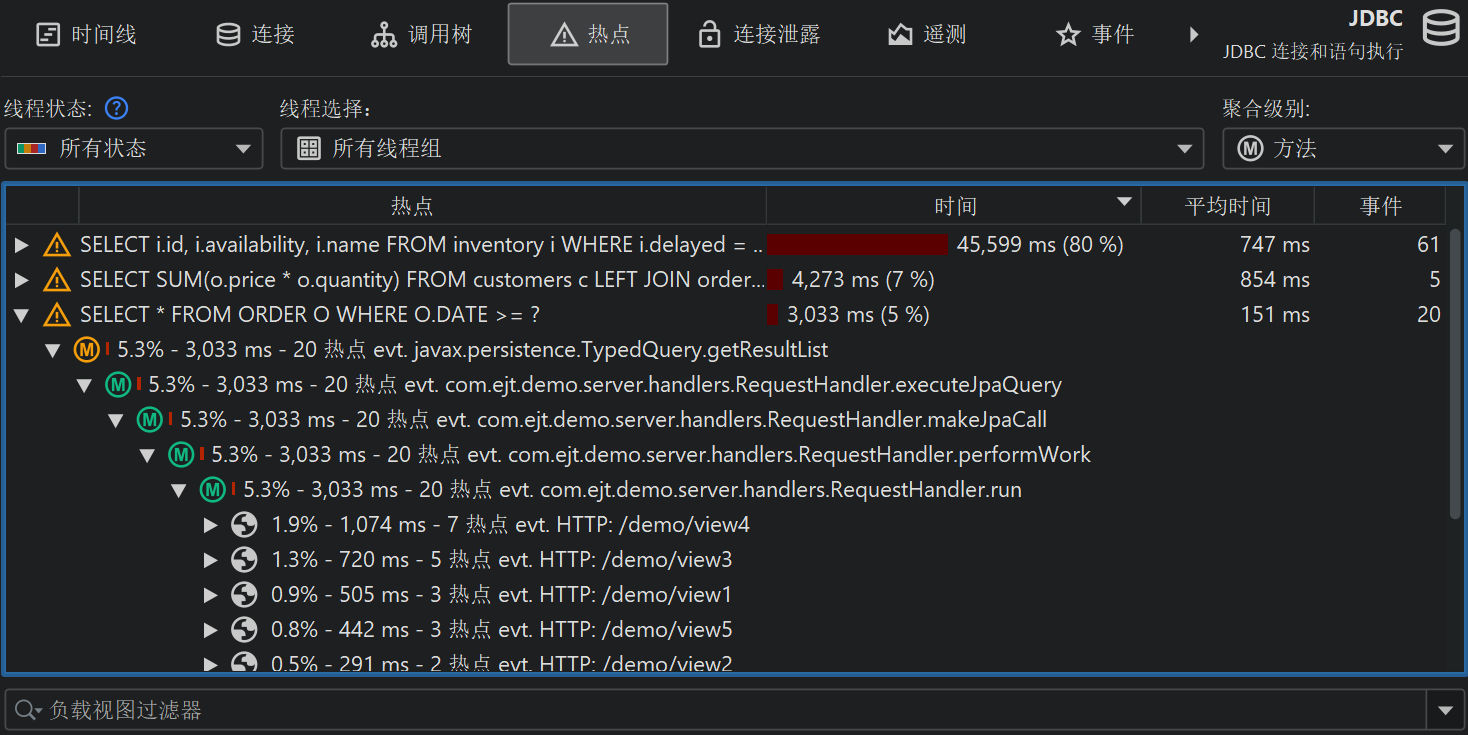
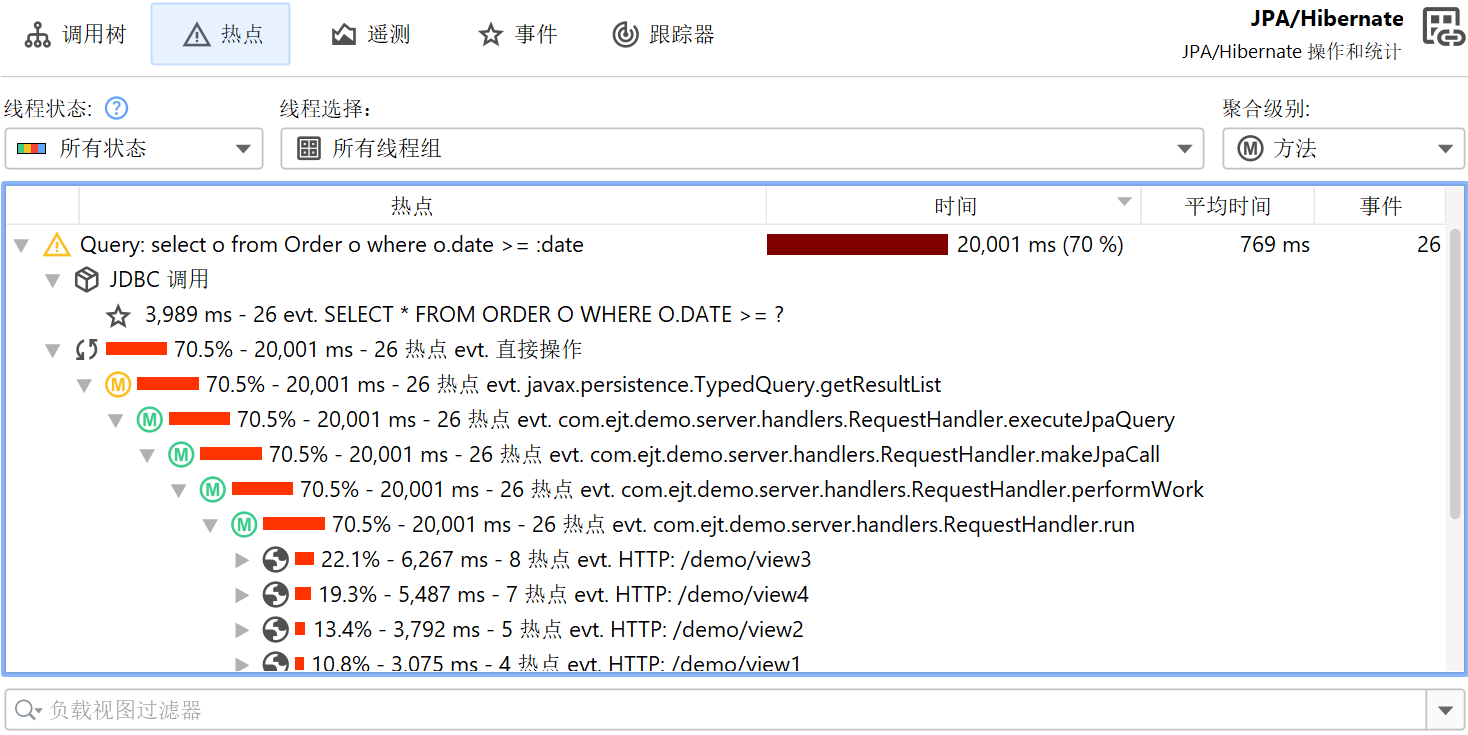
可以从探针调用树 (call tree) 计算热点 (hot spot)。热点节点现在是有效负载 (payload),而不是像 CPU 视图区域中那样是方法调用 (method call)。这通常是探针中最直接有用的视图 (view)。如果 CPU 记录处于活动状态,您可以打开顶级热点并分析方法反向跟踪,就像在常规 CPU 热点视图中一样。反向跟踪节点上的数字表示沿着从最深节点延伸到热点正下方节点的调用栈 (call stack),测量了多少个探针事件以及总持续时间。
探针调用树 (call tree) 和探针热点 (hot spot) 视图 (view) 都允许您选择线程或线程组、线程状态以及方法节点的聚合级别 (aggregation level),就像在相应的 CPU 视图中一样。当您从 CPU 视图过来比较数据时,务必牢记探针视图中的默认线程状态是“All states”,而不是像 CPU 视图中那样的“Runnable”。这是因为探针事件通常涉及外部系统,例如数据库调用、socket 操作或进程执行,在这些系统中查看总时间非常重要,而不仅仅是查看当前 JVM 花费在上面的时间。
控制对象
许多提供外部资源访问的库 (library) 都会为您提供一个连接对象,可用于与资源交互。例如,启动进程时,java.lang.Process 对象允许您从输出流 (stream)
中读取并写入输入流。使用 JDBC 时,您需要一个 java.sql.Connection 对象来执行 SQL 查询。JProfiler 中用于此类对象的通用术语是“控制对象 (control
object)”。
将探针事件与其控制对象 (control object) 进行分组并显示其生命周期,有助于更好地了解问题的根源。此外,创建控制对象通常开销很大,因此您希望确保应用程序不会创建过多控制对象并能够正确关闭它们。为此,支持控制对象的探针具有“Timeline”和“Control objects”视图 (view),其中后者可能会有更具体的命名,例如 JDBC 探针的“Connections”。当打开或关闭控制对象时,探针会创建特殊的探针事件,这些事件会显示在事件视图中,以便您可以检查关联的堆栈跟踪。
在时间线视图中,每个控制对象 (control object) 都显示为一个条形,其着色 (colorization) 显示了控制对象处于活动状态的时间。探针可以记录不同的事件类型,时间线也会相应地着色。此状态信息不是取自事件列表(该列表可能已被合并整理或根本不可用),而是每 100 毫秒从最新状态采样一次。控制对象具有一个名称,允许您识别它们。例如,文件探针创建以文件名命名的控制对象,而 JDBC 探针将连接字符串显示为控制对象的名称。
控制对象 (control object) 视图以表格形式显示所有控制对象。默认情况下,打开和已关闭的控制对象都会显示。您可以使用顶部的控件将显示限制为仅打开或已关闭的控制对象,或者过滤特定列的内容。除了控制对象的基本生命周期数据外,该表还显示每个控制对象的累积活动数据,例如事件计数和平均事件持续时间。
不同的探针在此处显示不同的列,例如进程探针为读取和写入事件显示单独的列集。如果禁用了单事件记录,此信息也可用。就像事件视图一样,底部的合计行可以与过滤结合使用,以获取部分控制对象 (control object) 集合的累积数据。
探针可以在嵌套表中发布某些属性。这样做是为了减少主表中的信息过载,并为主表列提供更多空间。如果存在嵌套表(例如文件探针和进程探针),则每行左侧都有一个展开手柄,可在原地打开属性-值表。
时间线视图、控制对象 (control object) 视图和事件视图通过导航操作进行连接。例如,在时间线视图中,您可以右键单击某一行并跳转到其他各个视图,从而仅显示来自所选控制对象的数据。这是通过将控制对象 ID 过滤为所选值来实现的。
遥测 (telemetry) 与跟踪器
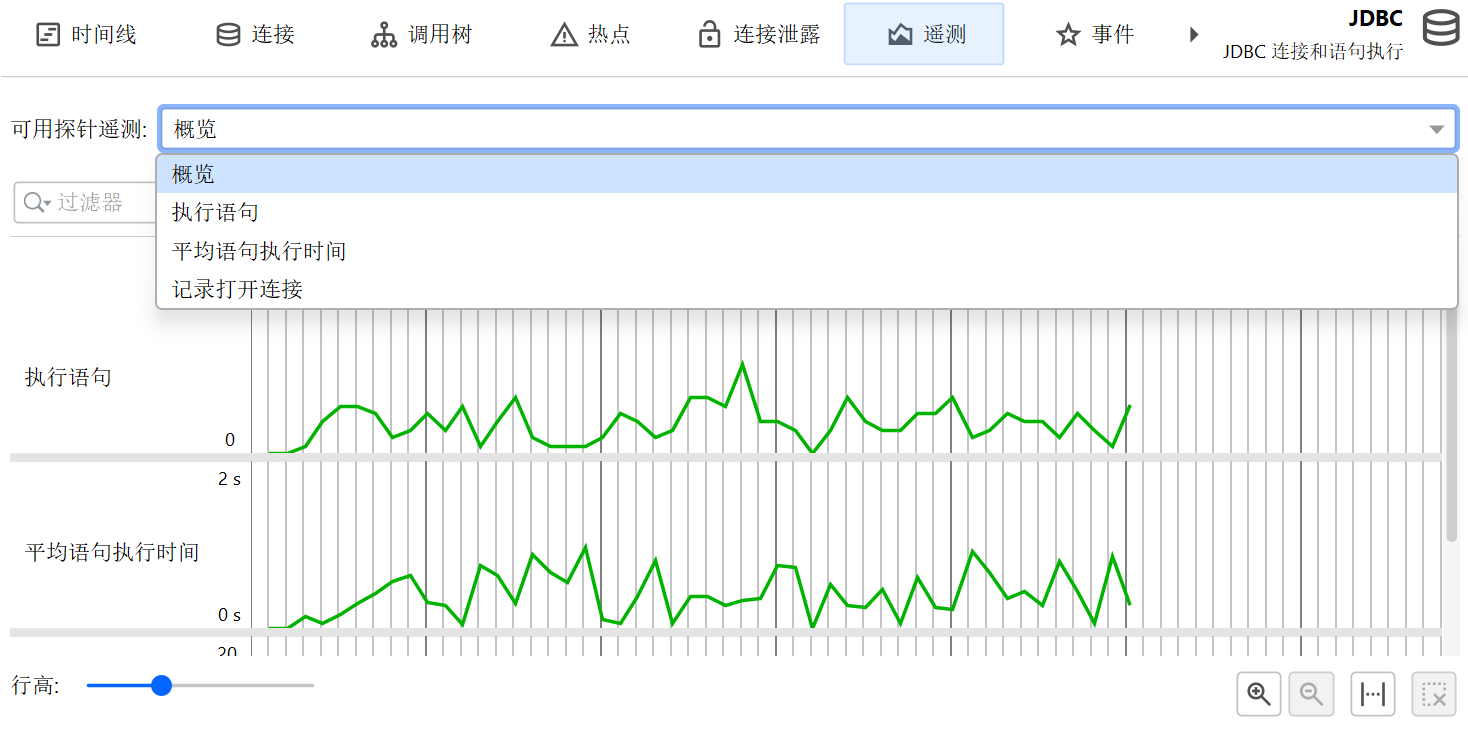
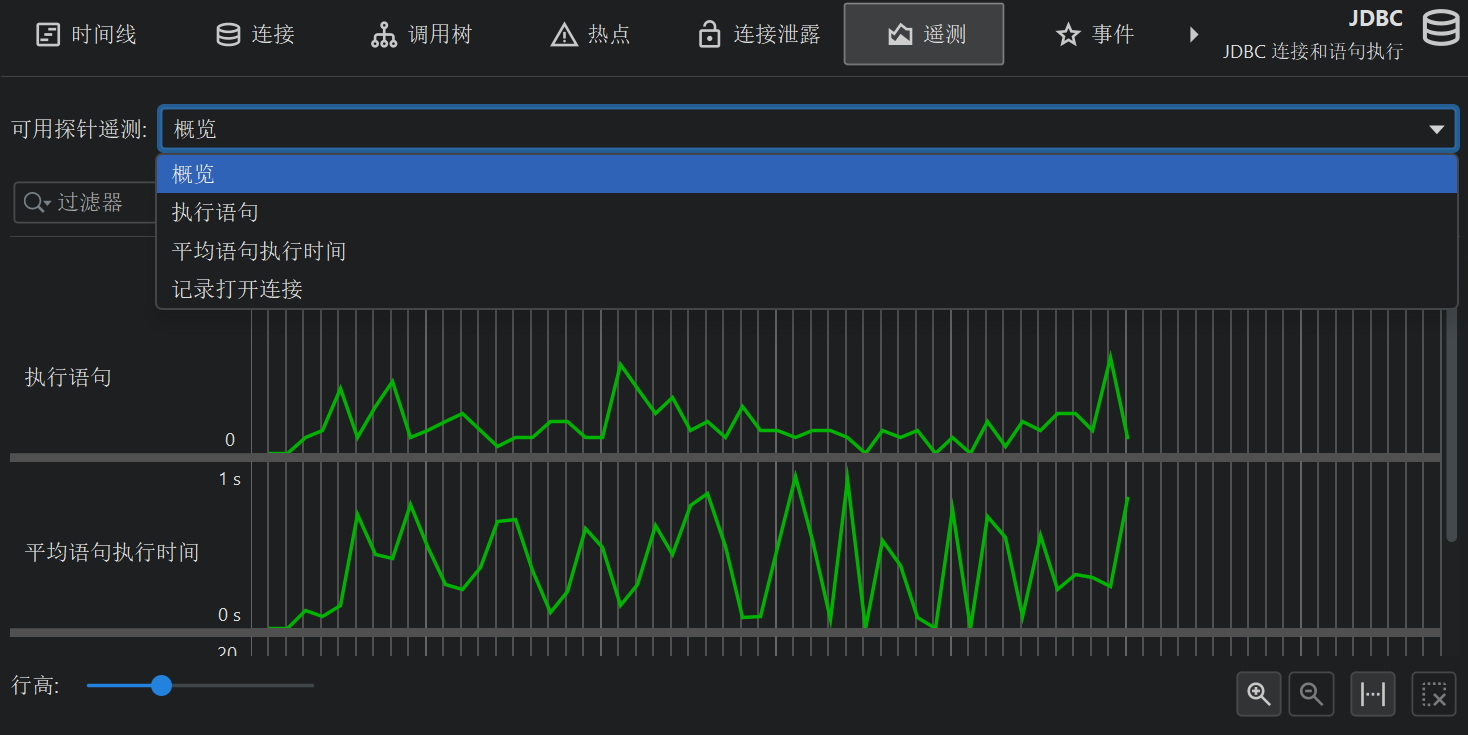
根据探针收集的累积数据,会记录多项遥测 (telemetry)。对于任何探针,每秒的探针事件数以及探针事件的某些平均指标(如平均持续时间或 I/O 操作的吞吐量)都是可用的。对于带有控制对象 (control object) 的探针,打开的控制对象数量也是一个标准遥测指标。每个探针都可以添加额外的遥测,例如 JPA 探针为查询计数和实体操作计数显示单独的遥测。
热点 (hot spot) 视图和控制对象 (control object) 视图显示了随时间跟踪可能很有意义的累积数据。这些特殊的遥测 (telemetry) 是使用探针跟踪器 (probe tracker) 记录的。设置跟踪的最简单方法是通过热点或控制对象视图中的 Add Selection To Tracker 操作添加新的遥测。在这两种情况下,您都必须选择是要跟踪时间还是计数。跟踪控制对象时,遥测是针对所有不同探针事件类型的堆叠面积图形 (graph)。对于被跟踪的热点,跟踪的时间会细分为不同的线程状态。
可以将探针遥测 (telemetry)添加到“Telemetries”区域,以便将它们与系统遥测或自定义遥测进行比较。然后,您还可以通过遥测概览中的上下文菜单操作来控制探针记录。
JDBC 和 JPA
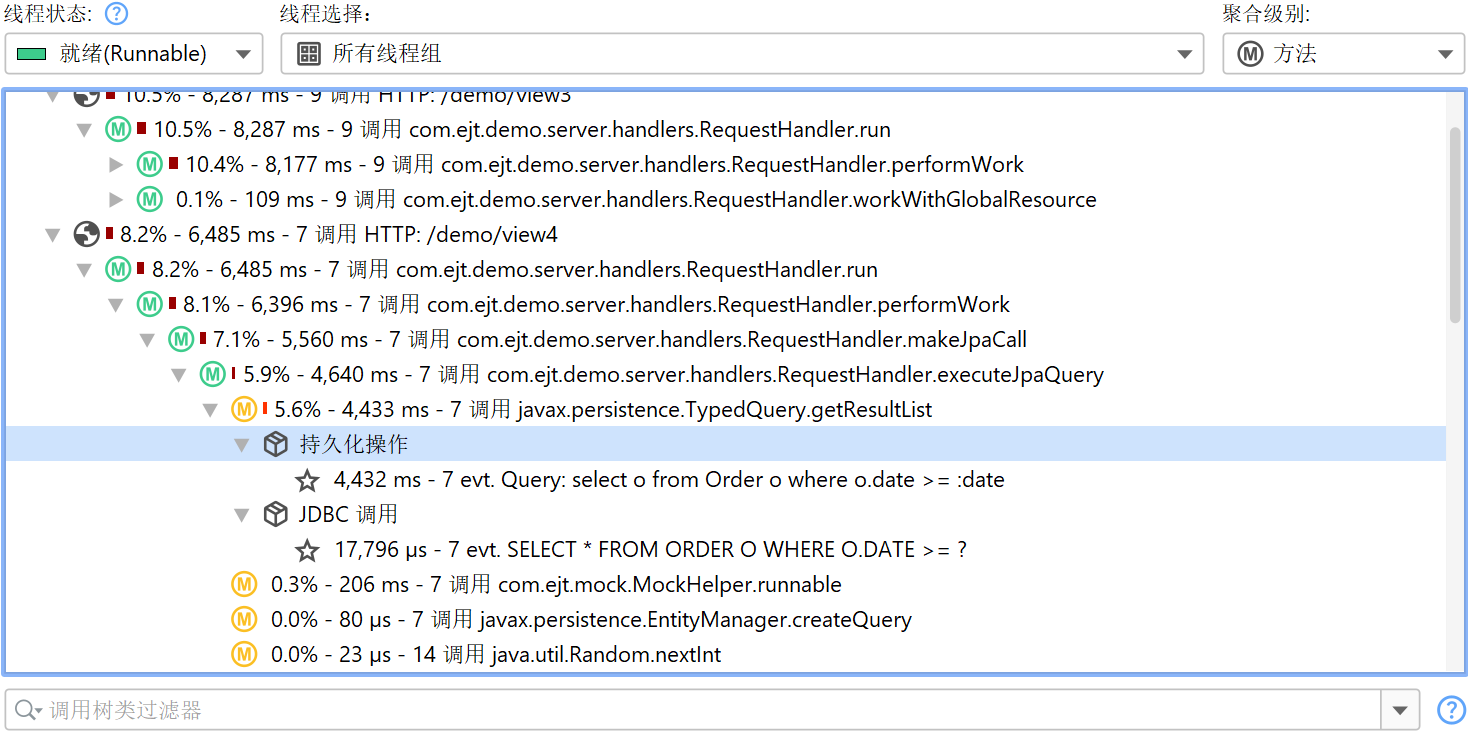
JDBC 探针和 JPA 探针协同工作。在 JPA 探针的事件视图中,如果 JDBC 探针与 JPA 探针一起记录,您可以展开单个事件以查看关联的 JDBC 事件。
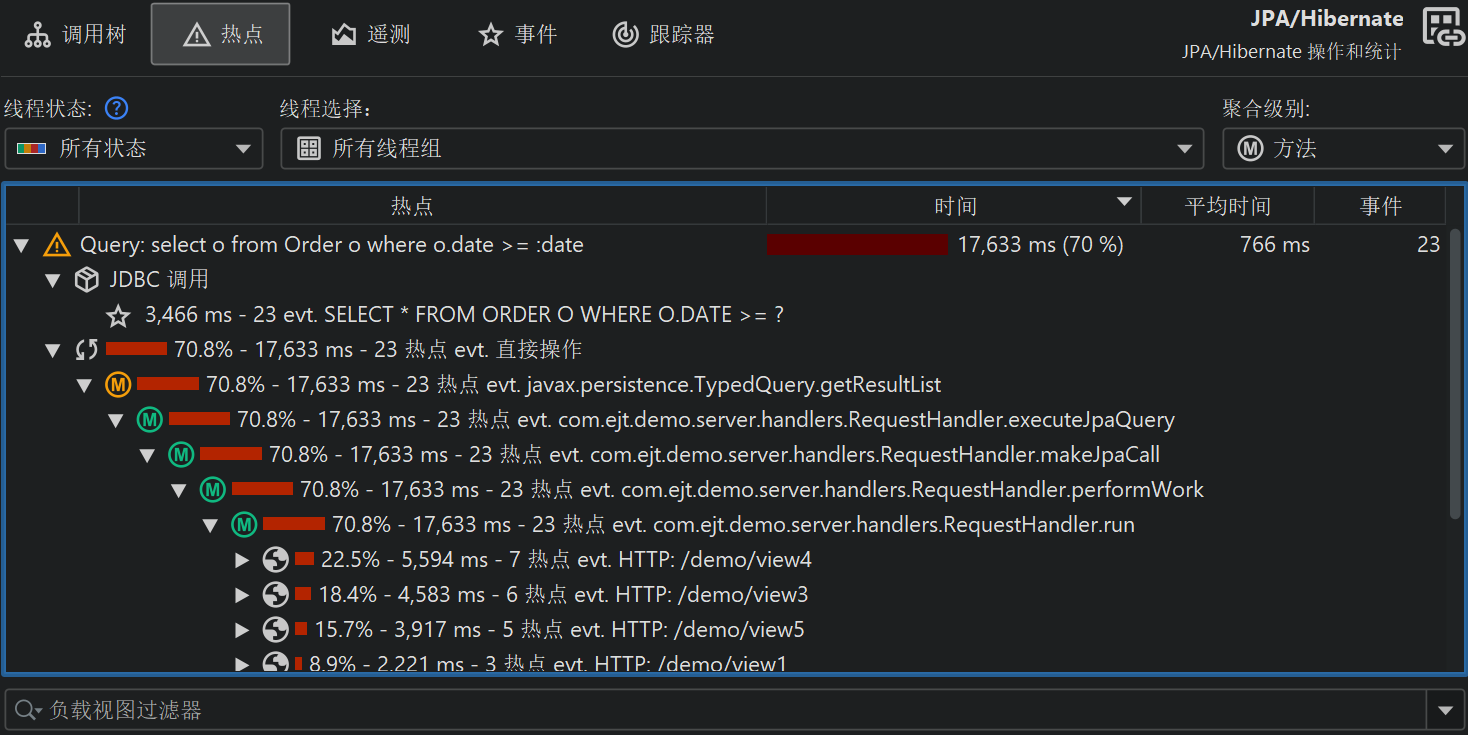
类似地,热点 (hot spot) 视图向所有热点添加一个特殊的“JDBC calls”节点,其中包含由 JPA 操作触发的 JDBC 调用。某些 JPA 操作是异步的,不会立即执行,而是在刷新会话 (session) 时的某个任意稍后时间点执行。在查找性能问题时,该 flush 的堆栈跟踪没有帮助,因此 JProfiler 会记住获取现有实体或持久化新实体的堆栈跟踪,并将它们绑定到探针事件。在这种情况下,热点的反向跟踪包含在标记为“Deferred operations”的节点内,否则会插入“Direct operations”节点。
其他探针(如 MongoDB 探针)同时支持直接操作和异步操作。异步操作不在当前线程上执行,而是在其他地方执行,无论是在同一 JVM 中的一个或多个其他线程上,还是在另一个进程中。对于此类探针,热点 (hot spot) 中的反向跟踪被分类到“Direct operations”和“Async operations”容器节点中。
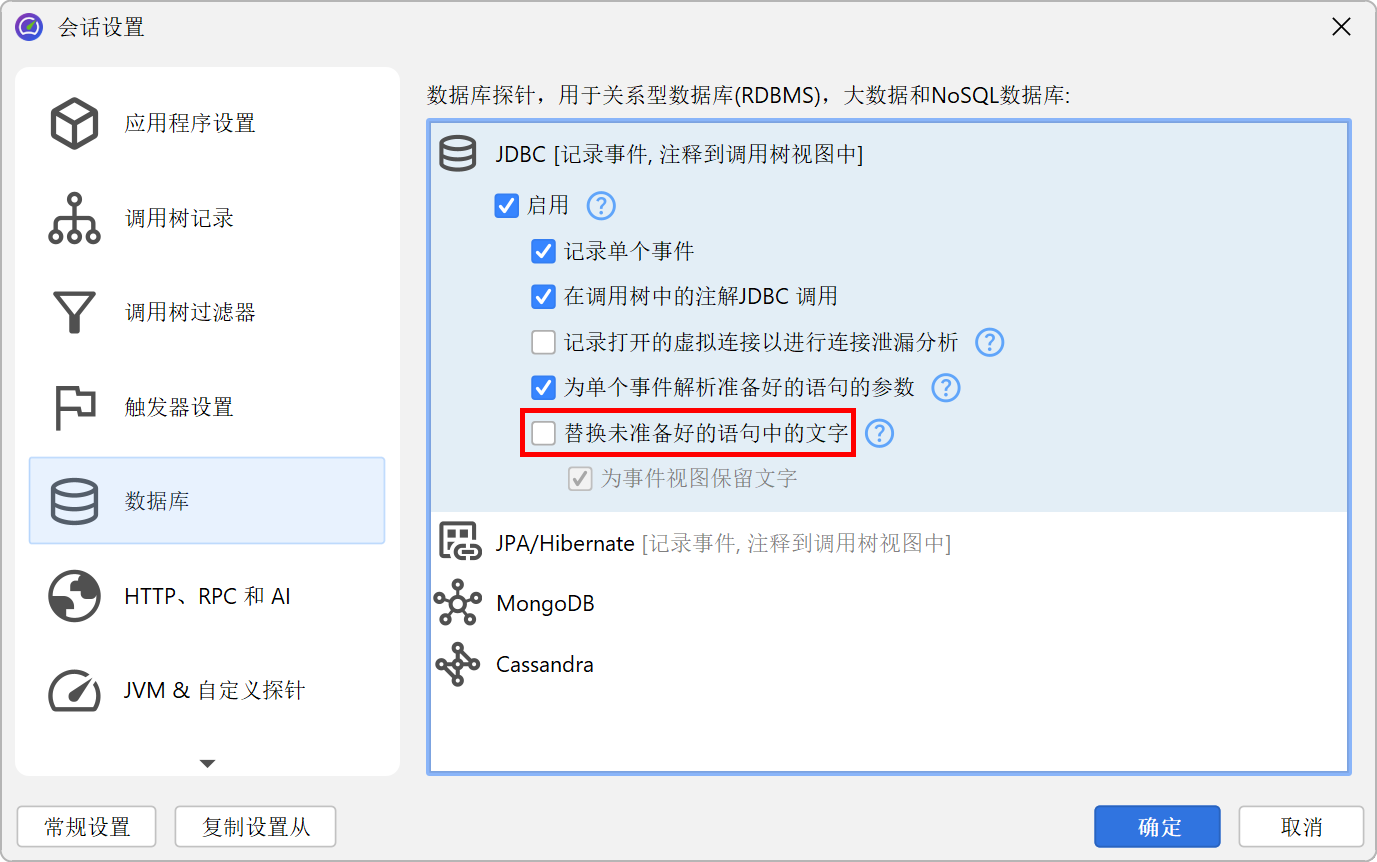
JDBC 探针中的一个特殊问题是,只有在 SQL 字符串中不包含像 ID 这样的字面量数据时,才能获得良好的热点 (hot spot)。如果使用 Prepared Statement,这会自动实现,但如果执行常规 Statement 则不然。在后一种情况下,您可能会得到一个热点列表,其中大多数查询只执行了一次。作为补救措施,JProfiler 在 JDBC 探针配置中提供了一个非默认选项,用于替换未预编译语句中的字面量。出于调试目的,您可能仍希望在事件视图 (view) 中查看字面量。停用该选项可以减少内存开销,因为 JProfiler 不必缓存如此多不同的字符串。
另一方面,JProfiler 会收集 Prepared Statement 的参数,并在事件视图中显示不带占位符的完整 SQL 字符串。同样,这在调试时非常有用,但如果您不需要它,可以在探针设置中将其关闭以节省内存。
JDBC 连接泄漏
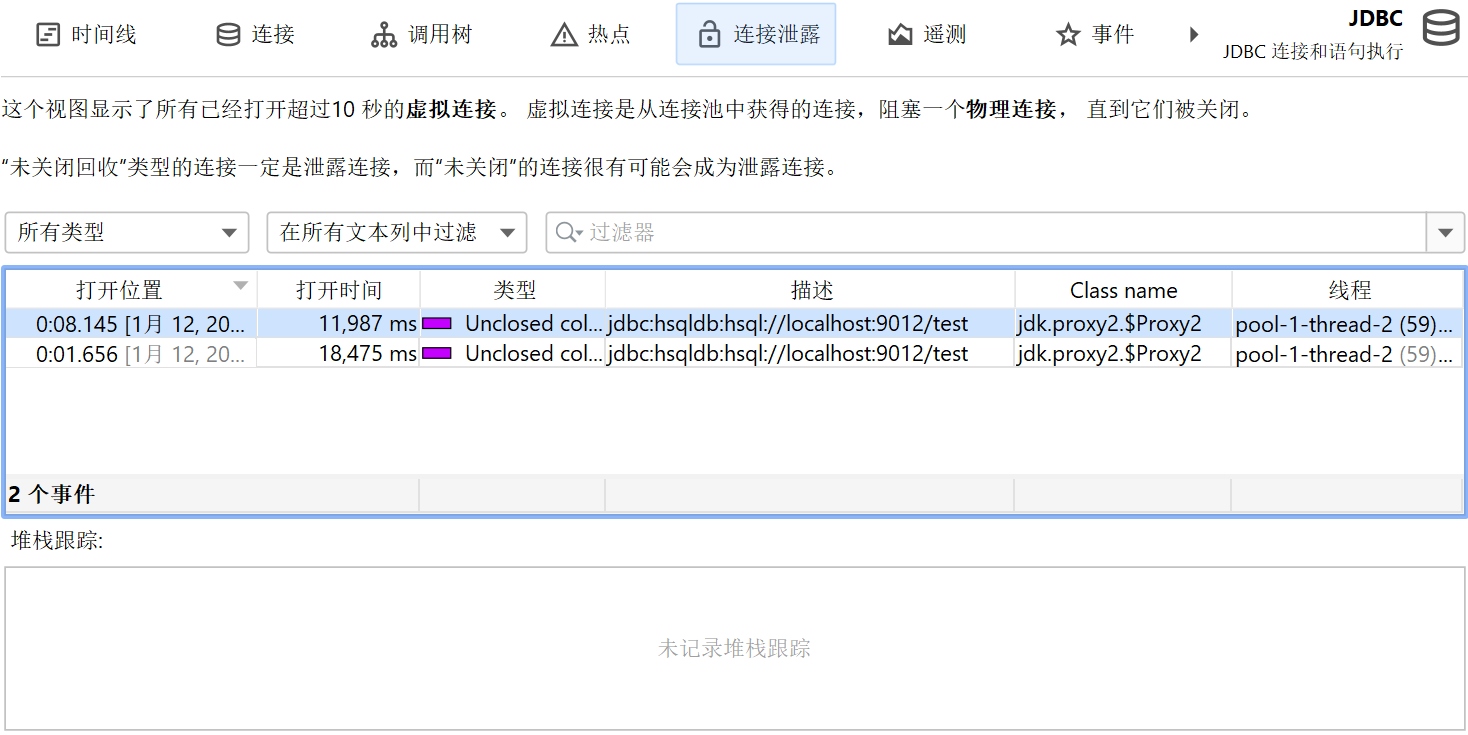
JDBC 探针具有一个“Connection leaks”视图,用于显示未归还给其数据库连接池的打开的虚拟数据库连接。这仅影响由连接池数据库源创建的虚拟连接。虚拟连接会阻塞物理连接,直到它们被关闭。
有两种类型的泄漏候选:“unclosed”连接和“unclosed collected”连接。这两种类型都是虚拟连接,其中由数据库池分发的连接对象仍在堆上,但尚未对其调用
close()。“Unclosed collected”连接已被垃圾回收,属于确定的连接泄漏 (connection leak)。
“Unclosed”连接对象仍保留在堆上。Open Since 持续时间越长,此类虚拟连接成为泄漏候选的可能性就越大。当虚拟连接打开超过 10 秒时,它将被视为潜在泄漏。但是,仍可能会对其调用
close(),随后“Connection leaks”视图中的条目将被移除。
连接泄漏表格包含一个显示连接类名称的 Class Name 列。这将告诉您是哪种类型的连接池创建了该连接。JProfiler 显式支持大量数据库驱动程序和连接池,并清楚哪些类是虚拟连接和物理连接。对于未知的连接池或数据库驱动程序,JProfiler 可能会将物理连接误认为虚拟连接。由于物理连接通常是长生命周期的,因此它会显示在“Connection leaks”视图中。在这种情况下,连接对象的类名将帮助您将其识别为误报。
默认情况下,当您启动探针记录时,连接泄漏 (connection leak) 分析未启用。连接泄漏视图中有一个单独的记录按钮,其状态对应于 JDBC 探针设置中的 Record open virtual connections for connection leak analysis 复选框。与事件记录一样,该按钮的状态是持久的,因此如果您启动一次该分析,则在下一次探针记录会话 (session) 中将自动启动它。
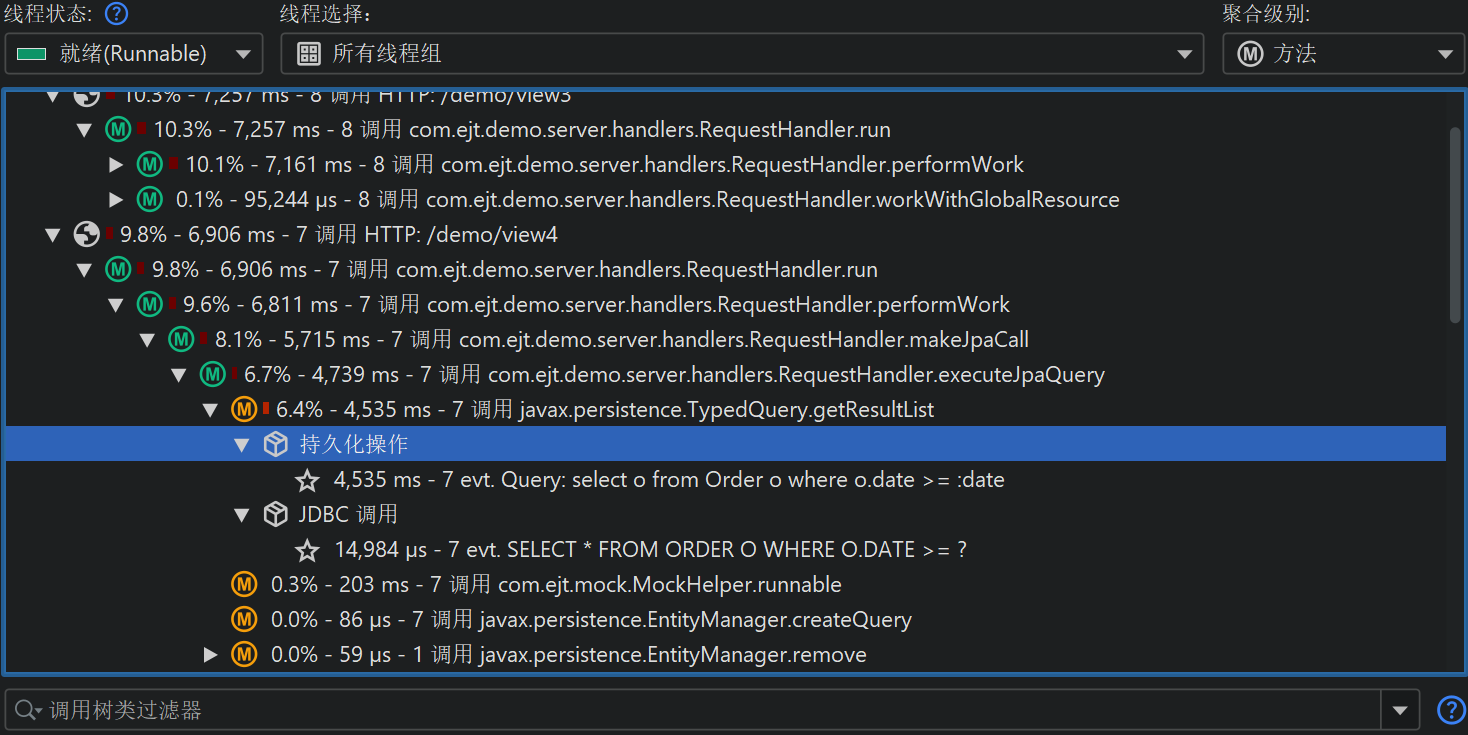
调用树中的有效负载 (payload) 数据
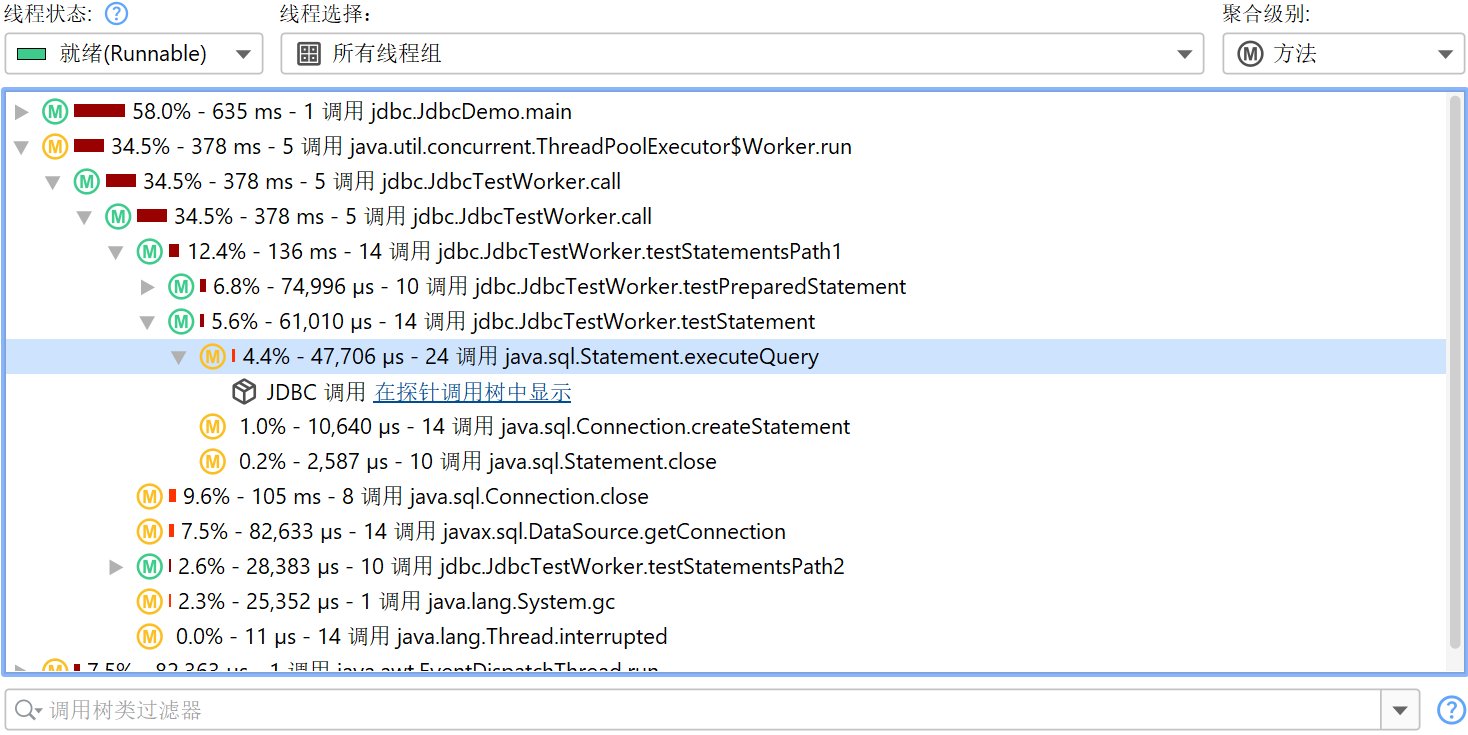
在查看 CPU 调用树 (call tree) 时,观察探针在何处记录了有效负载 (payload) 数据会很有意义。这些数据可以帮助您解释测得的 CPU 时间。这就是为什么许多探针会向 CPU 调用树中添加交叉链接。例如,类加载器 (classloader) 探针可以向您显示在何处触发了类加载。否则这在调用树中是不可见的,并且可能会增加意想不到的开销。在调用树视图中原本不透明的数据库调用,只需单击一下即可在相应的探针中进一步分析。这甚至适用于调用树分析,当您单击探针链接时,会在探针调用树视图的上下文中自动重复该分析。
另一种可能性是直接在 CPU 调用树 (call tree) 中内联显示有效负载 (payload) 信息。所有相关探针在其配置中都有一个用于该目的的 Annotate in call tree 选项。在这种情况下,没有指向探针调用树的链接。每个探针都有自己的有效负载容器节点。具有相同有效负载名称的事件将被聚合,并显示调用次数和总时间。有效负载名称在每个调用栈 (call stack) 基础上进行合并整理,最早的条目会被聚合到“[earlier calls]”节点中。每个调用栈记录的最大有效负载名称数量可在配置文件设置 (profiling setting) 中配置。
调用树拆分
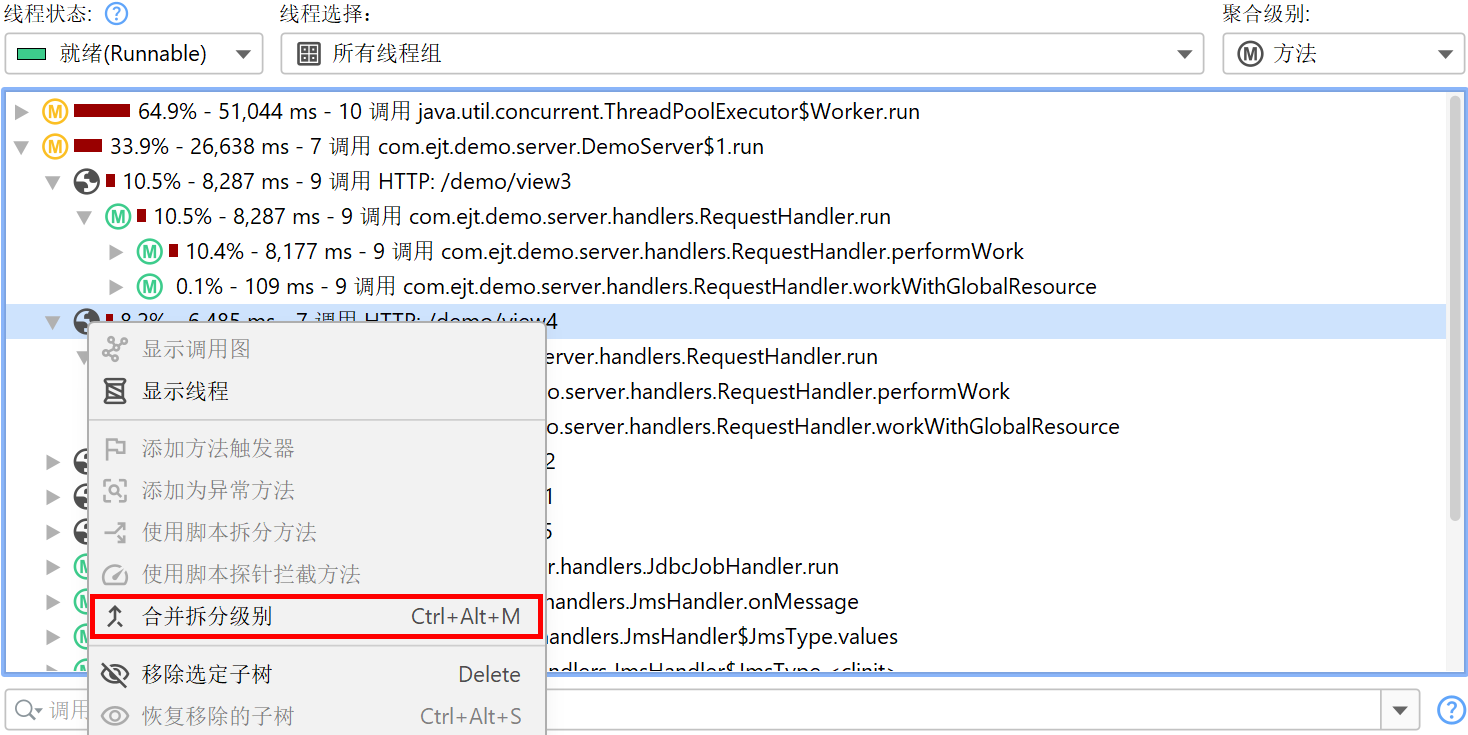
某些探针不使用其探针字符串向调用树 (call tree) 中标注有效负载 (payload) 数据。相反,它们针对每个不同的探针字符串进行调用树拆分。这对于服务器类型的探针特别有用,在这些探针中,您希望针对每种不同类型的传入请求分别查看调用树。 “HTTP server”探针会拦截 URL,并让您细粒度地控制应该使用 URL 的哪些部分来拆分调用树。默认情况下,它仅使用不带任何参数的请求 URI 路径。
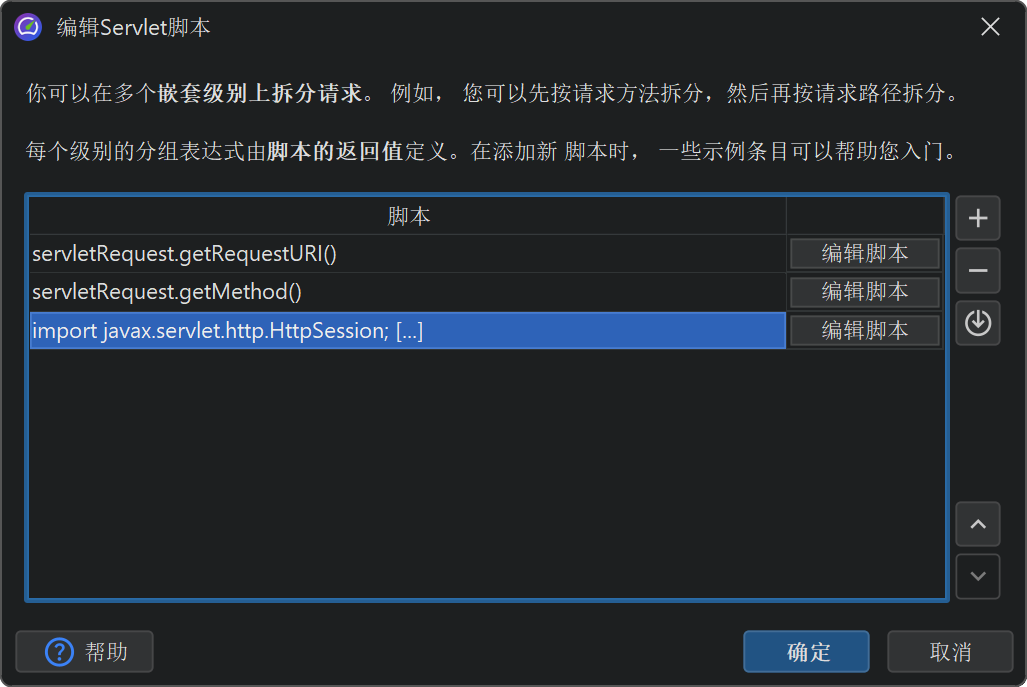
为了获得更大的灵活性,您可以定义一个脚本来确定拆分字符串。在脚本中,您获取当前的 javax.servlet.http.HttpServletRequest 作为参数并返回所需的字符串。
此外,您不仅限于单一拆分级别,还可以定义多个嵌套拆分。例如,您可以先按请求 URI 路径拆分,然后按从 HTTP 会话 (session) 对象中提取的用户名拆分。或者,您可以在按请求 URI 拆分之前按请求方法对请求进行分组。
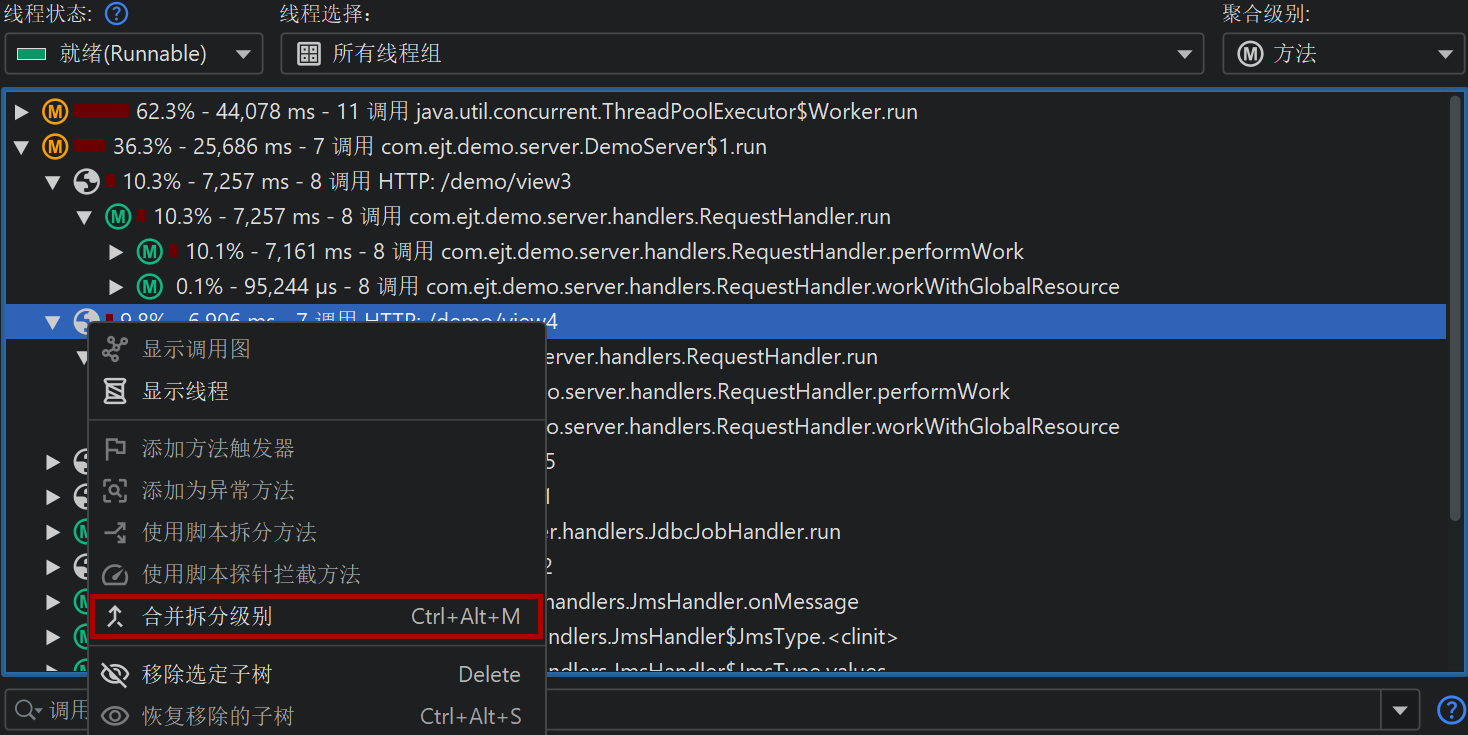
通过使用嵌套拆分,您可以在调用树 (call tree) 中查看每个级别的单独数据。查看调用树时,某个级别可能会产生干扰,您会发现自己需要从“HTTP server”探针配置中将其消除。更方便且不会丢失记录数据的是,您可以通过在相应拆分节点上使用上下文菜单,在调用树中动态临时合并和取消合并拆分级别。
拆分调用树 (call tree) 可能会导致可观的内存开销,因此应谨慎使用。为了避免内存过载,JProfiler 限制了最大拆分数量。如果达到特定拆分级别的拆分上限,则会添加一个带有用于重置上限计数器超链接的特殊“[capped nodes]”拆分节点。如果默认上限对于您的目的而言太低,您可以在配置文件设置 (profiling setting) 中调高它。