对于相同调用栈 (call stack)的重复调用,调用树 (call tree)会进行累加。这是出于内存开销的考虑,也是为了使数据更易于理解而需要整合数据。但是,有时您希望在选定的位置中断这种累加,以便能够分别查看调用树的各个部分。
JProfiler 具有调用树拆分的概念,通过在调用栈 (call stack)中插入特殊节点,并显示从插入节点上方的方法调用 (method call)中提取的语义信息。这些拆分节点允许您直接在调用树 (call tree)内部查看额外的有效负载 (payload)信息,并分别分析其包含的子树。每种拆分类型都可以通过上下文菜单中的操作动态合并和取消合并,并且对拆分节点总数设有上限,从而限制内存开销。
调用树拆分与探针
探针 (probe)可以根据它们在所关注的选定方法中收集到的信息来拆分调用树 (call tree)。例如,“HTTP server”探针 (probe)会针对每个不同的 URL 拆分调用树。在此情况下,拆分是高度可配置的,因此您可以仅包含 URL 中所需的部分、来自 Servlet 上下文的一些其他信息,甚至生成多个拆分级别。
如果您编写自己的探针 (probe),则可以通过嵌入 (embedded)和注入 (injected)自定义探针系统以相同的方式拆分调用树 (call tree)。
使用脚本拆分方法
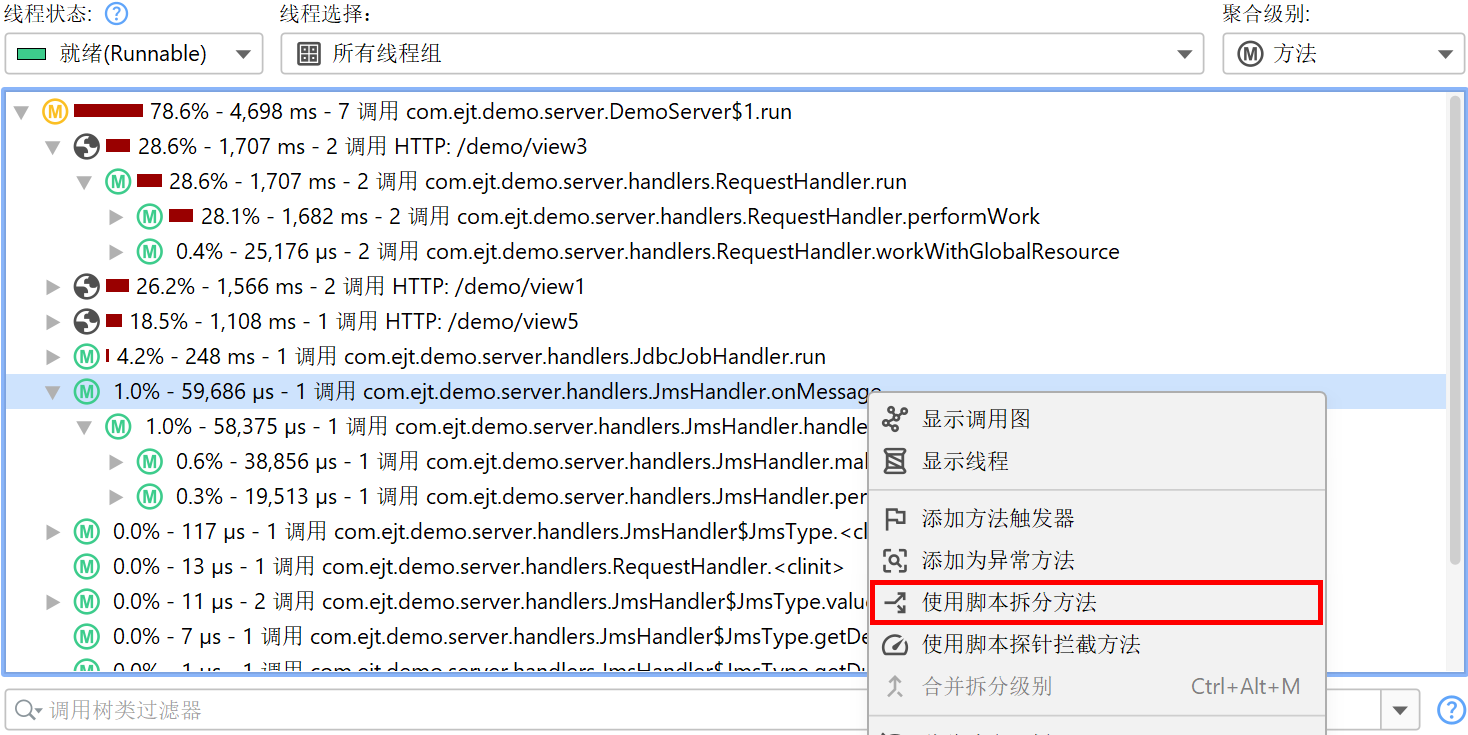
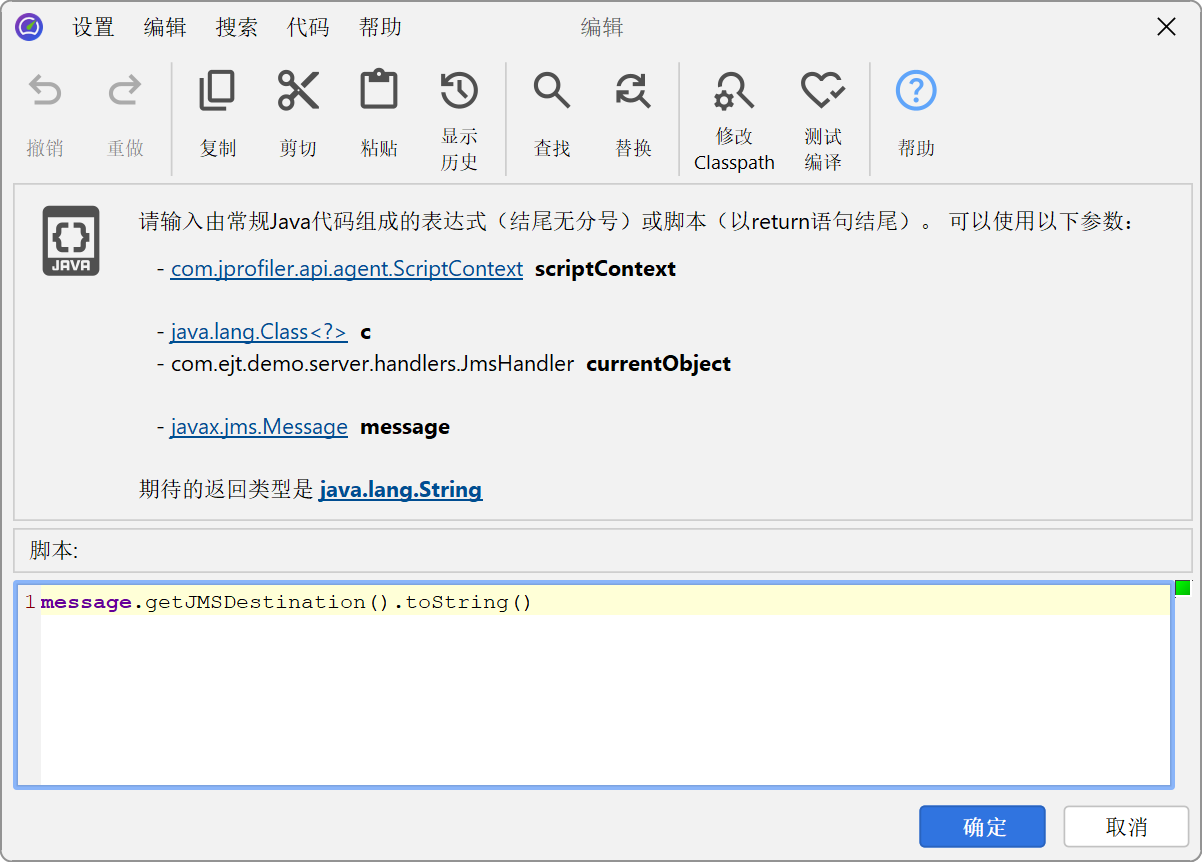
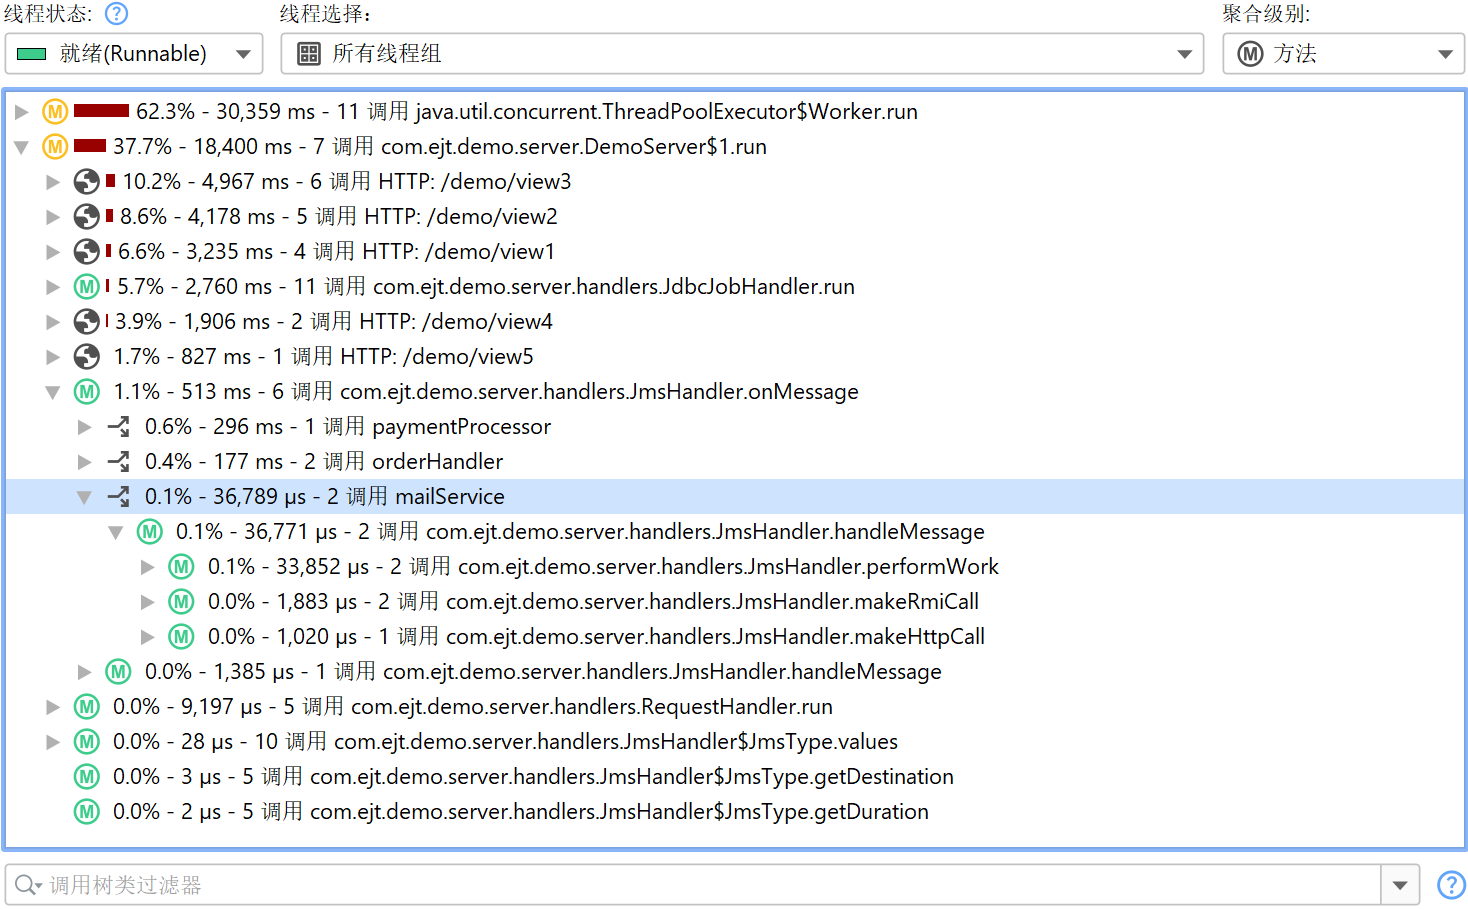
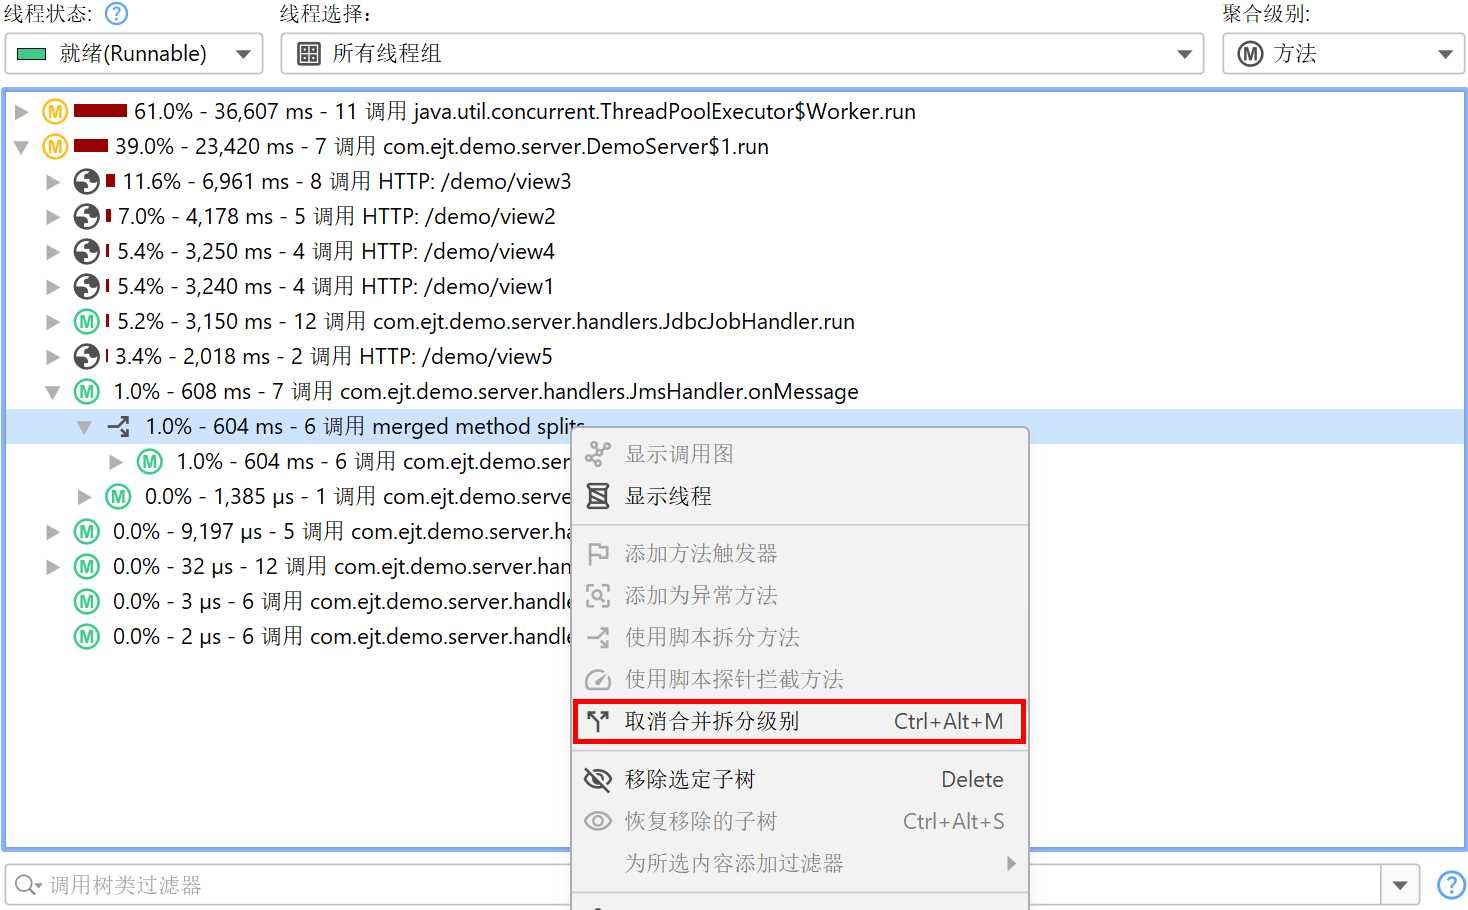
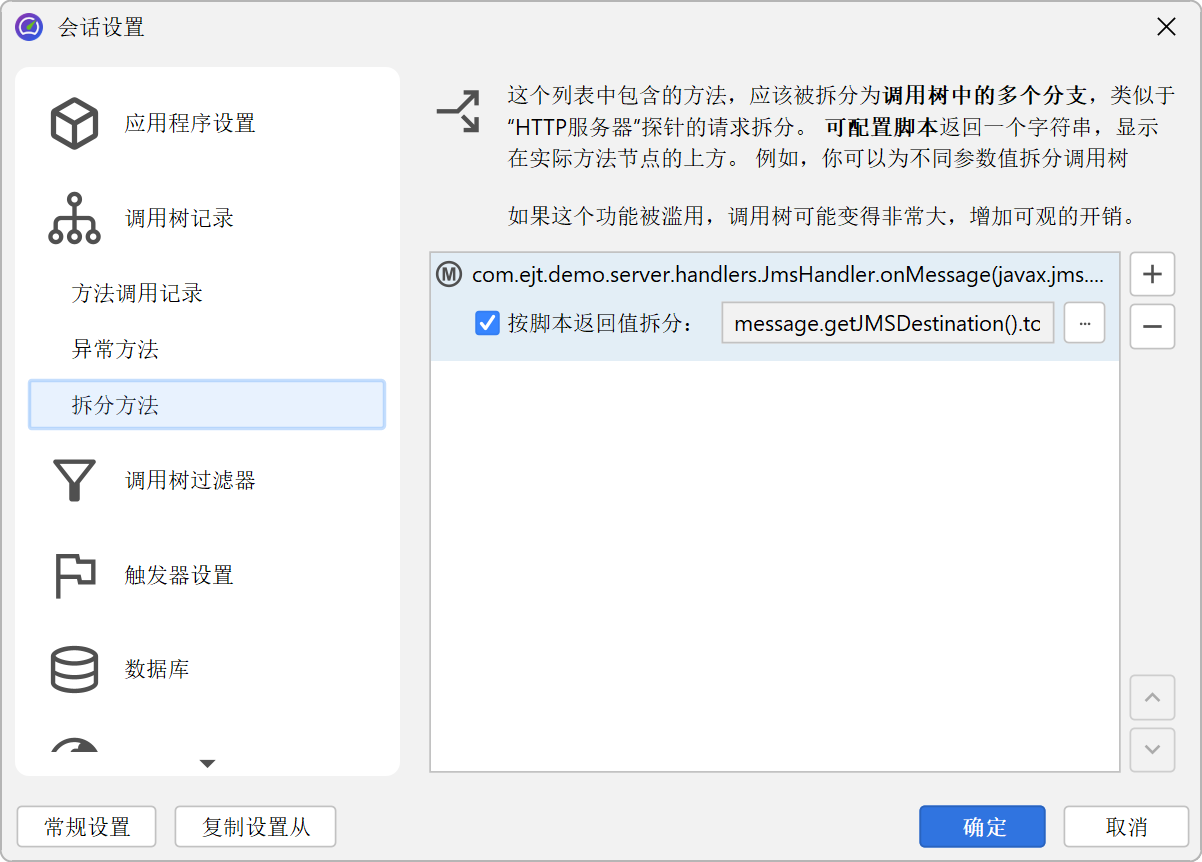
探针 (probe)具备的相同拆分功能也可以通过 使用脚本拆分方法 (Split Method with a Script) 操作直接在调用树 (call tree)中使用。在下方的屏幕截图中,我们希望为 JMS 消息处理程序拆分调用树,以便分别查看不同类型消息的处理情况。
您无需编写探针 (probe),只需输入一个返回字符串的脚本即可。该字符串用于在选定方法处对调用树 (call tree)进行分组,并显示在拆分节点中。如果您返回 null,则当前方法调用
(method call)将不会被拆分,而是照常添加到调用树中。
该脚本可以访问多个参数。它会接收选定方法的类、非静态方法的实例以及所有方法参数。此外,您还会获得一个可用于存储数据的 ScriptContext
对象。如果您需要从同一脚本的先前调用中读取某些值,可以调用上下文中的 getObject/putObject 和 getLong/putLong
方法。例如,您可能只想在首次出现特定方法参数值时进行拆分。然后您可以使用
if (scriptContext.getObject(text) == null) {
    scriptContext.putObject(text, text);
    return text;
} else {
    return null;
}
作为拆分脚本的一部分。
拆分节点会插入到选定方法下方。对于上述屏幕截图中的示例,我们现在可以分别查看每个 JMS 消息目标的处理代码。
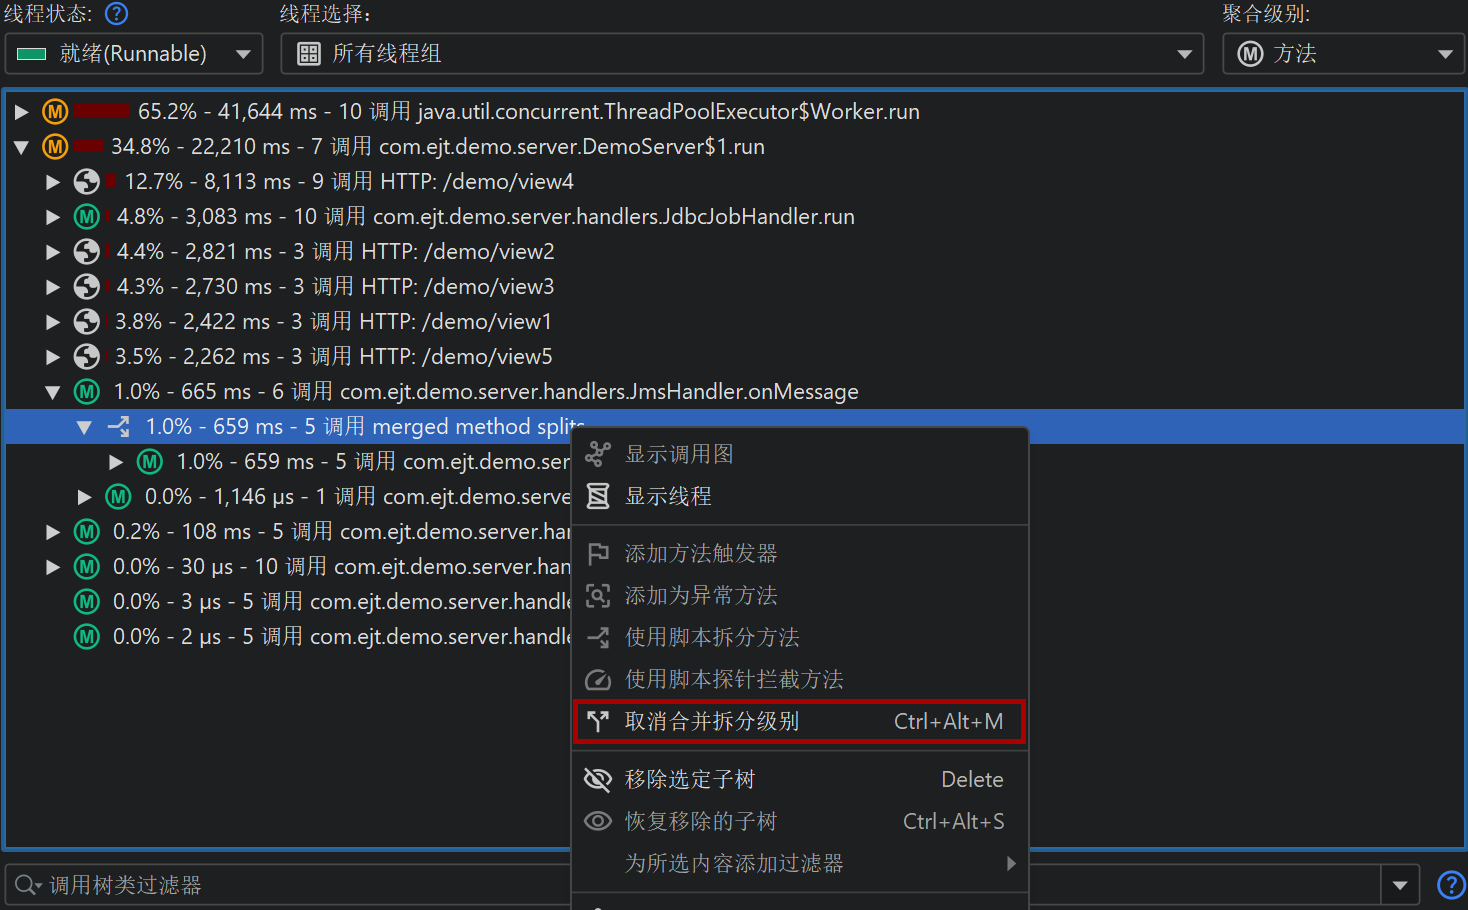
拆分位置绑定到方法,而不是选定的调用栈 (call stack)。如果相同的方法出现在调用树 (call tree)中的其他位置,它也将被拆分。如果您使用 合并拆分级别 (Merge splitting level) 操作,所有拆分将合并为一个节点。该节点使您能够随时再次取消合并拆分。
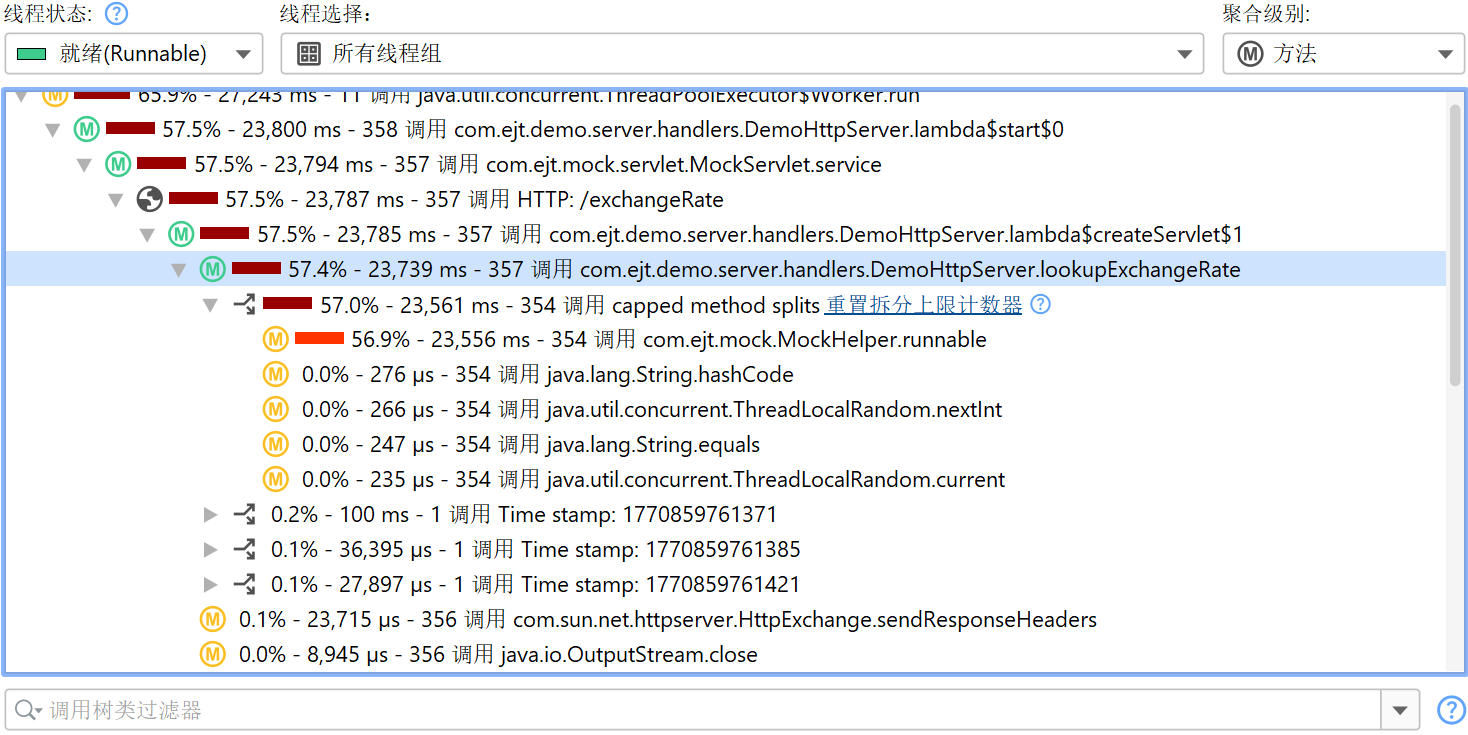
如果您产生了过多的拆分,标记为 受限的方法拆分 (capped method splits) 的节点将包含所有后续的拆分调用,并累加到单个树中。通过该节点中的超链接,您可以重置上限计数器并记录更多拆分节点。若要永久增加拆分的最大数量,您可以在配置文件设置 (profiling setting)中调高上限。
若要在创建拆分方法后对其进行编辑,请转到会话 (session)设置对话框。如果您不再需要某个特定的拆分方法,但希望保留它以备将来使用,可以通过脚本配置前面的复选框将其禁用。这比仅在调用树 (call tree)中合并它更好,因为记录开销可能会很显著。