

JProfiler 16.1 中引入的 MCP 服务器为 AI 编码代理提供了一套聚焦的性能分析工作流:记录 CPU 数据、查找热点并深入分析。在 JProfiler 16.3 中,MCP 服务器已远远超出最初的功能范围,现在覆盖了 JProfiler 的所有主要子系统,代理因此能够独立完成完整的性能分析工作流。MCP 工具参考详细介绍了所有可用的工具和资源。
JProfiler 的新功能
详细的变更列表请参阅更新日志。
新支持的子系统:
- 堆转储分析:可以在实时会话中获取堆转储,新建快照和已有快照都可以通过类直方图、最大对象、带值过滤器的实例查询、引用链、到 GC 根的路径、支配链以及自动化的堆检查进行分析。堆遍历器脚本可用于过滤和自定义分组。
- 探针事件:可以查询单个事件及其回溯、事件直方图和事件时间线;对于泄漏分析,会列出仍处于打开状态的控制对象(例如 JDBC 连接),并附上打开调用的堆栈跟踪。
- 监视器与锁:提供监视器统计、争用时间线、加锁历史和锁图,还可以对实时 JVM 执行监视器转储以进行死锁分析。
- 可以获取线程转储,包括虚拟线程层次结构。
- GC 数据:提供每次垃圾回收的触发原因、暂停时间、阶段和堆使用情况,以及 GC 配置和标志。
- MBean 快照:可以按需或定期捕获当前的 JMX MBean 属性值。
- 遥测数据:所有遥测数据集均可用,从 CPU 和堆使用情况到探针遥测数据。
- 分配记录:分配热点和调用树会显示每个调用点所分配的类和字节数,包括已被垃圾回收的对象。
- 方法复杂度分析:由脚本定义每次方法调用的复杂度(例如输入集合的大小),并通过曲线拟合将测得的执行时间与常见的大 O 复杂度关联起来。
- JavaScript 来源跟踪:提供被分析应用程序中 XHR 请求的浏览器调用栈。
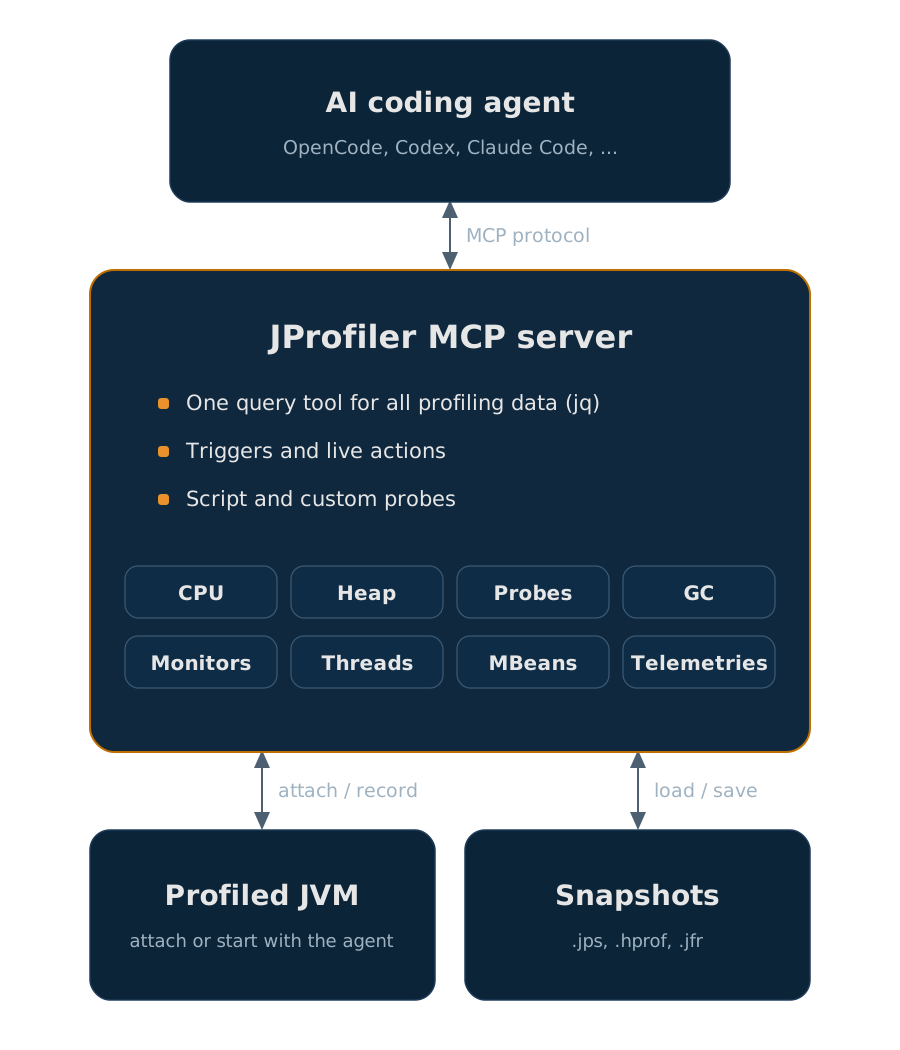
CPU 分析也得到了扩展:代理现在可以选择线程和线程组、按线程状态过滤、将热点和调用树节点归因到具体的线程,并借助离群值检测和异常方法记录来排查偶尔缓慢的调用。
触发器让代理能够捕获交互式工具调用无法获取的数据。线程转储、堆转储和 MBean 快照等操作可以在定时器到期时、跨越堆或 CPU 阈值时或调用特定方法时自动触发。这样一来,既可以从 JVM 启动开始记录,也可以监视长时间运行的会话,捕捉堆峰值等瞬时状态。这些操作还可以作为实时操作直接在运行中的 JVM 上执行。
借助脚本探针,代理可以即时定义全新的探针:脚本探针用一段 Java 代码拦截选定的方法,并像内置探针一样记录其结果,无需任何部署步骤。若要进行永久性插桩,代理可以编写自定义探针,使其成为被分析应用程序的一部分,最便捷的方式是使用嵌入式探针 API 编写嵌入式探针。自定义探针的记录和分析方式与内置探针完全相同,而且探针配置以及脚本探针和自定义探针 API 都以 MCP 资源的形式公开,代理可以在工作时随时查阅。
所有数据都通过一个使用 jq 表达式的查询工具获取,它取代了先前版本中众多的专用工具。更精简、统一的工具集让代理更加可靠:过滤、聚合和深入分析性能数据只有一种方式,并且在所有子系统中的工作方式完全一致。
配置方式保持不变:在 JProfiler UI 中配置您的代理,或按照 MCP 设置页面上的说明操作。
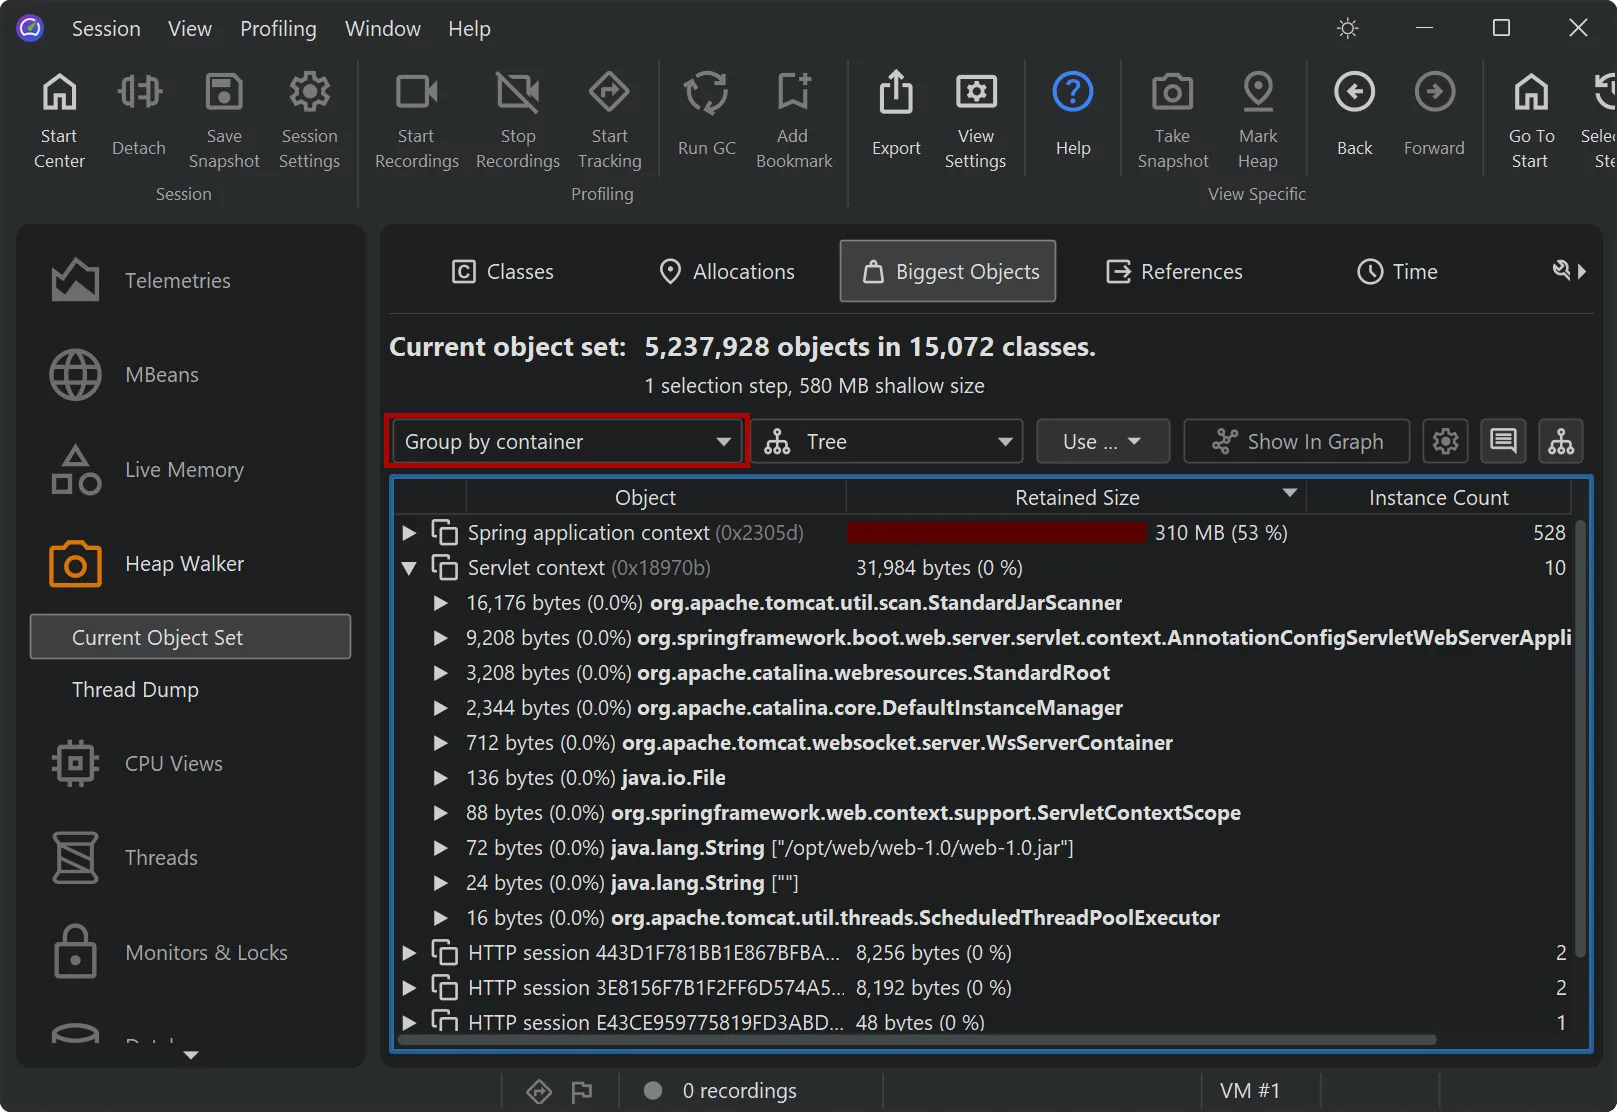
堆遍历器中的最大对象视图现在能够理解常见框架的语义。借助新增的“按容器分组”分组方式,对象会按照所属的框架容器进行分组。顶层显示带有标签的容器节点,涵盖 Spring 应用程序上下文、Servlet 会话、Servlet 上下文和 Hibernate 持久化上下文,并显示其托管对象的累计保留大小。
展开容器即可直接显示托管对象,中间不再夹杂任何框架注册表内部细节的引用链。诸如“哪个 Servlet 会话保留了最多的内存”或“这个对象属于哪个 Spring 应用程序上下文”之类的问题,现在可以直接在最大对象视图中得到解答。
JProfiler 现已附带 Maven 插件,补齐了与现有 Gradle 插件和 Ant 任务之间的差距。profile 目标会在附加分析代理的情况下运行项目的主类:
mvn com.jprofiler:jprofiler-maven:16.3:profile -Djprofiler.mainClass=com.example.Main
也可以在 POM 中配置插件:
<plugin>
  <groupId>com.jprofiler</groupId>
  <artifactId>jprofiler-maven</artifactId>
  <version>16.3</version>
  <configuration>
    <mainClass>com.example.Main</mainClass>
  </configuration>
</plugin>
之后只需执行 mvn jprofiler:profile 即可。其他目标支持在 CI 环境中执行无界面任务:export、compare 和 analyze 用于在命令行处理快照,而 set-agentpath-property 会准备一个包含 -agentpath VM 参数的属性,供其他插件使用。详情请参阅 Maven 目标文档。
如果在构建机器上没有配置 JProfiler 安装,Gradle 任务和新的 Maven 目标现在可以自动下载 JProfiler 安装。这让在 CI 流水线中进行性能分析变得容易得多:无需先在构建节点上安装 JProfiler,构建集成会按需预配置所需的版本。
在 Gradle 中,只需省略安装目录即可:
jprofiler {
    // installDir = file('/opt/jprofiler')
}
如果不指定 installDir,插件会下载版本与插件一致的 JProfiler 发行版,并将其缓存在 Gradle 用户主目录中。Maven 目标的工作方式与此相同。
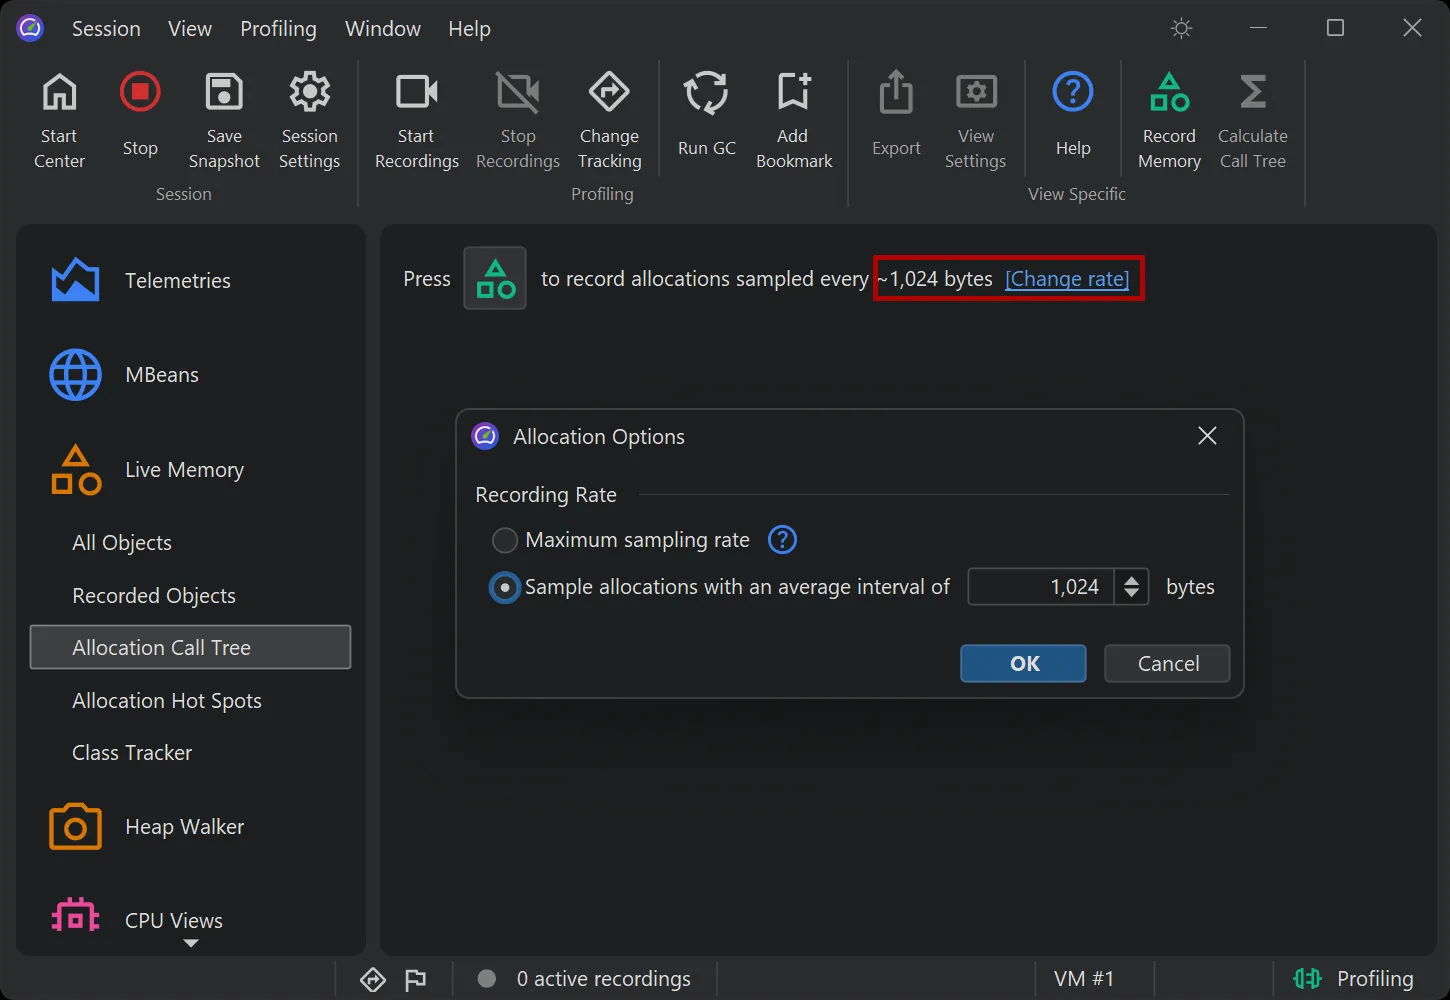
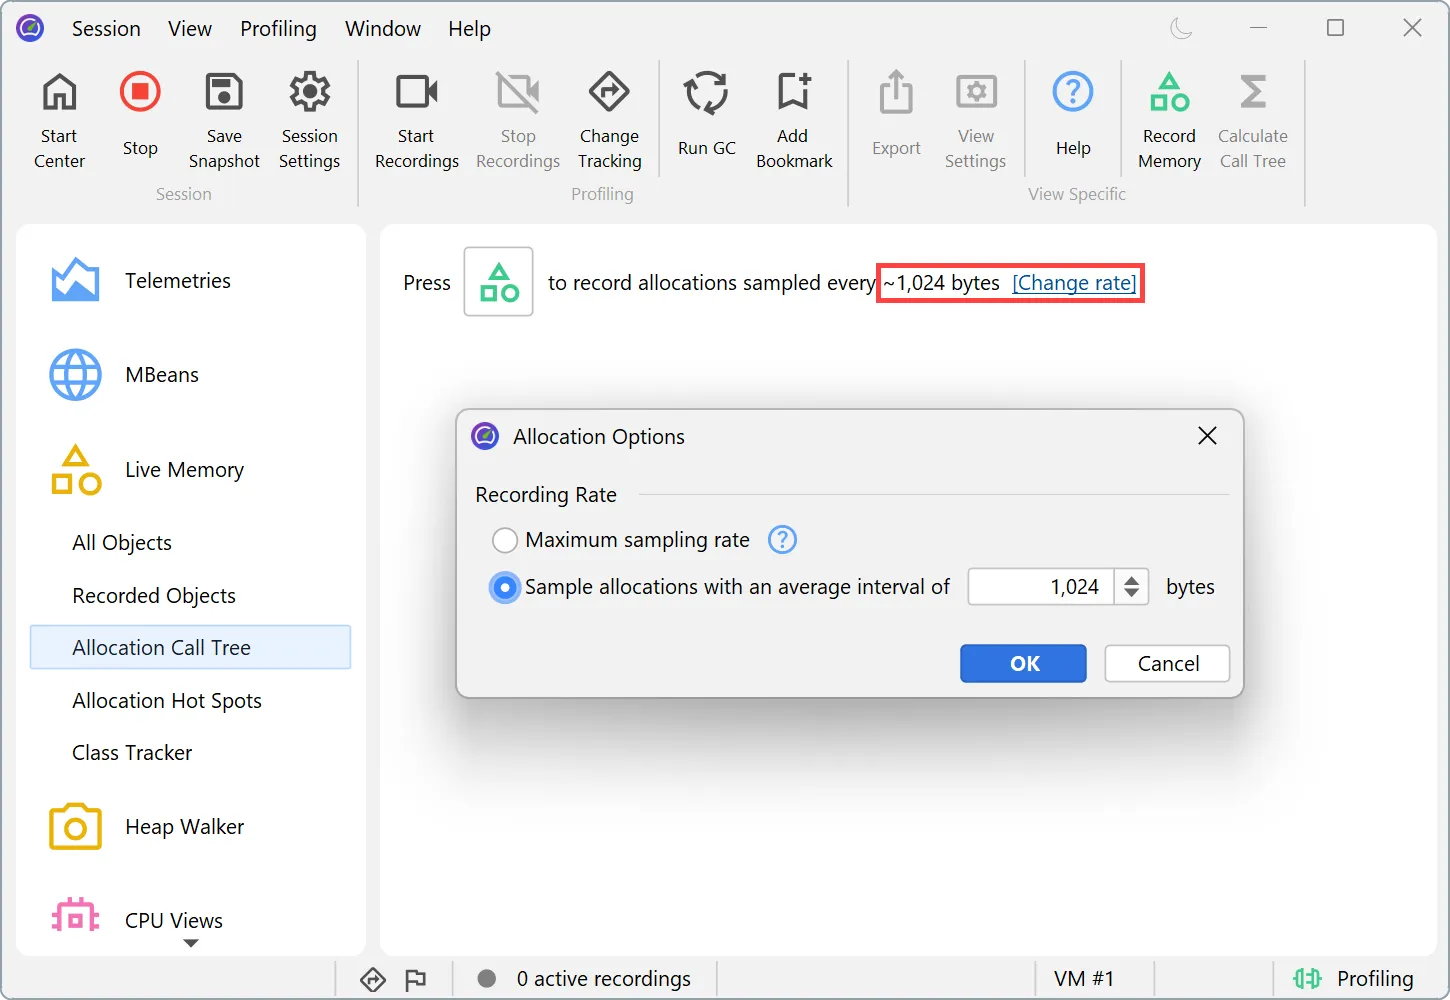
在 Java 11+ 上,分配记录现在默认采用基于低开销 JVMTI 分配采样机制(JEP 331)的字节间隔采样。分析代理不再通过对构造函数进行插桩来记录每第 n 个对象,而是从 JVM 接收采样分配事件,每分配 N 个字节触发一次。
这消除了构造函数插桩可能造成的测量失真,因为这类插桩会禁用 HotSpot JIT 中的逃逸分析。与此同时,记录开销也更低。
采样间隔现在以字节为单位进行配置,默认值为 1024。在 Java 8 以及不具备 JVMTI 采样能力的 JVM 上,会自动改用先前基于插桩的记录方式。
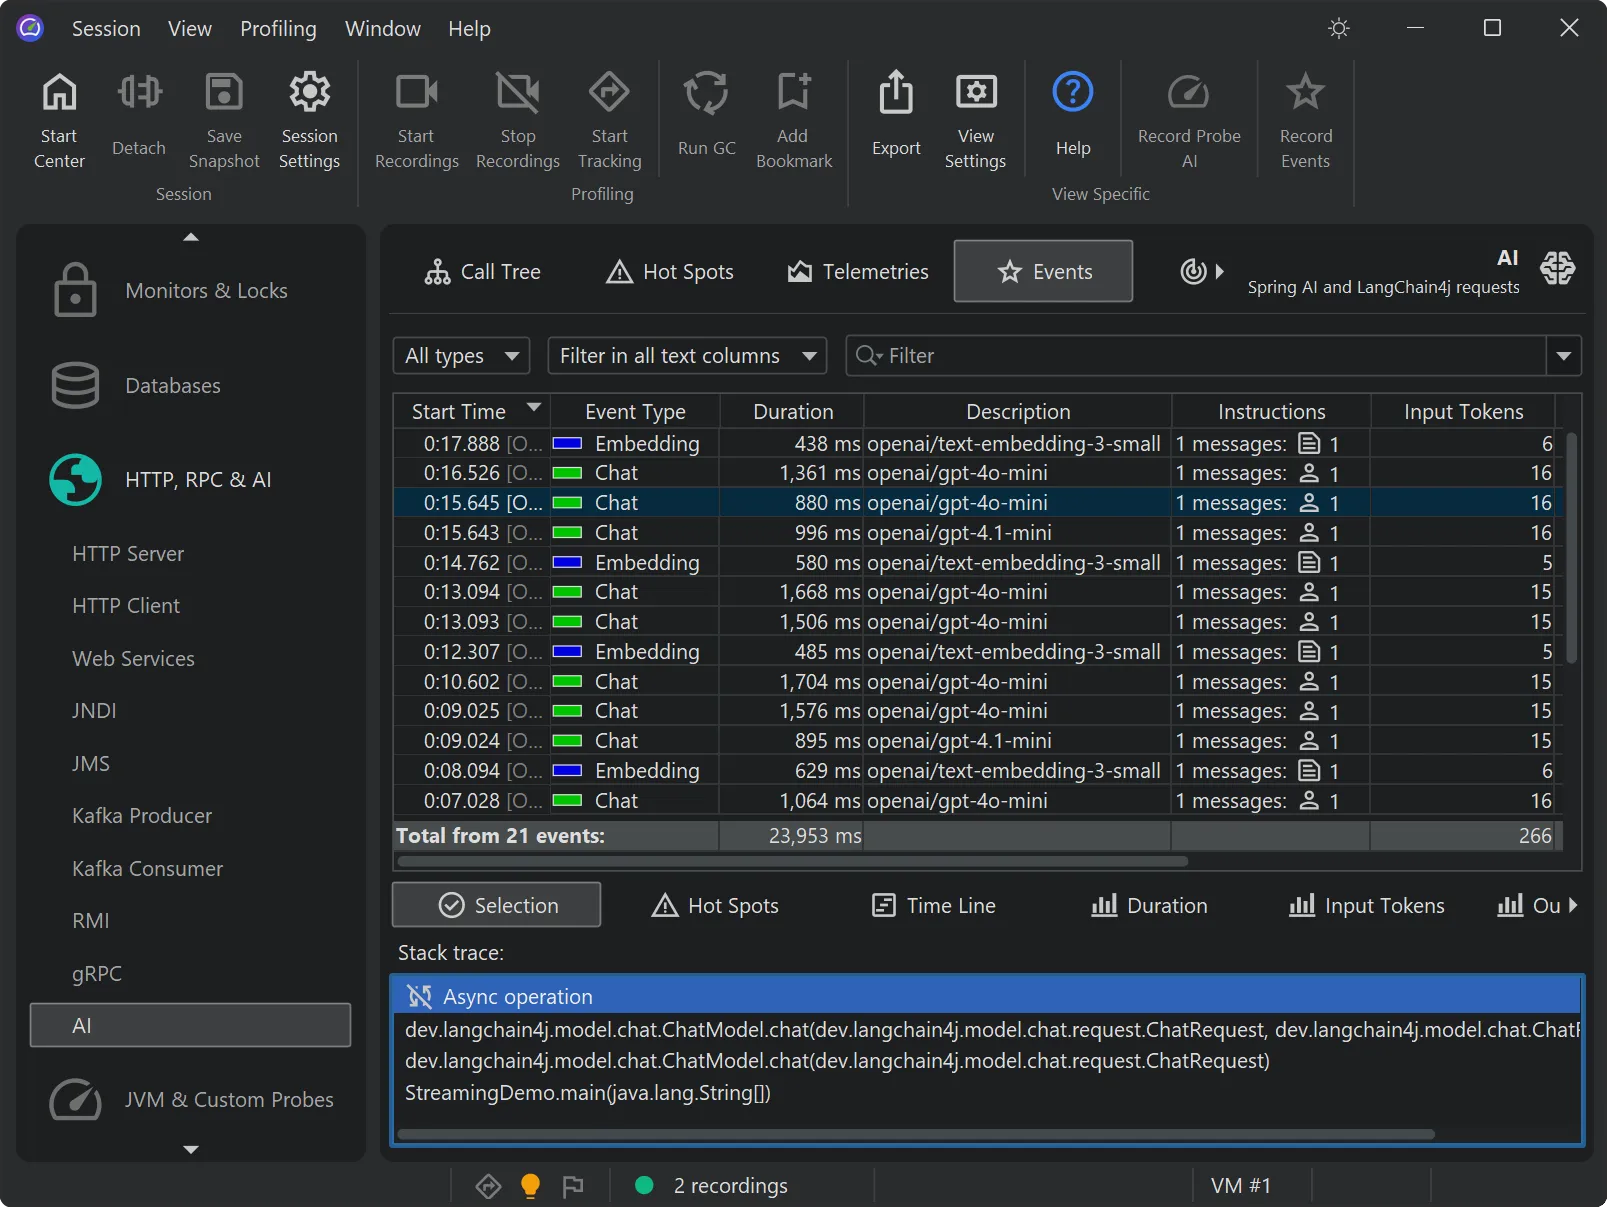
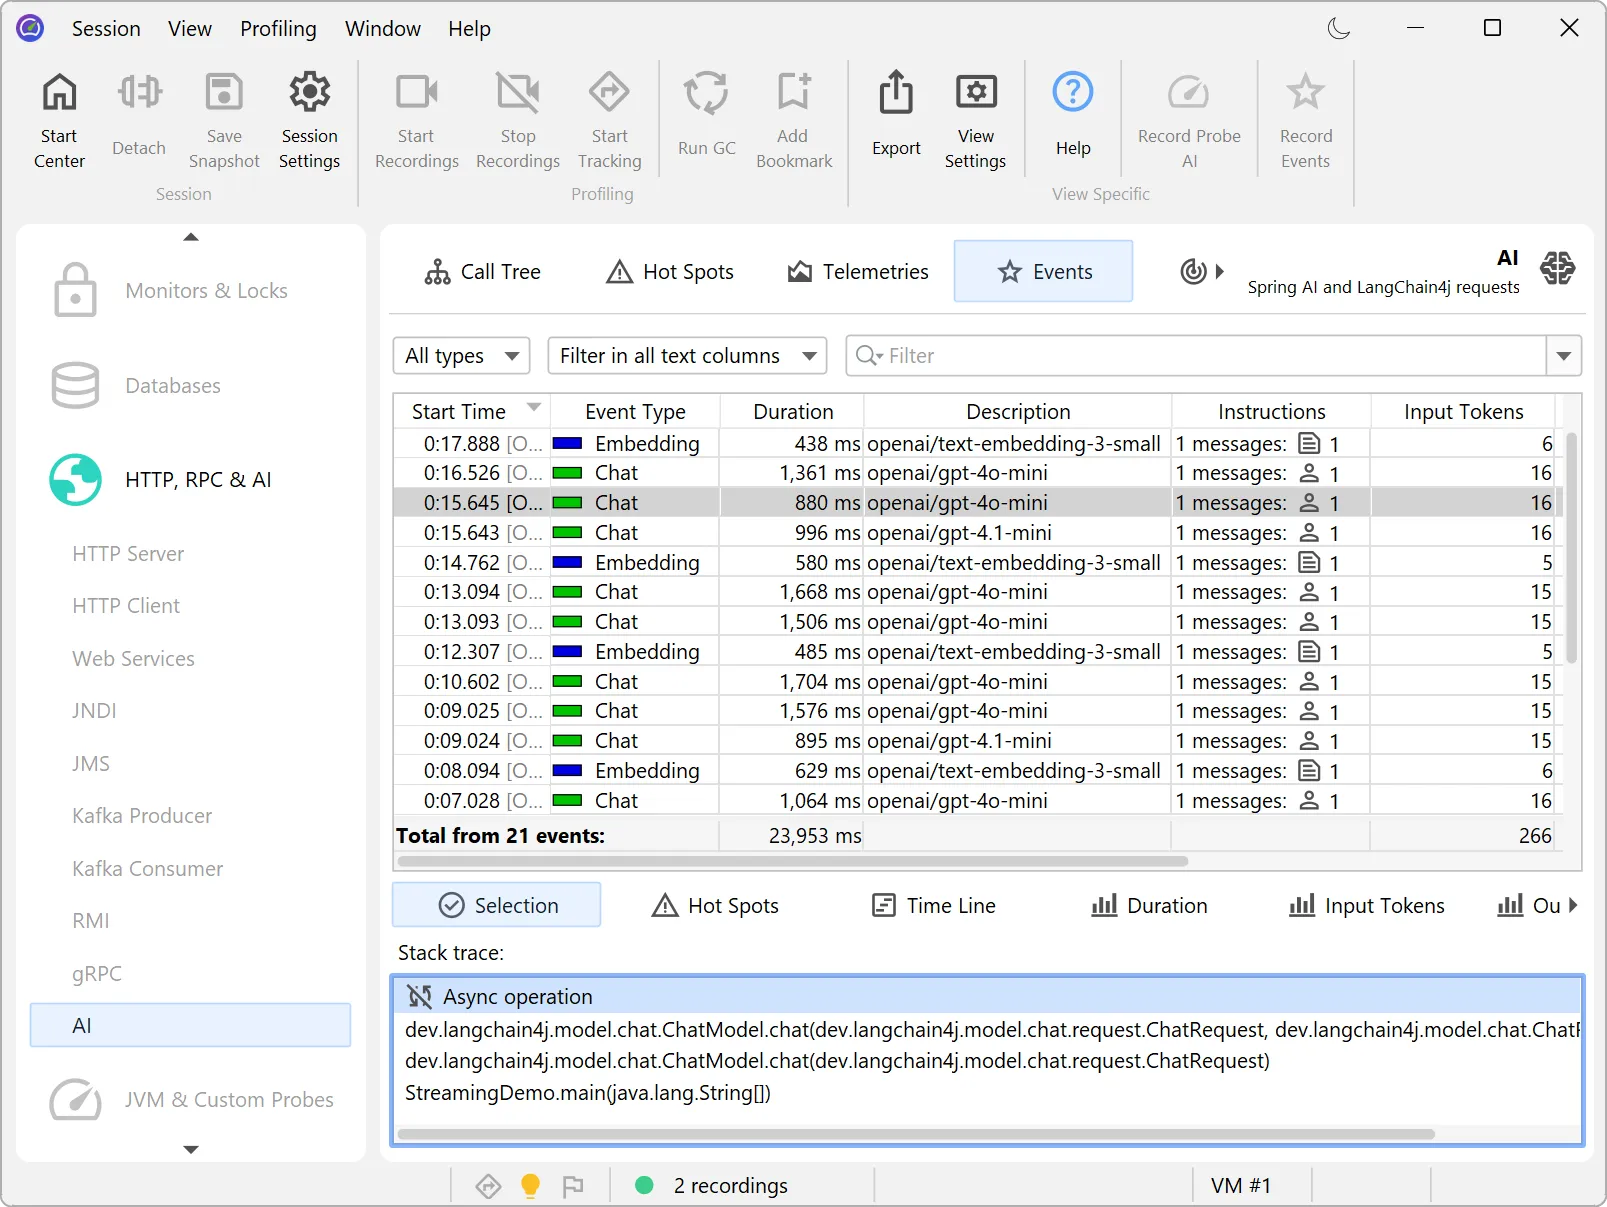
AI 探针现已支持 LangChain4j 的异步和流式请求,从而覆盖 LangChain4j 的所有 LLM 交互模式。
流式响应会被组装为完整的回复,token 用量和总耗时的记录方式与同步调用完全相同。异步请求会被持续跟踪,直至其完成、取消或超时,因此事件、热点和遥测数据能够为所有这些请求呈现正确的数据。
离线分析现在可以直接在 -agentpath VM 参数中进行配置,无需 JProfiler 配置文件。在此之前,离线模式要求您先从 JProfiler UI 导出会话配置。
您可以直接内联指定最常用的分析设置:通过 callTreeMode 指定调用树收集模式,通过 profile、compact 和 ignore 指定分析、精简和忽略的包过滤器。除此之外,您还可以添加完整的自动记录序列,利用 snapshot、recording、duration 和 delay 选项,无需任何 API 调用或 jpcontroller 即可保存快照。
例如,以下参数
-agentpath:...=offline,callTreeMode=sampling,profile=com.mycorp.,\
    snapshot=/tmp/snapshot.jps,recording=cpu:allocation,duration=10m
会记录十分钟 CPU 和分配数据,然后保存快照。
jpenable 命令行工具同样支持这些内联设置和记录选项,它可将分析代理附加到已经在运行的 JVM 上。选择离线模式后,jpenable 会通过其功能丰富的交互式控制台引导您完成各项设置。
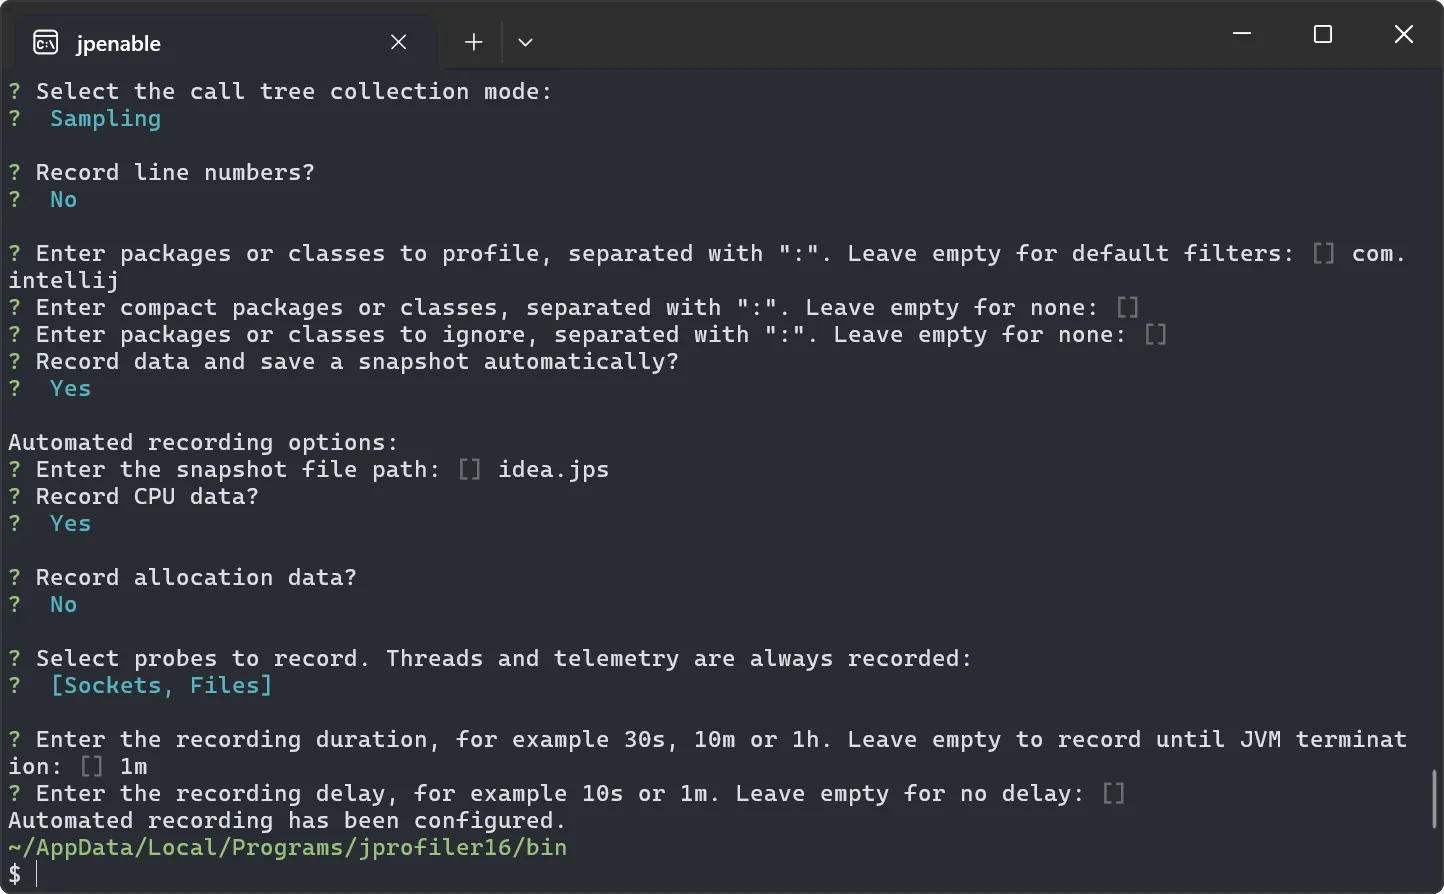
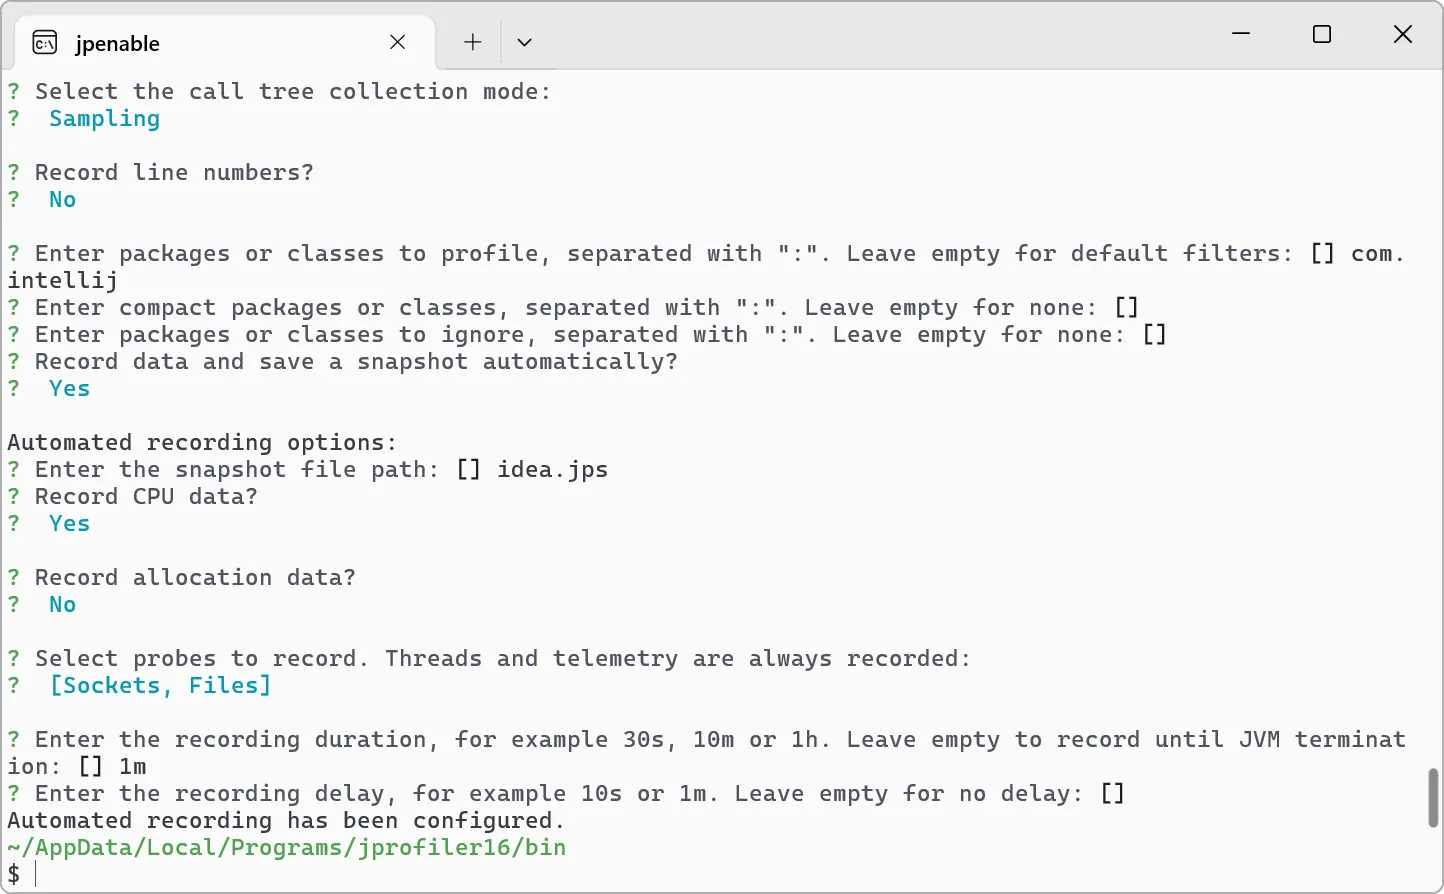
您也可以改在命令行上通过 --call-tree-mode、--profile、--line-numbers、--snapshot、--recording、--duration 等选项提供这些设置,以便在 CI 流水线中进行非交互式使用。
Gradle 和 Ant 分析任务通过任务属性提供了相同的功能,因此您可以直接在构建脚本中配置离线分析和自动记录序列。
JProfiler 16.1 中引入的 MCP 服务器得到了改进。它现在能够可靠地配合较弱的模型工作,并能更稳健地遵循分析工作流程。Antigravity 已新增为受支持的 AI 编码工具。
JProfiler 现在自带一个 MCP(Model Context Protocol,模型上下文协议)服务器,让 AI 编程代理能够对您的 Java 应用程序进行性能分析、分析结果并据此采取行动。它支持 Claude Code、Cursor、Codex、Gemini CLI 以及任何其他兼容 MCP 的 AI 编程工具。
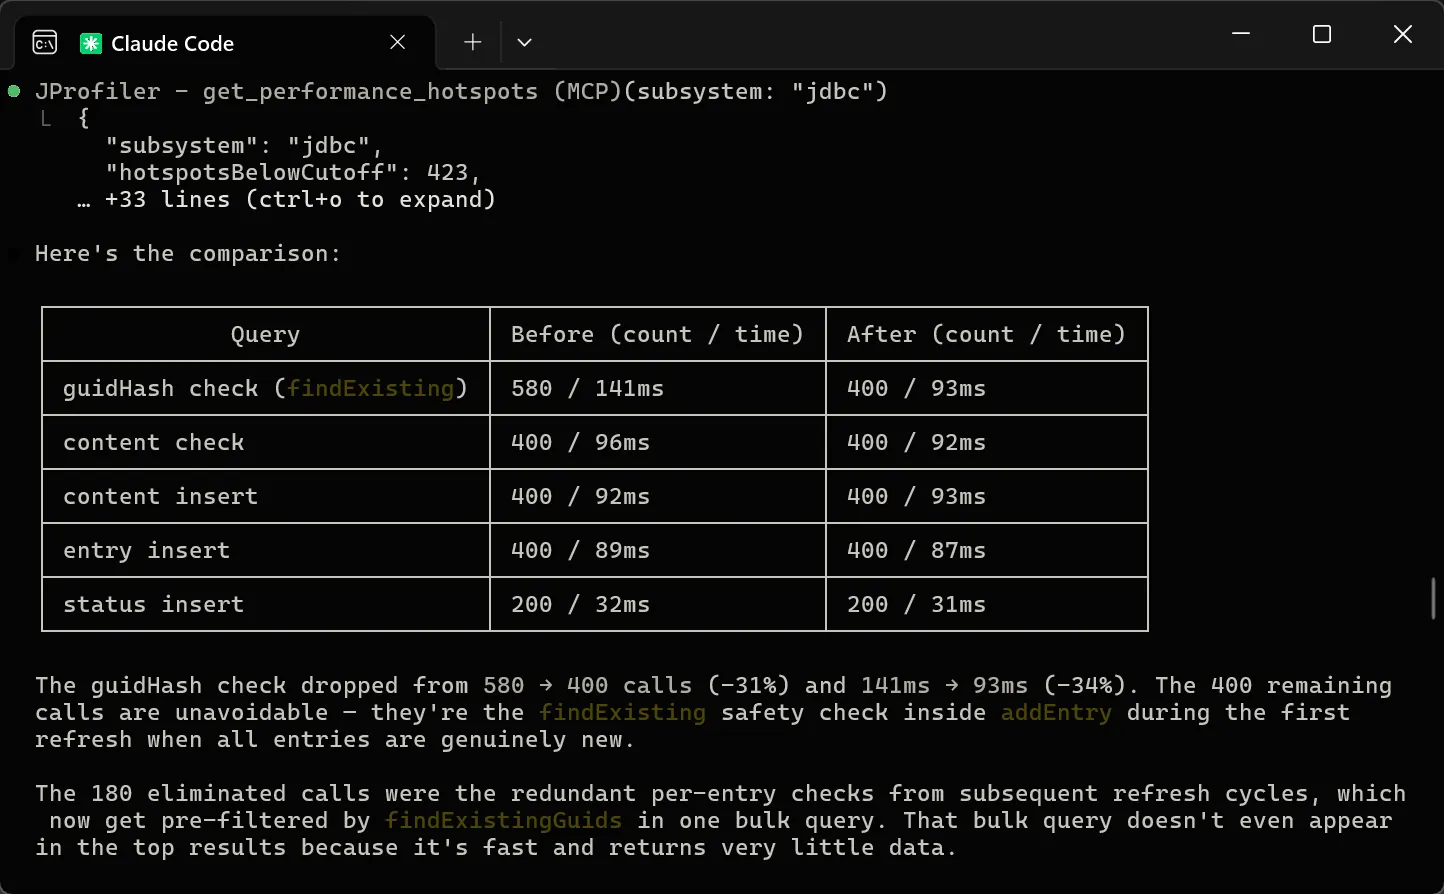
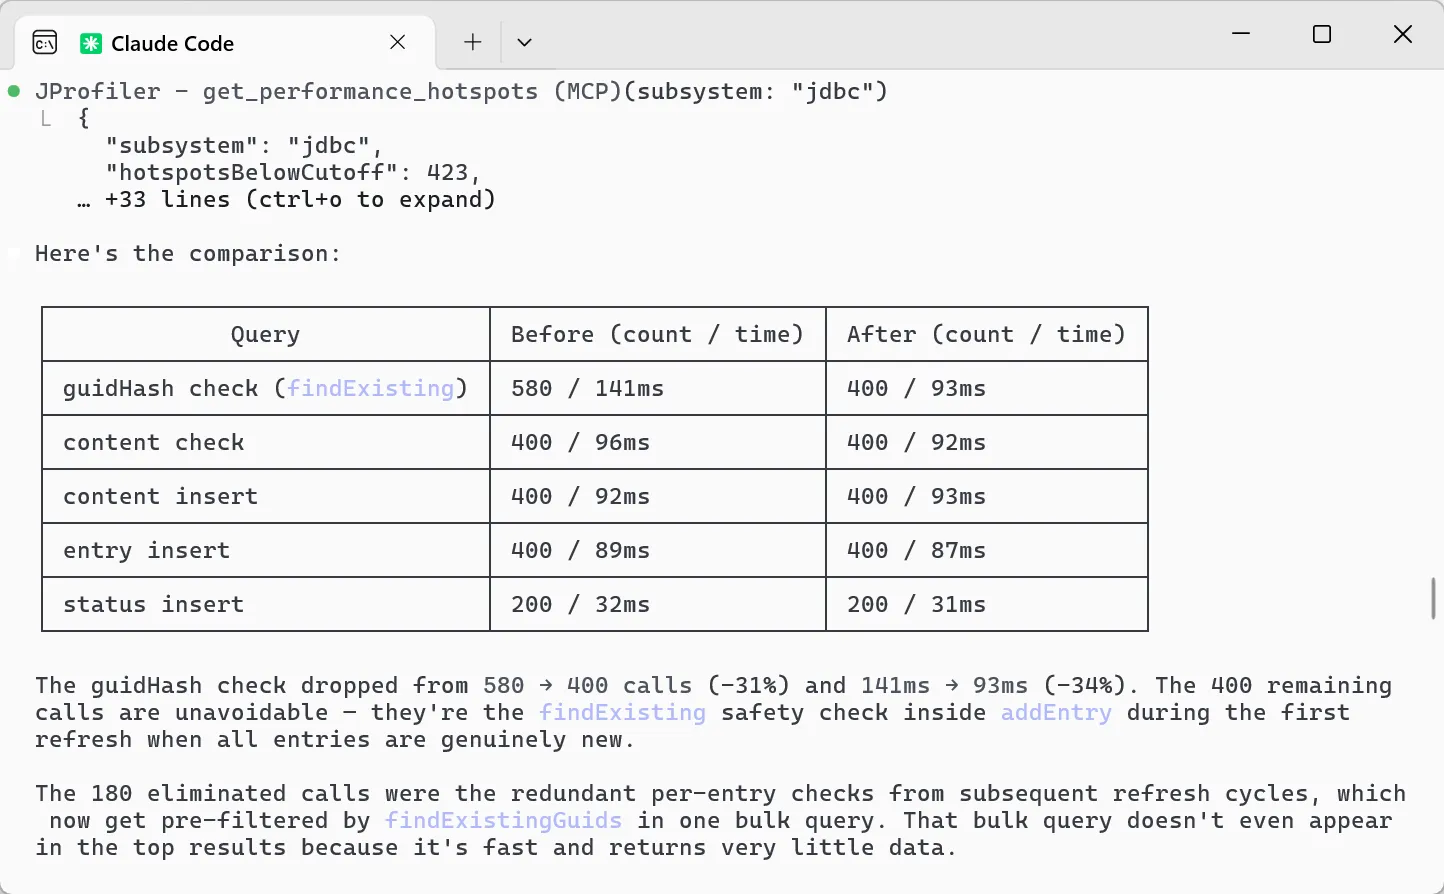
在此之前,性能分析一直是您在 GUI 中完成的工作:启动会话、浏览视图、解读数据。借助 MCP 服务器,代理可以自行完成整个闭环:对应用程序进行性能分析,发现 JDBC 查询占据了大部分执行时间,修改代码以消除冗余的数据库调用,再次分析以验证改进效果,并用具体数字呈现优化前后的对比。
MCP 服务器提供的工具经过了精心的设计和充分的测试,确保代理能够可靠地遵循与专家使用 JProfiler 的方式一致的性能分析工作流。代理首先为目标应用程序设置性能分析。测试运行完成后,它会检查数据是否可用,并获取初始的聚合热点视图,以了解时间消耗在何处。随后,它会深入分析各个具体热点,沿调用链一路追踪到根本原因。
每一步的数据都经过精心筛选,使代理既能看到关键内容,又不会被信息淹没,无论它们是在分析 CPU 热点、JDBC 和 JPA 查询、HTTP 调用、MongoDB 操作,还是堆转储。除了对本地和容器化 JVM 进行实时性能分析之外,代理还可以加载现有的 JProfiler、HPROF 或 JFR 快照进行分析。
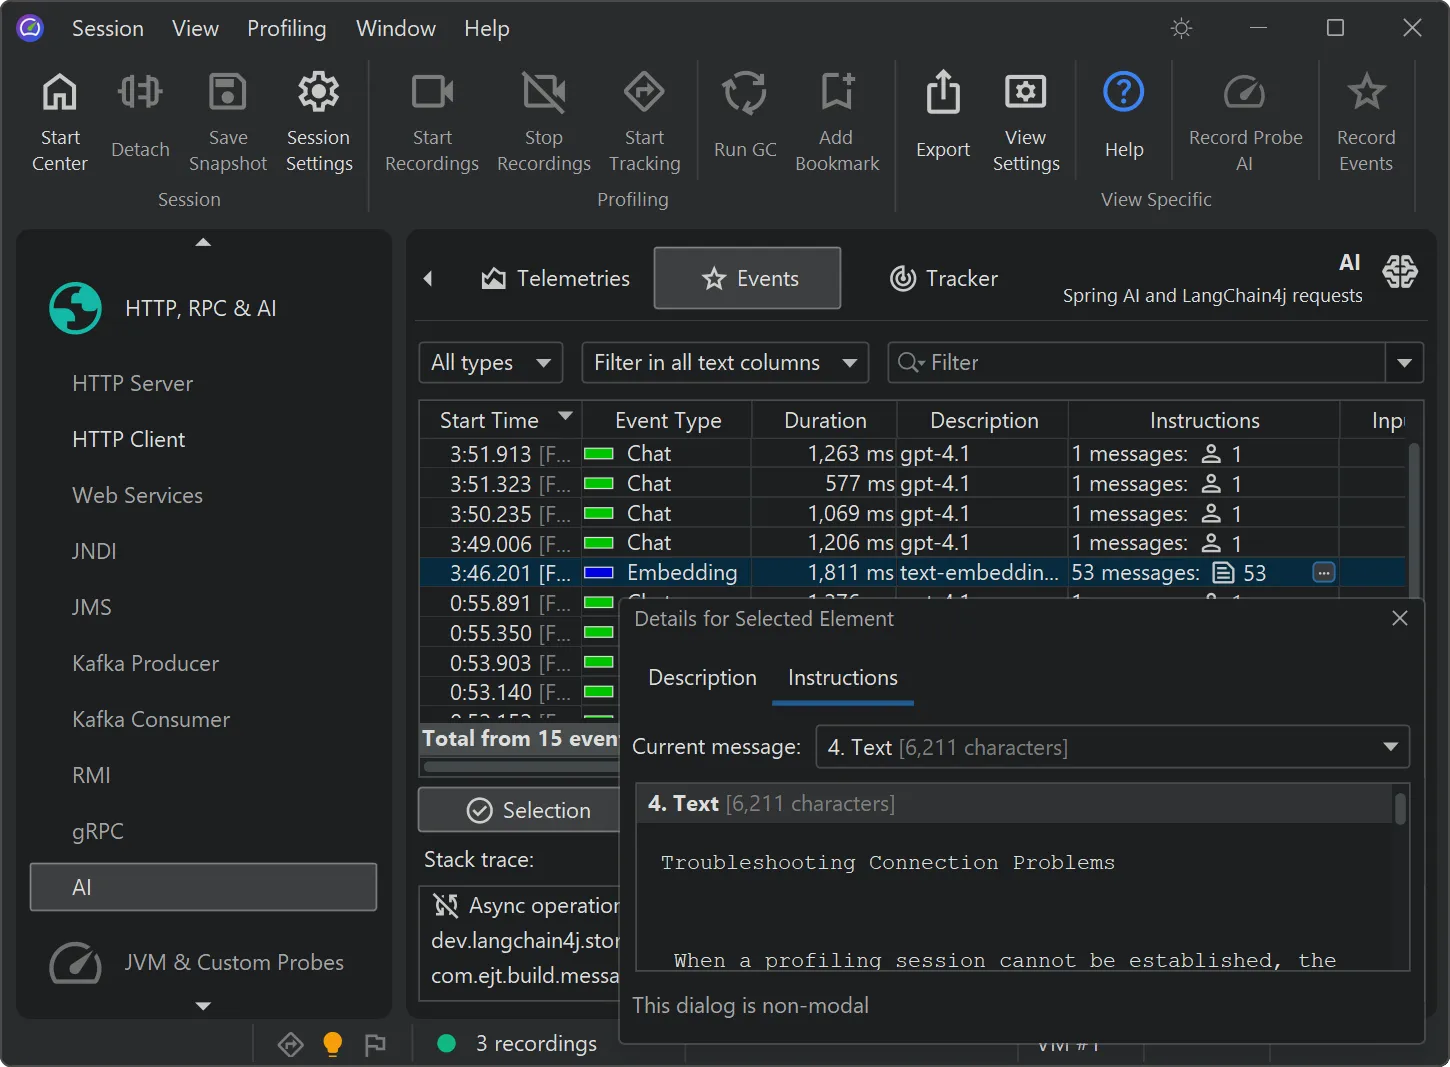
JProfiler 16 引入了 AI 探针。该探针通过 LangChain4j 和 Spring AI 度量与 LLM 的交互。
支持聊天请求和嵌入(embedding),并在事件视图中以不同的事件类型显示。
已处理指令的详细信息可在节点详细信息对话框中查看,通过指令列中的悬停按钮即可打开该对话框。指令列会显示不同指令类型的统计信息,例如用户消息、助手消息或工具消息。
AI 探针以事件为中心。您可以通过两种方式处理已记录事件的子集:第一种,选中多个事件时,底部的选择面板会为当前选择提供 CPU 热点、探针热点和探针调用树。
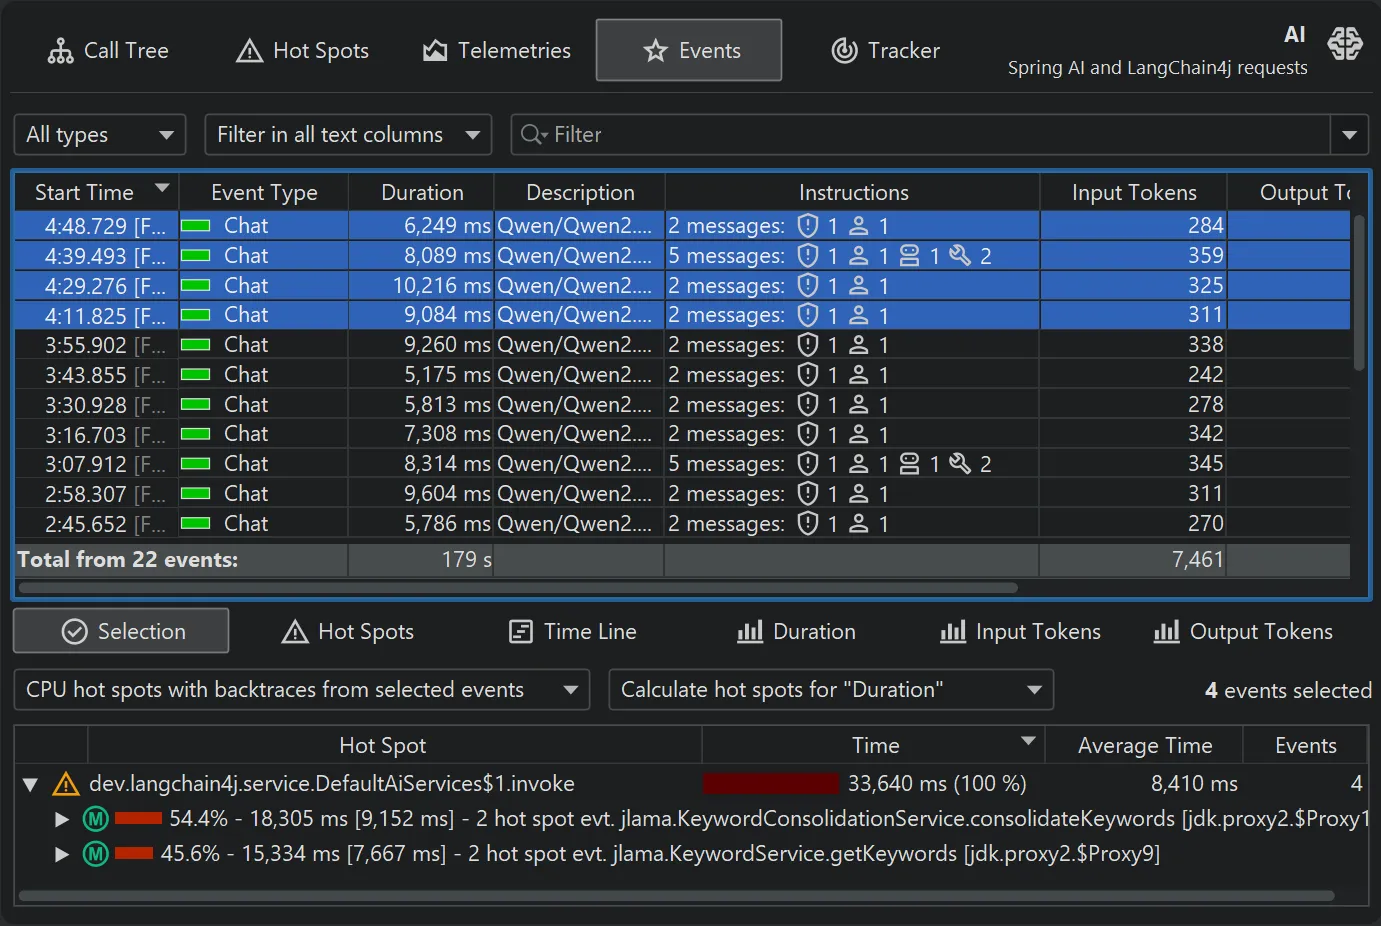
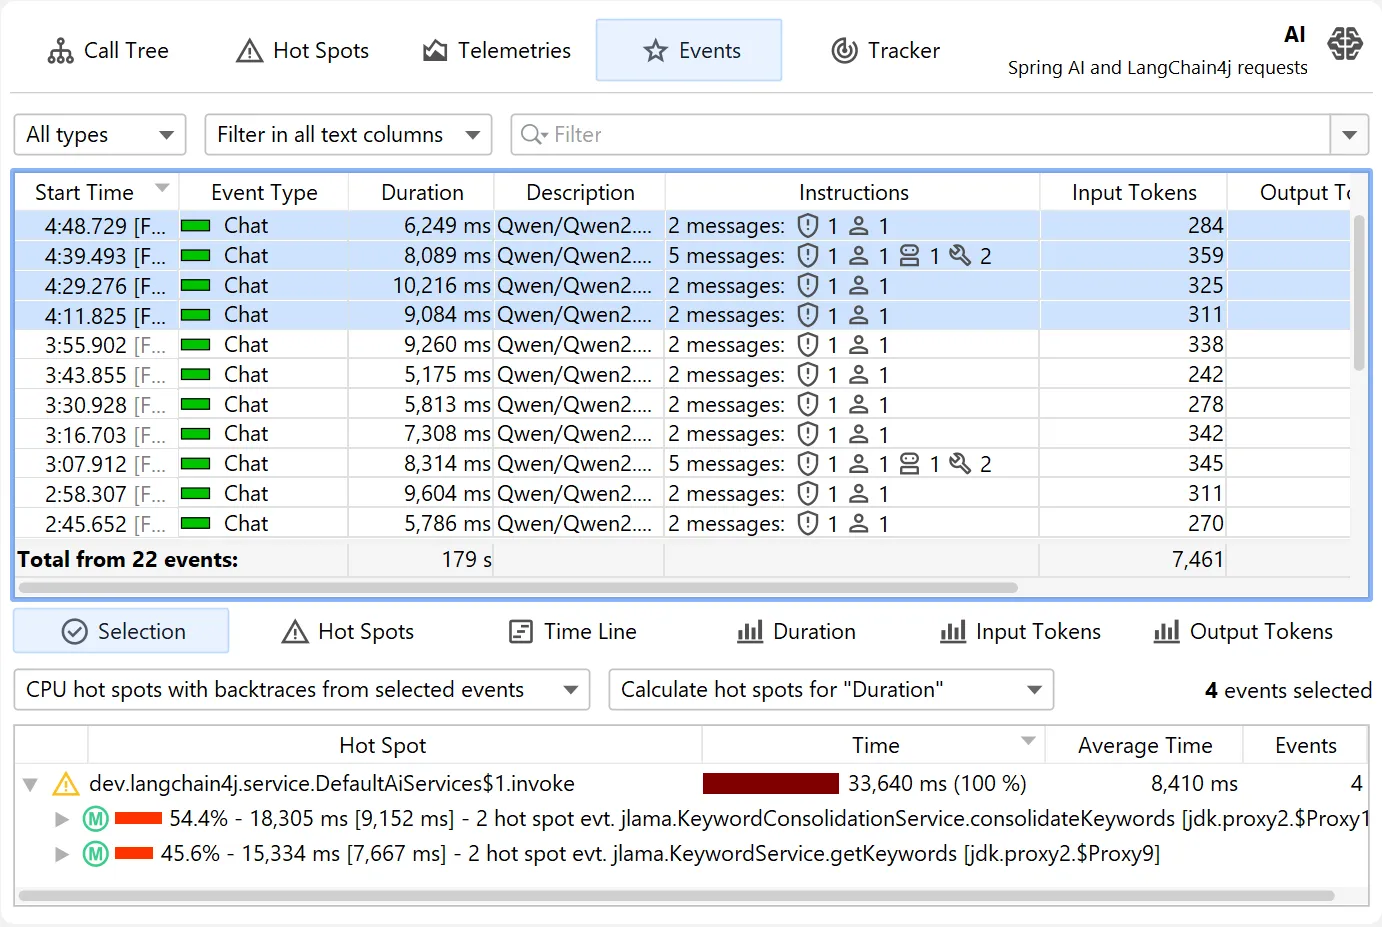
要进行更深入的分析,顶部的过滤器选择器和下方区域的各个选项卡可用于限制主表格及相关视图中显示的事件集合。
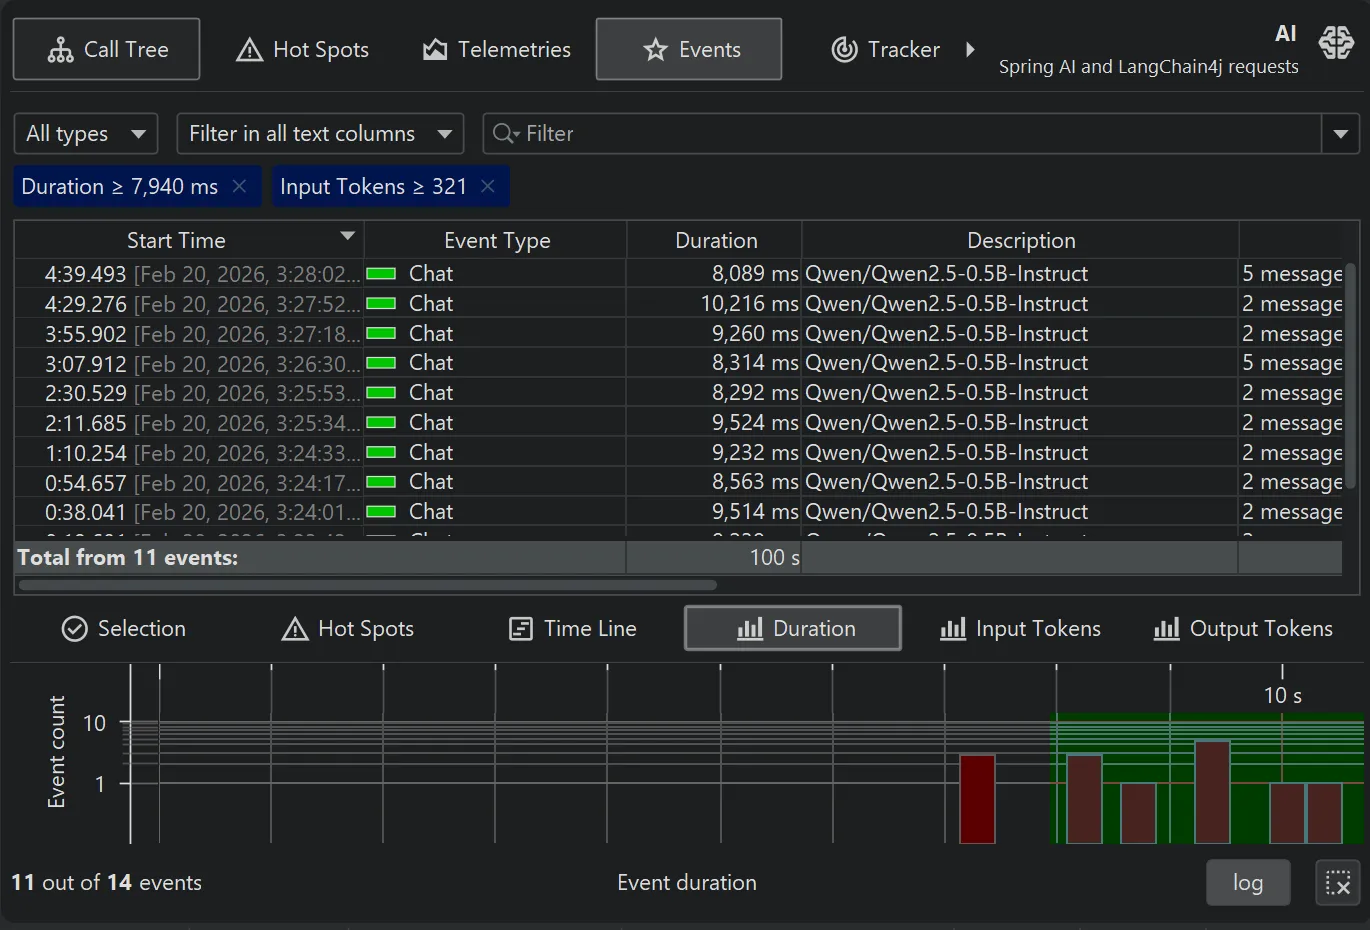
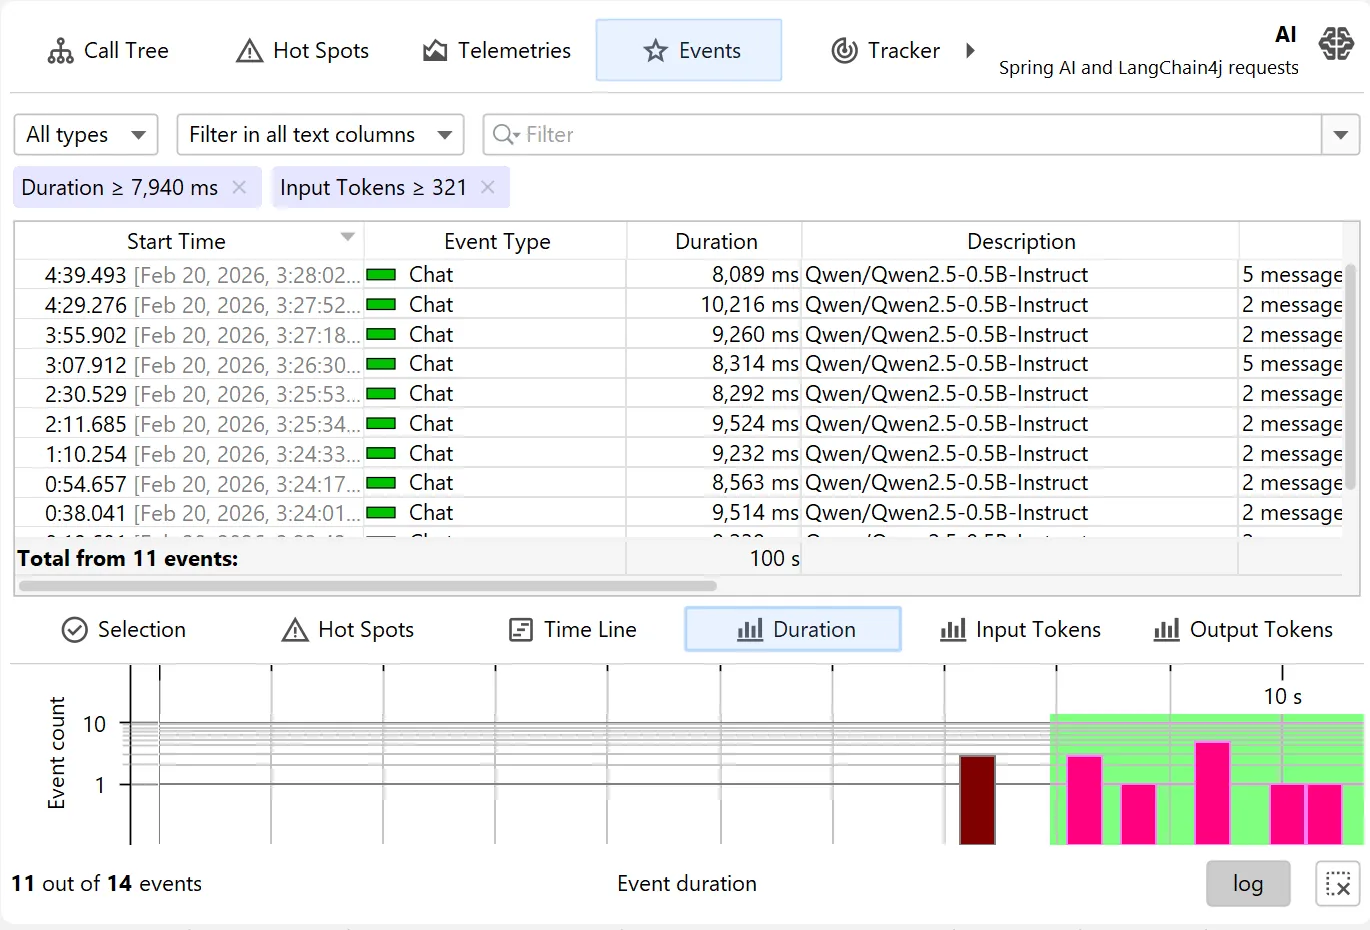
默认情况下,AI 探针会根据处理请求的具体模型名称来识别热点。这些数据不仅在事件视图中可用,在 AI 探针的热点视图中也可用,即使没有记录任何事件也是如此。
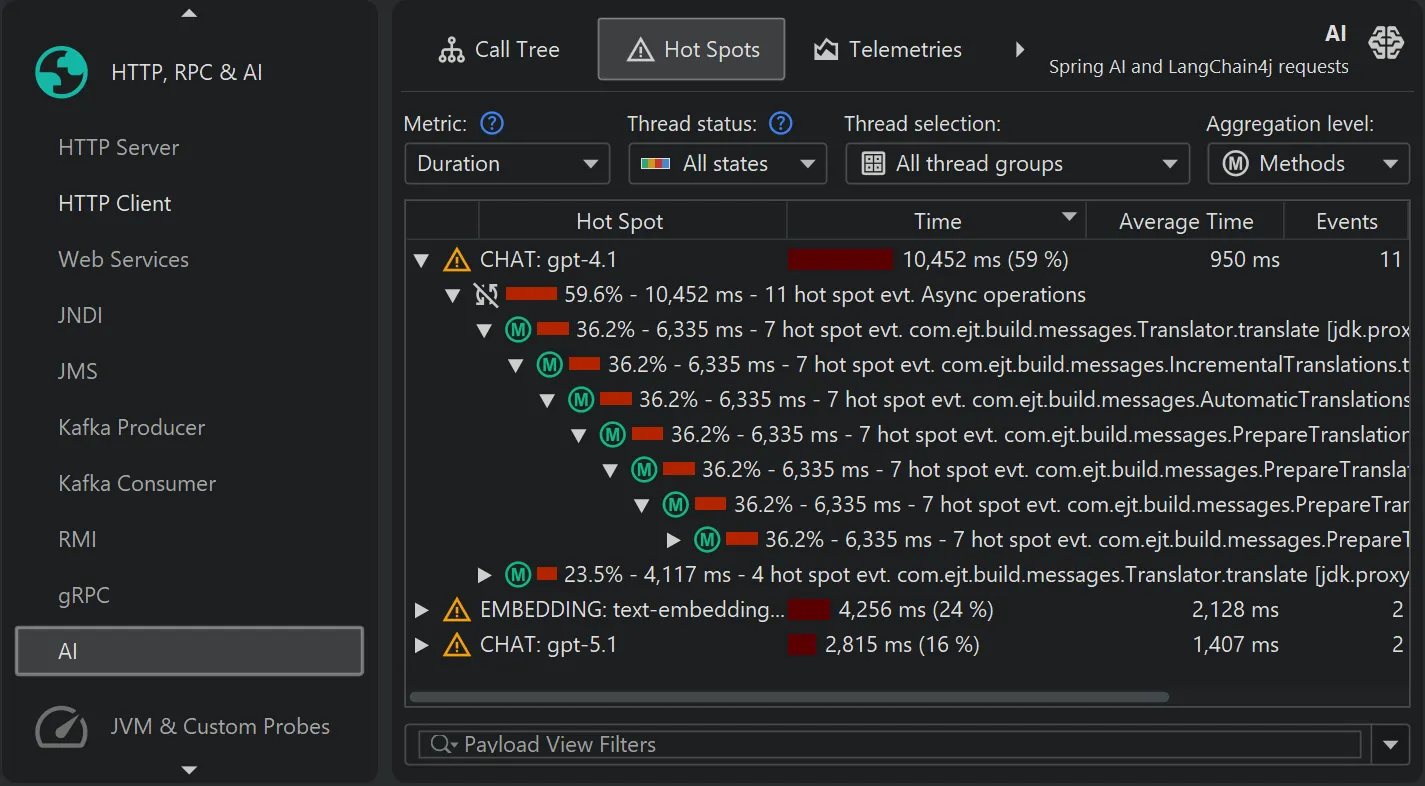
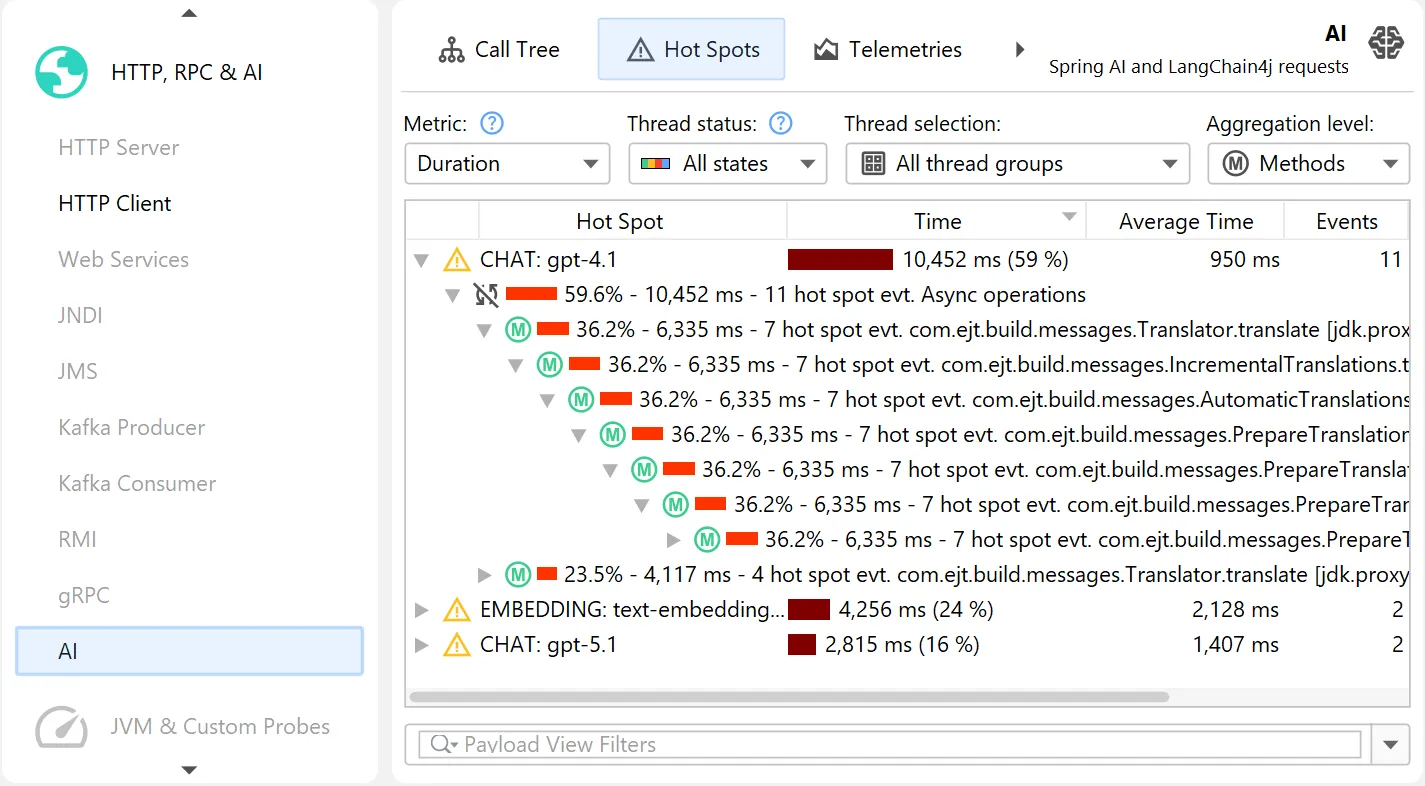
模型名称热点只是众多可能值得关注的热点类型之一。在探针设置中,您可以在 JProfiler 强大的脚本编辑器中输入一些 Java 代码,配置一个脚本来计算用户自定义的热点类型。
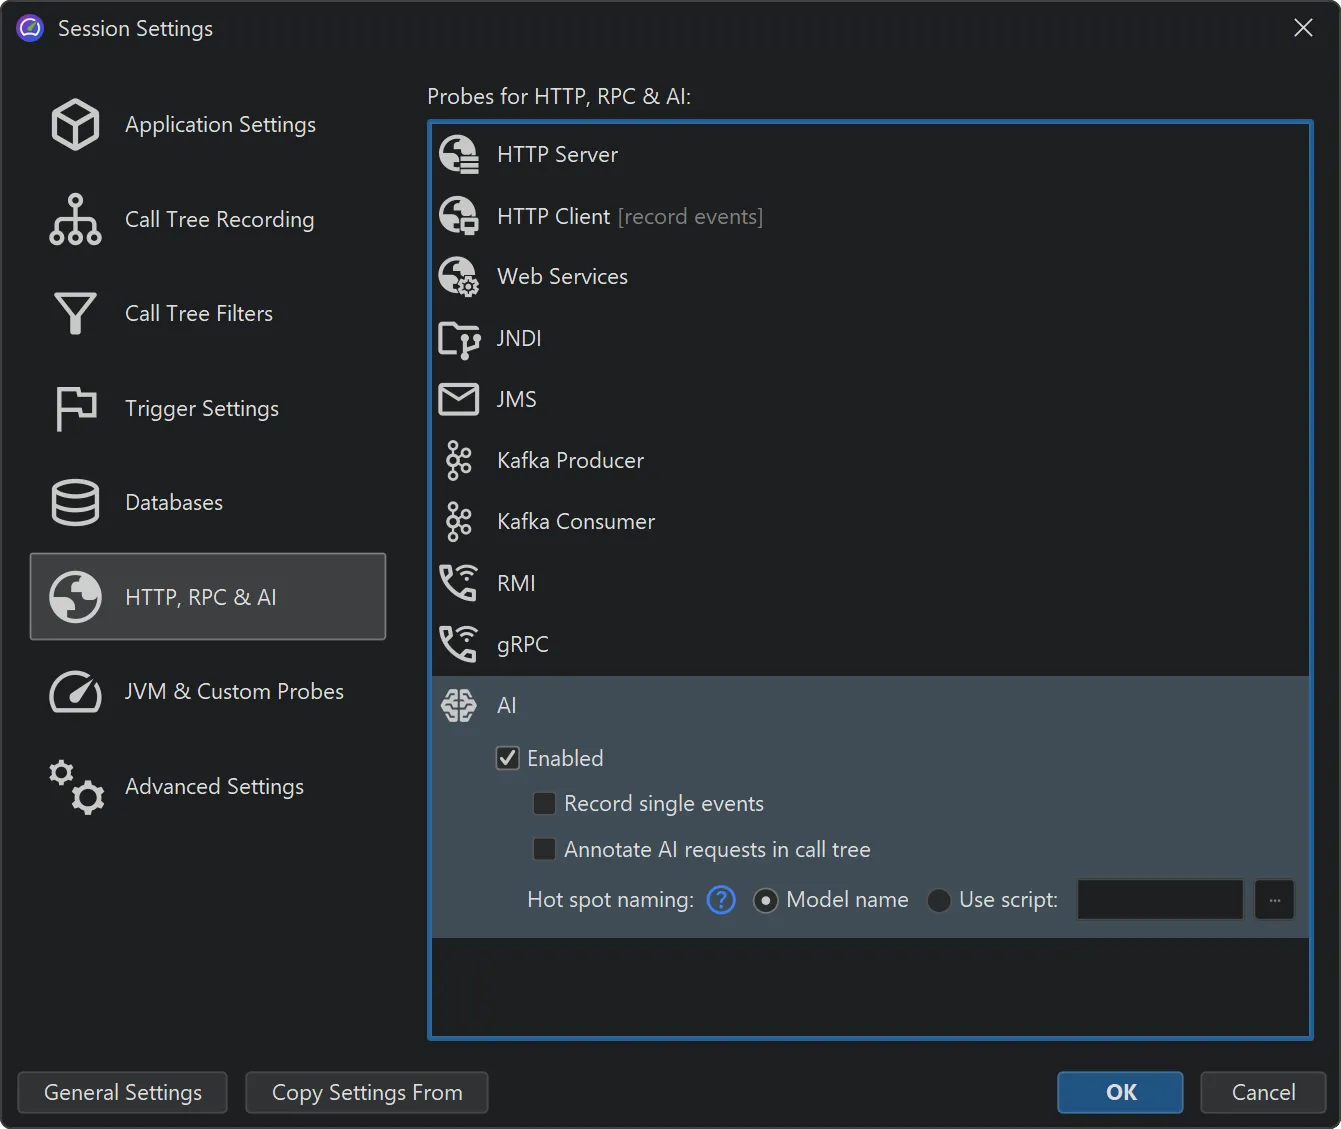
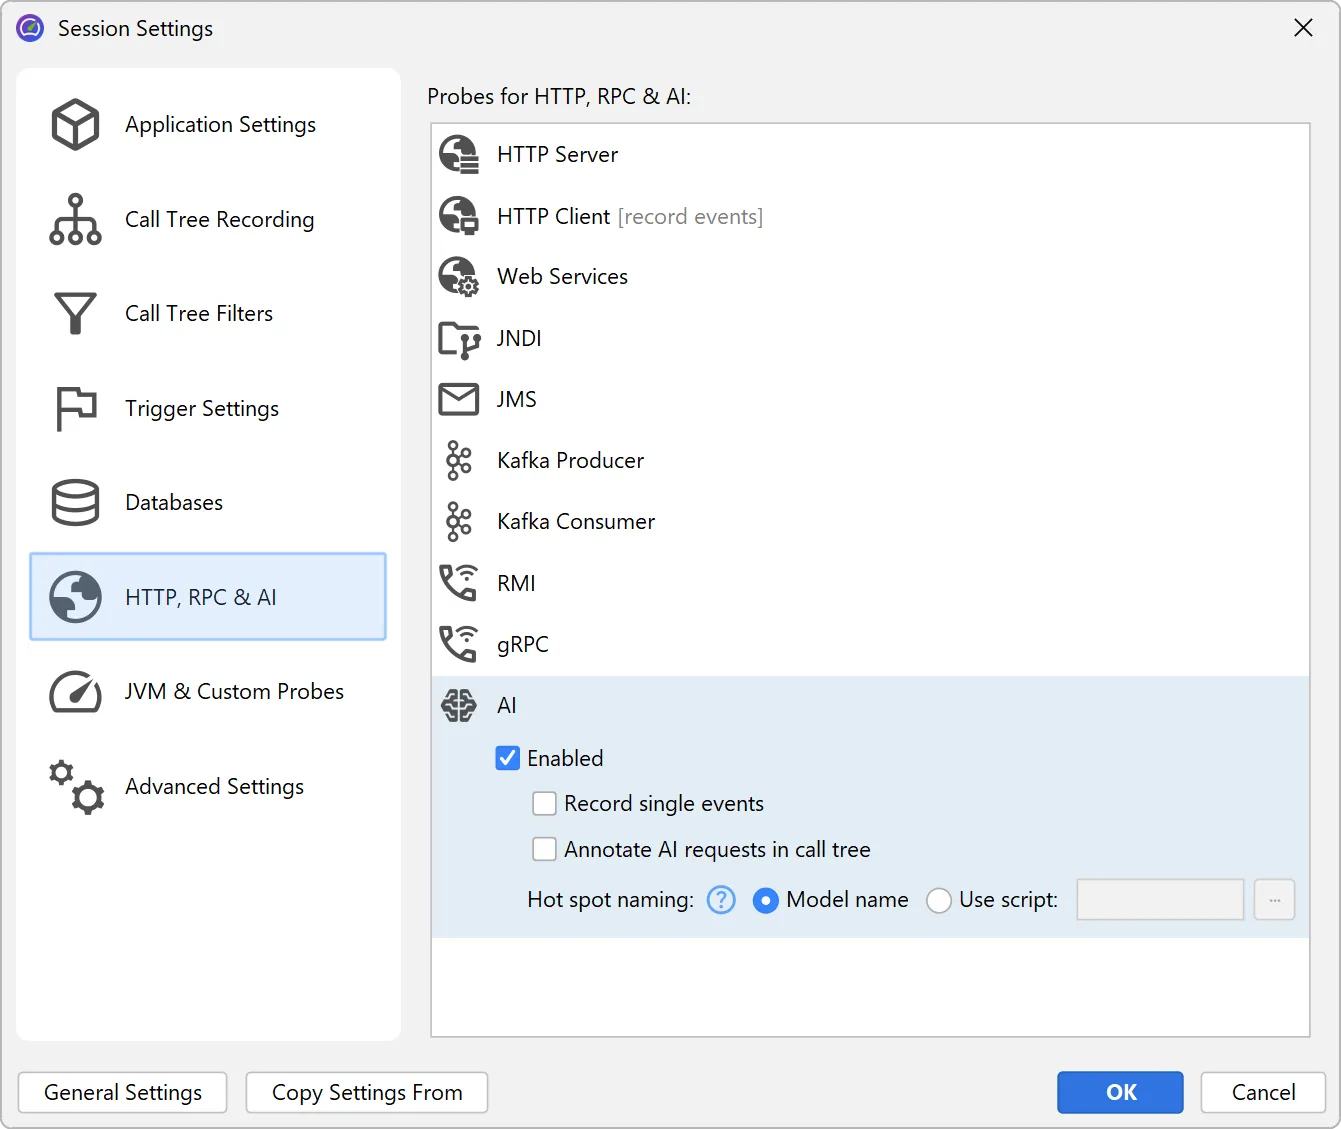
记录 AI 探针事件时,JProfiler 会以 ModelRequest 参数调用该脚本。该参数可用于访问请求类型、模型名称以及所有指令及其指令类型。
例如,您可以将提示长度按 50 个字符一组分桶,以此定义热点。下面的示例演示了具体做法。
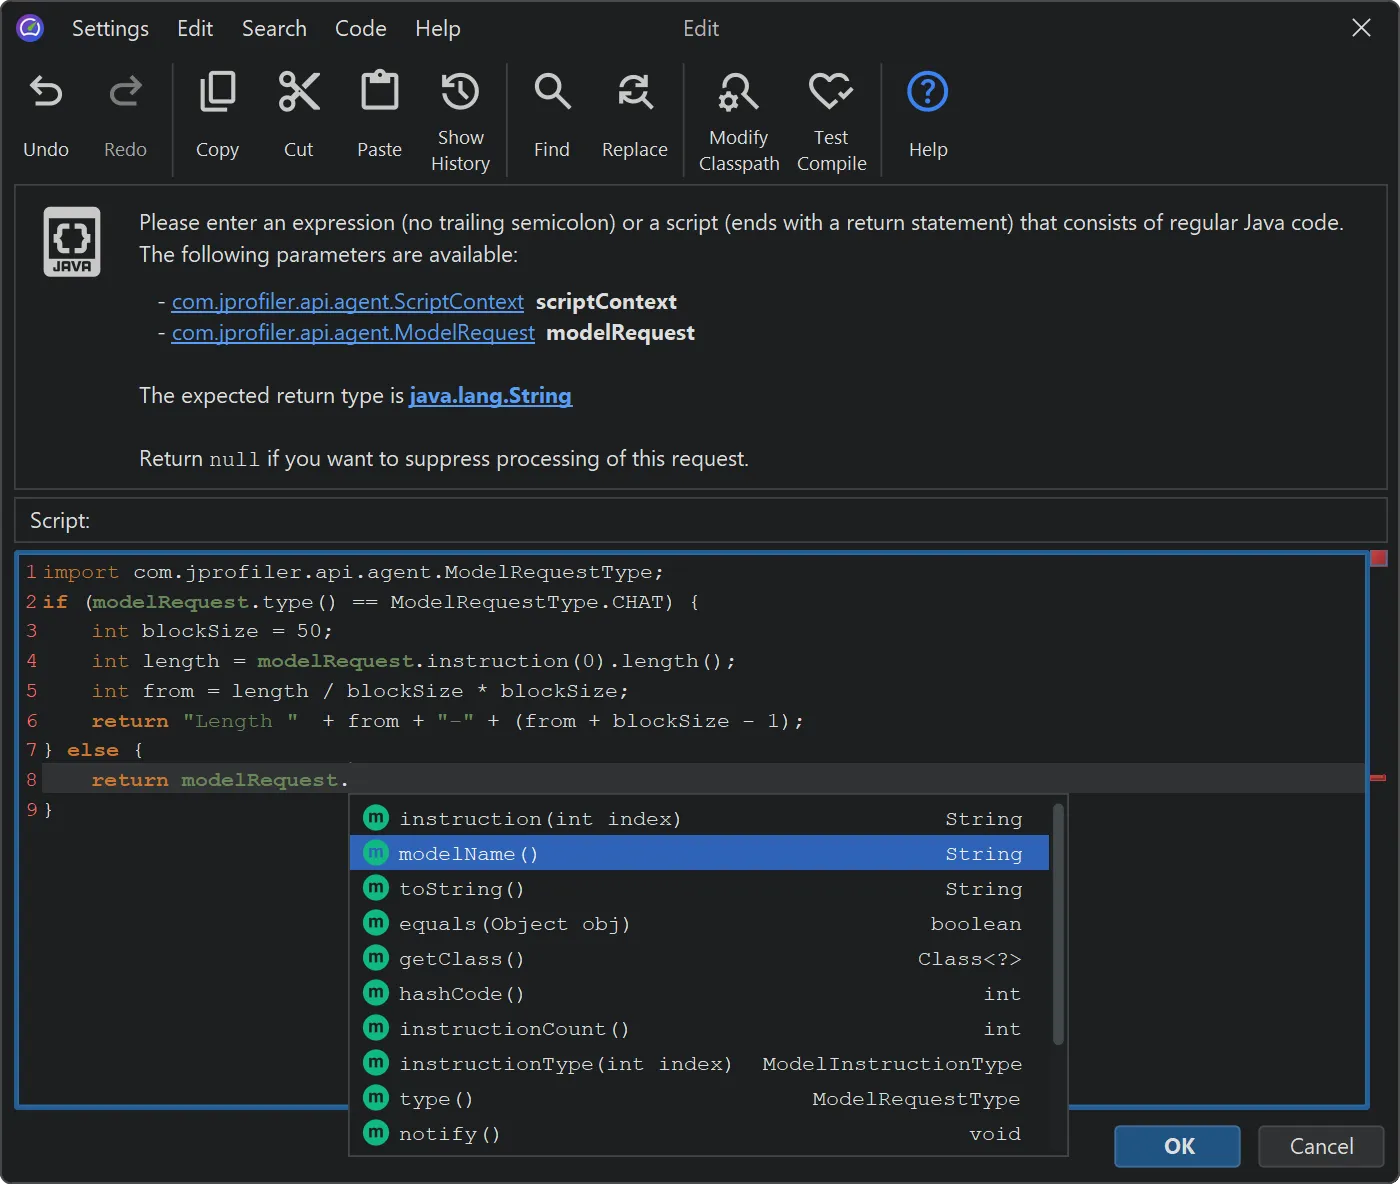
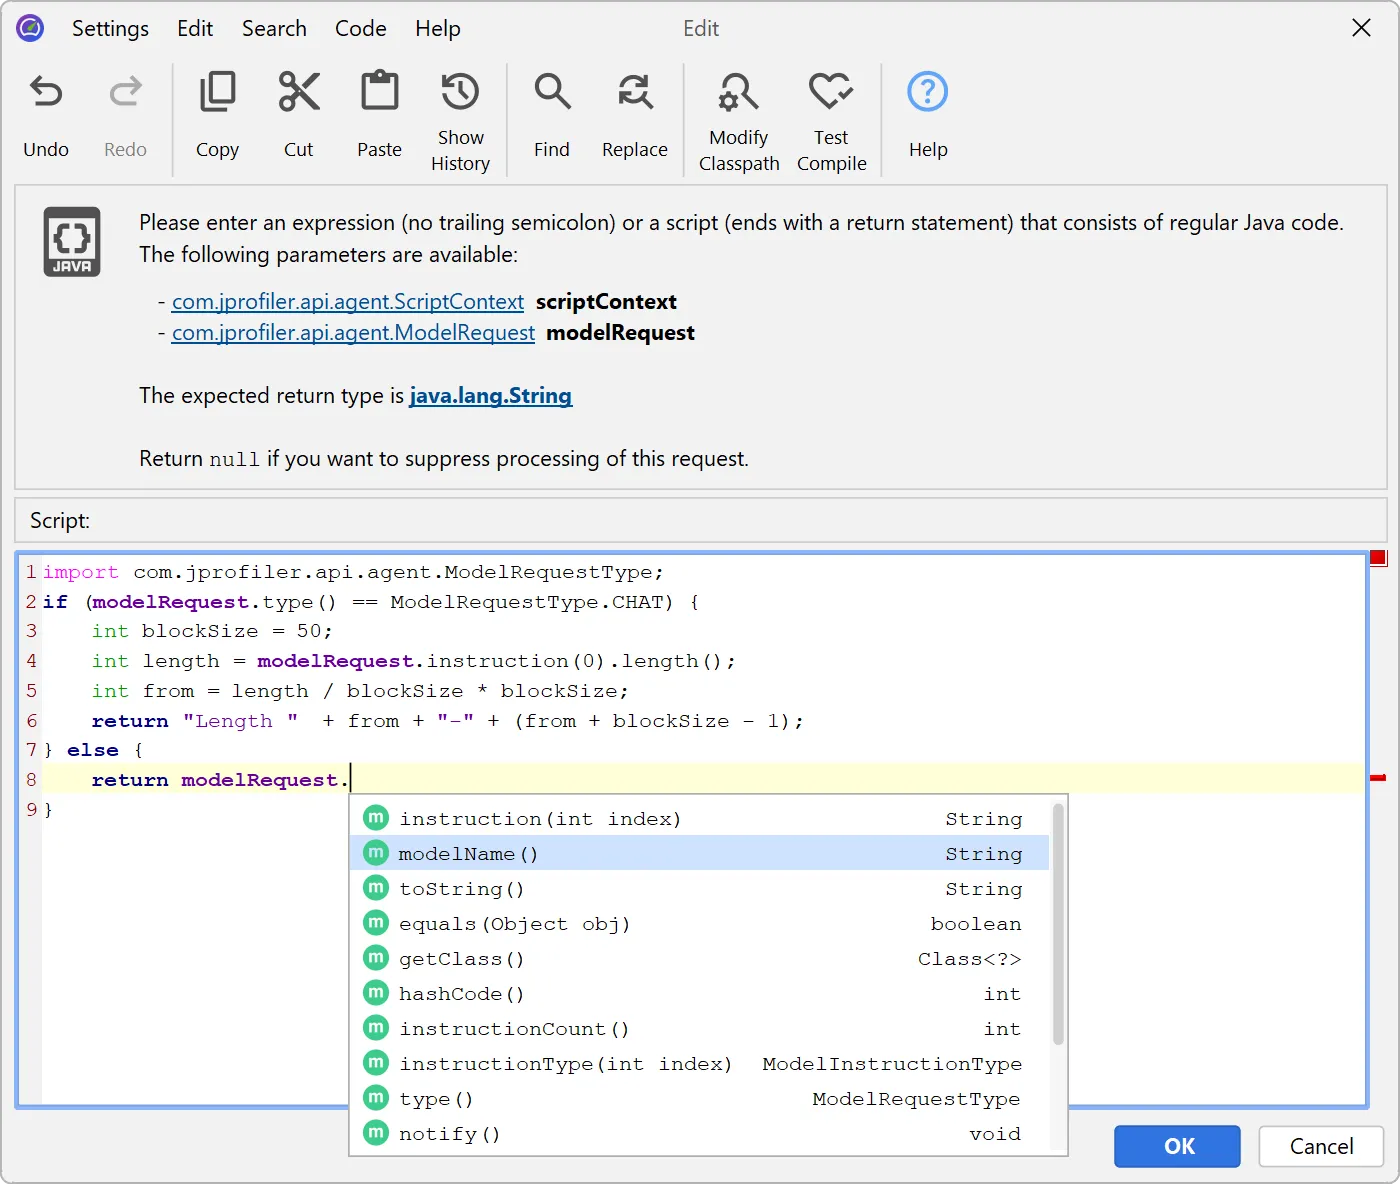
由于 JProfiler 在记录过程中实时显示数据,您可以在分析过程中更改这些设置并立即观察到效果。
使用上述脚本后,新的热点如下所示:
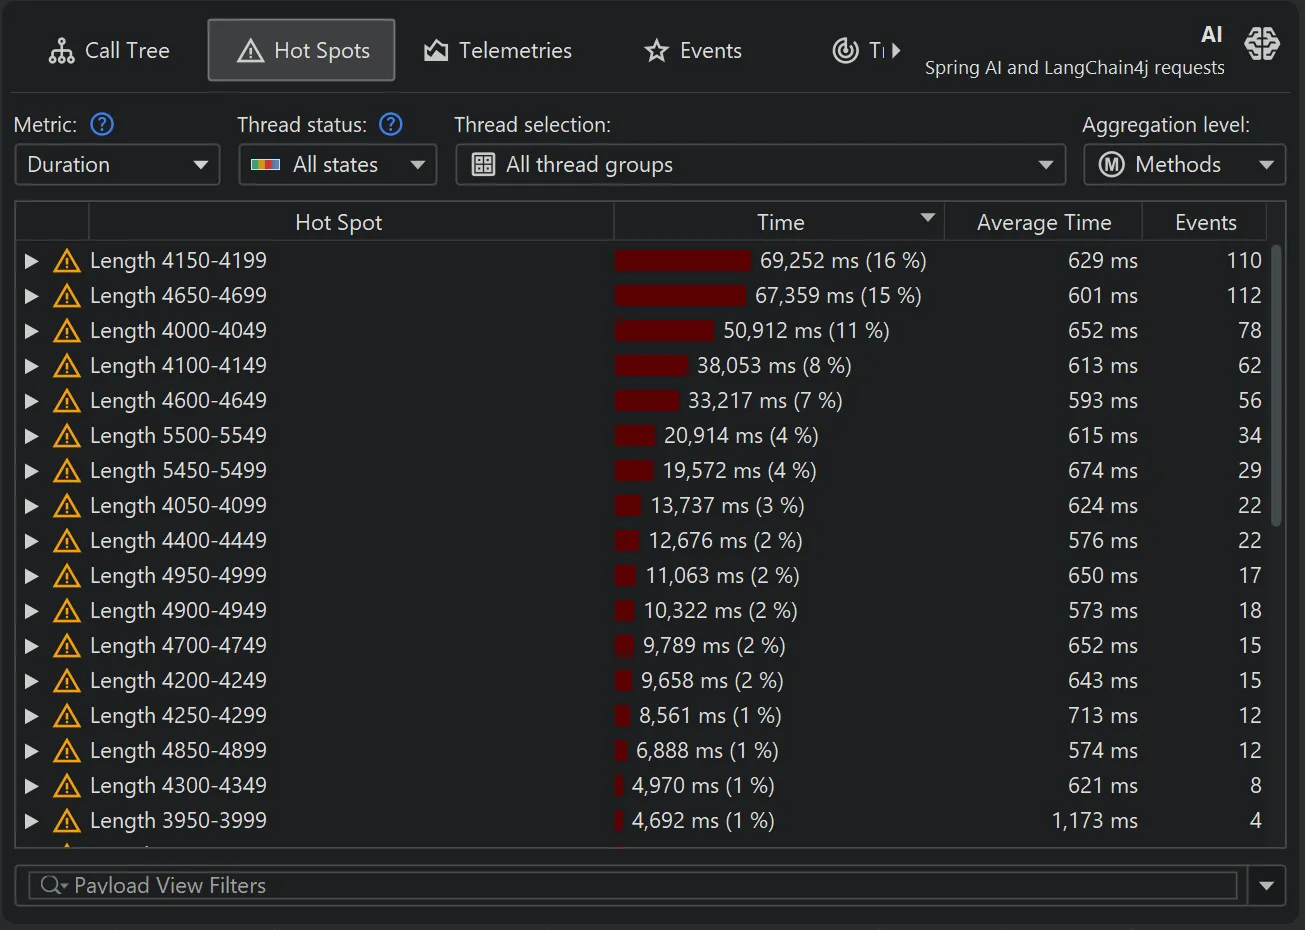
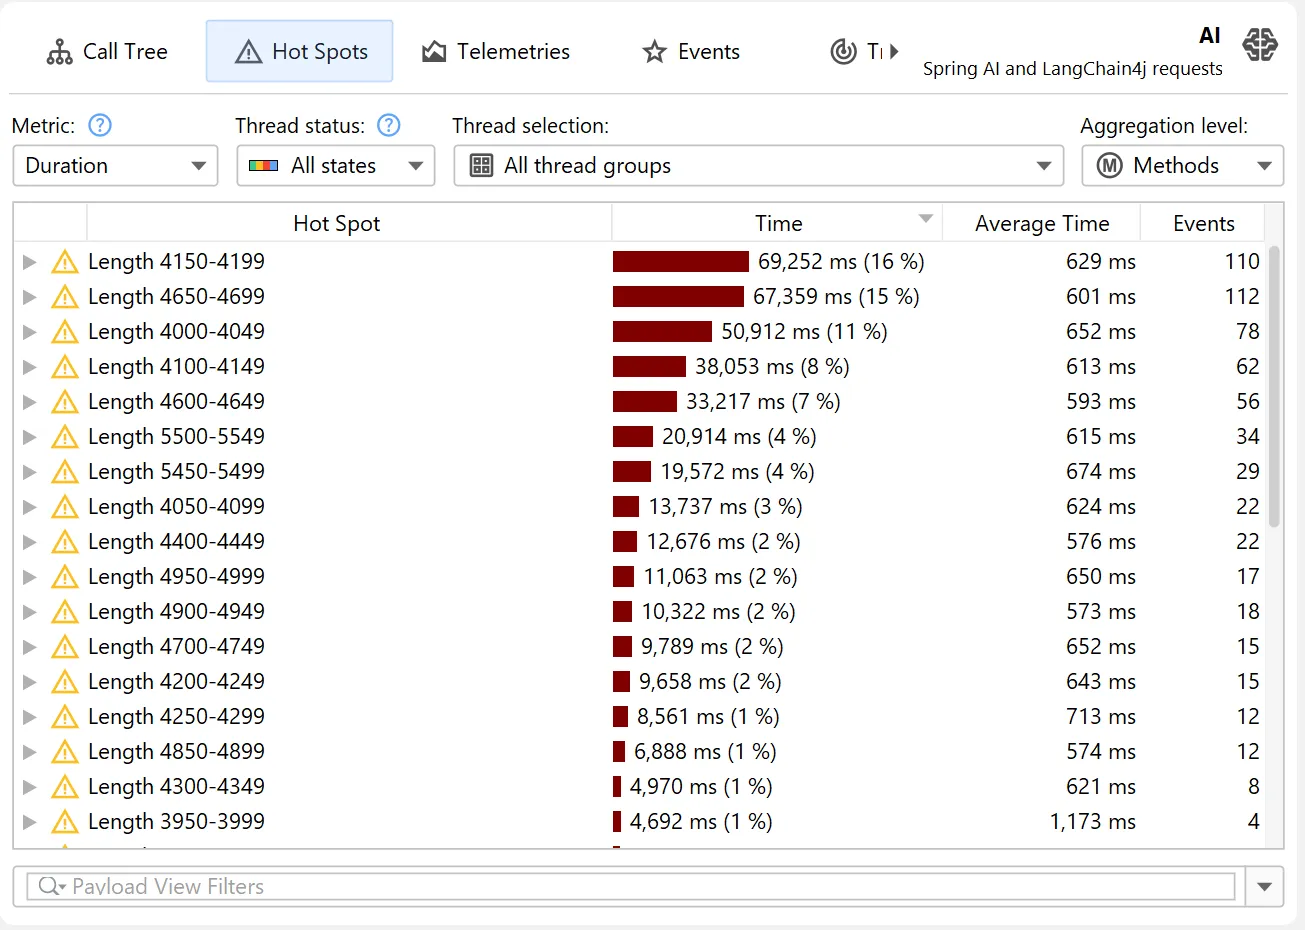
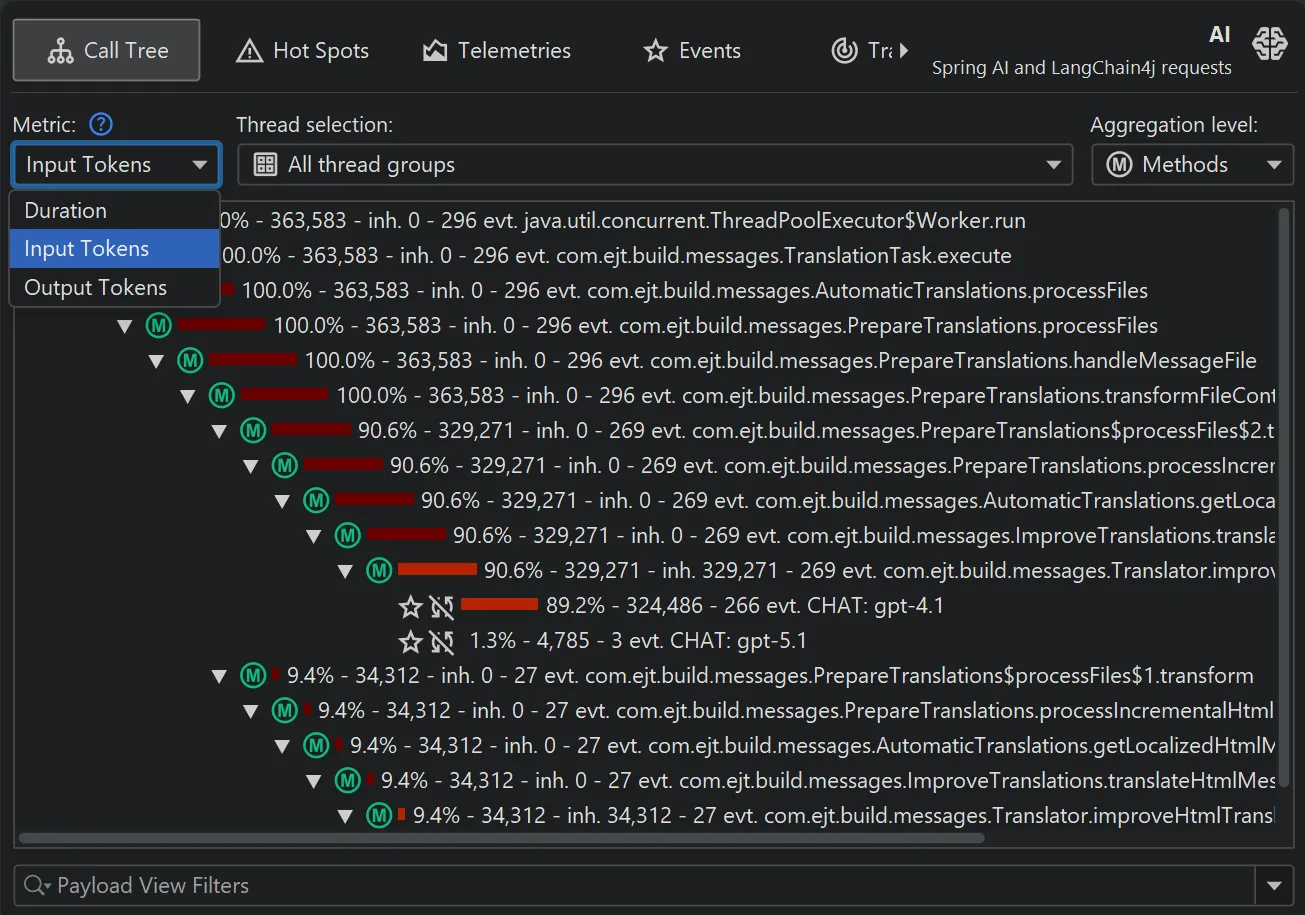
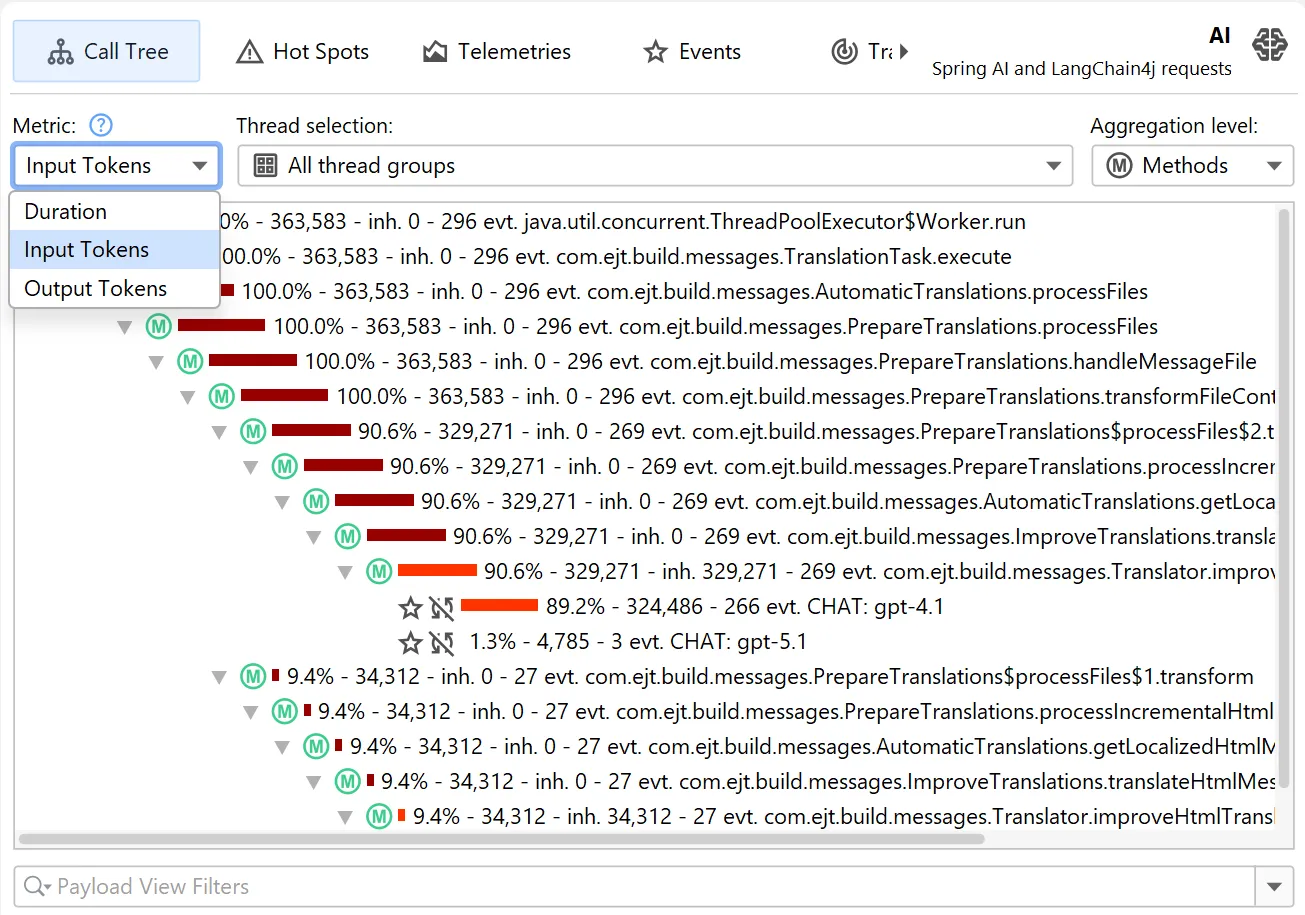
默认情况下,热点关注请求的持续时间,但您也可以将主度量切换为输入 token 数和输出 token 数。
这一操作在探针热点视图和探针调用树视图中均可进行。探针调用树视图提供自上而下的视图,将方法调用与探针负载关联起来。
AI 探针的探针遥测分别为聊天请求和嵌入请求显示请求计数、平均请求持续时间以及合并的输入/输出 token 图表。
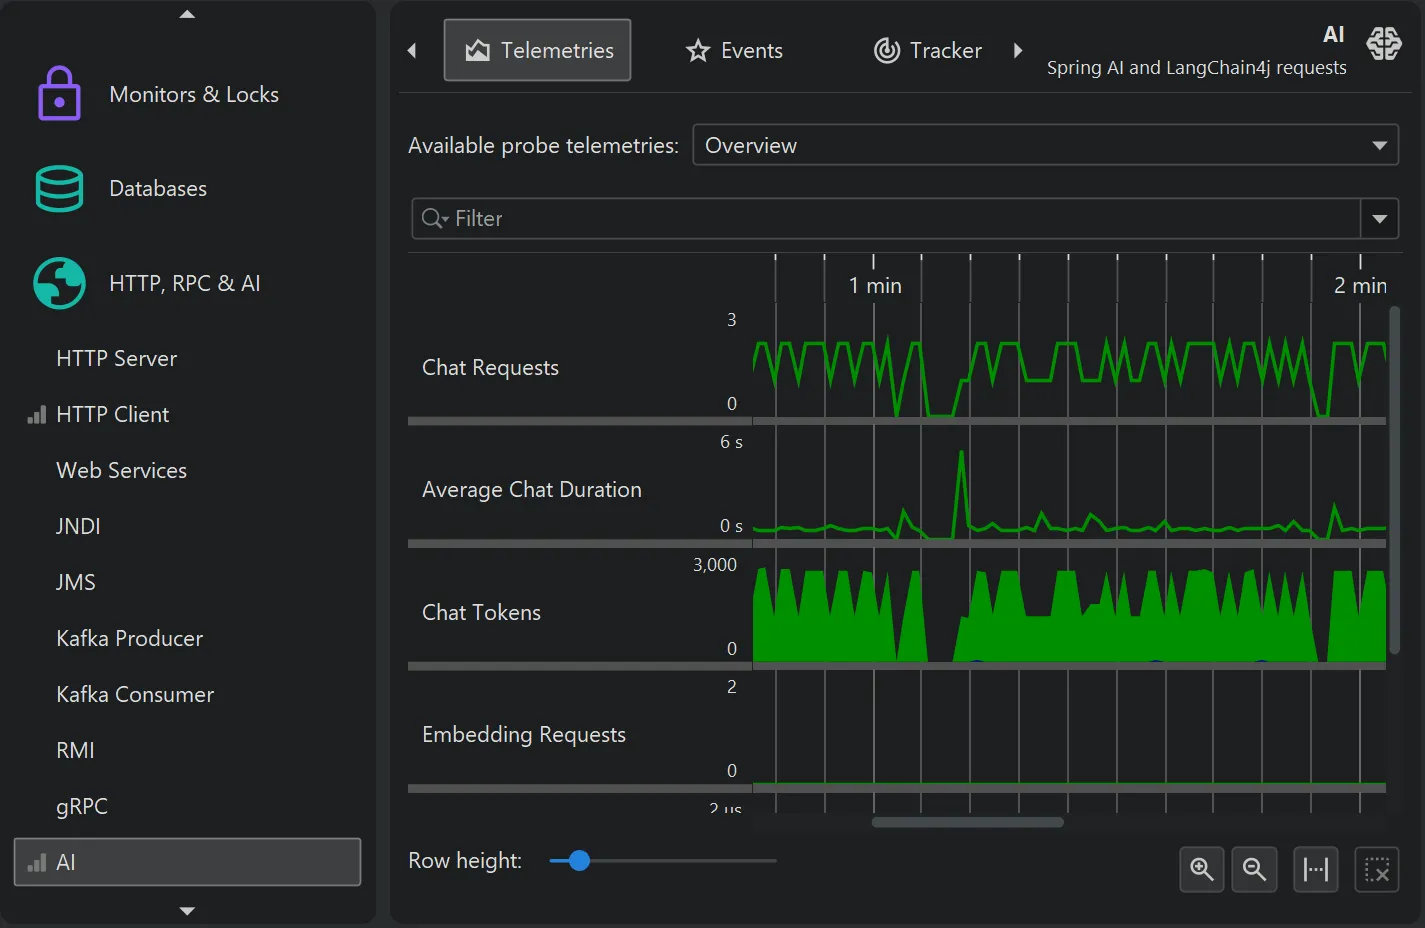
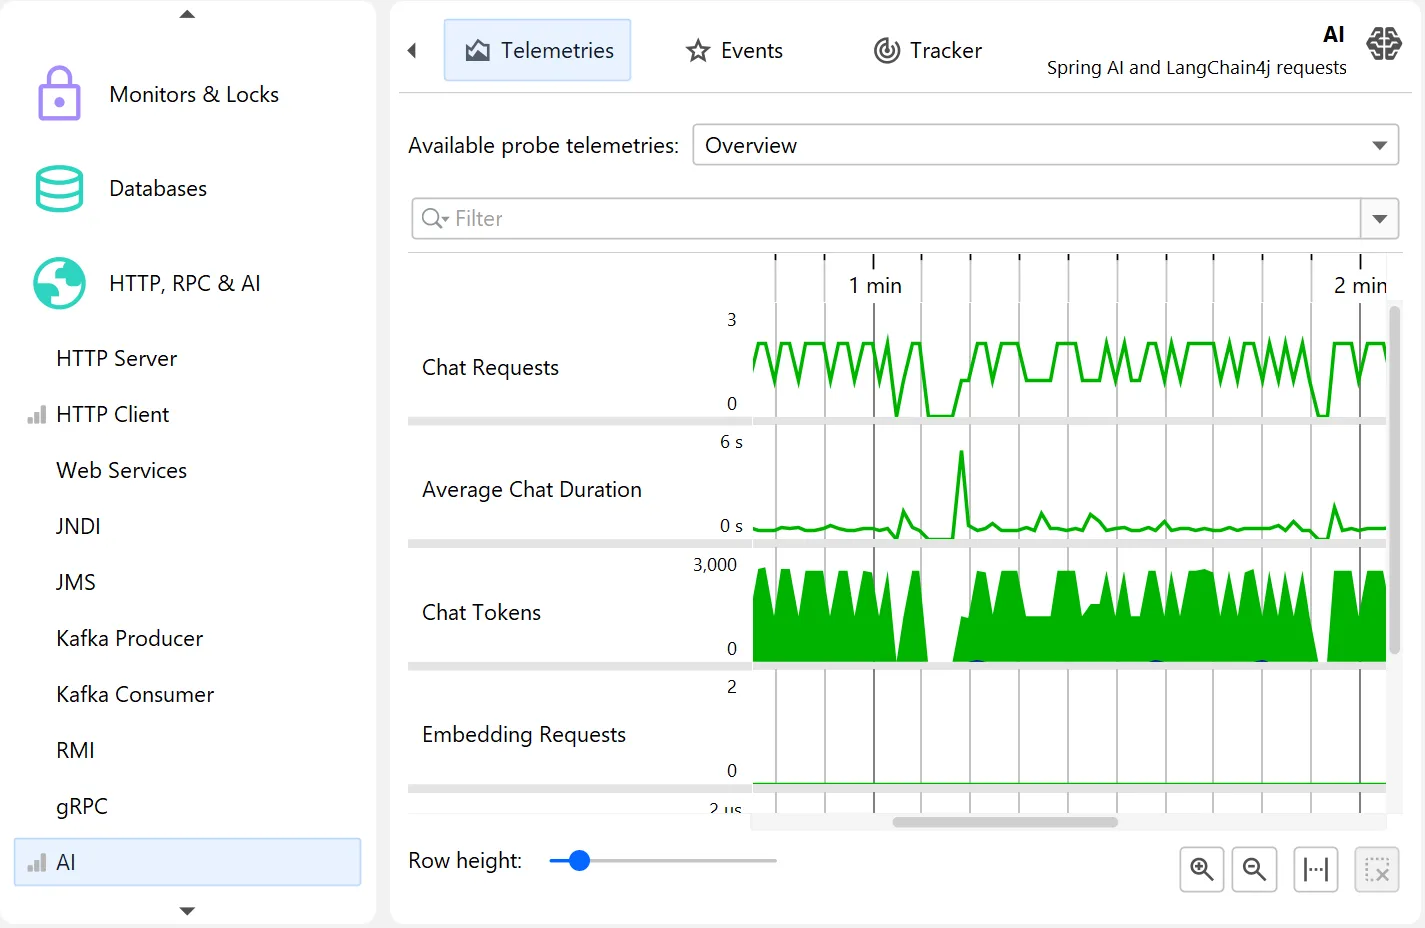
每个遥测图都可以单独显示,并可用于选择特定关注区域的事件。
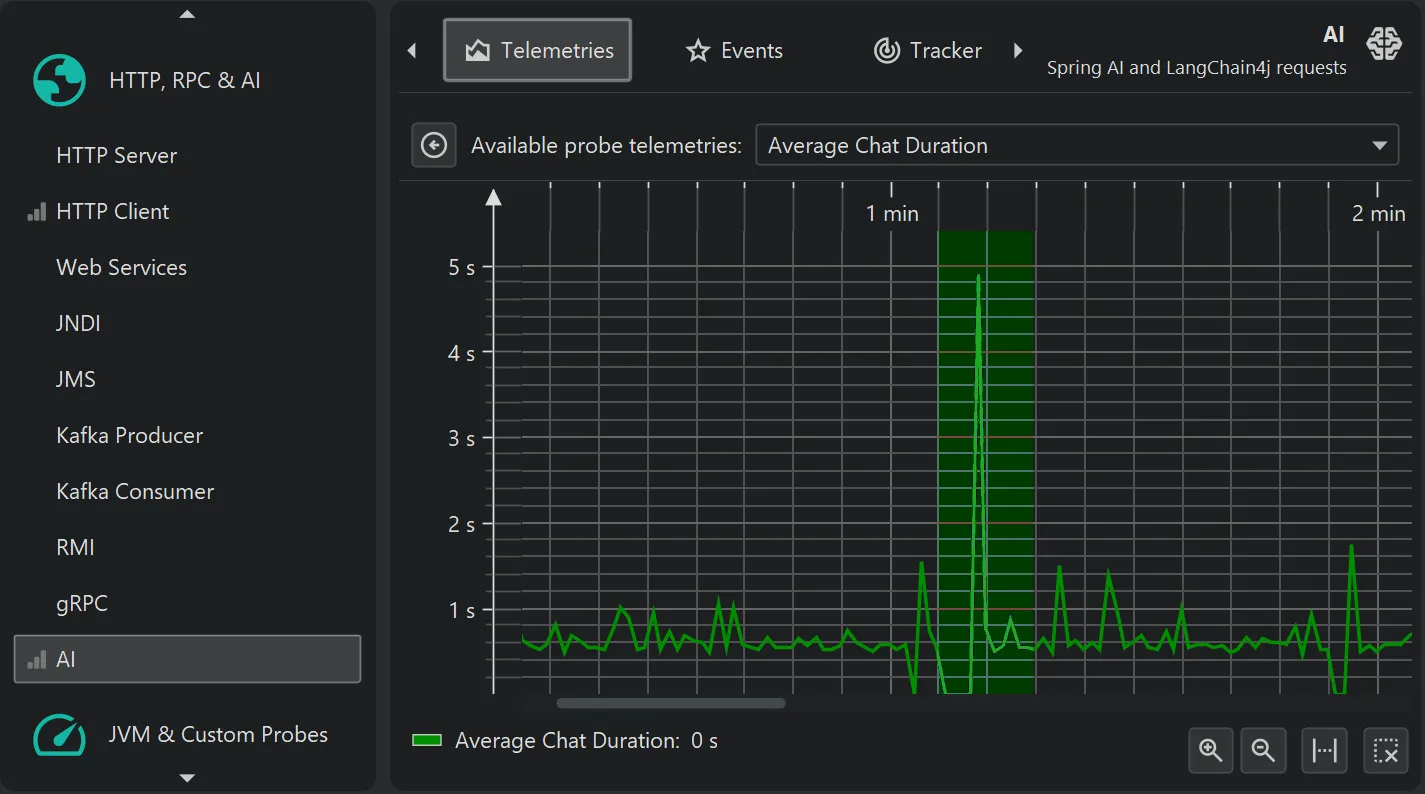
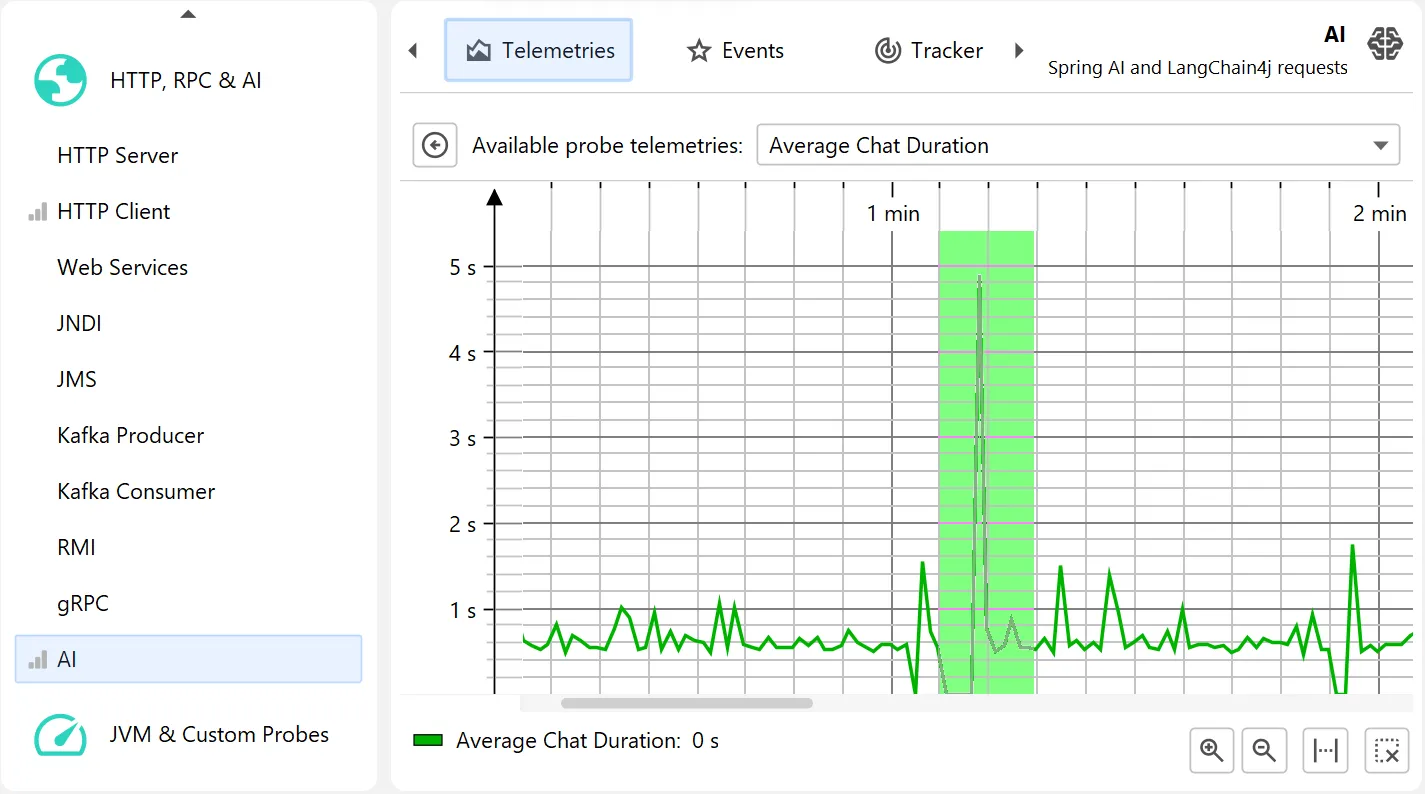
为帮助您了解 AI 探针,JProfiler 现在附带一个“LLM 演示”会话。
该演示使用 Jlama(一个面向 Java 21 及以上版本的跨平台推理引擎),并从 Hugging Face 下载一个 5 亿参数的模型,对来自 arXiv 的 LLM 相关预印本进行分类。
演示界面上会持续插入 LLM 生成的关键词,您可以在右侧浏览相关研究论文。
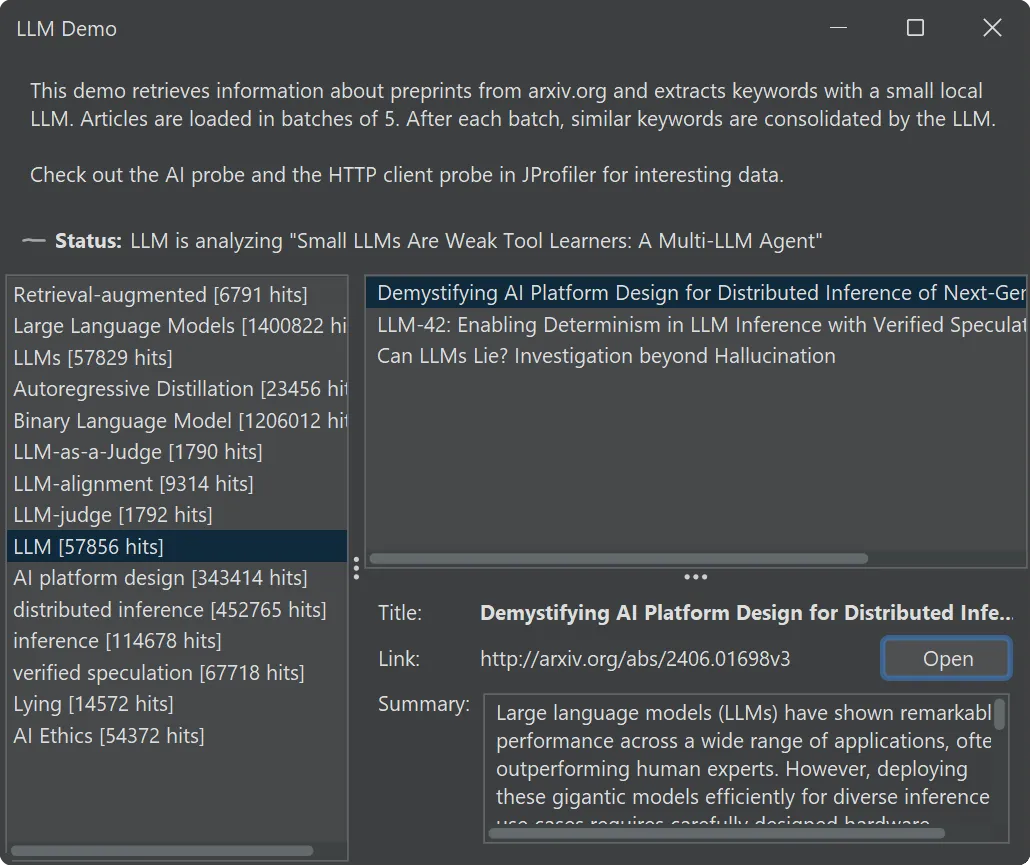
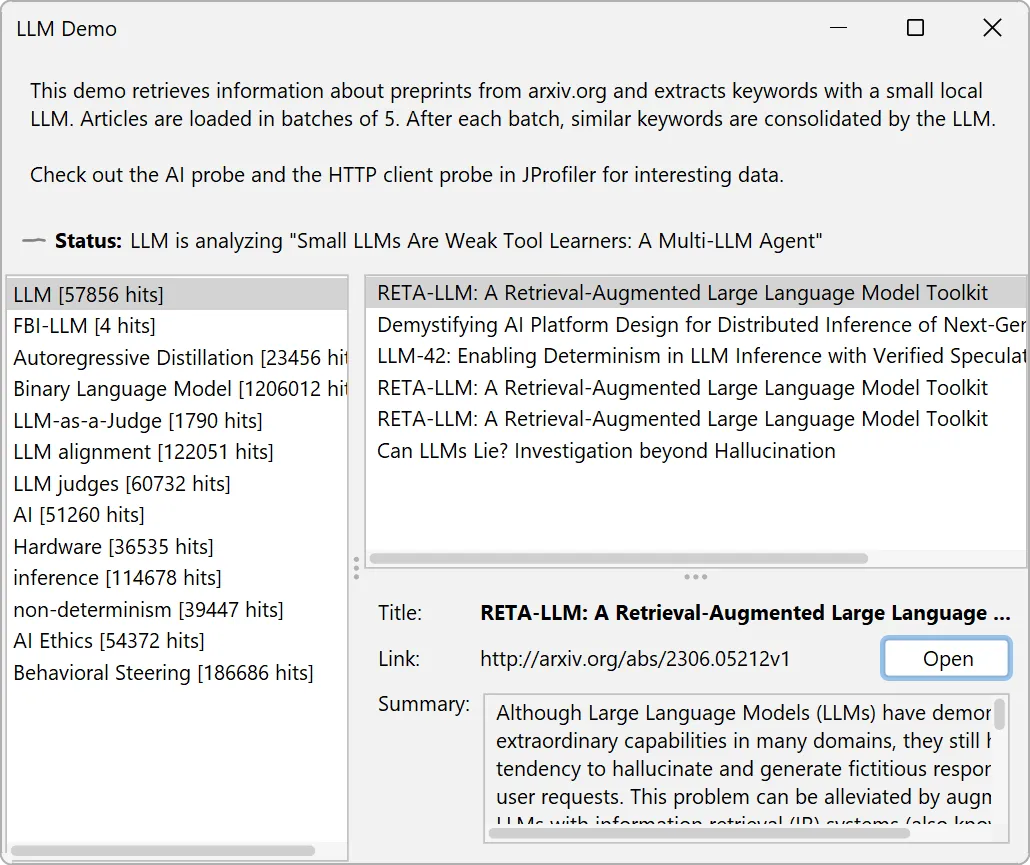
JProfiler 拥有全新的 UI,外观更加现代,图标也焕然一新。希望您会喜欢!我们提供浅色和深色主题。切换本页顶部的深色模式开关即可查看两者的屏幕截图。
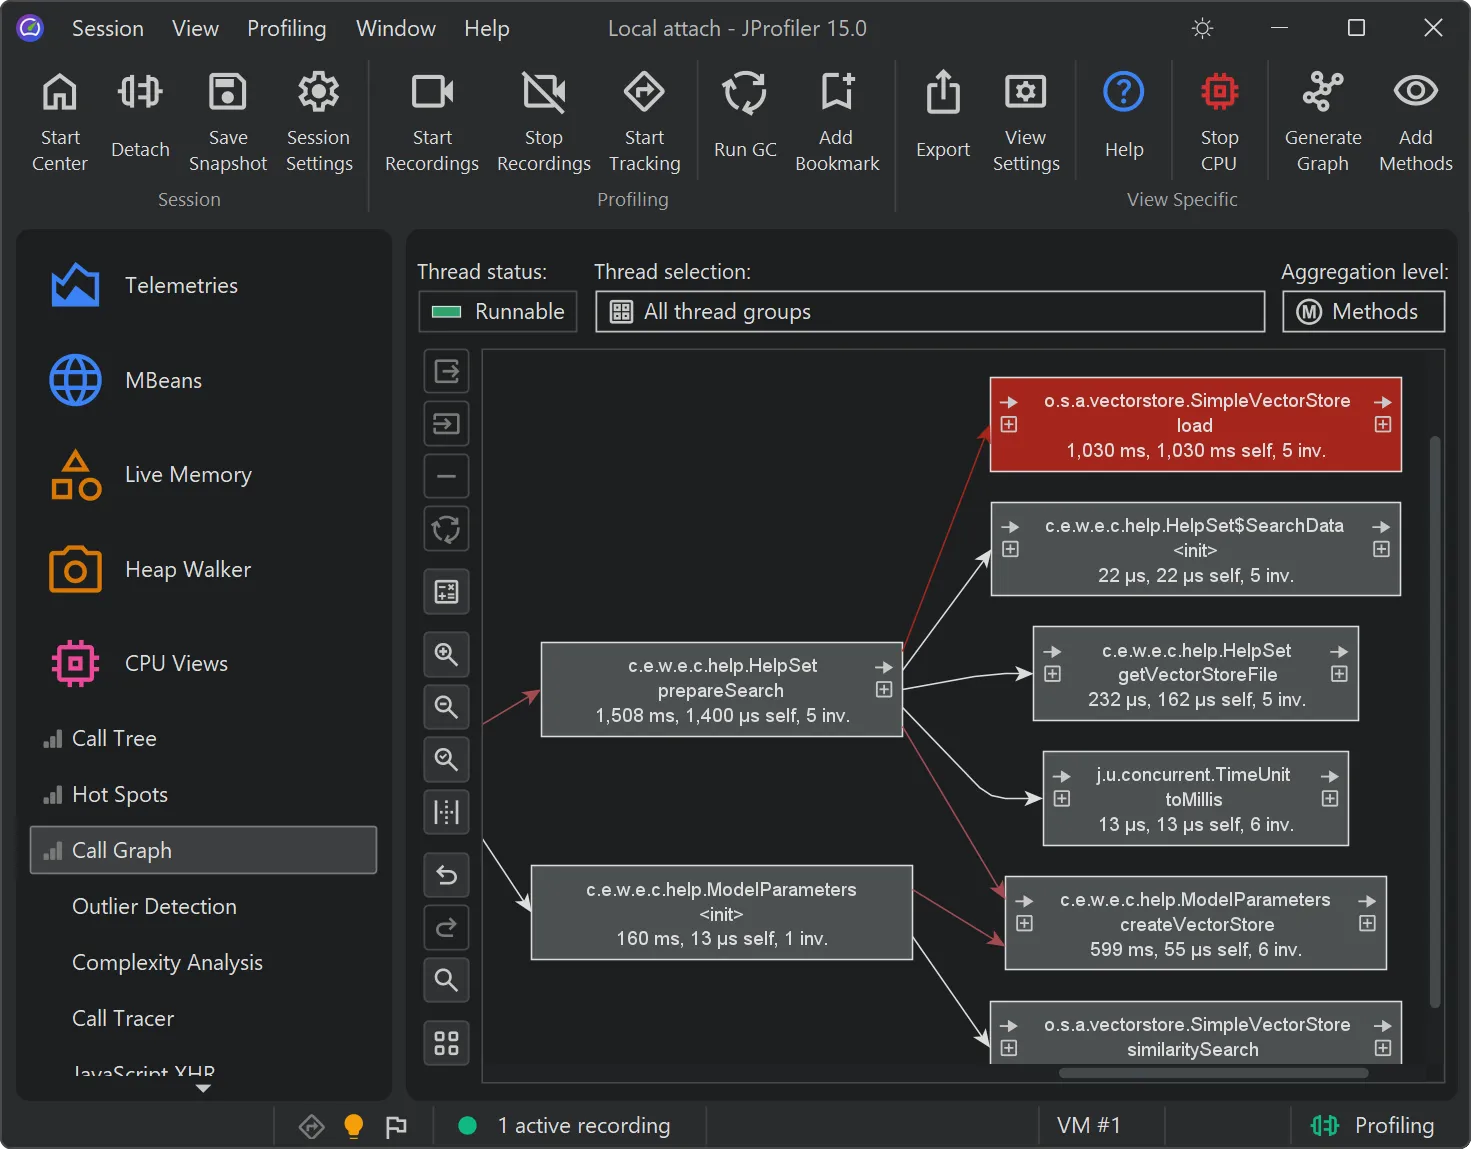
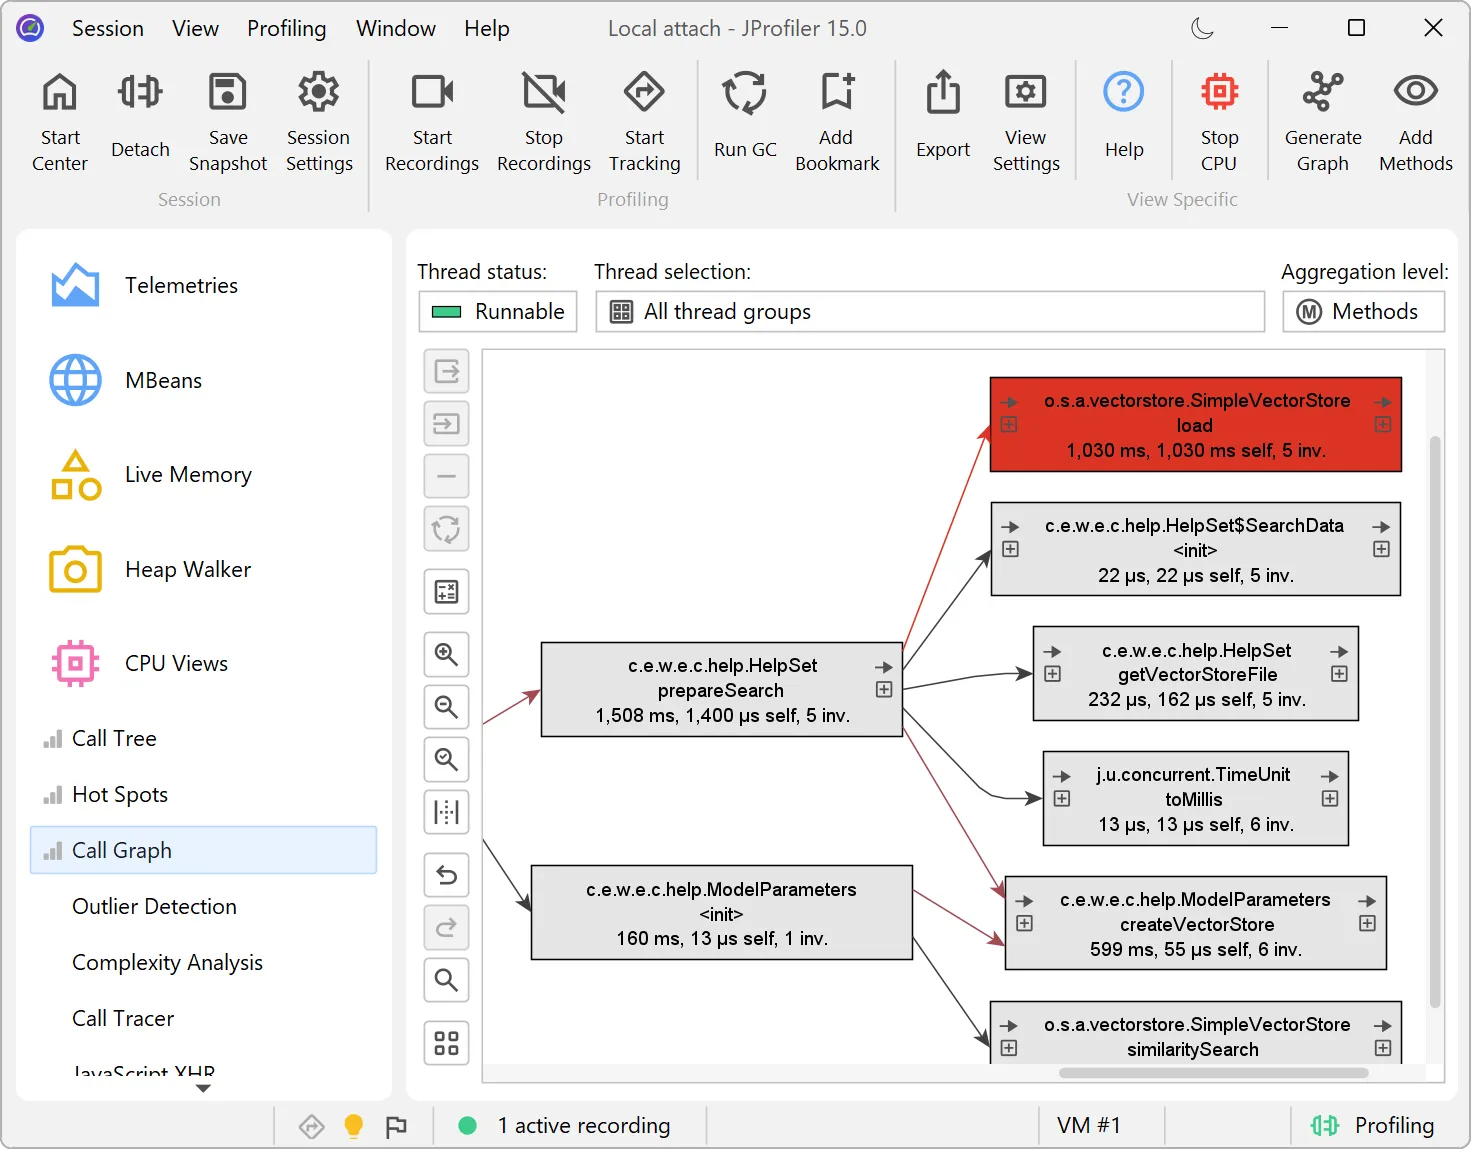
此外,UI 现在支持完全缩放。在常规设置中,您可以以百分比形式设置缩放因子,或者设置任意大小的自定义 UI 字体,UI 将相应地进行缩放。
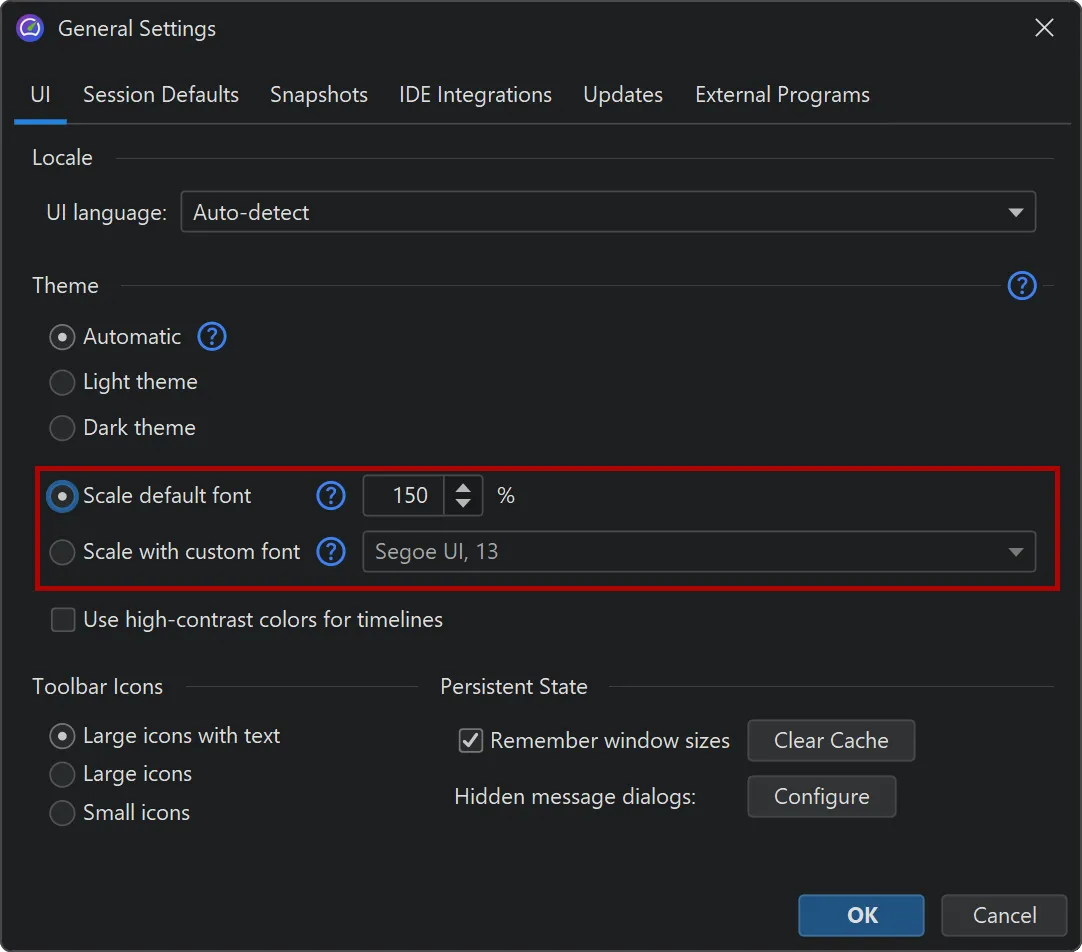
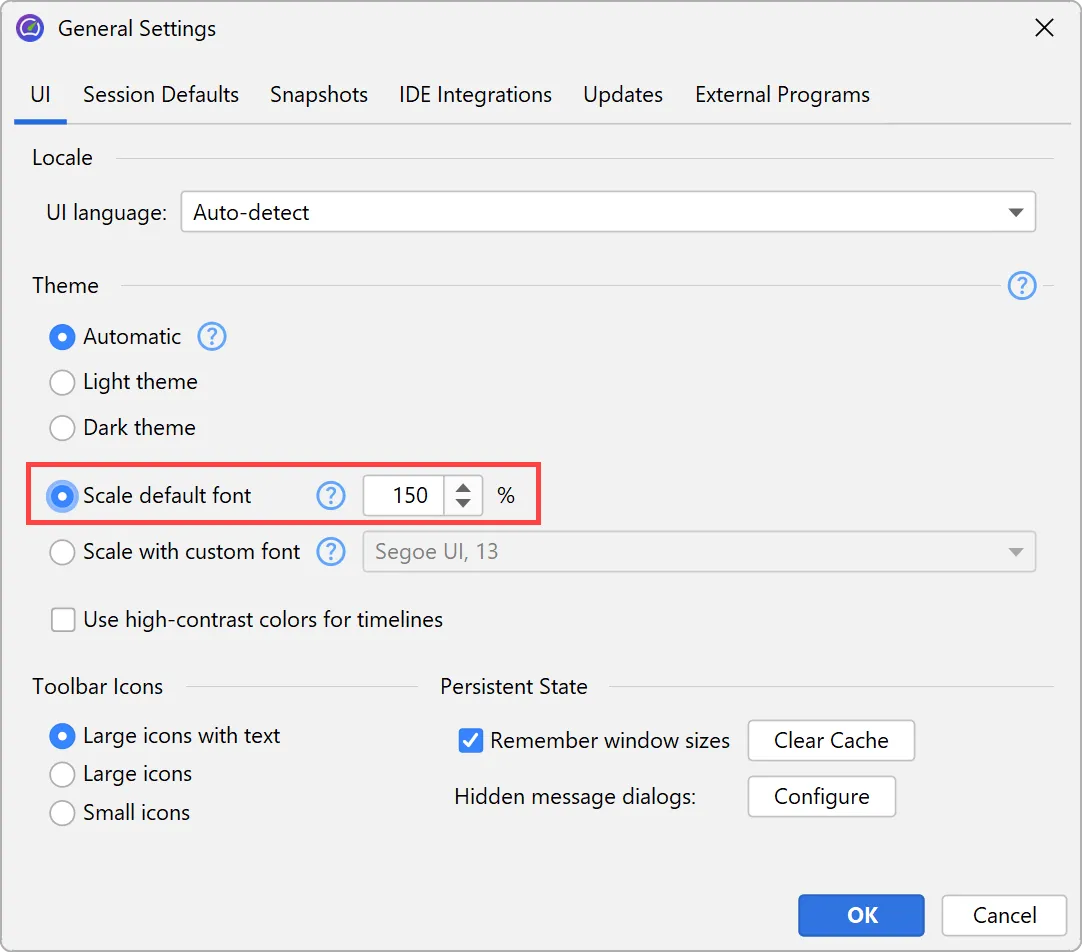
凭借这一能力,JProfiler UI 现在可以在 Linux 上搭配所有 OpenJDK 变体并以所有 HiDPI 分辨率运行。此前在 Linux 上支持 HiDPI 分辨率的只有 JetBrains 运行时。
JProfiler 安装程序已完成现代化改造,其默认执行模式也得到精简。默认情况下不会请求管理员权限,除非您在其自定义执行模式中选择为所有用户安装。
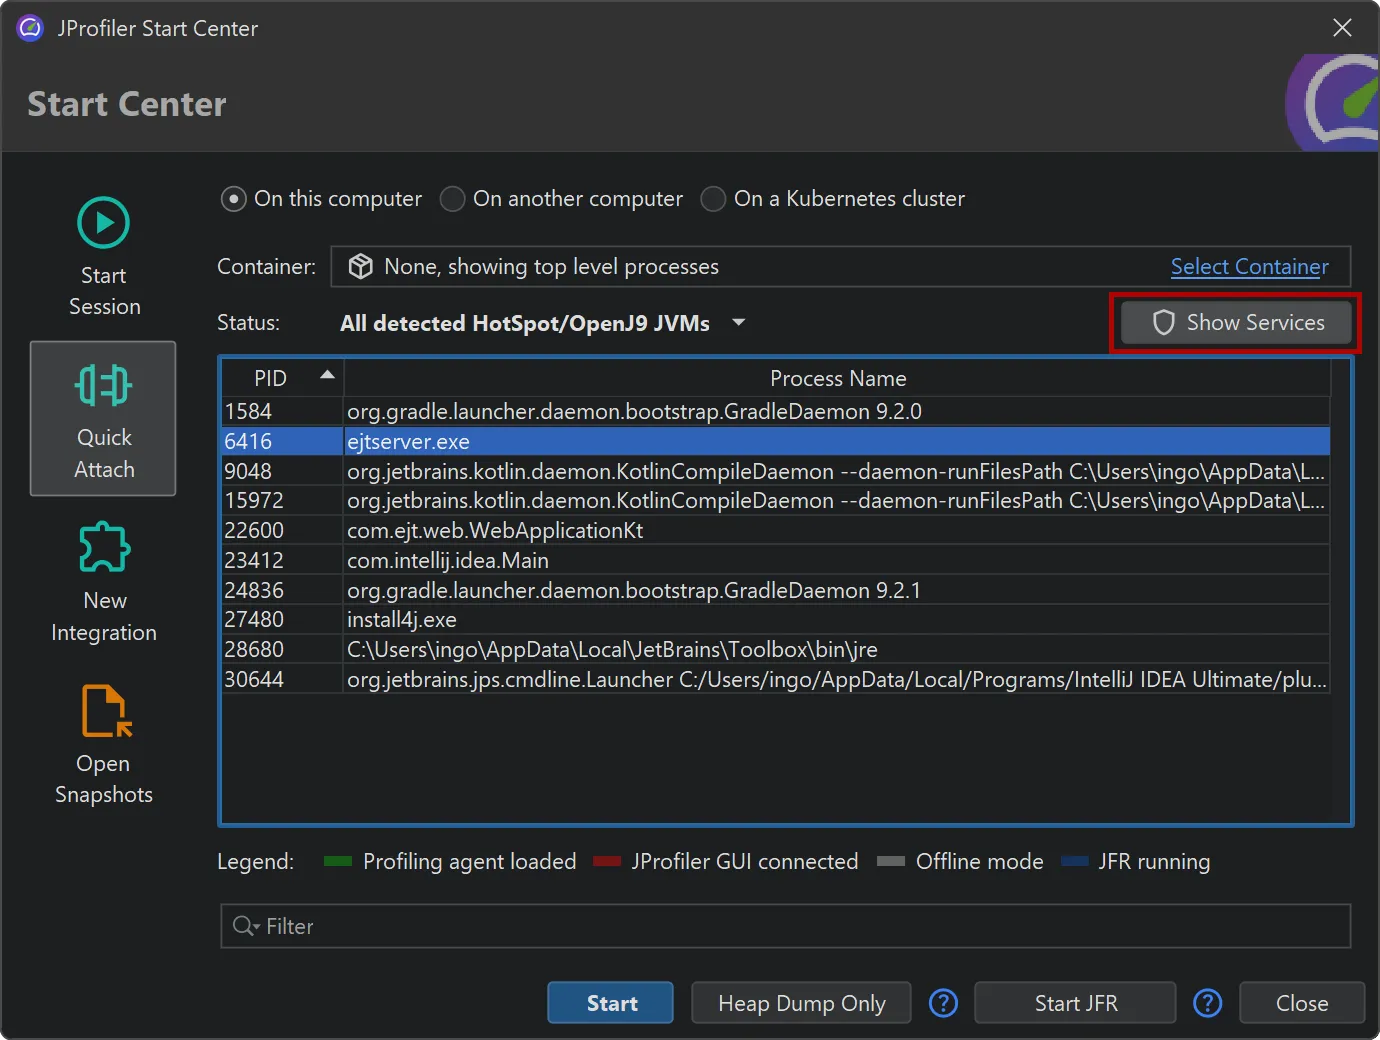
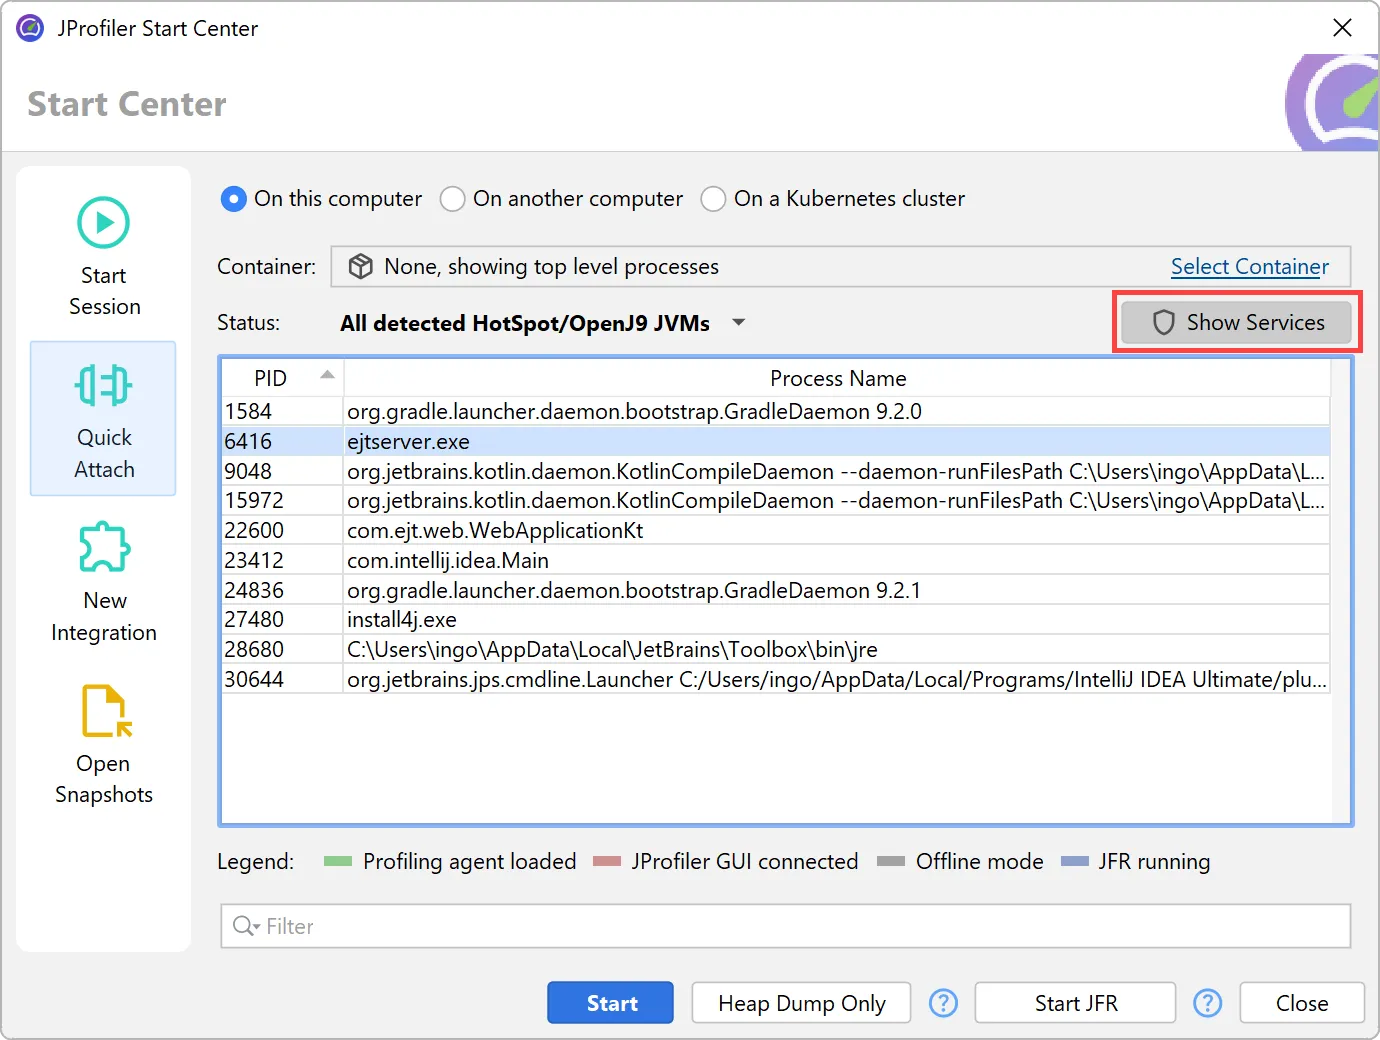
作为一项相关的改进,现在可以附加到以其他用户身份运行的 Windows 进程,即使 JProfiler 未安装在这些进程可读取的目录中也是如此。这对附加到 Windows 服务尤为重要。
JProfiler 的探针事件记录功能已重新实现。这带来了可扩展至数百万事件的能力以及众多新特性。
探针在 JProfiler 7 中引入时,重点放在累积数据上,例如热点和遥测。单个事件可作为调试问题的工具使用,但它们全部保存在内存中,因此事件数量受到较大限制。
然而,保留所有事件可以实现仅凭聚合数据无法达成的高级过滤。新的基于文件的后端支持高吞吐量记录,使跨海量事件集合执行复杂查询成为可能,而这在此前是无法处理的。
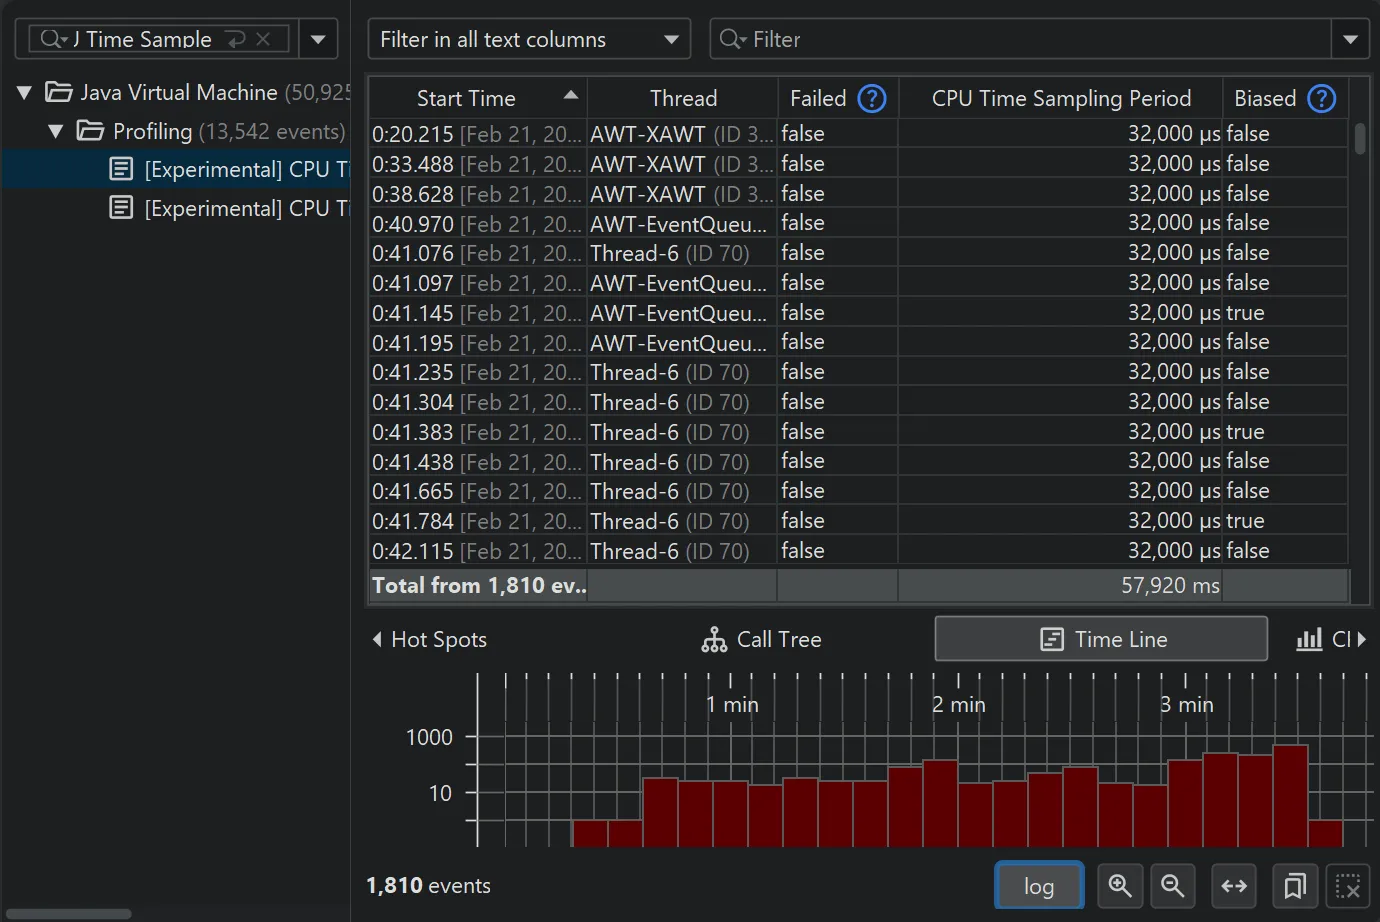
事件视图底部新增的时间线选项卡显示所有已记录事件的直方图,并允许您选择时间范围进行过滤。
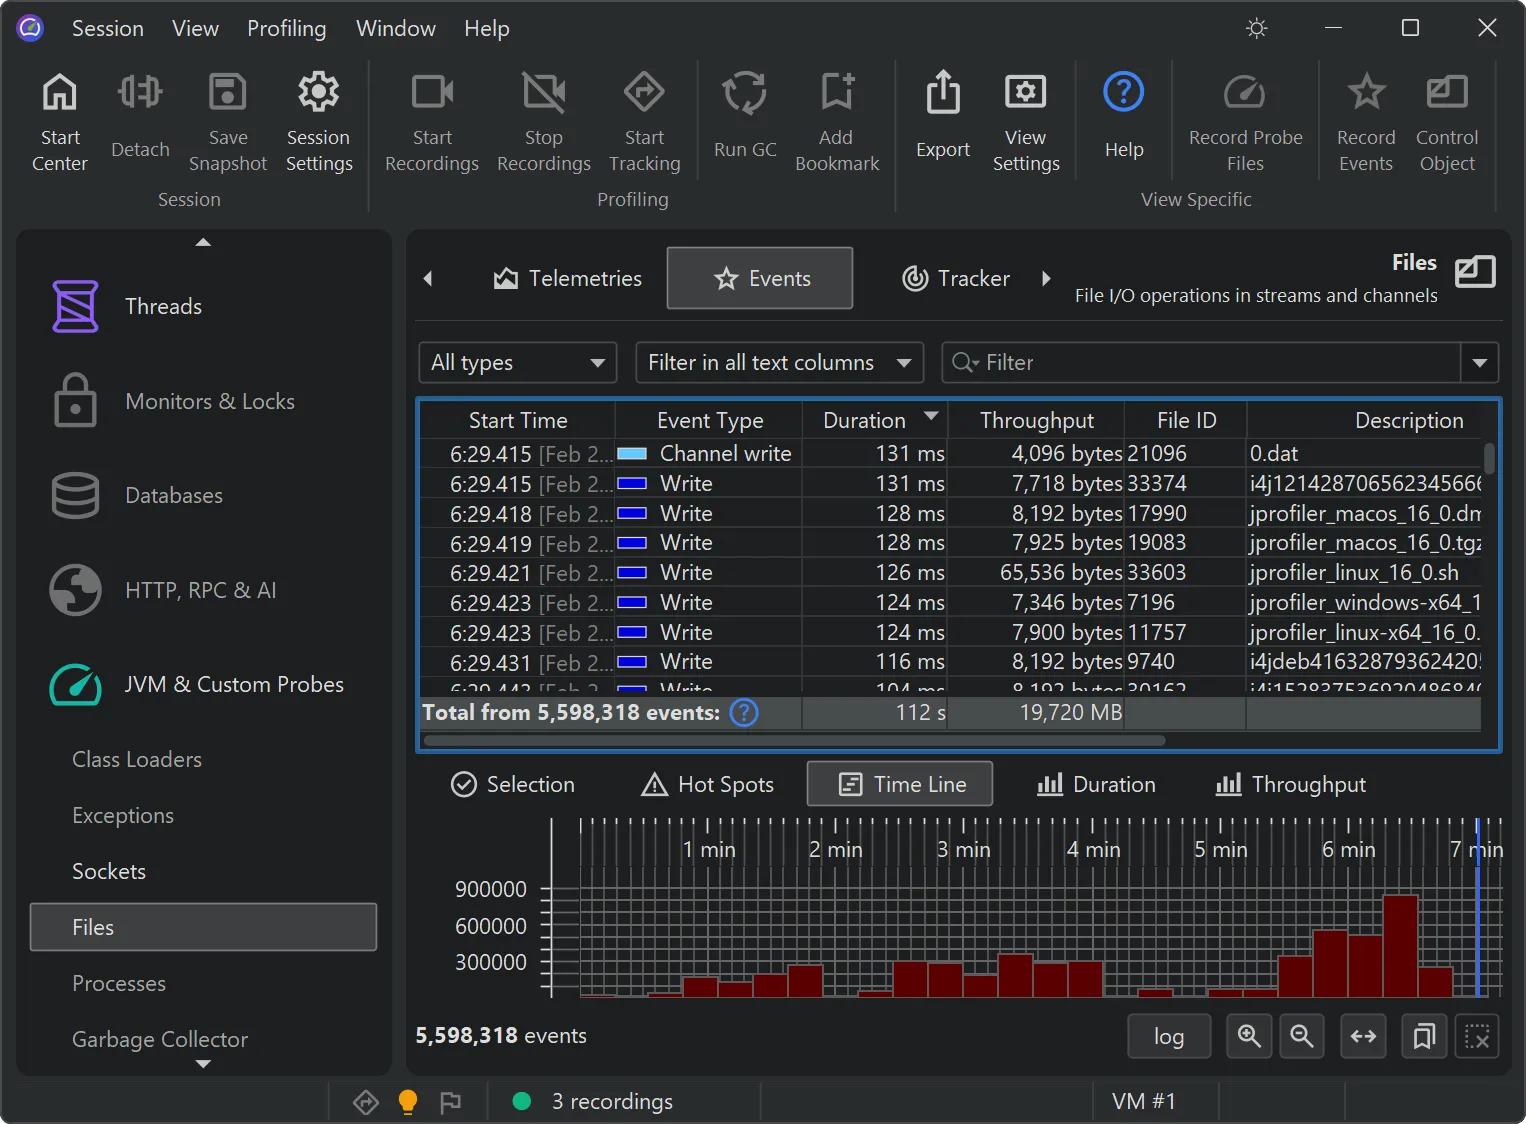
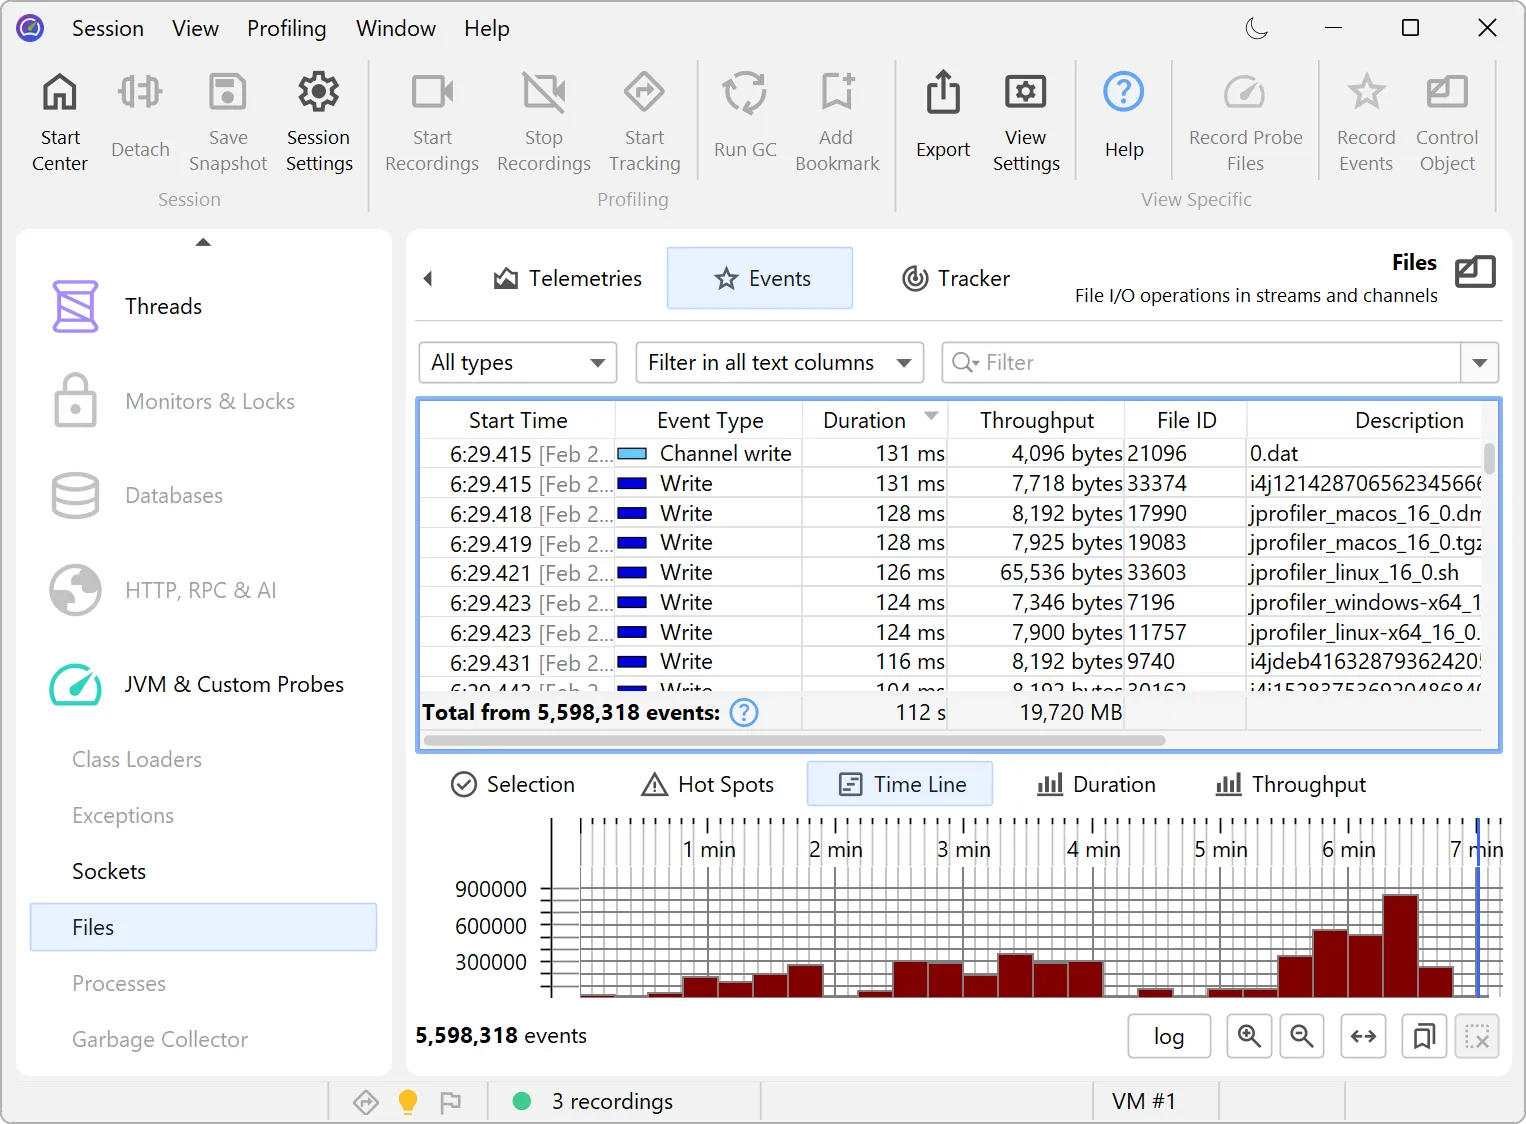
虽然表格仅显示数量有限的事件,但您可以在滚动到底部时添加更多事件。按列排序时会考虑整个已过滤事件集合,而不仅仅是当前可见的行。
表格中的总计也会针对整个已过滤事件集合进行计算。
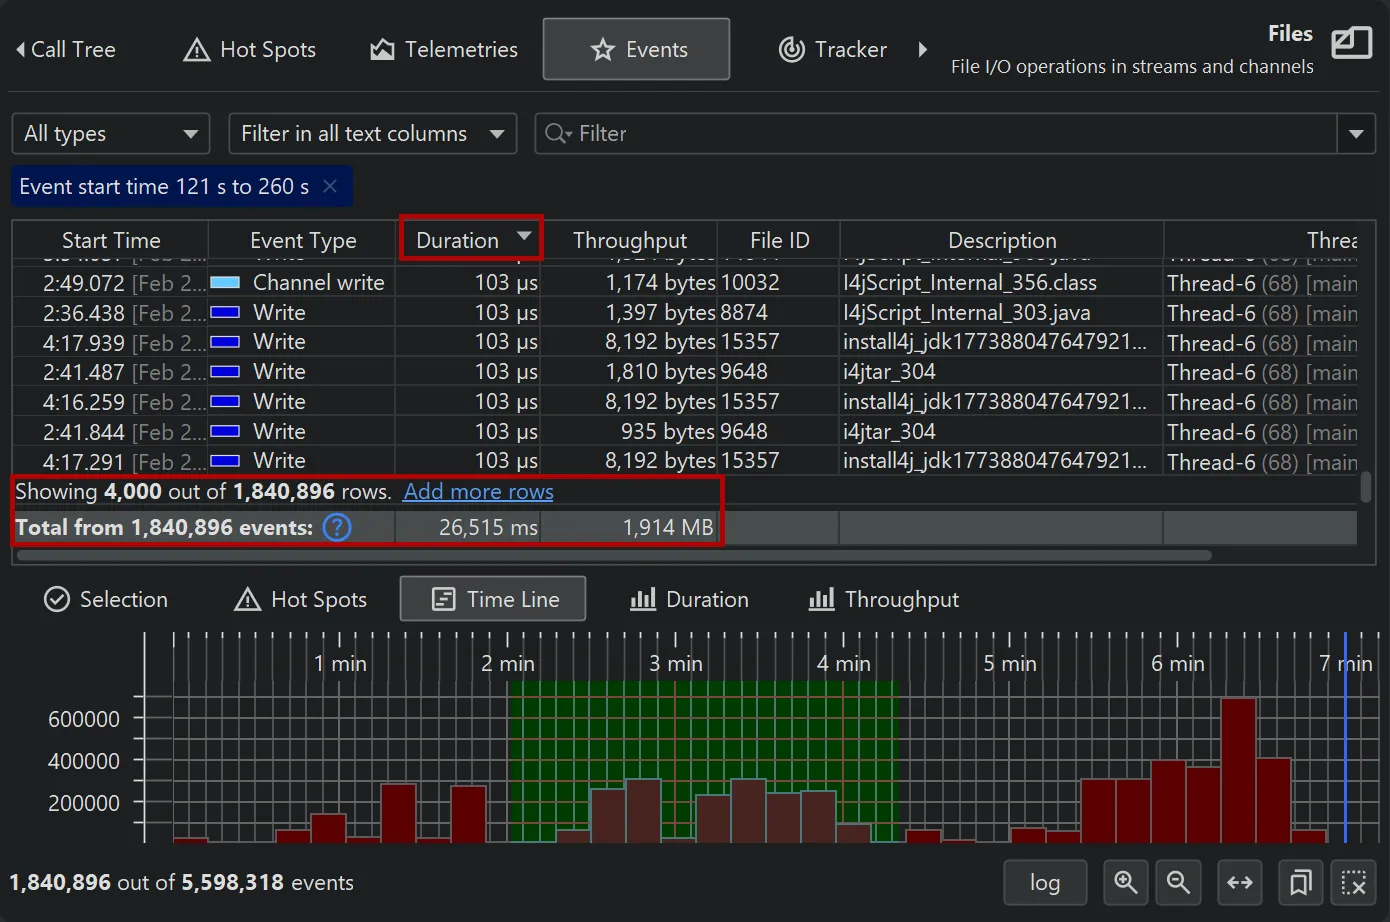
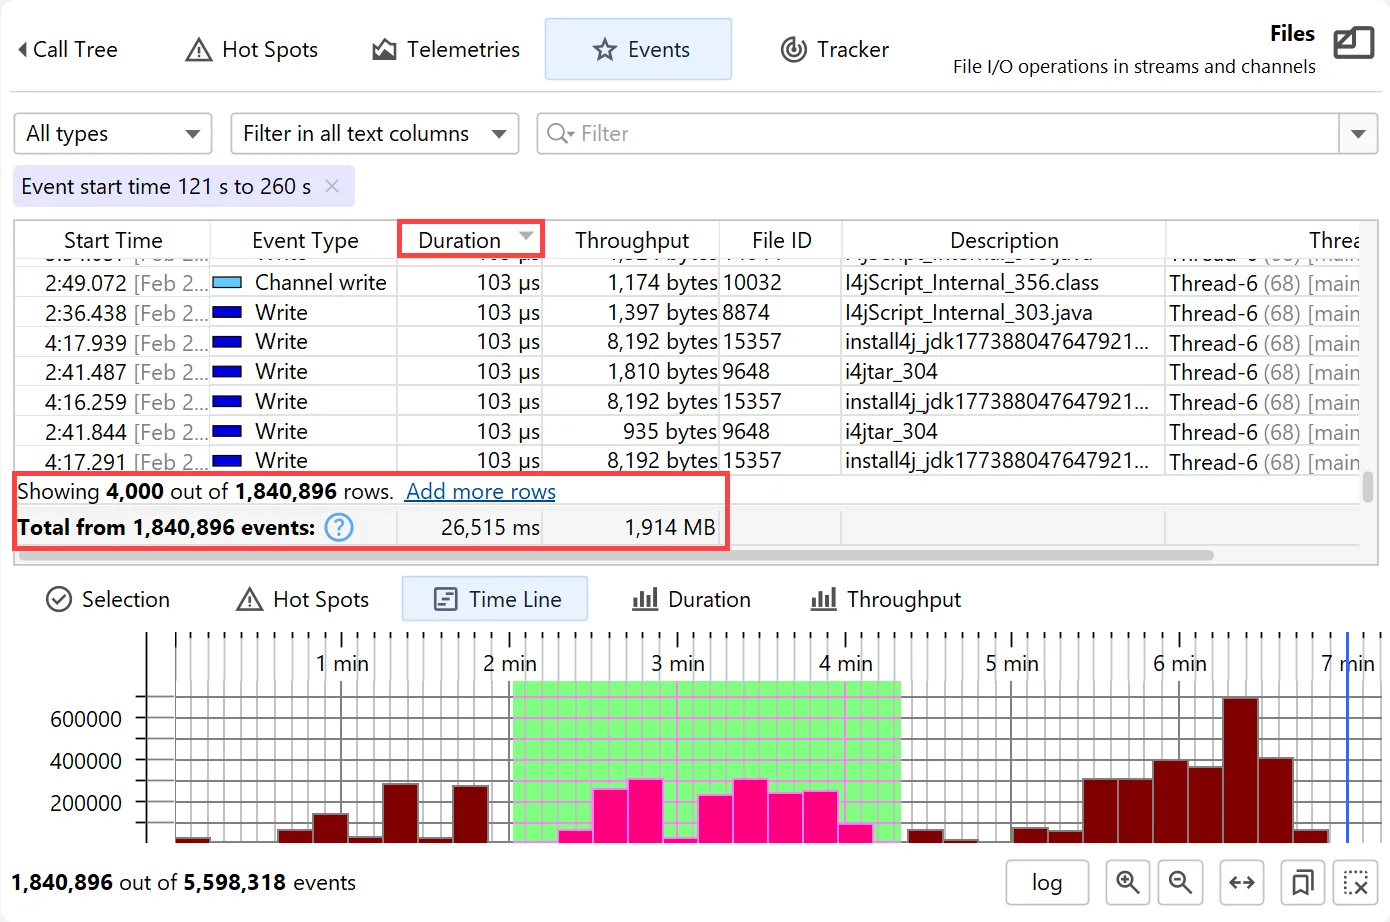
下方的“热点”选项卡包含 CPU 热点视图、探针热点视图和探针调用树,与“选择”选项卡类似,但针对所有已过滤事件而非选定行进行计算。
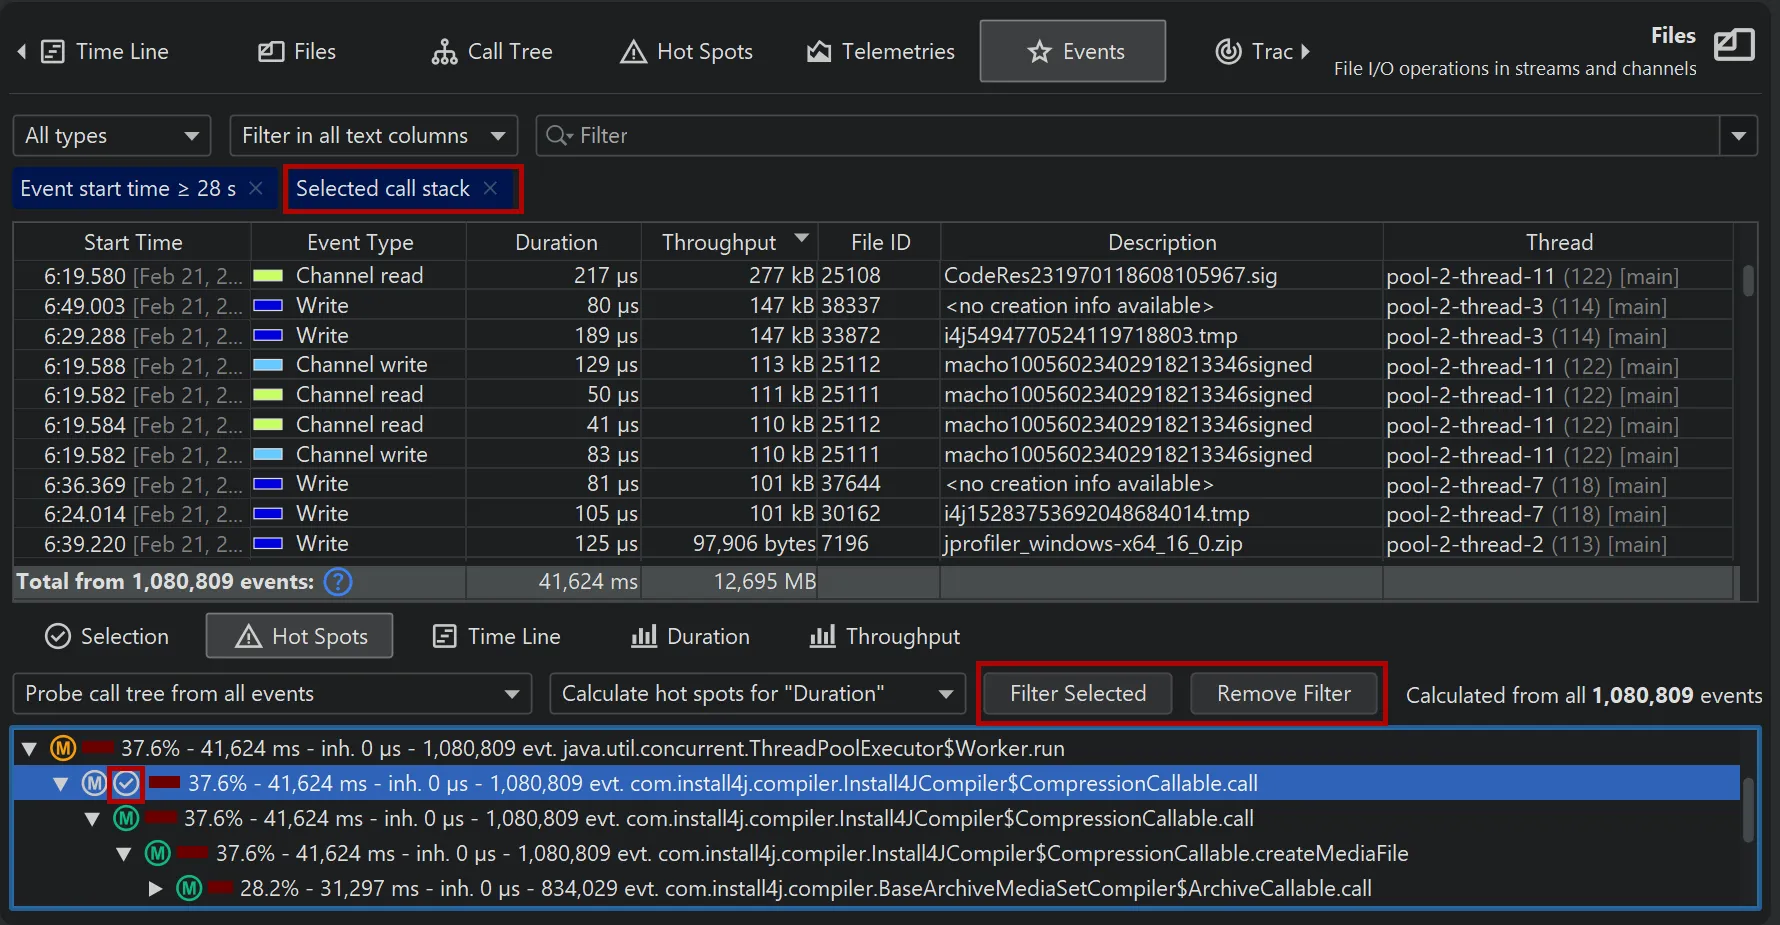
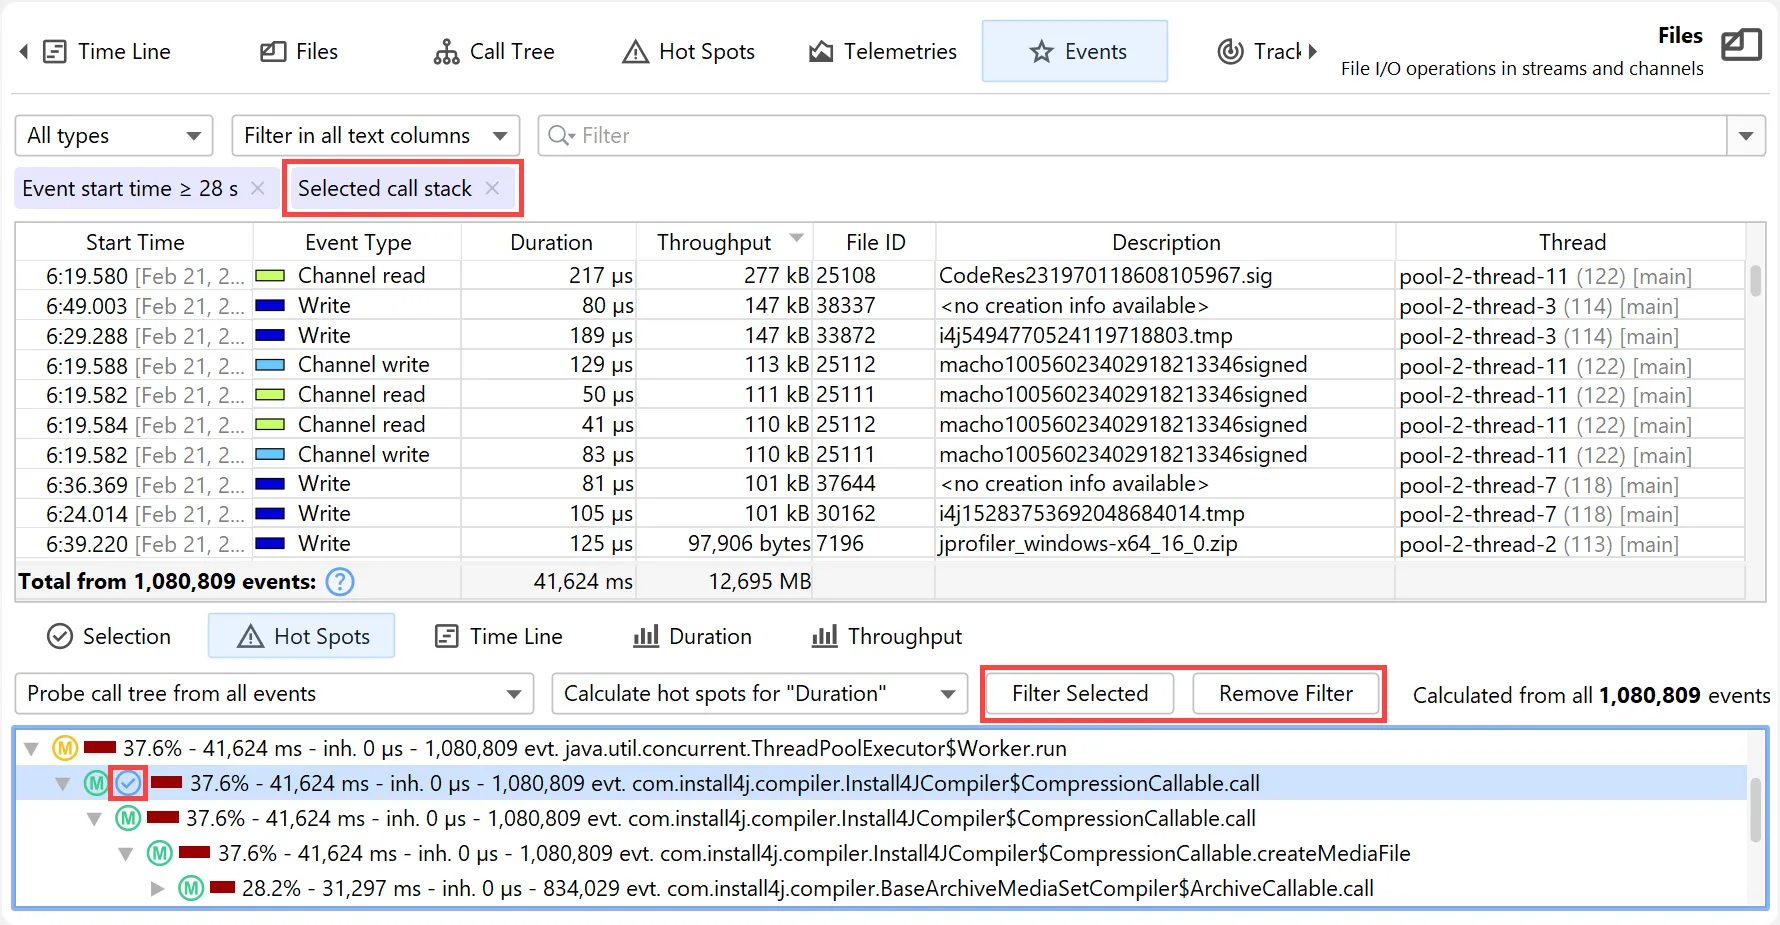
在这些视图中,您都可以使用过滤器按钮来限制主事件表格以及底部所有其他视图显示的事件。下方截图展示了探针调用树中的调用栈过滤器,其中被过滤的节点标有过滤器图标。
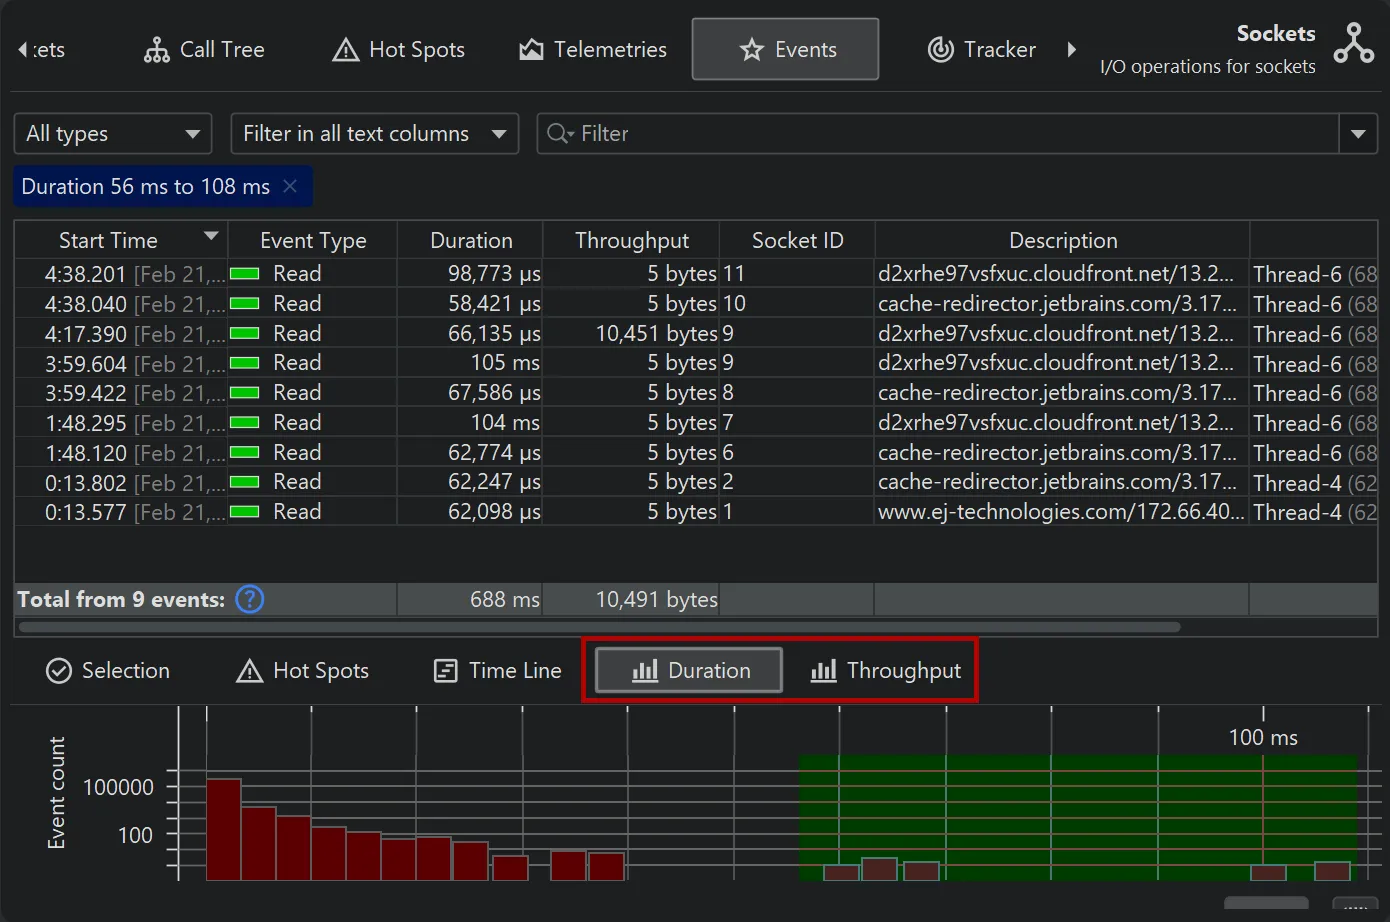
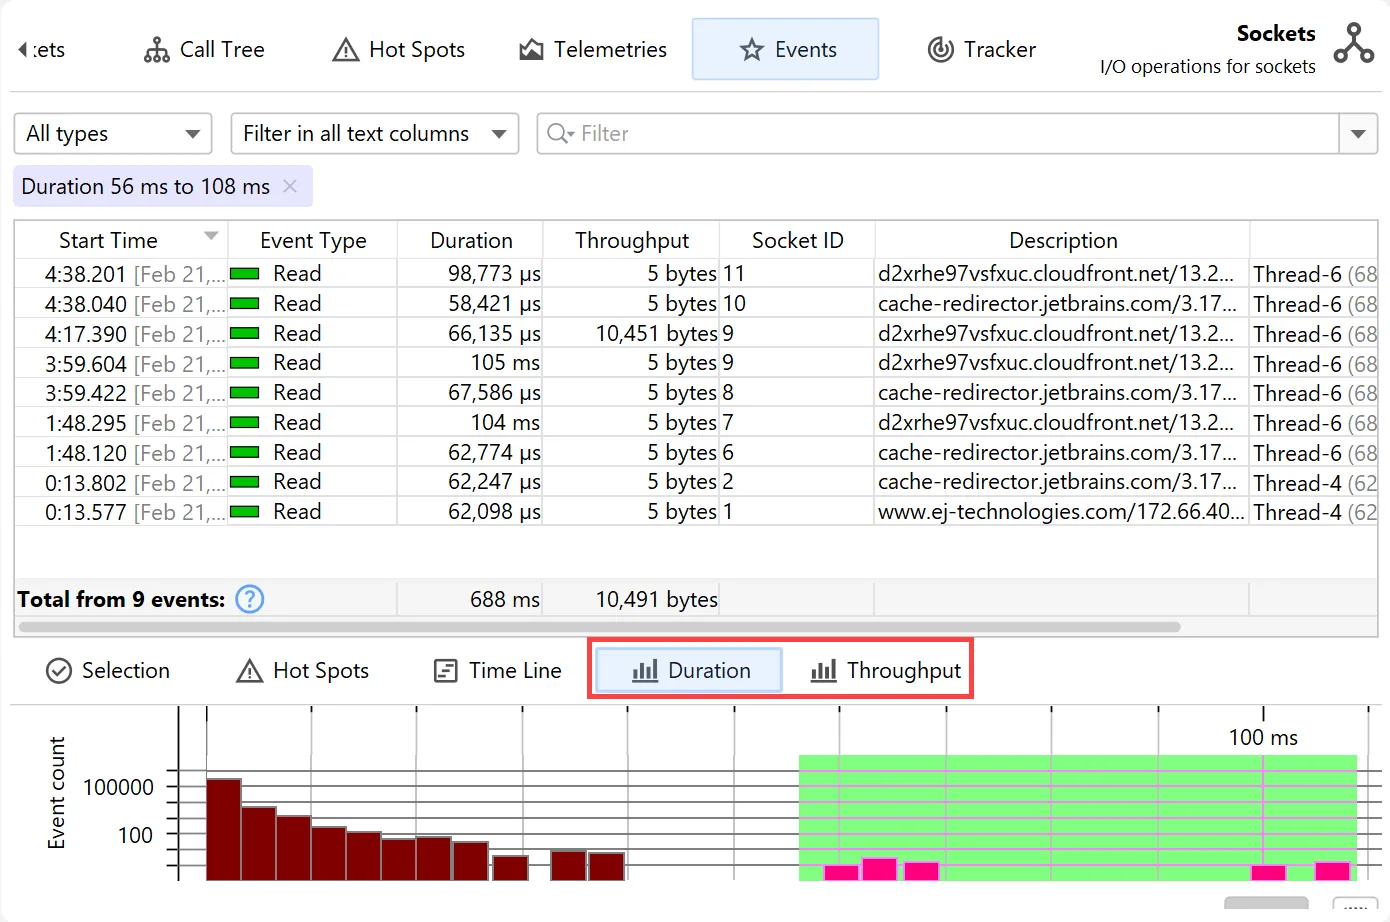
根据探针执行的度量,底部还提供额外的直方图视图。对于“文件”和“套接字”探针,这些视图是“持续时间”和“吞吐量”。
直方图可以使用对数 y 轴显示,并支持用鼠标拖动一个范围来进行过滤。
最后,事件视图中的智能列管理已经实现。JProfiler 会根据所有列的总宽度与可用视口宽度,决定是将各列调整至适应视口,还是激活水平滚动。手动调整列宽会停用“适应视口”模式;当表格总宽度再次小于视口宽度时,该模式会自动重新激活。
如果探针除事件持续时间之外还有其他度量,探针调用树和探针热点视图现在会提供度量选择器。例如,“文件”和“套接字”探针还提供“读取吞吐量”和“写入吞吐量”。选择其中一个吞吐量度量会自动将视图分别限制为“读取”或“写入”事件。
更改度量会重新计算热点,并更新探针调用树中的热路径。
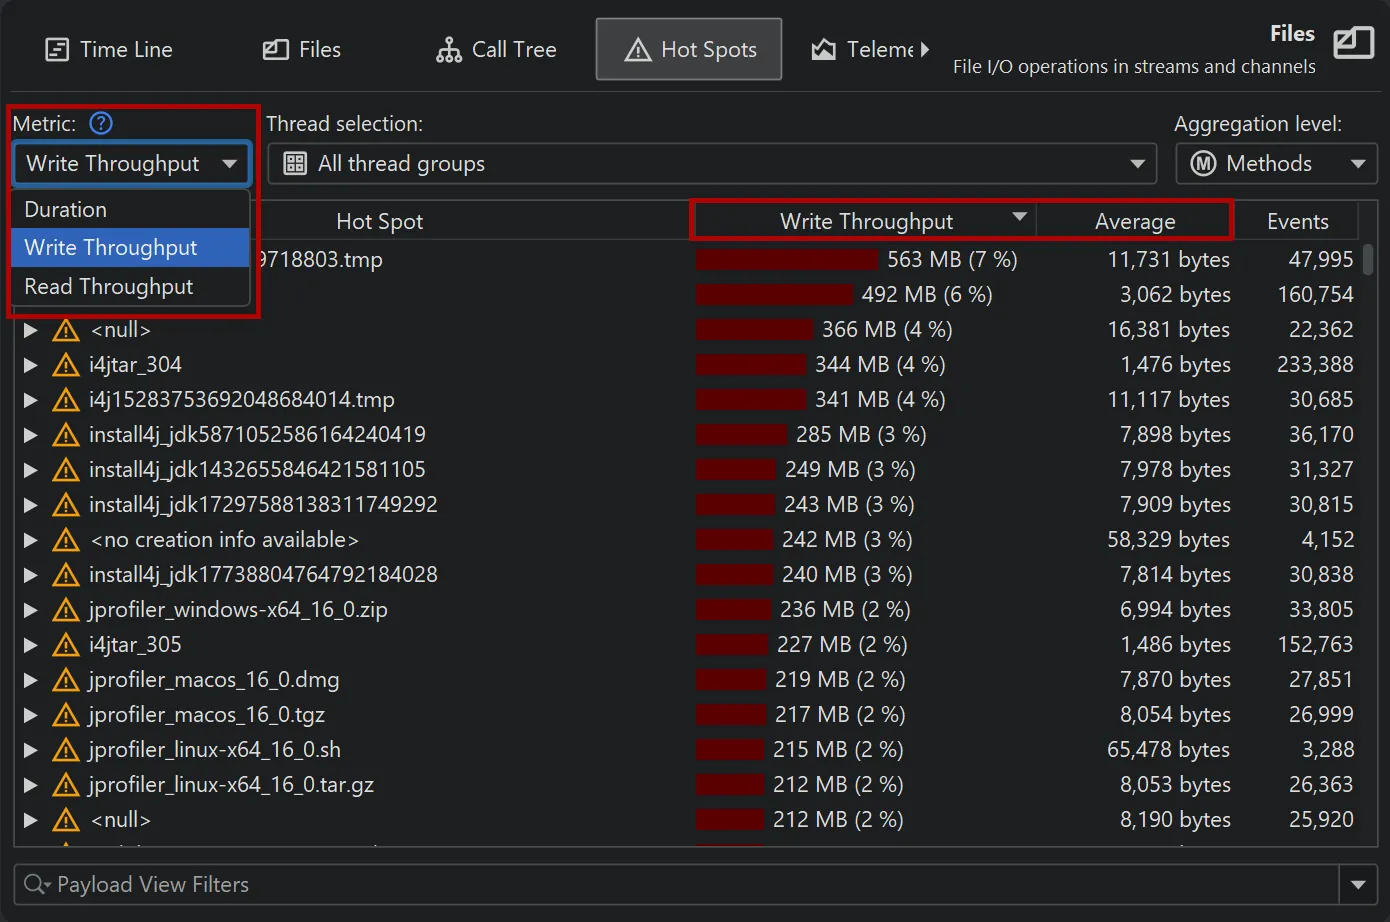
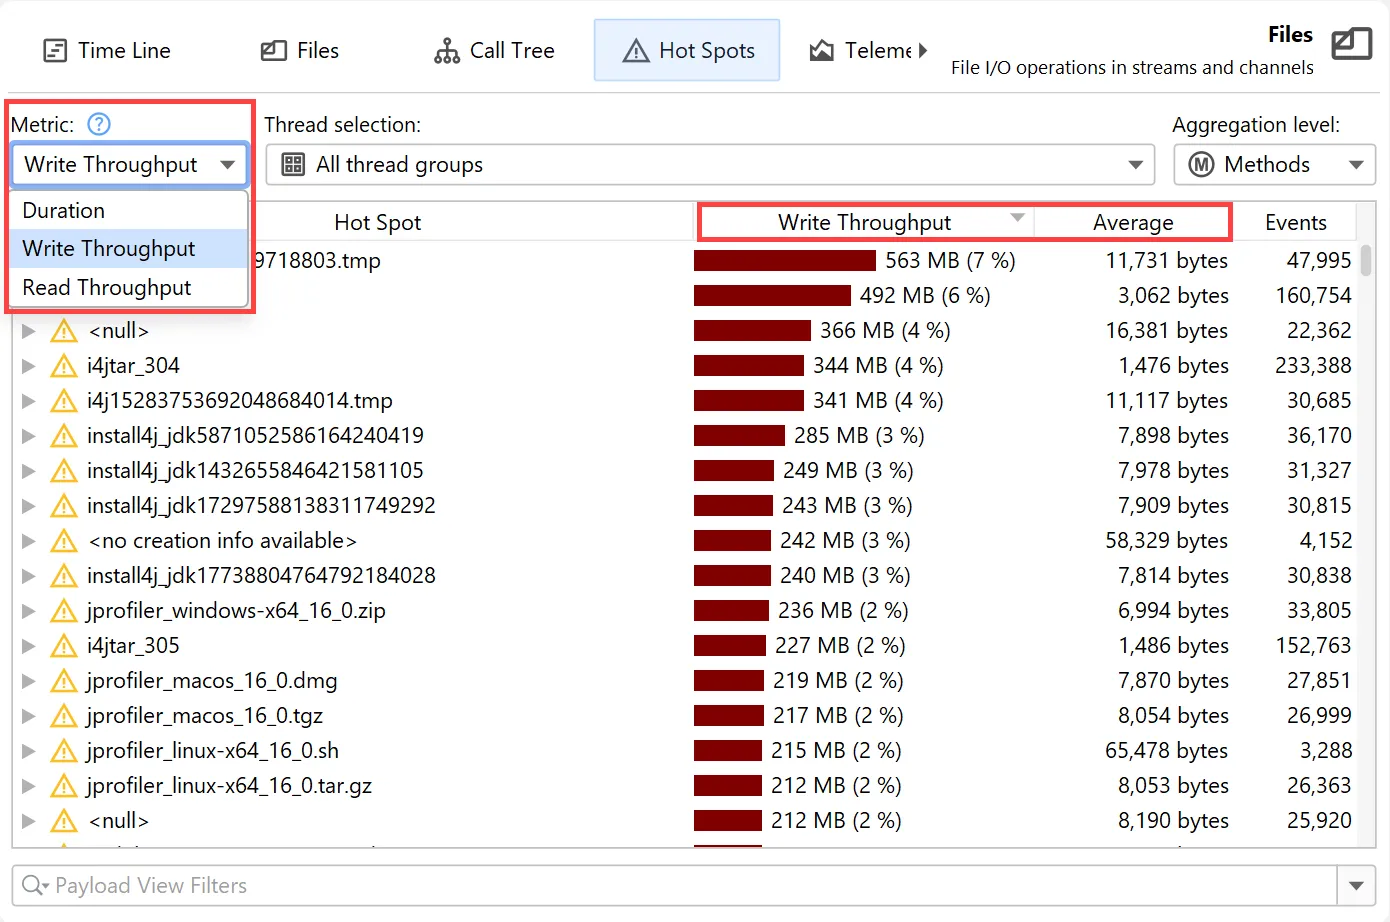
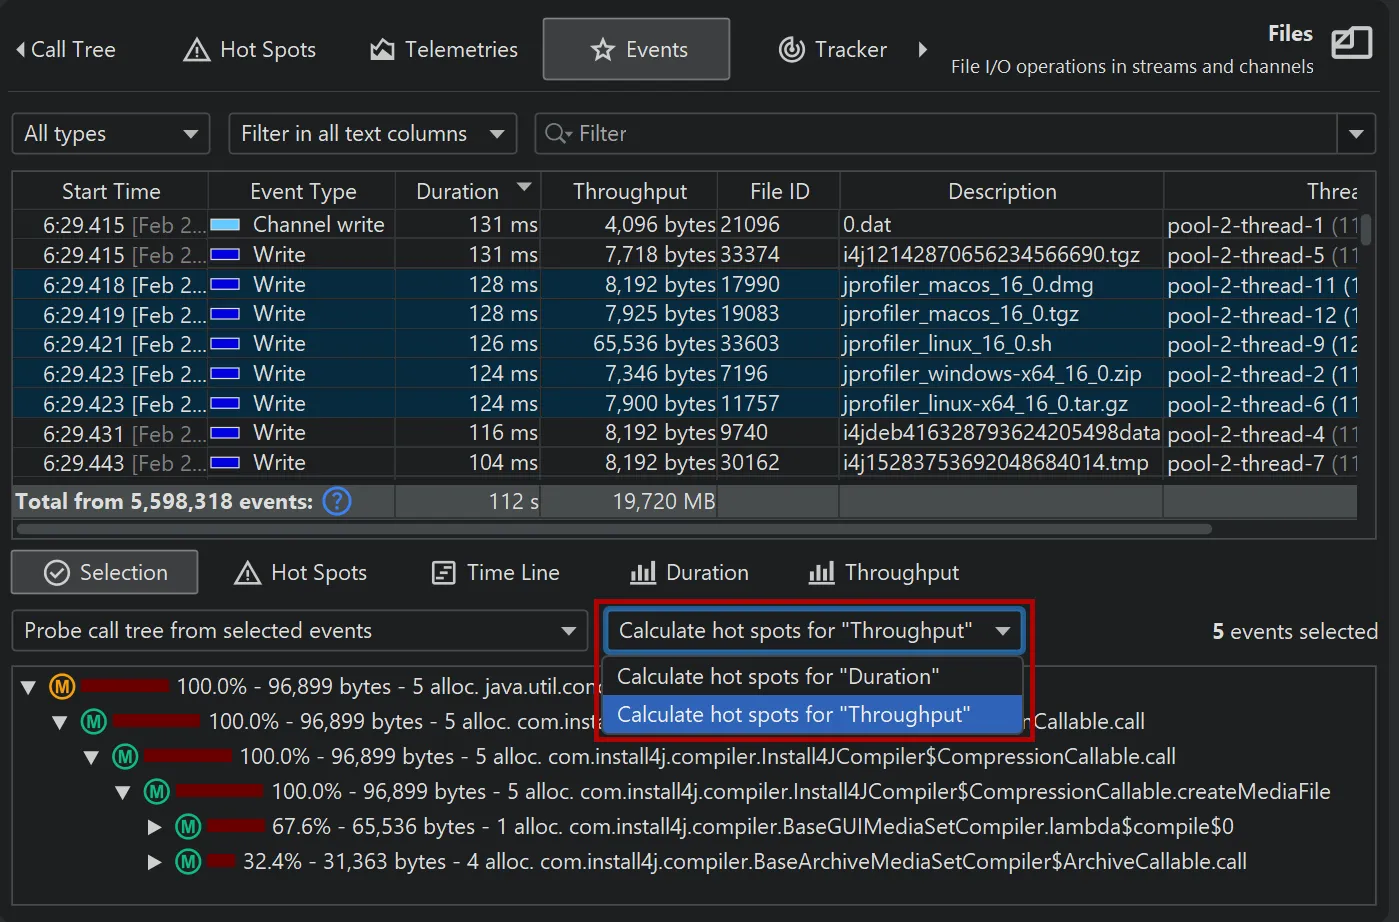
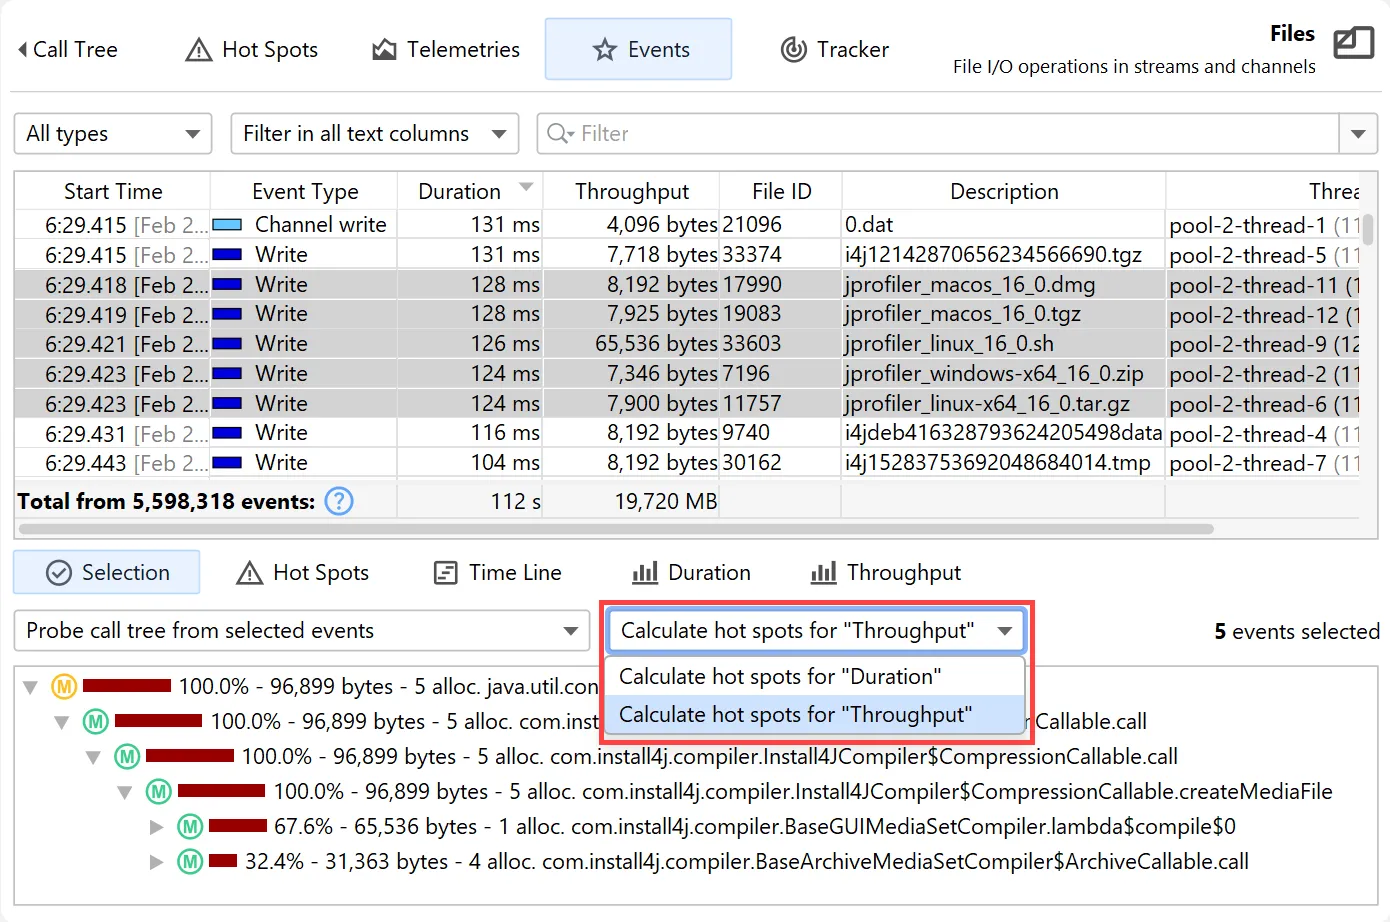
探针事件视图的“选择”和“热点”选项卡现在也提供度量选择器。由于“读取”和“写入”事件可以在事件视图中分别过滤,因此这里只有一个合并的“吞吐量”度量。
JProfiler 16 为 JFR 支持带来了大量改进。
- 通过预先计算下方视图的数据,事件浏览器在处理大量事件时的响应能力得到了提升。
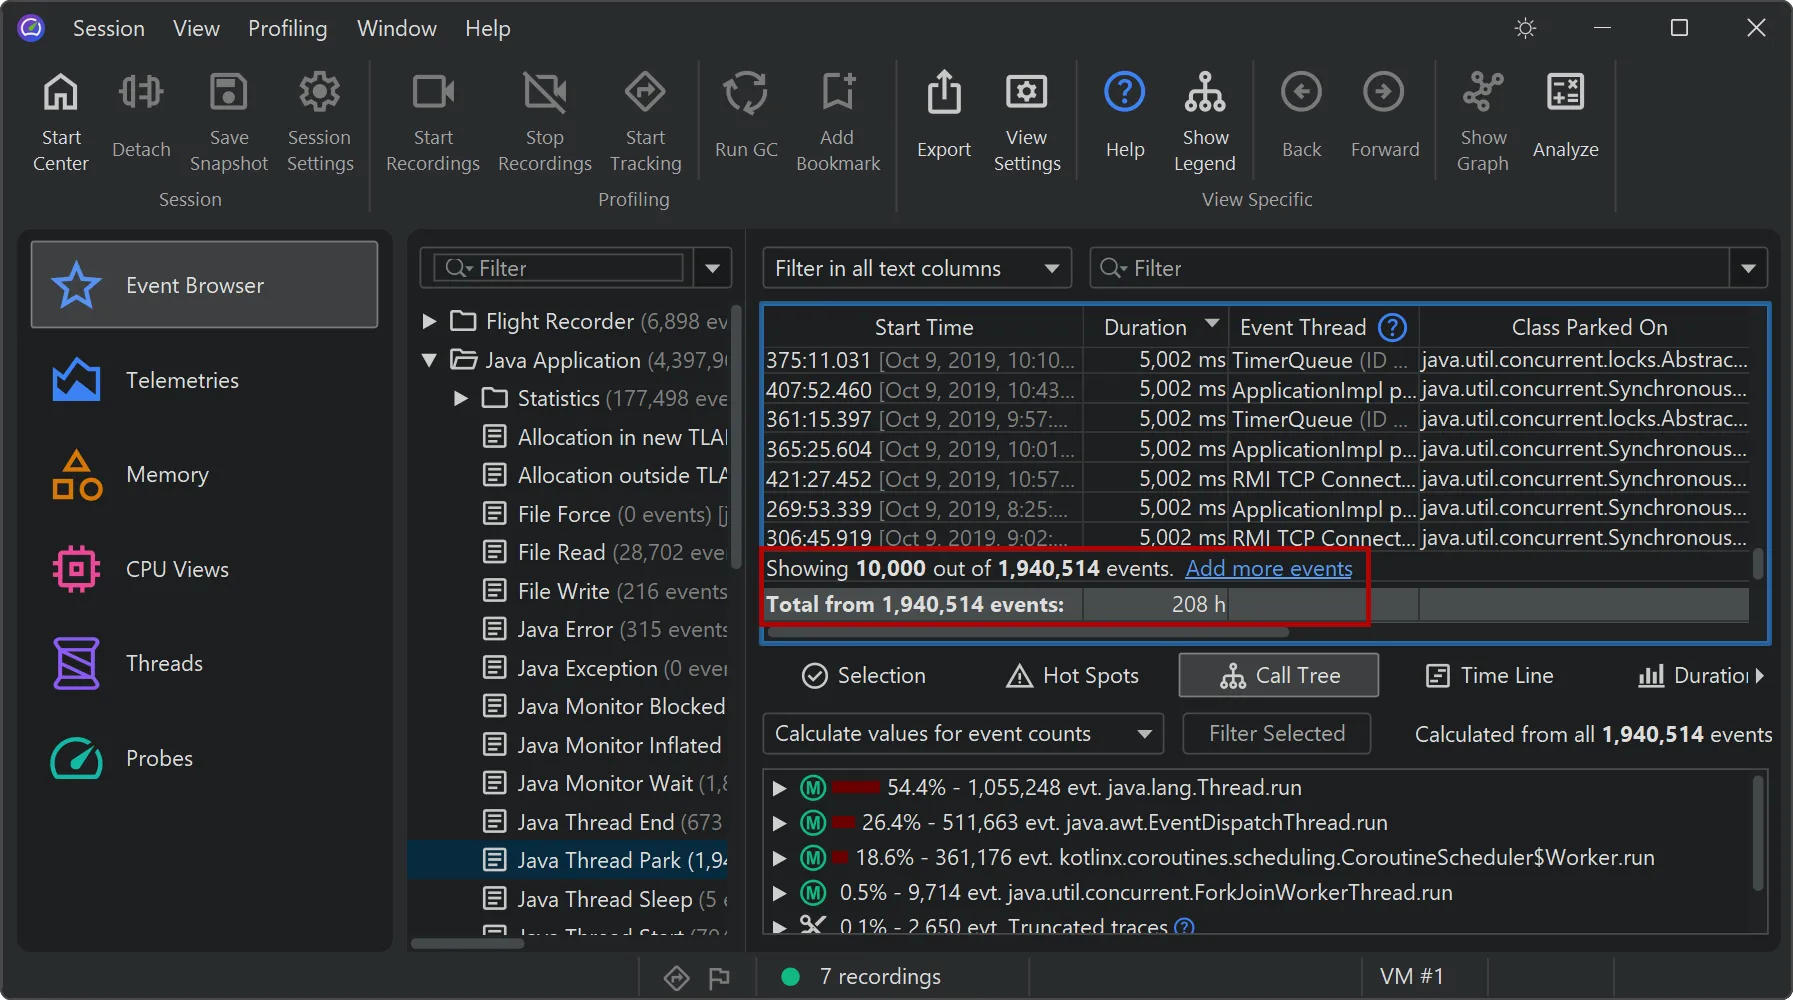
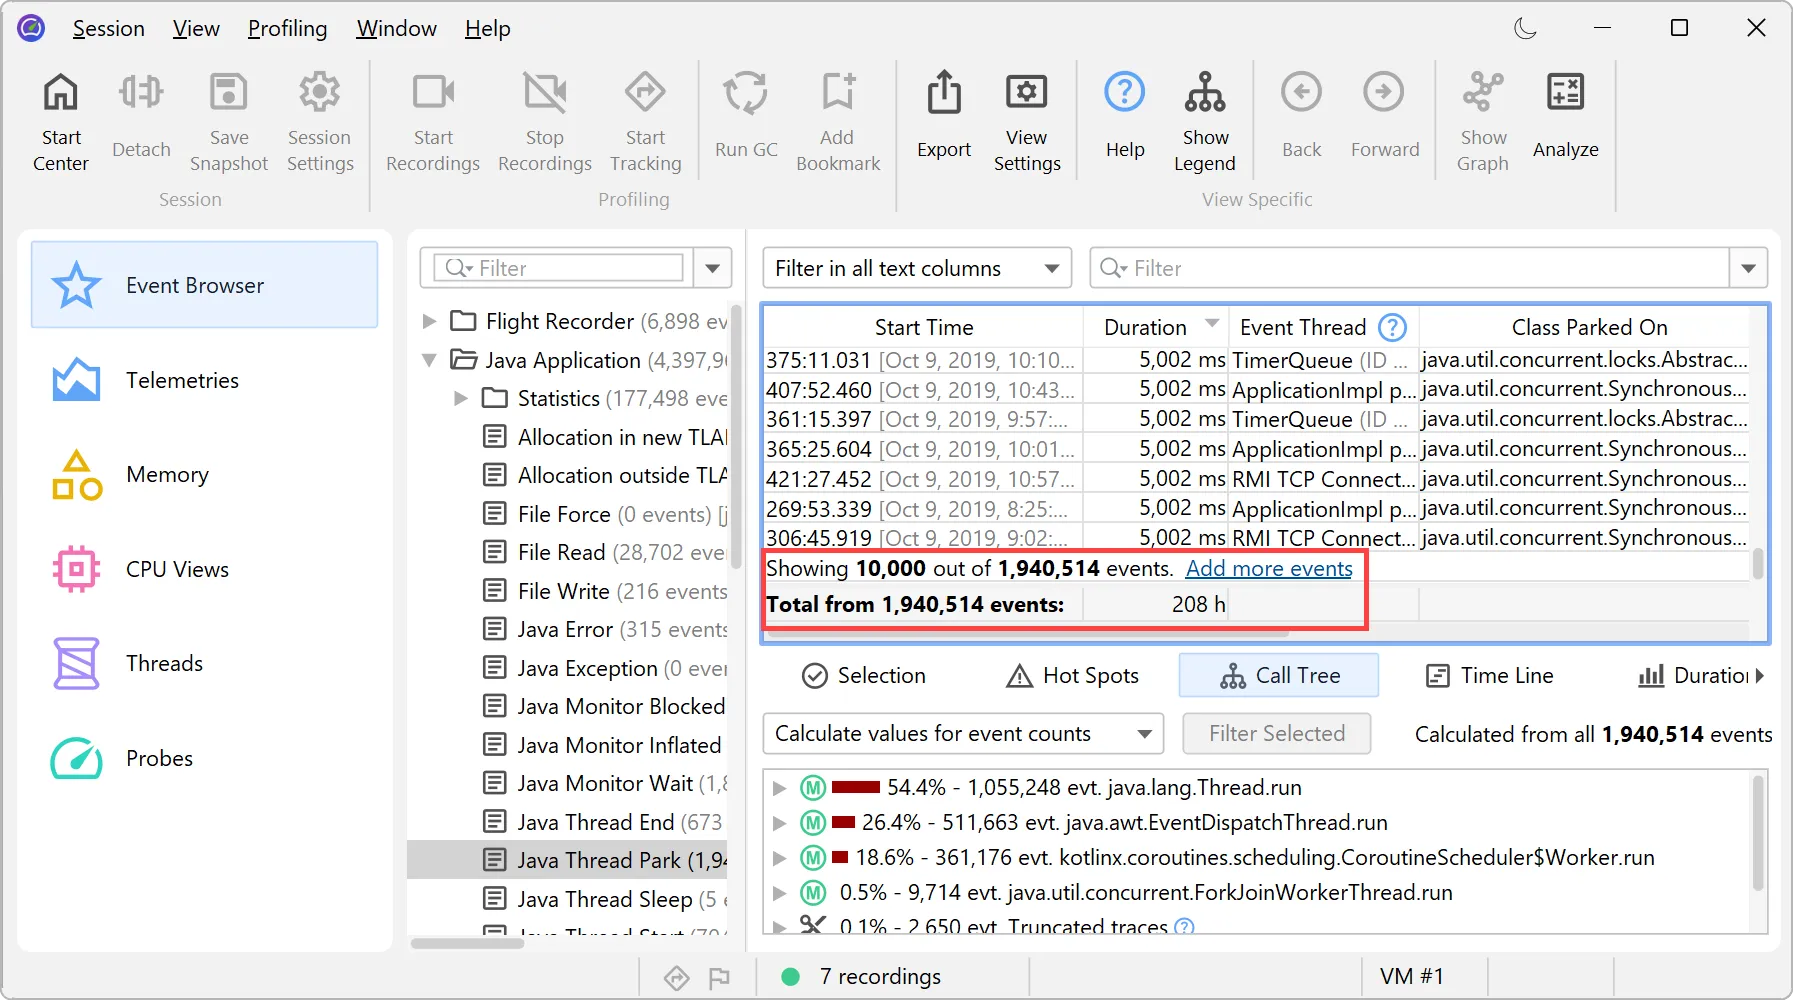
- 以前的 JProfiler 版本在事件表格中只能处理有限数量的事件。现在您可以在滚动到底部时加载更多事件。此外,对表格排序时会考虑所有已过滤事件,而不仅仅是可见的子集。
- 事件表格中的总计现在会针对所有已过滤事件进行计算,而不仅针对当前显示的事件。
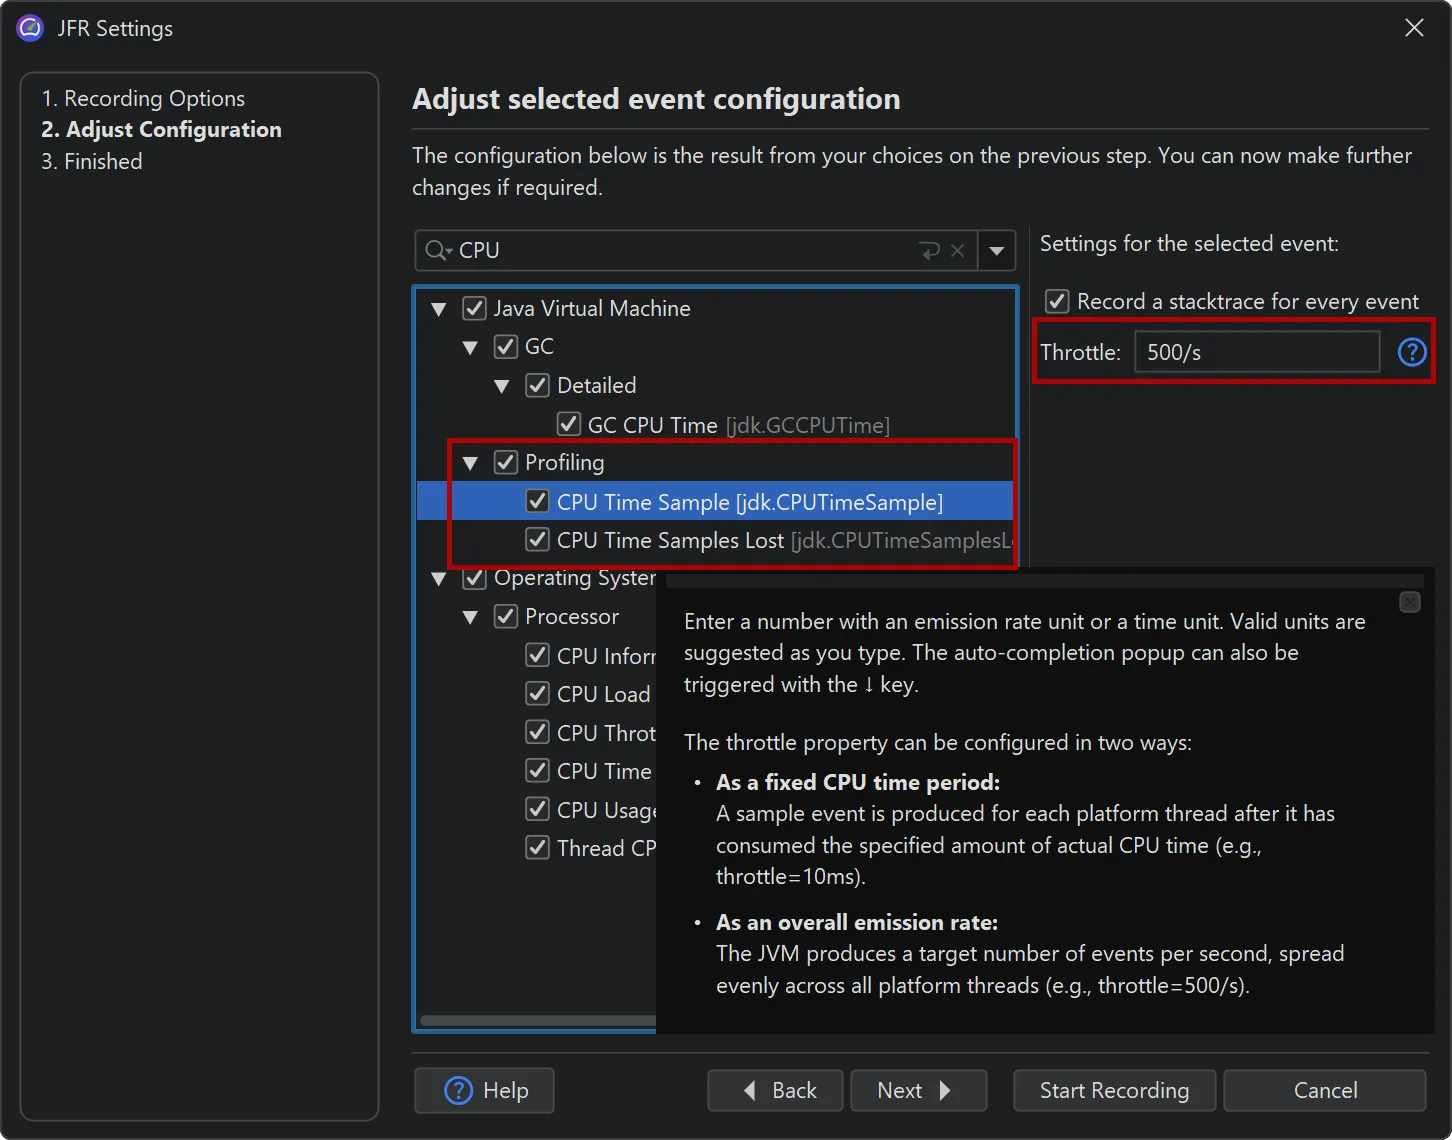
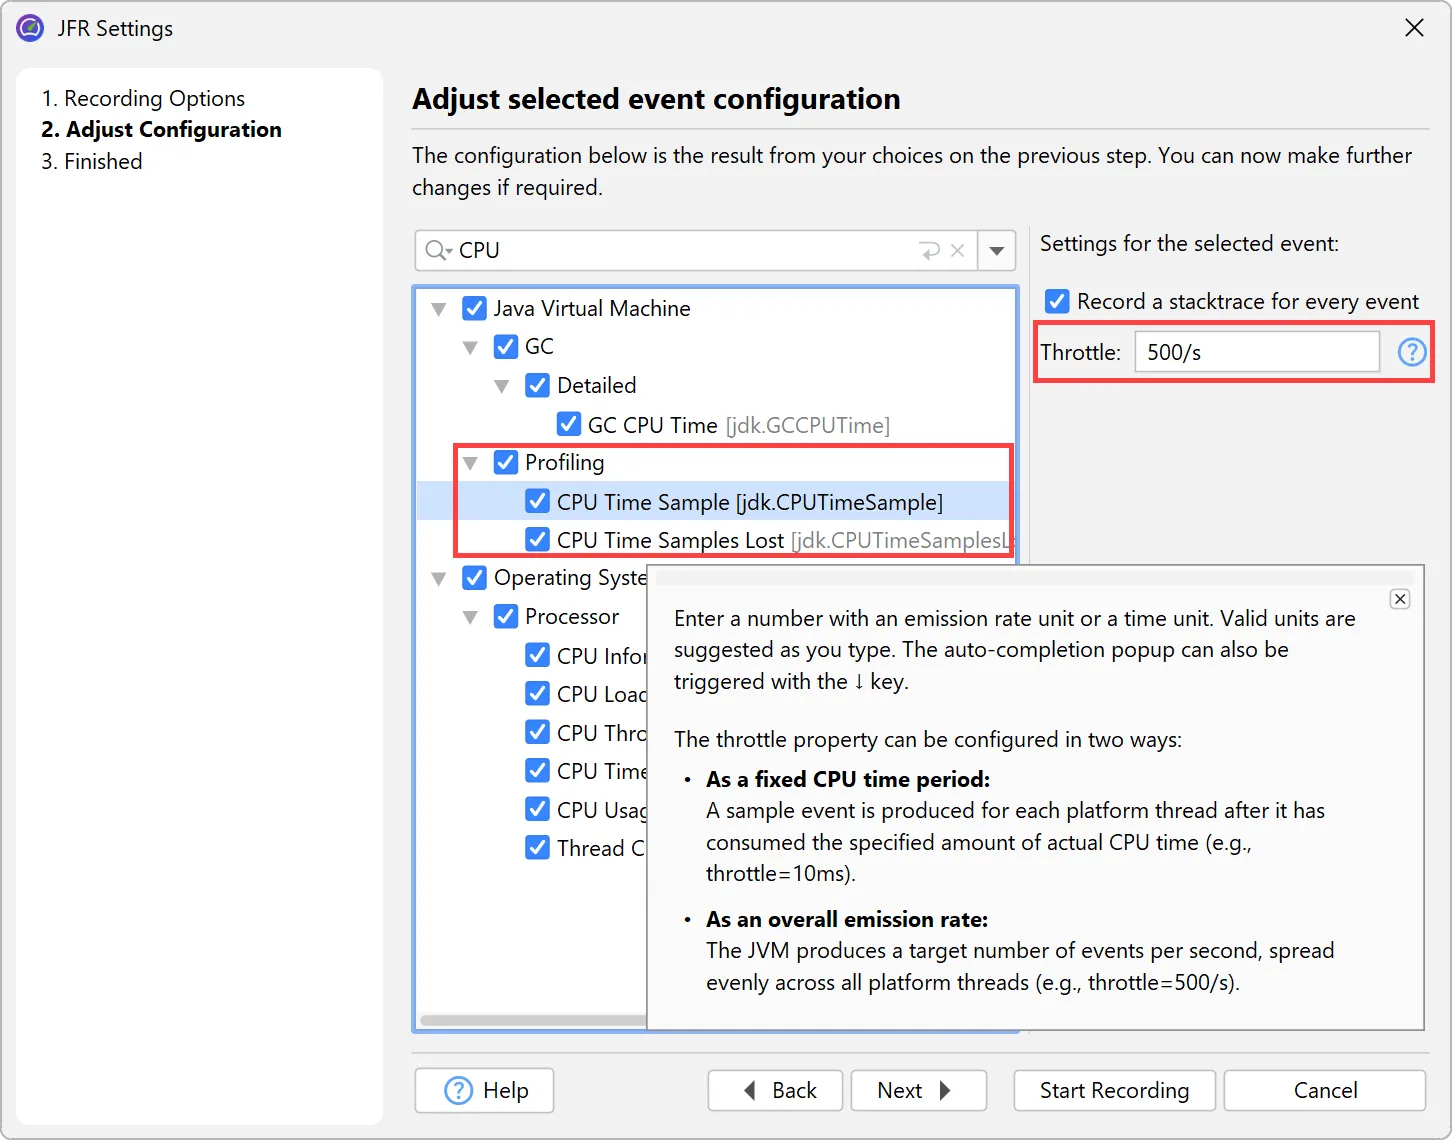
JFR 记录向导中新增了对节流设置的支持。例如,Java 25 中新增的 jdk.CPUTimeSample 事件就是通过节流来配置的。您也可以改为输入周期,或者输入带 /s 单位的发射速率。
节流设置还会显示在 CPU 视图中线程状态选择器的旁边。
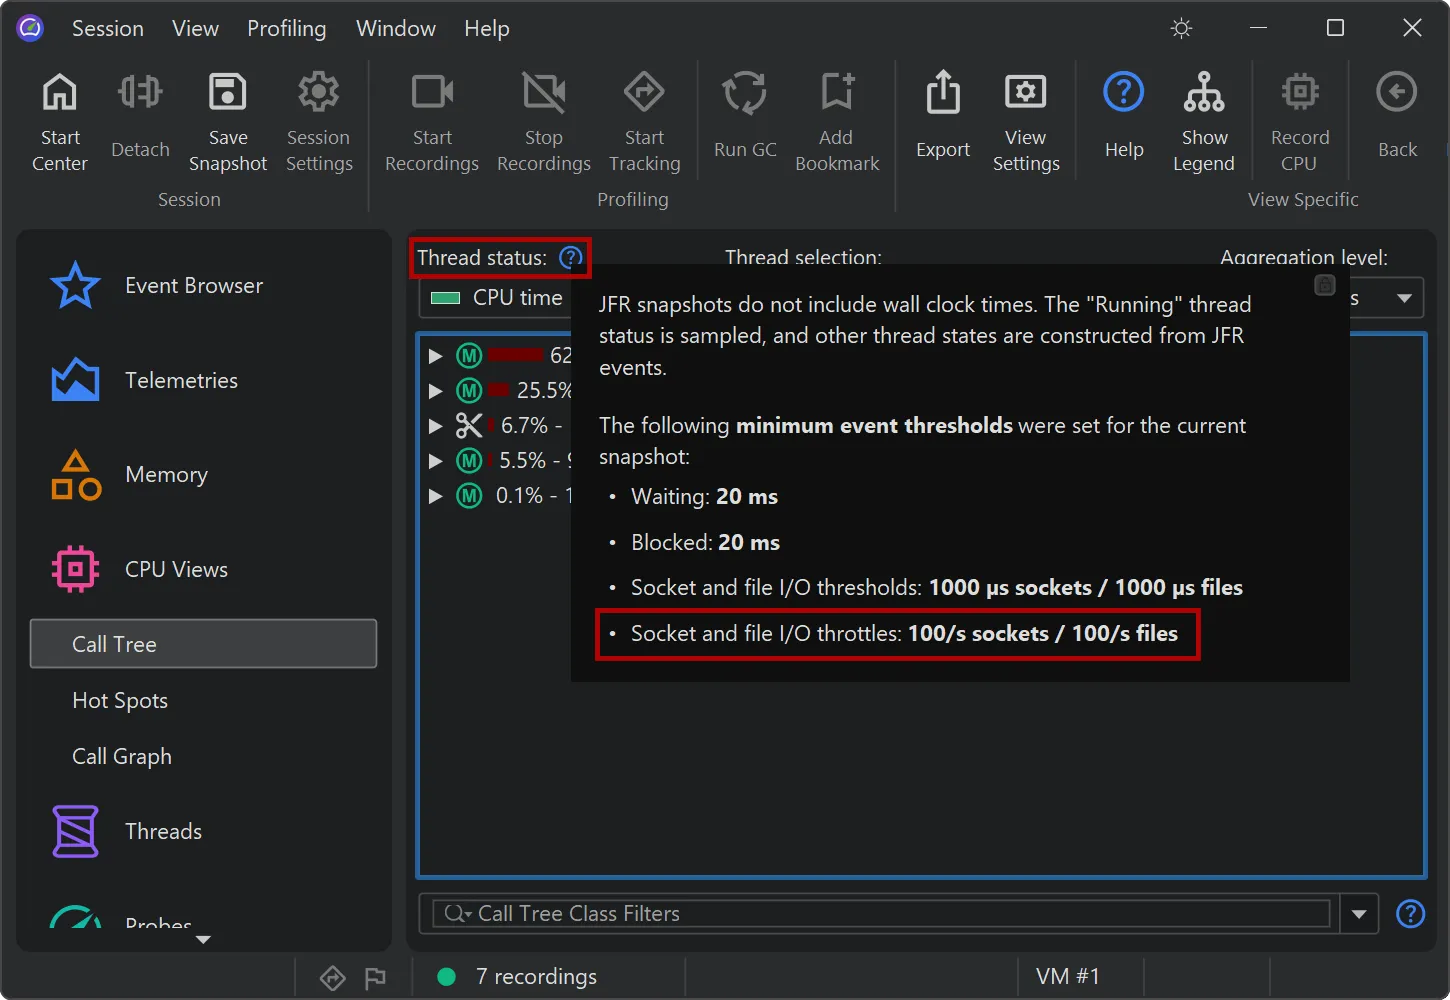
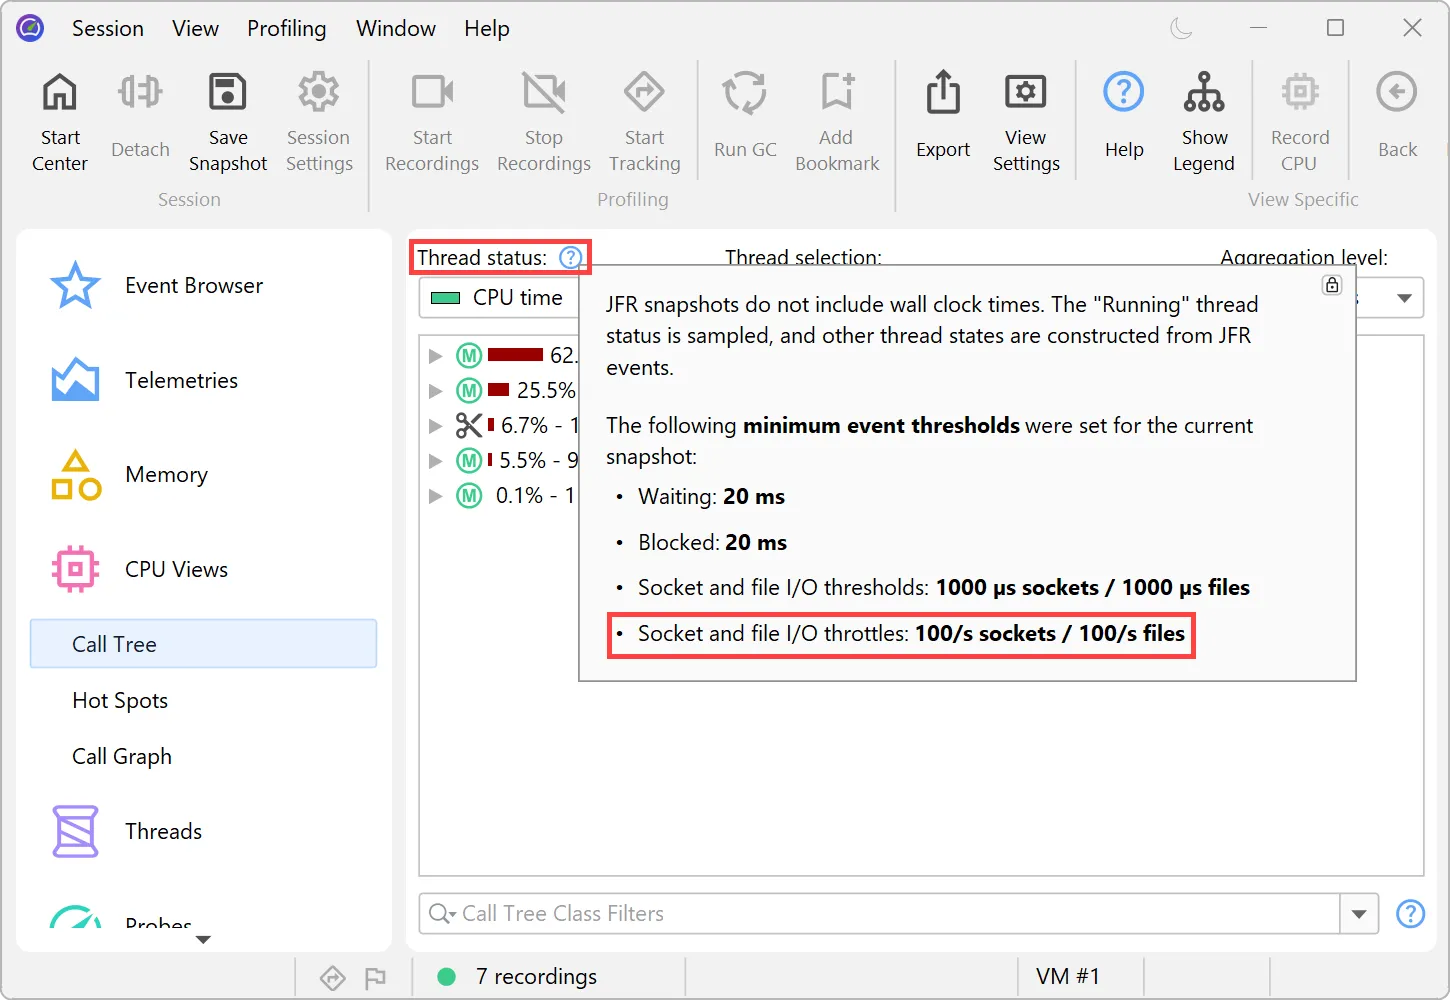
在计算CPU 部分的数据时,如果已记录,现在会使用仅限 Linux 的新 jdk.CPUTimeSample 事件(Java 25+),而不是较旧的 jdk.ExecutionSample 事件。jdk.ExecutionSample 虽然适用于所有平台,但可采样的线程数量有限,CPU 使用率的精度也有限;与之不同,jdk.CPUTimeSample 使用来自 Linux 内核的 CPU 时间事件来收集数据。
借助该事件,在不允许加载 JVMTI 代理的生产系统上,基于 JFR 的 CPU 分析现在也能提供切实可用的 CPU 指标。
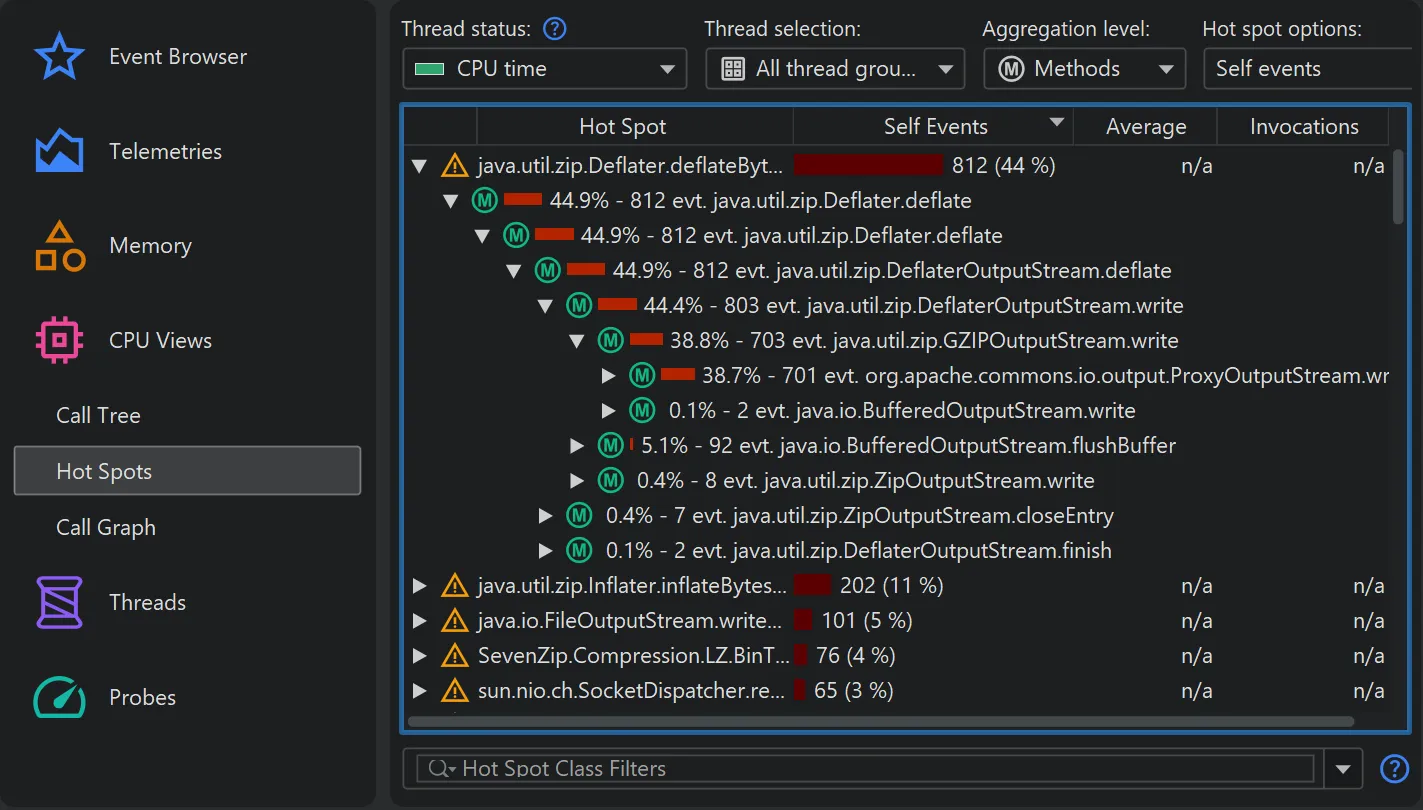
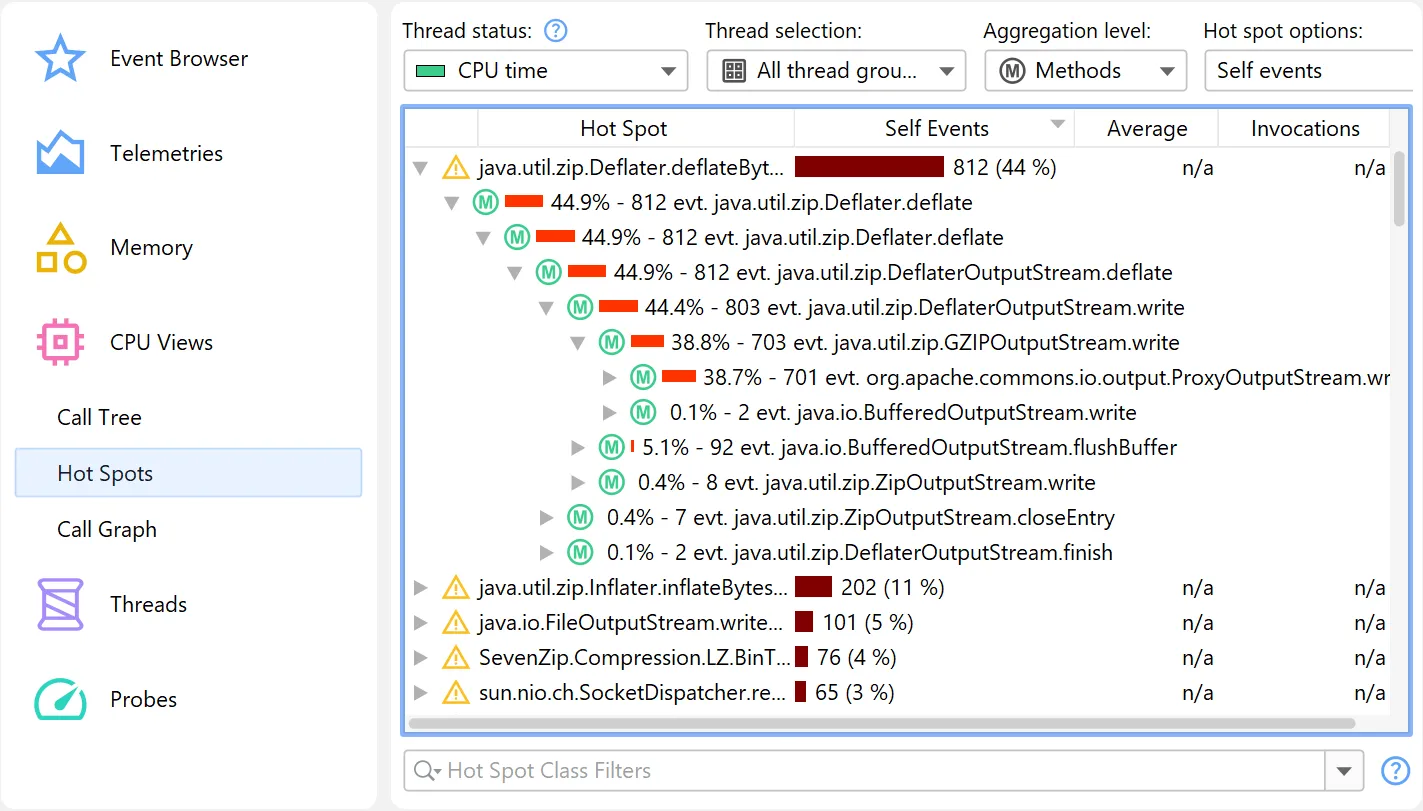
从 JProfiler 16 开始,事件浏览器中现在会显示所有实验性 JFR 事件,例如 jdk.CPUTimeSample 事件。
JProfiler 16 引入了虚拟线程转储支持。
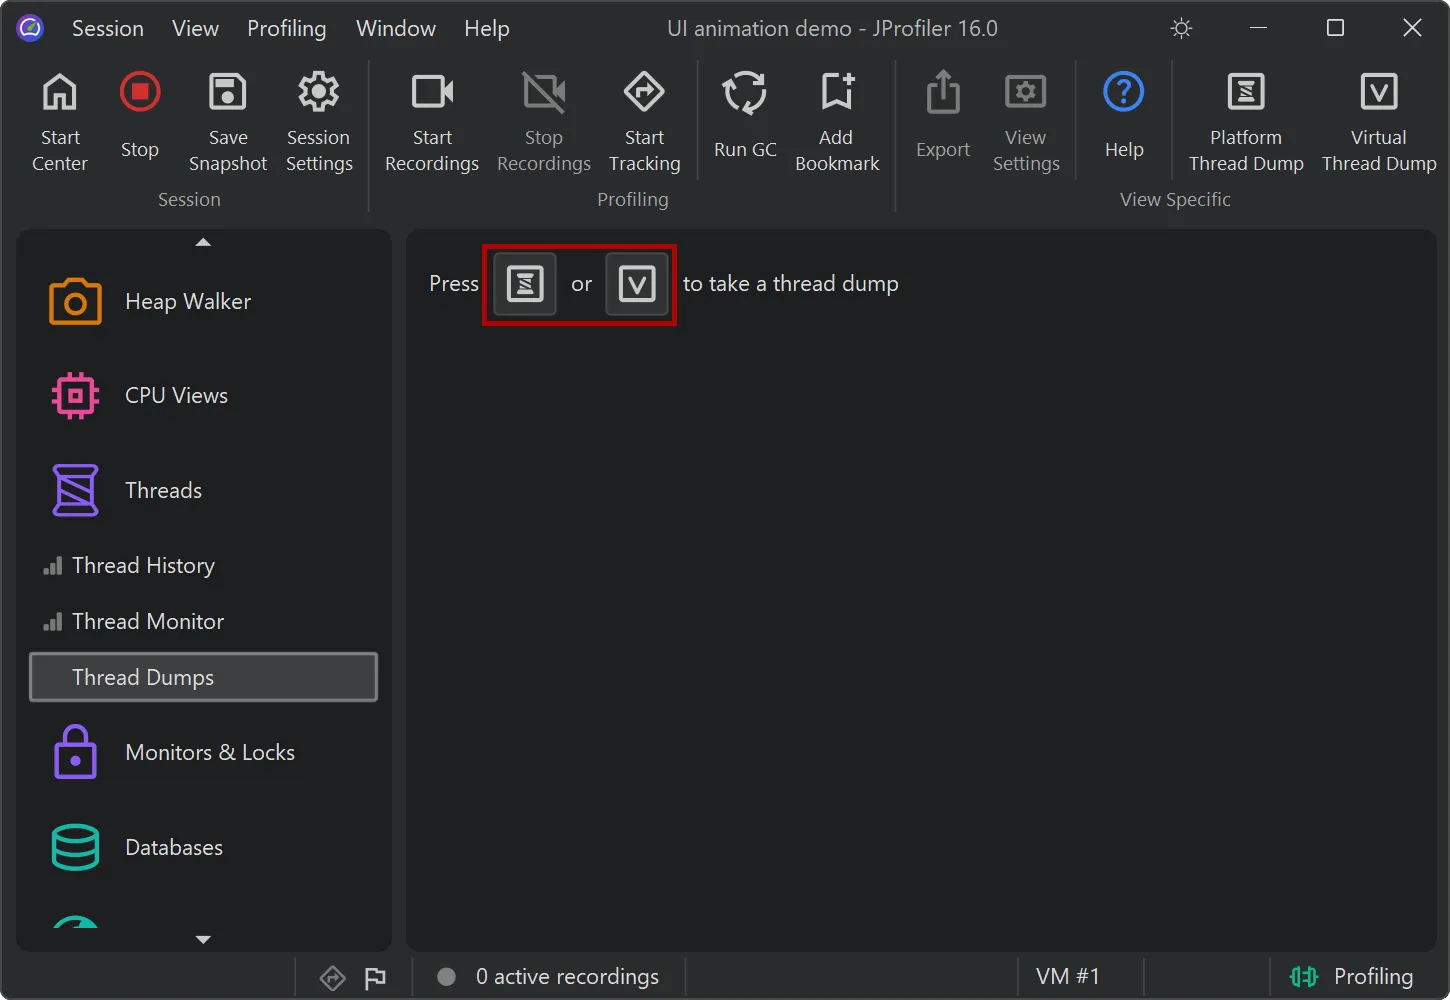
线程转储视图现在提供两个不同的操作:一个用于平台线程转储,另一个用于虚拟线程转储。
虽然虚拟线程转储也包含平台线程,但它是异步执行的,因此在不用虚拟线程时,同步的平台线程转储更为合适。
虚拟线程在其线程容器内按层次结构组织。这在使用结构化并发时尤为重要,截至 Java 25,结构化并发仍是预览特性。
在结构化并发中,每个作用域都会创建相应的线程容器。由于一次转储可能包含深层嵌套容器中的数百万个虚拟线程,虚拟线程转储可能会比平台线程转储大得多。
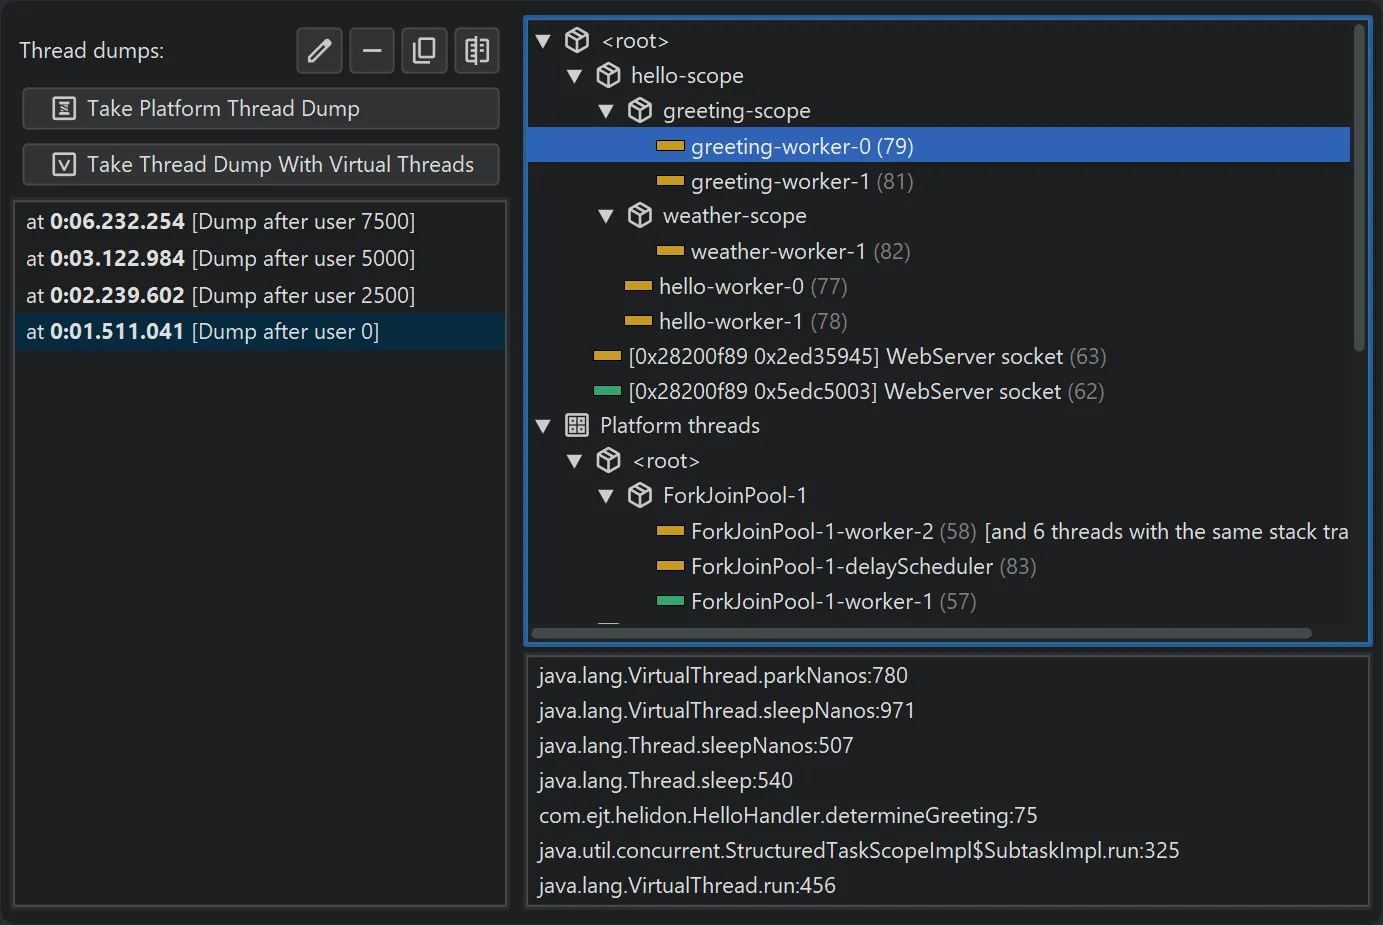
选中两个单独的虚拟线程或两个完整的线程转储,然后在上下文菜单中选择比较操作,即可对它们进行比较。
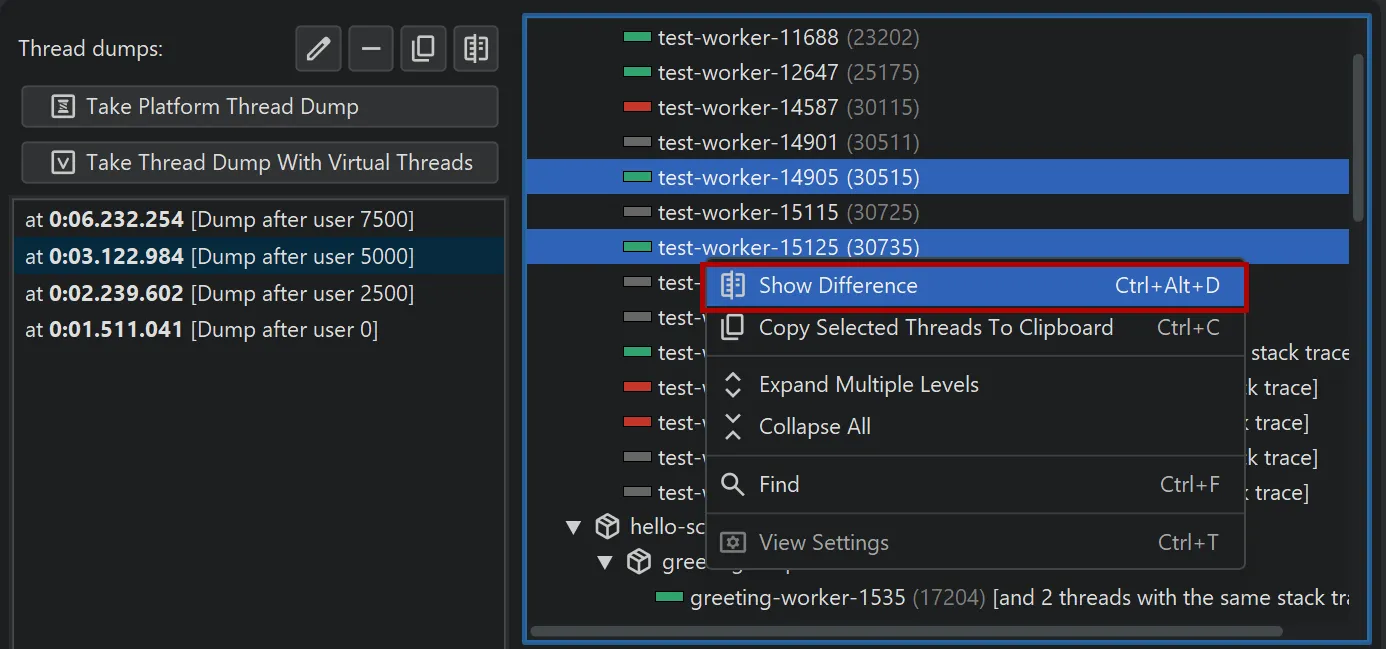
比较结果显示在单独窗口的差异查看器中。
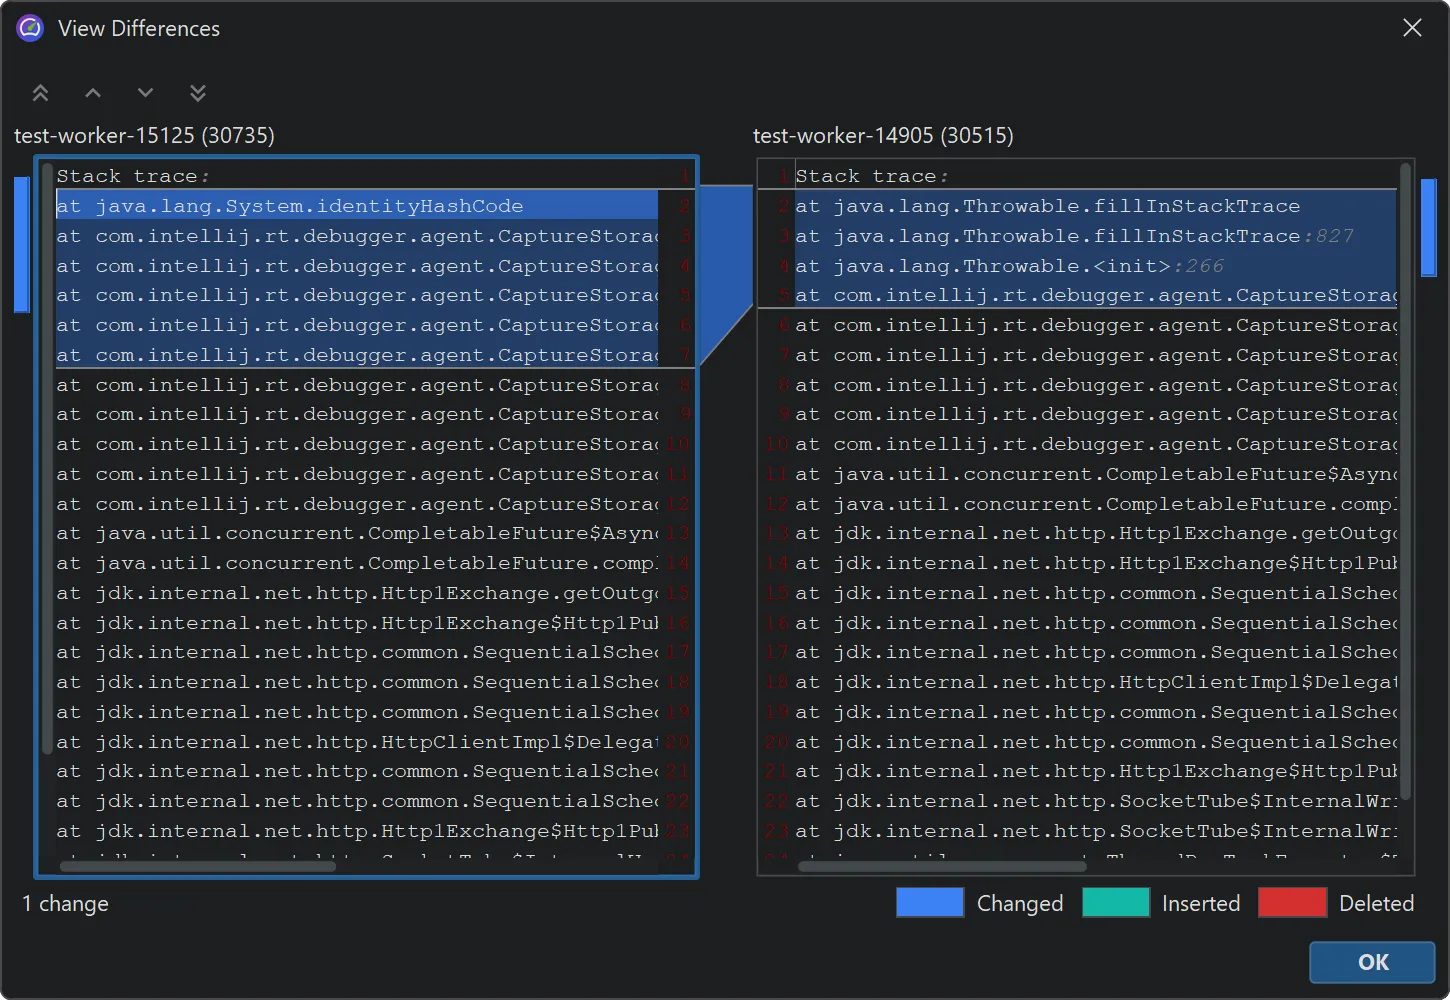
要将单个线程、多个线程或整个线程转储复制到剪贴板,请使用上下文菜单中的相应操作。
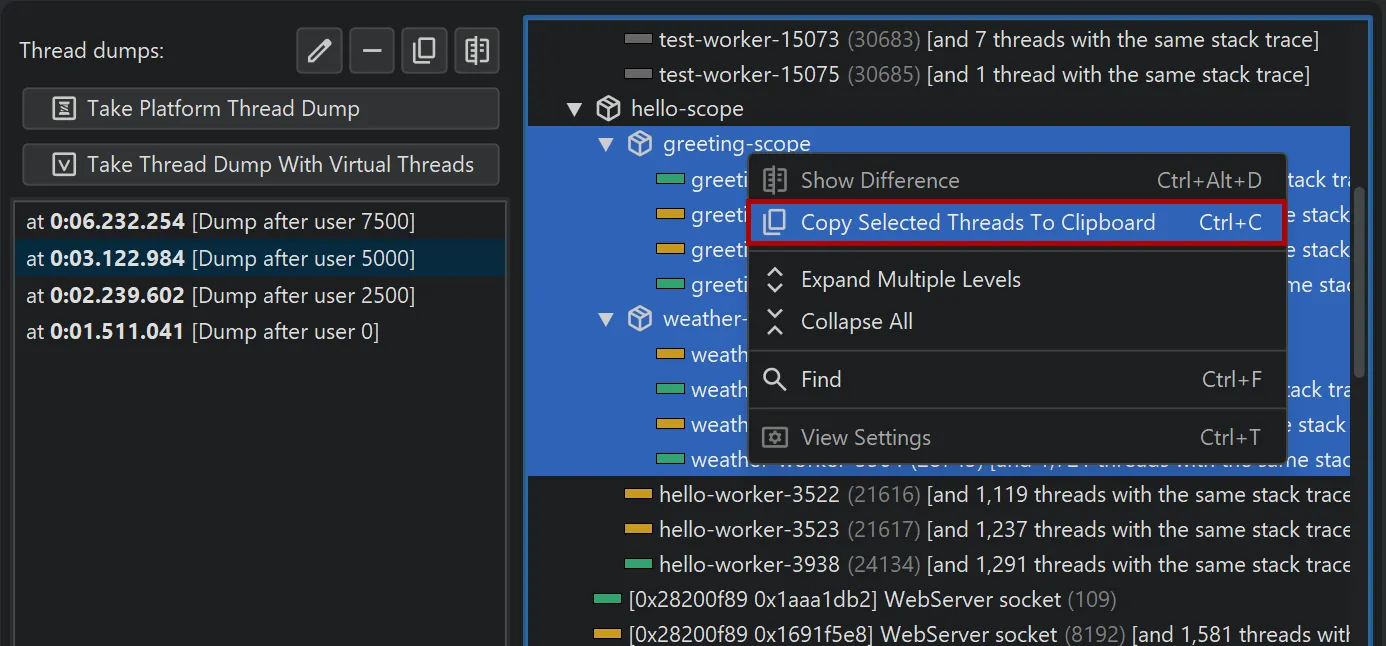
虚拟线程转储会将处于相同层次位置且具有相同堆栈跟踪的线程分组为单个节点。
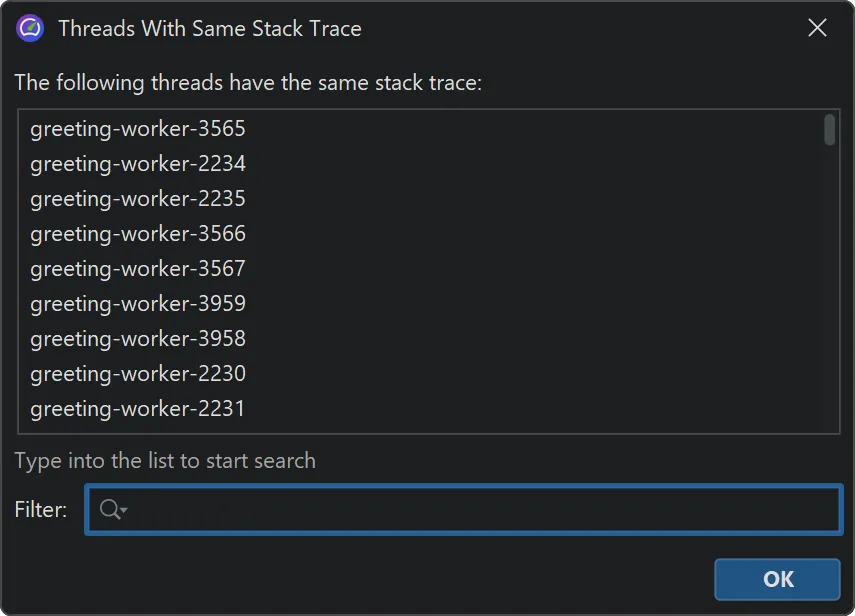
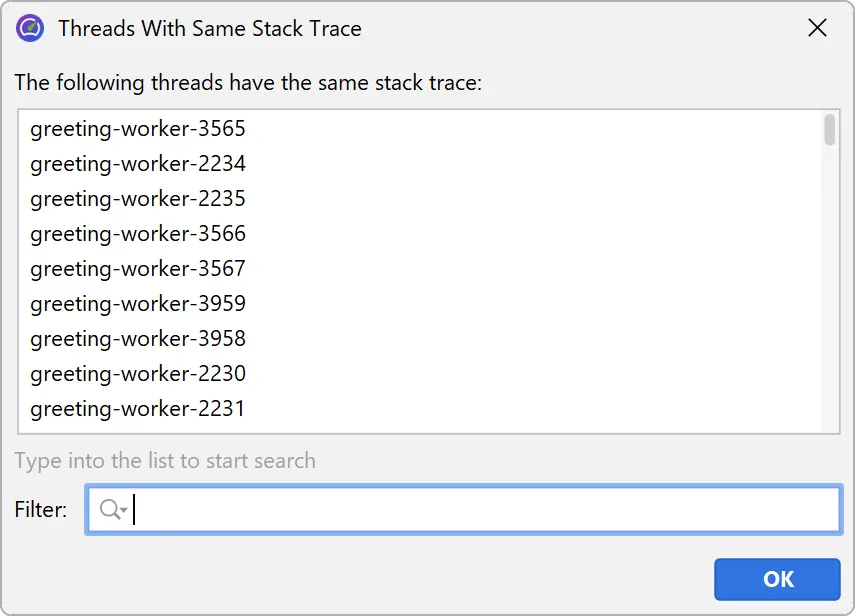
上下文菜单中提供了显示所有分组线程名称的操作。
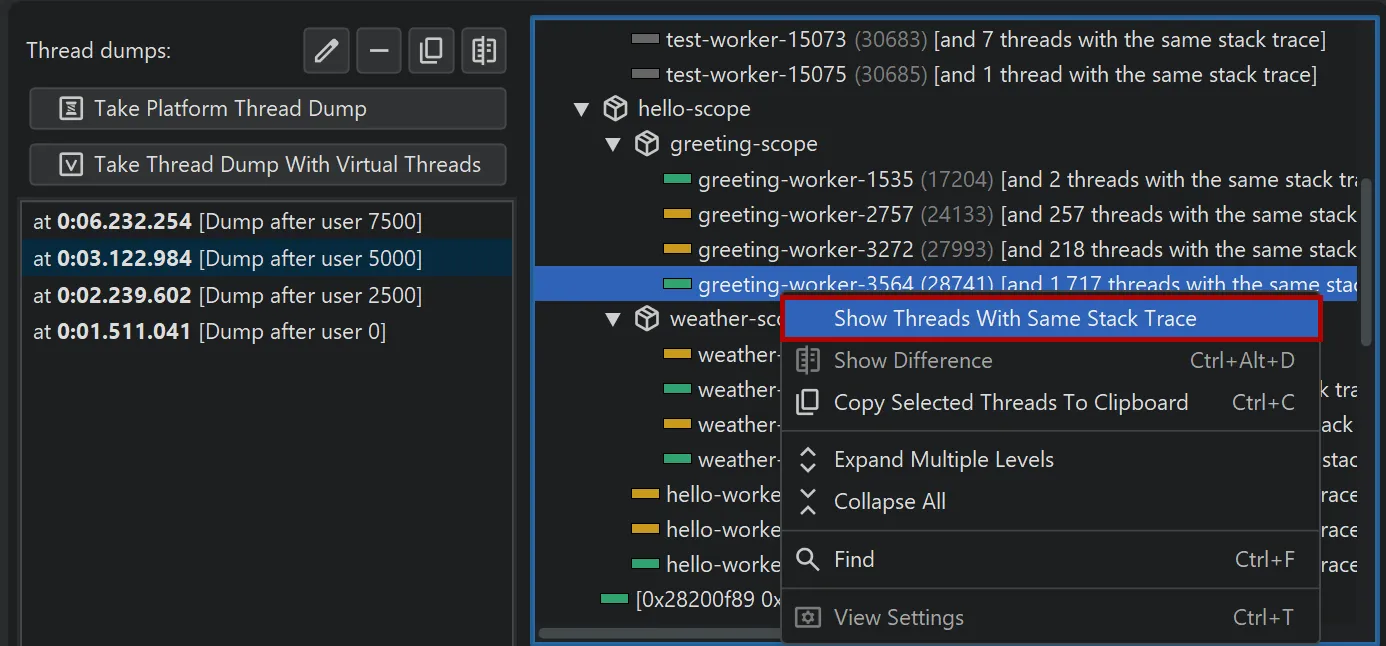
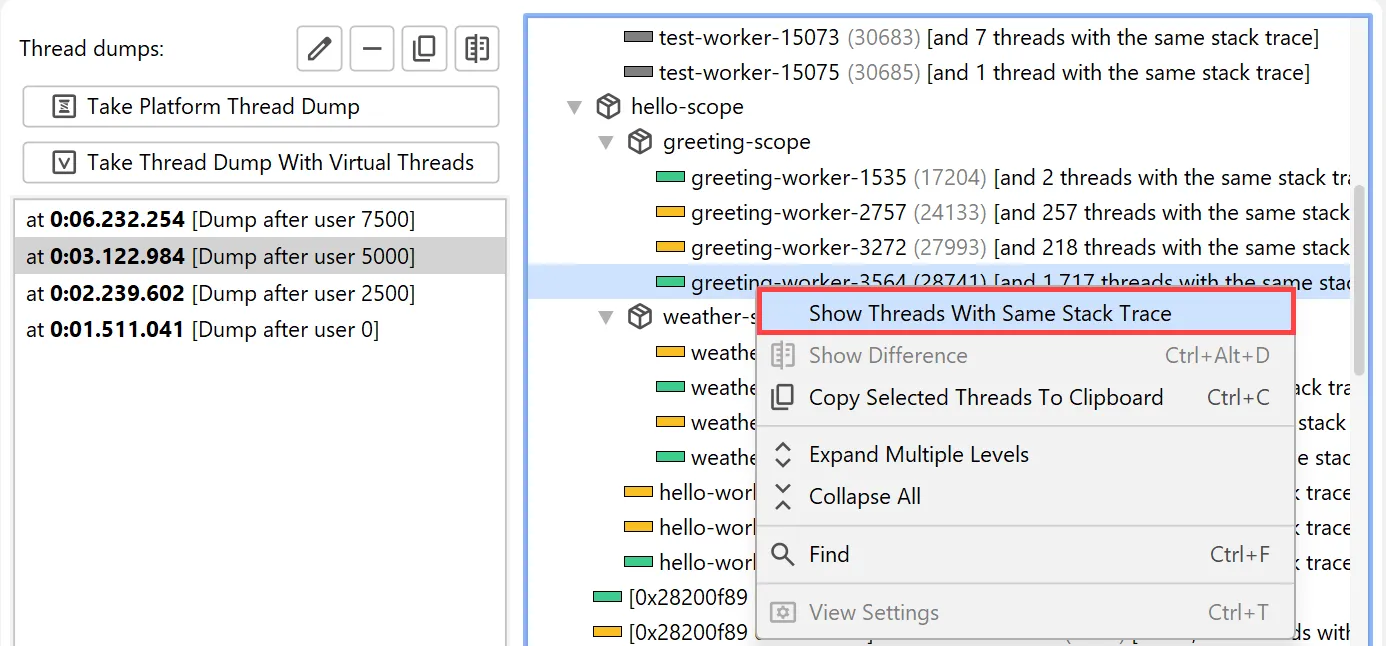
分组线程的名称显示在单独的窗口中,您可以在其中过滤出感兴趣的线程名称。
平台线程转储同样支持线程分组。
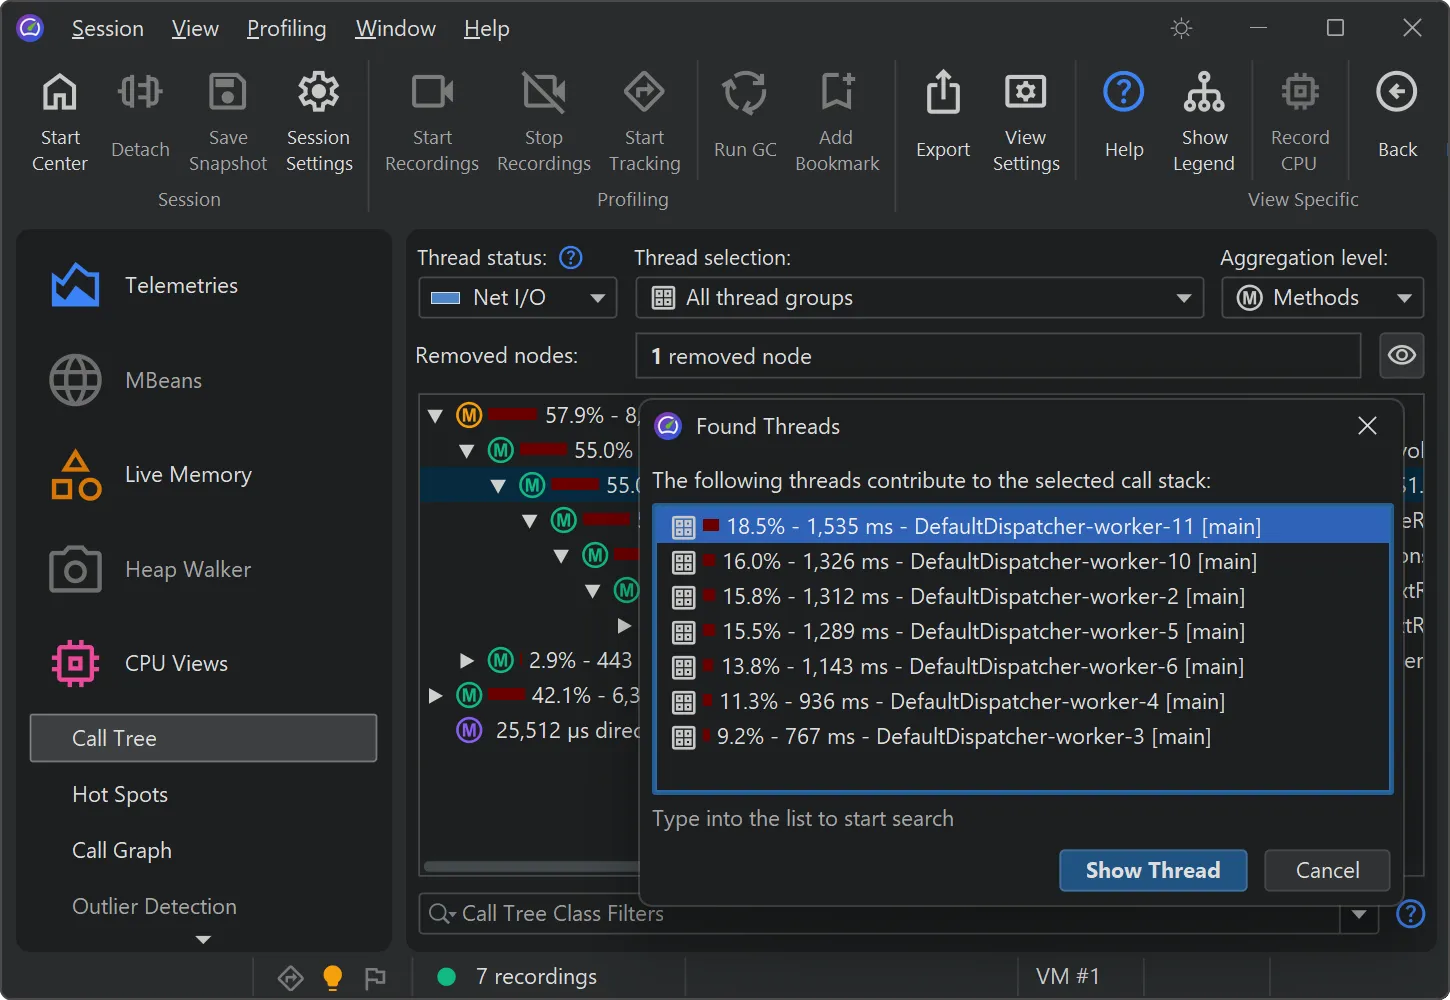
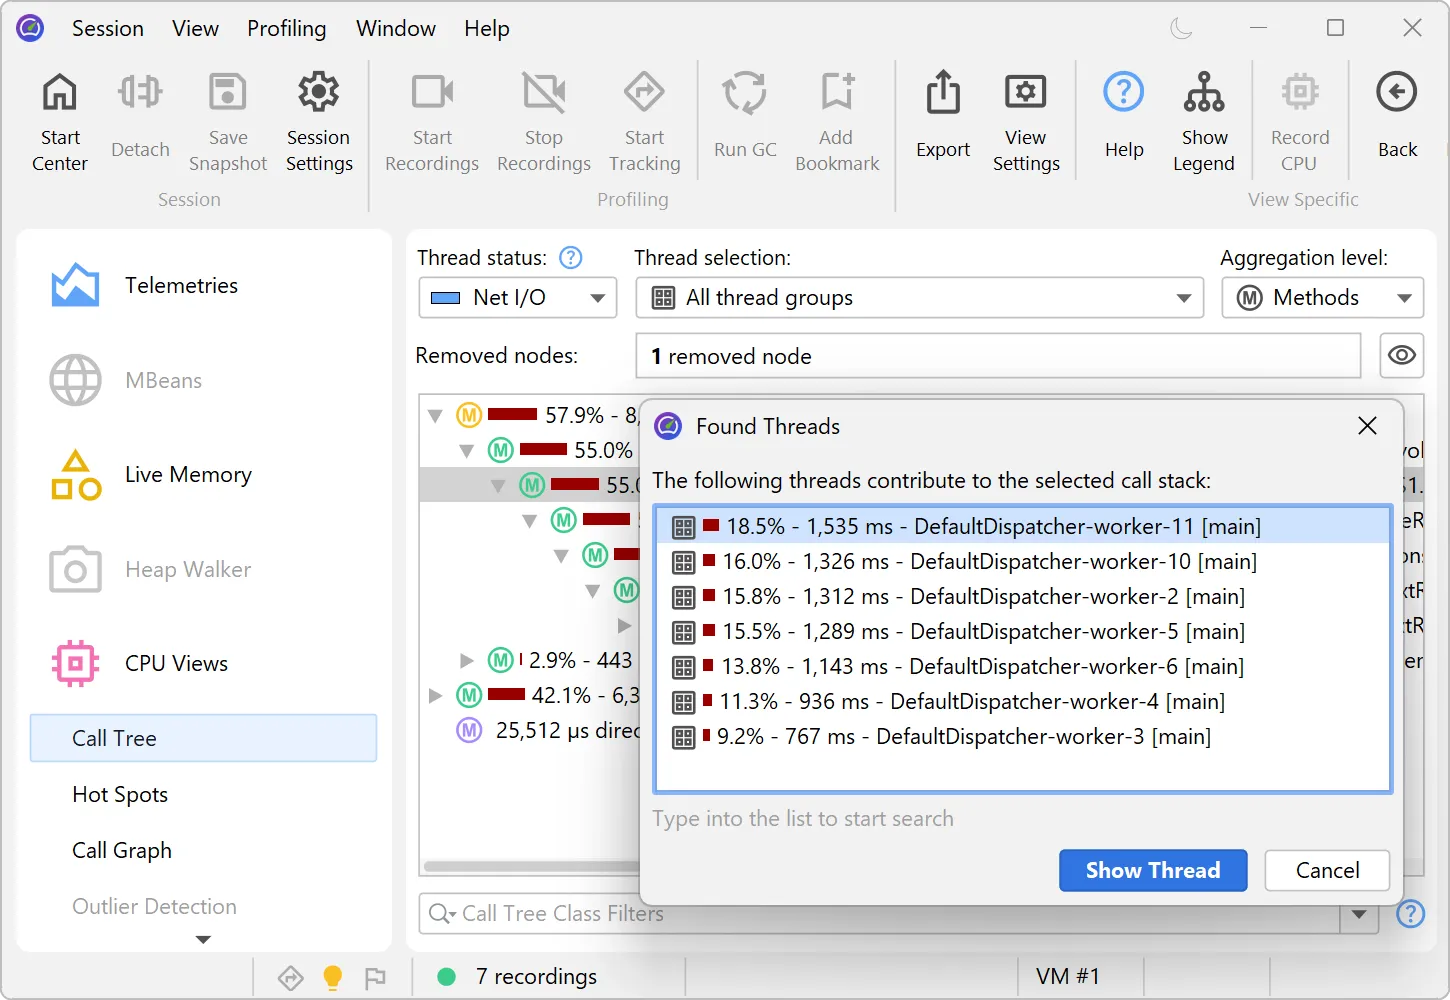
现在,您可以分析单个线程在累积调用树中的贡献。在调用树视图中,从上下文菜单选择“显示线程”,即可为选定节点计算该数据。
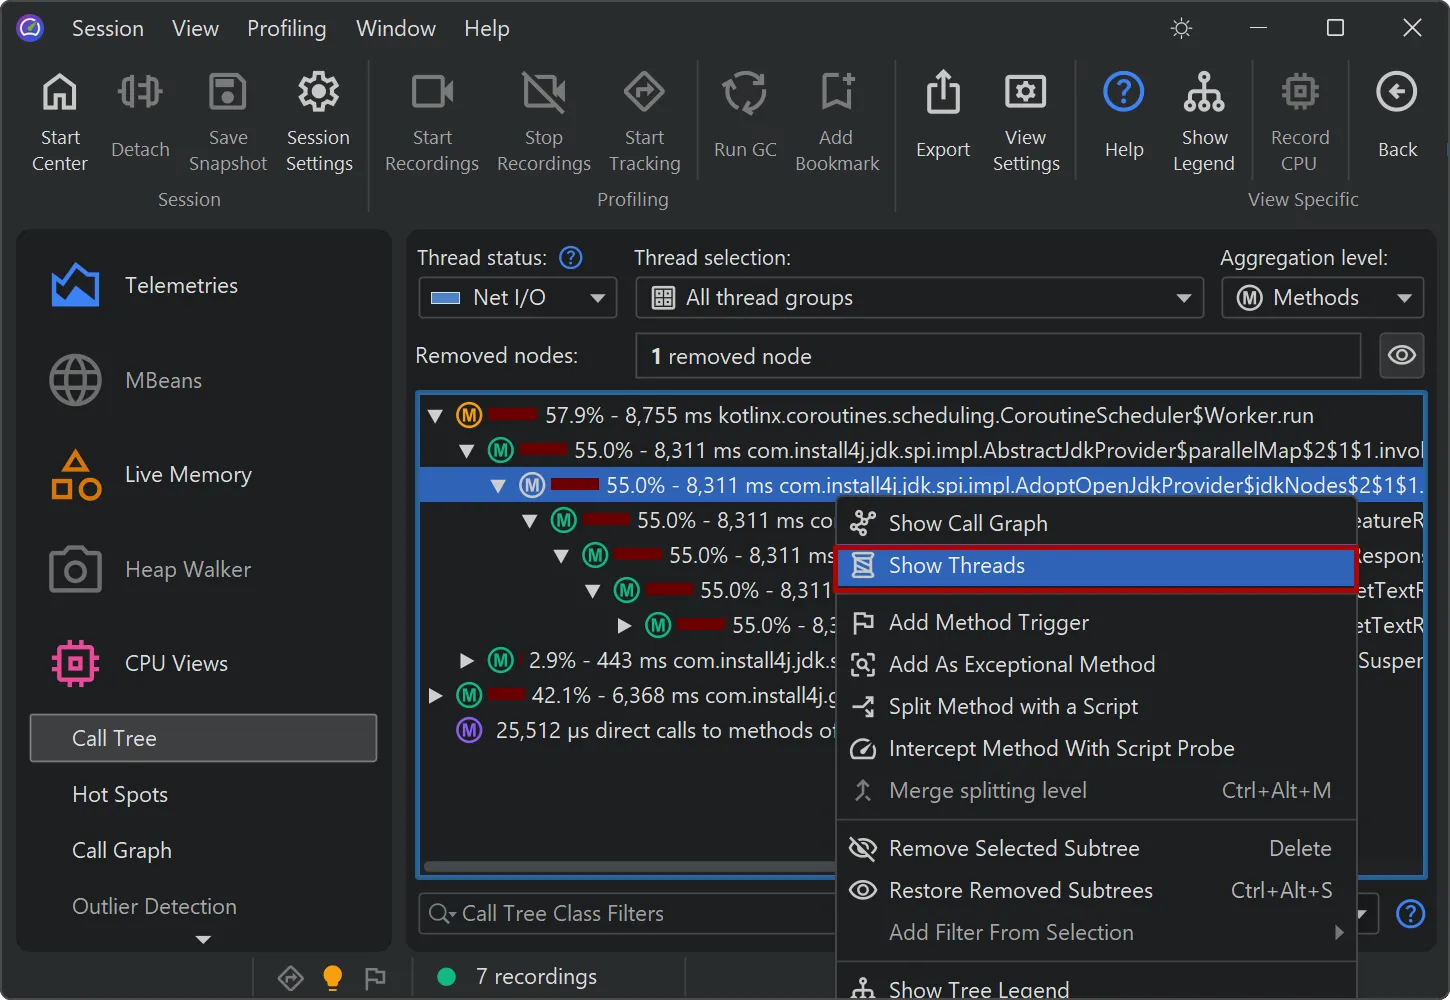
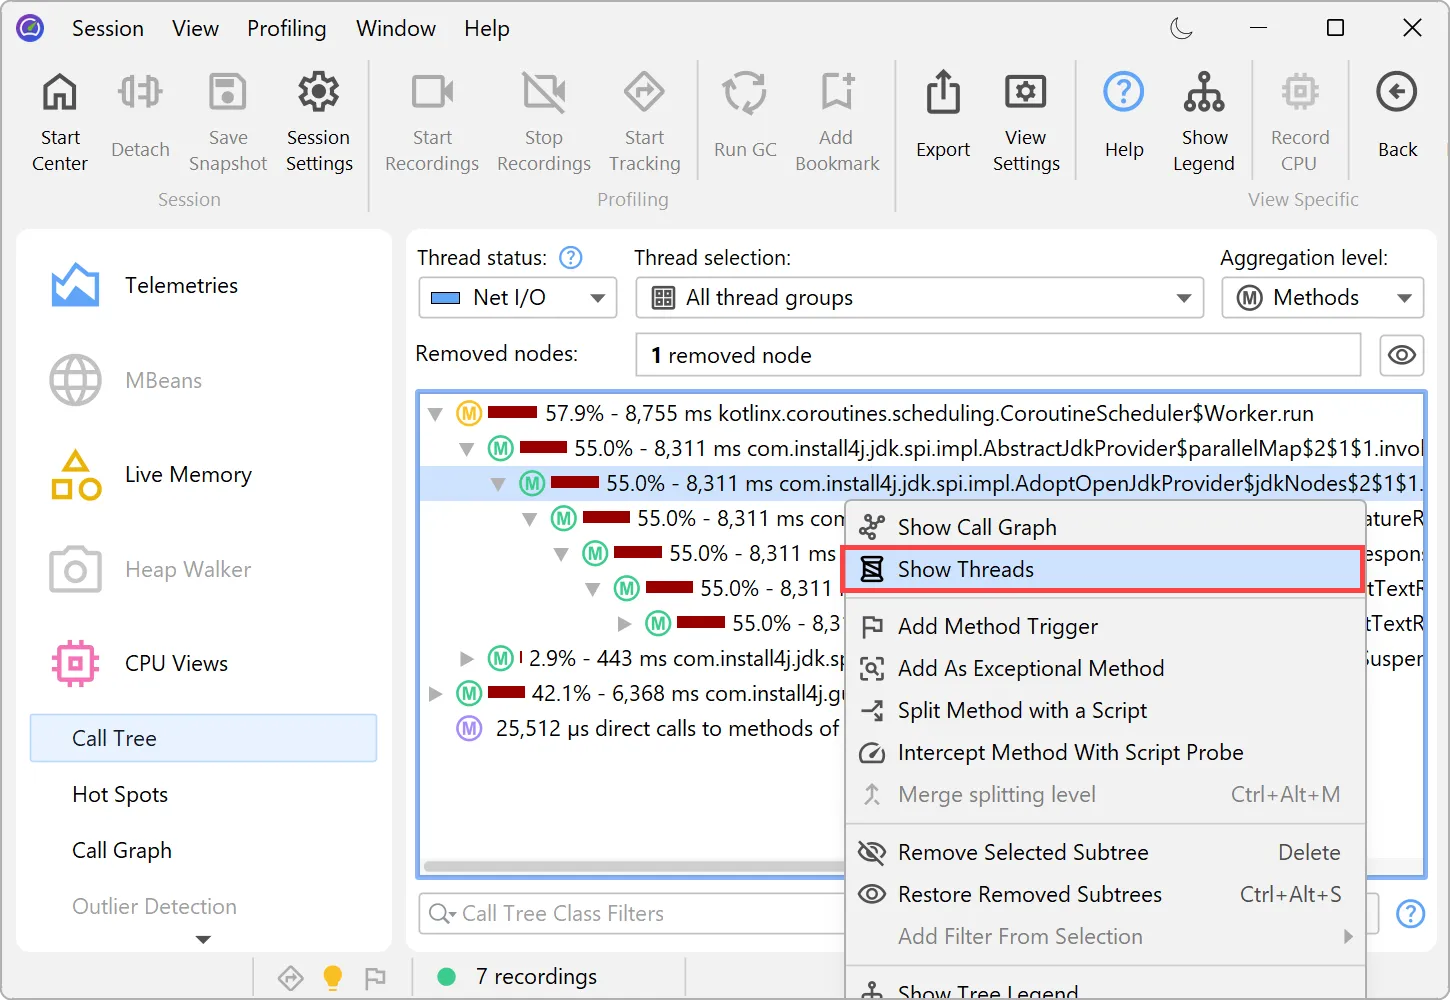
随后会显示一个单独的对话框,其中列出所有相关线程的百分比细分。您还可以选中某个线程,并在调用树视图中切换到该线程的调用树。
该功能有助于定位特定线程的性能问题。例如,您可能需要从线程池中隔离出行为异常的线程。
节点详细信息对话框得到了多方面的改进。
节点详细信息对话框是查看选定元素更多信息的常用工具,可从“视图”菜单或上下文菜单打开。
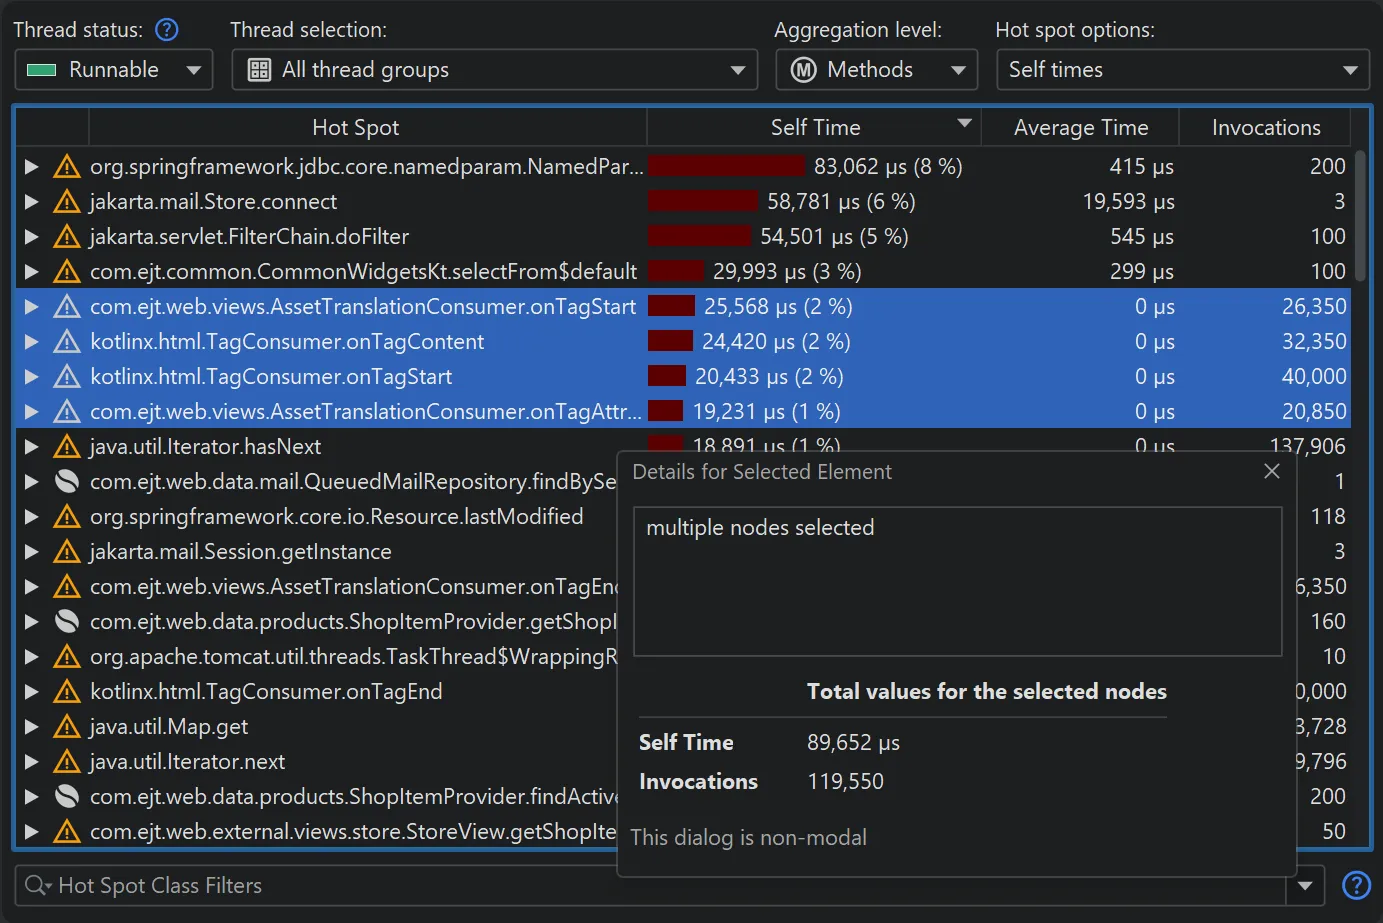
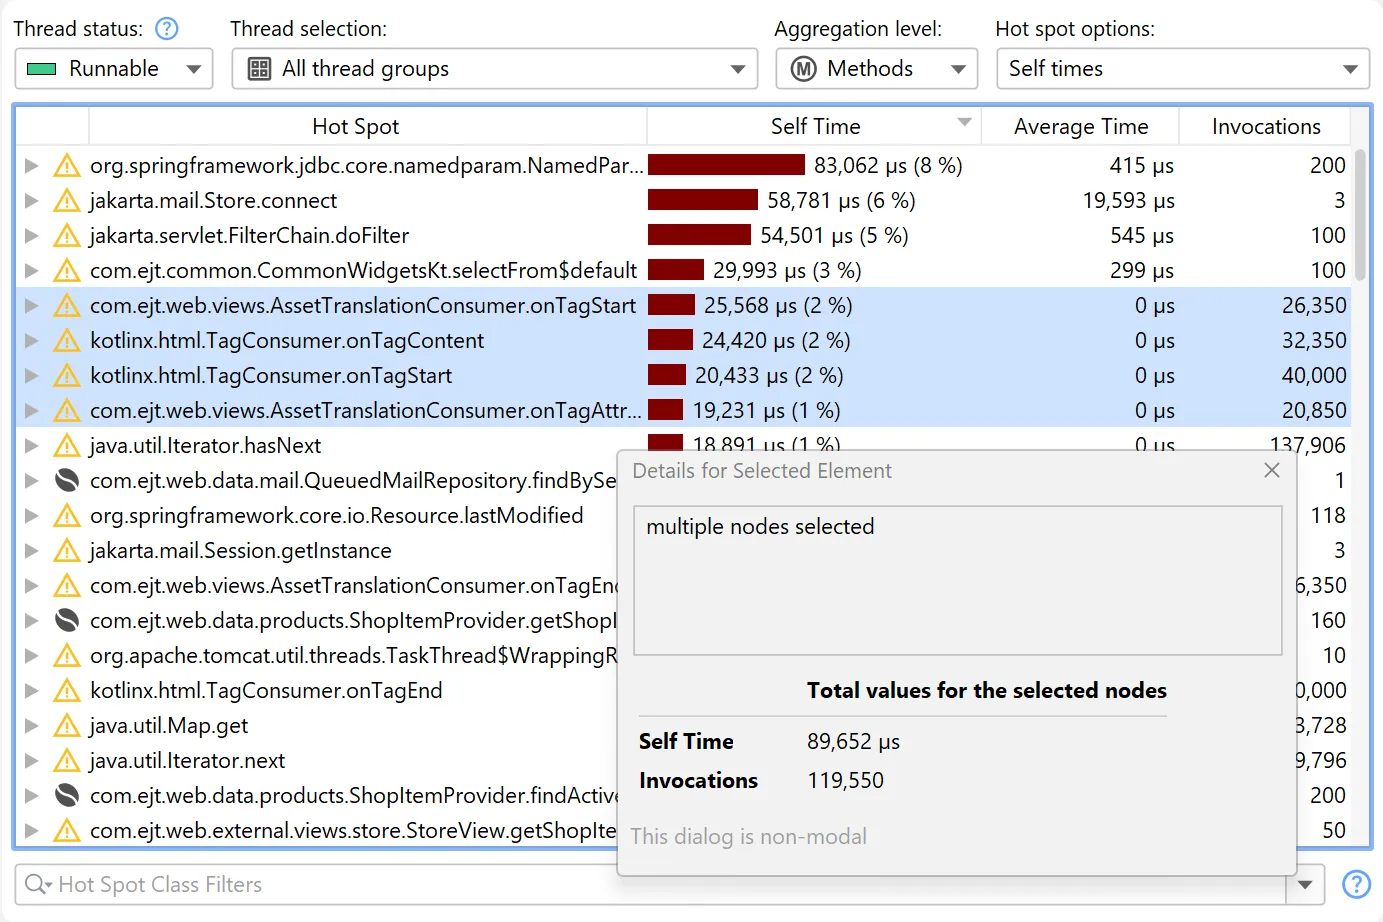
在热点视图中选中多个节点时,现在会显示所选内容的累积统计信息。
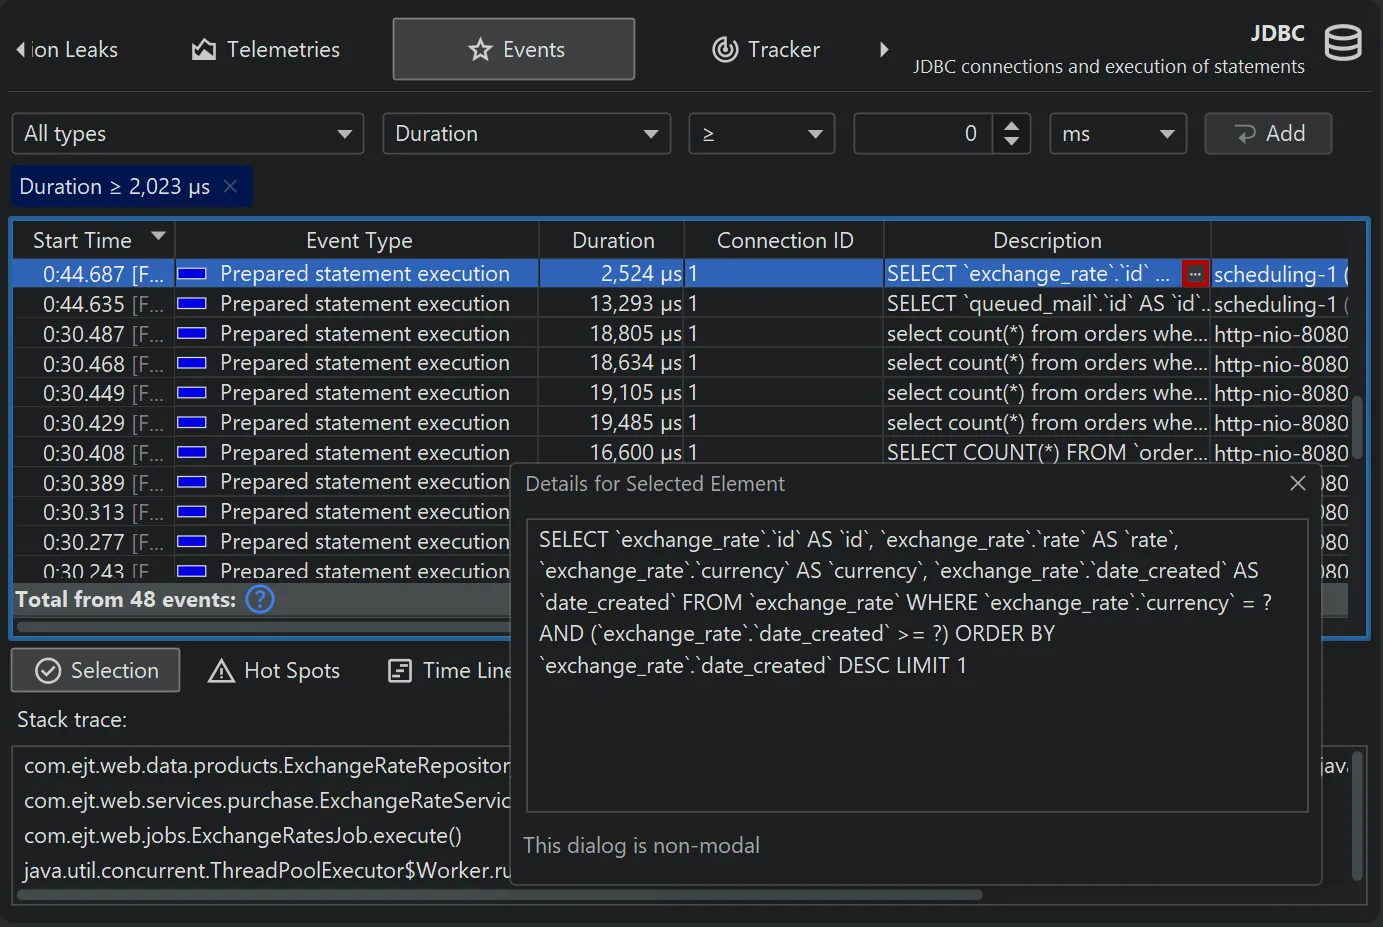
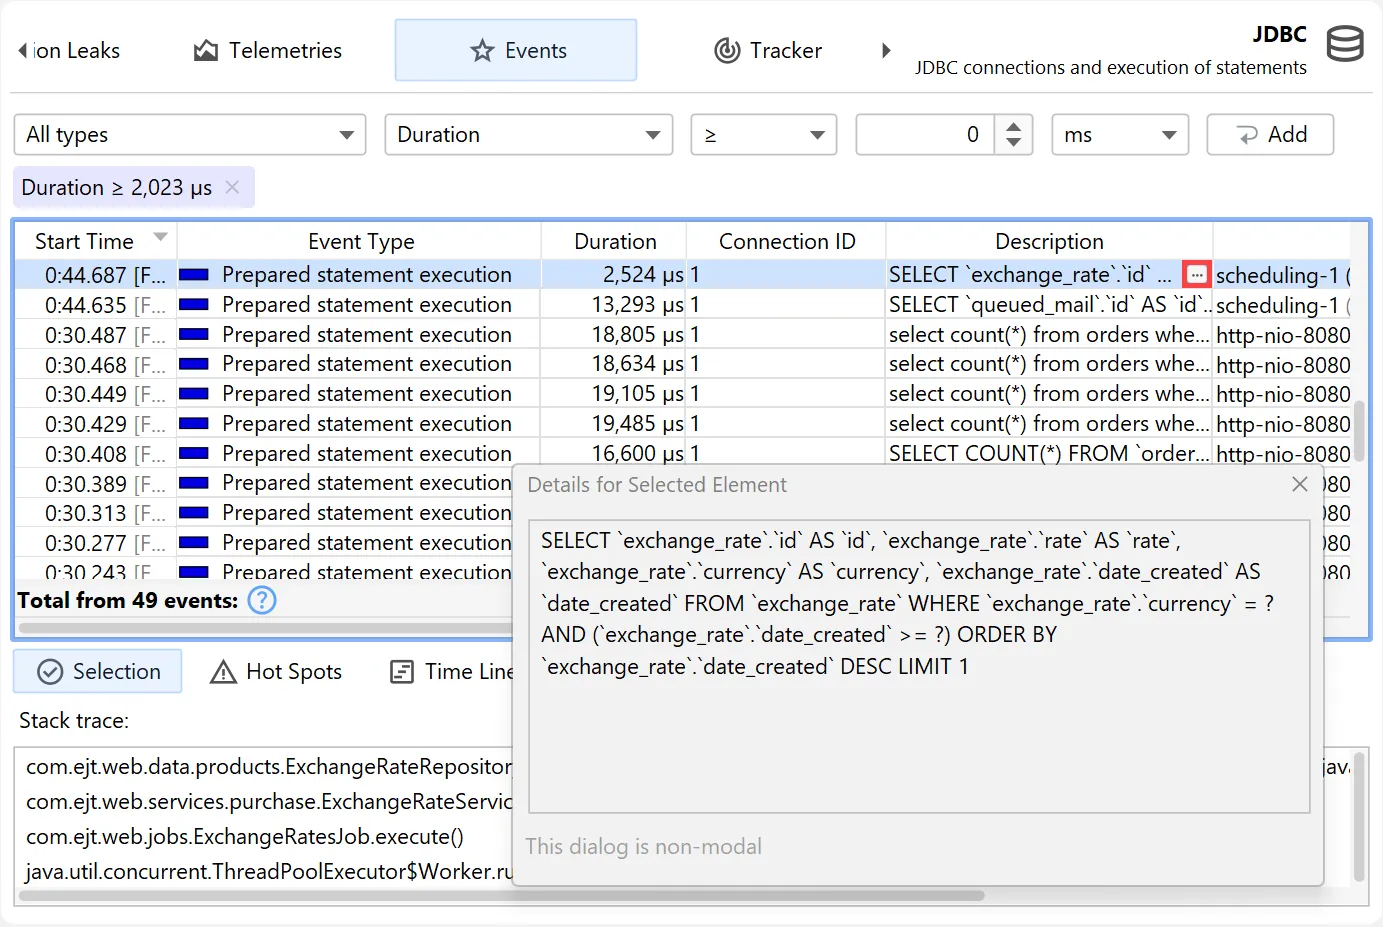
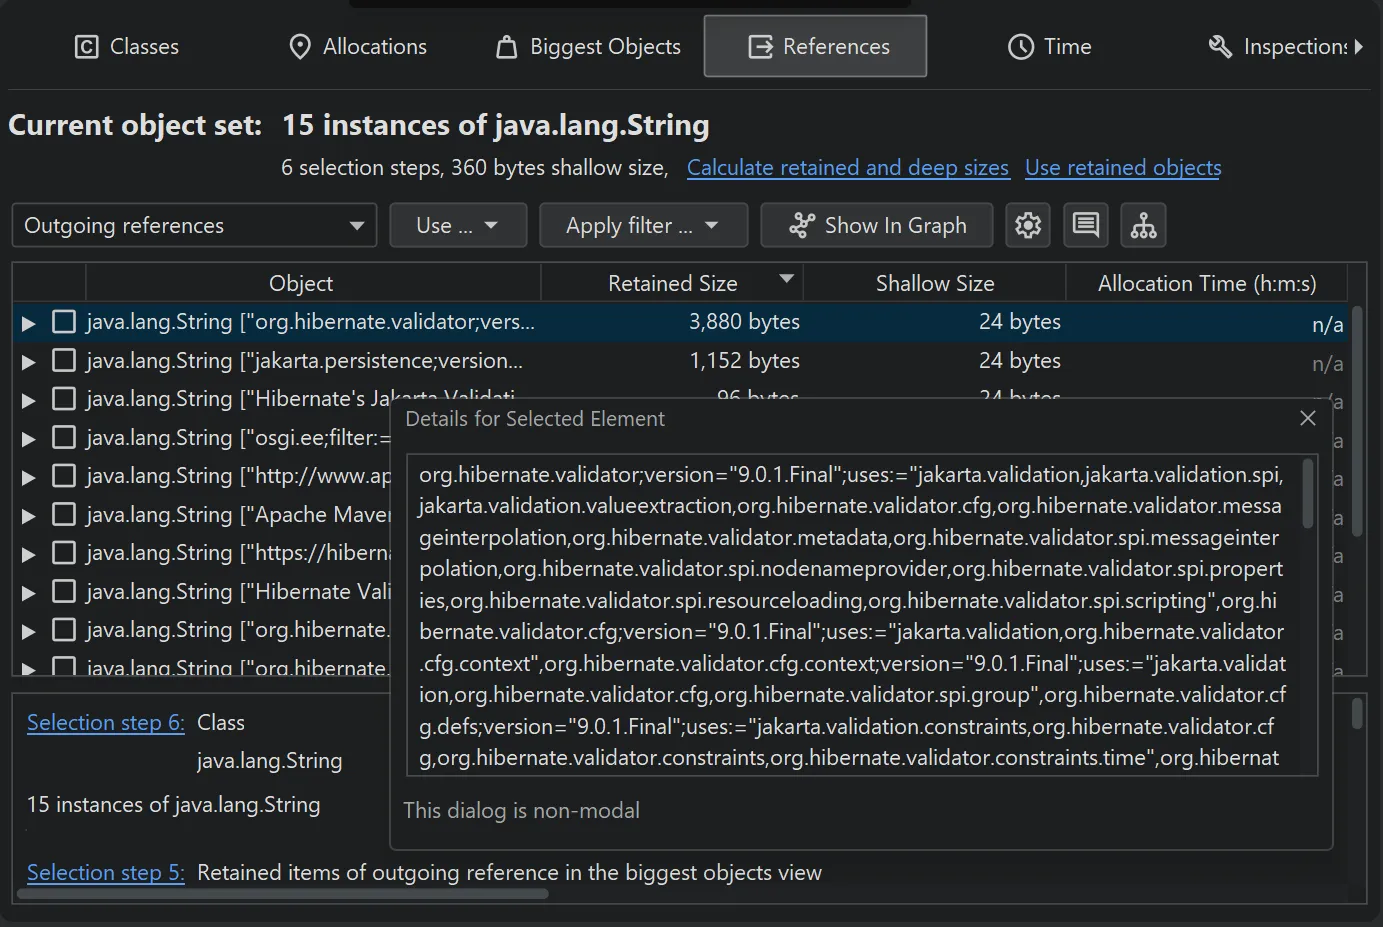
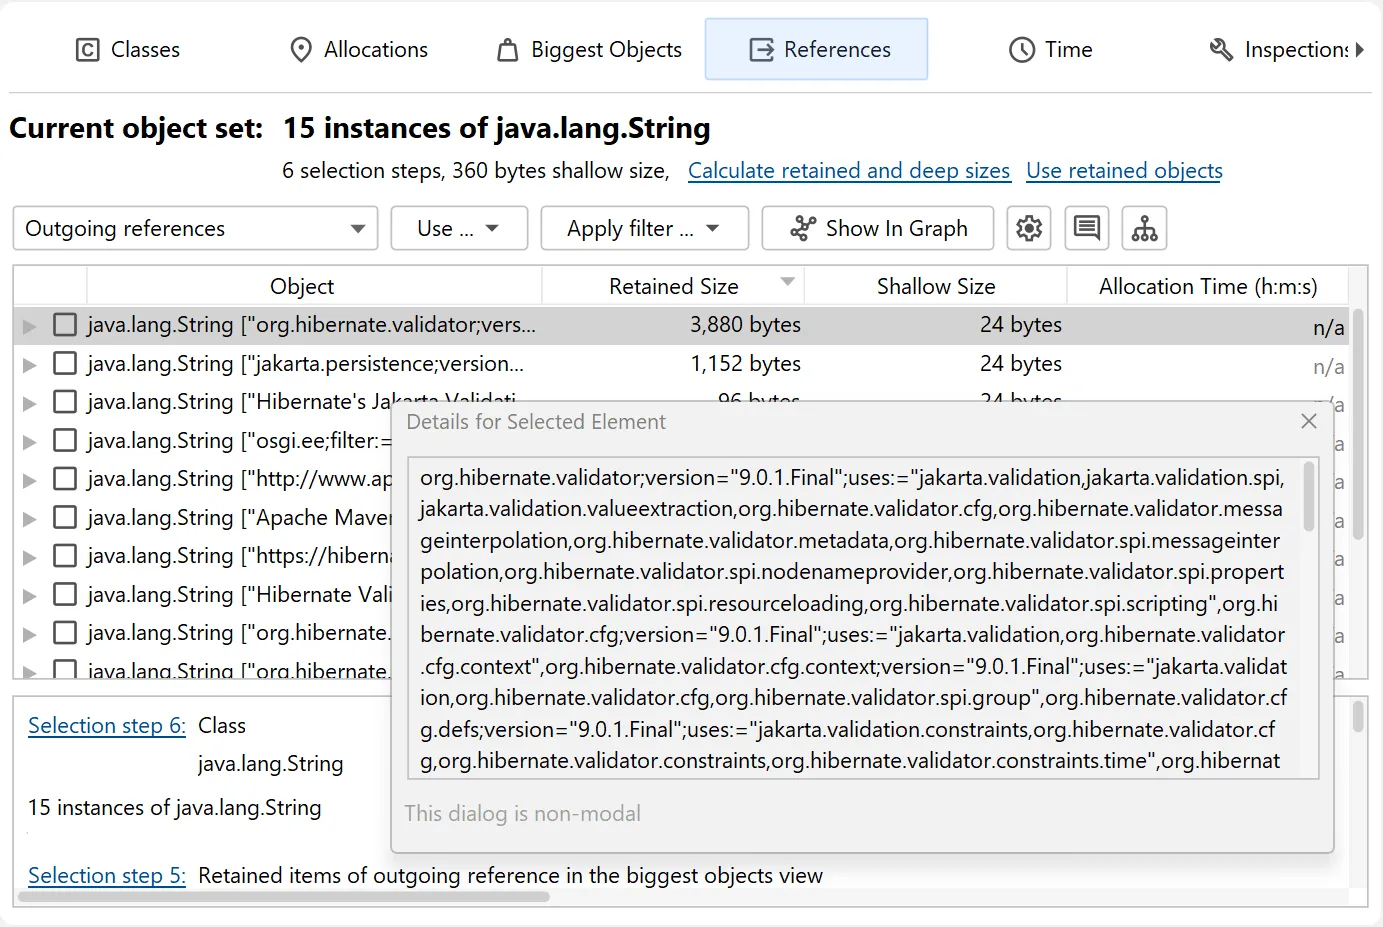
JProfiler 中的许多表格都有包含长文本、超出列宽的列。在这种情况下,节点详细信息对话框会显示完整文本。从 JProfiler 16 开始,新增了一个悬停按钮,可以直接打开节点详细信息对话框;如果表格中存在多个长文本列,它还会激活正确的选项卡。
在堆遍历器中,节点详细信息对话框现在会显示引用视图中字符串值的完整内容,而不仅仅是显示时被截断的预览字符串。
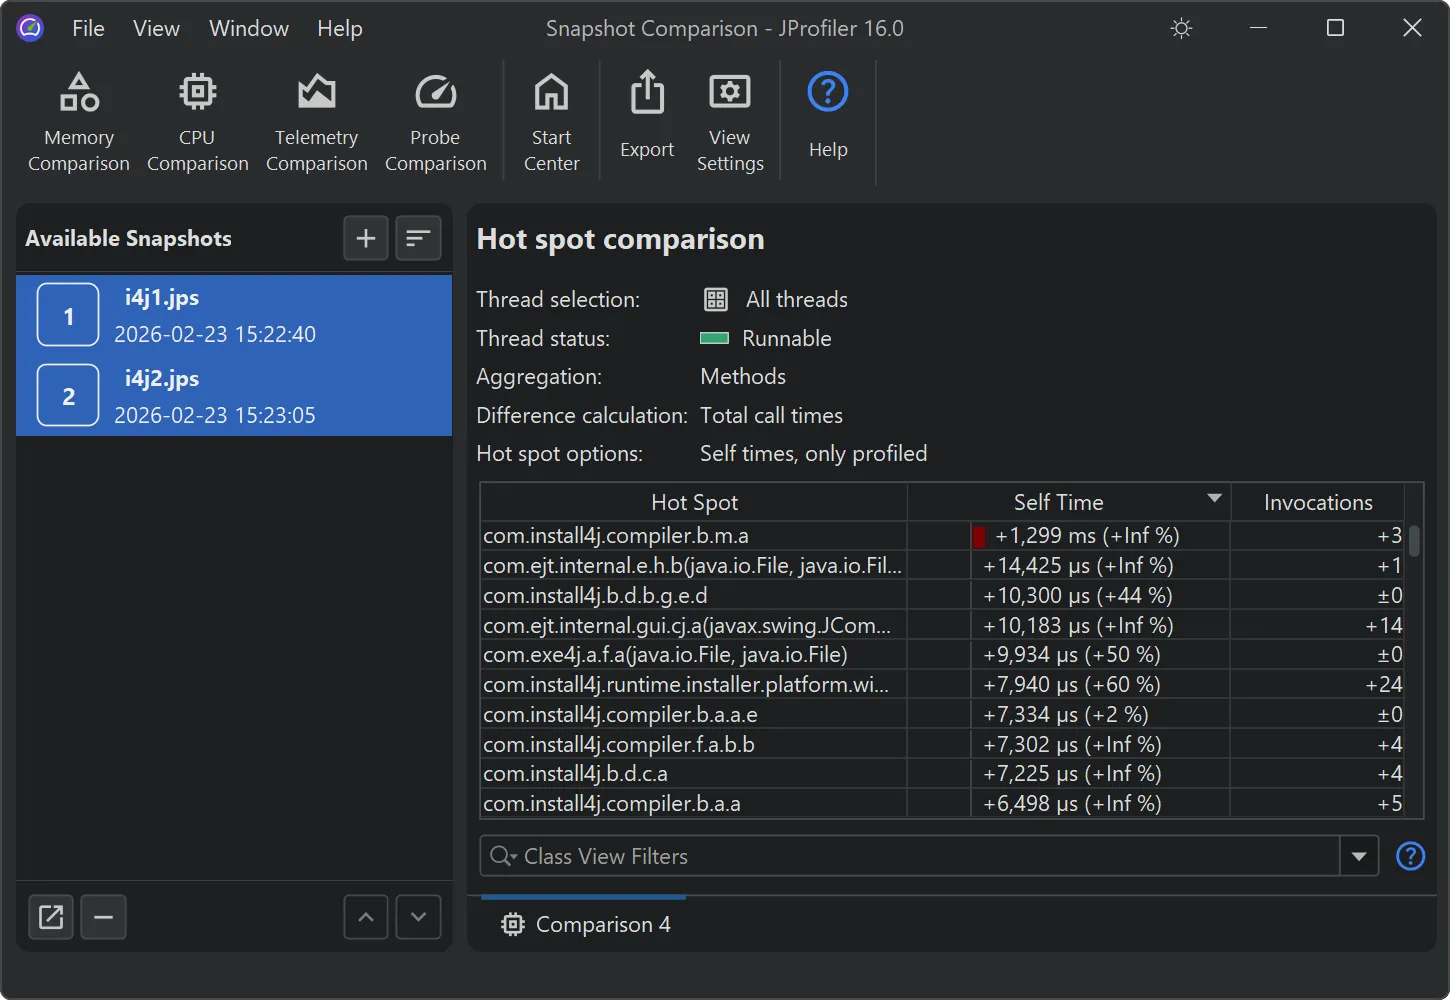
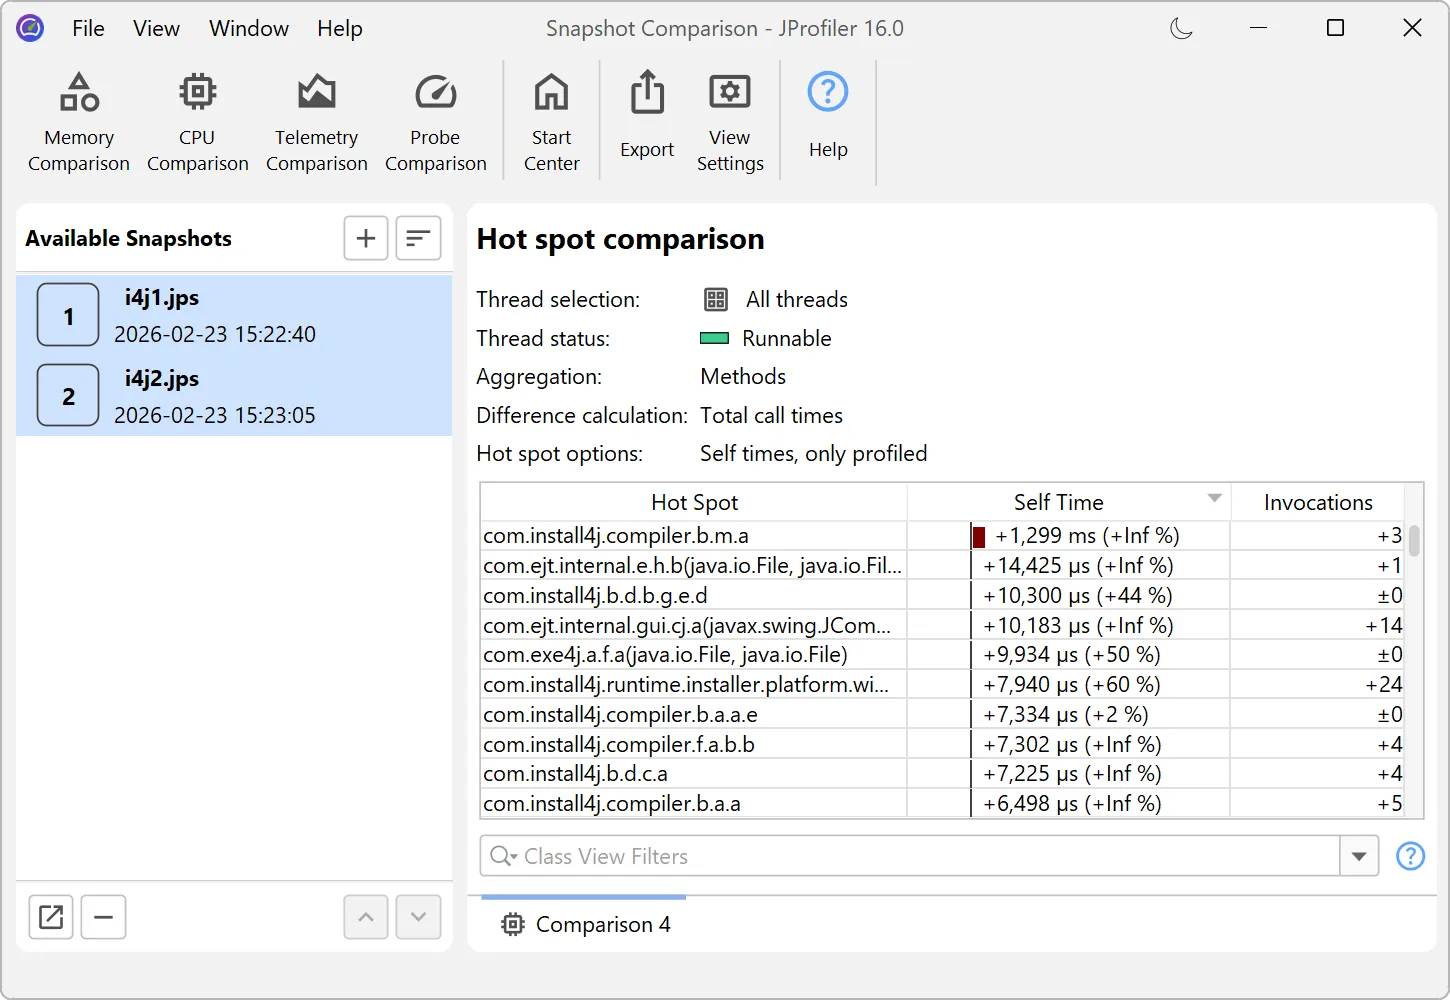
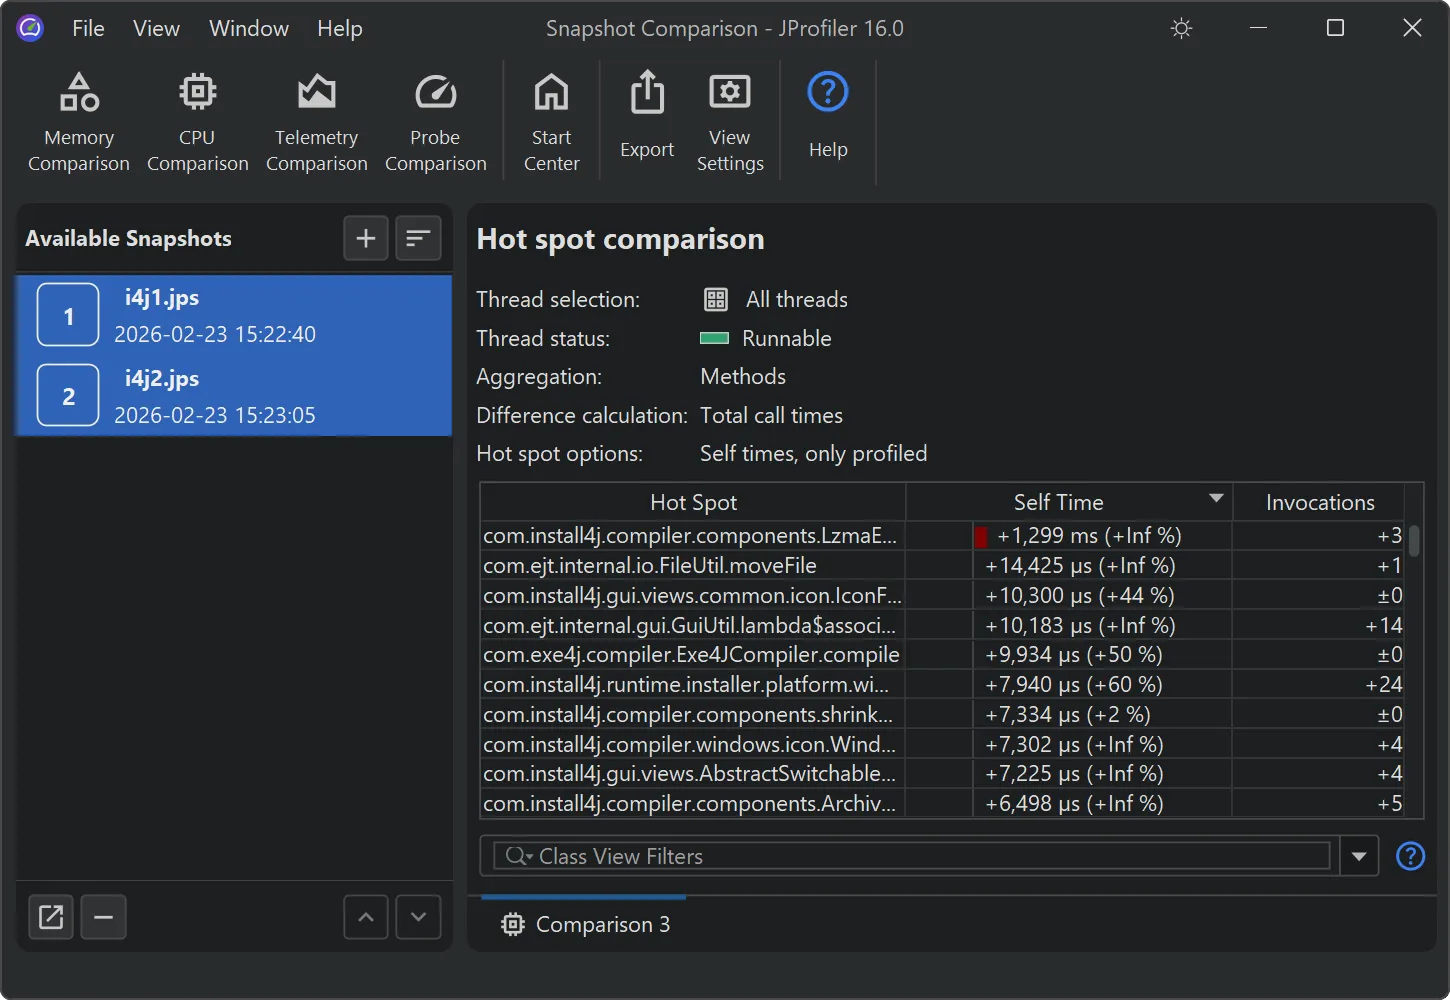
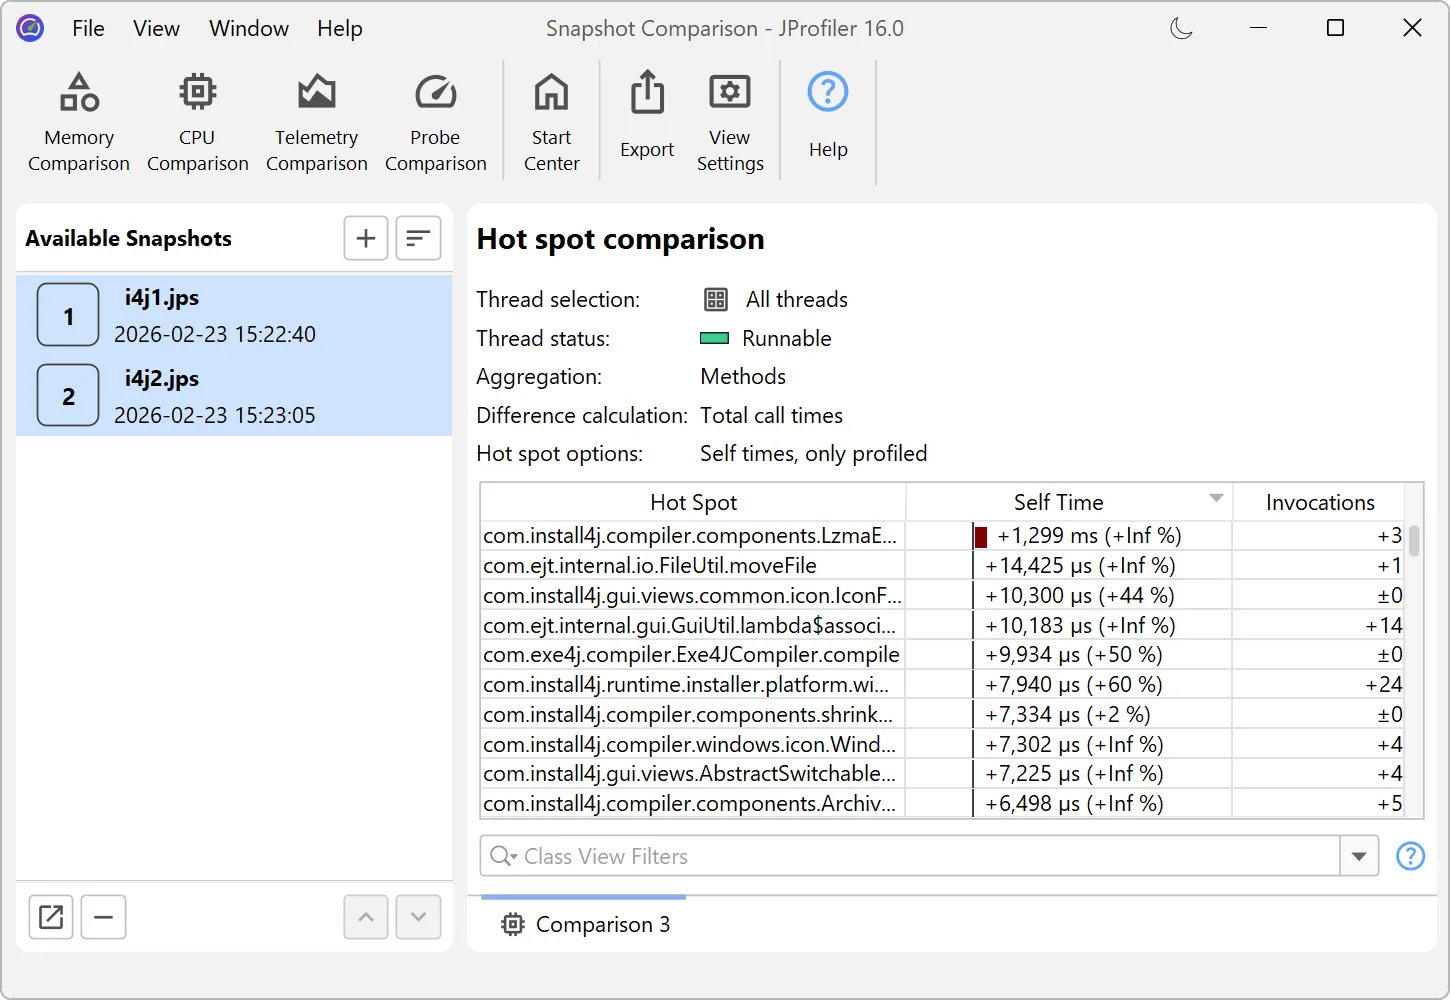
JProfiler 现在支持快照比较的反混淆。
以前,在比较来自经过混淆的应用程序的快照时,无法对类和方法进行反混淆。下方展示了使用混淆名称进行比较的示例。
与打开快照时已有的反混淆支持类似,在向比较窗口添加快照时,文件选择器现在包含一个“反混淆”复选框。
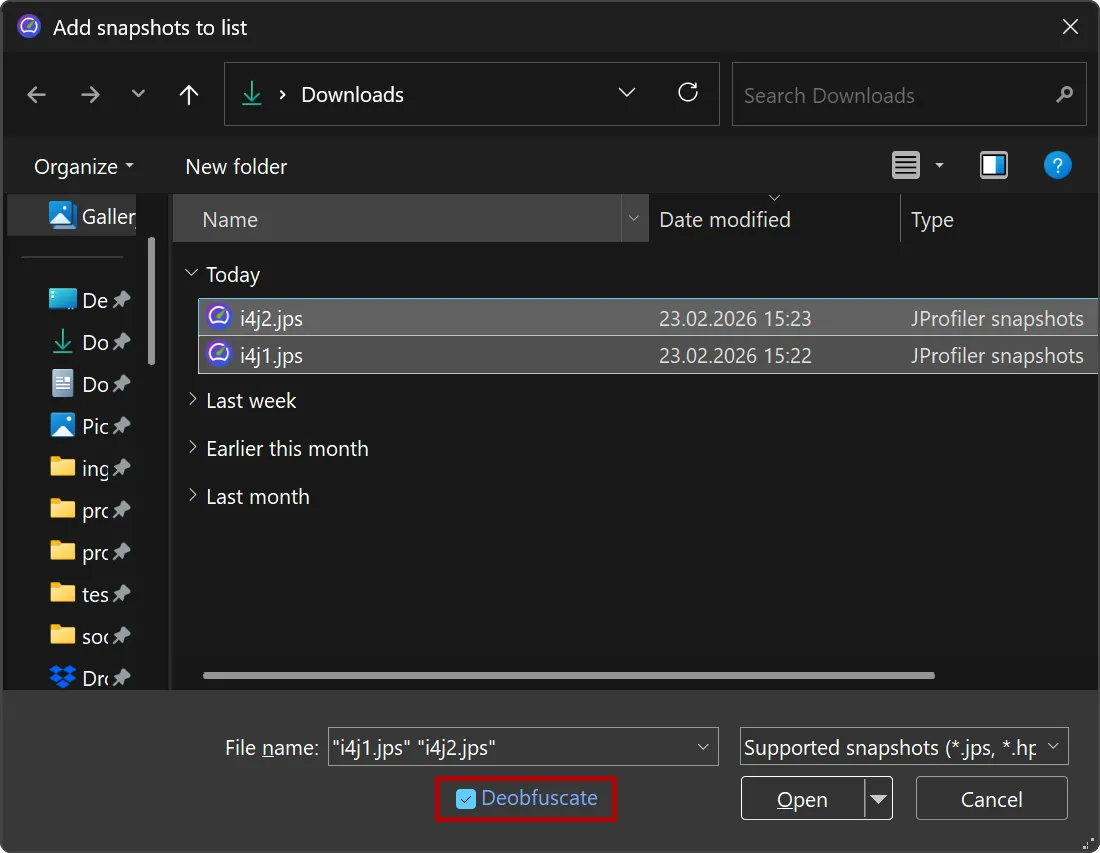
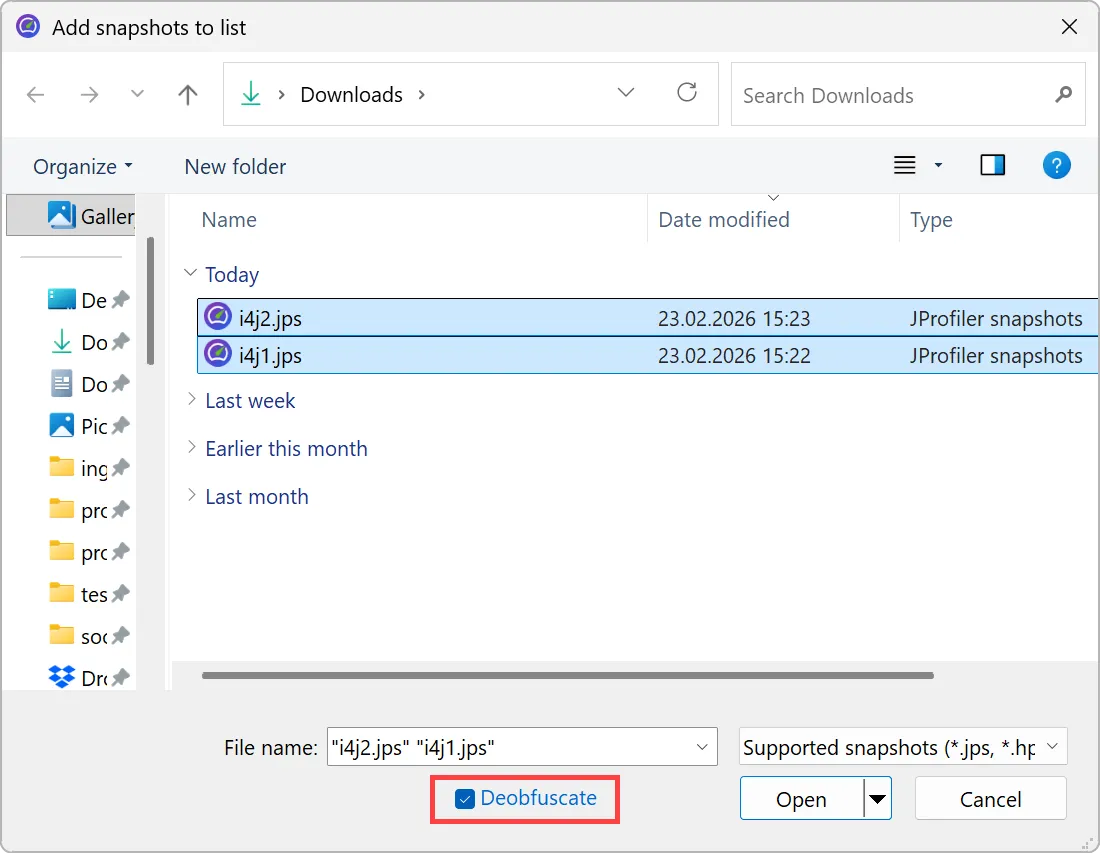
勾选该复选框后,会出现一个对话框,其中包含所支持混淆器的下拉列表以及映射文件路径输入框。
如果不同的快照文件使用不同的映射文件,您可以逐个添加快照。
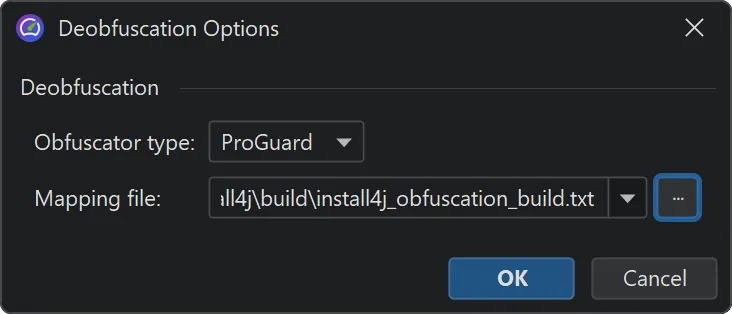
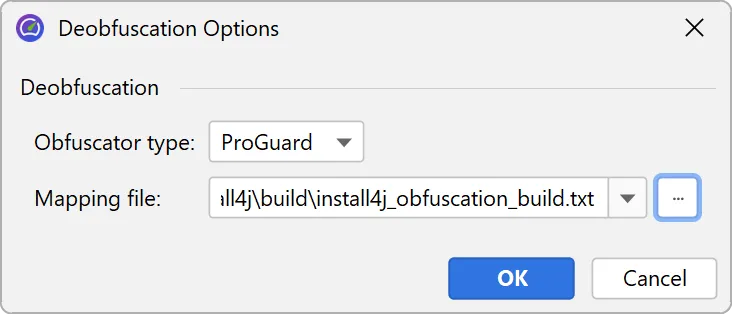
应用映射文件后,JProfiler 中的所有比较都会显示原始的类名和方法名。
时间线视图现在支持行固定。
在线程历史视图和所有探针时间线视图中,您可以通过上下文菜单固定选定的行。这些行显示在顶部的一个单独区域中,您可以通过拖放来更改它们的顺序。
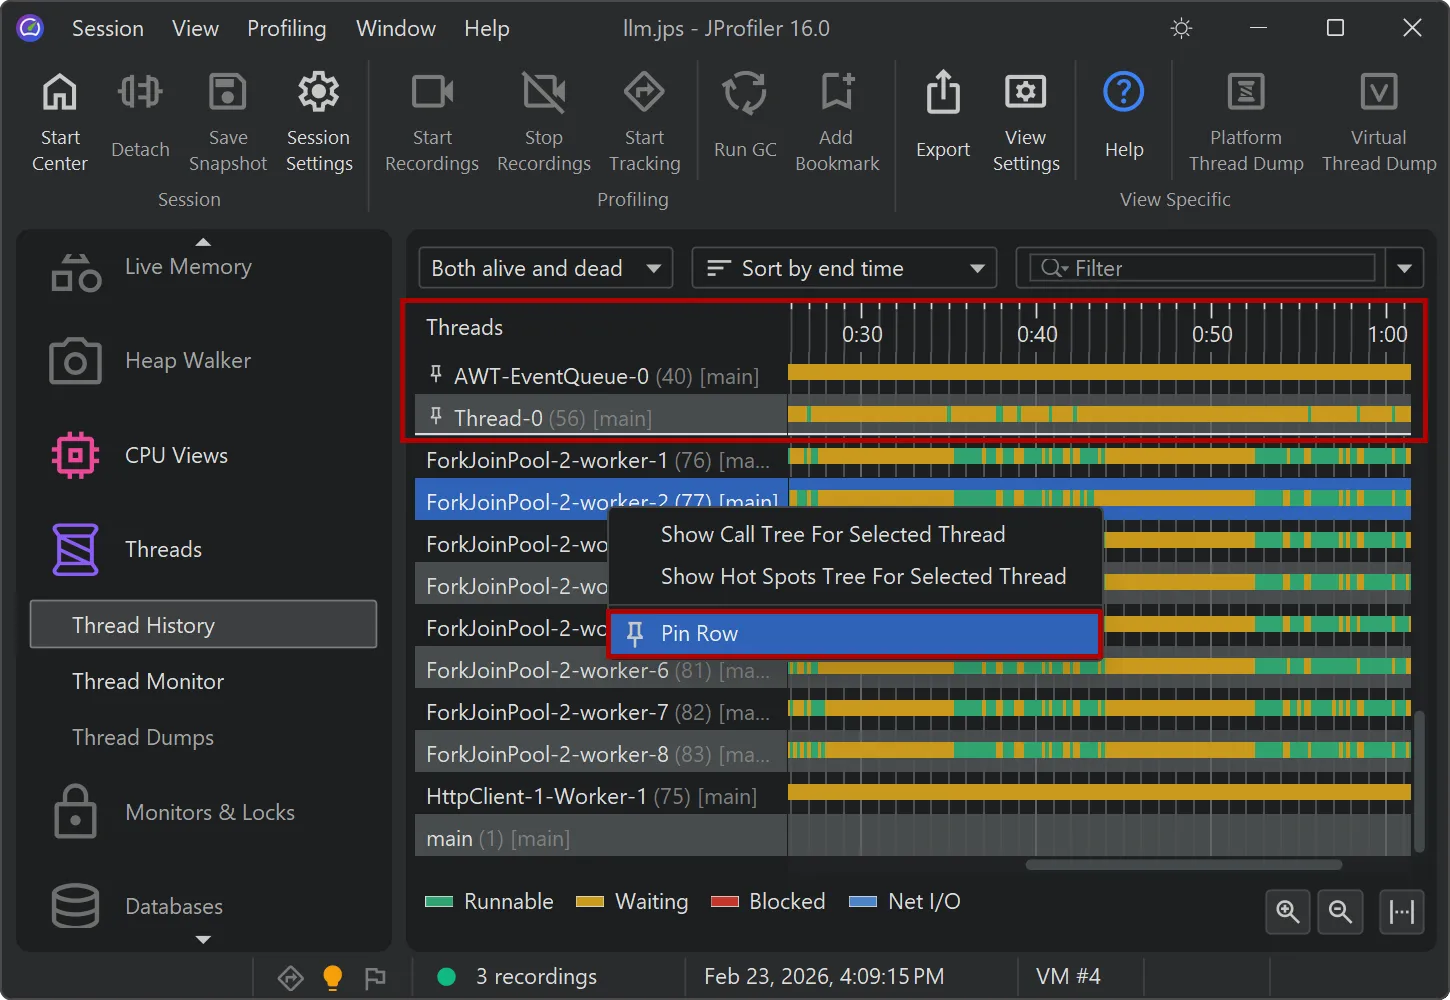
已固定的行可以逐个取消固定,也可以一次性全部取消固定。
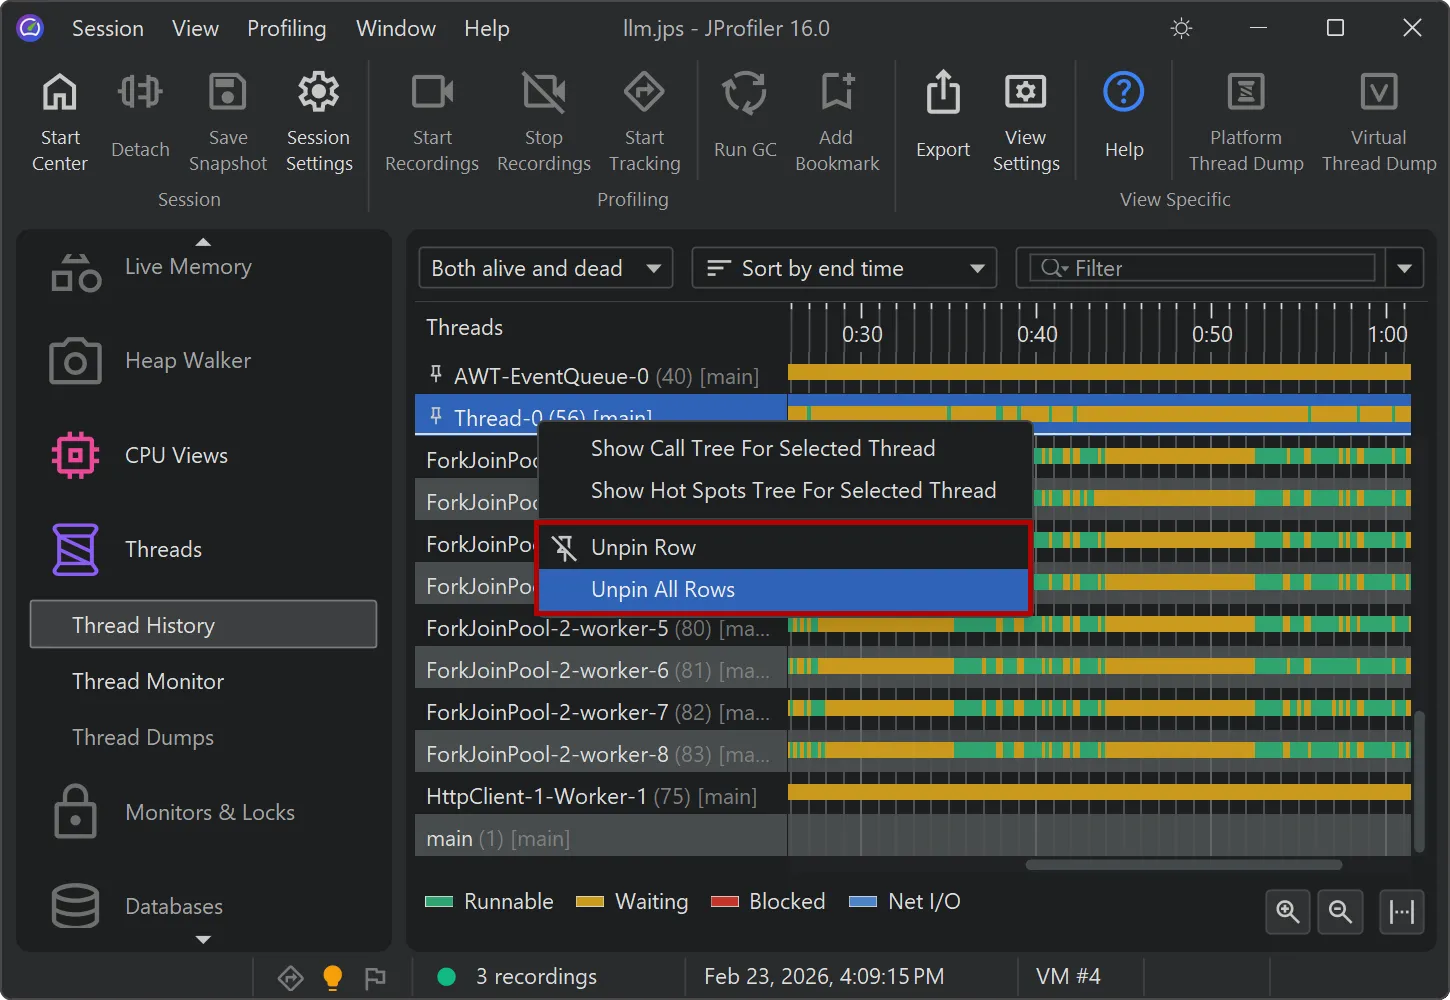
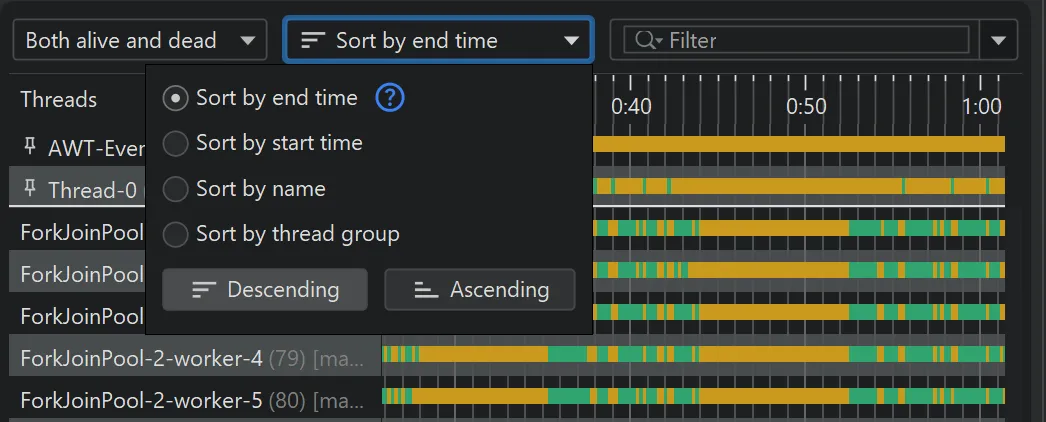
JProfiler 16 还新增了一个排序下拉列表,提供升序和降序两种排序方向,以及一种新的默认排序模式:仍处于活动状态的长存续行显示在最前面,随后是最近关闭的行。
JProfiler 16 增加了对 Java 26 进行分析的完整支持。
如果您要分析虚拟线程,或者要使用 JDK HTTP 客户端中新增的内置 HTTP/3 支持,那么这个版本必不可少。