

JProfiler 16.1에서 도입된 MCP 서버는 AI 코딩 에이전트에게 집중된 프로파일링 워크플로를 제공했습니다: CPU 데이터를 기록하고, 핫스팟을 찾아 상세 분석하는 것이었습니다. JProfiler 16.3에서 MCP 서버는 이러한 초기 기능 범위를 훨씬 뛰어넘어 성장했으며 이제 JProfiler의 모든 주요 서브시스템을 다루기 때문에, 에이전트가 온전한 프로파일링 및 분석 워크플로를 스스로 수행할 수 있습니다. MCP 도구 레퍼런스에서 사용할 수 있는 모든 도구와 리소스를 자세히 살펴볼 수 있습니다.
JProfiler의 새로운 소식
모든 변경 사항의 자세한 목록은 변경 로그를 참조하십시오.
새로 지원되는 서브시스템:
- 힙 덤프 분석: 라이브 세션에서 힙 덤프를 생성할 수 있고, 새로 생성한 스냅샷과 기존 스냅샷 모두 클래스 히스토그램, 가장 큰 객체, 값 필터가 적용된 인스턴스 쿼리, 참조 체인, GC 루트까지의 경로, 지배자 체인, 자동화된 힙 검사로 분석할 수 있습니다. 힙 워커 스크립트는 필터링과 사용자 지정 그룹화에 사용할 수 있습니다.
- 프로브 이벤트: 백트레이스, 이벤트 히스토그램, 이벤트 타임라인이 포함된 개별 이벤트를 쿼리할 수 있고, JDBC 연결 같은 열려 있는 컨트롤 객체는 열기 호출의 스택 트레이스와 함께 누수 분석을 위해 나열됩니다.
- 모니터 및 락: 모니터 통계, 경합 타임라인, 락 히스토리, 락 그래프가 제공되며, 교착 상태 분석을 위한 라이브 JVM의 모니터 덤프도 사용할 수 있습니다.
- 가상 스레드 계층 구조를 포함한 스레드 덤프를 생성할 수 있습니다.
- GC 데이터: 원인, 일시 중지 시간, 단계, 힙 사용량이 포함된 개별 가비지 컬렉션과 GC 구성 및 플래그.
- MBean 스냅샷: 현재 JMX MBean 속성 값을 온디맨드 또는 주기적으로 캡처할 수 있습니다.
- 텔레메트리: CPU와 힙 사용량부터 프로브 텔레메트리까지 모든 텔레메트리 데이터셋을 사용할 수 있습니다.
- 할당 기록: 할당 핫스팟과 콜 트리가 호출 지점별로 할당된 클래스와 바이트를 보여 주며, 이미 가비지 컬렉션된 객체도 포함됩니다.
- 메서드 복잡도 분석: 스크립트가 각 메서드 호출의 복잡도(예: 입력 컬렉션의 크기)를 정의하고, 곡선 피팅이 측정된 실행 시간을 일반적인 big-O 복잡도와 연관 지어 줍니다.
- JavaScript 출처 추적: 프로파일링되는 애플리케이션의 XHR 요청에 대한 브라우저 호출 스택.
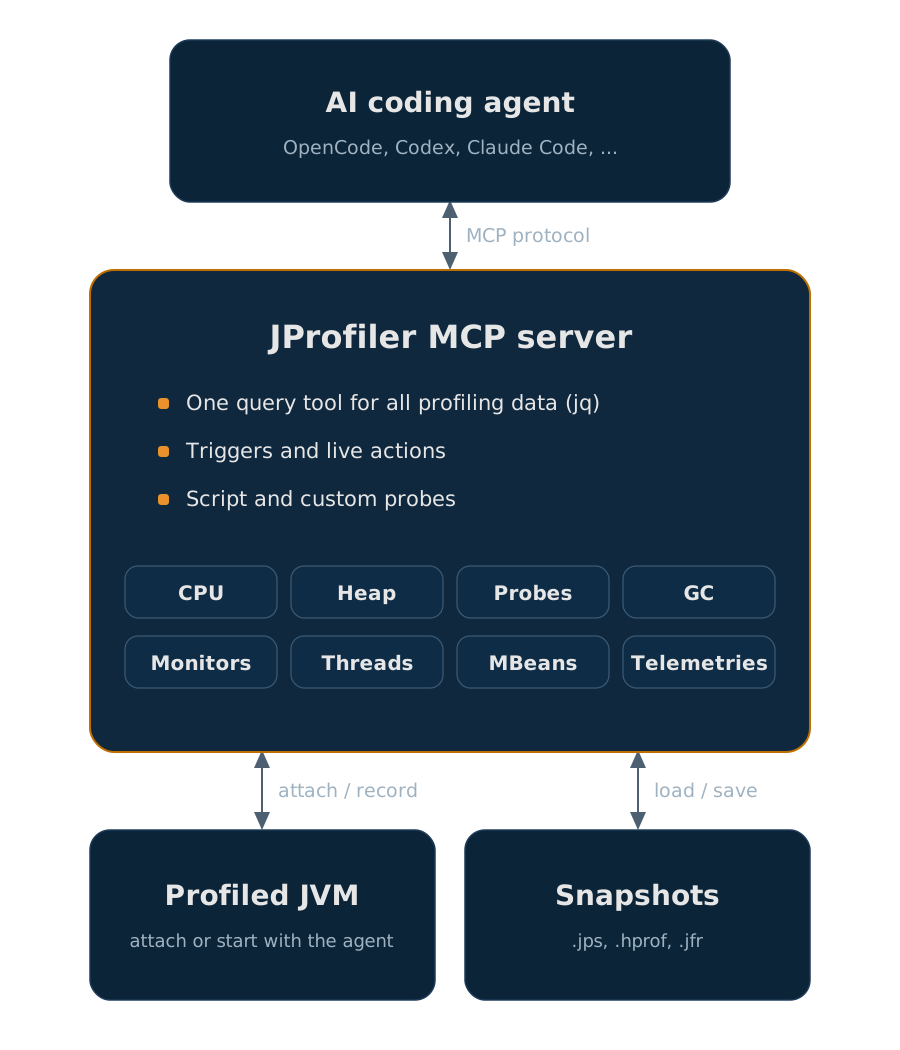
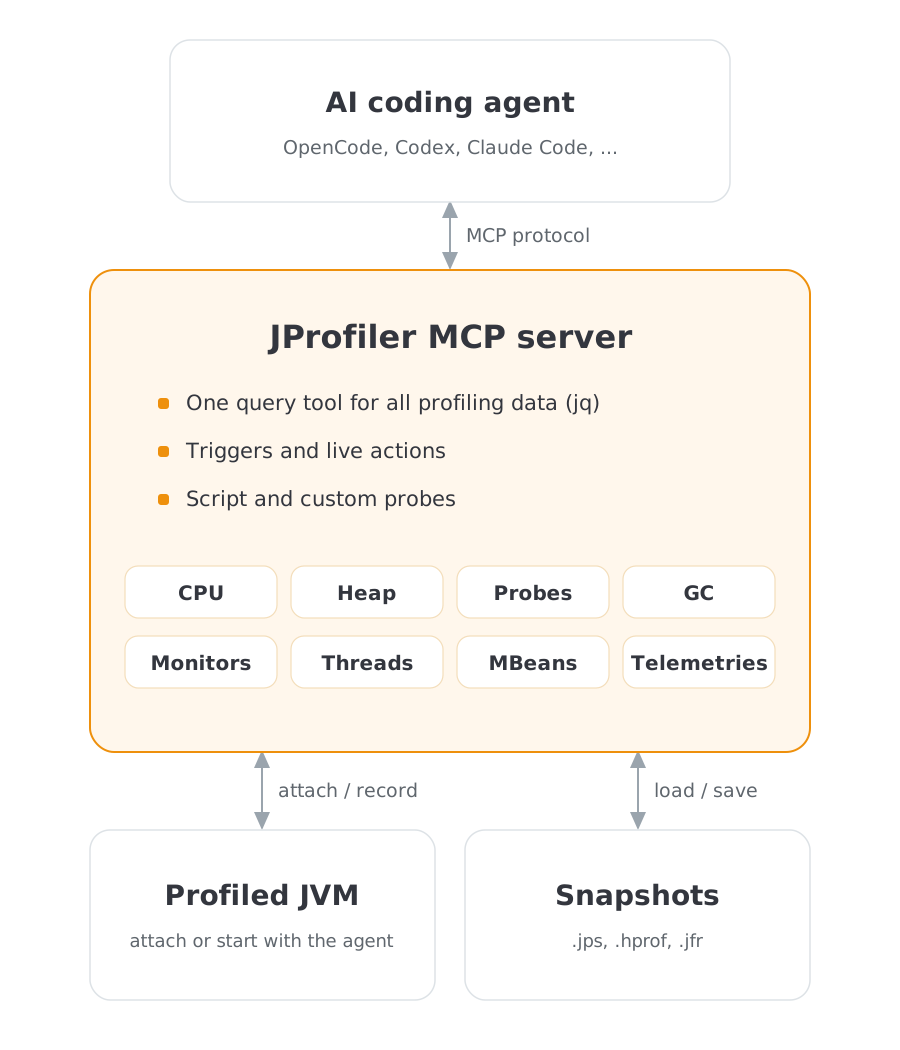
CPU 분석도 확장되었습니다. 이제 에이전트는 스레드와 스레드 그룹을 선택하고, 스레드 상태로 필터링하고, 핫스팟과 콜 트리 노드를 개별 스레드에 귀속시키고, 아웃라이어 감지 및 예외 메서드 기록으로 간헐적으로 느린 호출을 추적할 수 있습니다.
트리거를 사용하면 대화형 도구 호출로는 잡아낼 수 없는 데이터를 에이전트가 캡처할 수 있습니다. 스레드 덤프, 힙 덤프, MBean 스냅샷 같은 액션은 타이머에 따라, 힙 또는 CPU 임계값을 초과할 때, 또는 특정 메서드가 호출될 때 자동으로 발동될 수 있습니다. 이를 통해 JVM 시작 시점부터 기록할 수 있고, 장시간 실행되는 세션에서 힙 사용량 급증 같은 일시적인 상태를 감시할 수 있습니다. 동일한 액션은 실행 중인 JVM에서 라이브 액션으로 직접 실행할 수도 있습니다.
스크립트 프로브를 사용하면 에이전트가 완전히 새로운 프로브를 즉석에서 정의할 수 있습니다. 스크립트 프로브는 Java 코드 조각으로 선택한 메서드를 가로채고, 배포 단계 없이 내장 프로브와 같은 방식으로 결과를 기록합니다. 영구적인 인스트루멘테이션을 위해서는 에이전트가 프로파일링되는 애플리케이션의 일부가 되는 커스텀 프로브를 작성할 수 있는데, 가장 편리한 방법은 내장형 프로브 API를 사용하는 내장형 프로브입니다. 커스텀 프로브는 내장 프로브와 동일한 방식으로 기록·분석되며, 프로브 구성과 스크립트 및 커스텀 프로브 API는 MCP 리소스로 노출되므로 에이전트가 작업 중에 언제든 조회할 수 있습니다.
모든 데이터는 이전 버전의 수많은 특수 목적 도구를 대체하는 jq 표현식 기반의 단일 쿼리 도구를 통해 검색합니다. 더 적고 균일한 도구 집합은 에이전트를 더 신뢰할 수 있게 만듭니다. 프로파일링 데이터를 필터링, 집계, 드릴다운하는 방법이 하나뿐이며, 모든 서브시스템에서 동일하게 동작합니다.
설정 방법은 이전과 동일합니다. JProfiler UI에서 에이전트를 구성하거나 에이전트 설정 페이지의 지침을 따르세요.
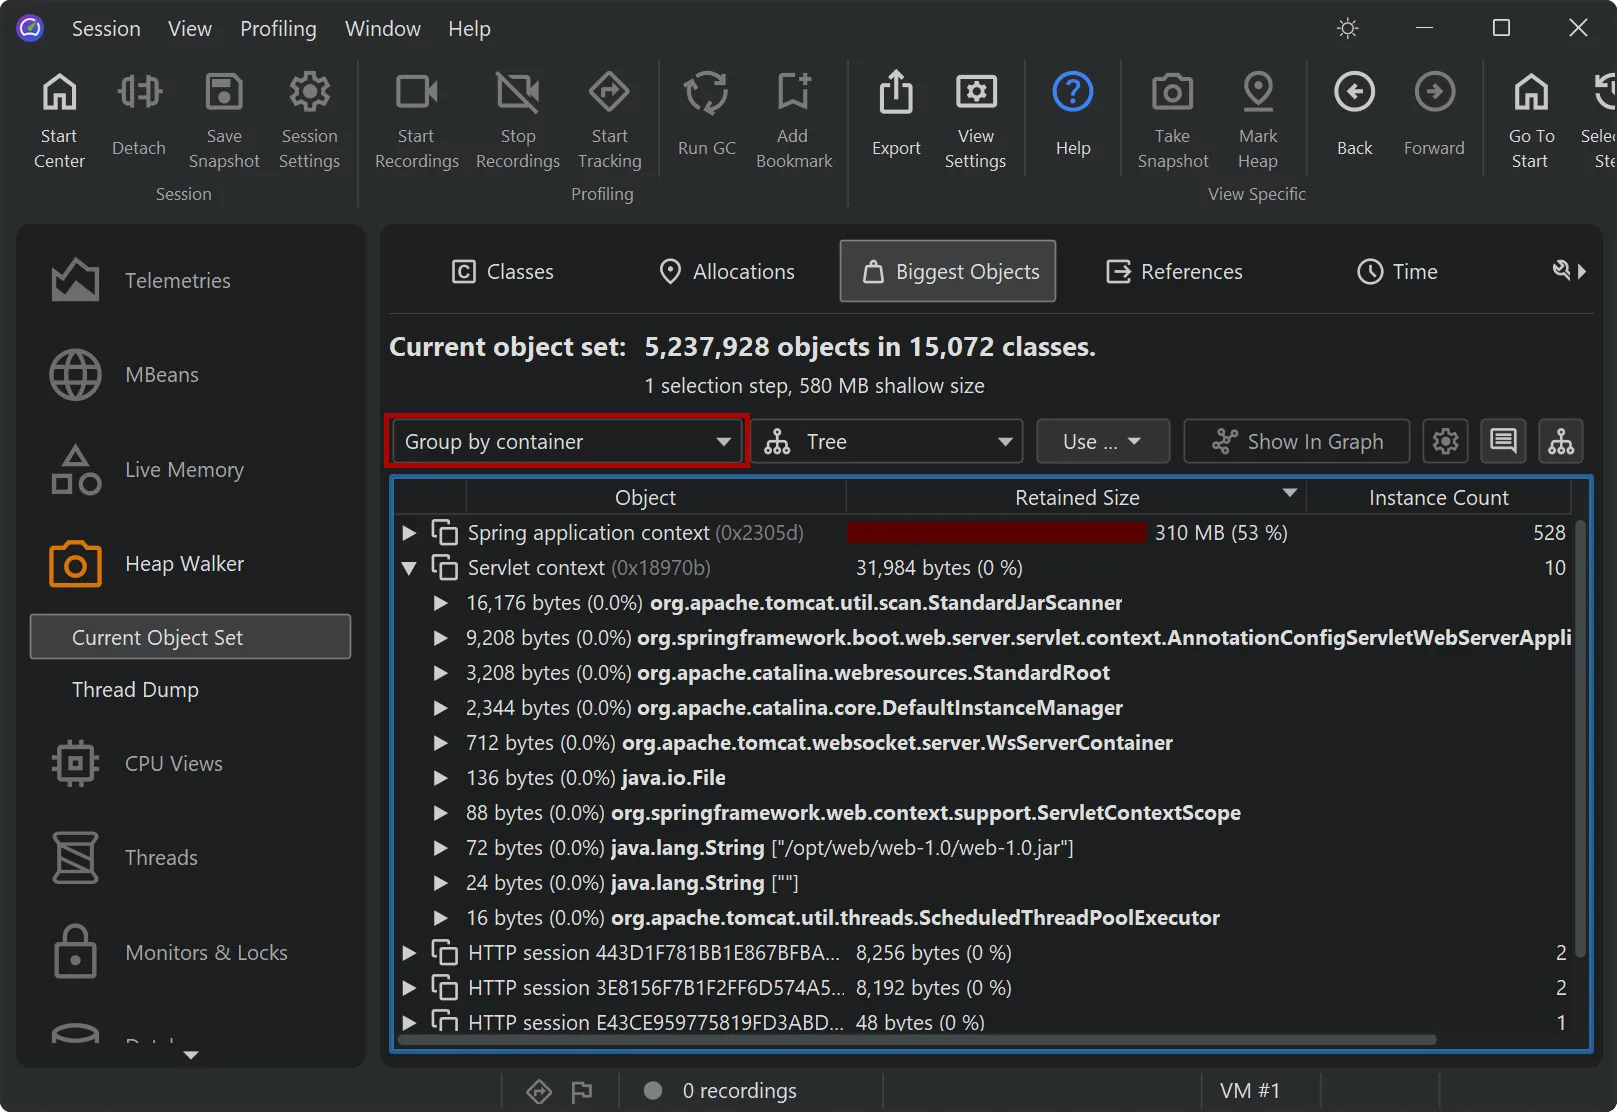
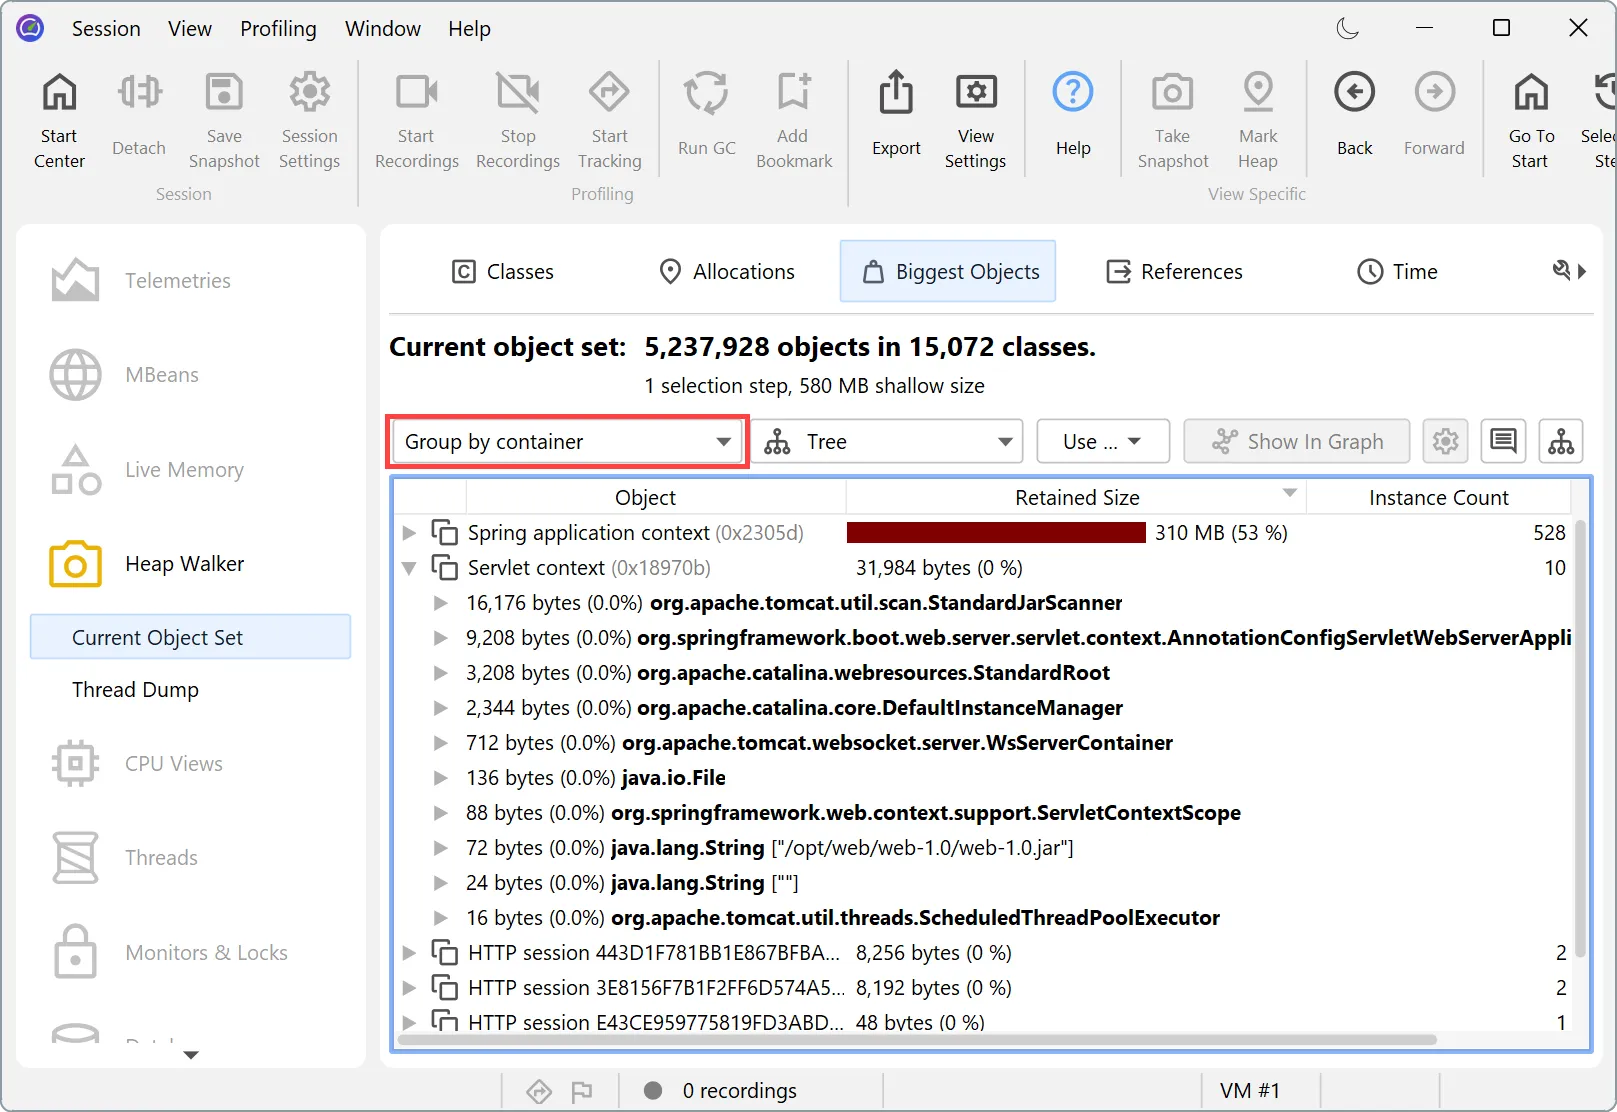
힙 워커의 가장 큰 객체 뷰가 이제 널리 사용되는 프레임워크의 의미를 이해합니다. 새로운 "컨테이너별 그룹화" 그룹화를 사용하면 객체가 자신이 속한 프레임워크 컨테이너를 기준으로 그룹화됩니다. 최상위 수준에는 Spring 애플리케이션 컨텍스트, 서블릿 세션, 서블릿 컨텍스트, Hibernate 영속성 컨텍스트에 해당하는 레이블이 붙은 컨테이너 노드가 표시되며, 각 컨테이너가 관리하는 객체의 누적 리테인드 크기도 함께 표시됩니다.
컨테이너를 확장하면 프레임워크 레지스트리 내부를 거치는 참조 체인 없이 관리되는 객체가 곧바로 표시됩니다. "어떤 서블릿 세션이 가장 많은 메모리를 유지하는가", "이 객체는 어느 Spring 애플리케이션 컨텍스트에 속하는가"와 같은 질문에 이제 가장 큰 객체 뷰에서 바로 답을 얻을 수 있습니다.
JProfiler가 이제 Maven 플러그인을 제공하여 기존 Gradle 플러그인 및 Ant 태스크와의 격차를 메웁니다. profile 골은 프로파일링 에이전트를 붙인 상태로 프로젝트의 메인 클래스를 실행합니다:
mvn com.jprofiler:jprofiler-maven:16.3:profile -Djprofiler.mainClass=com.example.Main
또는 POM에서 플러그인을 구성할 수 있습니다:
<plugin>
  <groupId>com.jprofiler</groupId>
  <artifactId>jprofiler-maven</artifactId>
  <version>16.3</version>
  <configuration>
    <mainClass>com.example.Main</mainClass>
  </configuration>
</plugin>
그런 다음에는 mvn jprofiler:profile만으로 충분합니다. 이 밖의 골들은 CI 환경에서의 헤드리스 작업을 지원합니다: export, compare, analyze는 명령줄에서 스냅샷을 처리하고, set-agentpath-property는 다른 플러그인이 사용할 수 있도록 -agentpath VM 파라미터가 들어간 프로퍼티를 준비합니다. 자세한 내용은 Maven 골 문서를 참조하세요.
Gradle 태스크와 새로운 Maven 골은 이제 빌드 머신에 설치가 구성되어 있지 않으면 JProfiler 설치본을 자동으로 다운로드합니다. 덕분에 CI 파이프라인에서 프로파일링하기가 훨씬 쉬워집니다. 빌드 에이전트에 JProfiler를 미리 설치해 둘 필요가 없으며, 빌드 통합이 요청된 버전을 필요한 시점에 프로비저닝합니다.
Gradle에서는 설치 디렉터리를 생략하기만 하면 됩니다:
jprofiler {
    // installDir = file('/opt/jprofiler')
}
installDir를 지정하지 않으면 플러그인이 플러그인 버전과 동일한 버전의 JProfiler 배포판을 다운로드하여 Gradle 사용자 홈 디렉터리에 캐시합니다. Maven 골도 같은 방식으로 동작합니다.
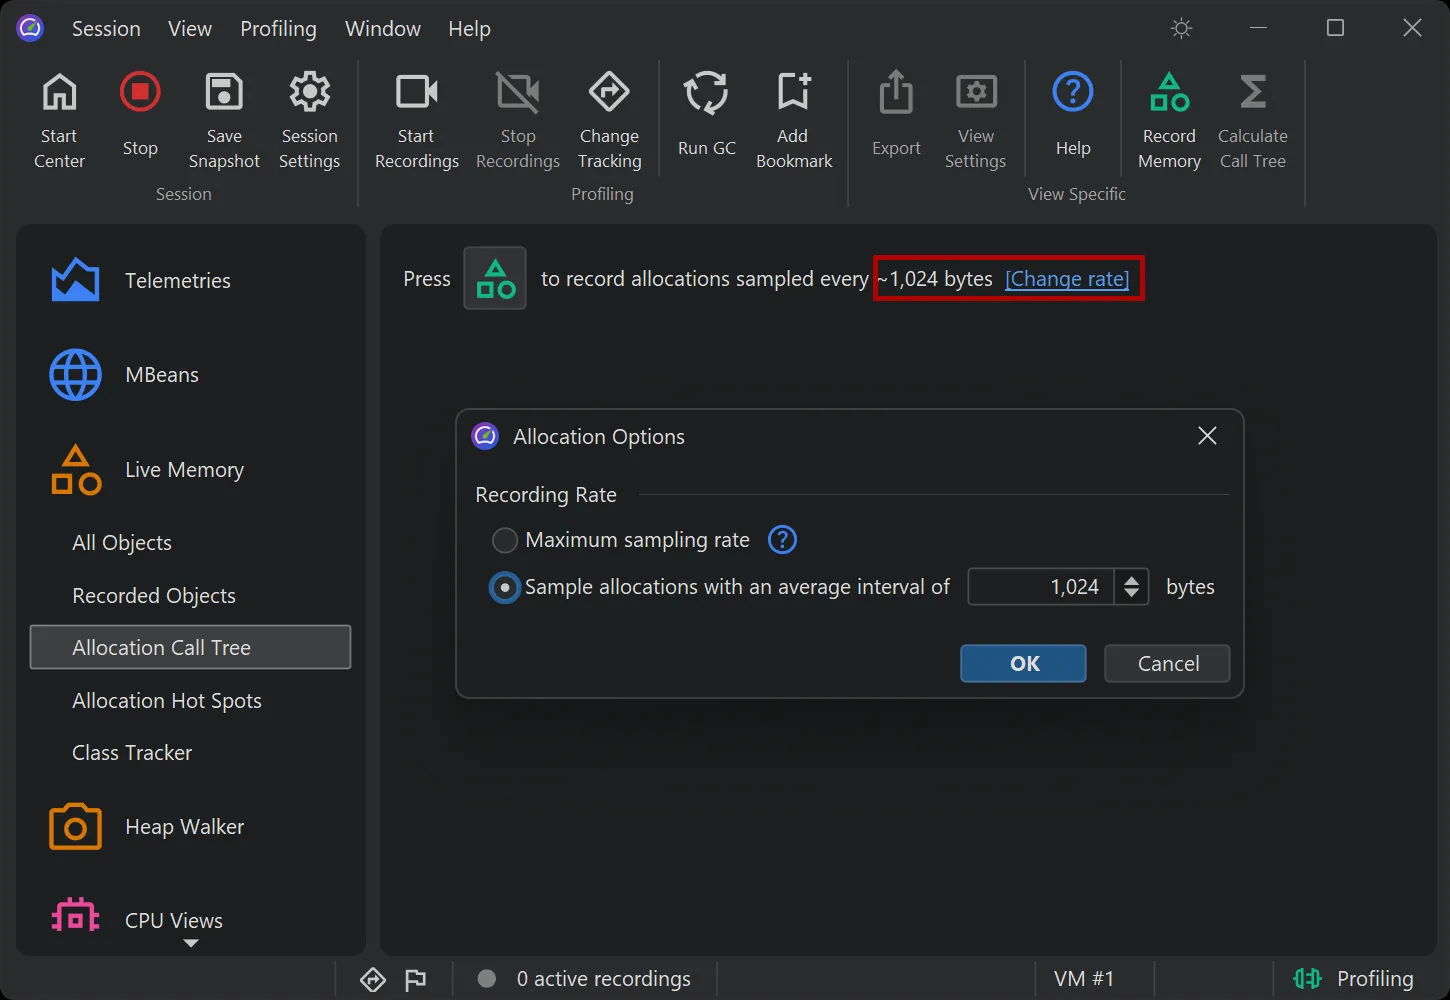
할당 기록은 이제 Java 11+에서 오버헤드가 낮은 JVMTI 할당 샘플링 메커니즘(JEP 331)을 사용하는 바이트 간격 샘플링이 기본 방식입니다. 매 n번째 객체를 기록하기 위해 생성자를 인스트루멘트하는 대신, 프로파일링 에이전트는 JVM이 N바이트를 할당할 때마다 샘플링된 할당 이벤트를 전달받습니다.
이로써 HotSpot JIT의 이스케이프 분석을 비활성화할 수 있었던 생성자 인스트루멘테이션에 따른 측정 왜곡이 사라집니다. 동시에 기록 오버헤드도 더 낮아집니다.
샘플링 간격은 이제 바이트 단위로 설정하며 기본값은 1024입니다. Java 8이나 JVMTI 샘플링 기능이 없는 JVM에서는 기존의 인스트루멘테이션 기반 기록이 자동으로 사용됩니다.
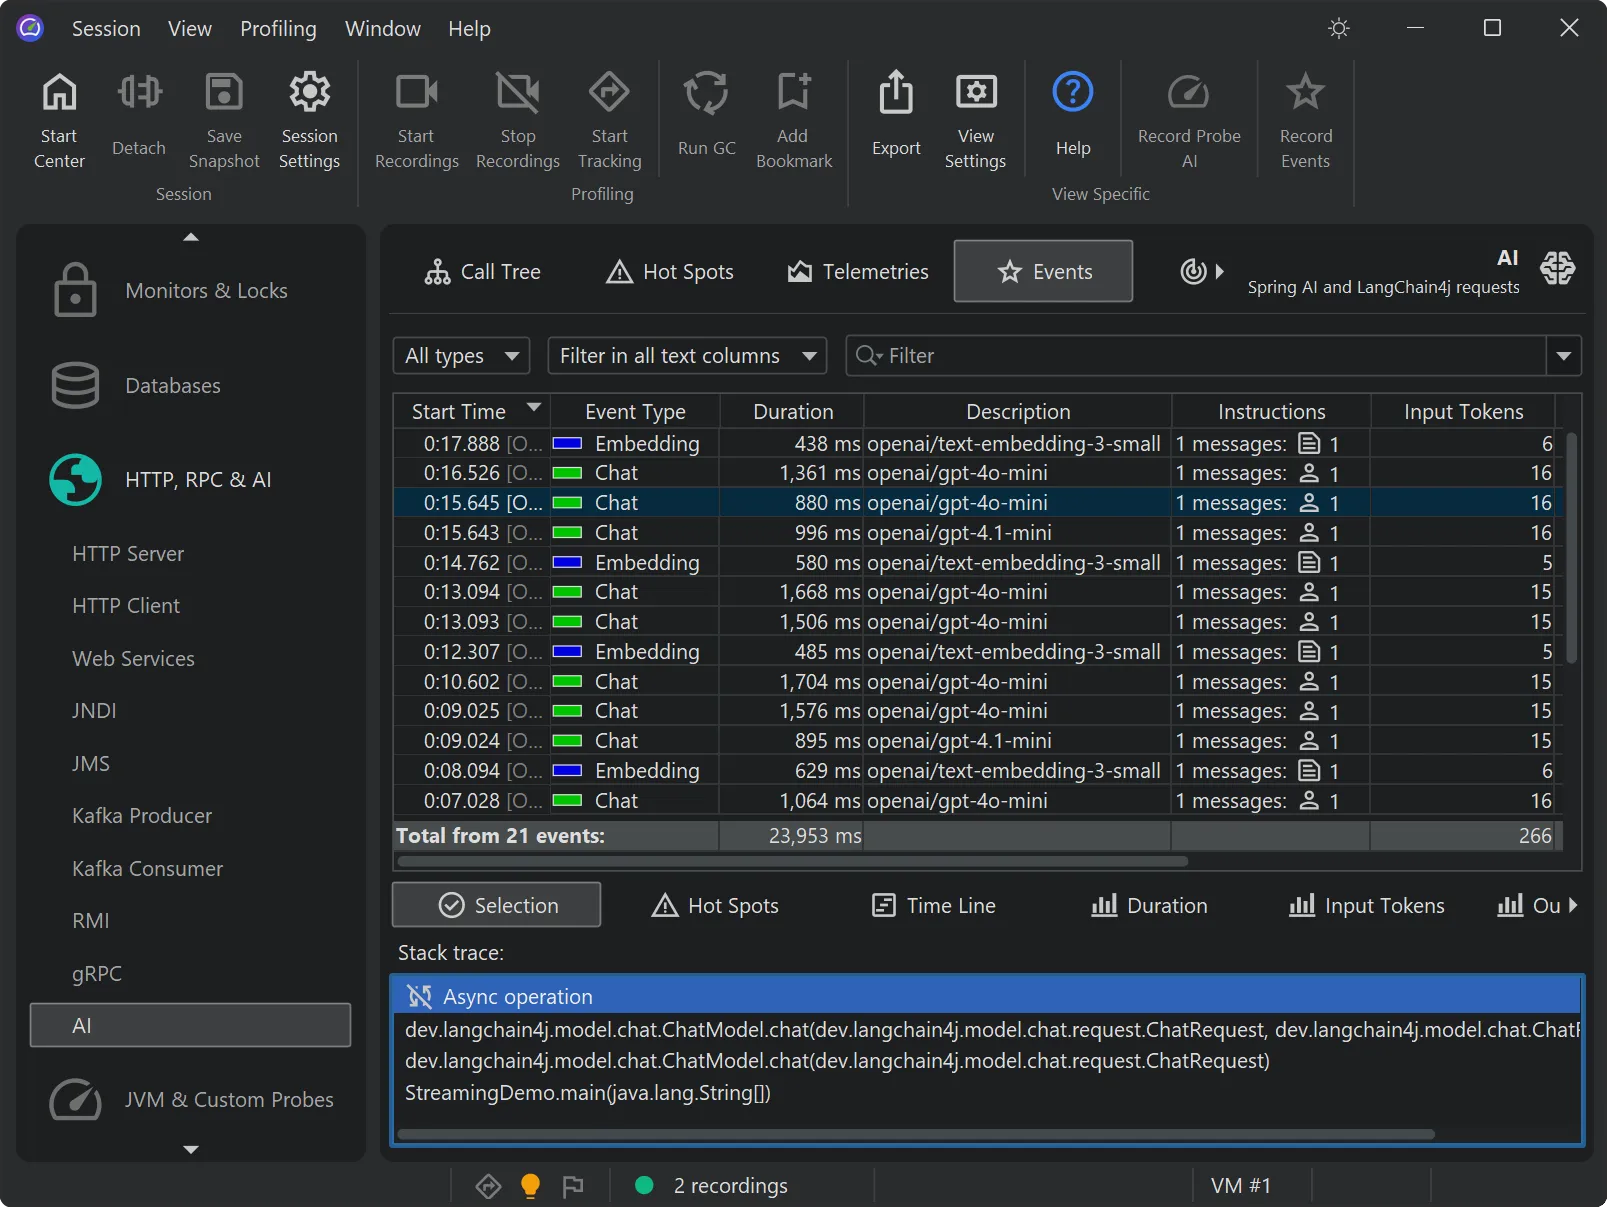
AI 프로브가 이제 LangChain4j의 비동기 및 스트리밍 요청을 지원하여 LangChain4j의 모든 LLM 상호작용 패턴을 다룹니다.
스트리밍 응답은 완전한 응답으로 조립되고, 토큰 사용량과 총 소요 시간은 동기 호출과 마찬가지로 기록됩니다. 비동기 요청은 완료, 취소, 시간 초과 시점까지 추적되므로 이벤트, 핫스팟, 텔레메트리가 모든 요청에 대해 올바른 데이터를 보여 줍니다.
이제 오프라인 프로파일링을 JProfiler 구성 파일 없이 -agentpath VM 파라미터에서 직접 구성할 수 있습니다. 이전에는 오프라인 모드를 사용하려면 먼저 JProfiler UI에서 세션 구성을 내보내야 했습니다.
가장 많이 사용되는 프로파일링 설정은 인라인으로 지정할 수 있습니다. 콜 트리 수집 모드는 callTreeMode로, 프로파일링 대상·컴팩트·무시 패키지 필터는 profile, compact, ignore로 지정합니다. 여기에 더해, 완전한 자동 기록 시퀀스를 추가할 수 있습니다. 이 시퀀스는 API 호출이나 jpcontroller 없이 snapshot, recording, duration, delay 옵션으로 스냅샷을 저장합니다.
예를 들어 다음 파라미터는
-agentpath:...=offline,callTreeMode=sampling,profile=com.mycorp.,\
    snapshot=/tmp/snapshot.jps,recording=cpu:allocation,duration=10m
CPU와 할당 데이터를 10분 동안 기록한 다음 스냅샷을 저장합니다.
동일한 인라인 설정과 기록 옵션은 이미 실행 중인 JVM에 프로파일링 에이전트를 연결하는 jpenable 명령줄 도구에서도 사용할 수 있습니다. 오프라인 모드를 선택하면 jpenable이 대화형 리치 콘솔을 통해 설정을 단계별로 안내합니다.
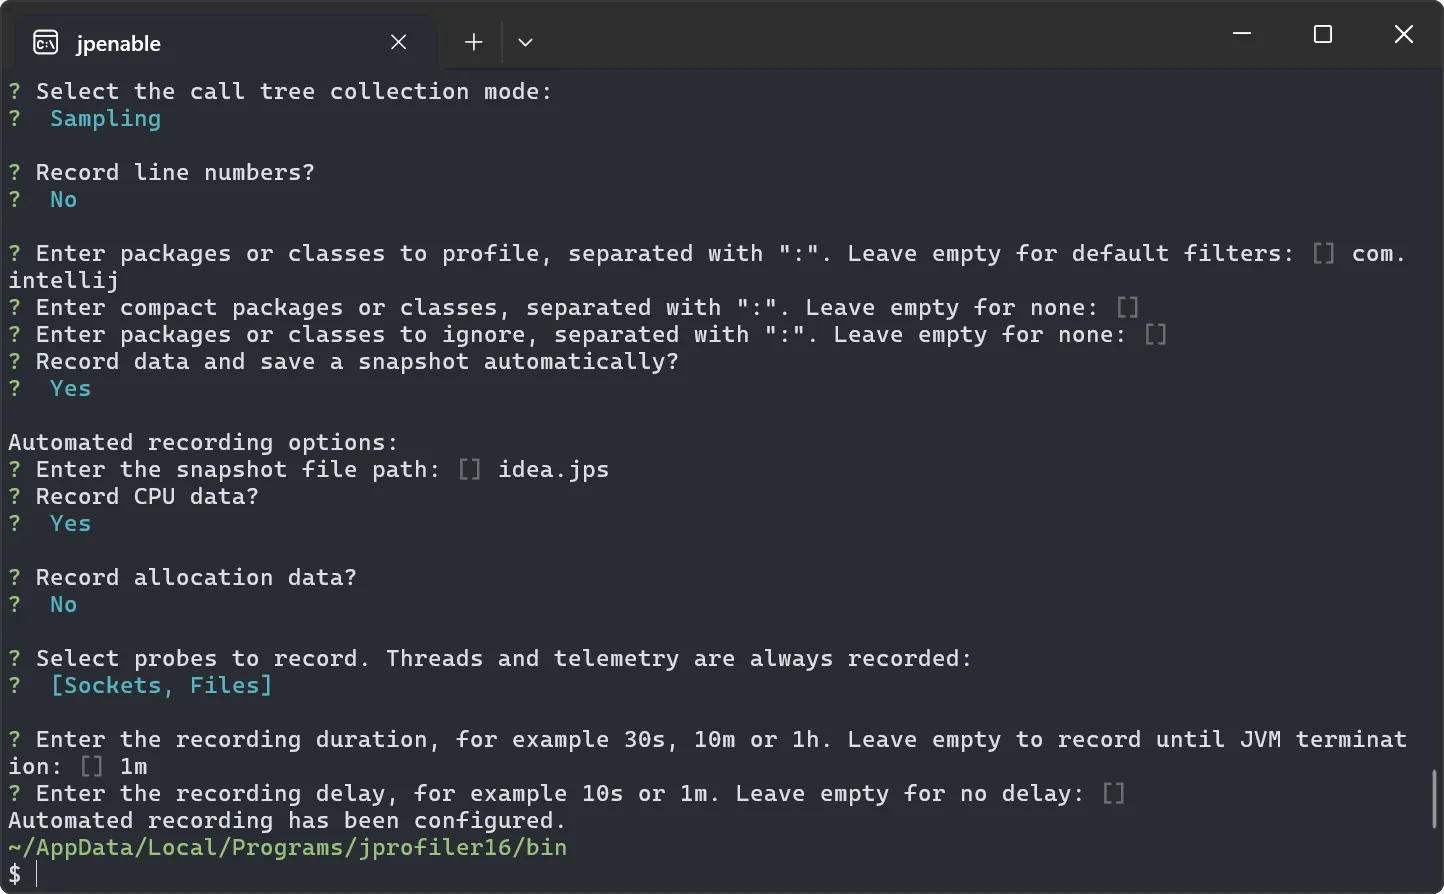
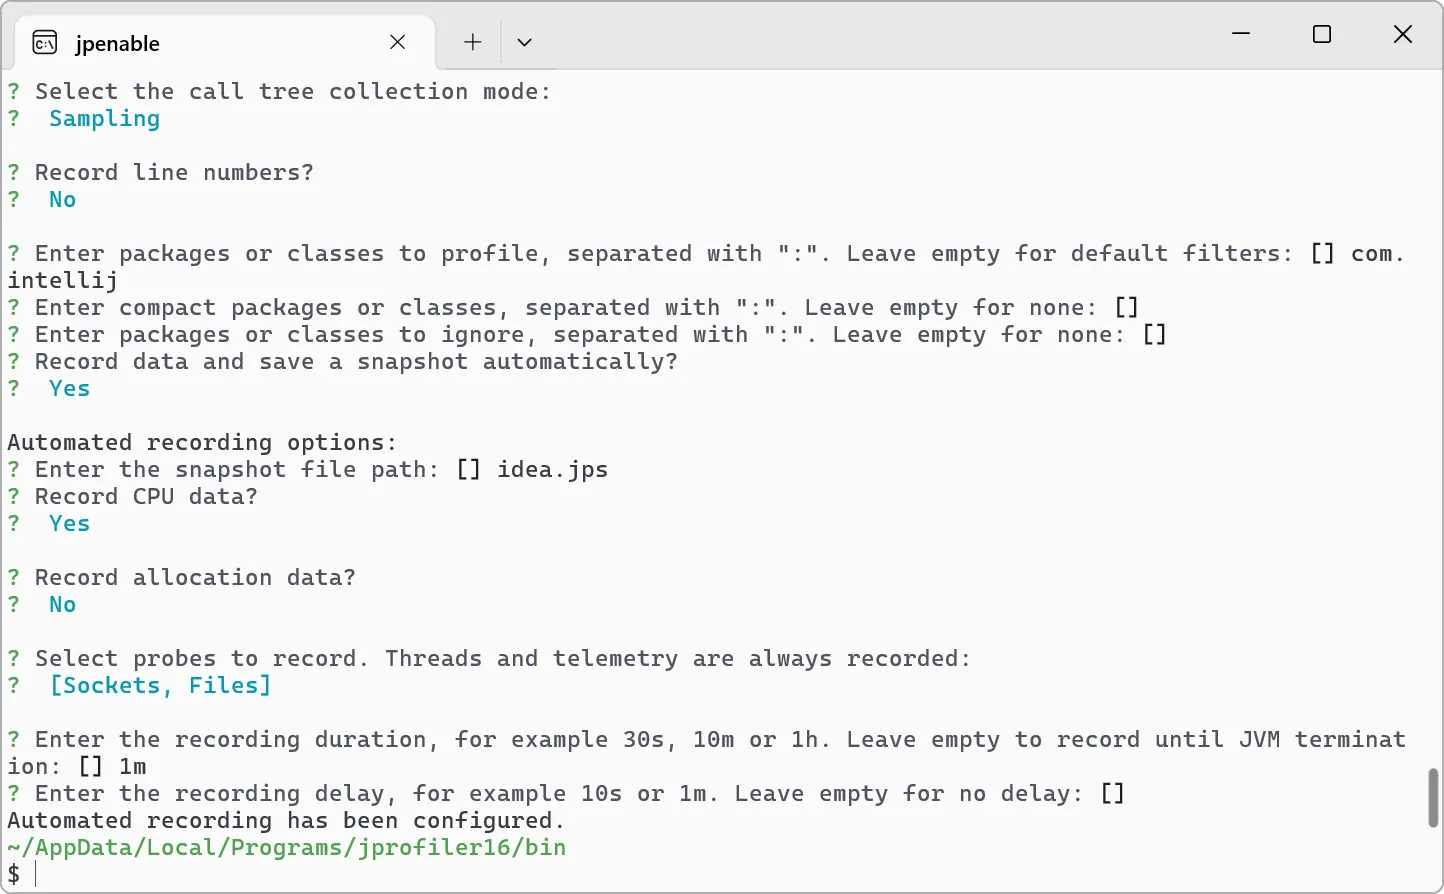
또는 CI 파이프라인에서 비대화형으로 사용할 수 있도록 --call-tree-mode, --profile, --line-numbers, --snapshot, --recording, --duration 등의 옵션으로 명령줄에서 설정을 지정할 수도 있습니다.
Gradle 및 Ant 프로파일링 태스크는 태스크 속성을 통해 동일한 기능을 제공하므로, 빌드 스크립트에서 바로 오프라인 프로파일링과 자동 기록 시퀀스를 구성할 수 있습니다.
JProfiler 16.1에서 도입된 MCP 서버가 개선되었습니다. 이제 덜 강력한 모델과도 안정적으로 작동하며 프로파일링 워크플로를 더욱 견고하게 수행합니다. 지원하는 AI 코딩 도구로 Antigravity가 추가되었습니다.
이제 JProfiler에 AI 코딩 에이전트가 Java 애플리케이션을 프로파일링하고, 그 결과를 분석한 뒤 후속 조치까지 수행할 수 있게 해 주는 MCP(Model Context Protocol) 서버가 포함되었습니다. Claude Code, Cursor, Codex, Gemini CLI를 비롯하여 MCP와 호환되는 모든 AI 코딩 도구에서 사용할 수 있습니다.
지금까지 프로파일링은 GUI로 수행하는 작업이었습니다. 세션을 시작하고, 뷰를 탐색하고, 데이터를 해석하는 과정을 직접 거쳐야 했습니다. MCP 서버를 사용하면 에이전트가 이 일련의 과정을 스스로 완결할 수 있습니다. 애플리케이션을 프로파일링하여 JDBC 쿼리가 실행 시간의 대부분을 차지함을 발견하고, 중복된 데이터베이스 호출을 제거하도록 코드를 수정한 다음, 개선을 검증하기 위해 다시 프로파일링하여 구체적인 수치로 수정 전후를 비교해 보여 줍니다.
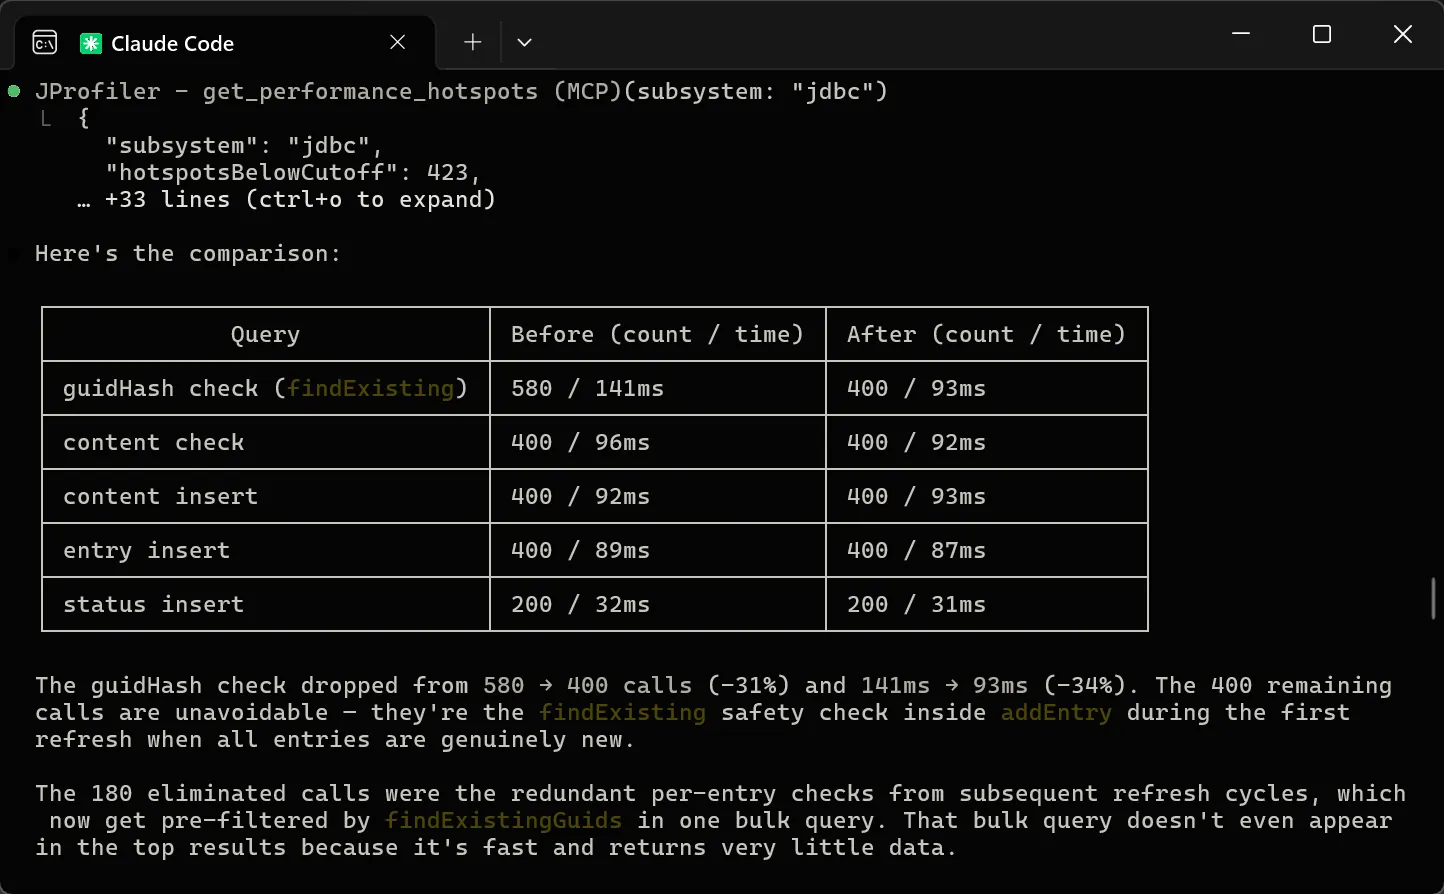
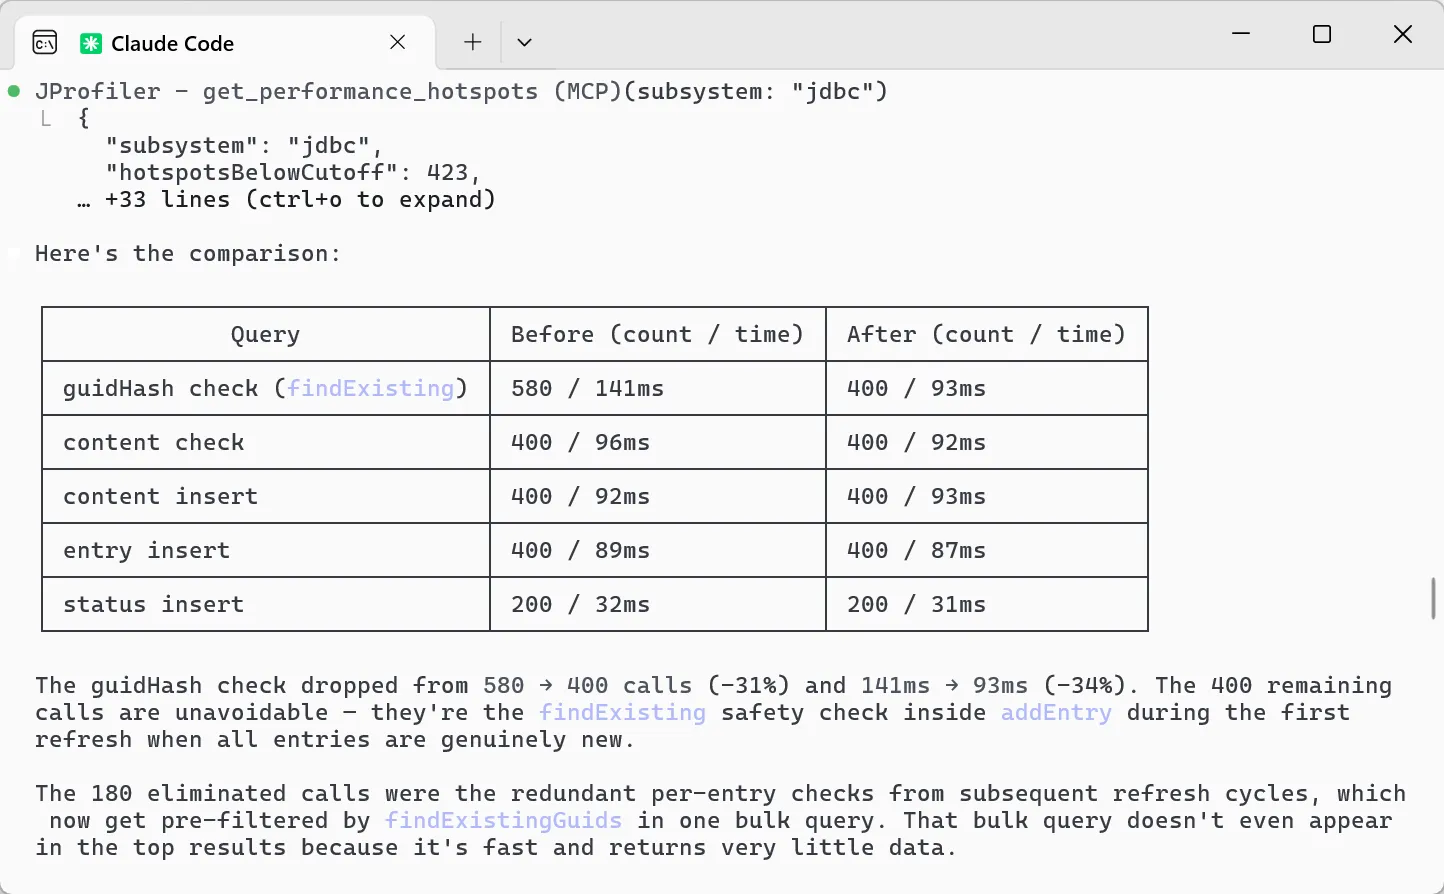
MCP 서버가 노출하는 도구들은 에이전트가 전문가가 JProfiler를 사용하는 방식을 그대로 재현하는 프로파일링 워크플로를 안정적으로 따를 수 있도록 면밀하게 설계되고 검증되었습니다. 에이전트는 먼저 대상 애플리케이션에 대한 프로파일링을 설정합니다. 테스트 실행이 끝나면 데이터 가용 여부를 확인하고, 시간이 어디에 소요되는지 파악하기 위해 초기 집계 핫스팟 뷰를 가져옵니다. 이어서 호출 체인을 따라가며 근본 원인까지 개별 핫스팟을 상세히 파고듭니다.
각 단계의 데이터는 신중하게 필터링되므로, CPU 핫스팟, JDBC 및 JPA 쿼리, HTTP 호출, MongoDB 작업, 힙 덤프 중 무엇을 분석하든 에이전트는 방대한 정보에 압도되지 않고 중요한 부분에 집중할 수 있습니다. 로컬 및 컨테이너화된 JVM의 라이브 프로파일링 외에도, 기존의 JProfiler, HPROF 또는 JFR 스냅샷을 불러와 분석할 수 있습니다.
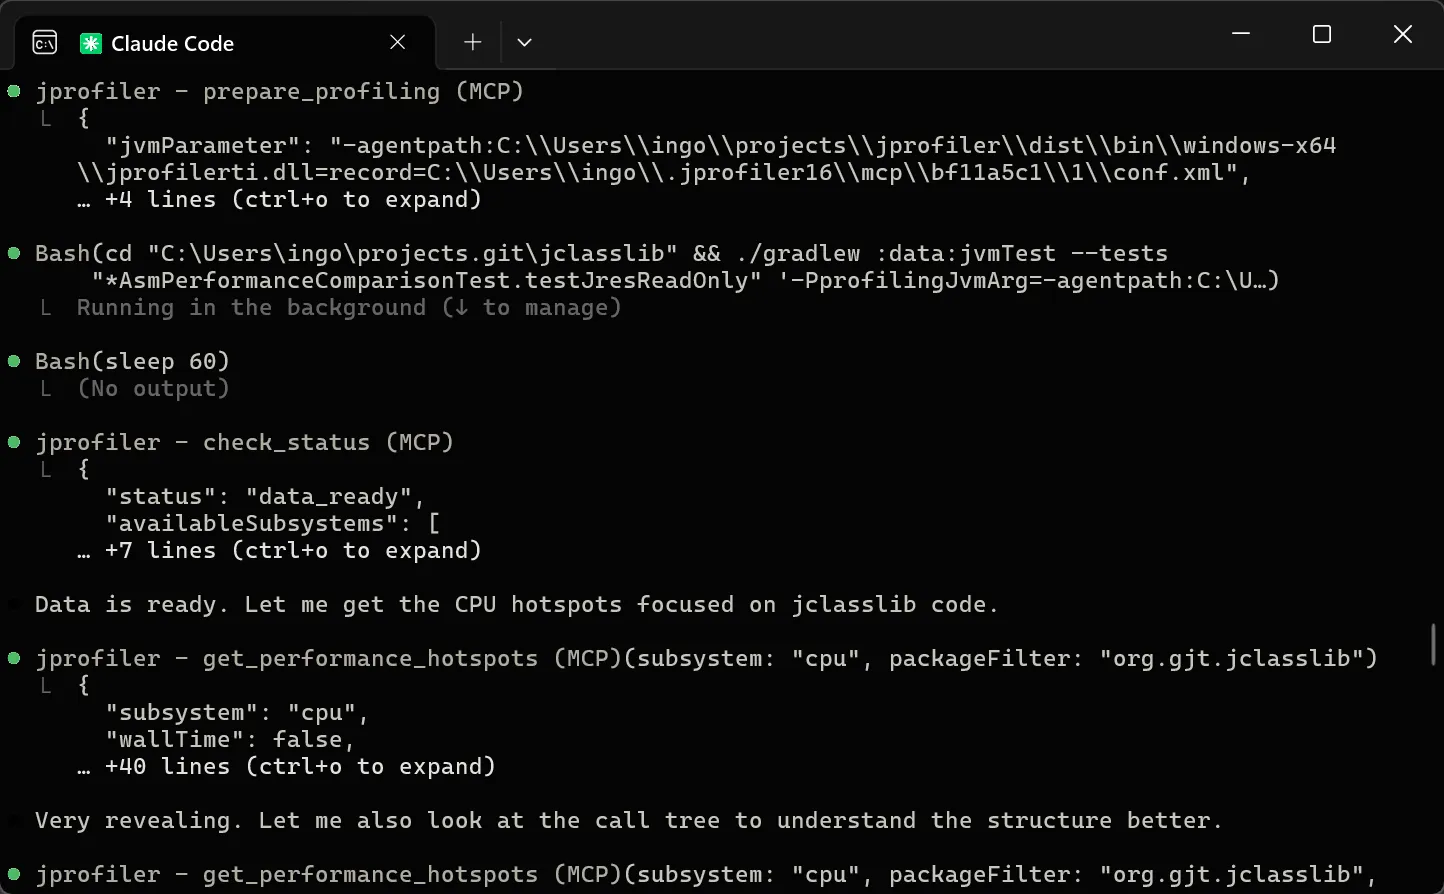
설정은 완전히 간편합니다. MCP 서버는 처음 사용할 때 JProfiler 바이너리를 자동으로 설치하고 라이선스 처리도 MCP 프로토콜을 통해 수행합니다. 에이전트는 JProfiler UI에서 직접 설정할 수도 있고, MCP 설정 페이지의 안내에 따를 수도 있습니다. 이번 릴리스에 대한 전체 내용은 발표 블로그 게시물을 참조하십시오.
JProfiler 16에는 AI 프로브가 도입되었습니다. 이 프로브는 LangChain4j와 Spring AI를 통한 LLM 상호작용을 측정합니다.
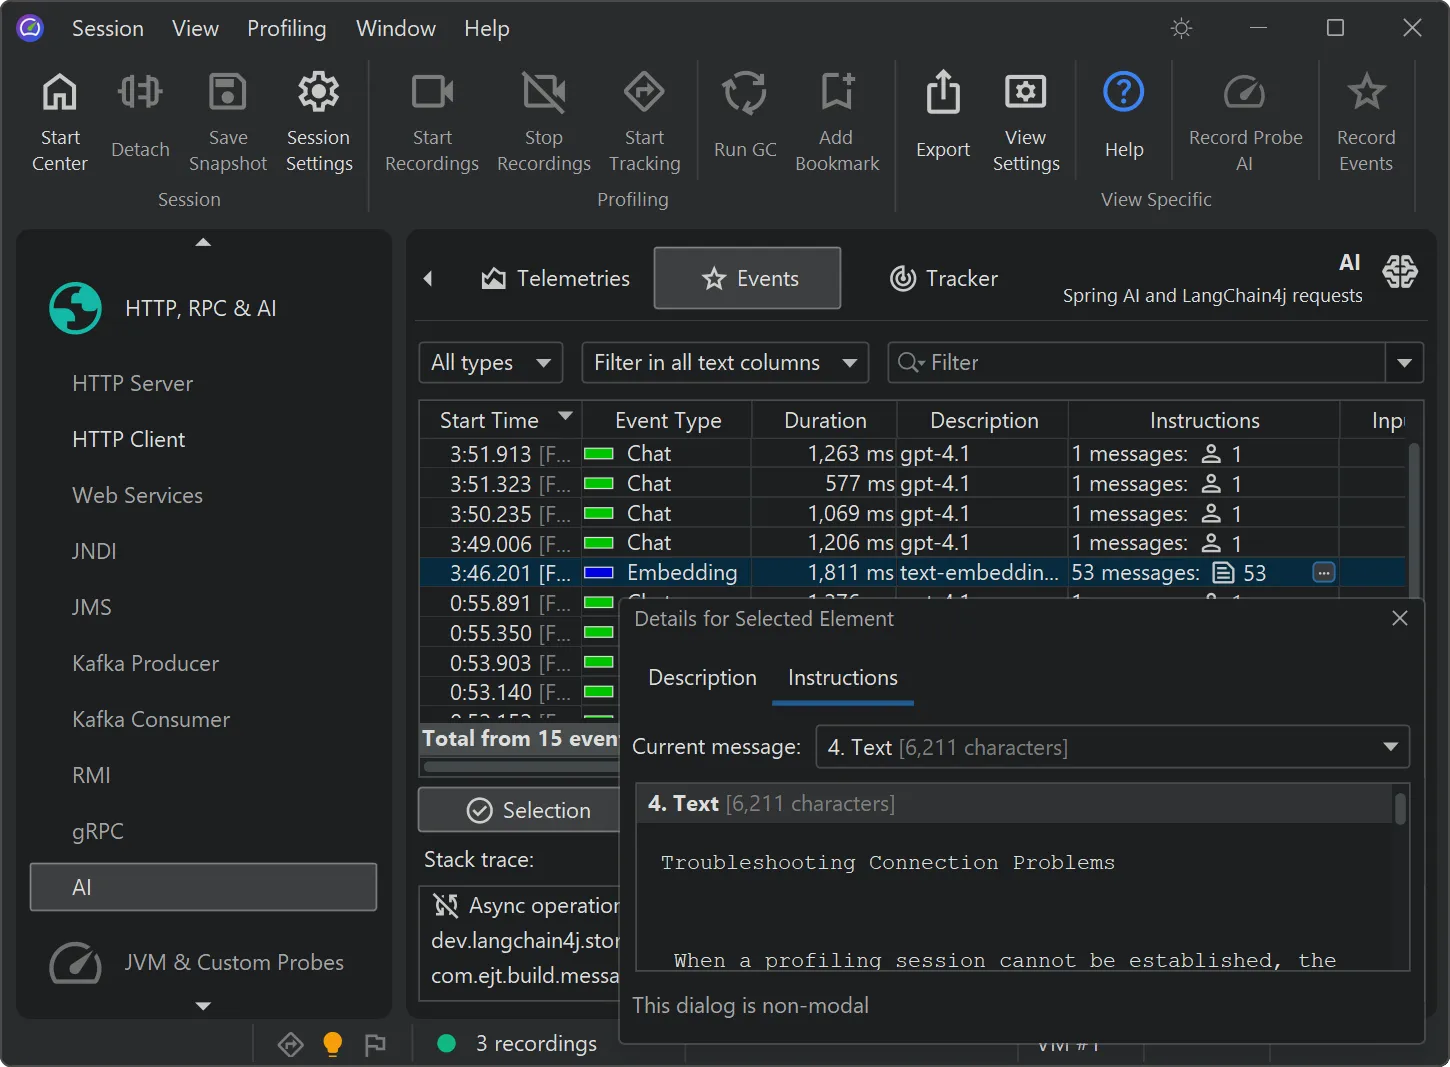
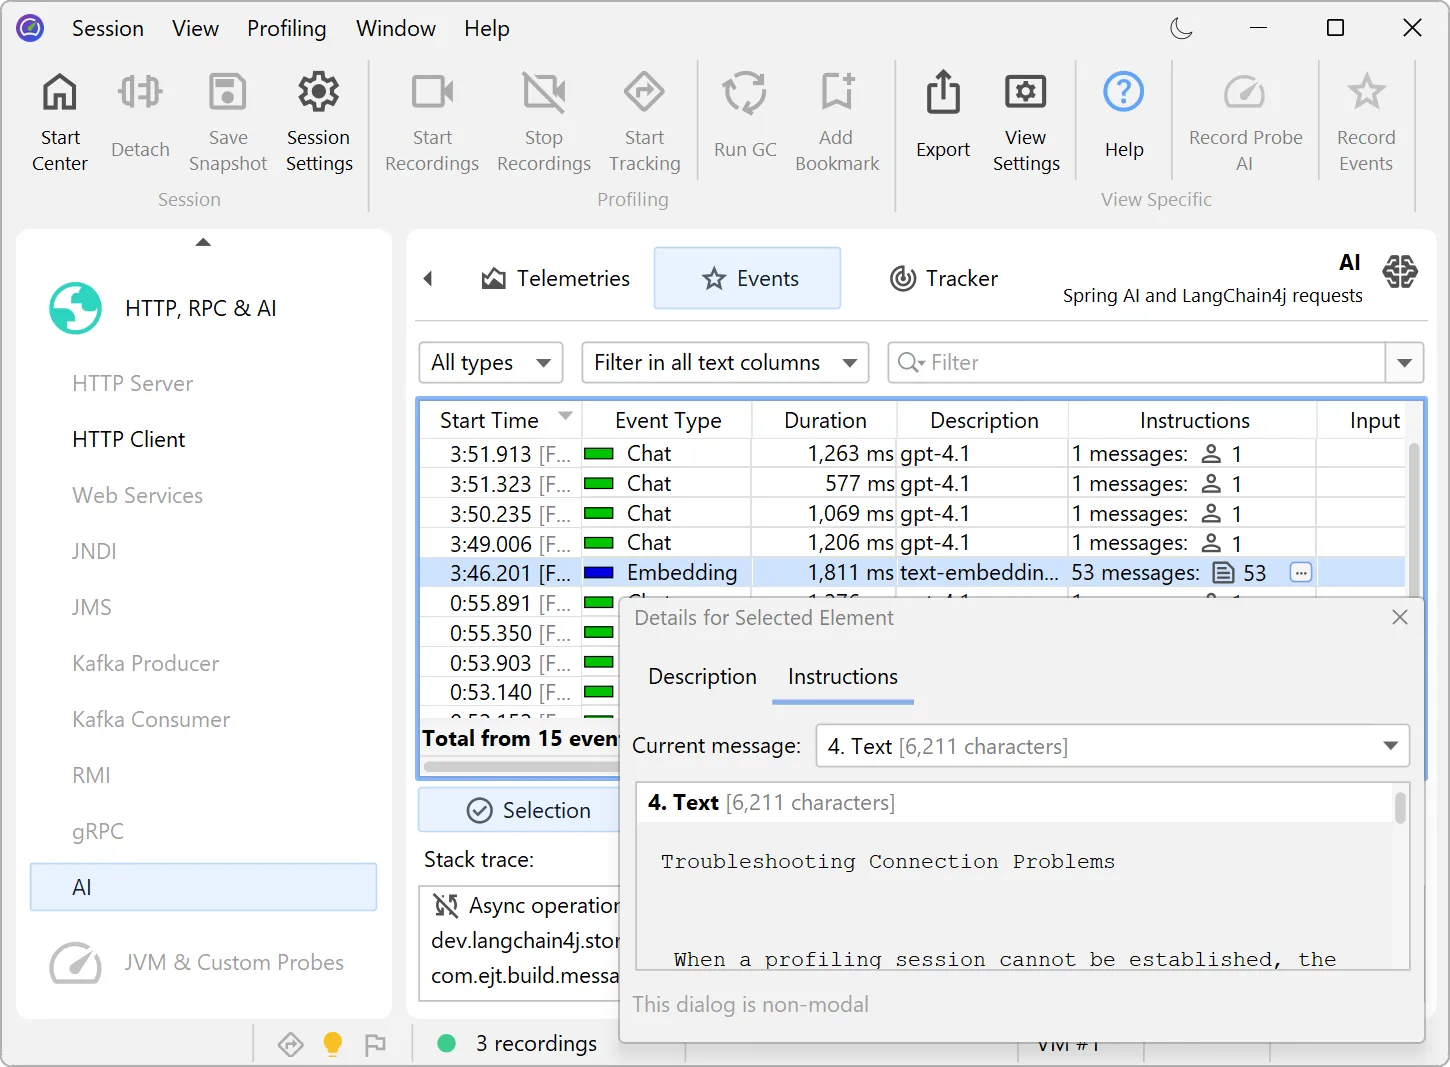
채팅 요청과 임베딩이 지원되며, 이벤트 뷰에 서로 다른 이벤트 유형으로 표시됩니다.
처리된 인스트럭션에 대한 상세 정보는 인스트럭션 열의 호버 버튼으로 표시할 수 있는 노드 상세 대화 상자에서 확인할 수 있습니다. 인스트럭션 열에는 사용자 메시지, 어시스턴트 메시지, 도구 메시지 같은 여러 인스트럭션 유형별 통계가 표시됩니다.
AI 프로브는 이벤트 중심으로 작동합니다. 기록된 이벤트의 부분 집합을 다루는 방법은 두 가지가 있습니다. 첫째, 여러 이벤트를 선택하면 하단의 선택 패널이 현재 선택 영역에 대한 CPU 핫스팟, 프로브 핫스팟, 프로브 콜 트리를 제공합니다.
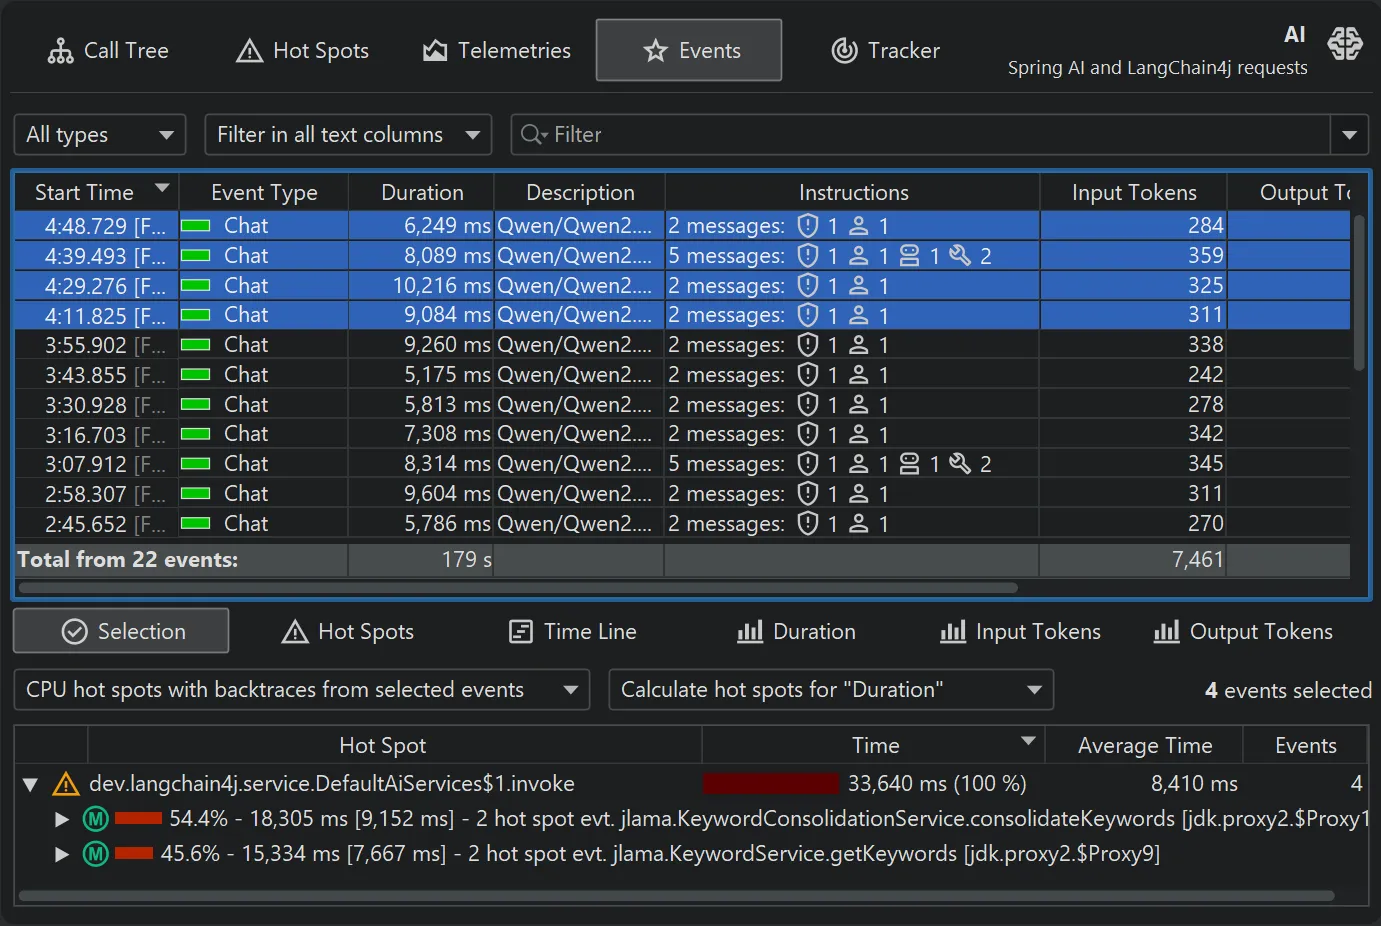
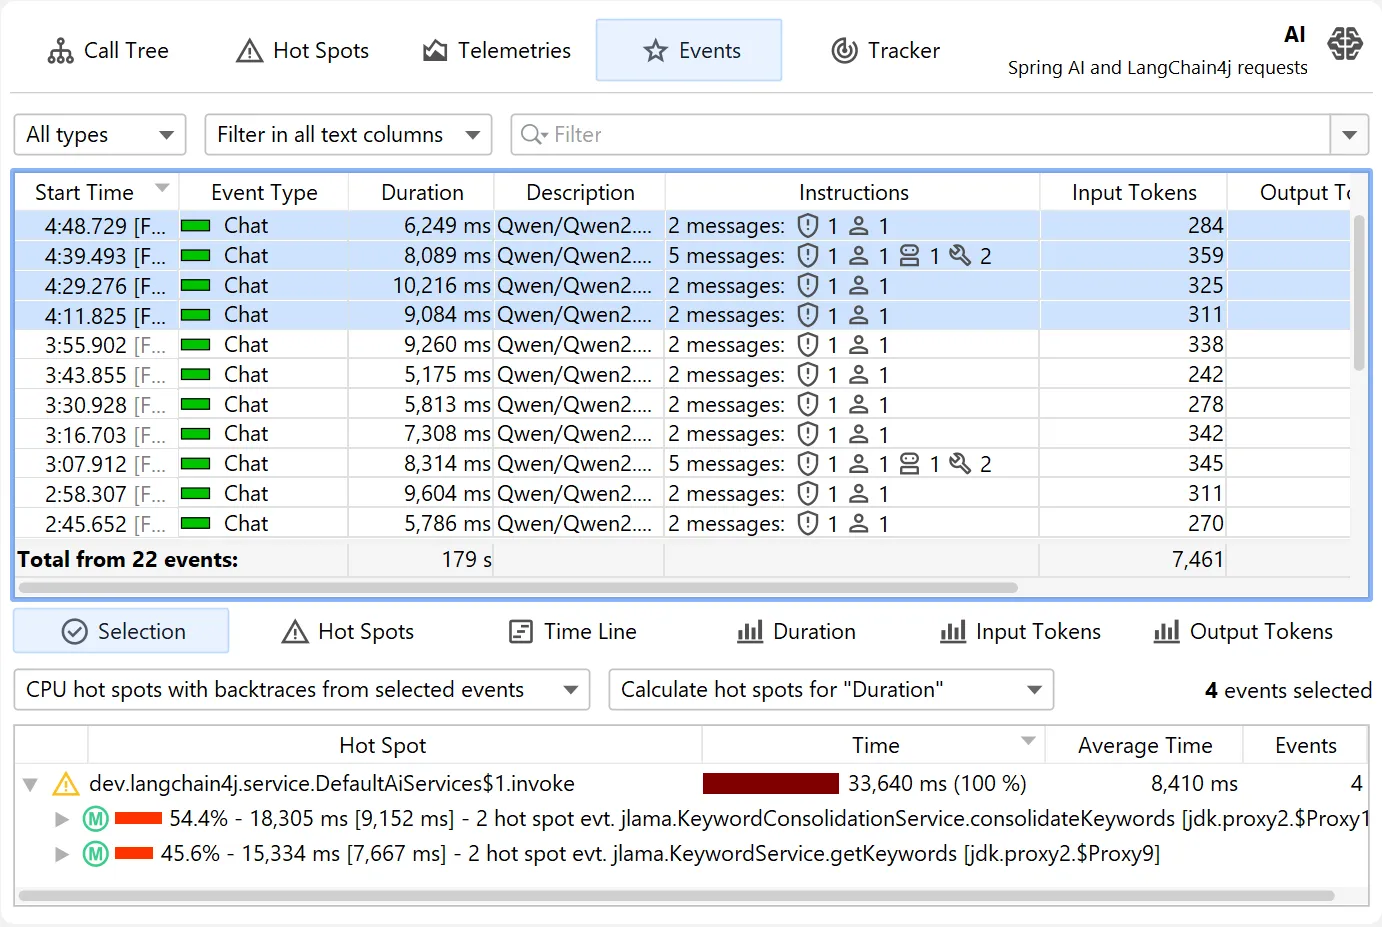
더 철저한 분석을 위해서는 상단의 필터 선택기와 하단 섹션의 여러 탭을 사용하여 메인 테이블과 관련 뷰에서 다룰 이벤트 집합을 제한할 수 있습니다.
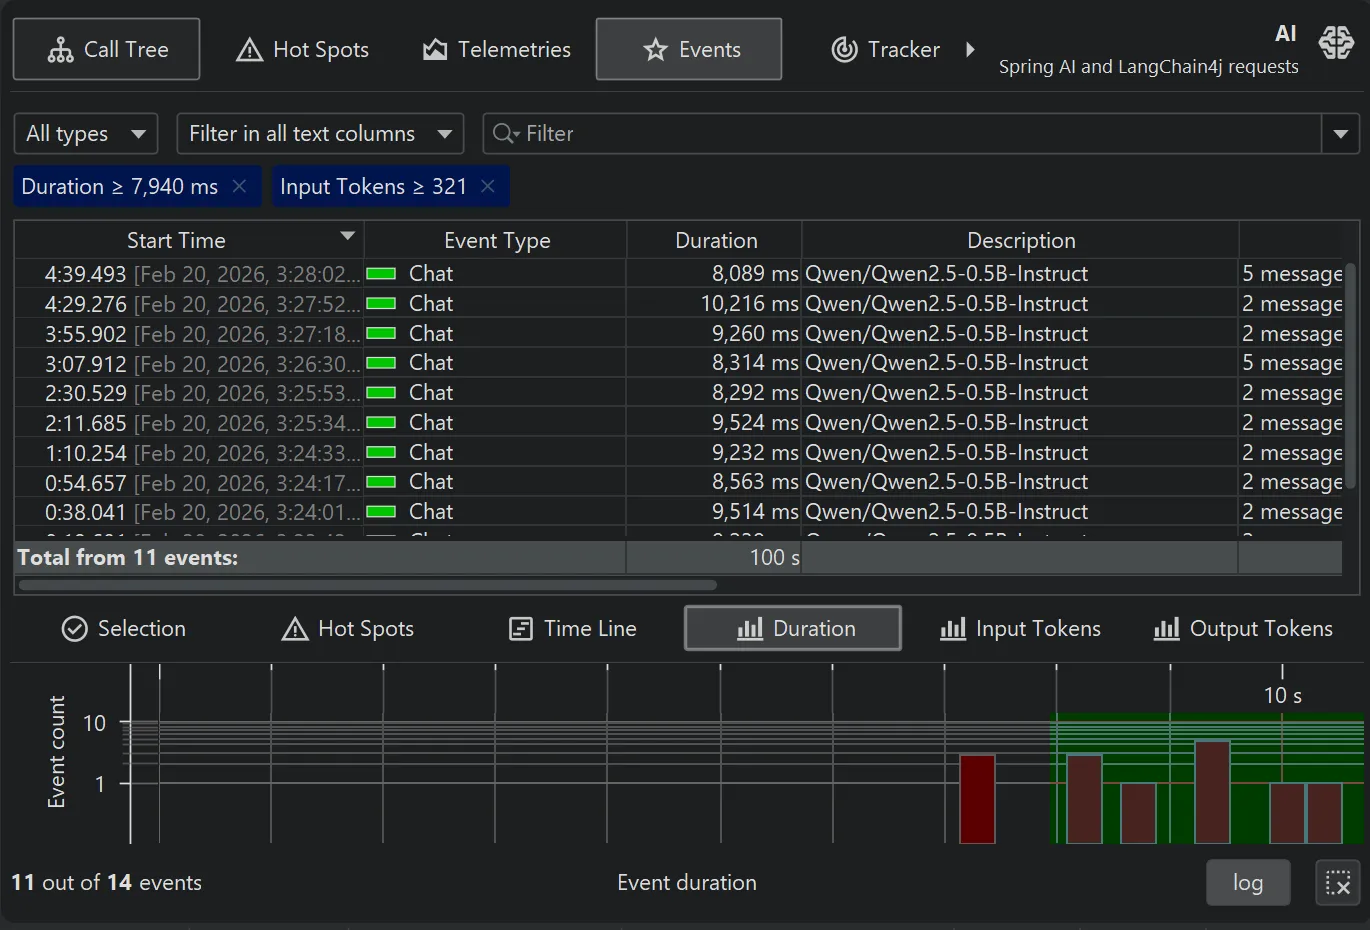
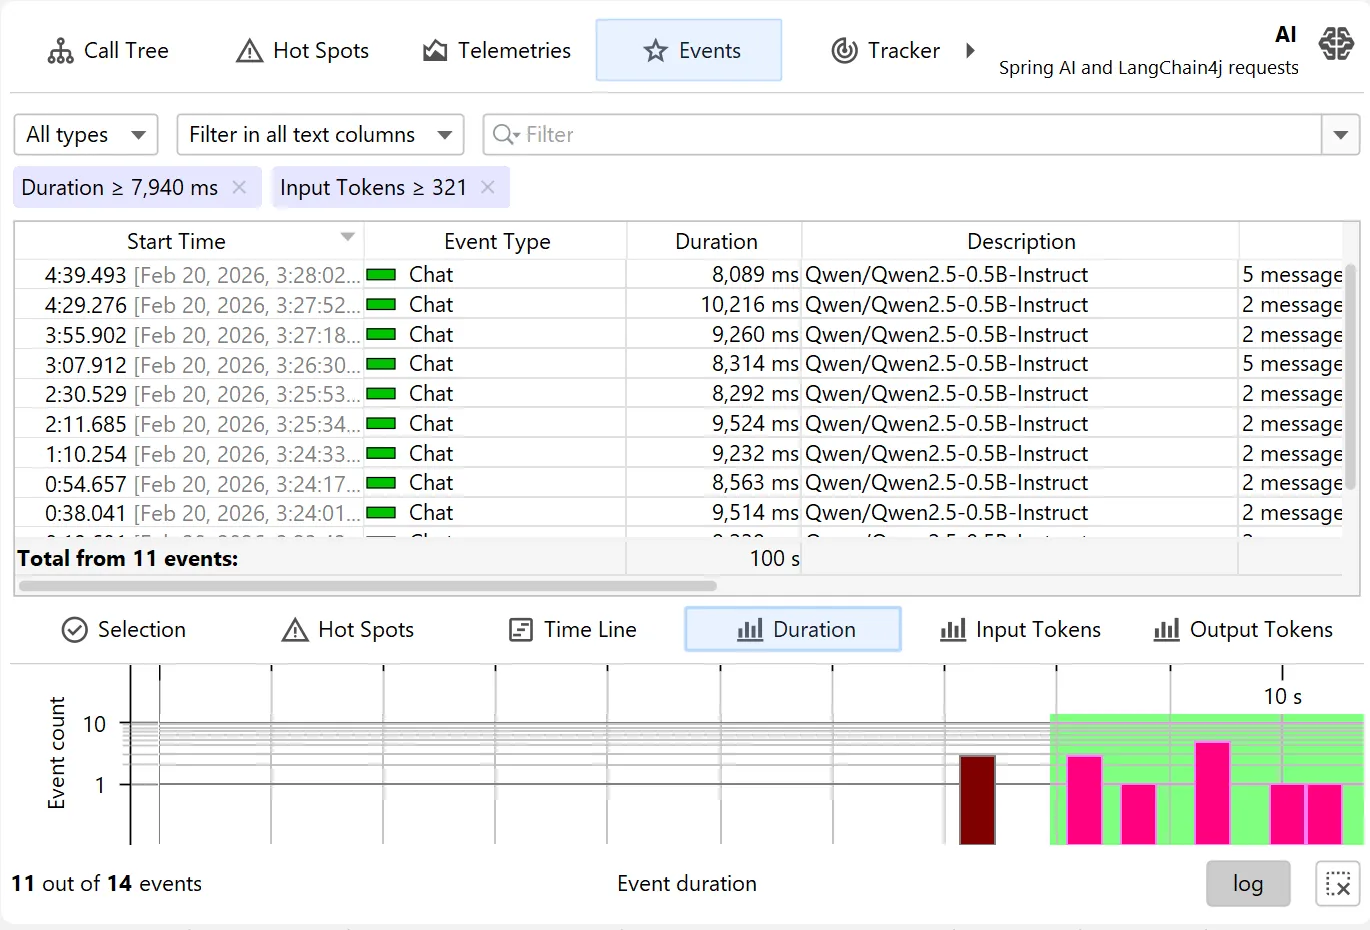
기본적으로 AI 프로브는 요청을 처리한 구체적인 모델 이름을 기준으로 핫스팟을 식별합니다. 이 데이터는 이벤트 뷰뿐만 아니라, 이벤트가 기록되지 않은 경우에도 AI 프로브의 핫스팟 뷰에서 확인할 수 있습니다.
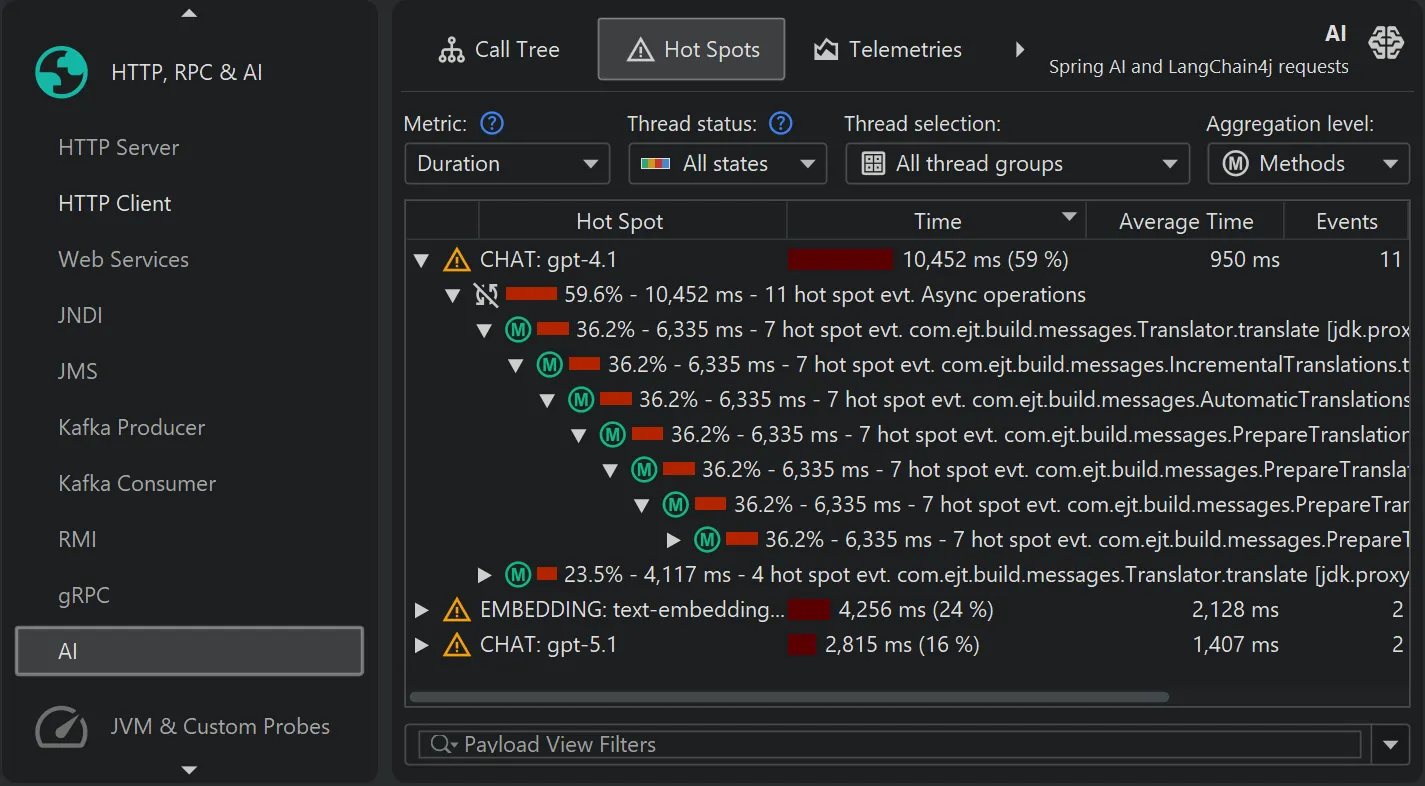
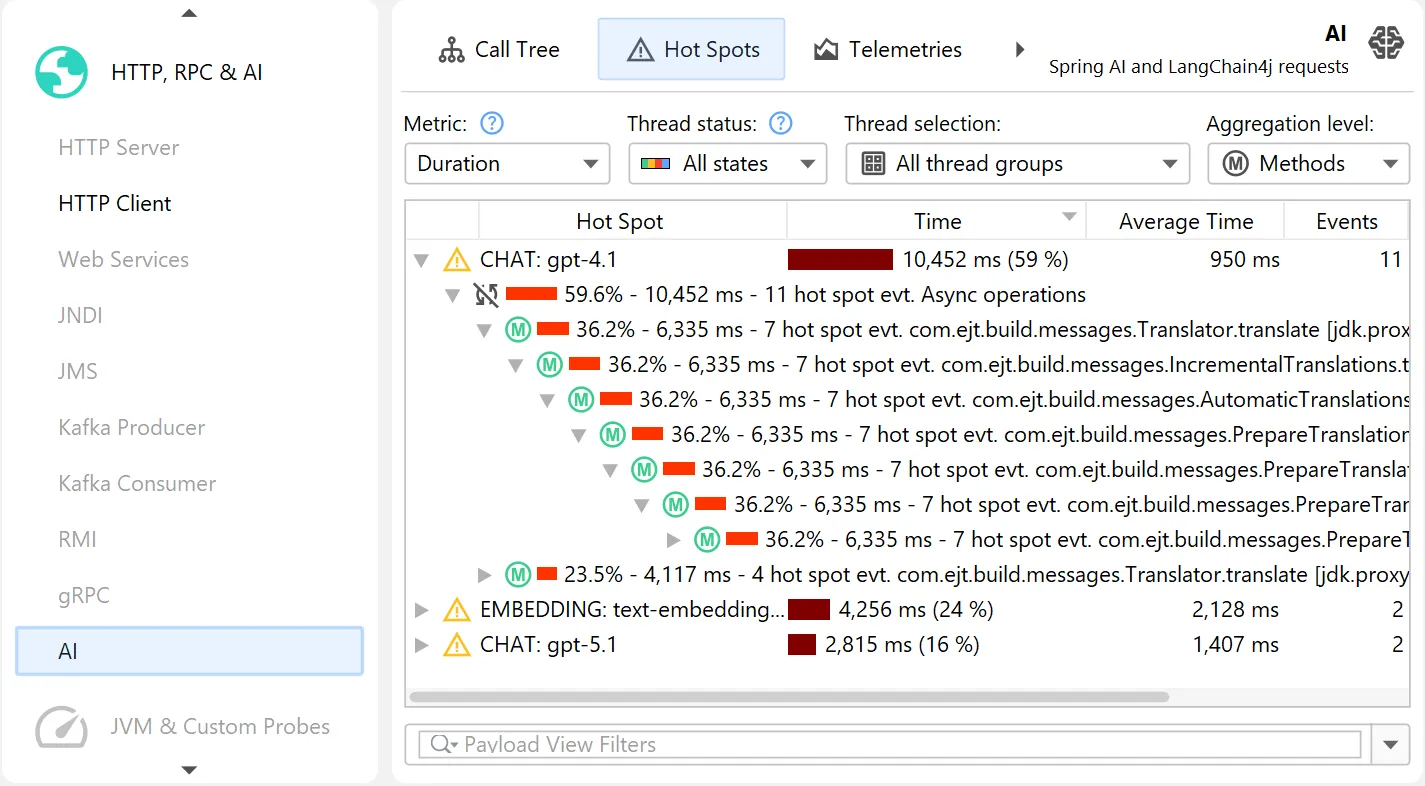
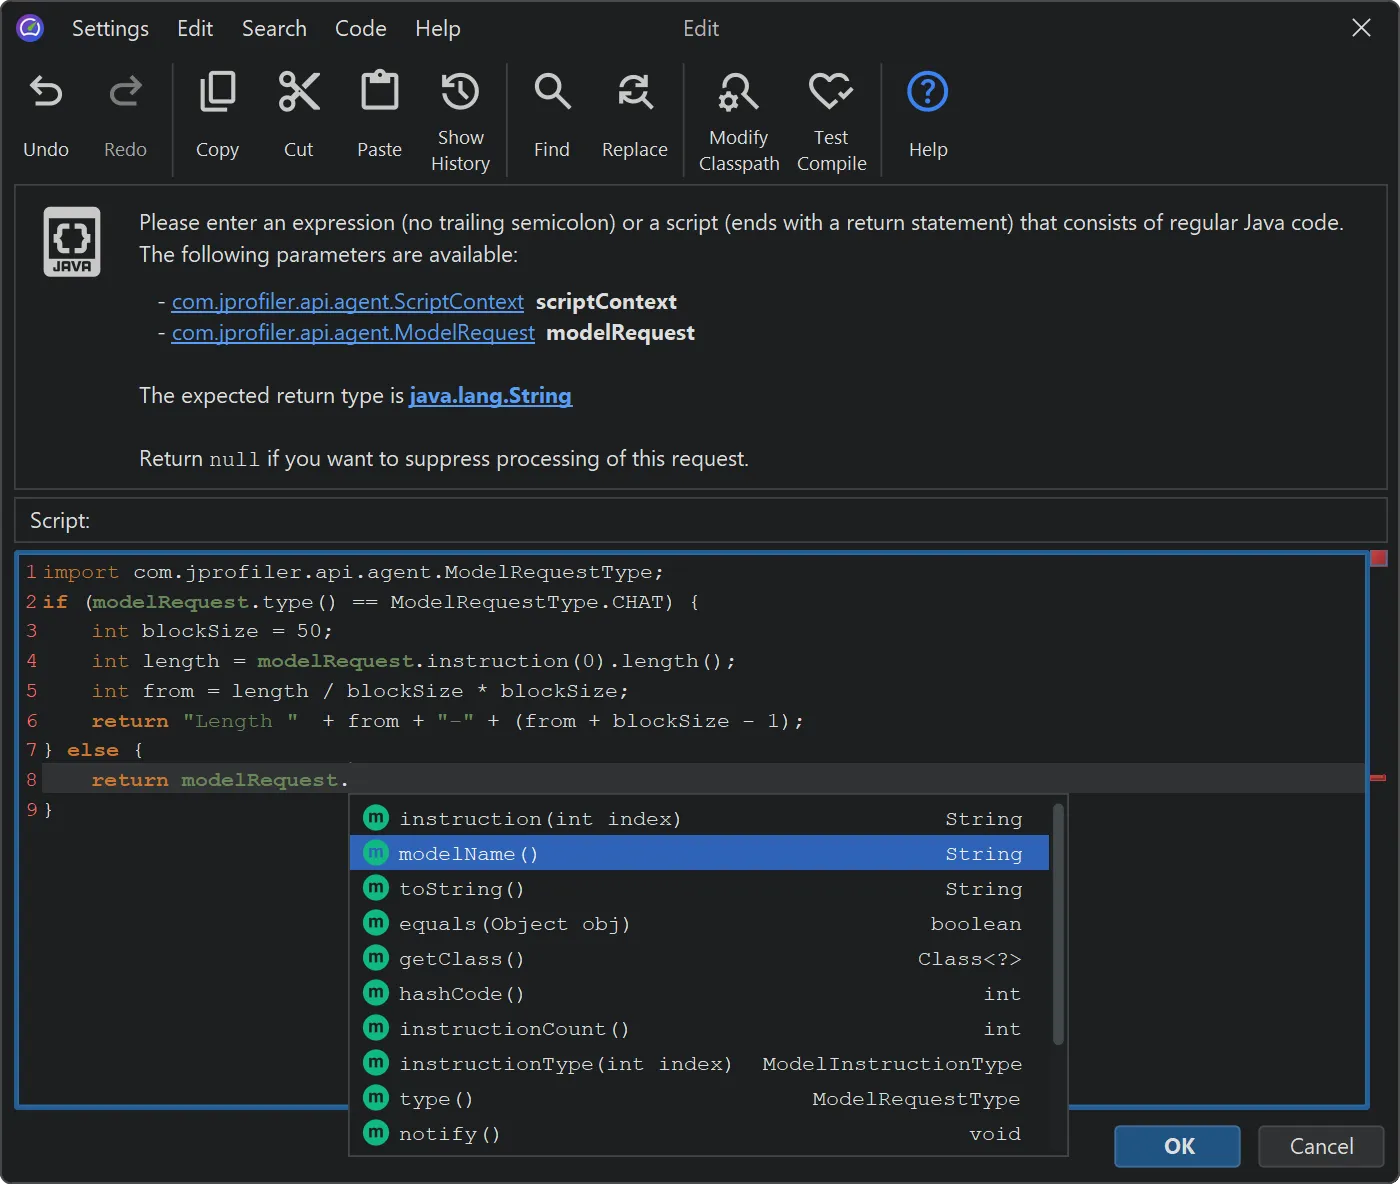
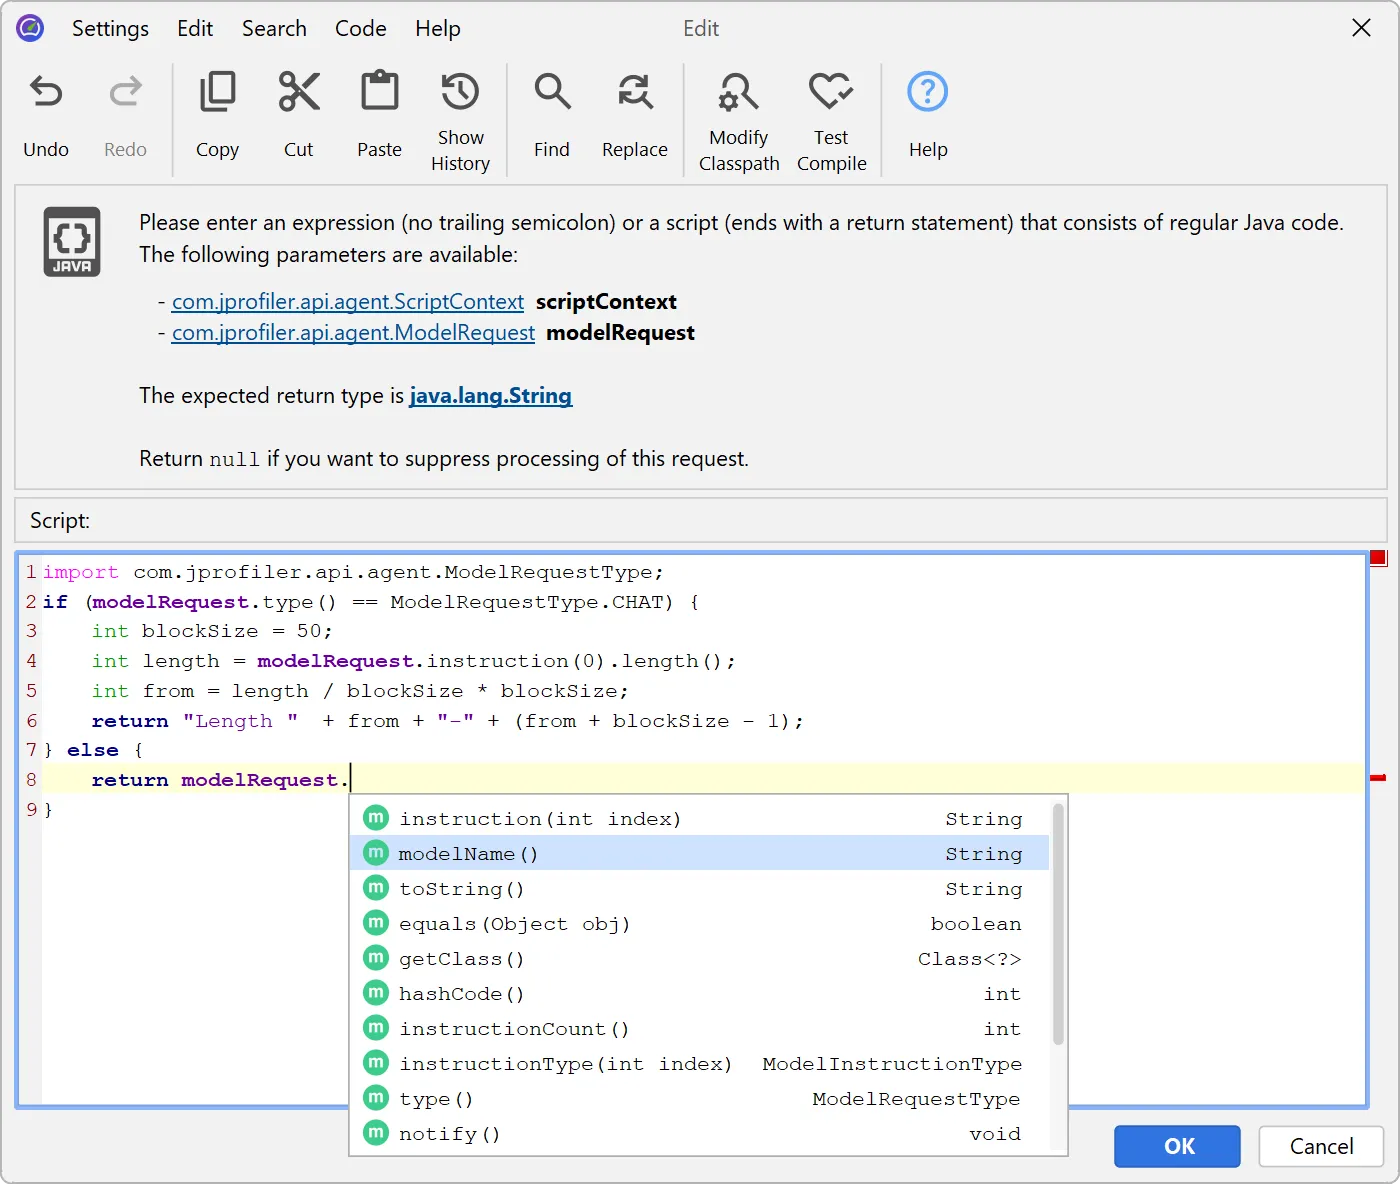
모델 이름 핫스팟은 잠재적으로 흥미로운 여러 핫스팟 유형 중 하나일 뿐입니다. 프로브 설정에서 JProfiler의 강력한 스크립트 편집기에 Java 코드를 입력하여 사용자 정의 핫스팟 유형을 계산하는 스크립트를 구성할 수 있습니다.
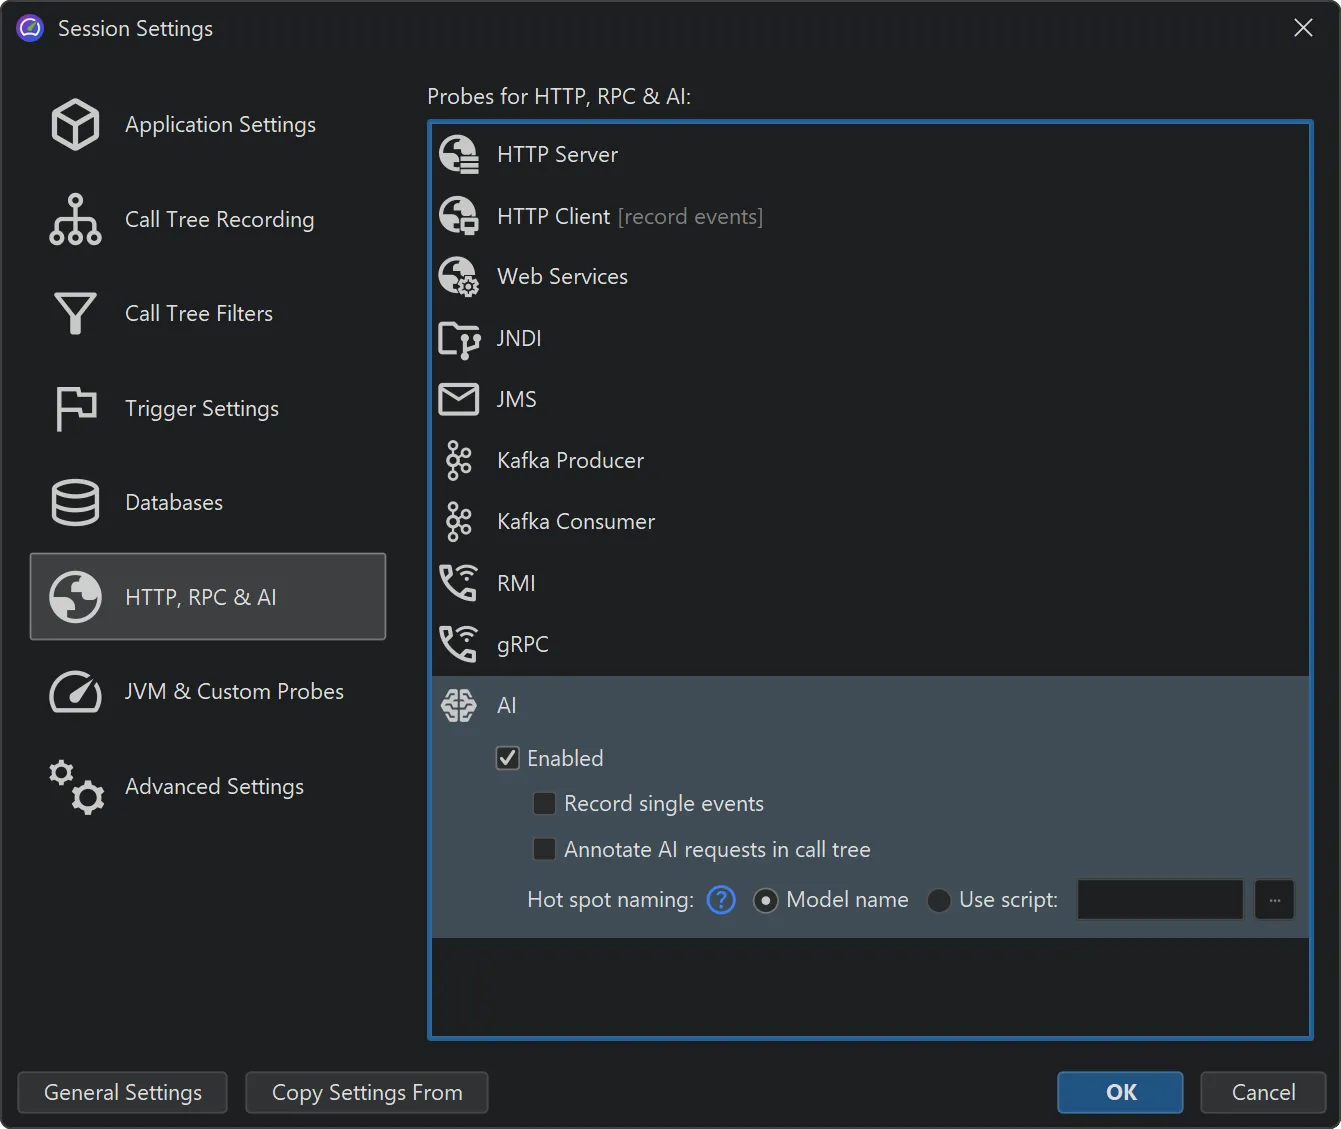
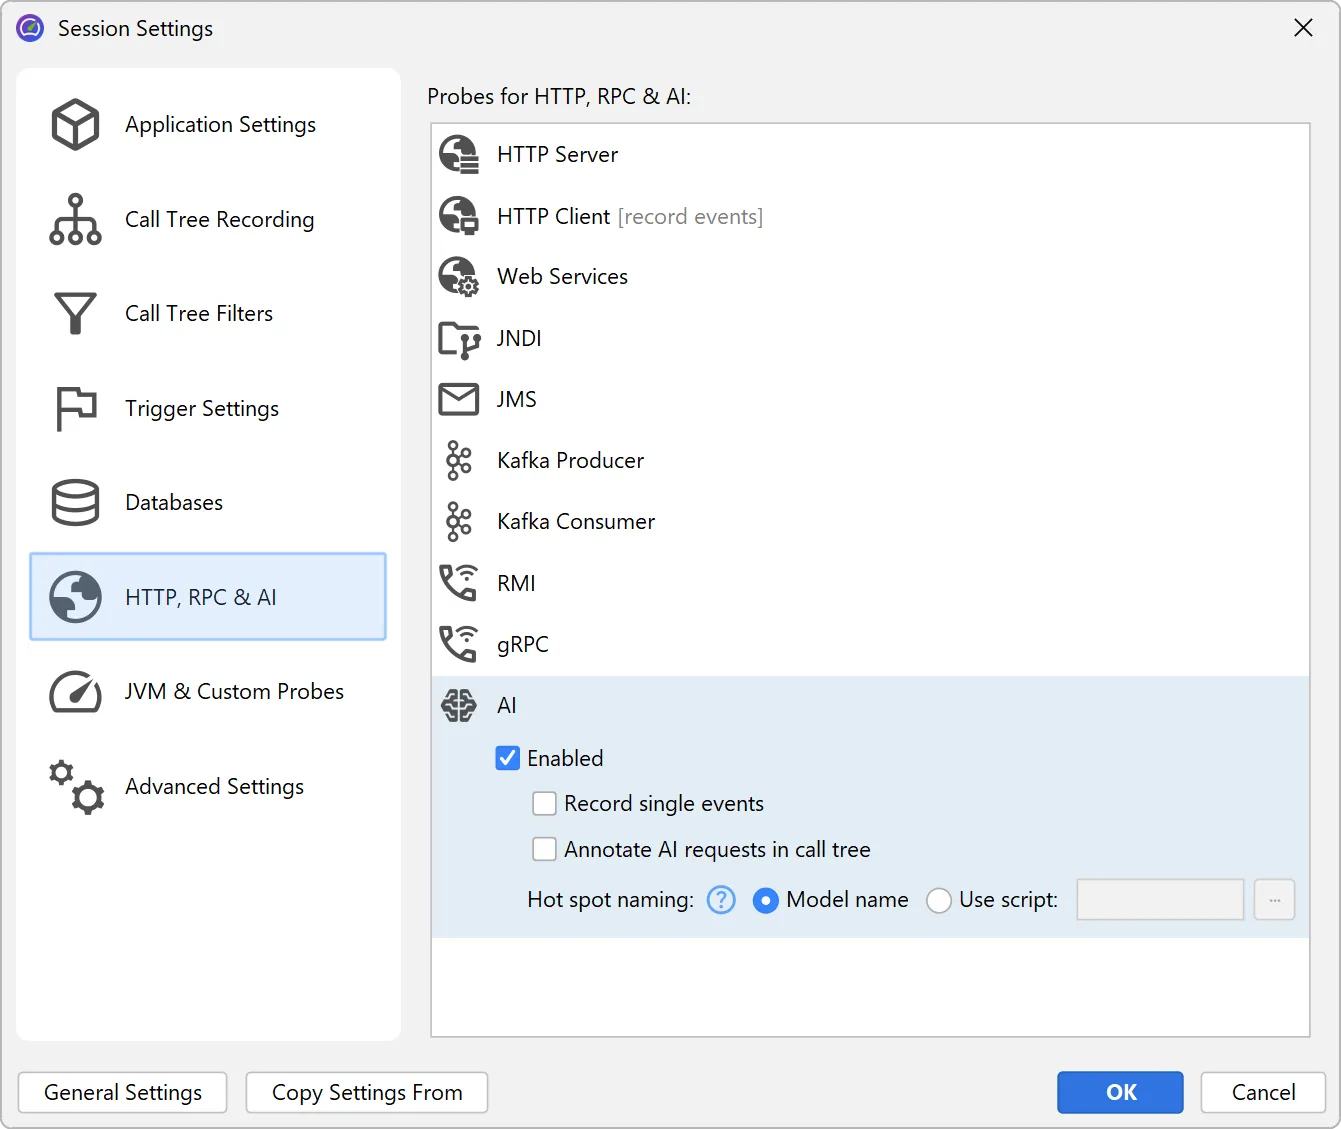
AI 프로브 이벤트가 기록되면 JProfiler는 ModelRequest 파라미터와 함께 이 스크립트를 호출합니다. 이 파라미터는 요청 유형, 모델 이름, 그리고 각 인스트럭션의 유형 정보가 포함된 모든 인스트럭션에 대한 접근을 제공합니다.
예를 들어 프롬프트 길이를 50자 단위의 버킷으로 묶어 핫스팟을 정의할 수 있습니다. 아래 예제는 그 과정을 보여 줍니다.
JProfiler는 기록 중에도 데이터를 실시간으로 표시하므로, 프로파일링하는 동안 이러한 설정을 변경하고 그 효과를 즉시 확인할 수 있습니다.
위의 스크립트를 적용하면 새로운 핫스팟은 다음과 같이 표시됩니다:
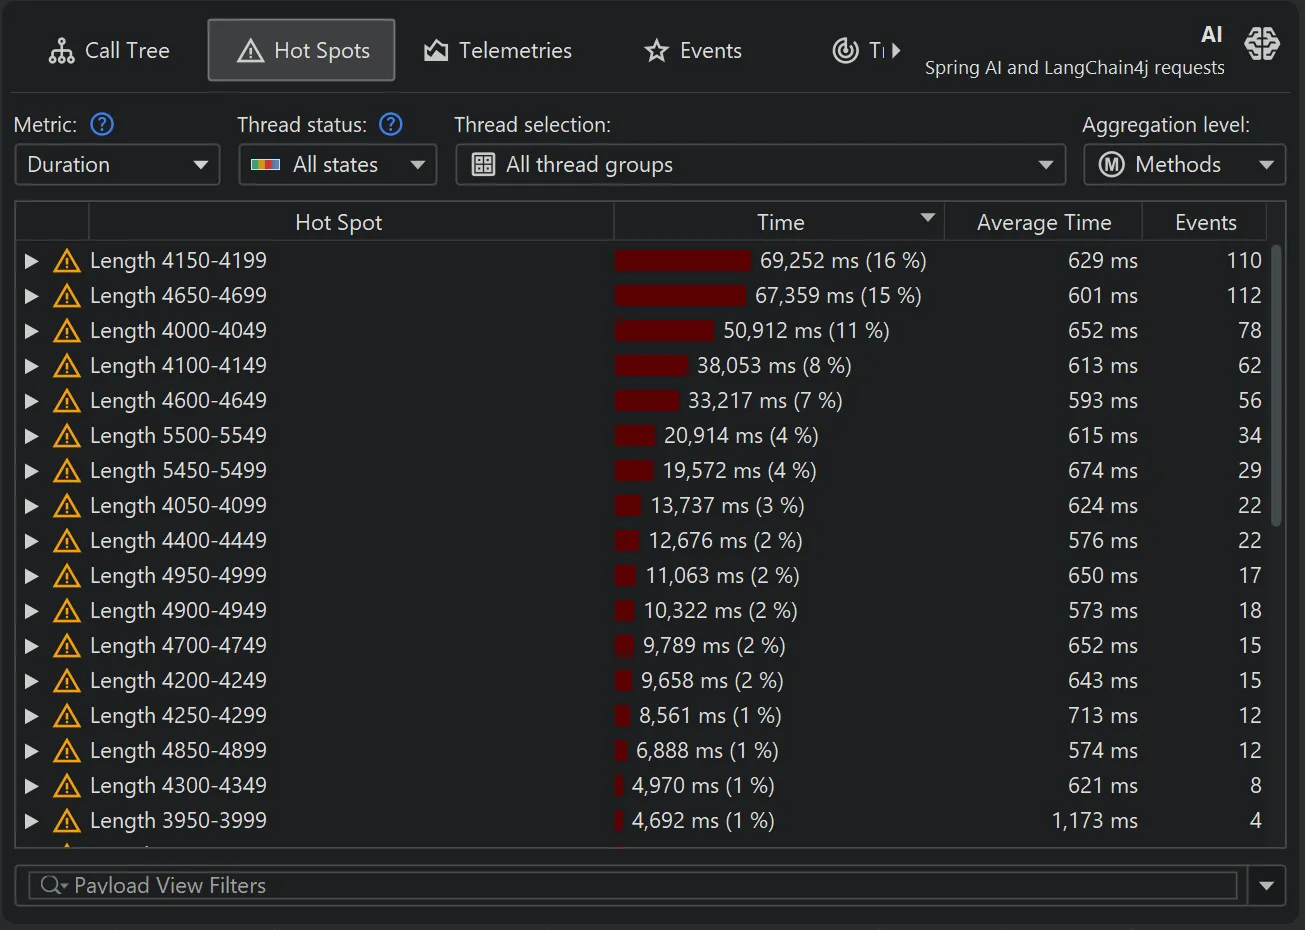
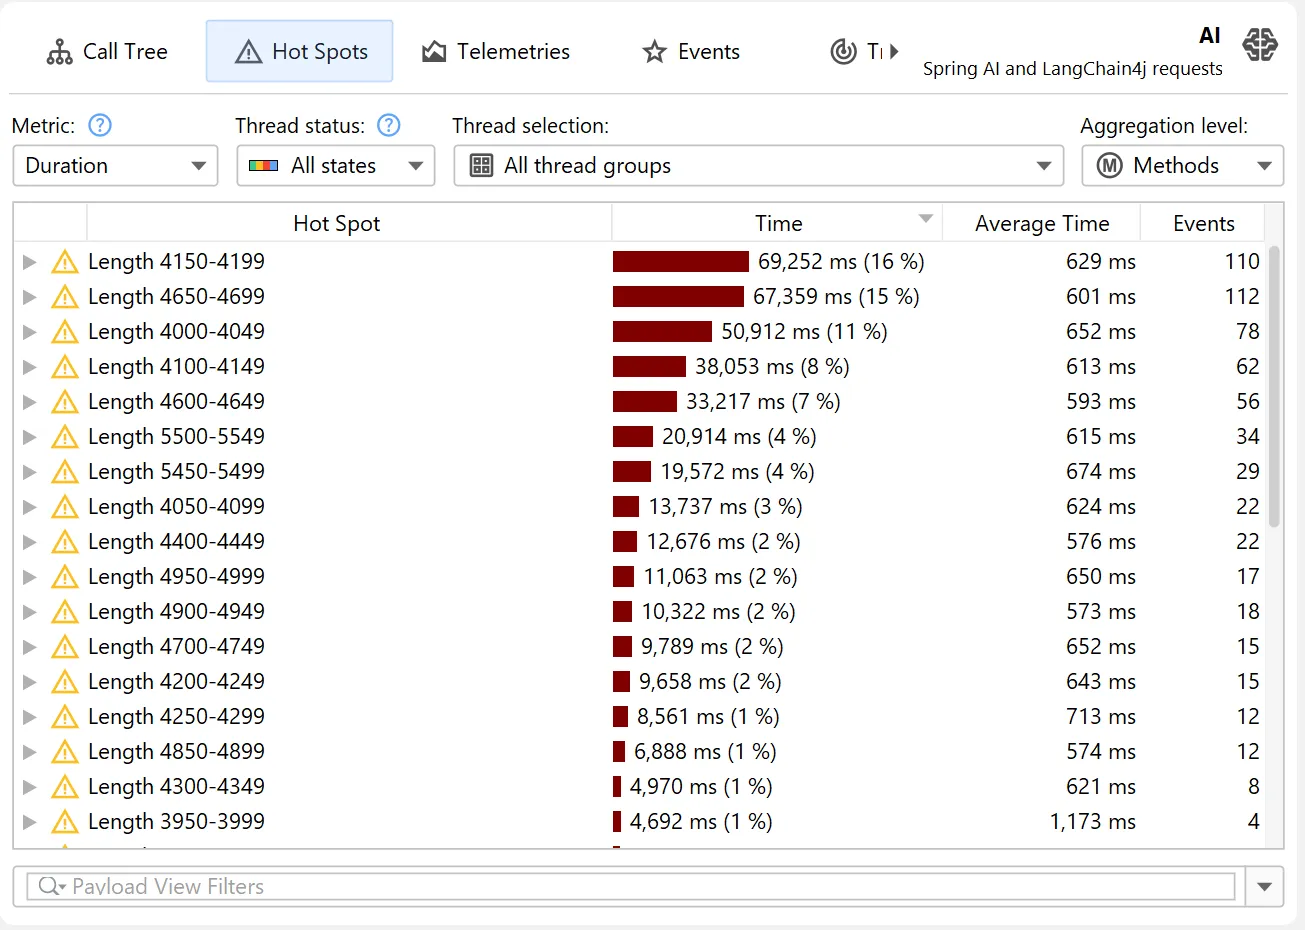
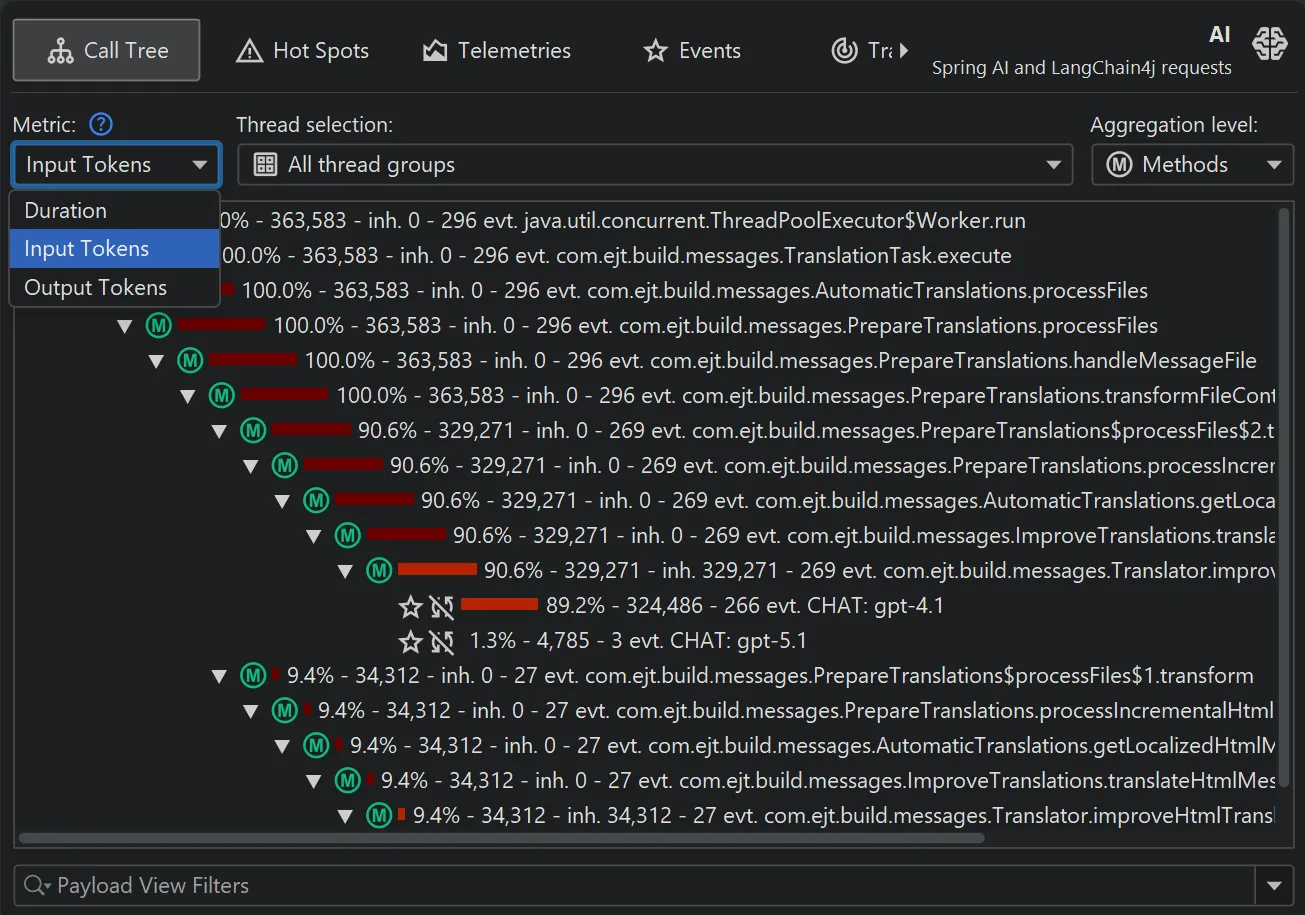
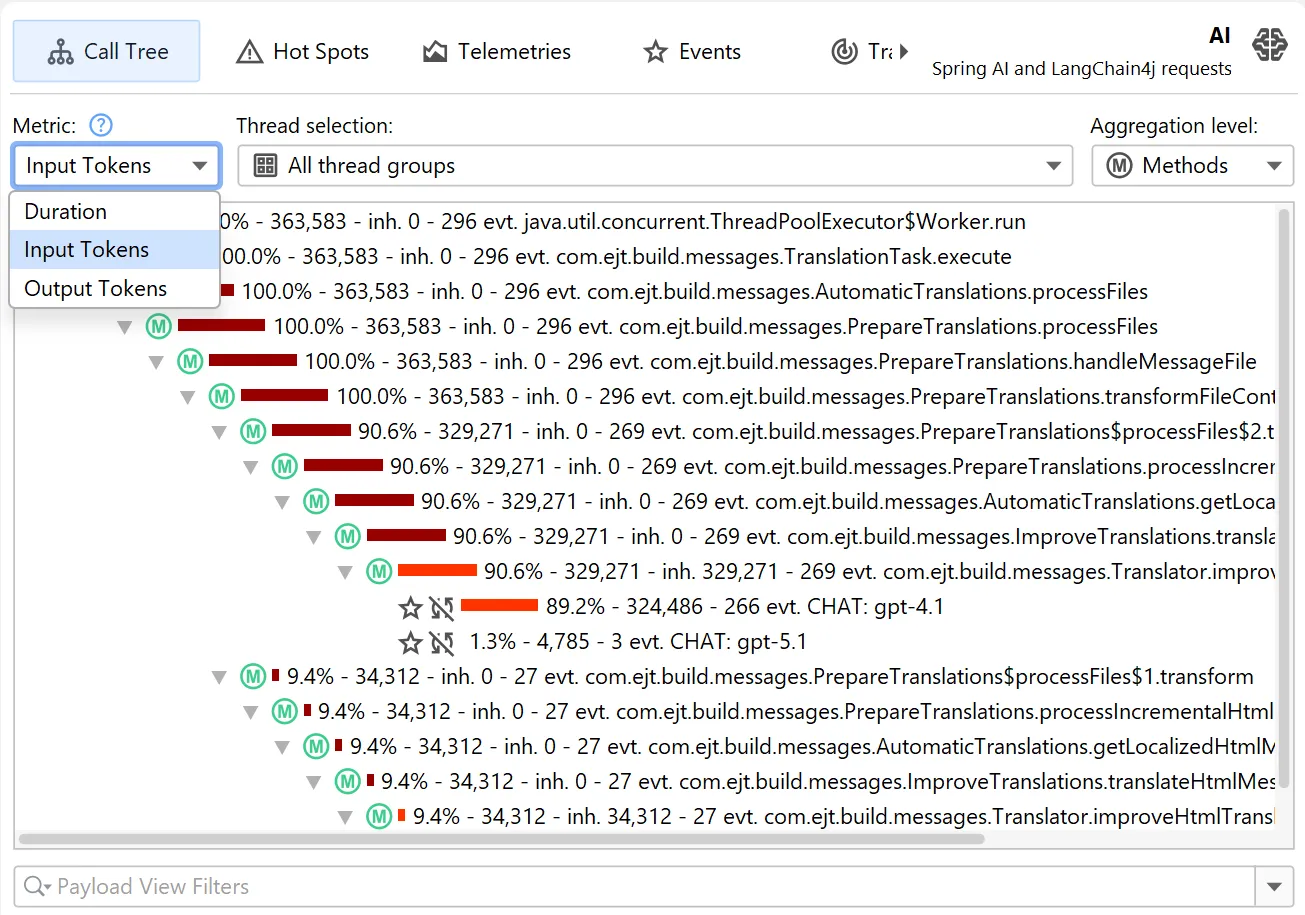
기본적으로 핫스팟은 요청 지속 시간에 초점을 맞추지만, 기본 측정값을 입력 토큰과 출력 토큰으로 전환할 수도 있습니다.
이는 프로브 핫스팟 뷰와 프로브 콜 트리 뷰 모두에서 가능합니다. 프로브 콜 트리 뷰는 메서드 호출을 프로브 페이로드와 연결하는 탑다운 뷰를 보여 줍니다.
AI 프로브의 프로브 텔레메트리는 채팅 요청과 임베딩 요청별로 요청 횟수, 평균 요청 지속 시간, 입력/출력 토큰 통합 그래프를 각각 표시합니다.
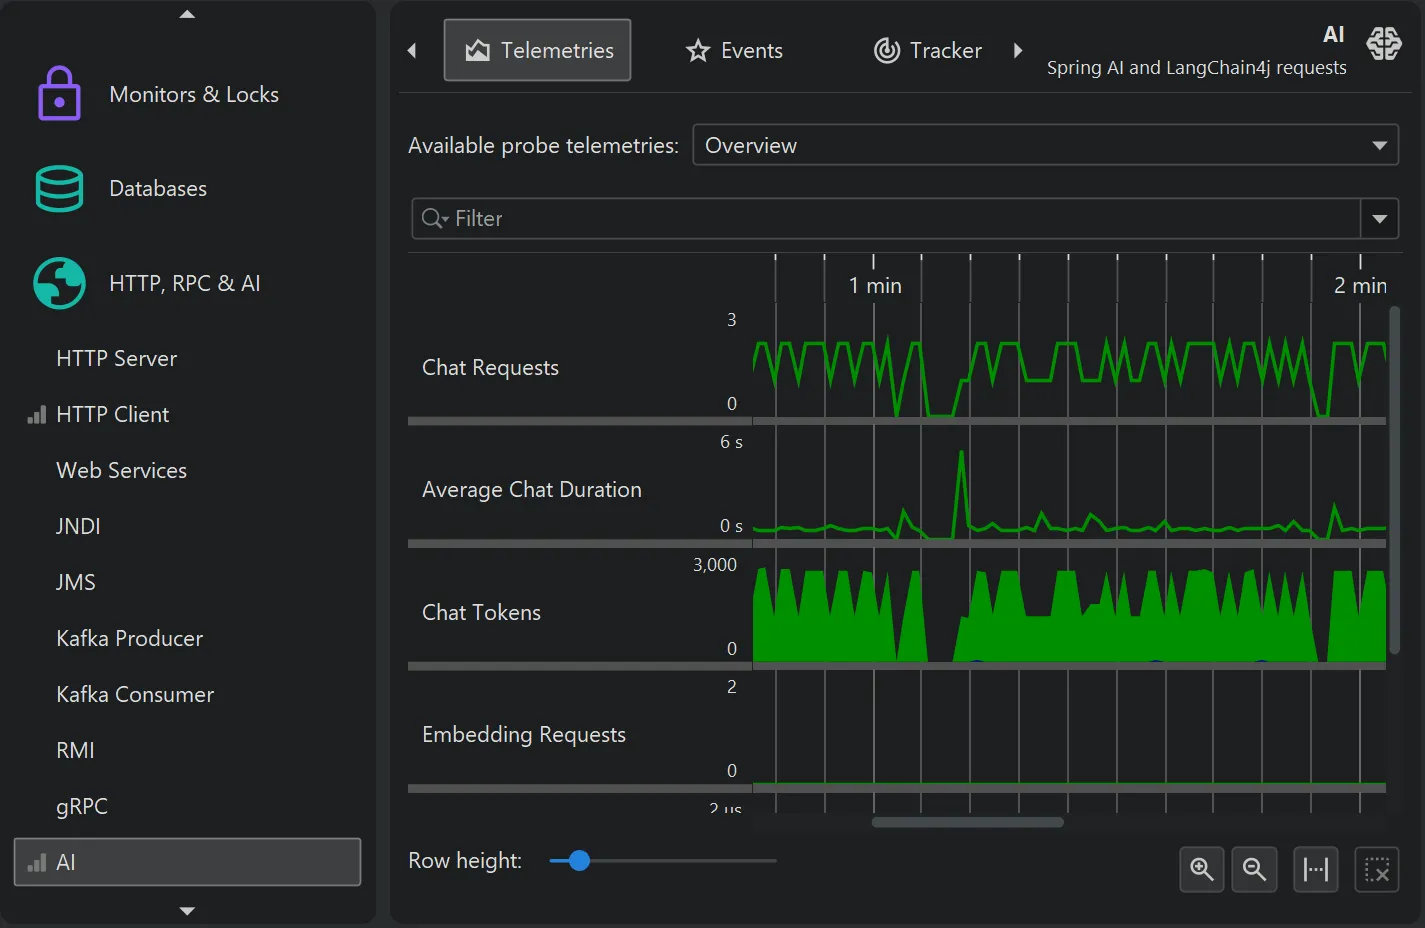
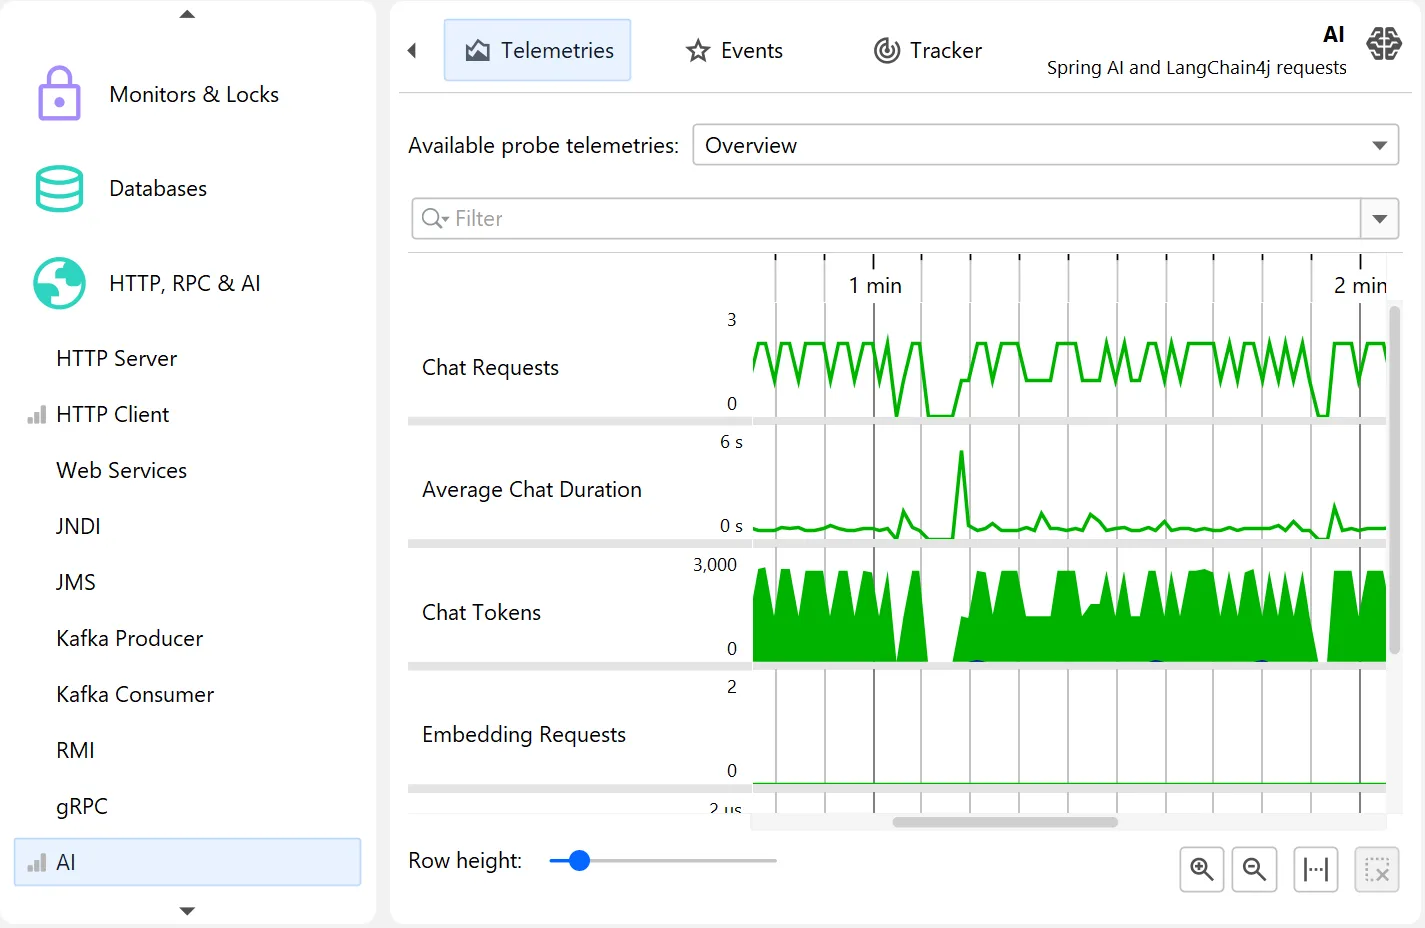
각 텔레메트리는 개별적으로 표시할 수 있으며, 특정 관심 영역에 해당하는 이벤트를 선택하는 데 사용할 수 있습니다.
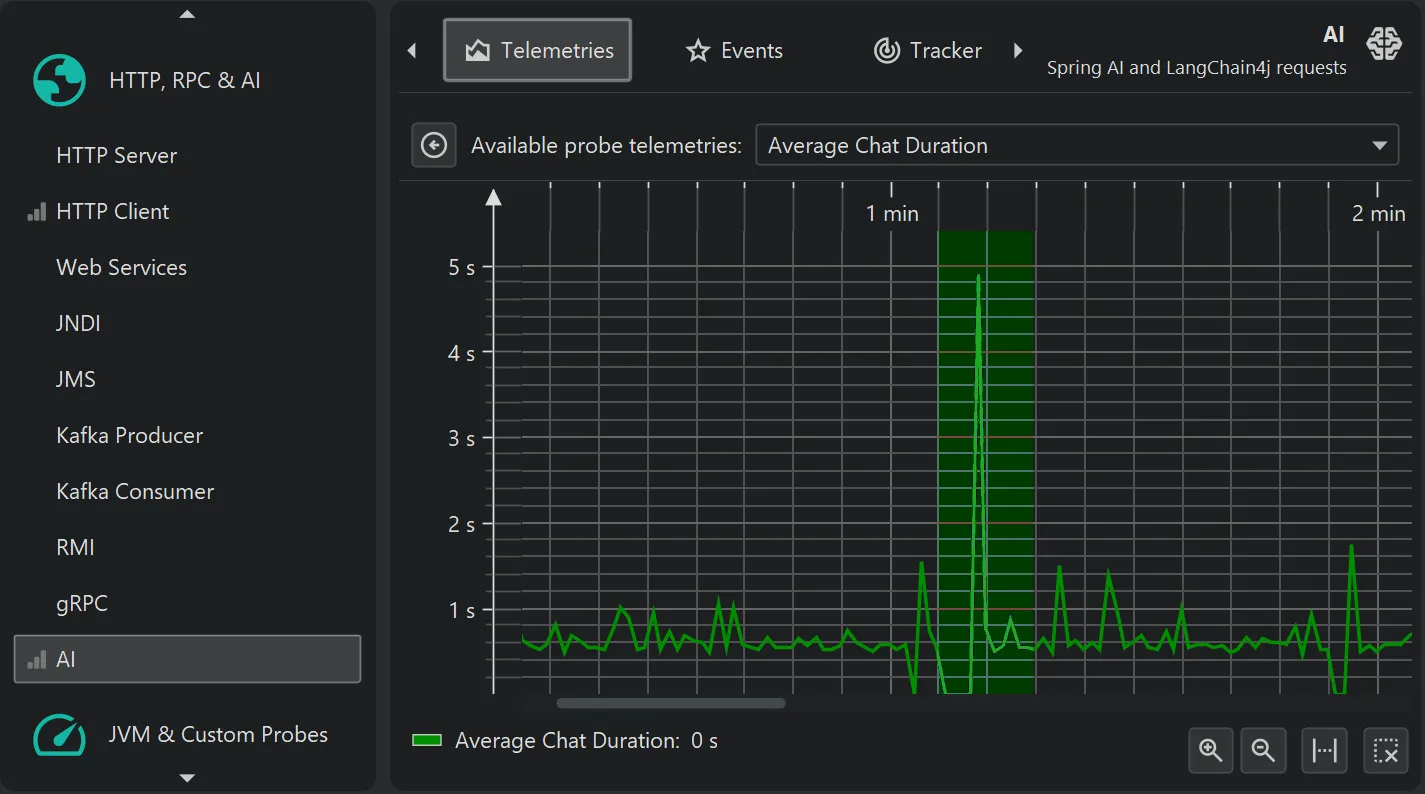
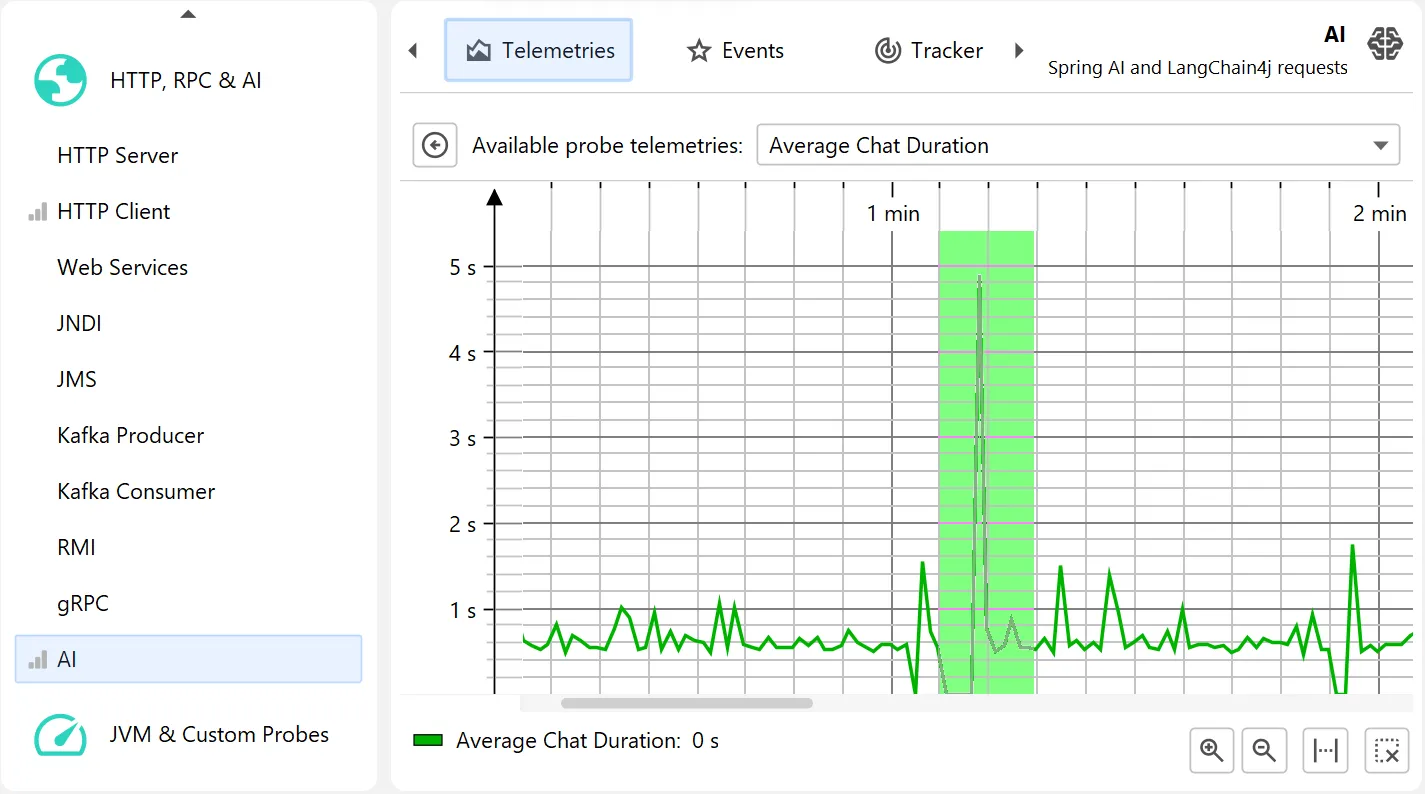
AI 프로브를 둘러볼 수 있도록 JProfiler에 이제 "LLM 데모" 세션이 포함됩니다.
이 세션은 Java 21+용 크로스 플랫폼 추론 엔진인 Jlama를 사용하며, Hugging Face에서 5억 파라미터 규모의 모델을 다운로드하여 arXiv의 LLM 관련 프리프린트를 분류합니다.
데모에는 LLM이 생성한 키워드가 계속 삽입되는 UI가 마련되어 있고, 오른쪽에서 관련 연구 논문을 살펴볼 수 있습니다.
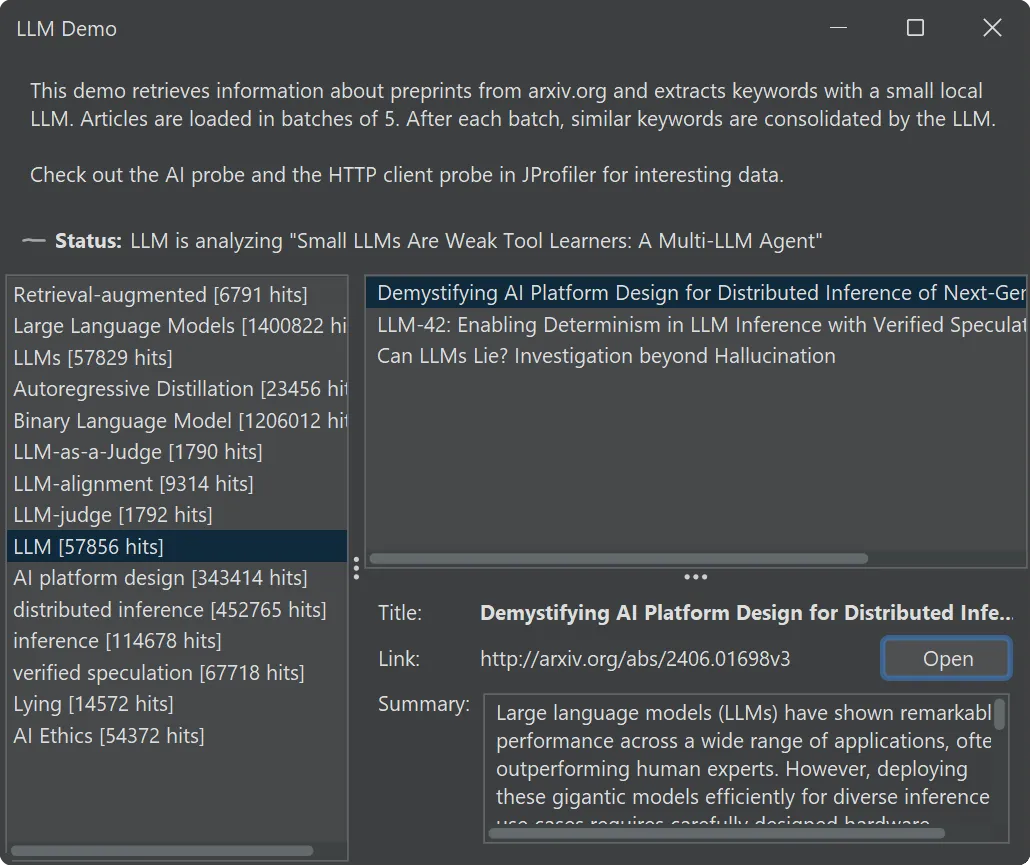
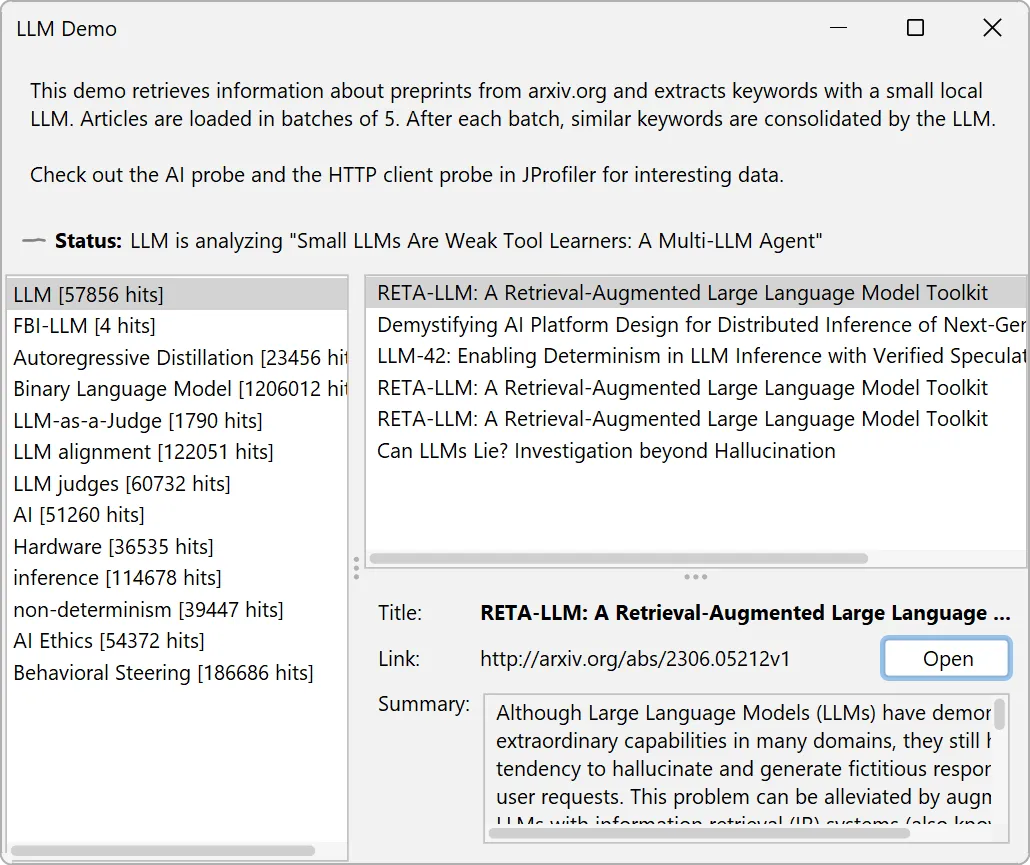
JProfiler에는 새로운 UI가 적용되었습니다. 모던한 비주얼 스타일과 새로운 아이콘이 그 결과입니다. 마음에 드시길 바랍니다! 라이트 테마와 다크 테마가 제공되며, 이 페이지 상단의 다크 모드 스위치를 전환하면 각 테마의 스크린샷을 볼 수 있습니다.
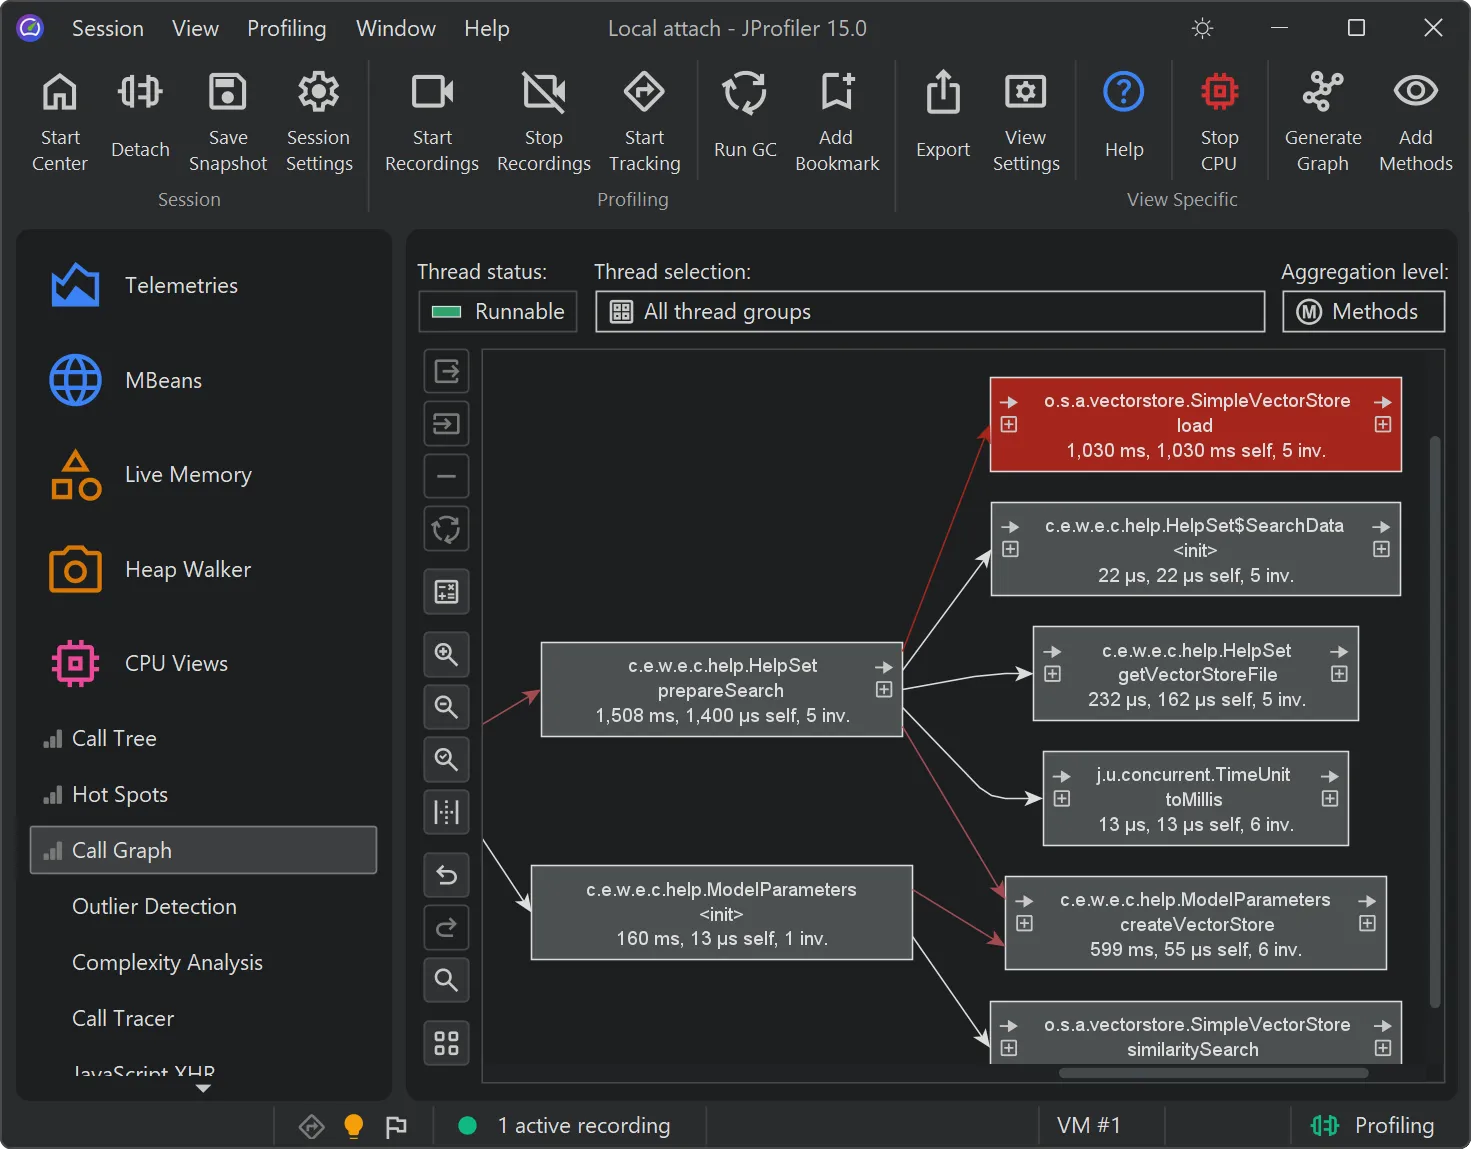
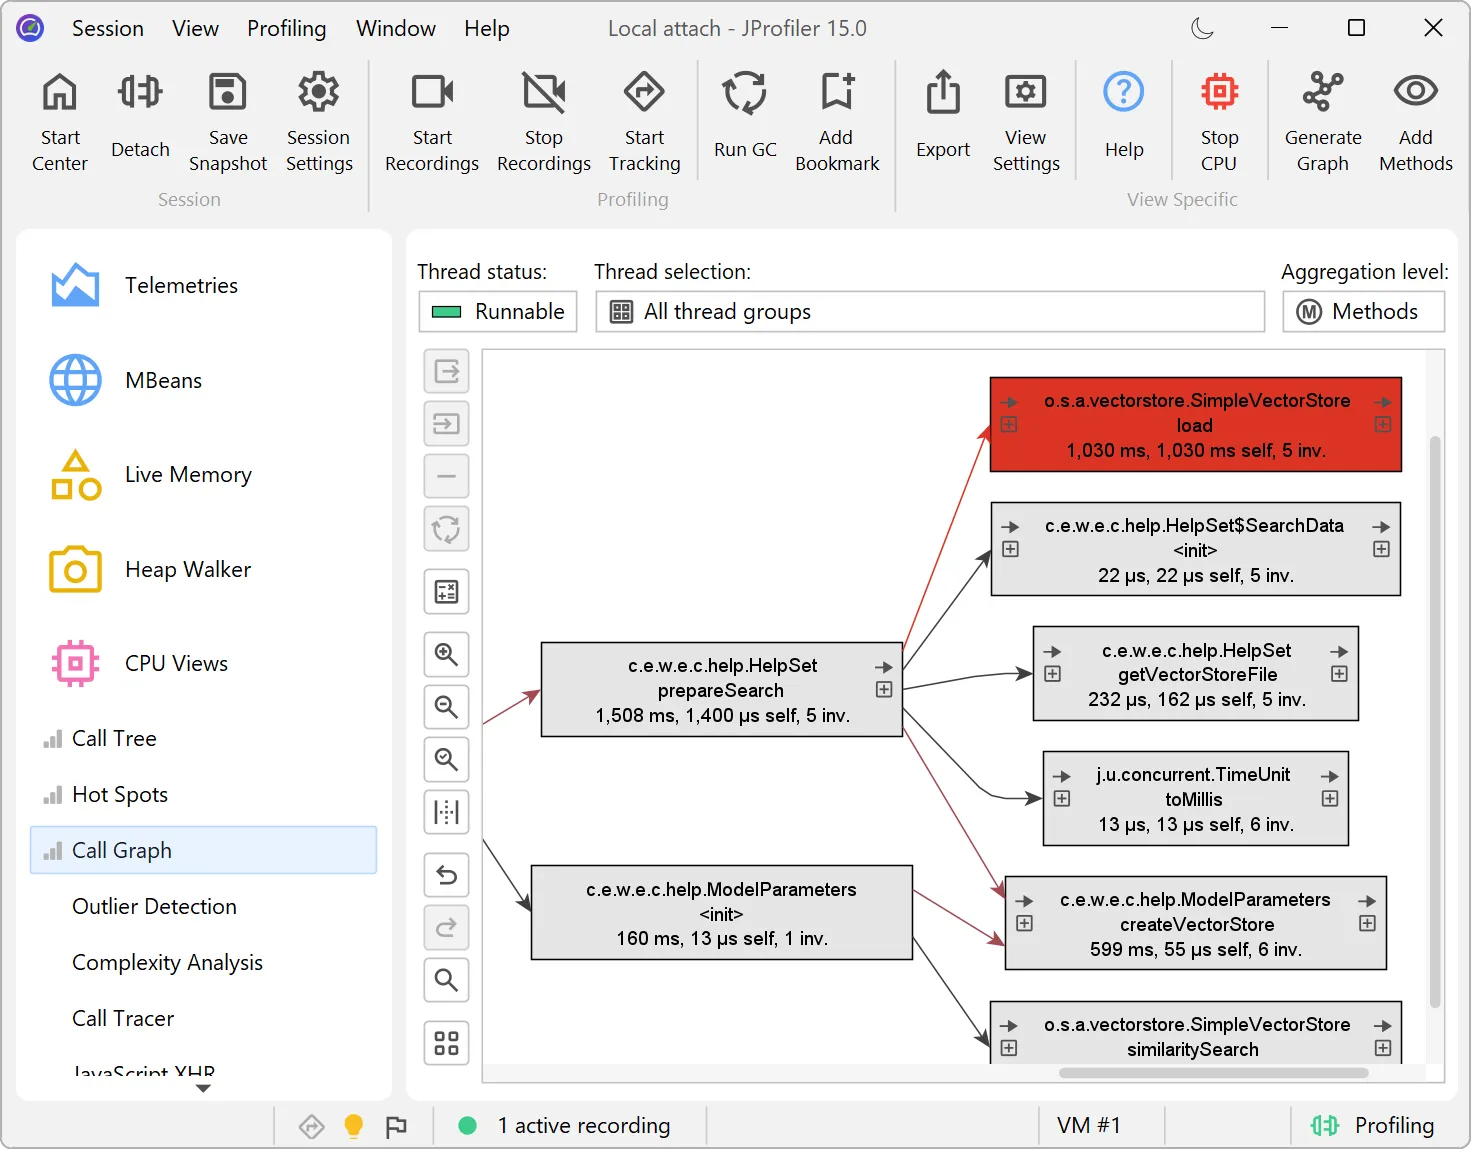
게다가 UI가 이제 완전하게 확장 가능합니다. 일반 설정에서 백분율 단위의 배율 인수를 지정하거나 임의의 크기를 가진 사용자 지정 UI 글꼴을 설정하면 UI가 그에 맞게 확장됩니다.
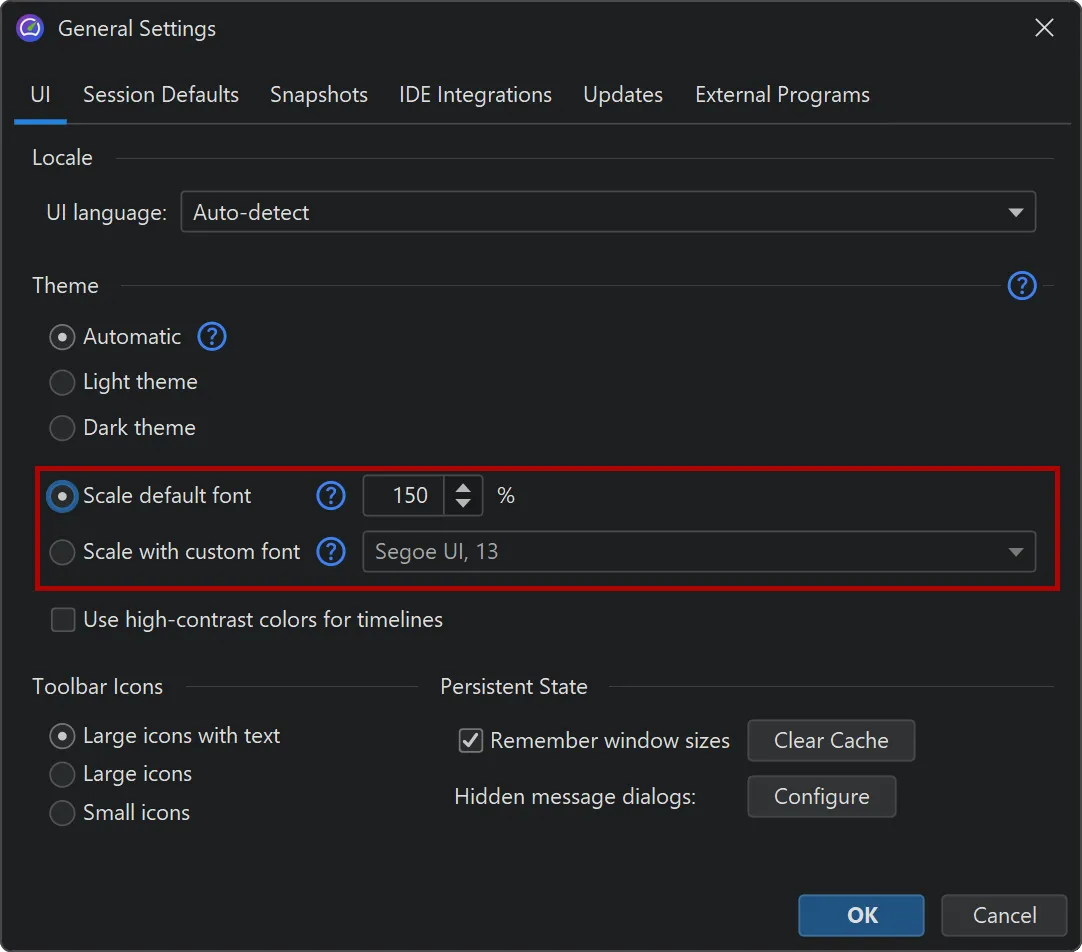
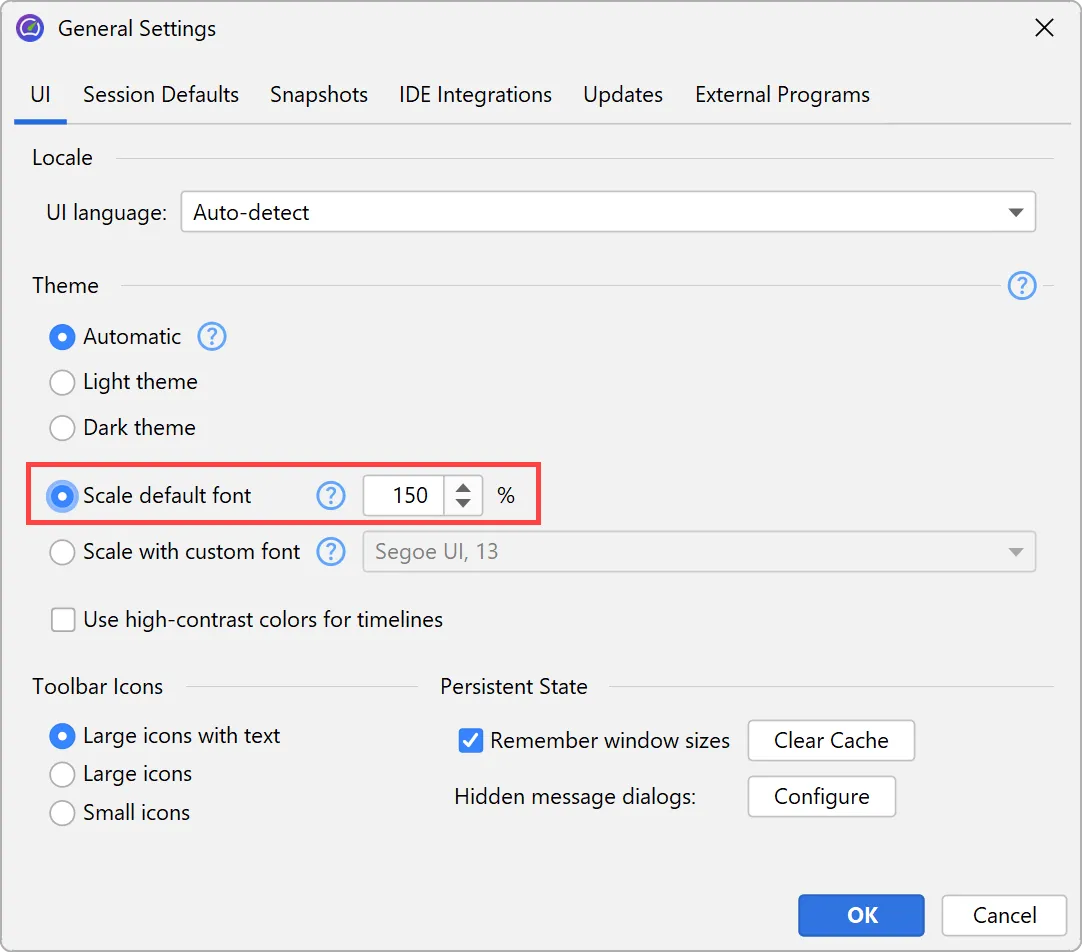
이 기능 덕분에 이제 JProfiler UI를 모든 OpenJDK 변형과 모든 HiDPI 해상도의 Linux에서 실행할 수 있습니다. 이전에는 HiDPI 해상도의 Linux에서 JetBrains 런타임만 지원되었습니다.
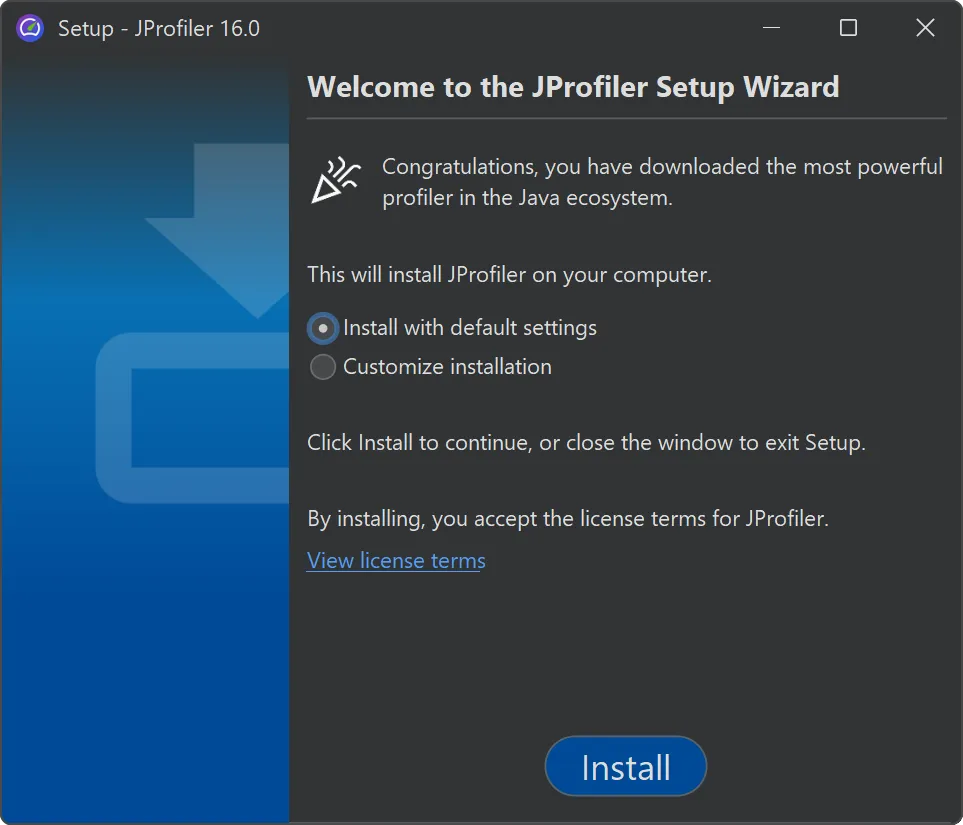
JProfiler 인스톨러가 현대화되었고 기본 실행 모드가 간소화되었습니다. 사용자 지정 실행 모드에서 모든 사용자용 설치를 선택하지 않는 한 기본적으로 관리자 권한을 요청하지 않습니다.
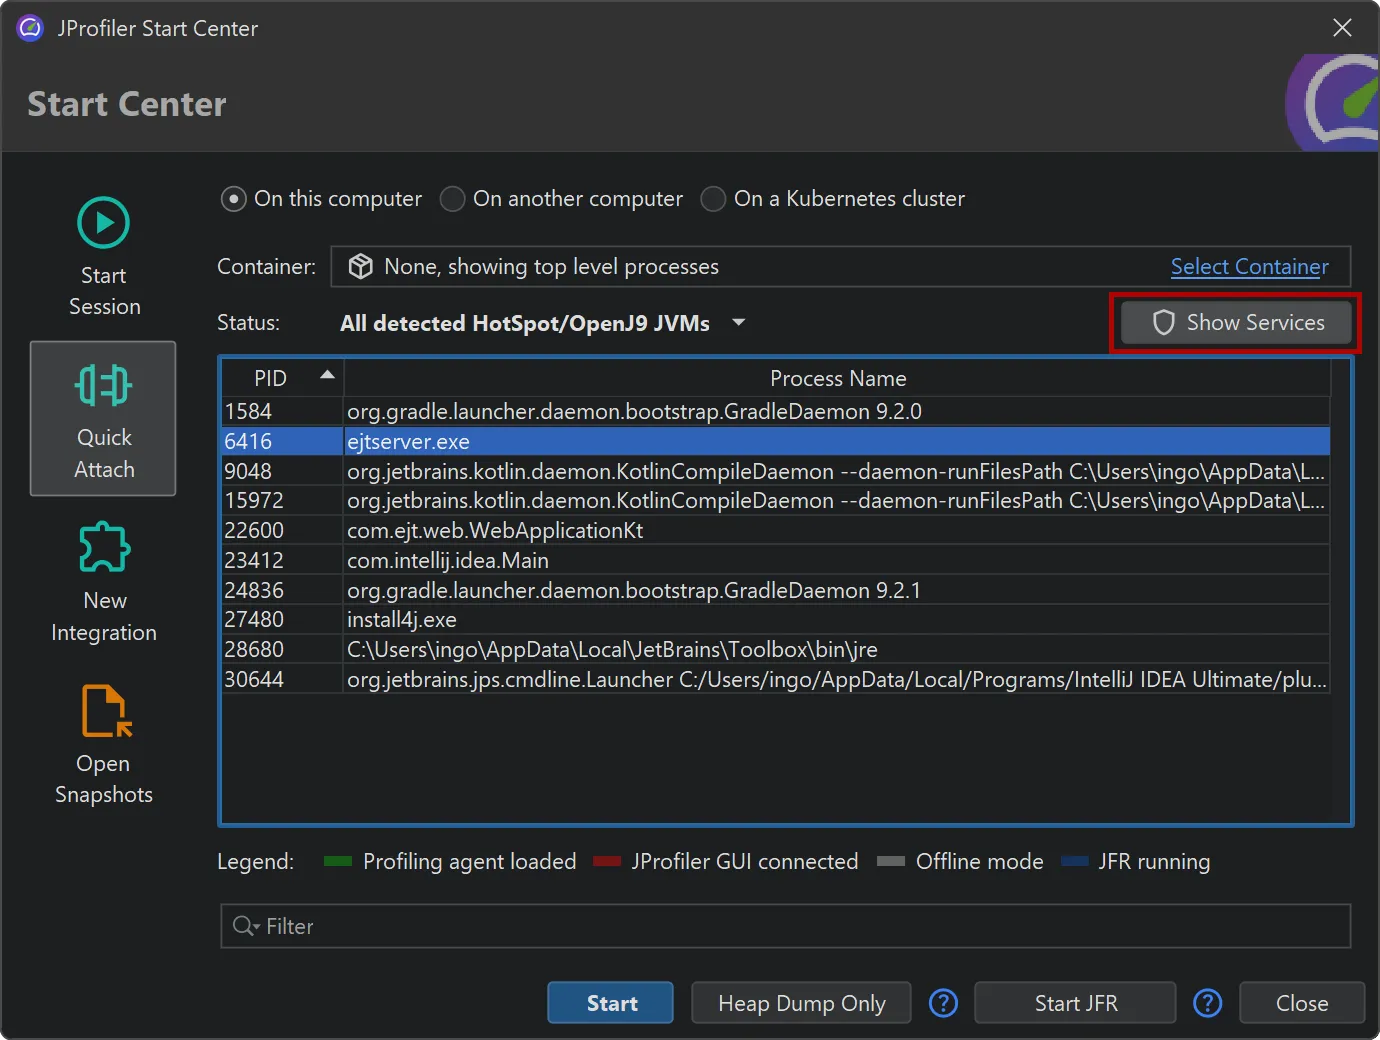
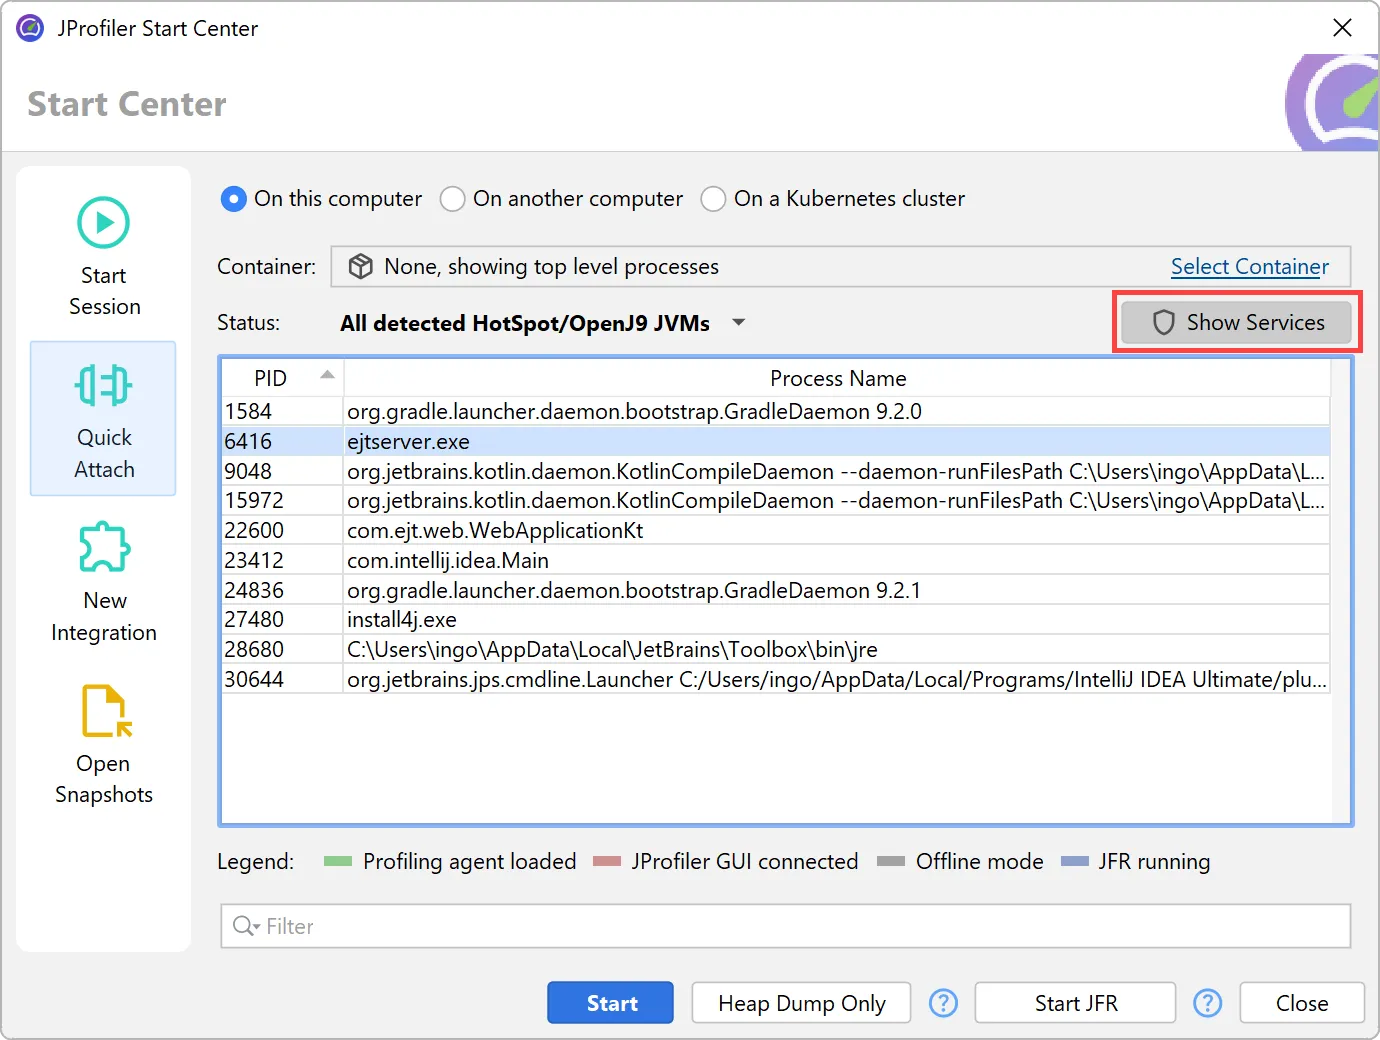
관련된 개선 사항으로, 이제 JProfiler가 해당 프로세스가 읽을 수 있는 디렉터리에 설치되어 있지 않더라도 다른 사용자로 실행 중인 Windows 프로세스에 어태치할 수 있습니다. Windows 서비스에 어태치할 때 특히 중요합니다.
JProfiler의 프로브 이벤트 기록이 재구현되었습니다. 이를 통해 수백만 건의 이벤트에 대한 확장성과 다수의 새로운 기능이 제공됩니다.
JProfiler 7에서 프로브가 도입되었을 때는 핫스팟과 텔레메트리 같은 누적 데이터에 초점이 맞춰져 있었습니다. 개별 이벤트는 문제를 디버깅하는 도구로 제공되었지만 모두 메모리에 보관되었기 때문에 상대적으로 적은 이벤트 수로 제한되었습니다.
다만 모든 이벤트를 보관하면 집계 데이터만으로는 달성할 수 없는 고급 필터링이 가능해집니다. 새로운 파일 기반 백엔드는 높은 처리량의 기록을 지원하여, 이전에는 처리가 불가능했던 대규모 이벤트 집합에 대한 복잡한 쿼리를 수행할 수 있게 해 줍니다.
이벤트 뷰 하단의 새로운 타임라인 탭은 기록된 모든 이벤트의 히스토그램을 표시하며, 필터링에 사용할 시간 범위를 선택할 수 있습니다.
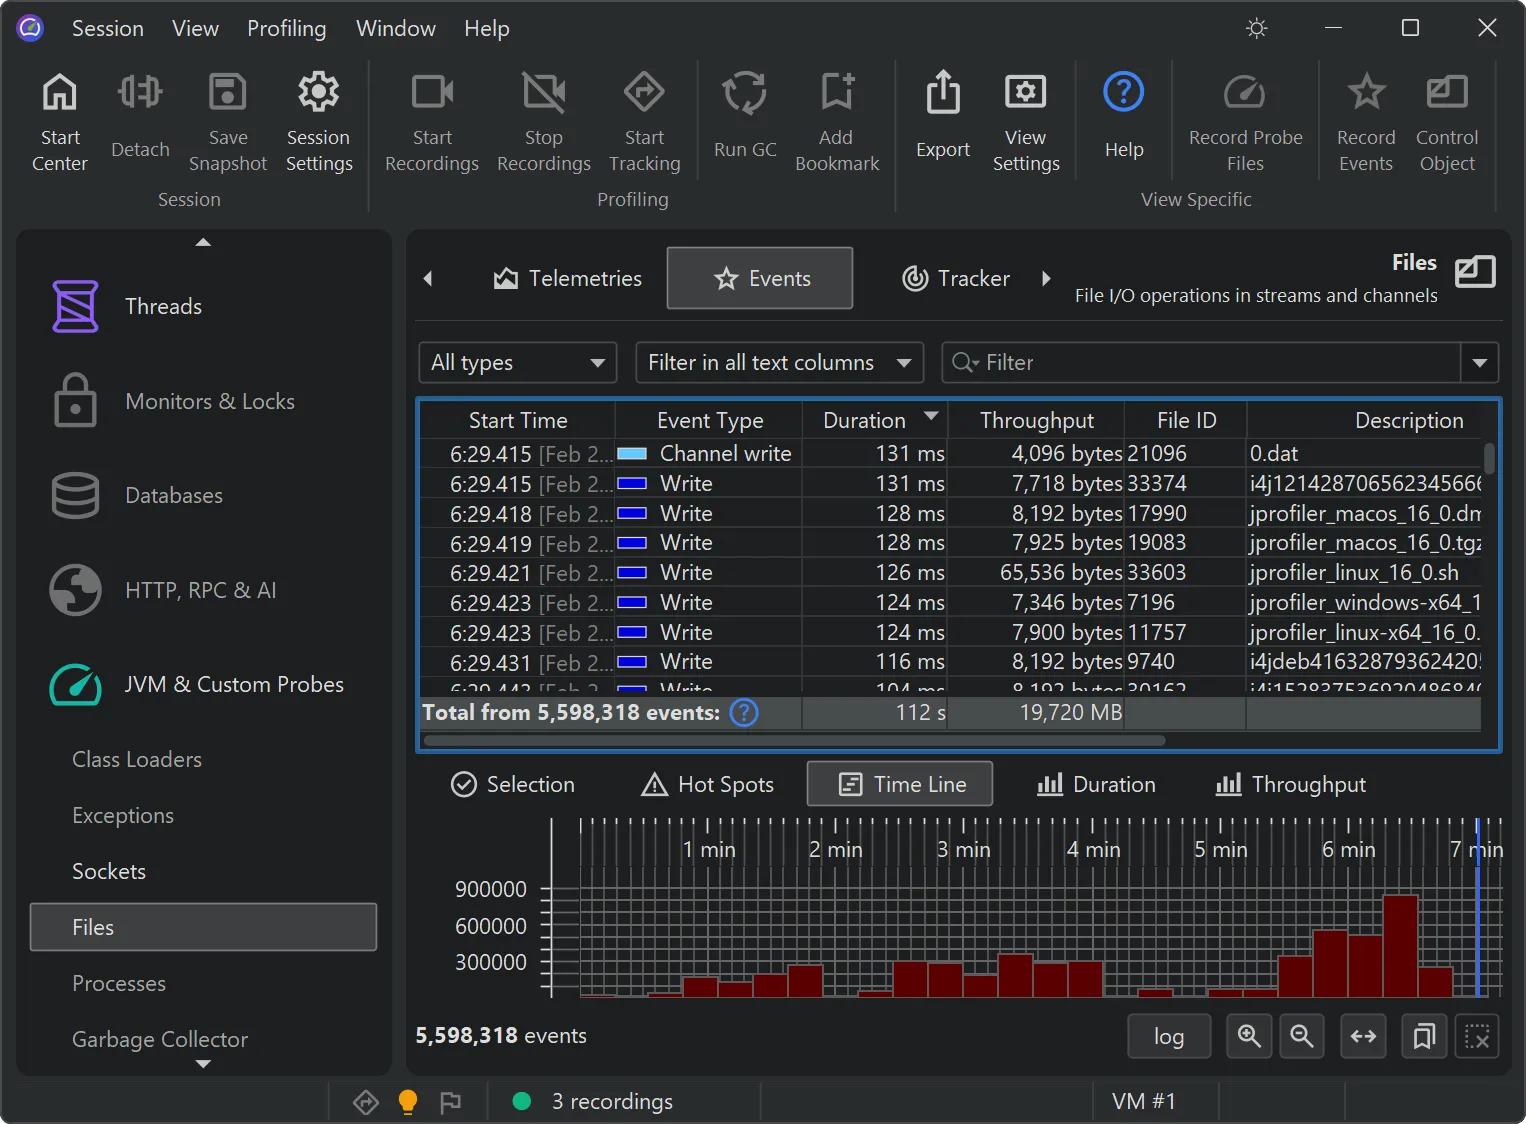
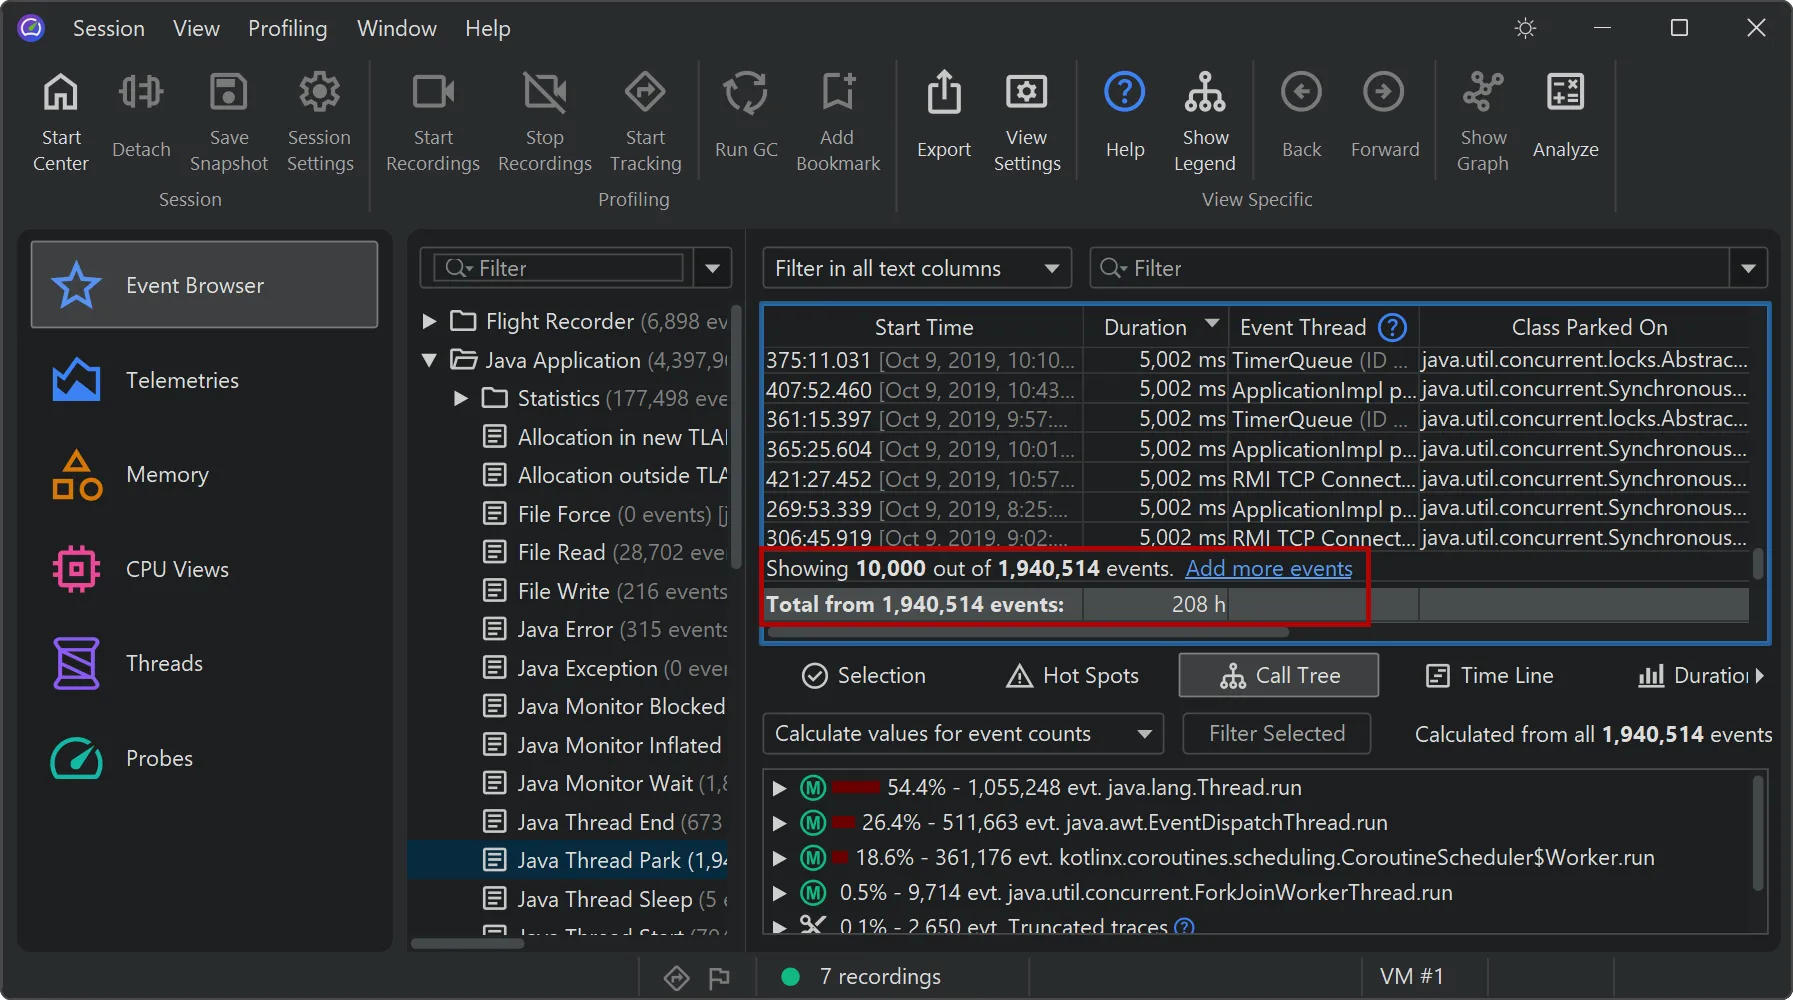
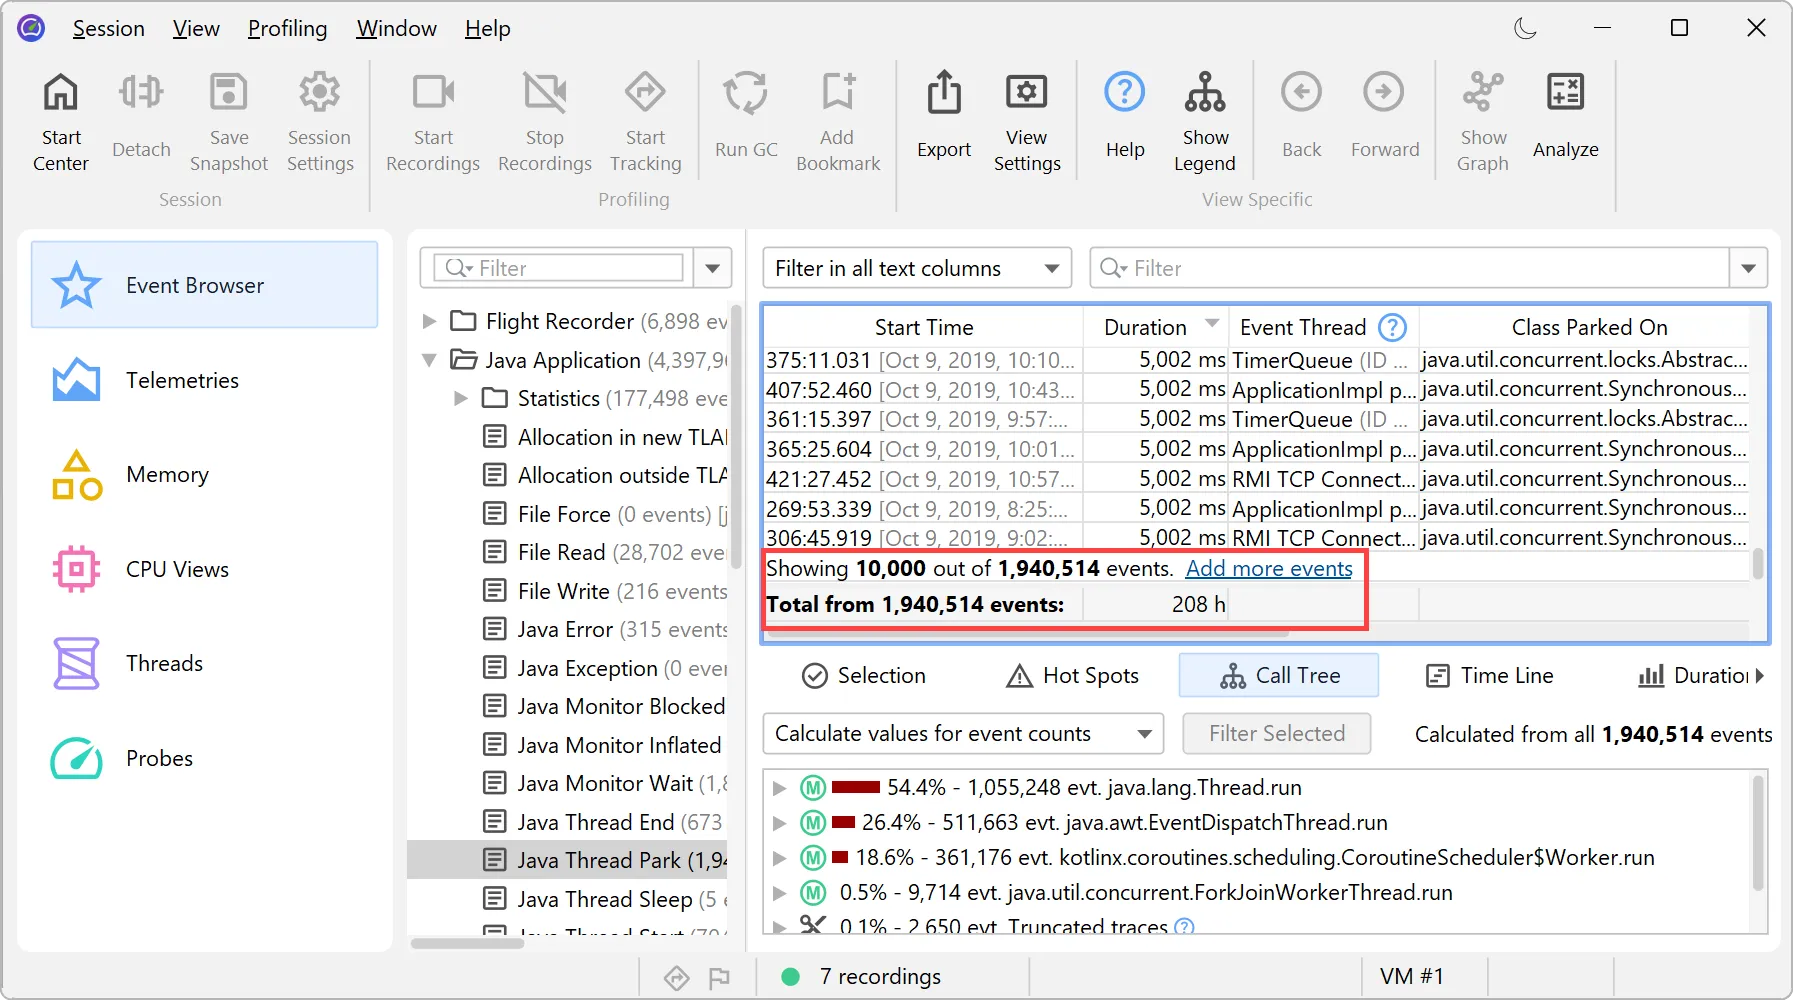
테이블에는 제한된 수의 이벤트만 표시되지만, 맨 아래로 스크롤하면 이벤트를 더 불러올 수 있습니다. 열을 기준으로 정렬할 때는 현재 보이는 행뿐만 아니라 필터링된 전체 이벤트 집합이 고려됩니다.
테이블의 총계 역시 필터링된 전체 이벤트 집합에 대해 계산됩니다.
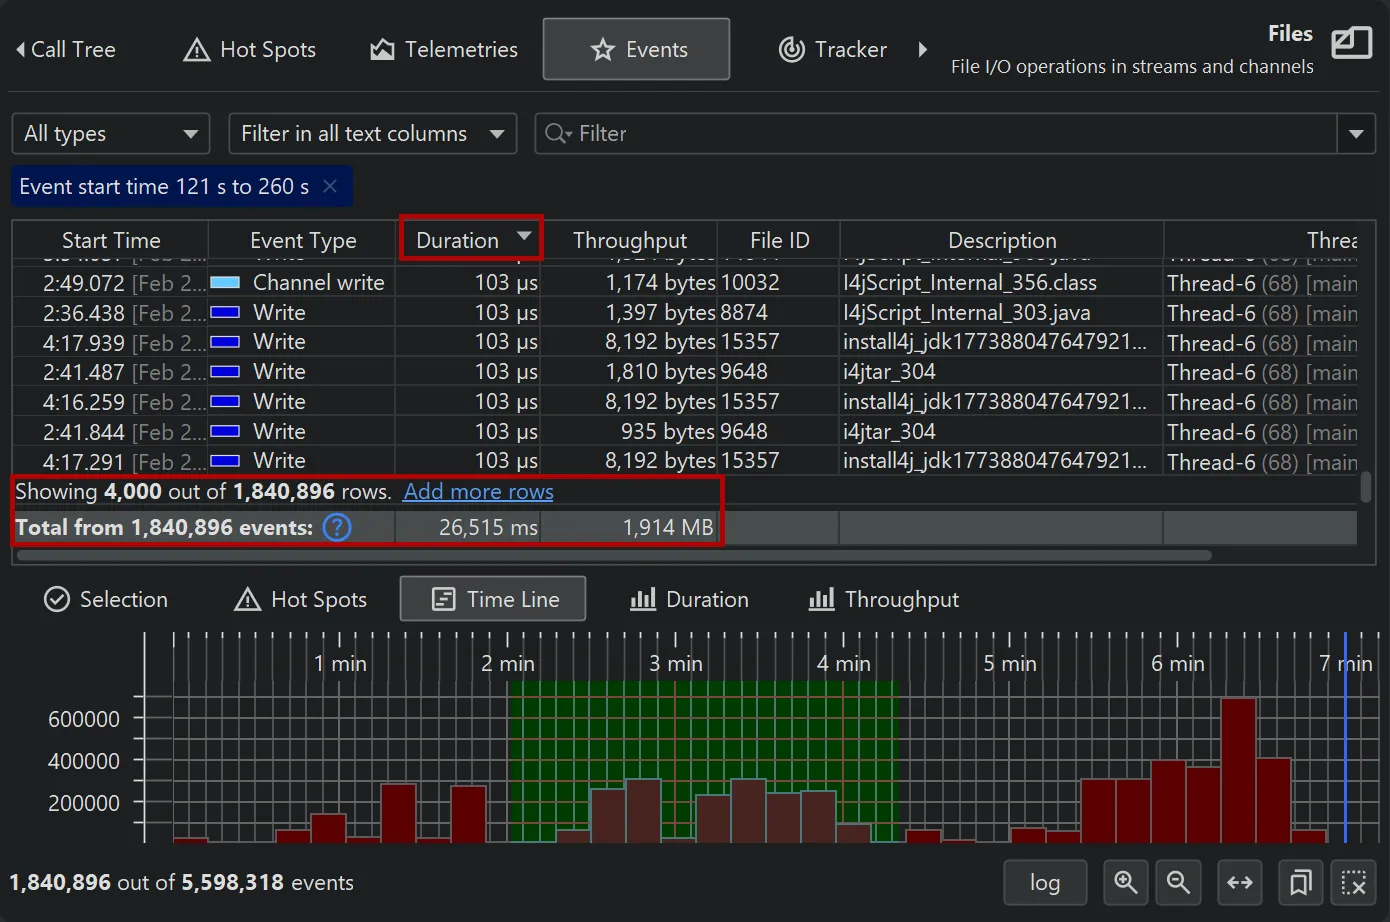
하단의 "핫스팟" 탭에는 CPU 핫스팟 뷰, 프로브 핫스팟 뷰, 프로브 콜 트리가 포함되어 있습니다. "선택" 탭과 비슷하지만, 선택된 행이 아니라 필터링된 모든 이벤트에 대해 계산된다는 점이 다릅니다.
이러한 각 뷰에서 필터 버튼을 사용하여 메인 이벤트 테이블과 하단의 다른 모든 뷰에 표시되는 이벤트를 제한할 수 있습니다. 아래는 프로브 콜 트리의 콜 스택 필터로, 필터링된 노드에 필터 아이콘이 표시되어 있습니다.
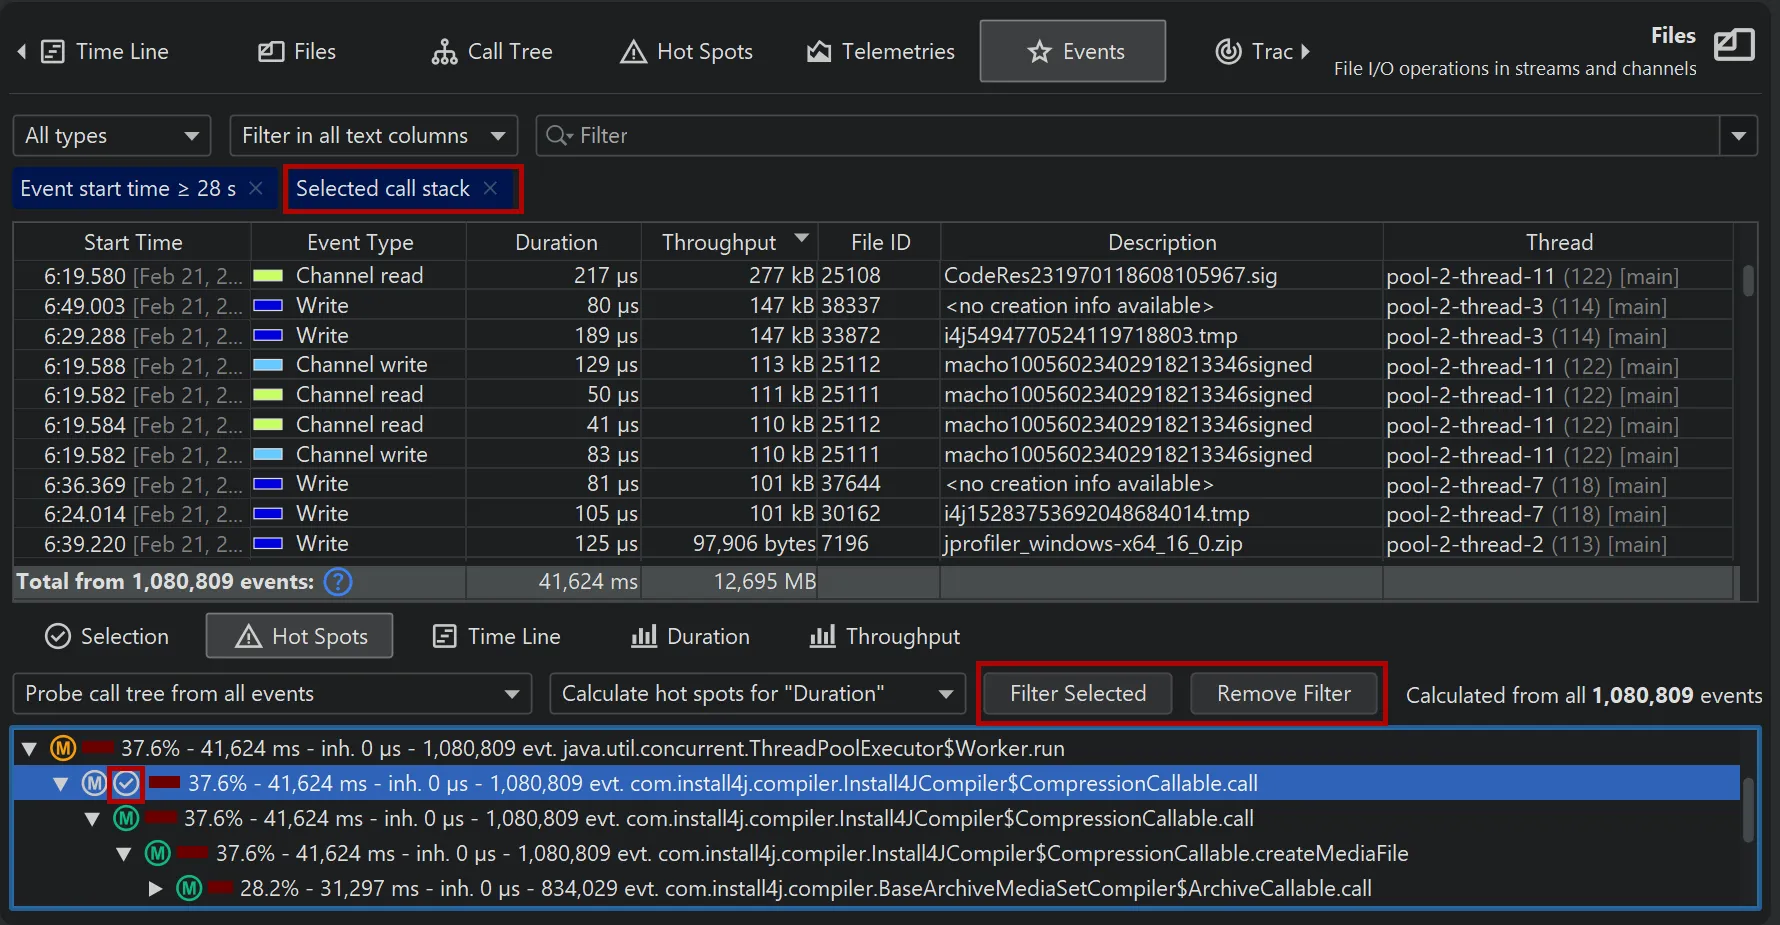
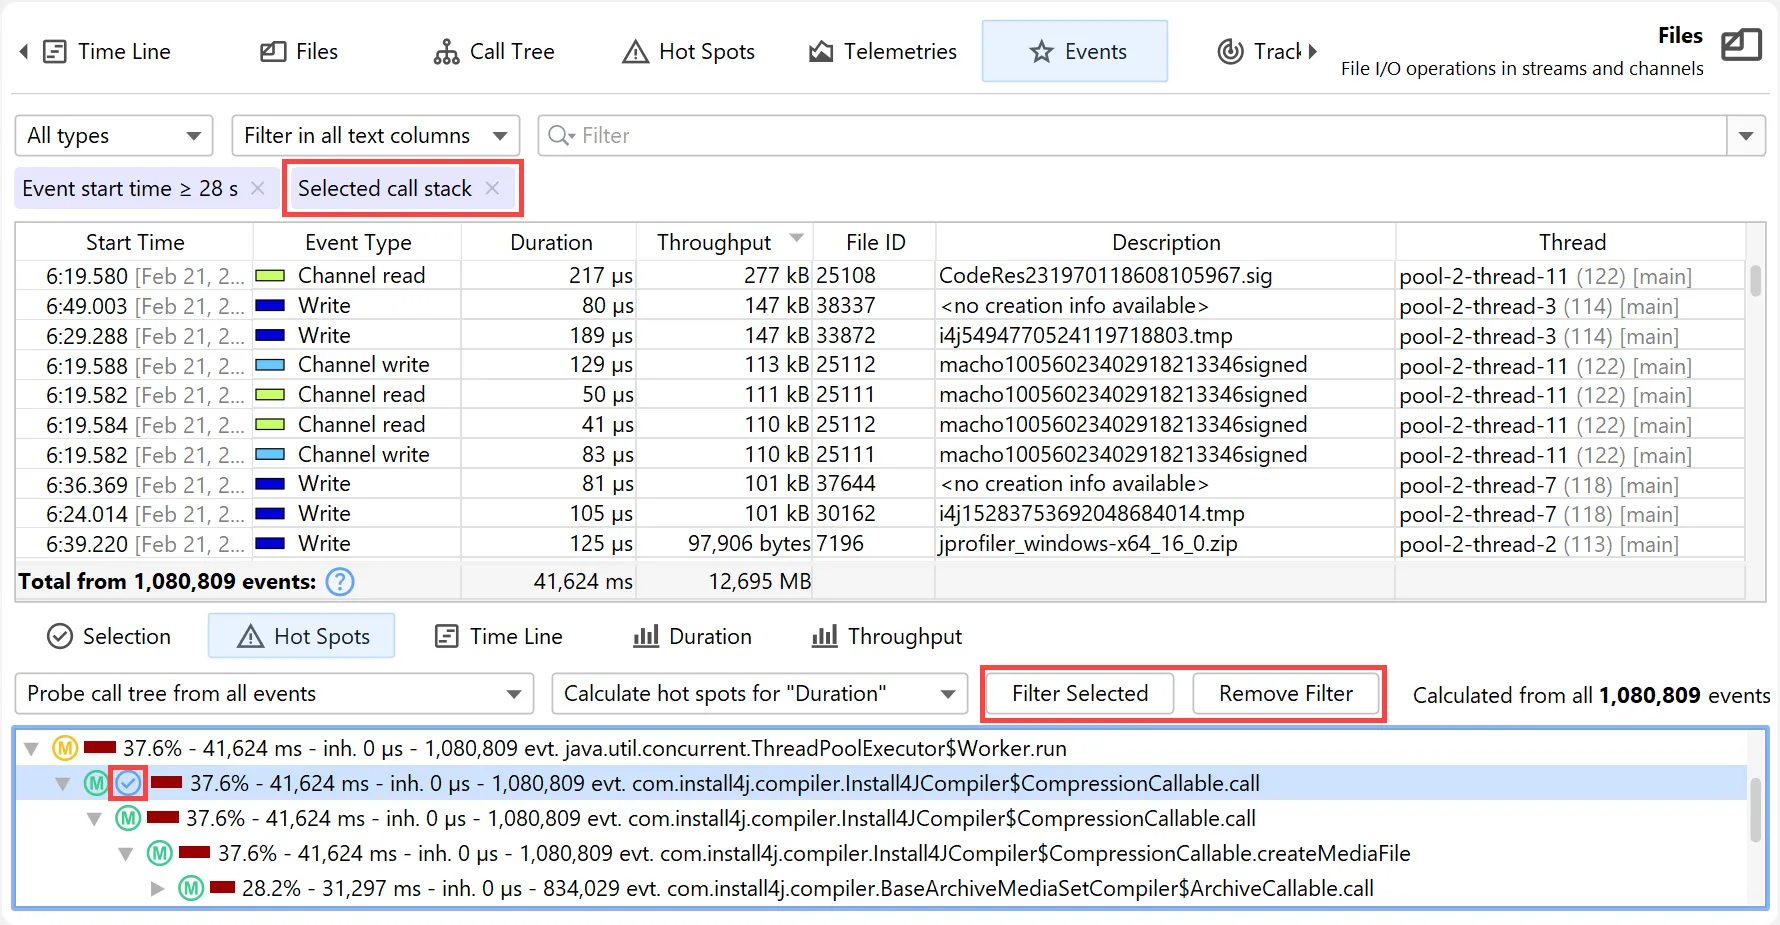
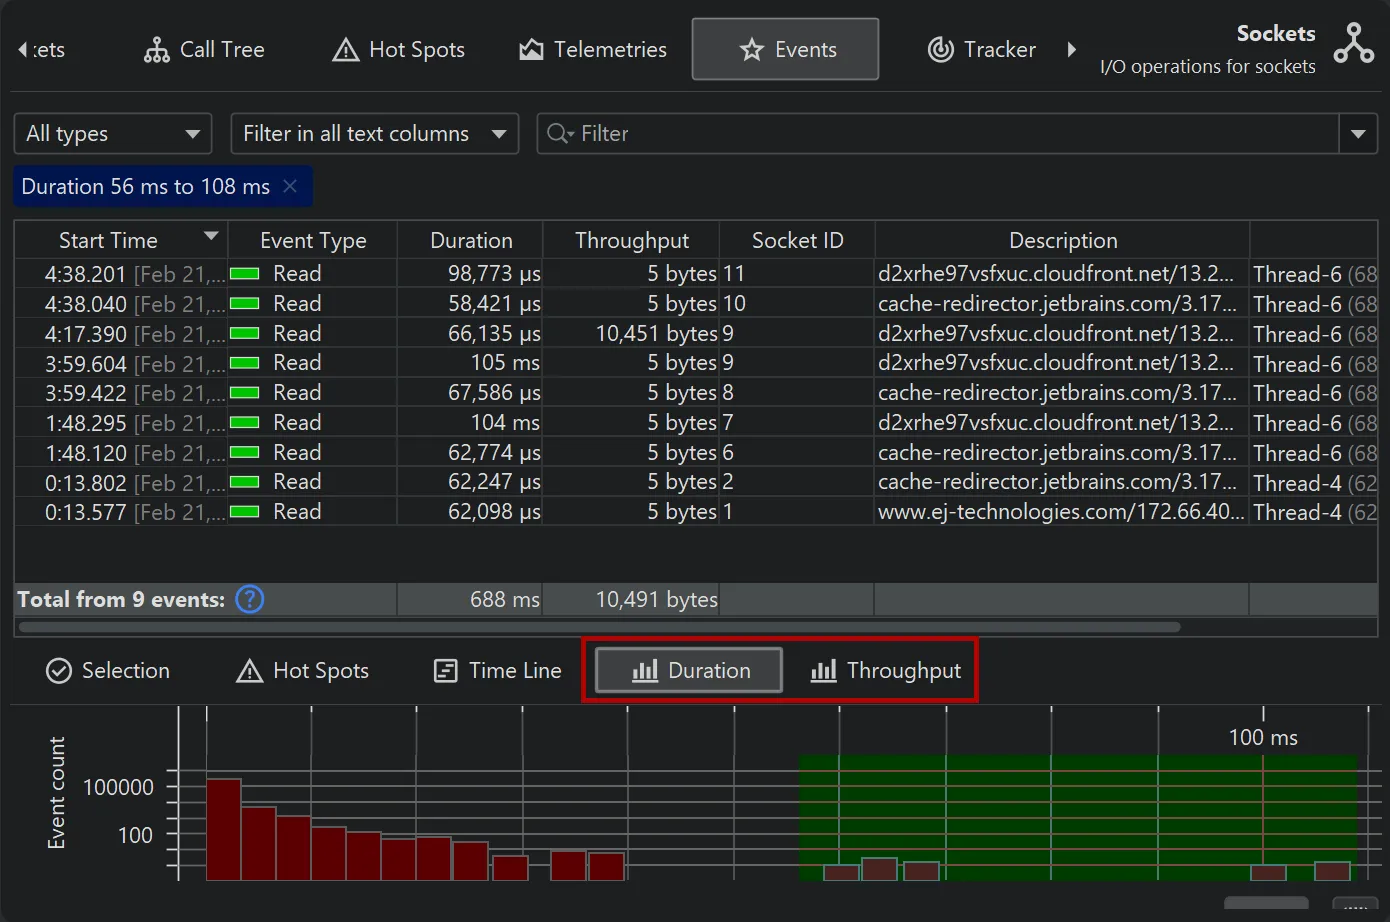
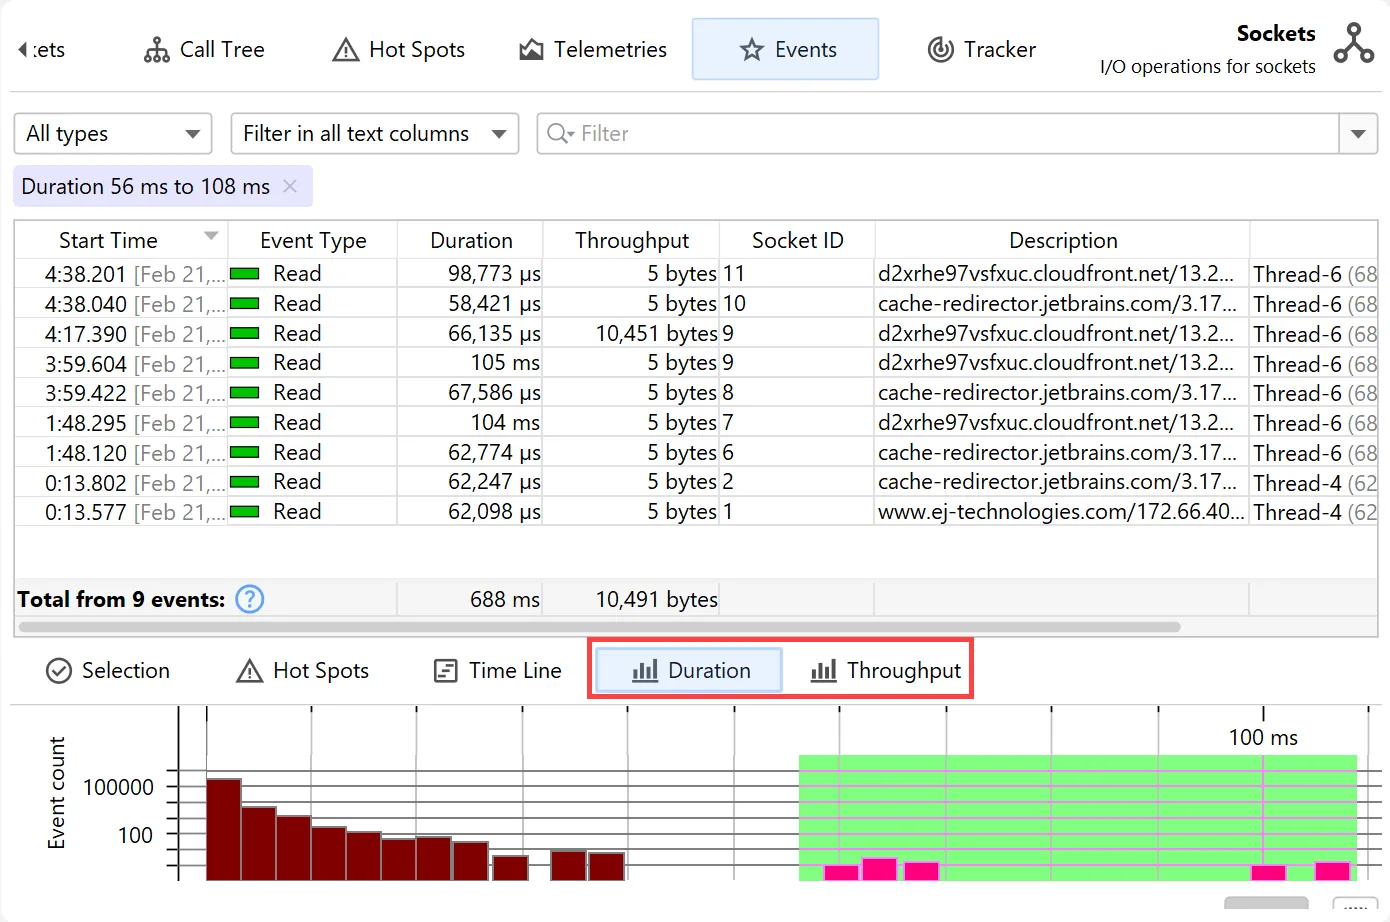
프로브가 수행하는 측정에 따라 하단에 추가 히스토그램 뷰가 제공됩니다. "파일" 및 "소켓" 프로브의 경우 "지속 시간"과 "처리량"입니다.
히스토그램은 로그 스케일 y축으로 표시할 수 있으며, 마우스로 범위를 드래그하여 필터링할 수 있습니다.
마지막으로 이벤트 뷰에 스마트 열 관리가 구현되었습니다. JProfiler는 모든 열의 너비와 사용 가능한 뷰포트 너비를 바탕으로 열을 뷰포트에 맞출지, 아니면 가로 스크롤을 활성화할지 결정합니다. 열 크기를 수동으로 조정하면 "뷰포트에 맞추기" 모드가 비활성화되지만, 테이블 전체 너비가 뷰포트보다 작아지면 자동으로 다시 활성화됩니다.
프로브가 이벤트 지속 시간 이외의 추가 측정값을 가지고 있다면, 프로브 콜 트리 뷰와 프로브 핫스팟 뷰에 이제 메트릭 선택기가 제공됩니다. 예를 들어 "파일" 및 "소켓" 프로브는 "읽기 처리량"과 "쓰기 처리량"도 제공합니다. 처리량 메트릭 중 하나를 선택하면 뷰가 자동으로 "읽기" 또는 "쓰기" 이벤트로 제한됩니다.
메트릭을 변경하면 핫스팟이 다시 계산되고 프로브 콜 트리의 핫 경로가 갱신됩니다.
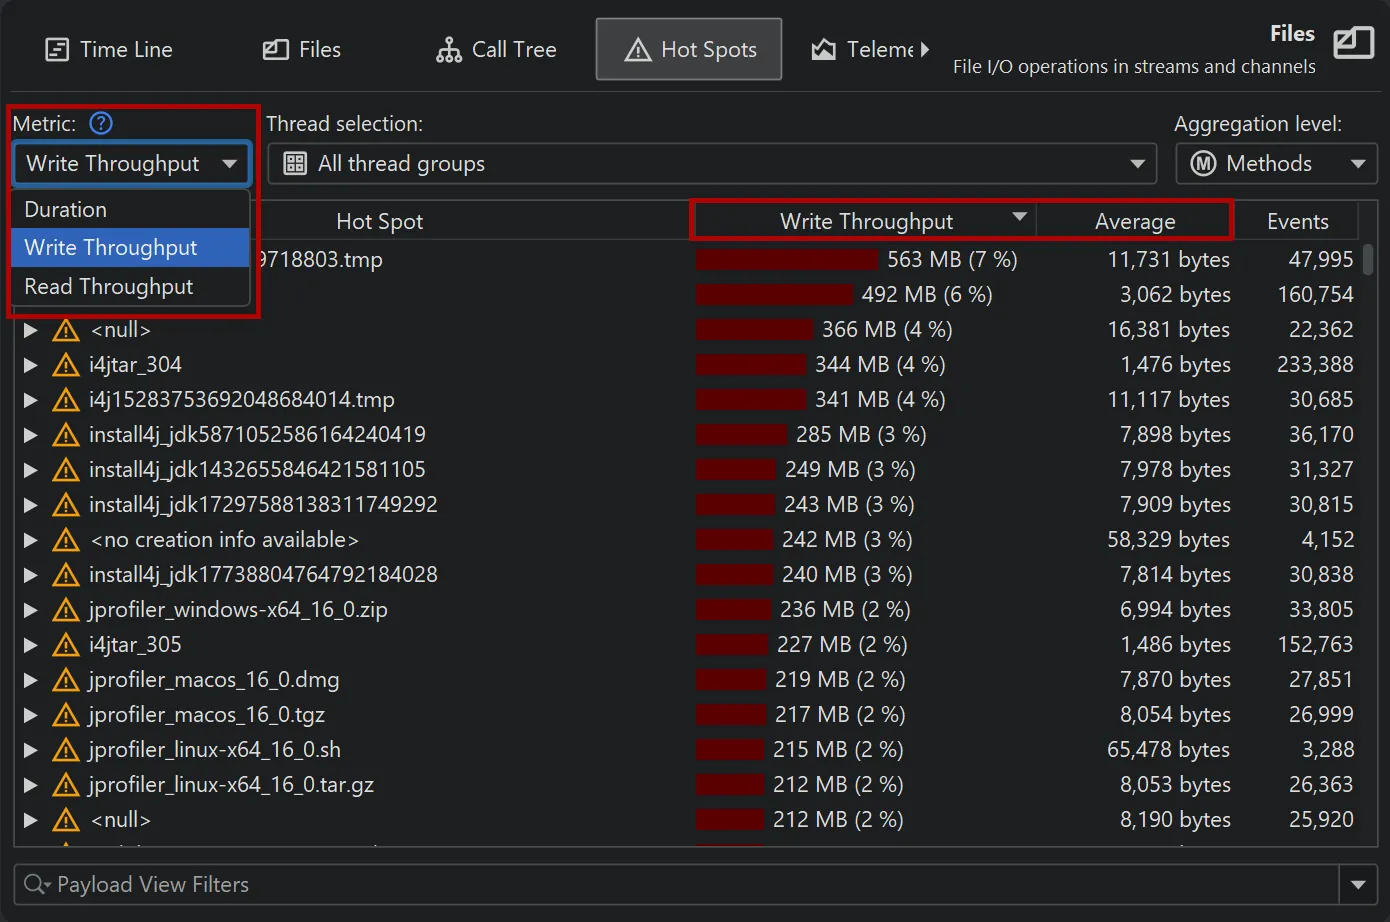
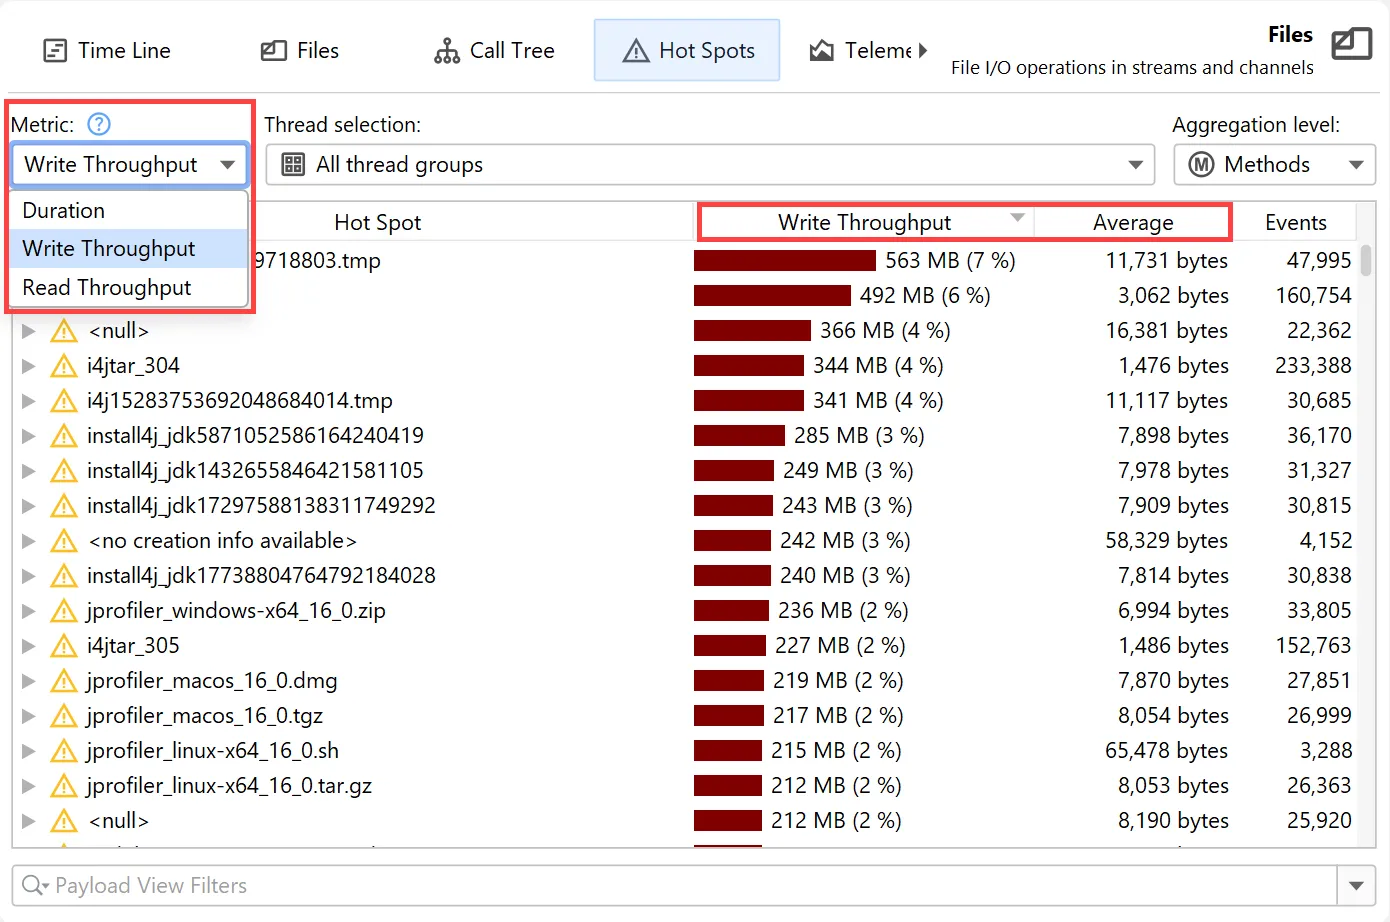
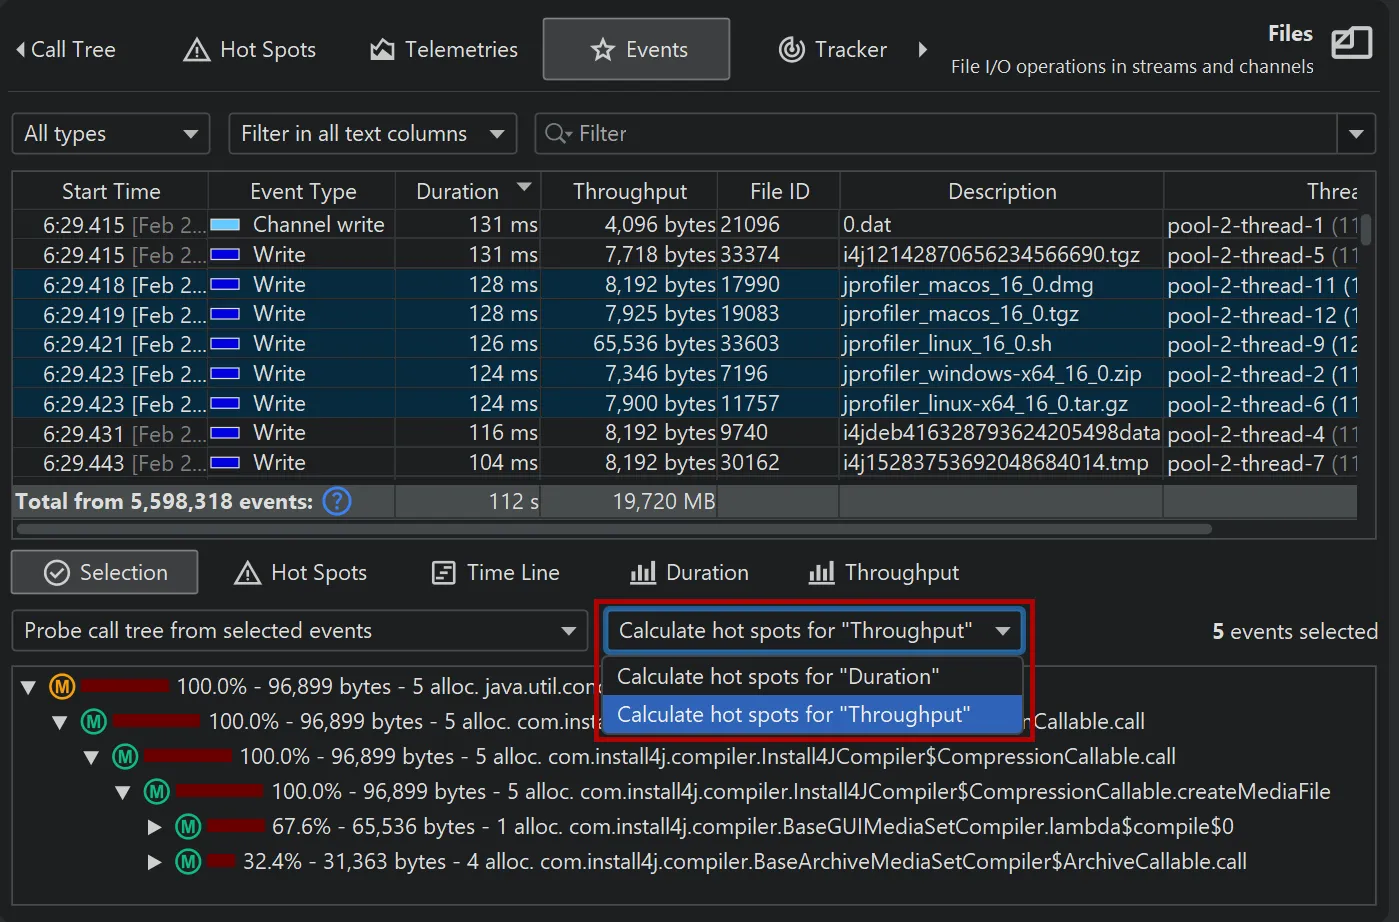
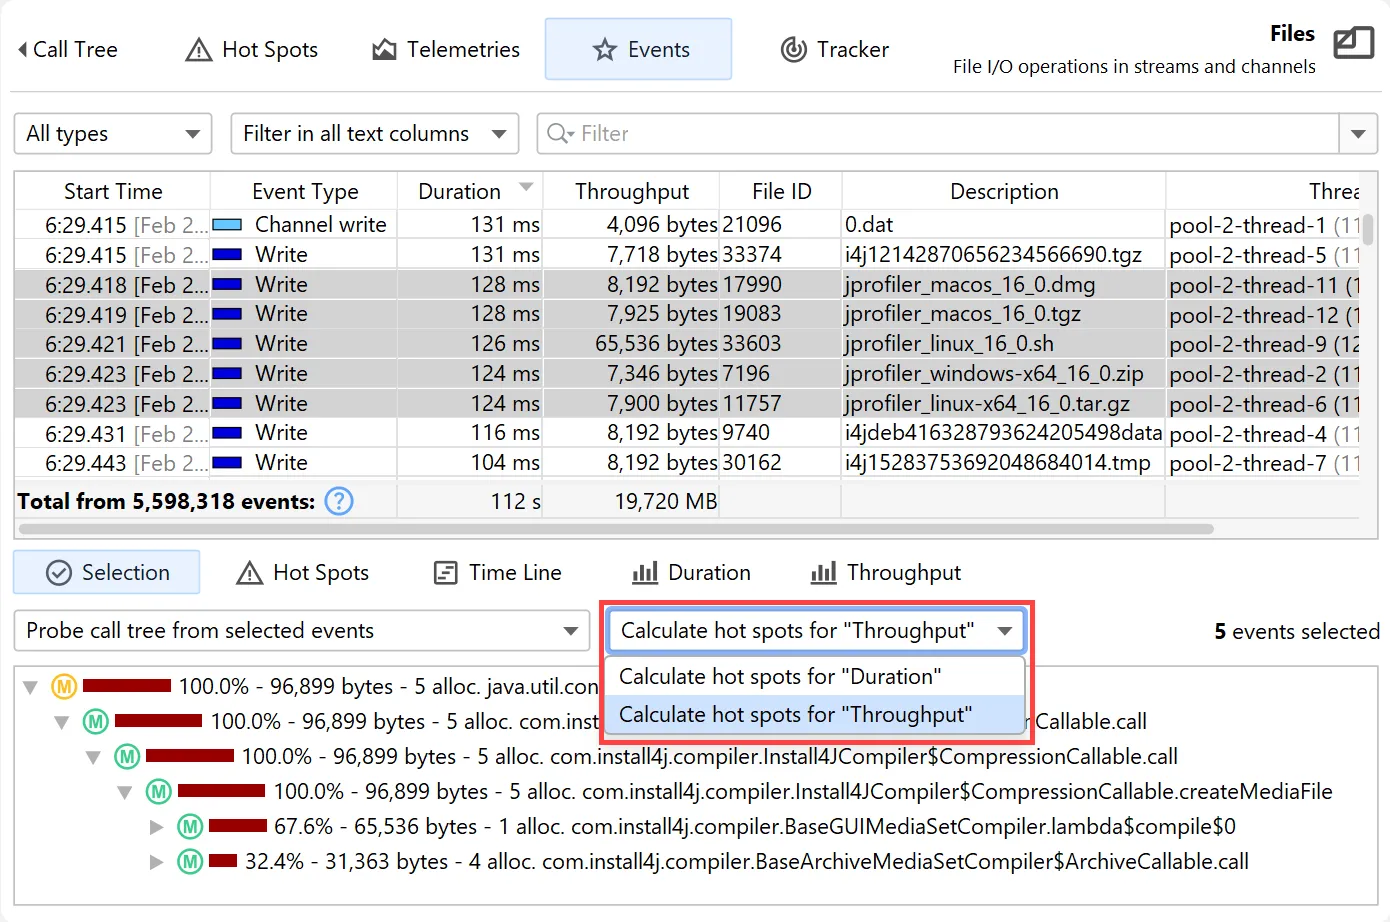
메트릭 선택기는 이제 프로브 이벤트 뷰의 "선택" 및 "핫스팟" 탭에서도 사용할 수 있습니다. 이벤트 뷰에서 "읽기"와 "쓰기" 이벤트를 별도로 필터링할 수 있으므로, 여기에는 하나로 합쳐진 "처리량" 측정값이 제공됩니다.
JProfiler 16은 JFR 지원에 관한 수많은 개선을 제공합니다.
- 하단 뷰의 데이터를 미리 계산하여 이벤트 수가 많을 때 이벤트 브라우저의 응답성이 향상되었습니다.
- 이전 버전의 JProfiler는 이벤트 테이블에서 최대 이벤트 수까지만 처리했습니다. 이제 맨 아래로 스크롤하면 추가 이벤트를 불러올 수 있습니다. 또한 테이블을 정렬할 때 표시된 일부가 아니라 필터링된 모든 이벤트가 고려됩니다.
- 이벤트 테이블의 총계는 이제 현재 표시된 이벤트뿐 아니라 필터링된 모든 이벤트에 대해 계산됩니다.
JFR 기록 마법사에 스로틀 설정 지원이 추가되었습니다. 예를 들어 Java 25의 새로운 jdk.CPUTimeSample 이벤트는 스로틀링을 통해 구성합니다. 대신 주기를 입력하거나 /s 단위로 발생률을 입력할 수도 있습니다.
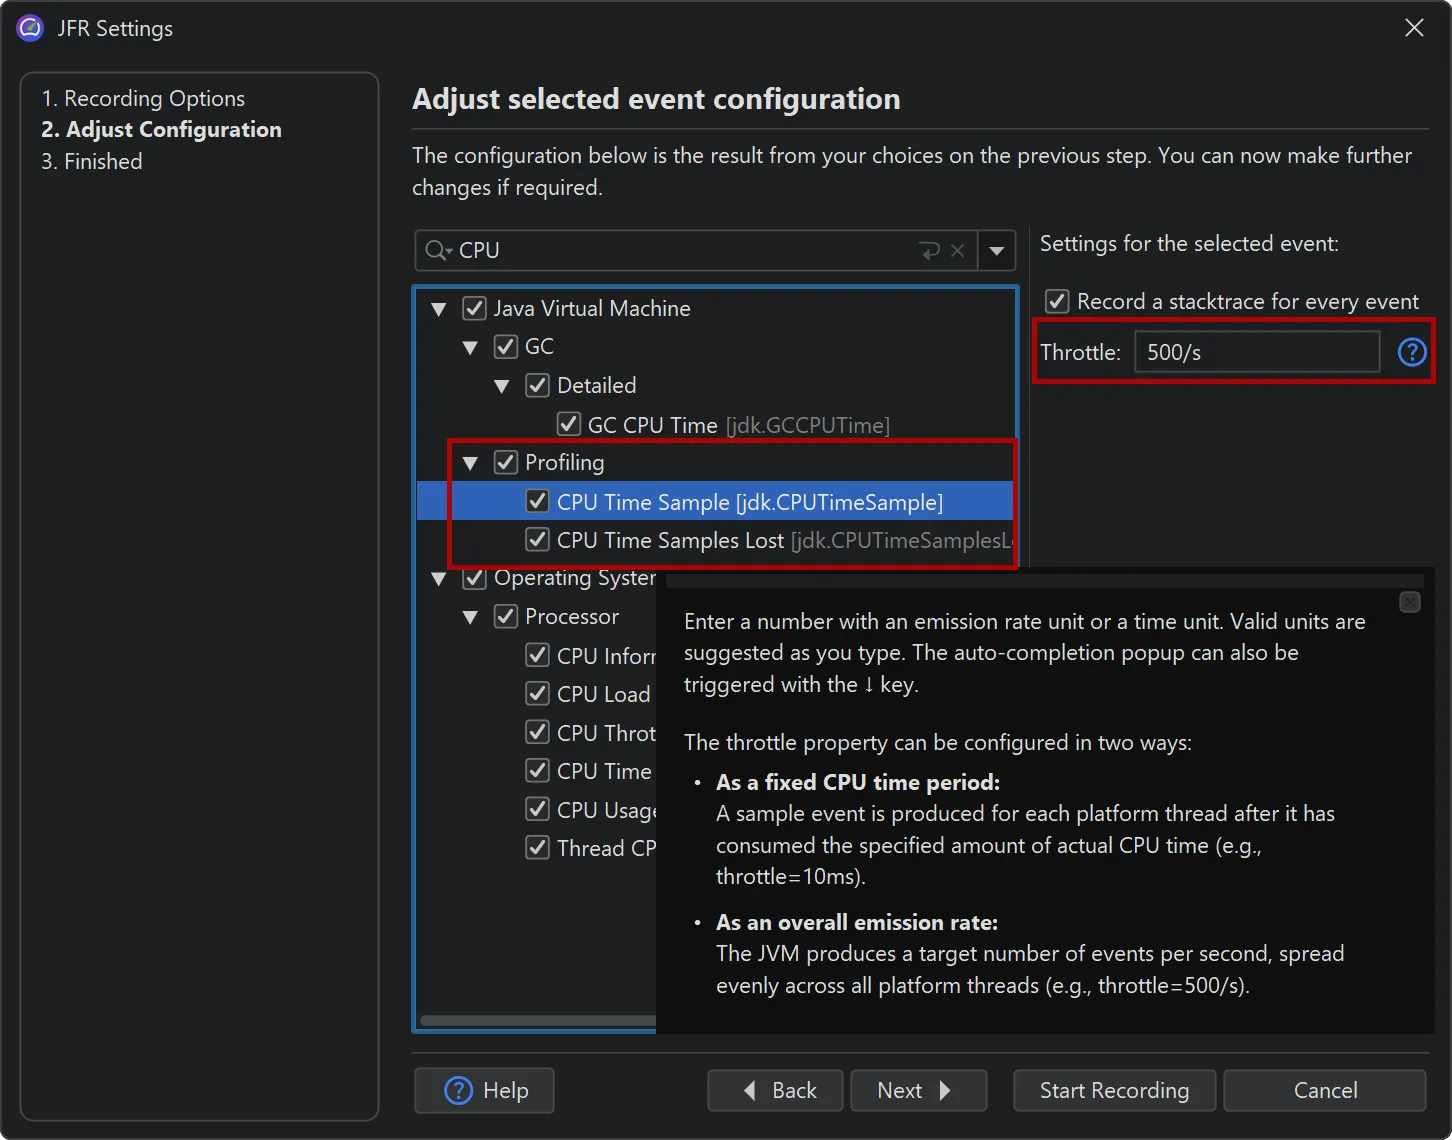
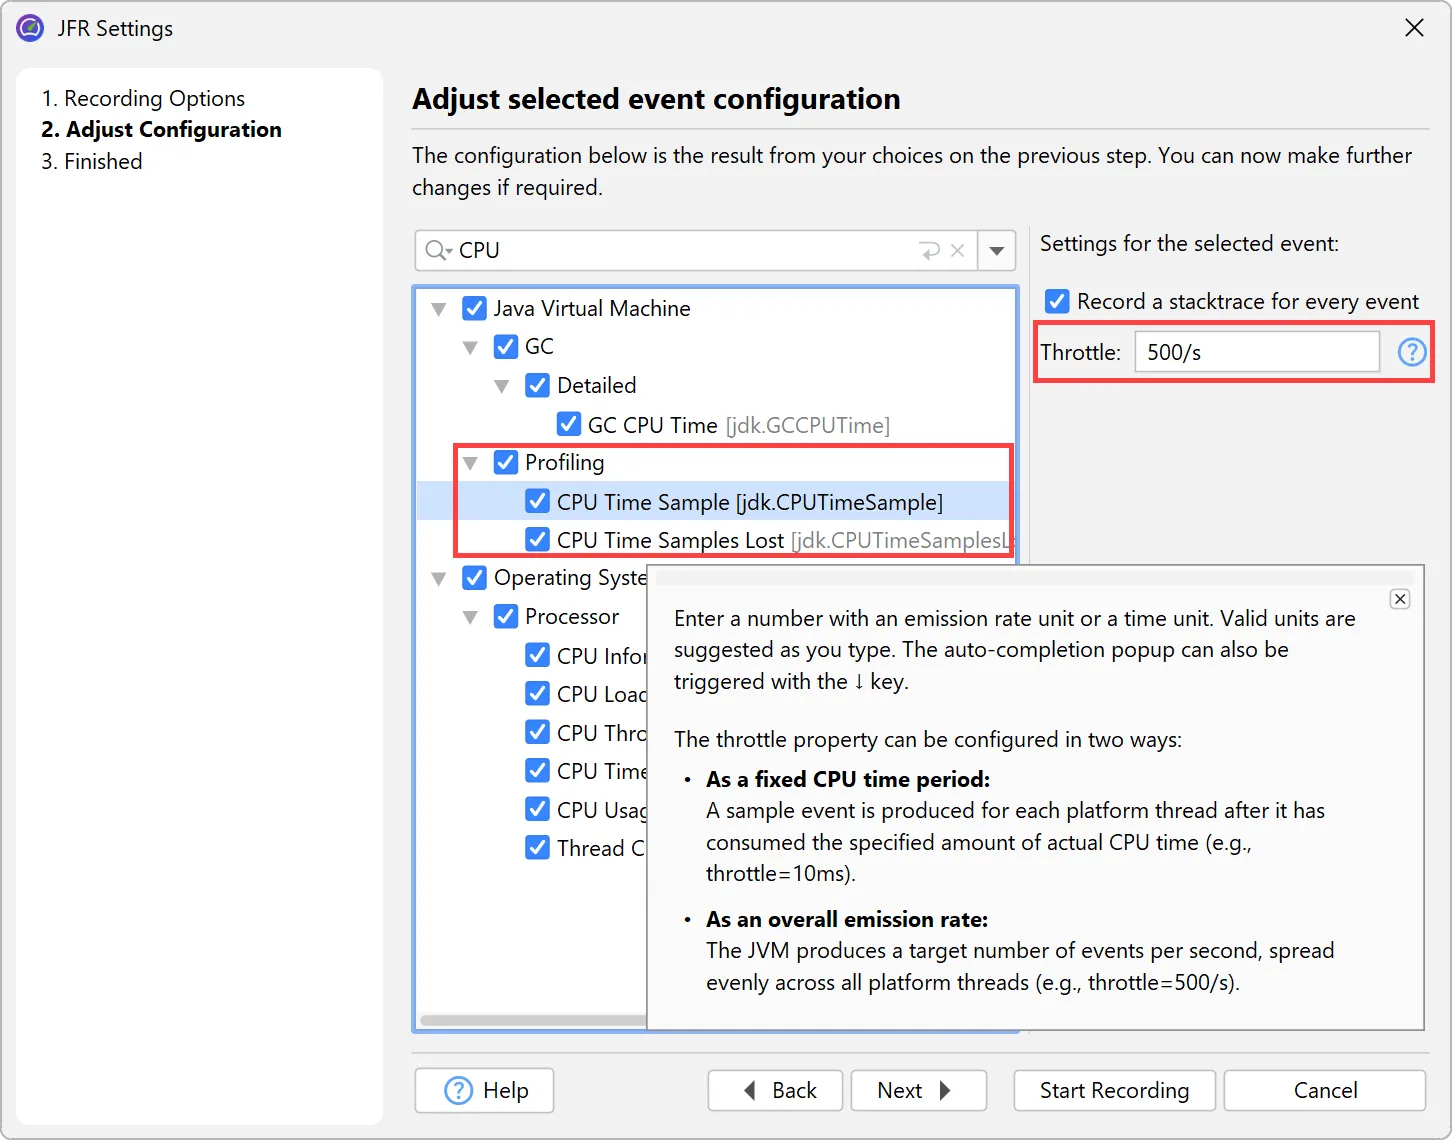
스로틀 설정은 CPU 뷰에서 스레드 상태 선택기 옆에도 표시됩니다.
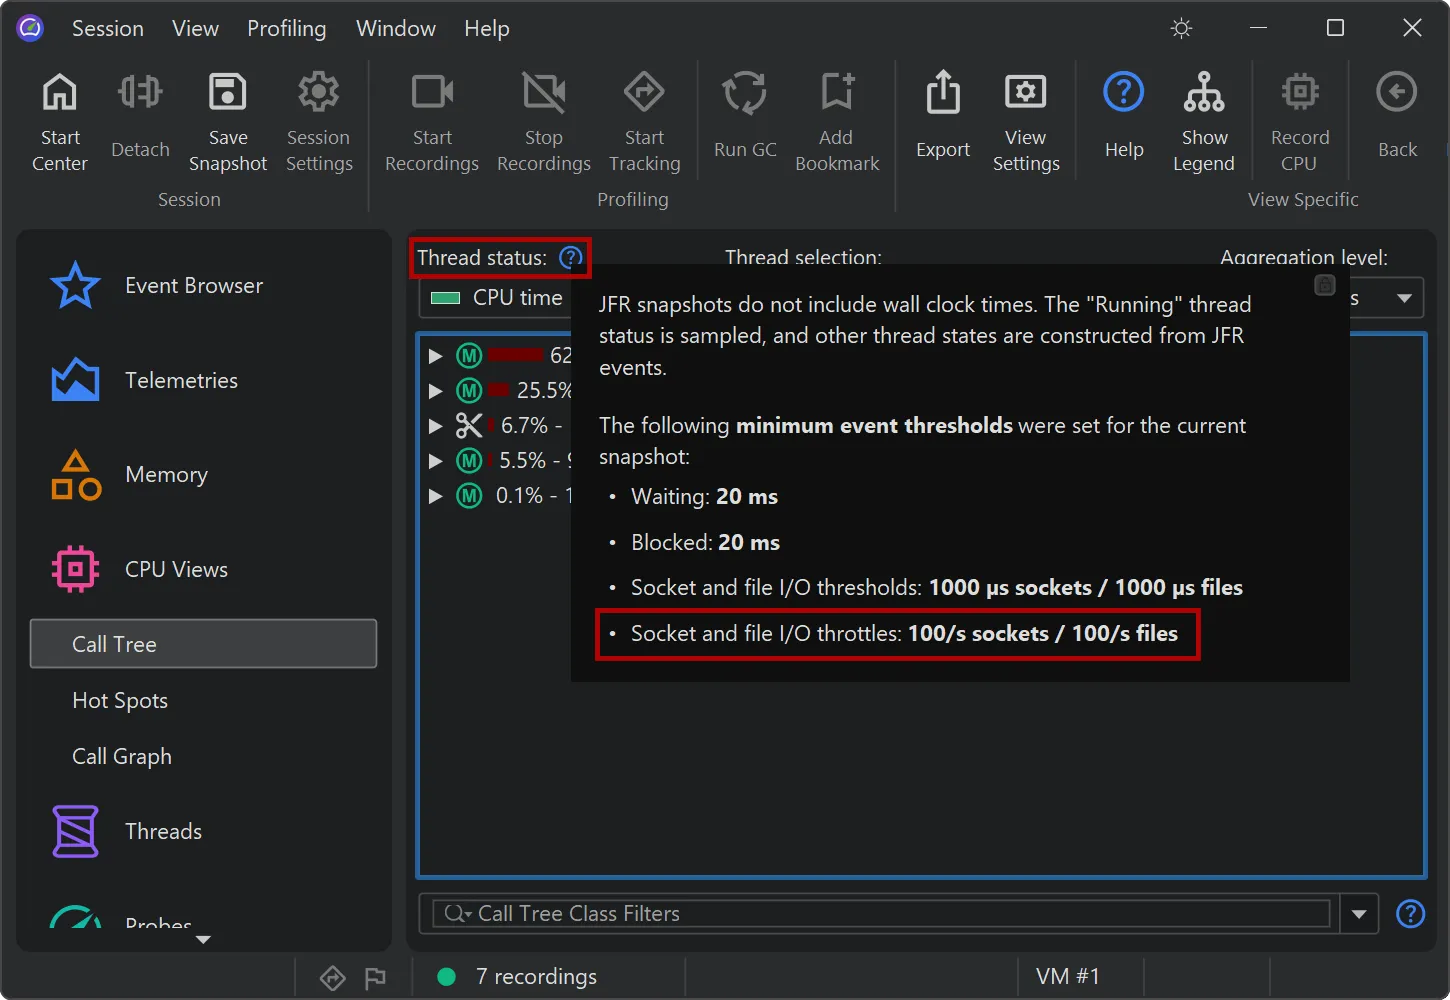
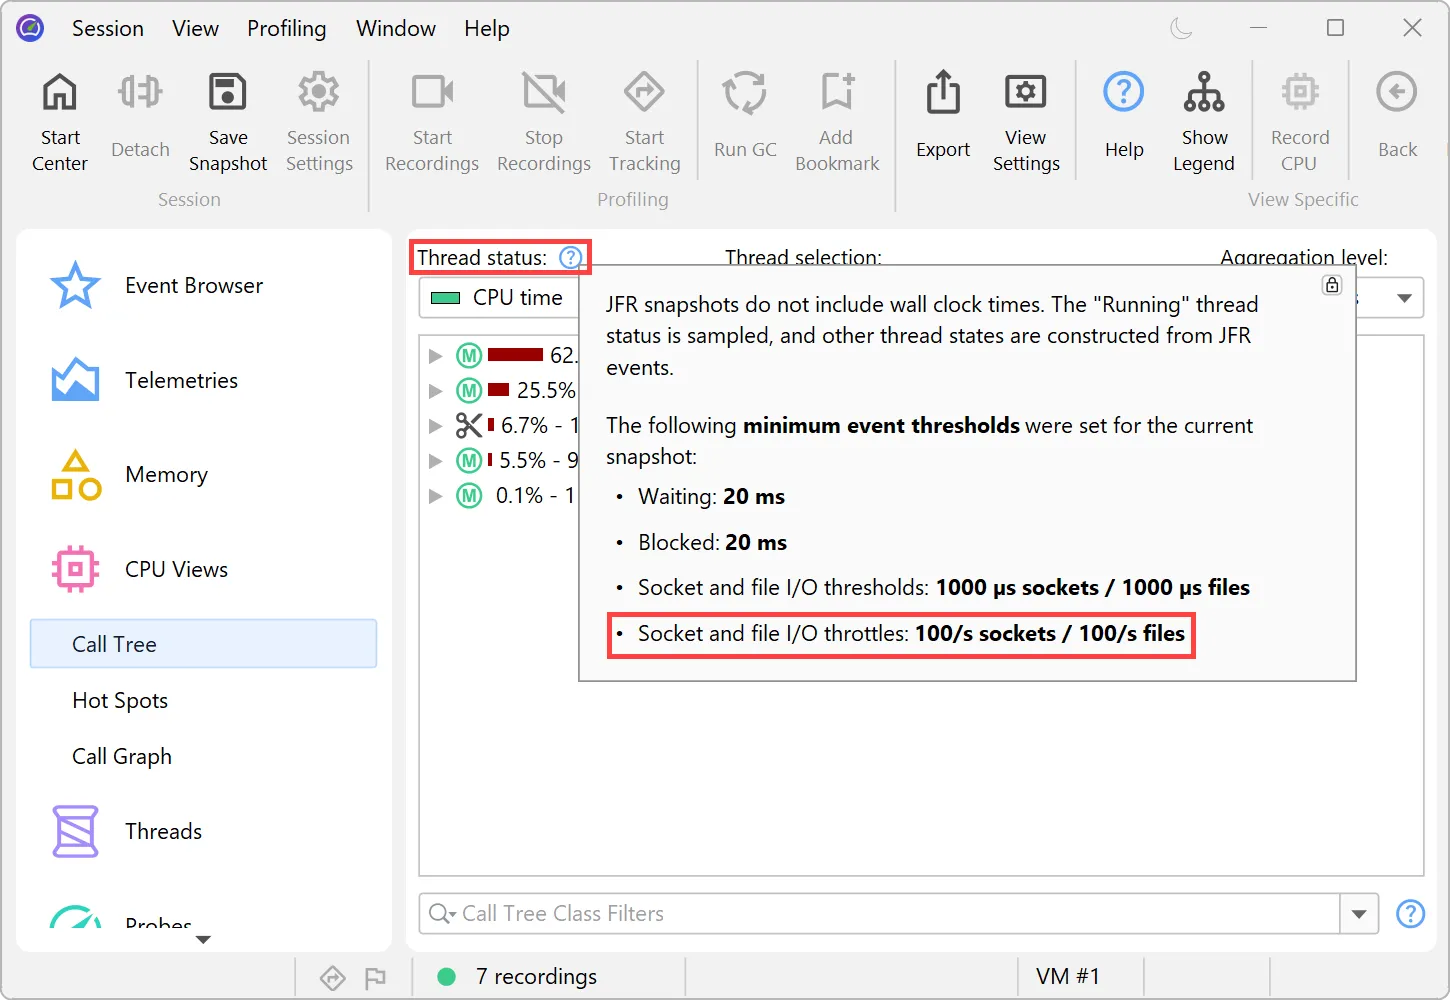
CPU 섹션의 데이터를 계산할 때는 기존의 jdk.ExecutionSample 이벤트 대신, 기록되어 있는 경우 새로운 Linux 전용 jdk.CPUTimeSample 이벤트(Java 25+)가 사용됩니다. 모든 플랫폼에서 동작하지만 샘플링하는 스레드 수와 CPU 사용량 정확도에 제한이 있는 jdk.ExecutionSample과 달리, jdk.CPUTimeSample은 Linux 커널의 CPU 시간 이벤트를 사용하여 데이터를 수집합니다.
이 이벤트를 통해 JFR을 사용한 CPU 프로파일링도 이제 JVMTI 에이전트 로딩이 허용되지 않는 프로덕션 시스템에서 바로 활용할 수 있는 CPU 메트릭을 제공할 수 있습니다.
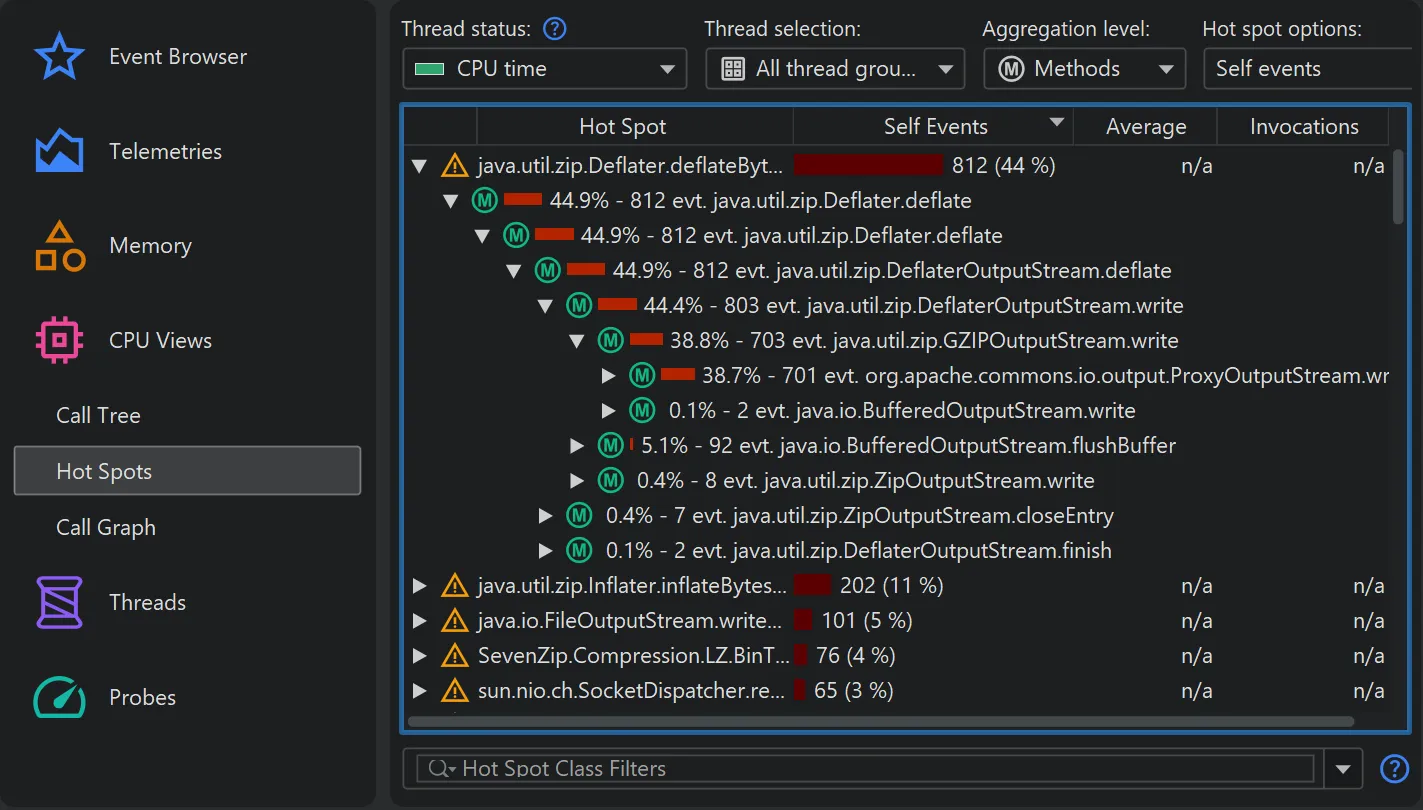
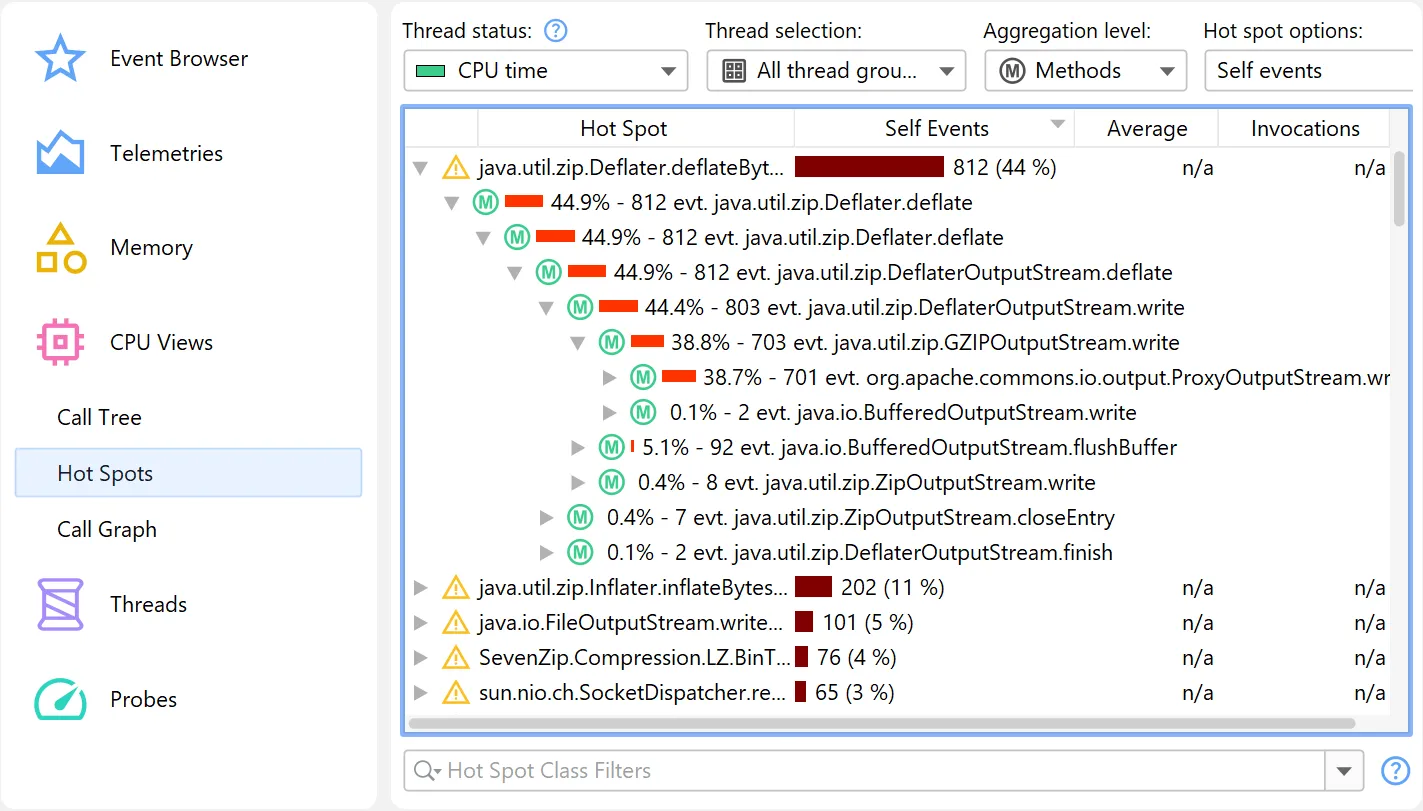
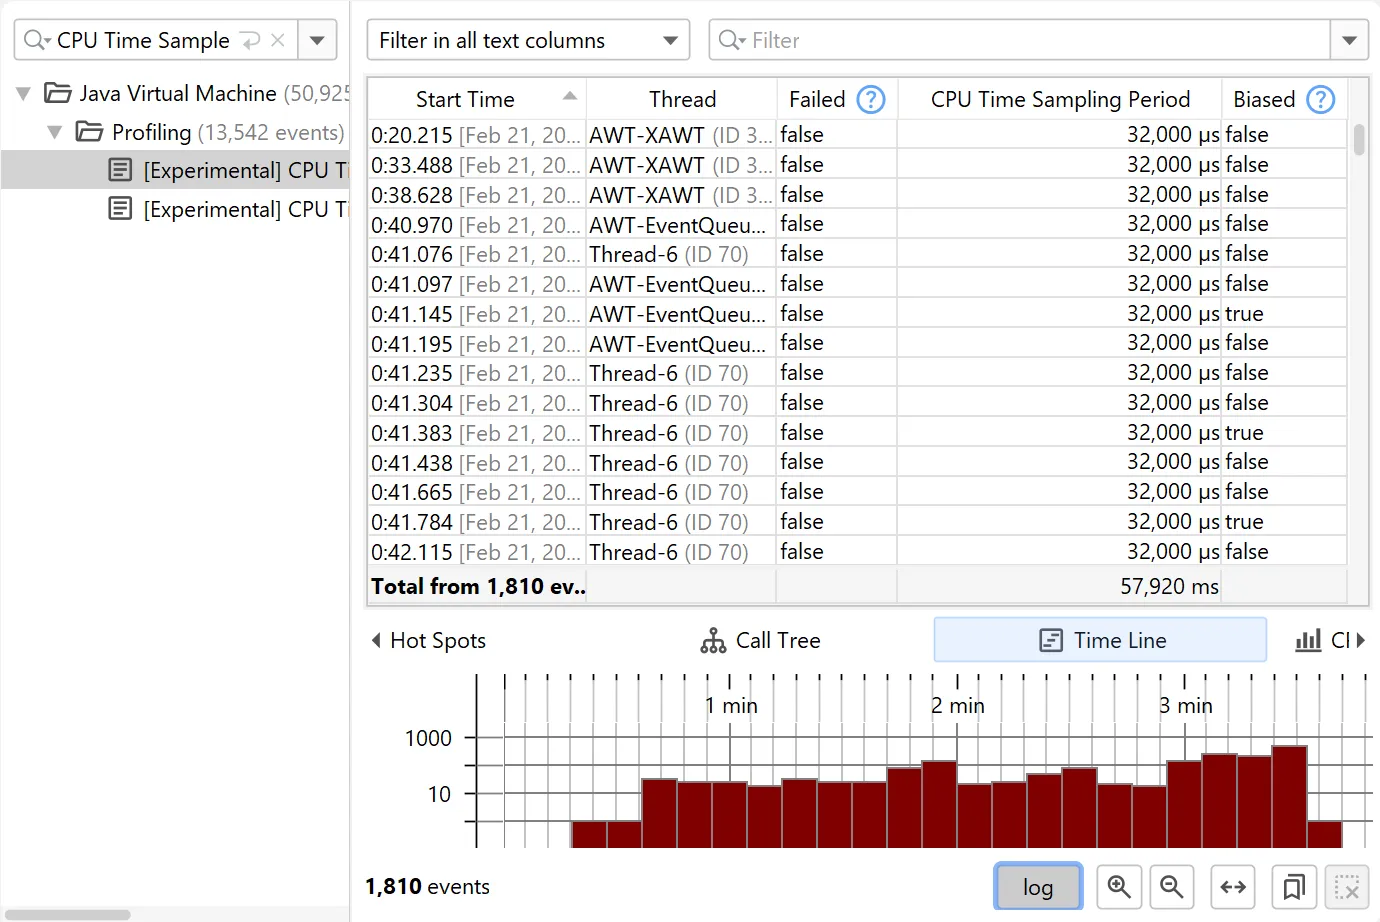
JProfiler 16부터 모든 실험적 JFR 이벤트가 이벤트 브라우저에 표시됩니다. 예를 들어 jdk.CPUTimeSample 이벤트가 그렇습니다.
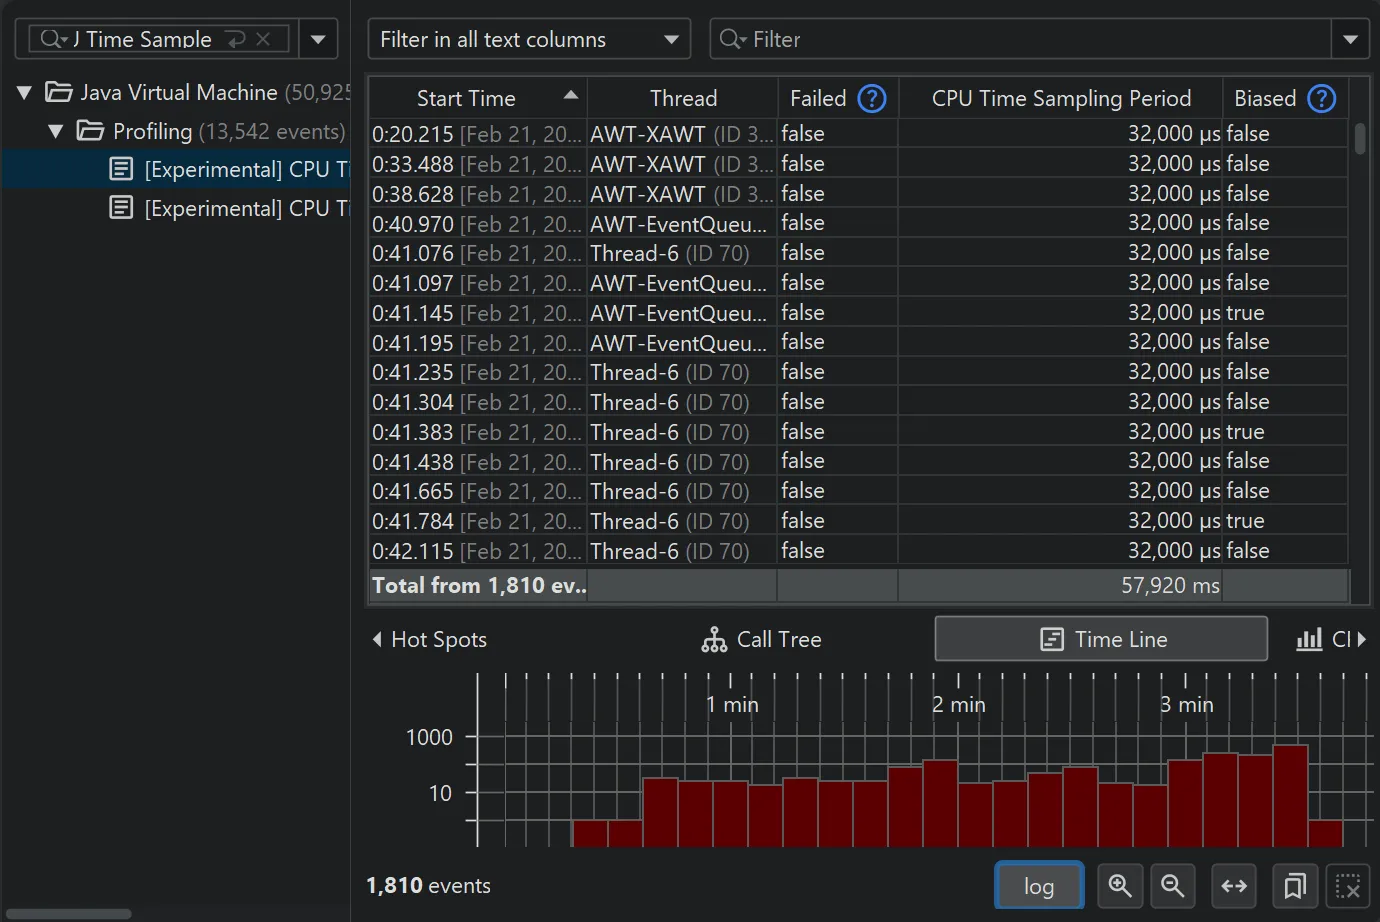
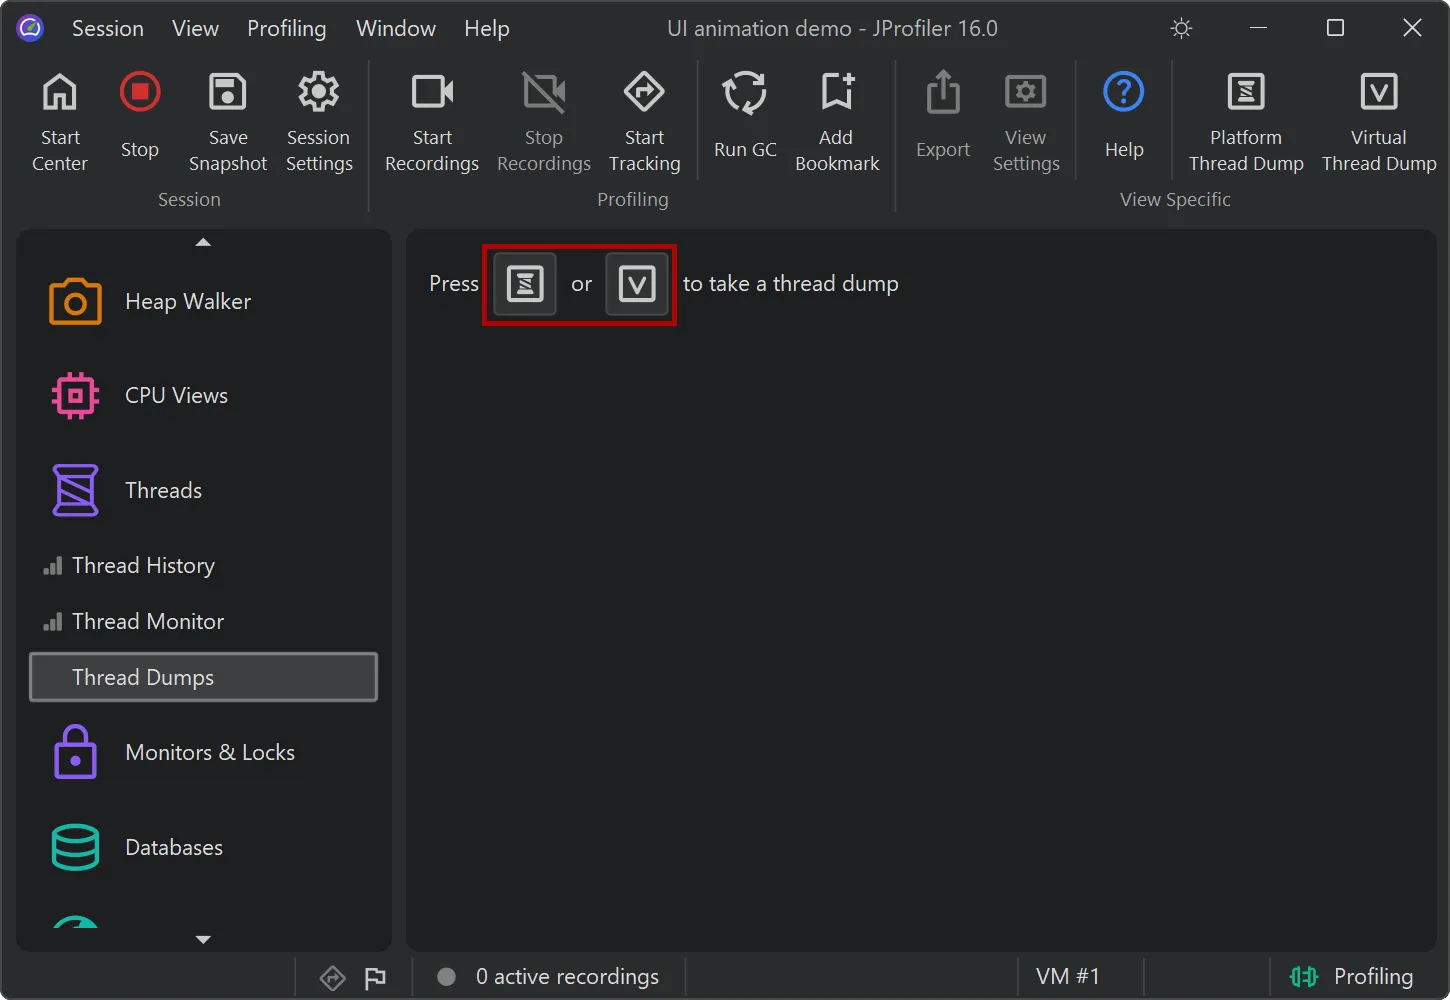
JProfiler 16에 가상 스레드 덤프 지원이 도입되었습니다.
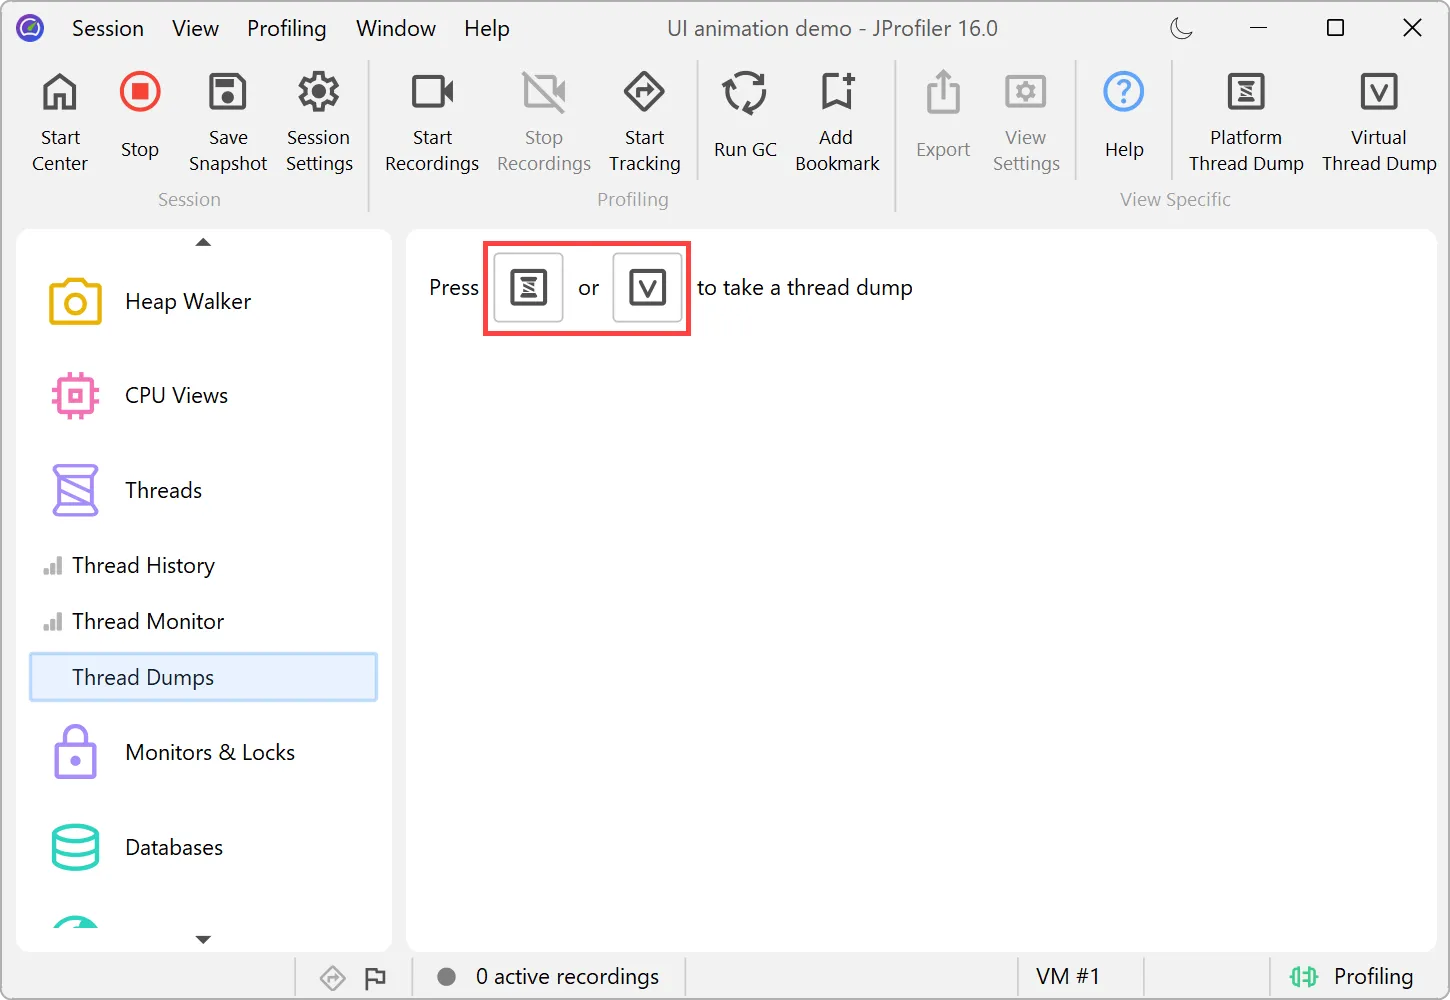
스레드 덤프 뷰에는 이제 두 가지 별개의 액션이 있습니다. 하나는 플랫폼 스레드 덤프용이고, 다른 하나는 가상 스레드 덤프용입니다.
가상 스레드 덤프에는 플랫폼 스레드도 포함되지만 비동기 방식으로 수행되므로, 가상 스레드를 다루지 않을 때는 동기 방식의 플랫폼 스레드 덤프가 더 적합합니다.
가상 스레드는 스레드 컨테이너 안에서 계층적으로 구성됩니다. 이는 Java 25 시점에서 아직 프리뷰 기능인 구조적 동시성을 사용할 때 중요합니다.
구조적 동시성에서는 각 스코프가 대응하는 스레드 컨테이너를 생성합니다. 덤프 하나에 깊게 중첩된 컨테이너 안의 수백만 개 가상 스레드가 포함될 수 있으므로, 가상 스레드 덤프는 플랫폼 스레드 덤프보다 훨씬 커질 수 있습니다.
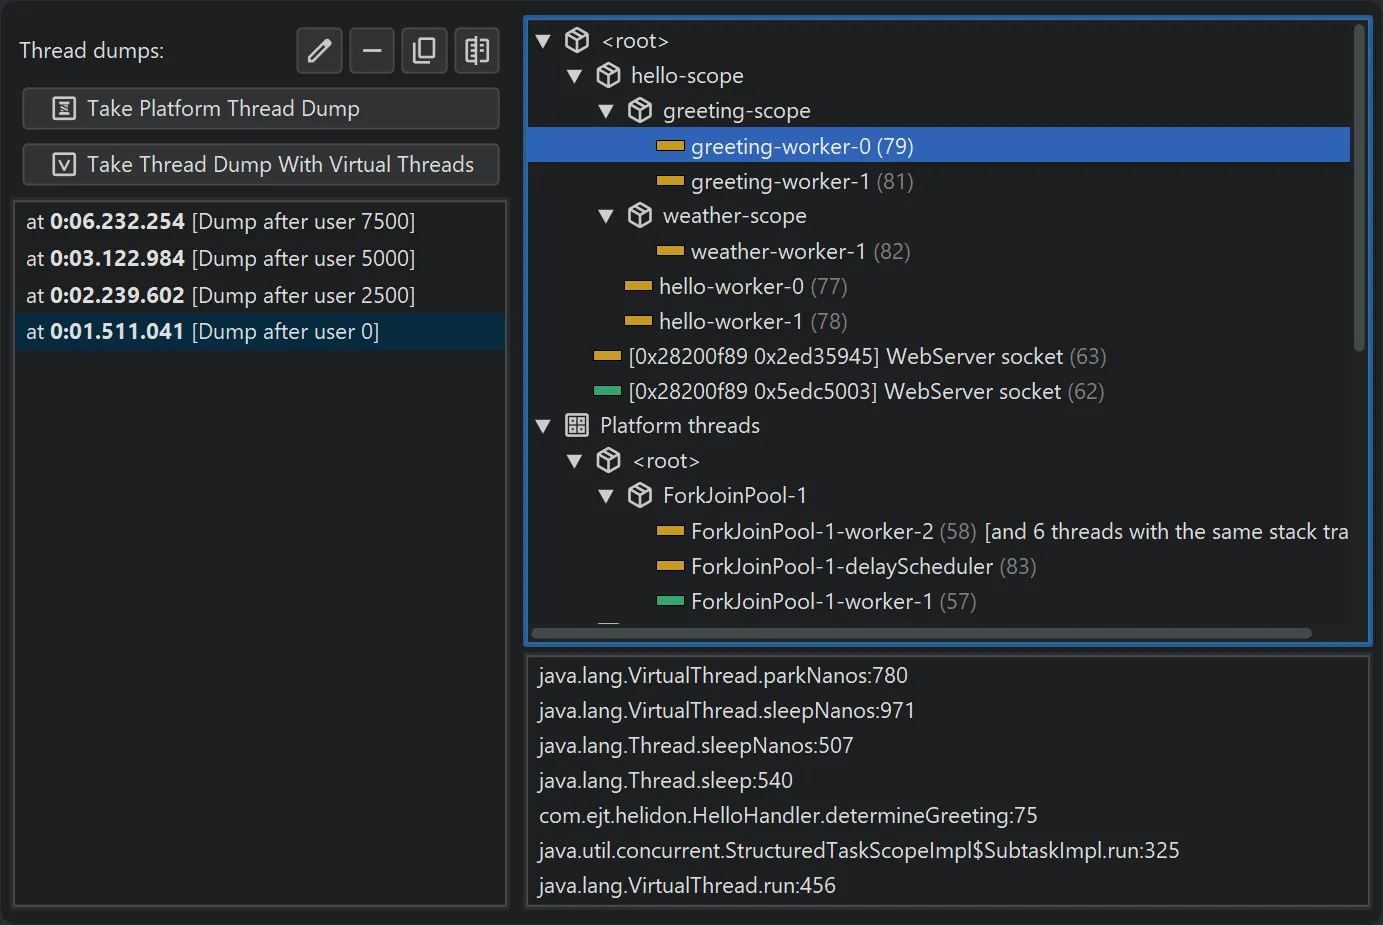
개별 가상 스레드 두 개 또는 스레드 덤프 전체 두 개를 선택하고 컨텍스트 메뉴에서 비교 액션을 선택하면 이를 비교할 수 있습니다.
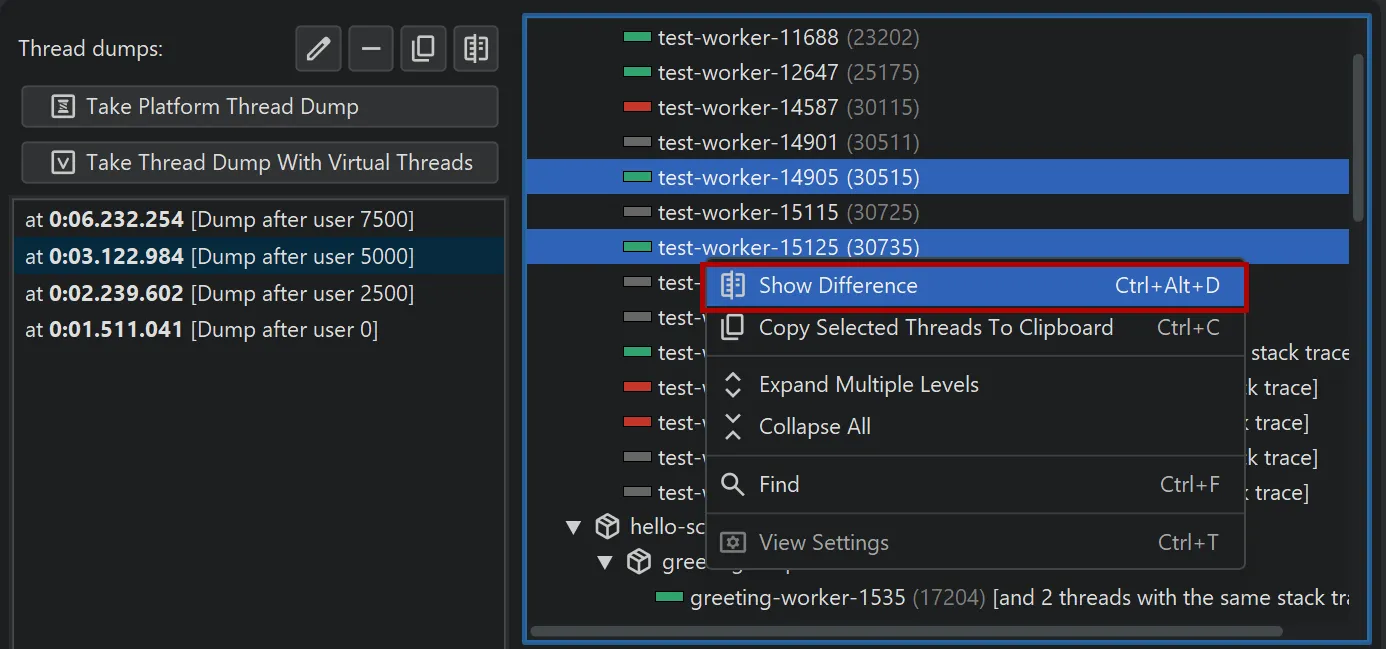
비교 결과는 별도 창의 diff 뷰어에 표시됩니다.
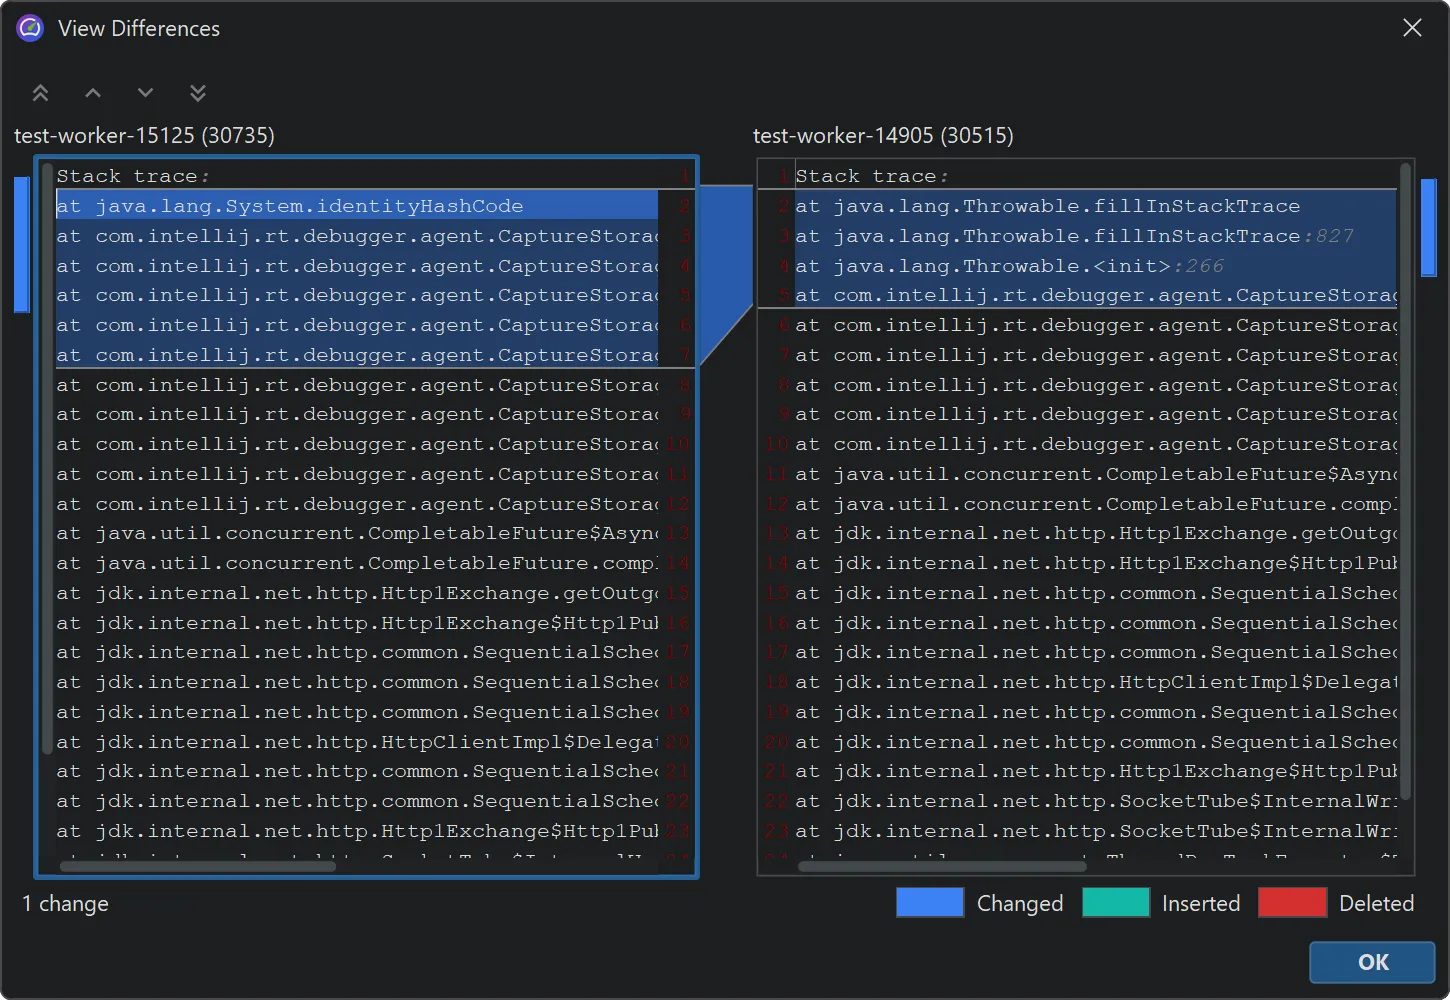
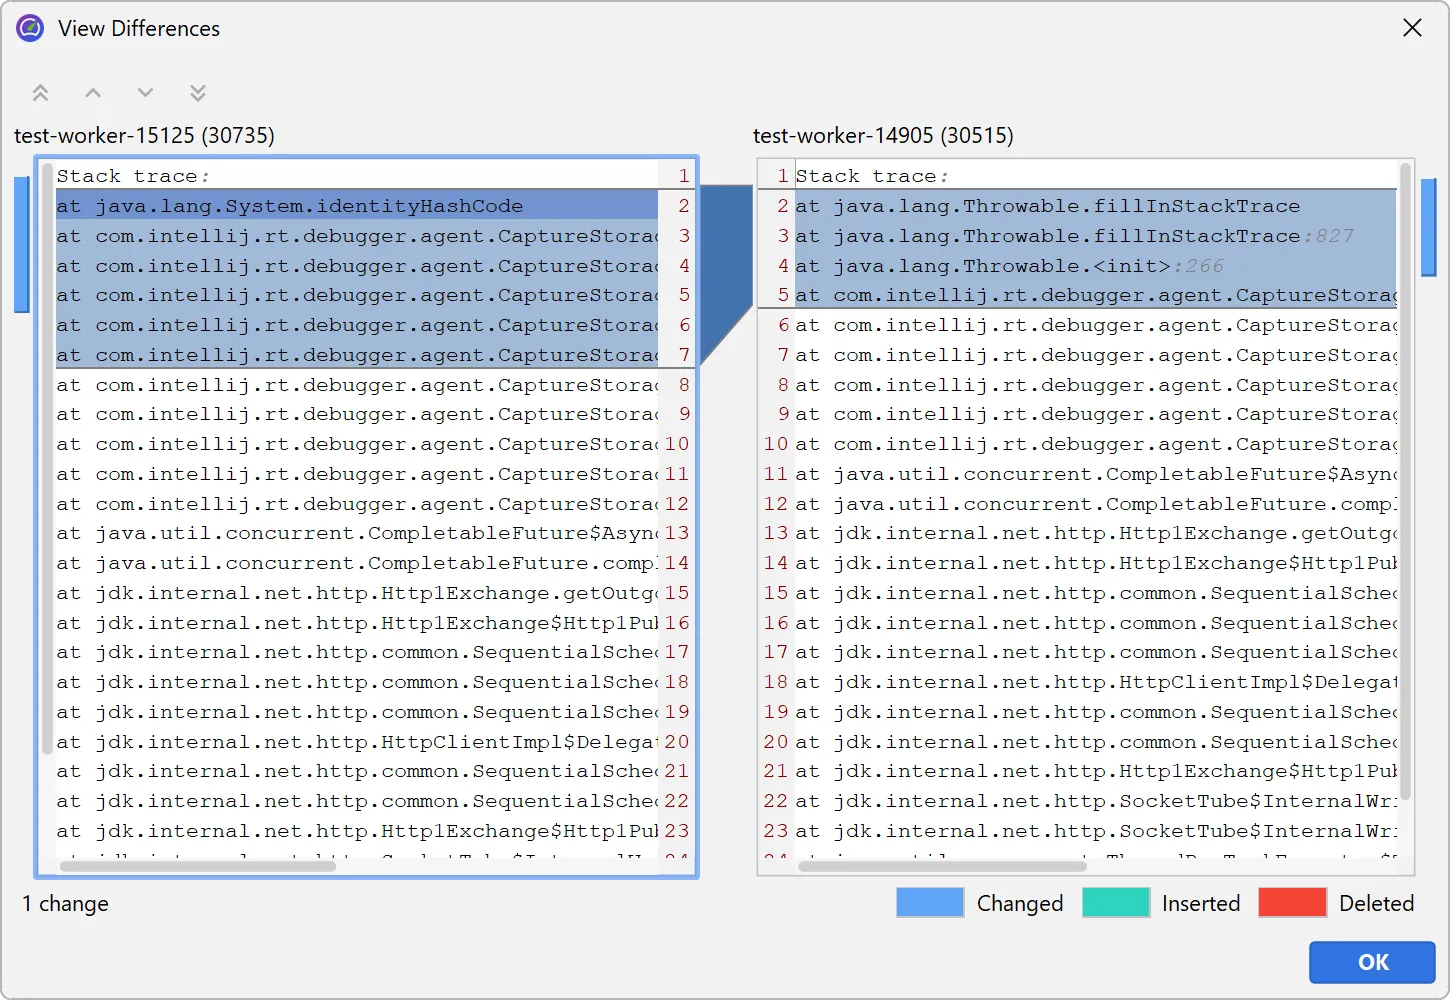
개별 스레드, 여러 스레드 또는 스레드 덤프 전체를 클립보드로 복사하려면 컨텍스트 메뉴에서 해당 액션을 사용하십시오.
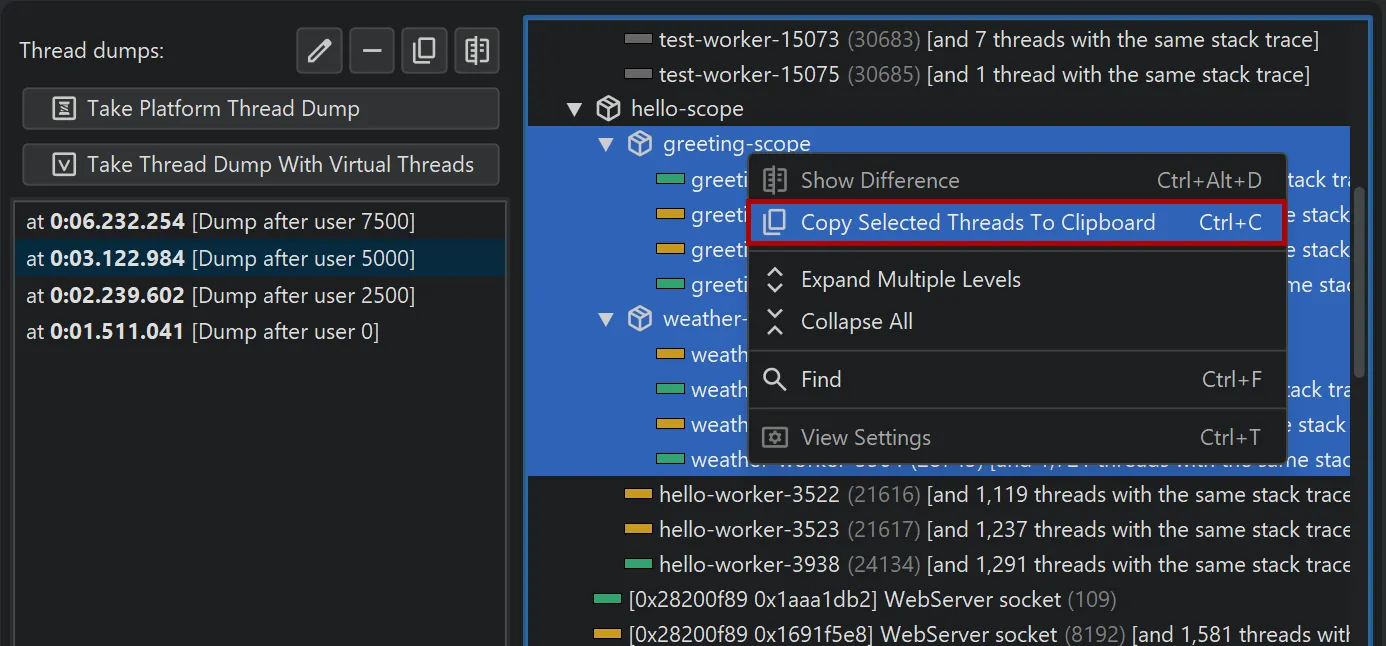
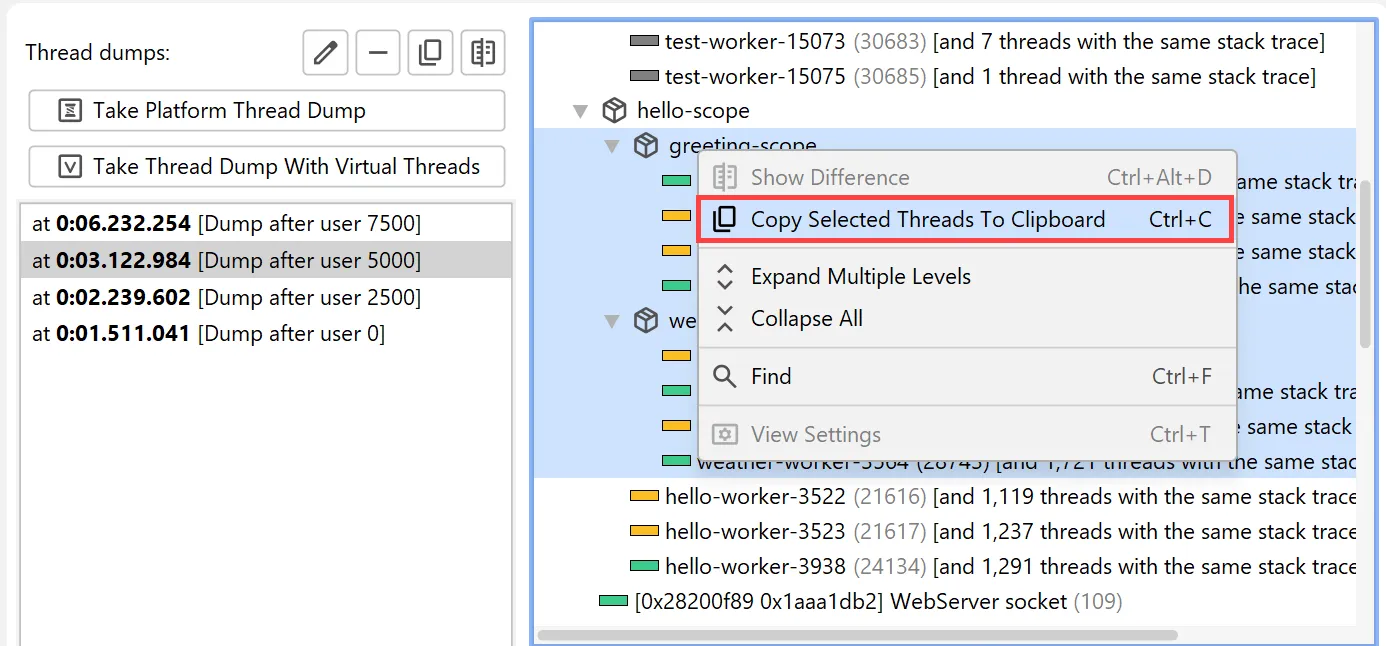
가상 스레드 덤프는 동일한 계층 위치에서 동일한 스택 트레이스를 가진 스레드들을 하나의 노드로 묶습니다.
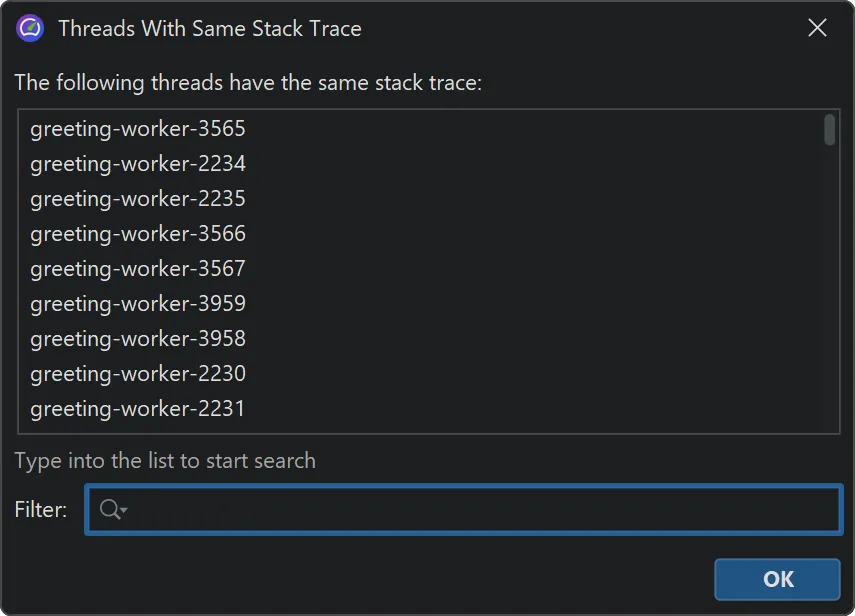
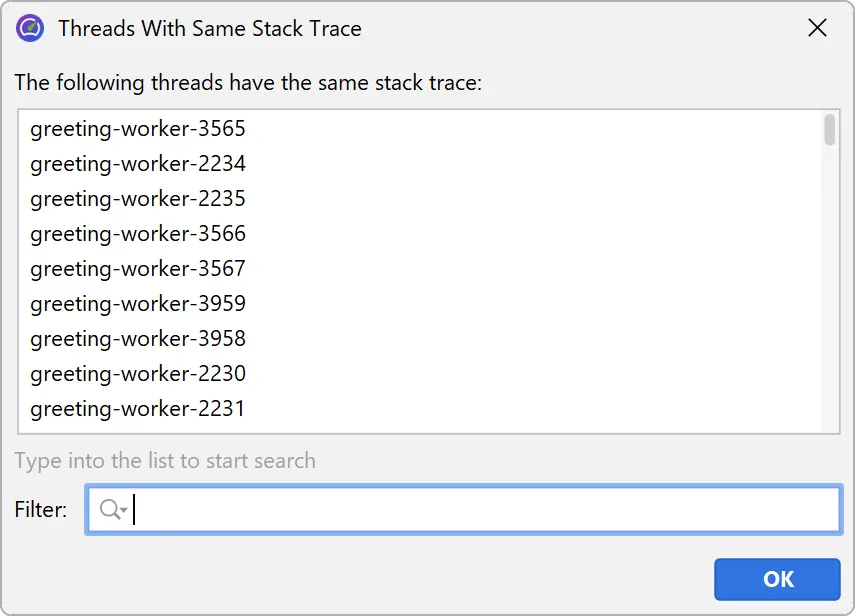
컨텍스트 메뉴에는 묶인 모든 스레드 이름을 표시하는 액션이 포함되어 있습니다.
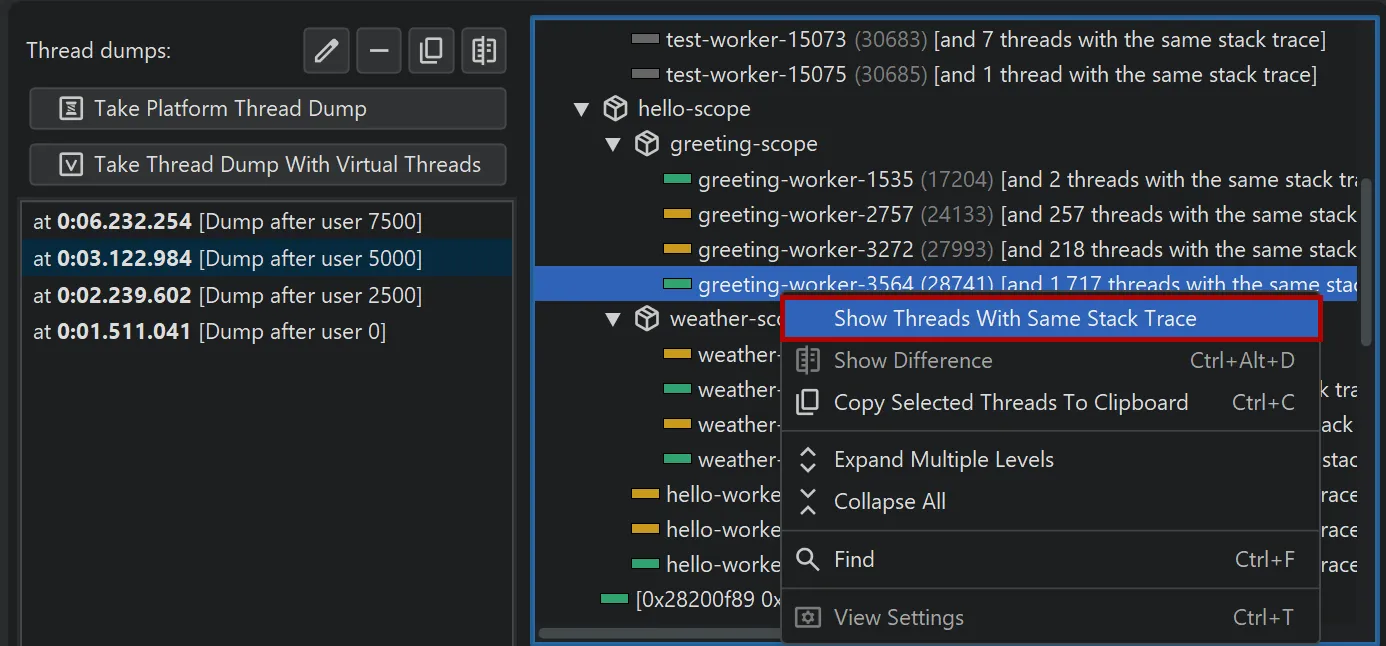
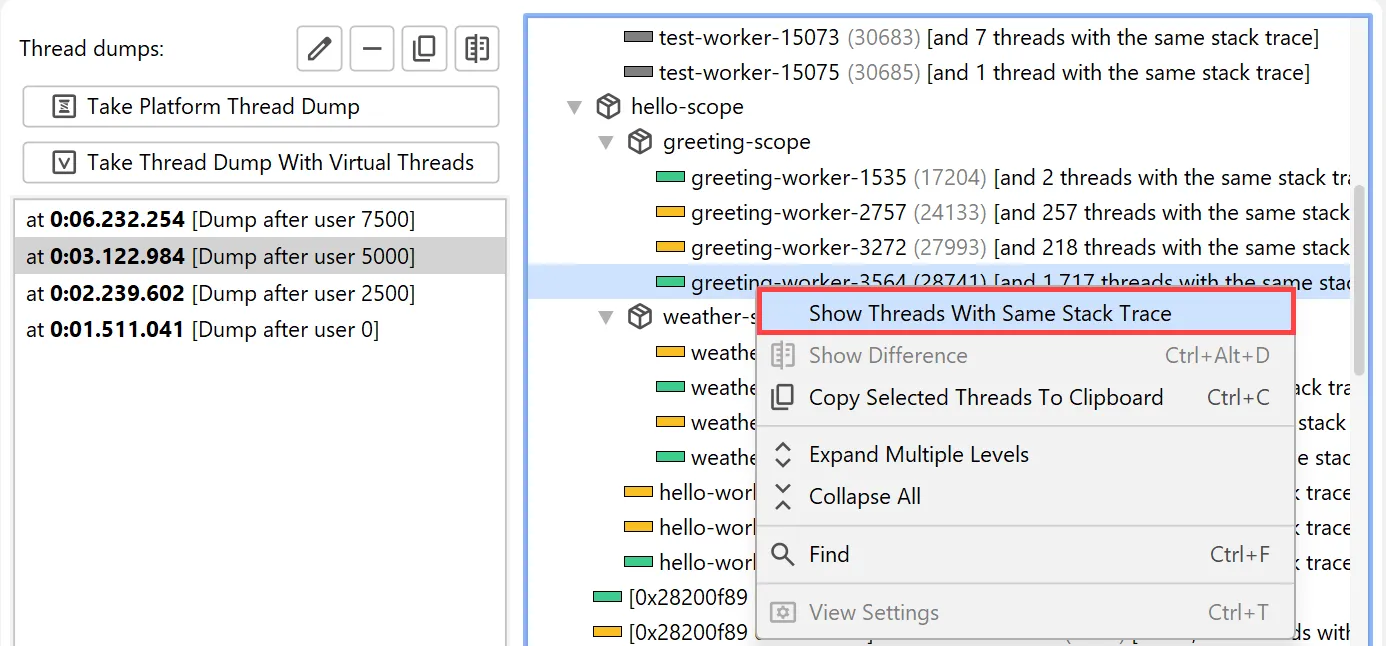
묶인 스레드의 이름은 별도 창에 표시되며, 여기서 관심 있는 스레드 이름을 필터링할 수 있습니다.
스레드 그룹화는 플랫폼 스레드 덤프에서도 지원됩니다.
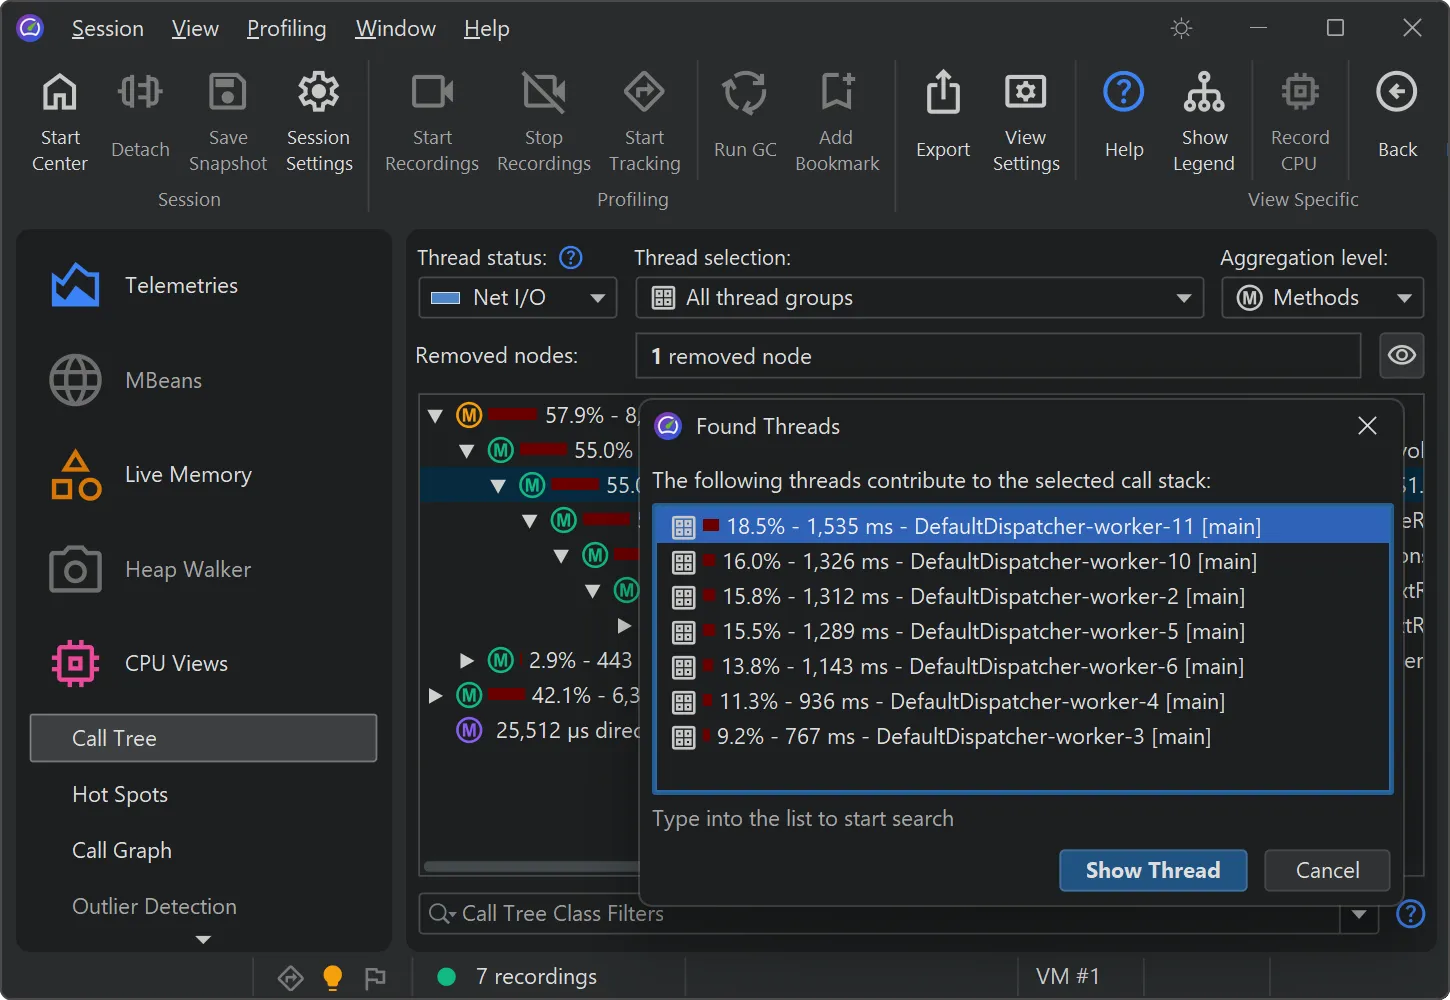
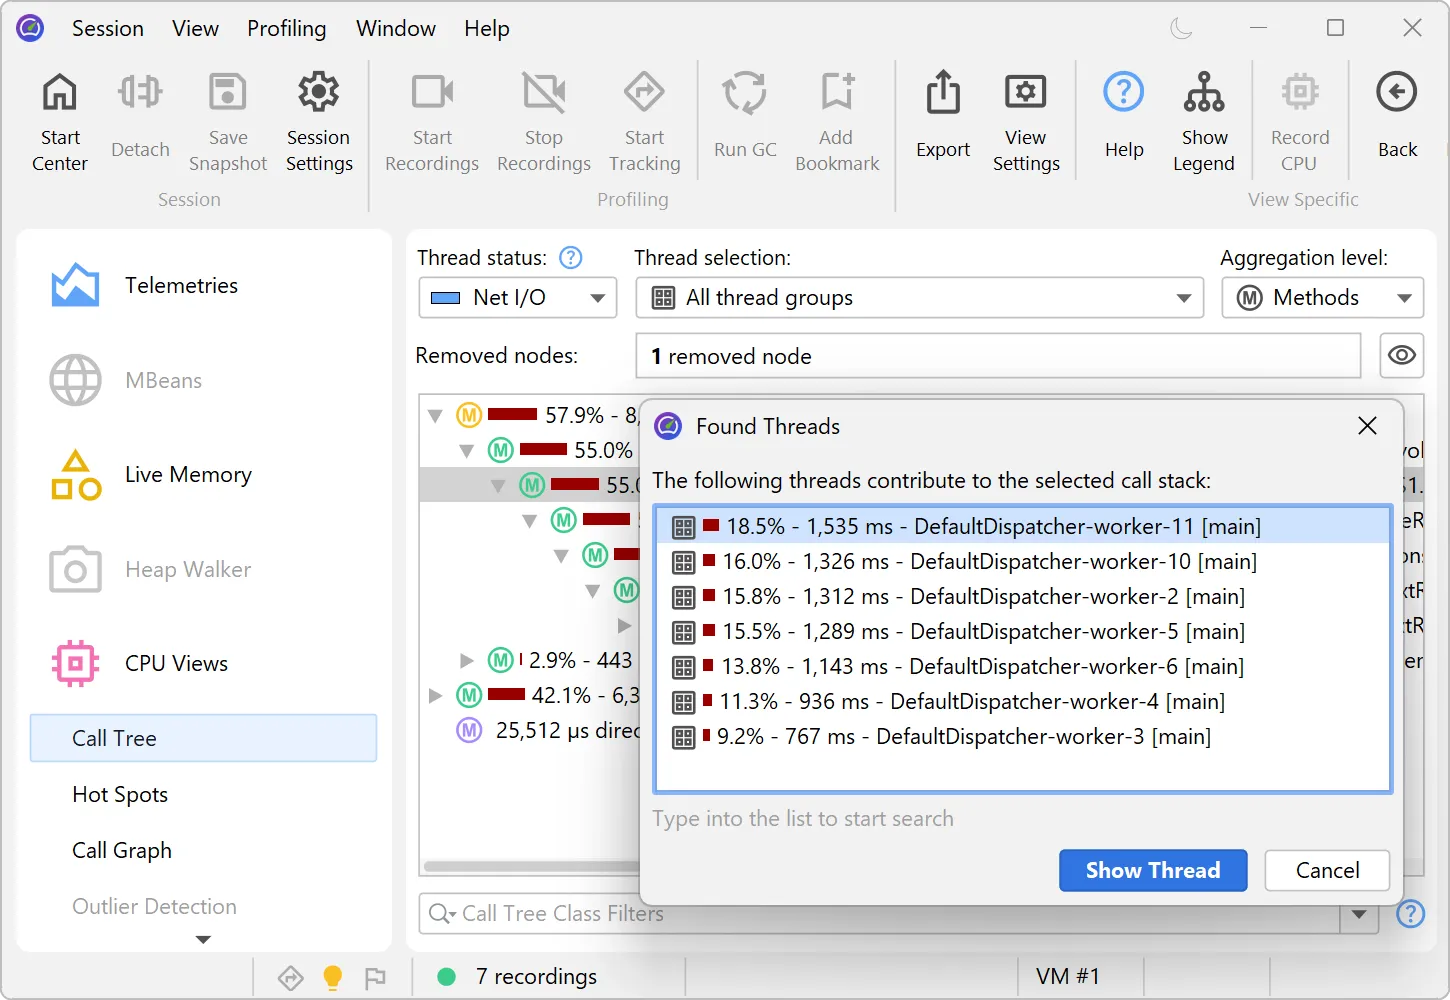
이제 누적 콜 트리에서 개별 스레드의 기여도를 분석할 수 있습니다. 콜 트리 뷰에서 컨텍스트 메뉴의 "스레드 표시"를 선택하면 선택한 노드에 대해 이 데이터가 계산됩니다.
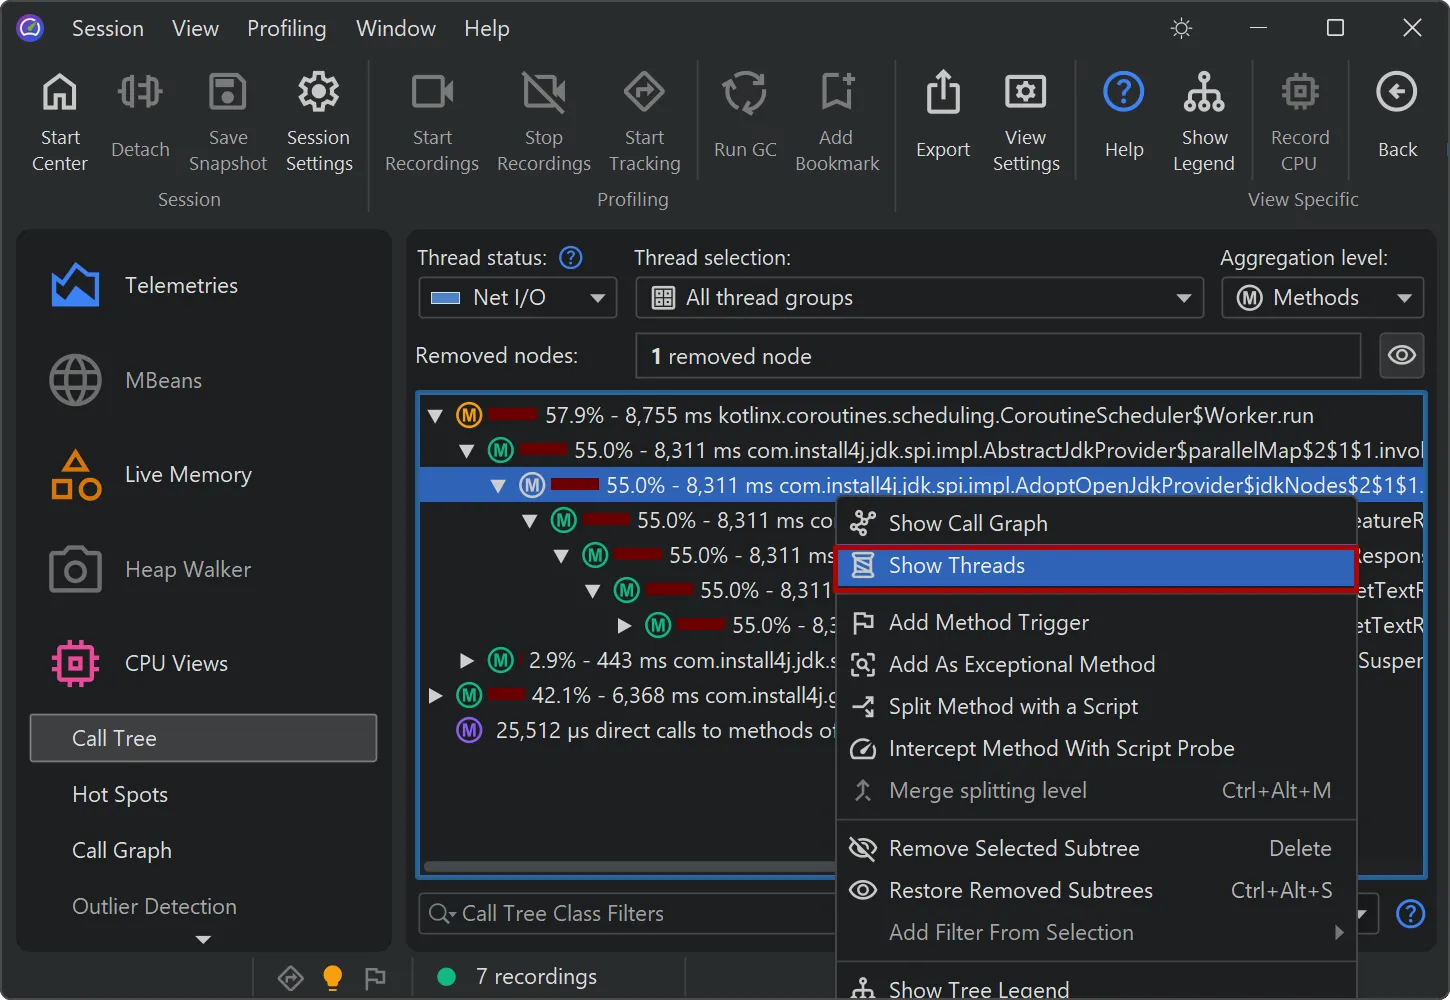
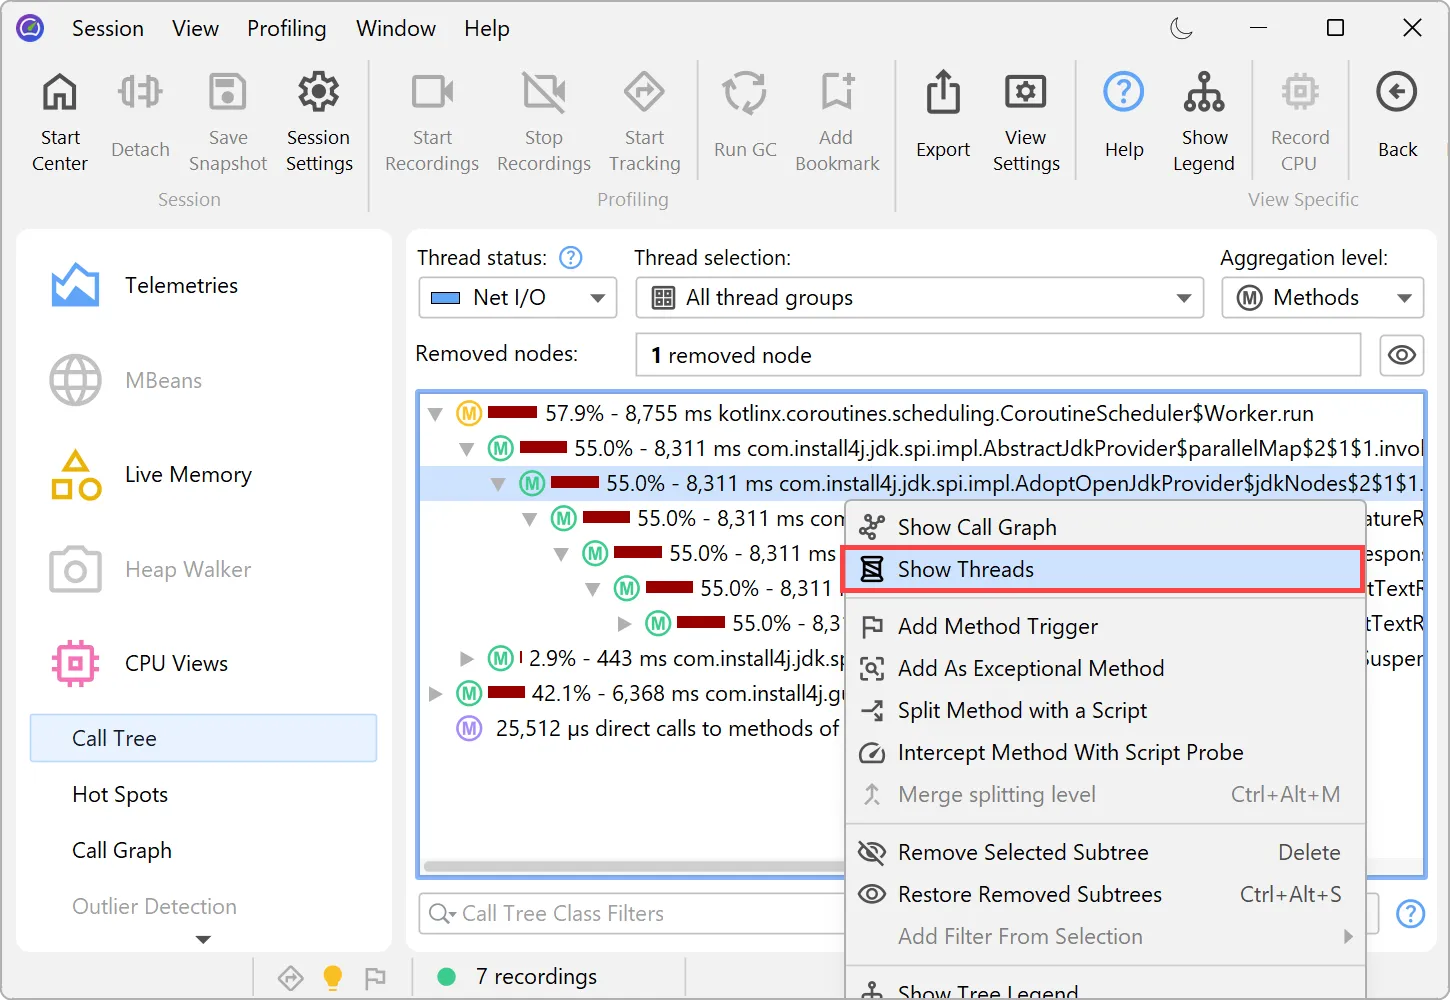
기여하는 모든 스레드의 백분율 분석을 보여 주는 별도 대화 상자가 표시됩니다. 원하는 경우 스레드 하나를 선택한 다음 콜 트리 뷰에서 해당 스레드의 콜 트리로 전환할 수 있습니다.
이 기능은 스레드별 성능 문제를 파악하는 데 도움이 됩니다. 예를 들어 스레드 풀에서 문제를 일으키는 스레드를 분리하고 싶을 때 유용합니다.
노드 상세 대화 상자가 여러 면에서 개선되었습니다.
노드 상세 대화 상자는 선택한 요소에 대한 추가 정보를 표시하는 중요한 도구로, "보기" 메뉴 또는 컨텍스트 메뉴에서 사용할 수 있습니다.
핫스팟 뷰에서 여러 노드를 선택하면 이제 선택 영역에 대한 누적 통계가 표시됩니다.
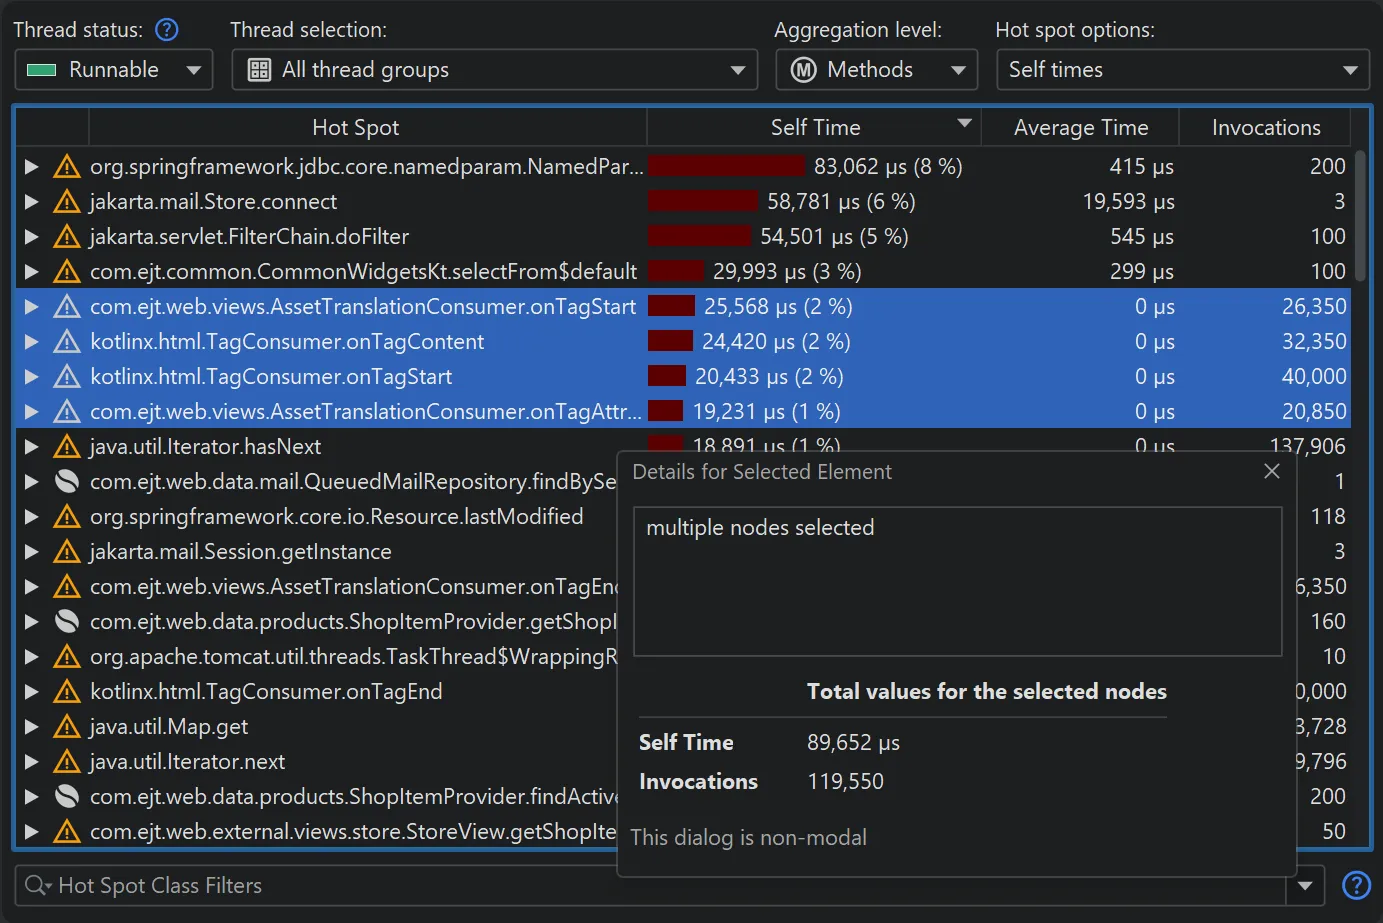
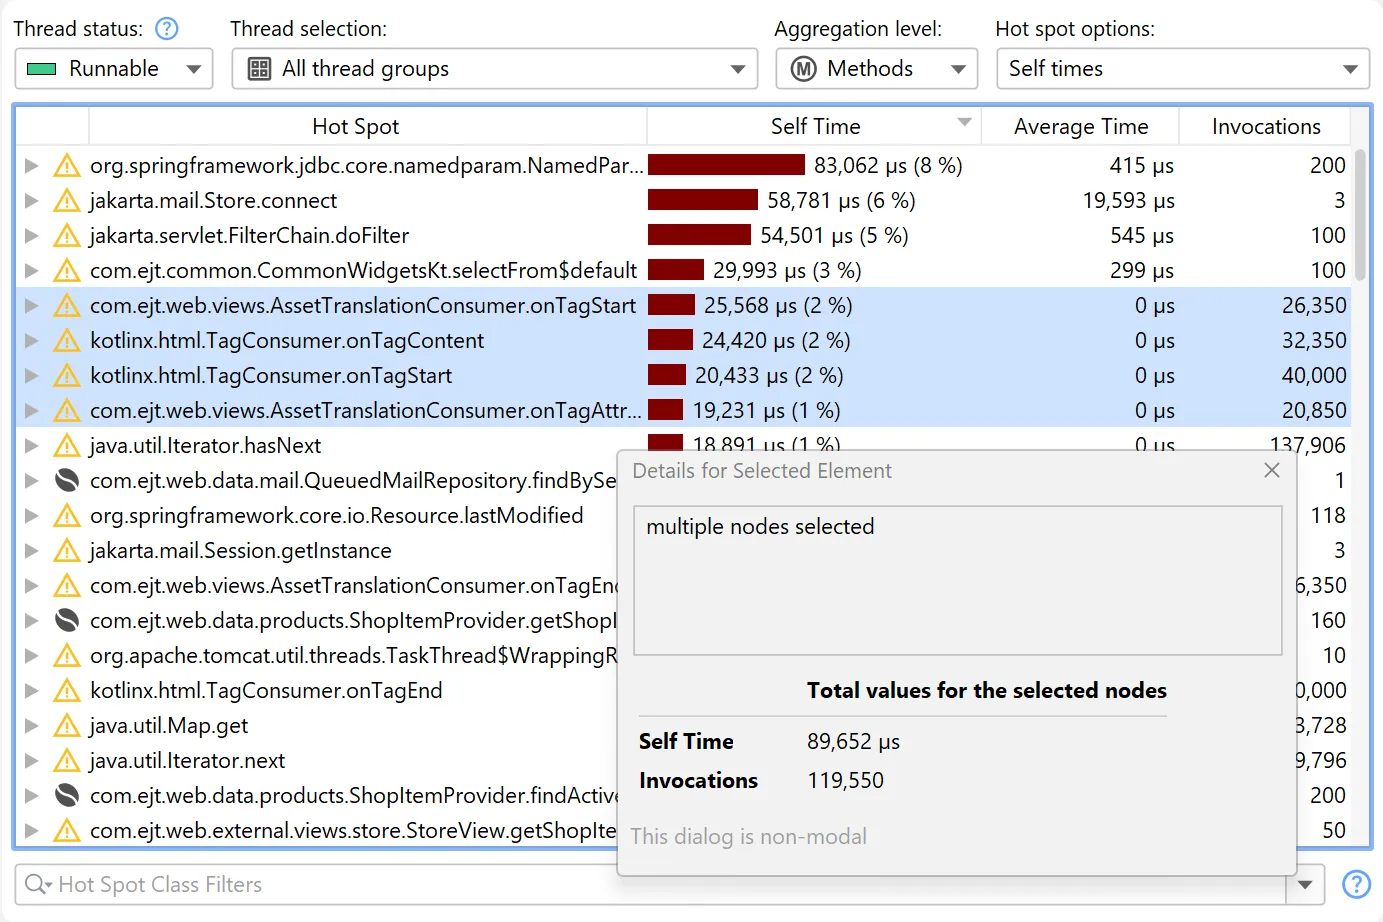
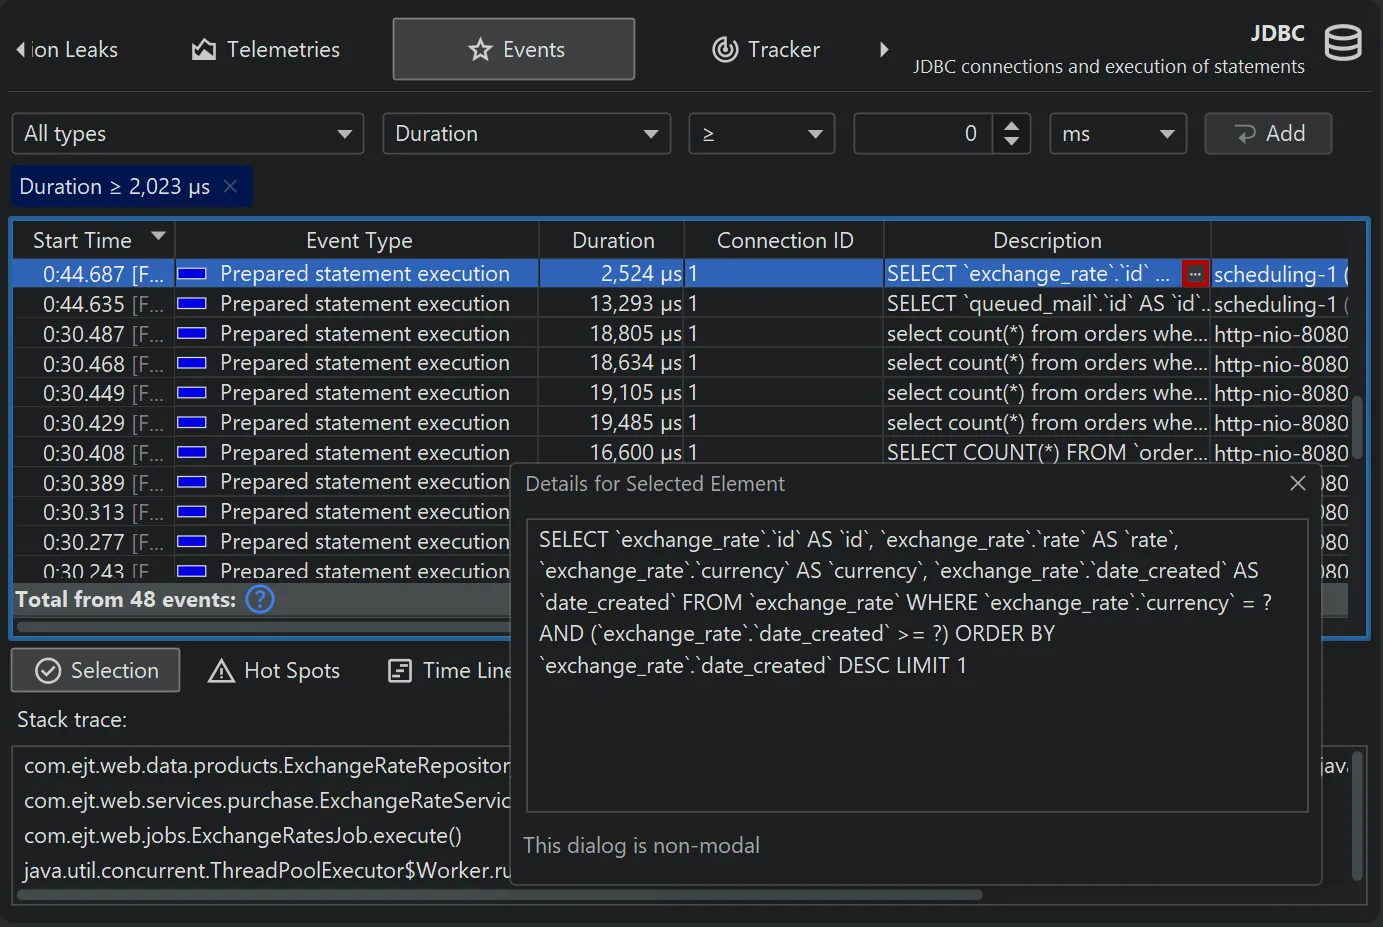
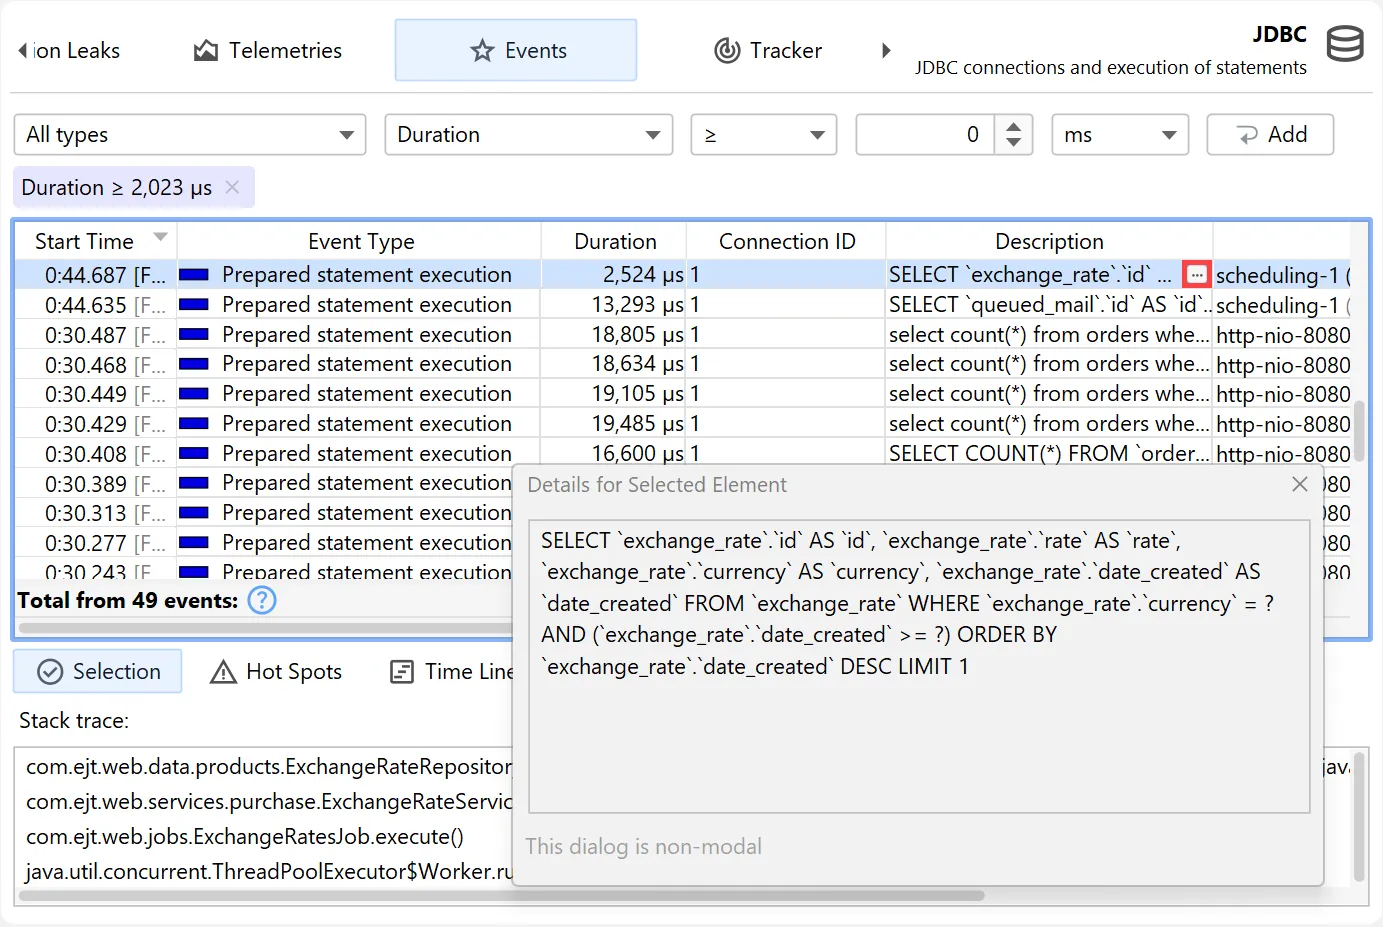
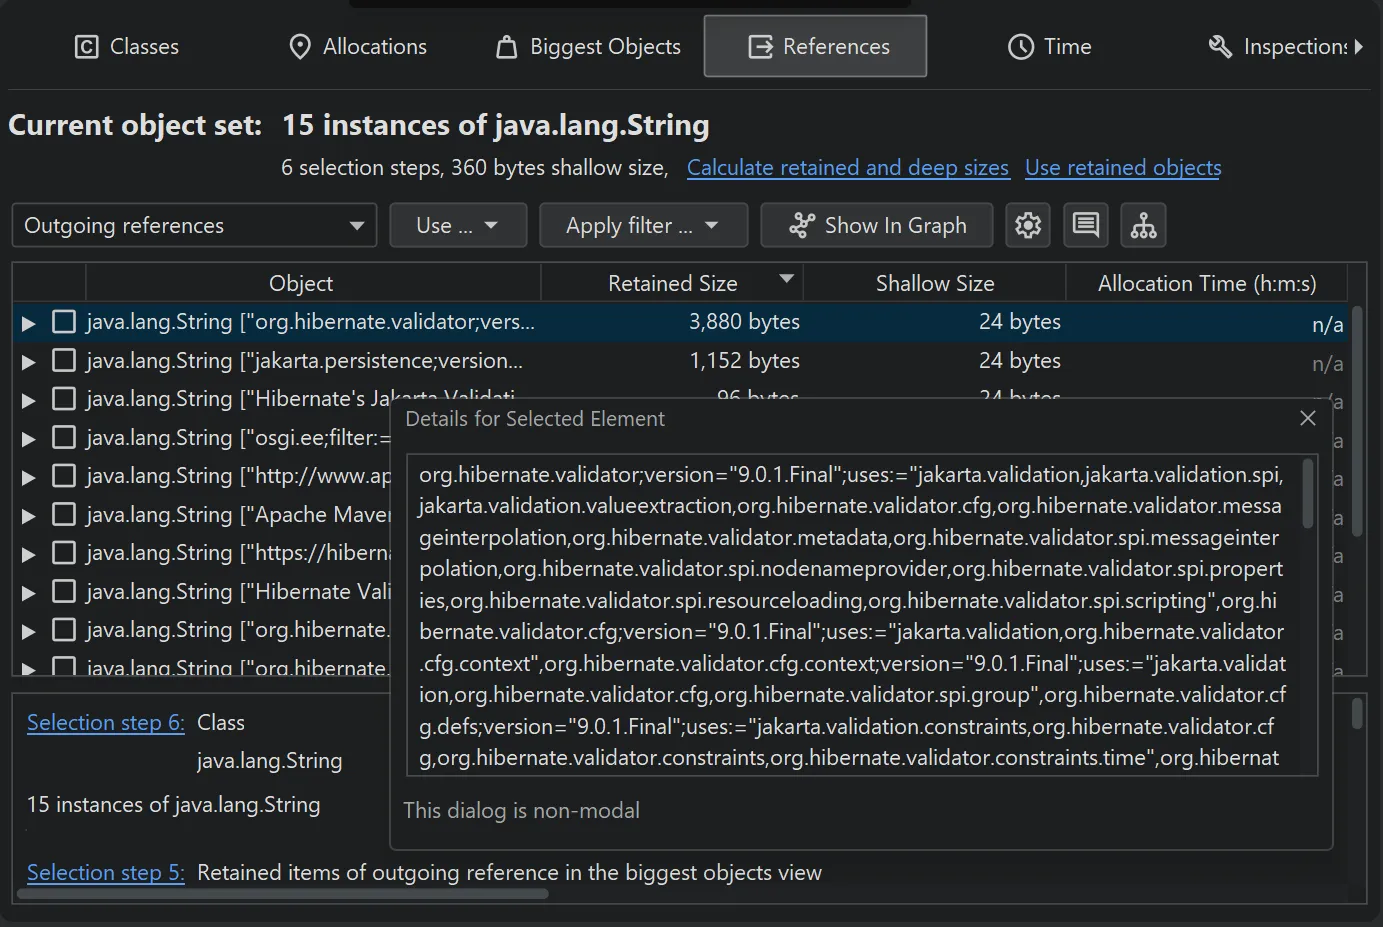
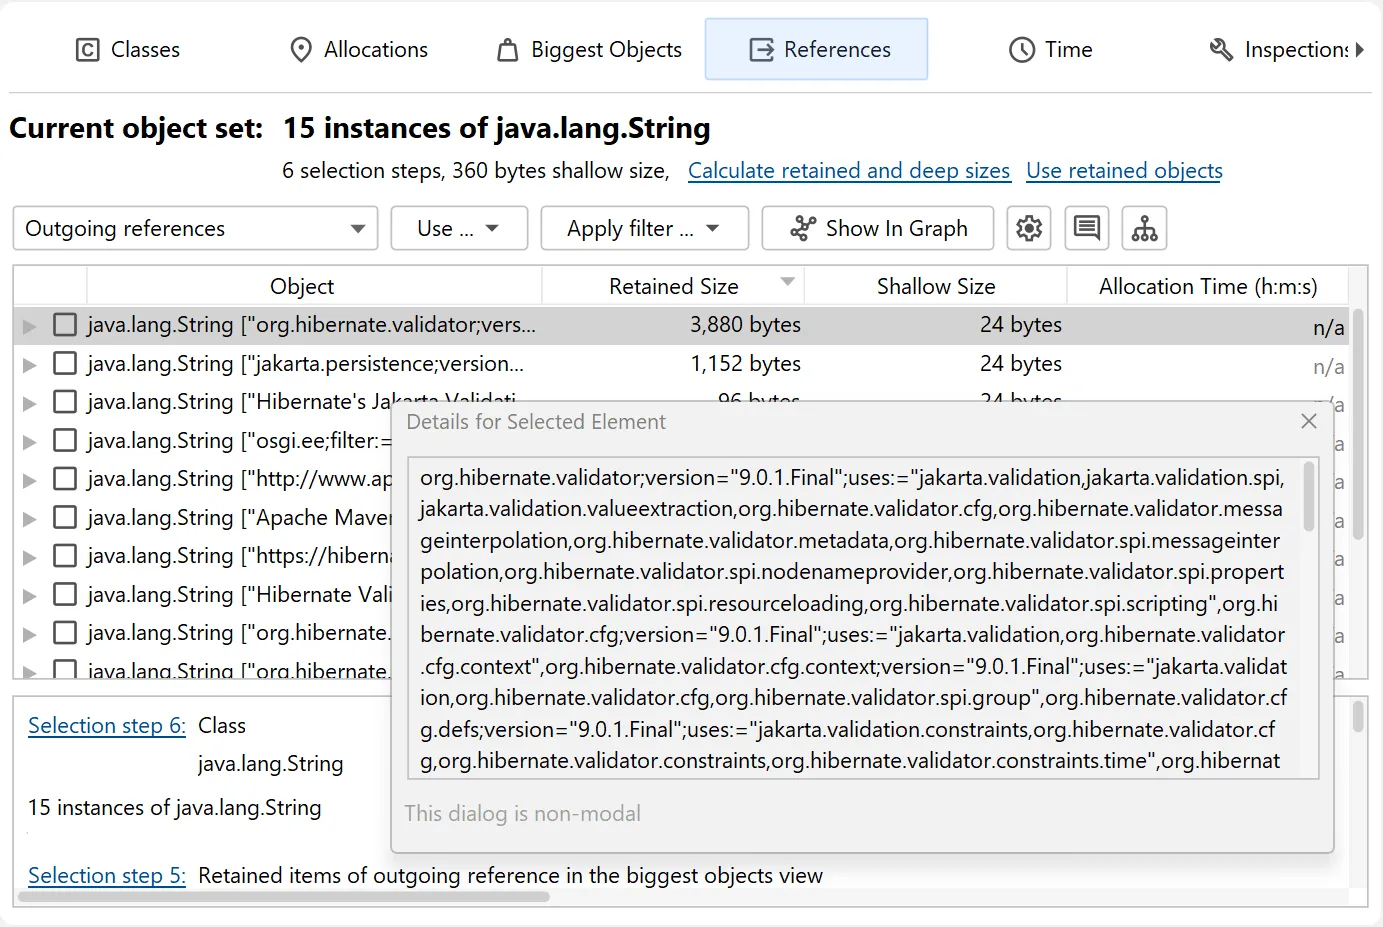
JProfiler의 많은 테이블에는 열 너비를 초과하는 긴 텍스트가 들어 있는 열이 있습니다. 이 경우 노드 상세 대화 상자가 전체 텍스트를 보여 줍니다. JProfiler 16부터는 노드 상세 대화 상자를 바로 열어 주는 호버 버튼이 제공되며, 테이블에 긴 텍스트 열이 여러 개일 때는 올바른 탭을 활성화합니다.
힙 워커에서 노드 상세 대화 상자는 이제 참조 뷰의 문자열 값 전체를 표시하며, 더 이상 표시된 잘린 미리보기 문자열에만 머무르지 않습니다.
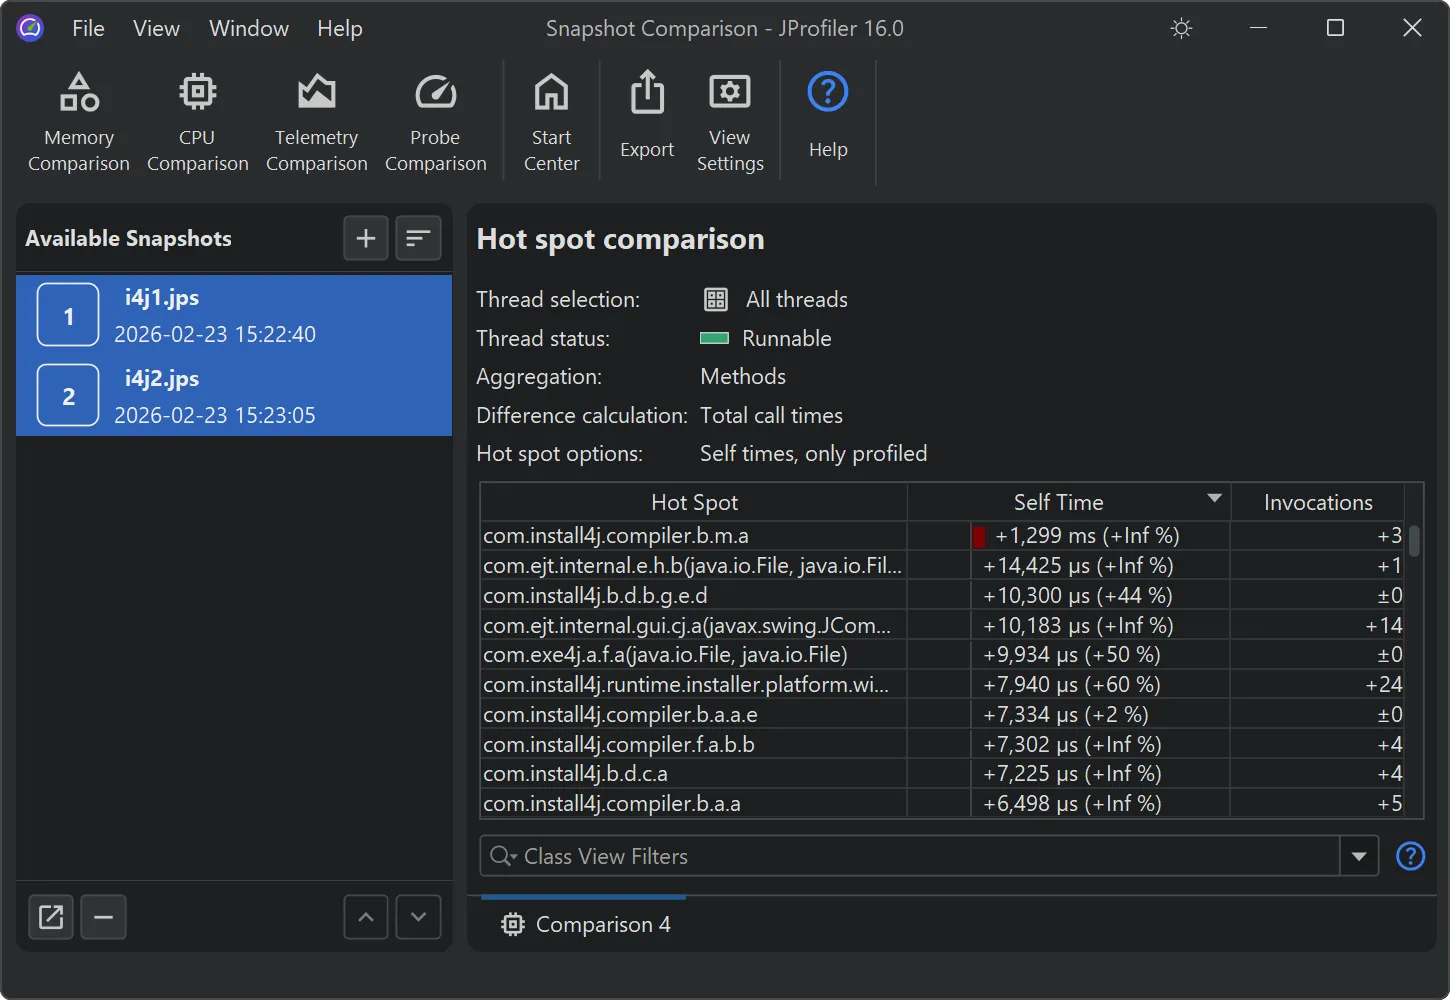
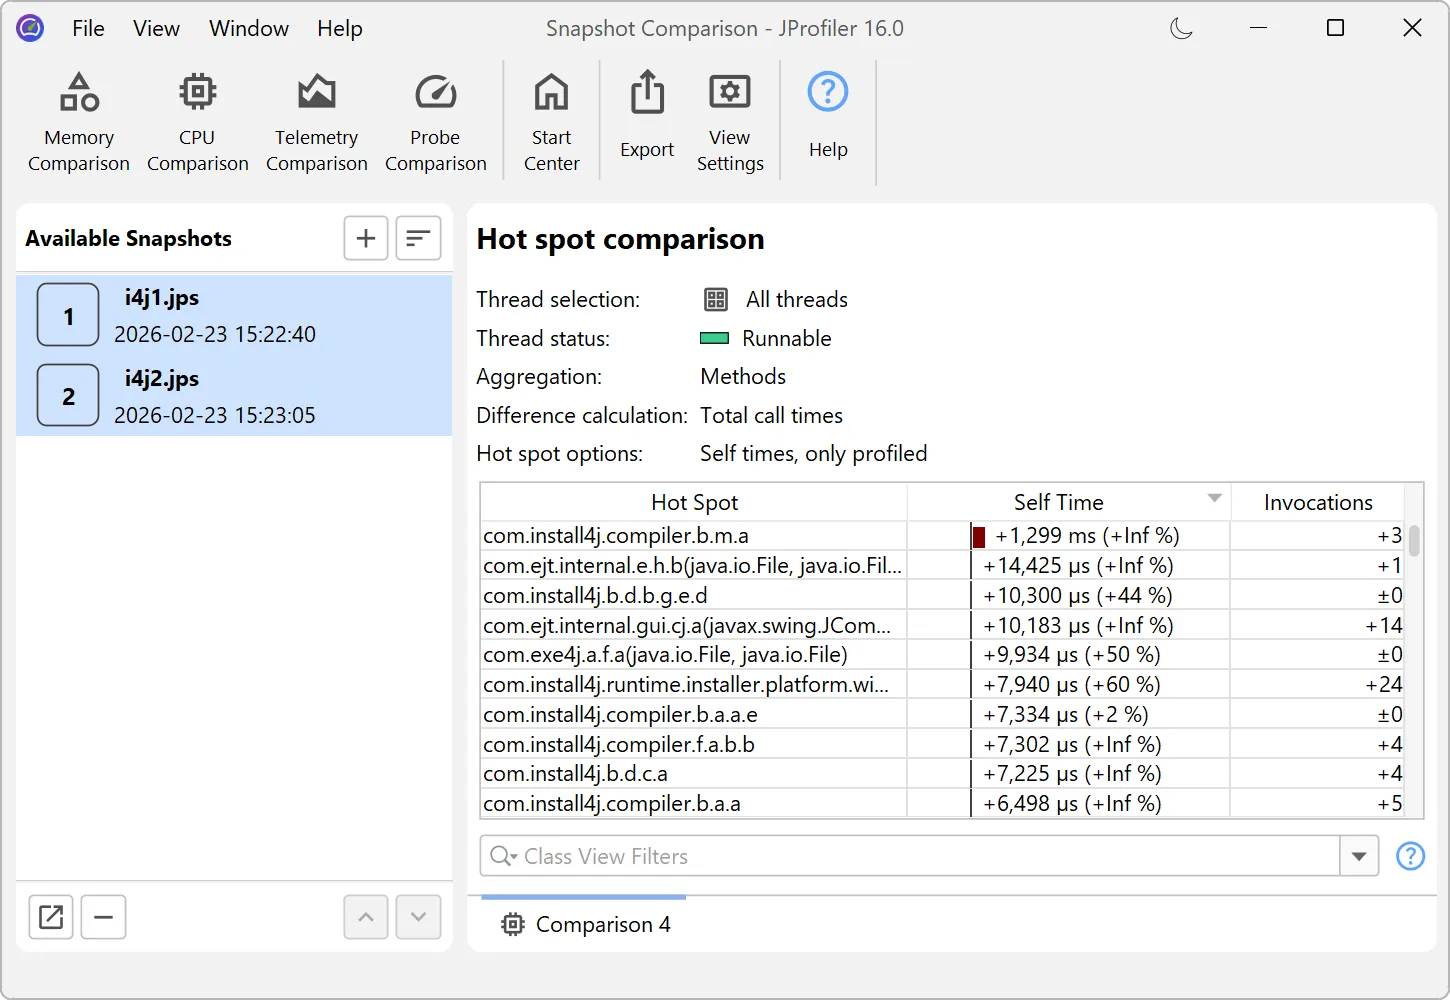
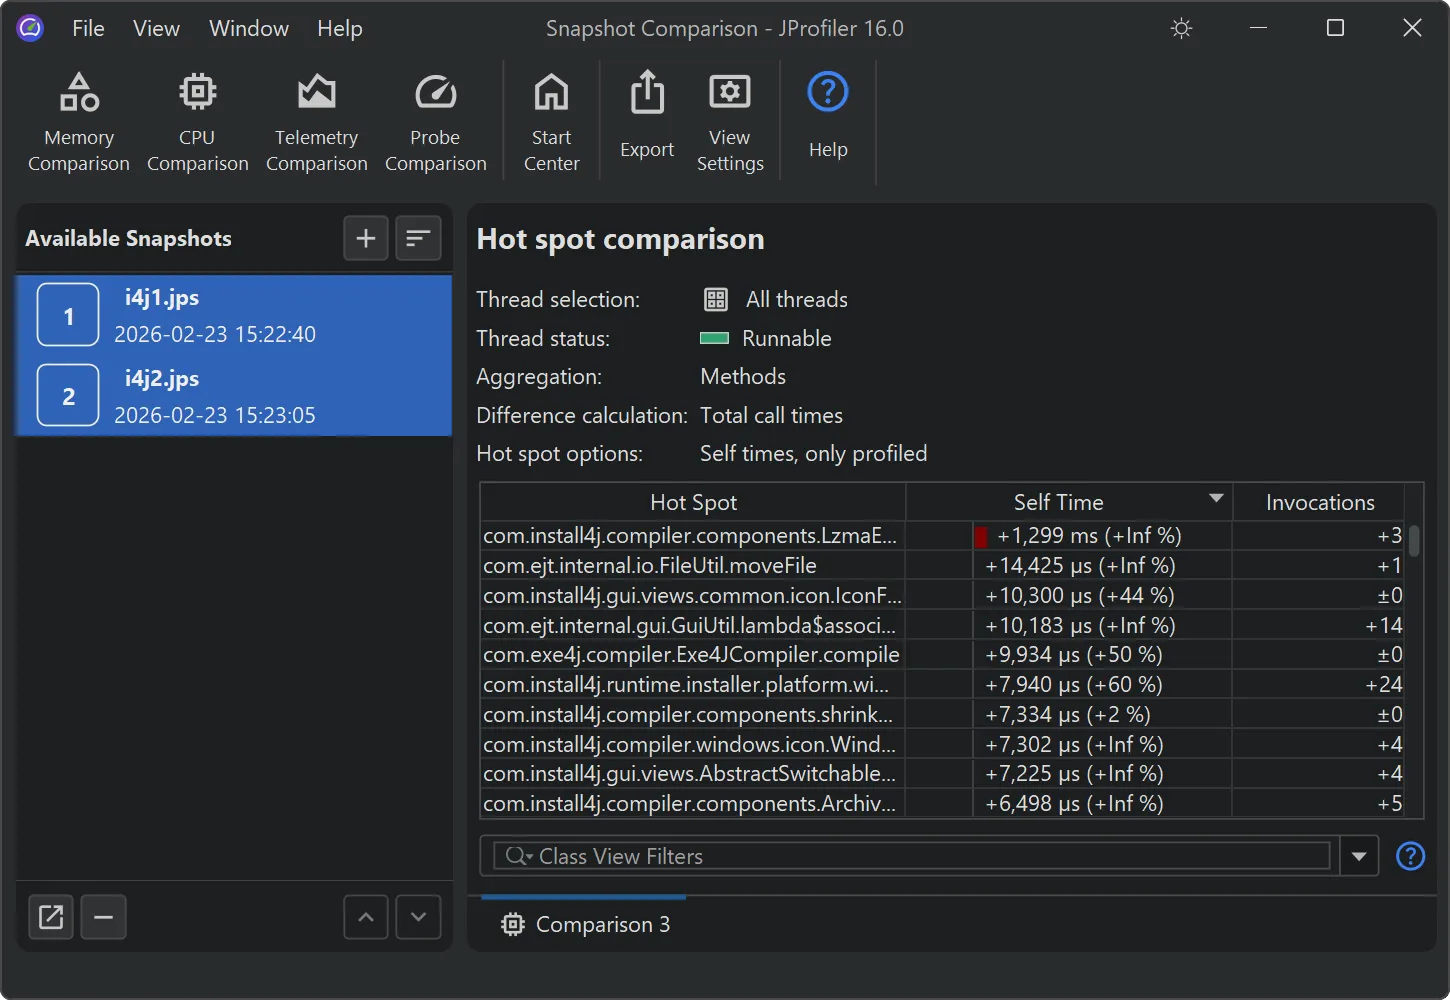
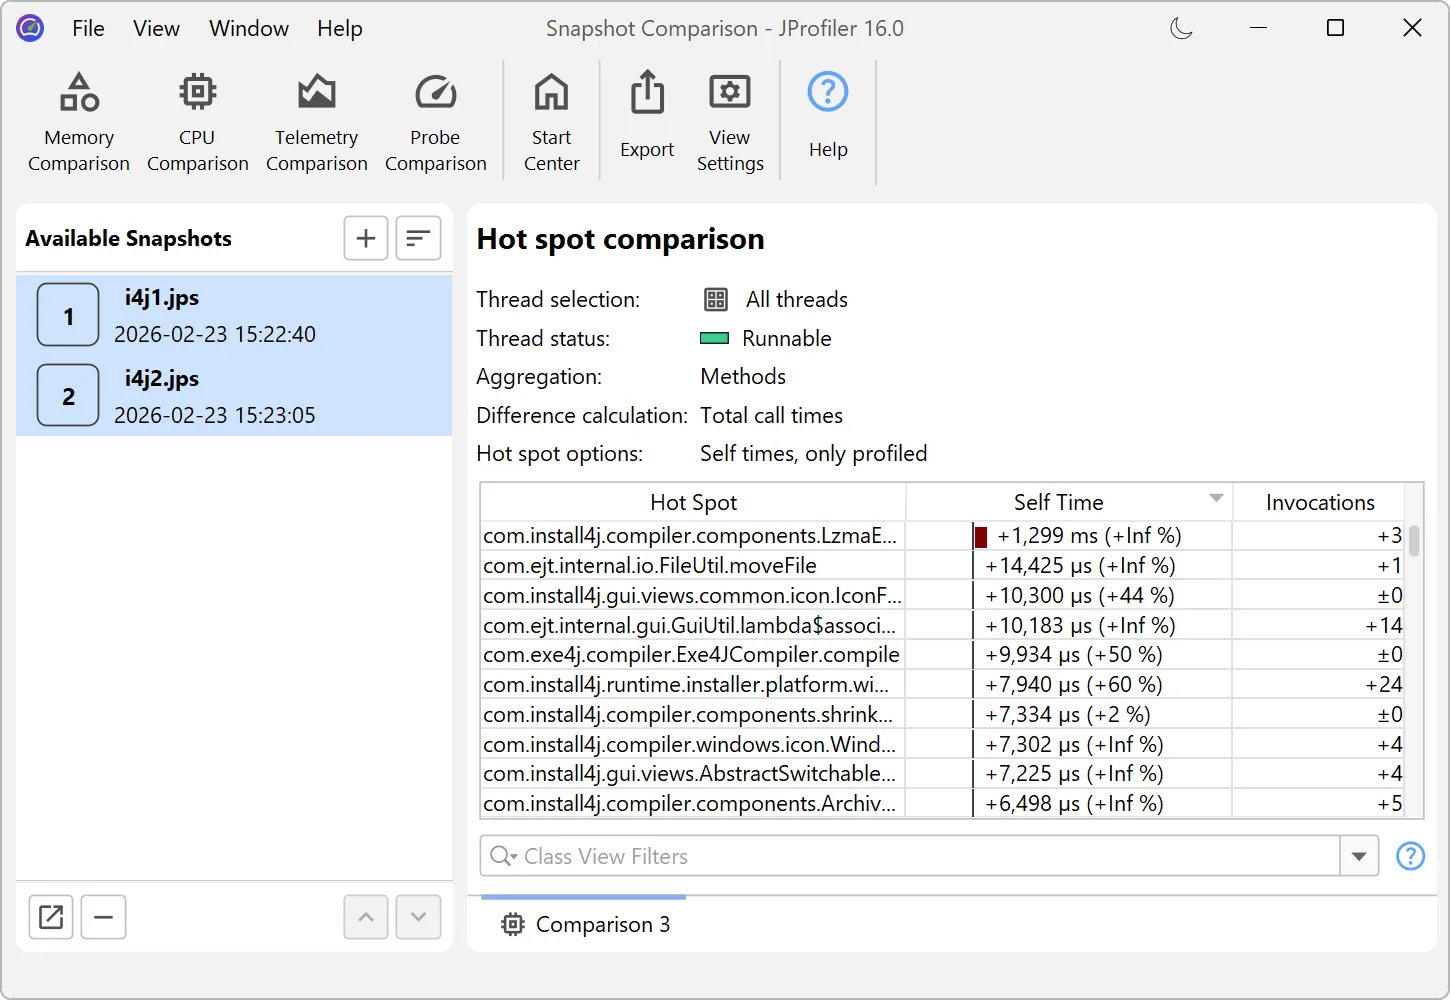
JProfiler가 이제 스냅샷 비교를 위한 난독화 해제를 지원합니다.
이전에는 난독화된 애플리케이션의 스냅샷을 비교할 때 클래스와 메서드의 난독화를 해제할 방법이 없었습니다. 아래는 난독화된 이름을 사용한 비교 예제입니다.
스냅샷을 열 때 제공되던 기존 난독화 해제 지원과 마찬가지로, 비교 창에 스냅샷을 추가할 때는 파일 선택기에 이제 "난독화 해제" 체크 박스가 포함됩니다.
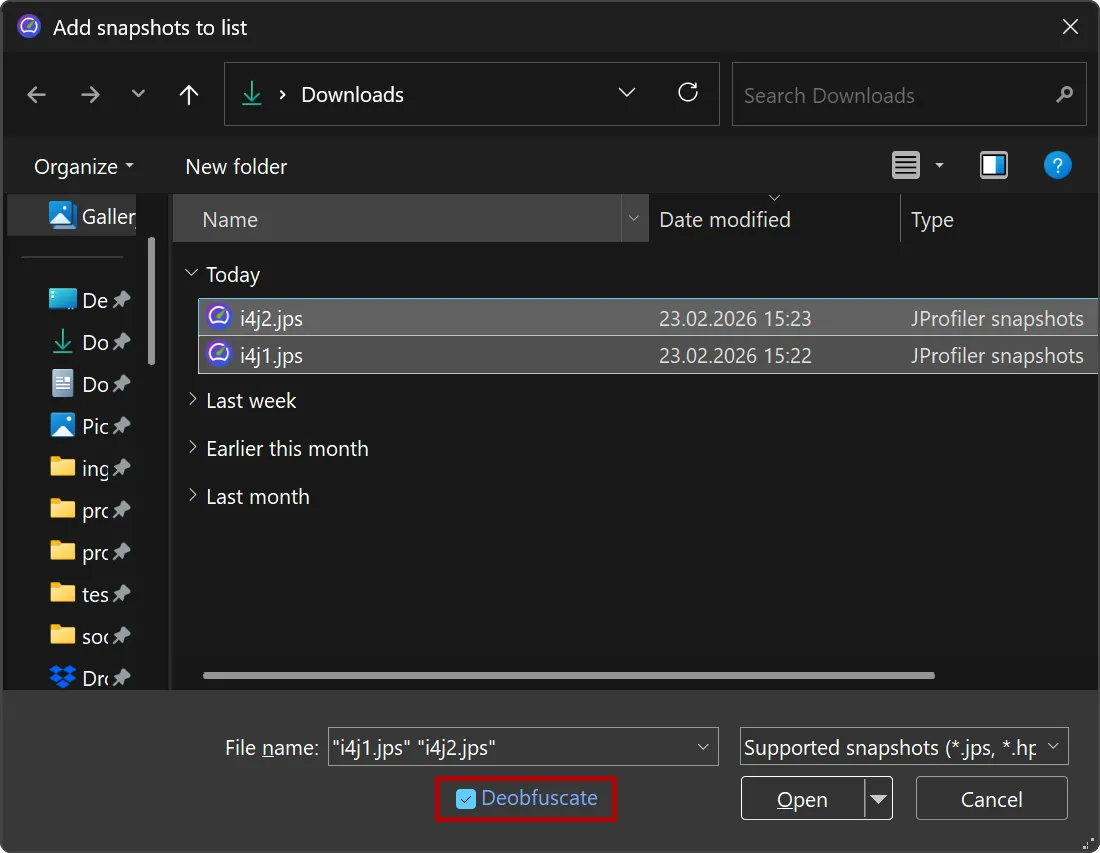
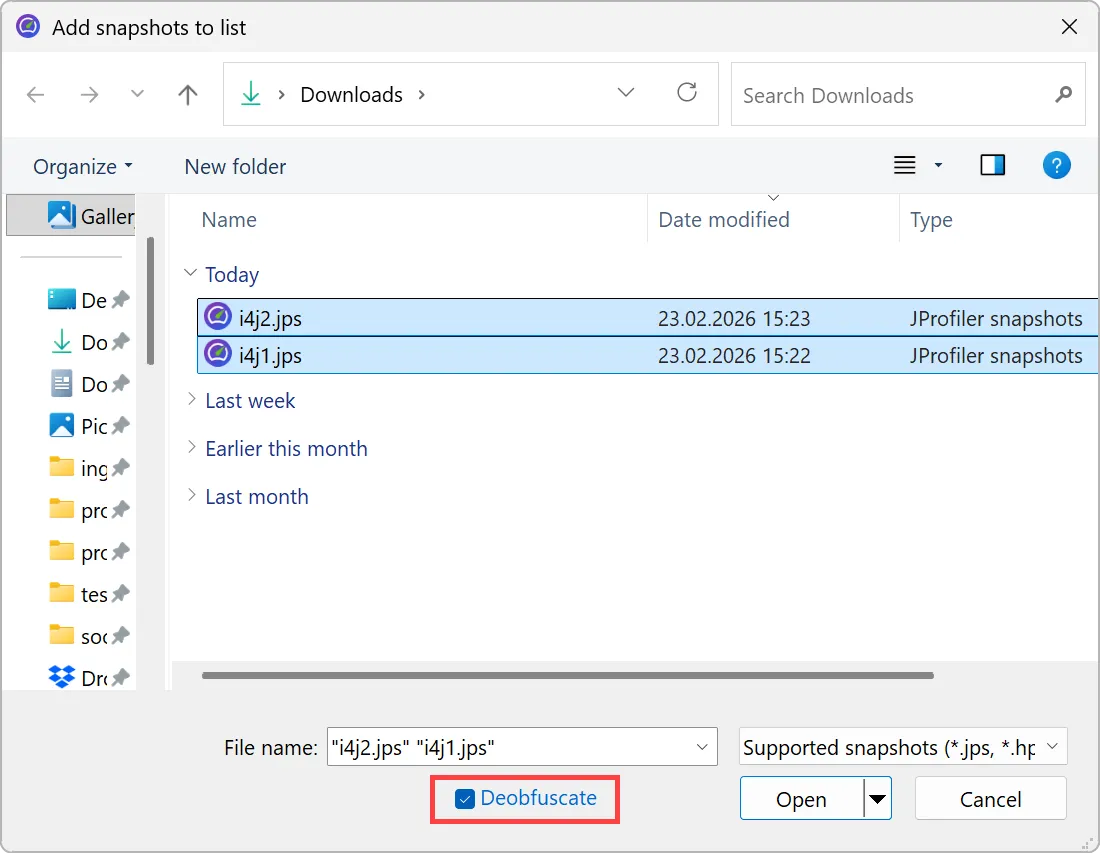
이 체크 박스를 선택하면 지원되는 난독화 도구를 고를 수 있는 드롭다운과 매핑 파일 경로 입력 필드가 있는 대화 상자가 나타납니다.
스냅샷 파일마다 매핑 파일이 다른 경우에는 스냅샷을 개별적으로 추가하면 됩니다.
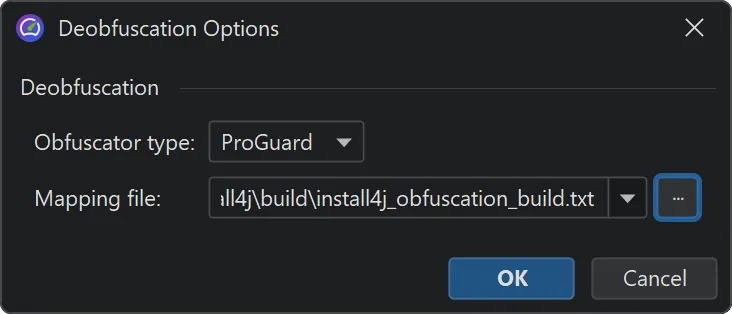
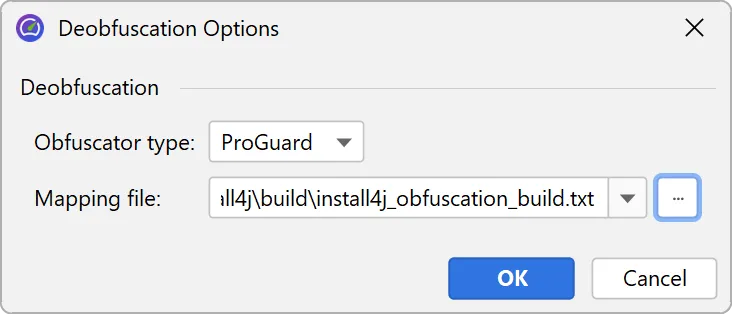
매핑 파일이 적용되면 JProfiler의 모든 비교에서 원래의 클래스 이름과 메서드 이름이 표시됩니다.
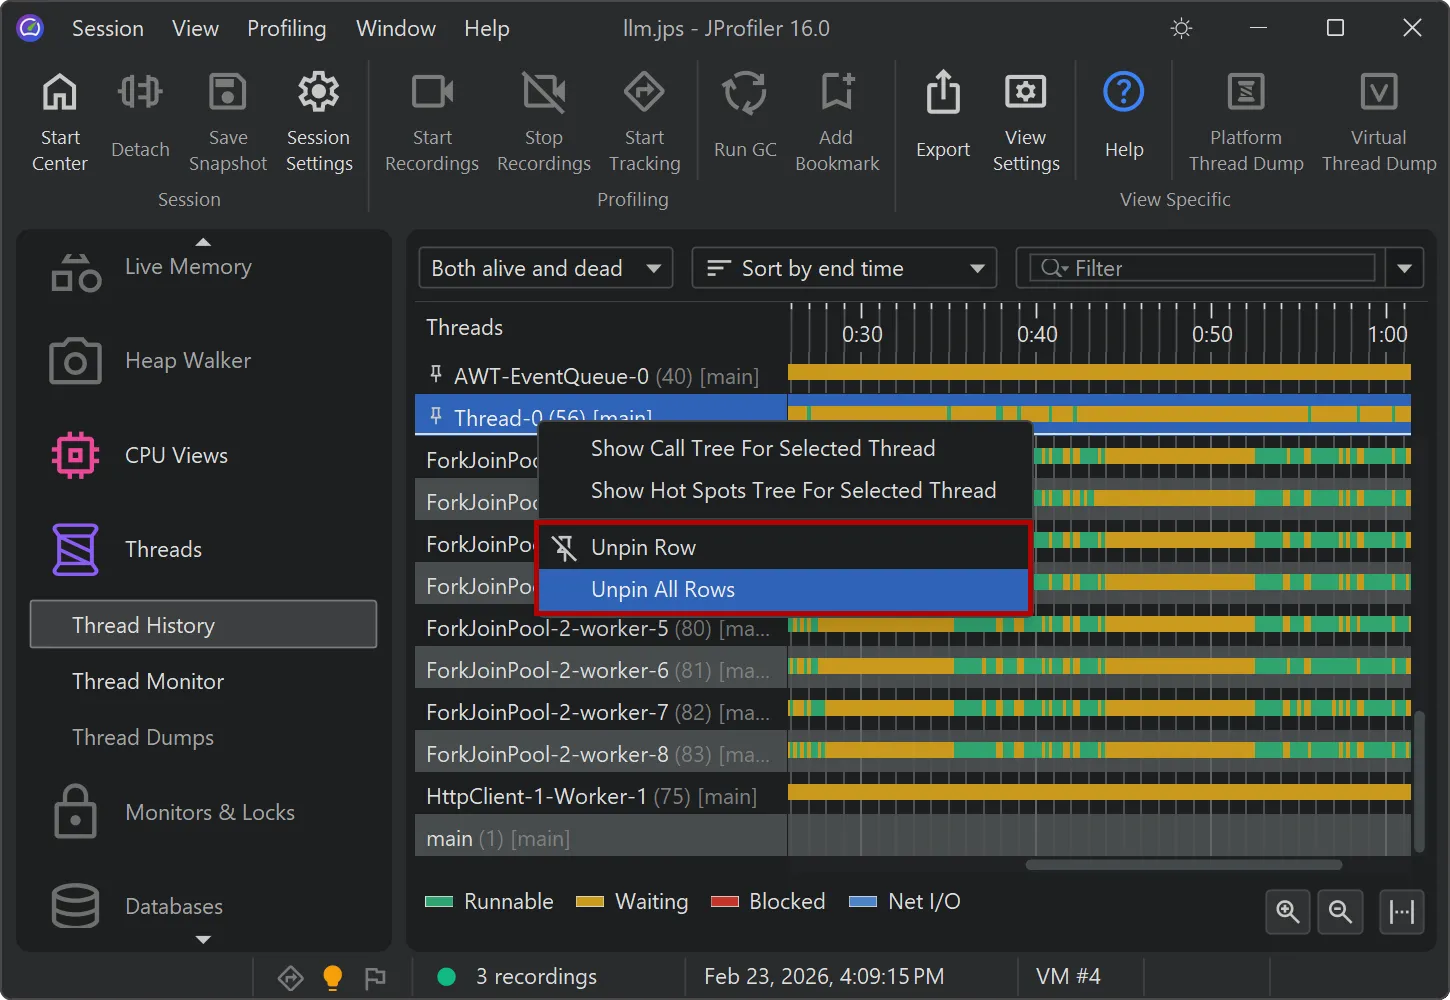
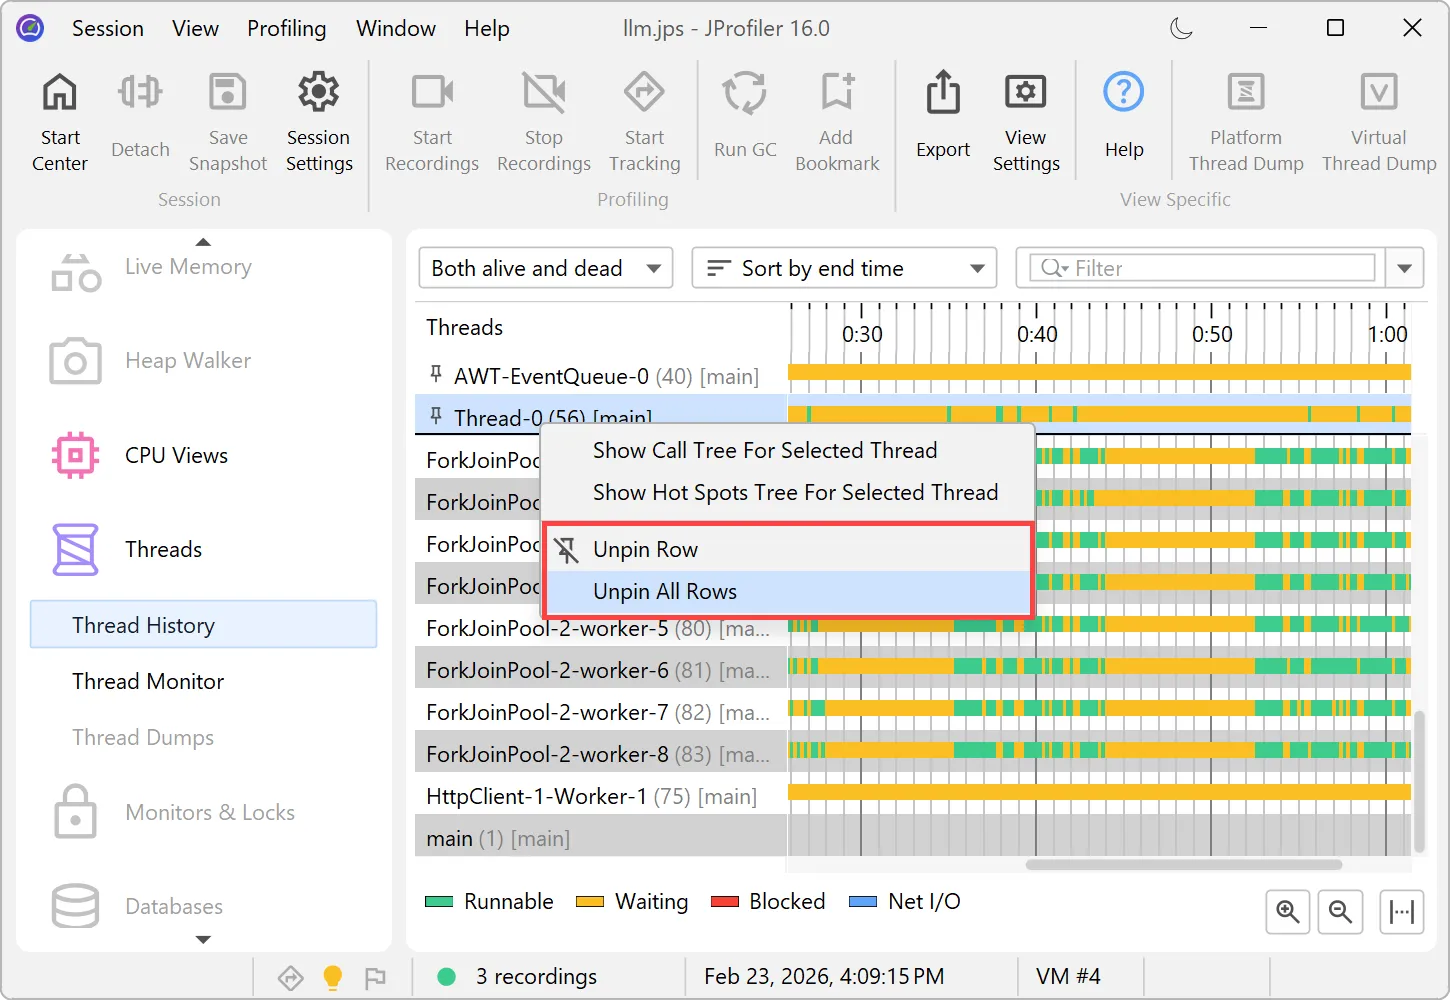
타임라인 뷰가 이제 행 고정을 지원합니다.
스레드 히스토리 뷰와 모든 프로브 타임라인 뷰에서는 컨텍스트 메뉴를 통해 선택한 행을 고정할 수 있습니다. 고정된 행은 상단의 별도 영역에 표시되며, 드래그 앤 드롭으로 순서를 변경할 수 있습니다.
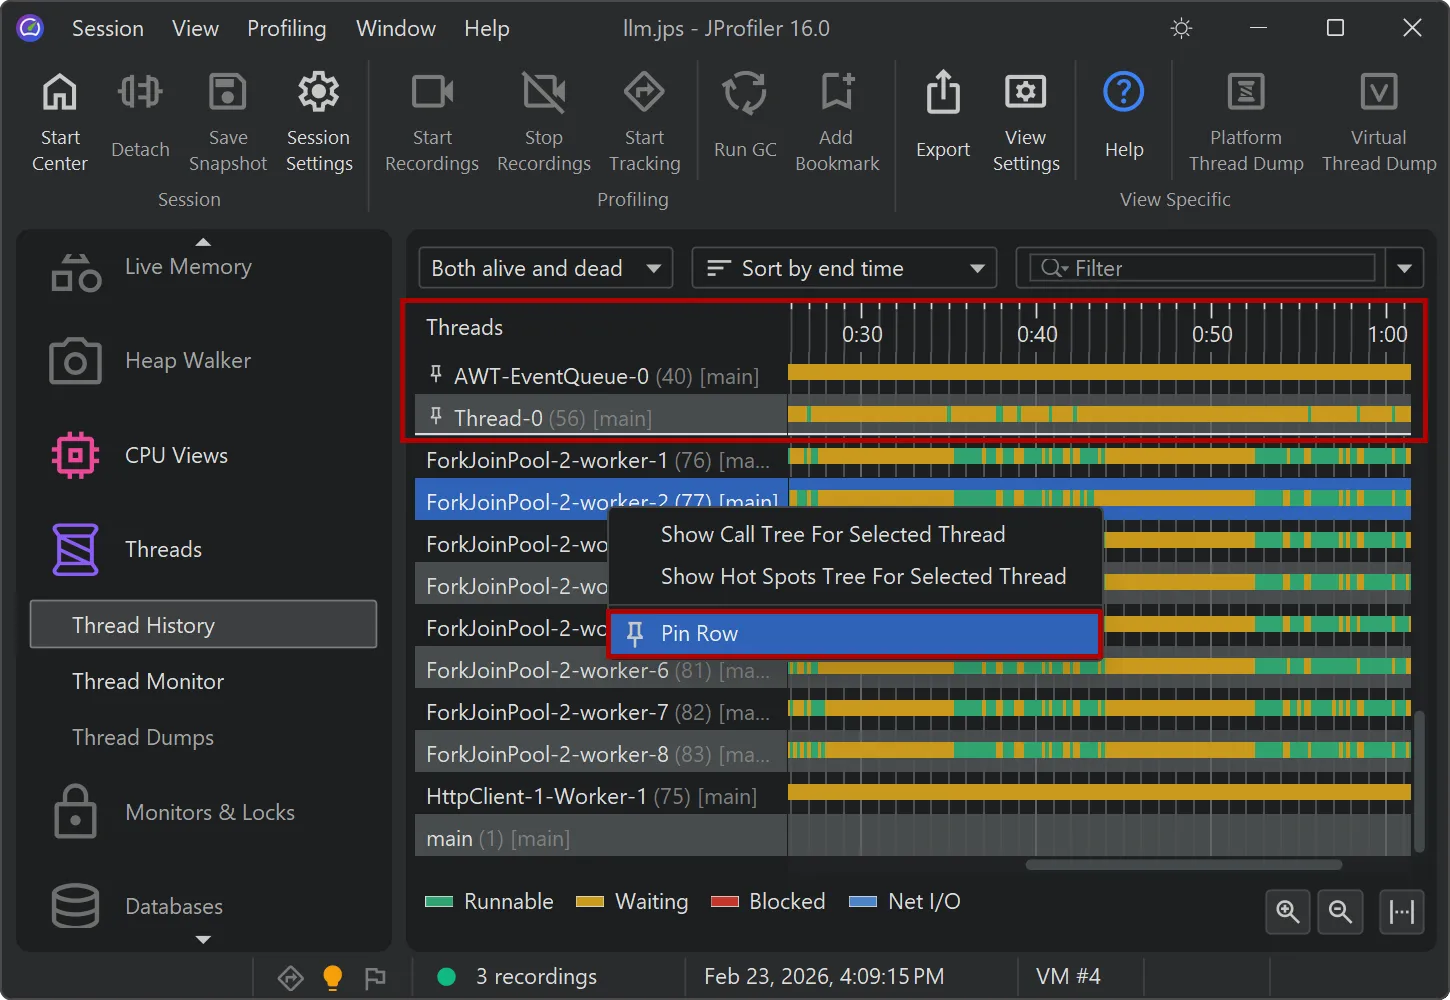
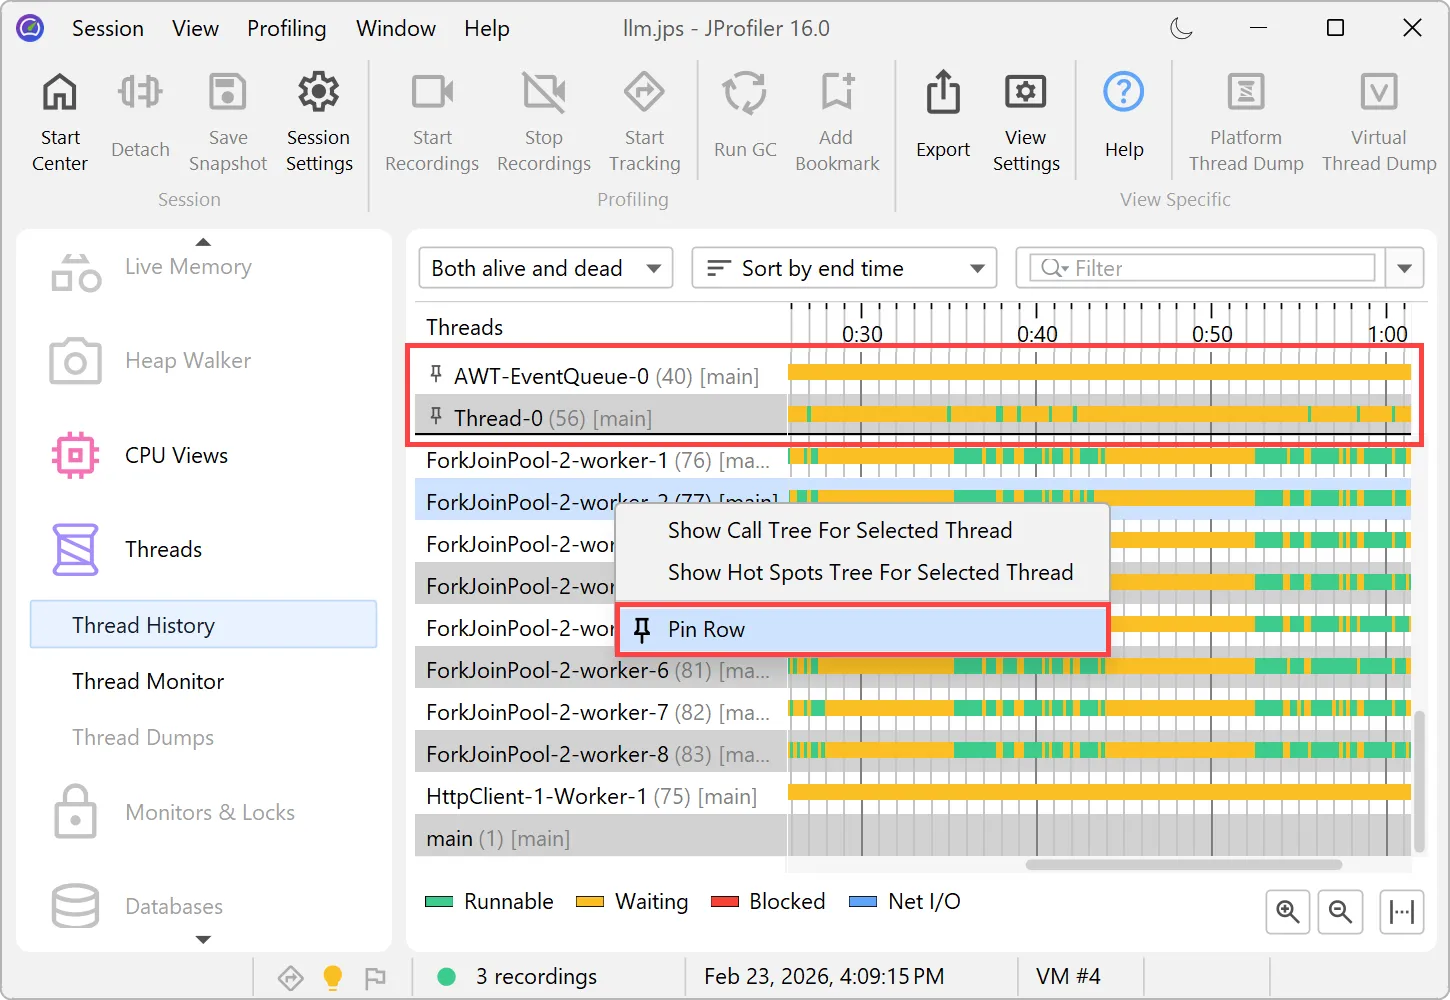
고정된 행은 개별적으로 또는 한꺼번에 모두 고정 해제할 수 있습니다.
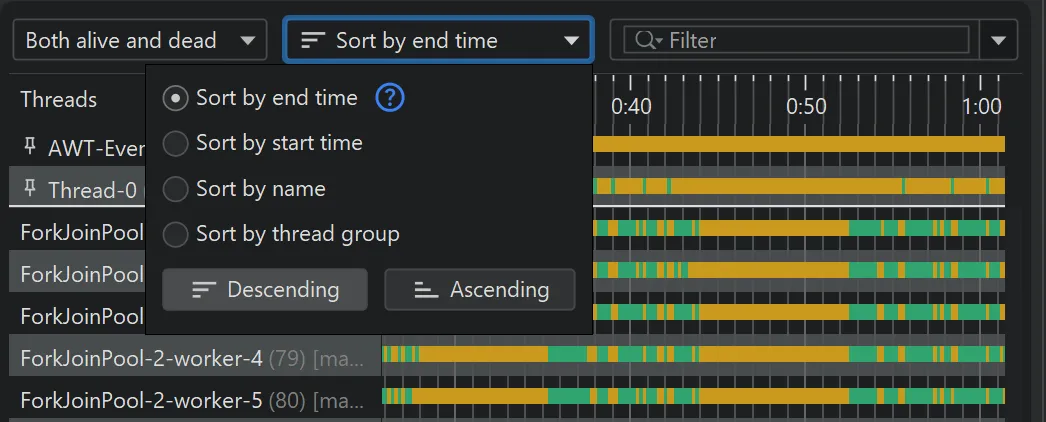
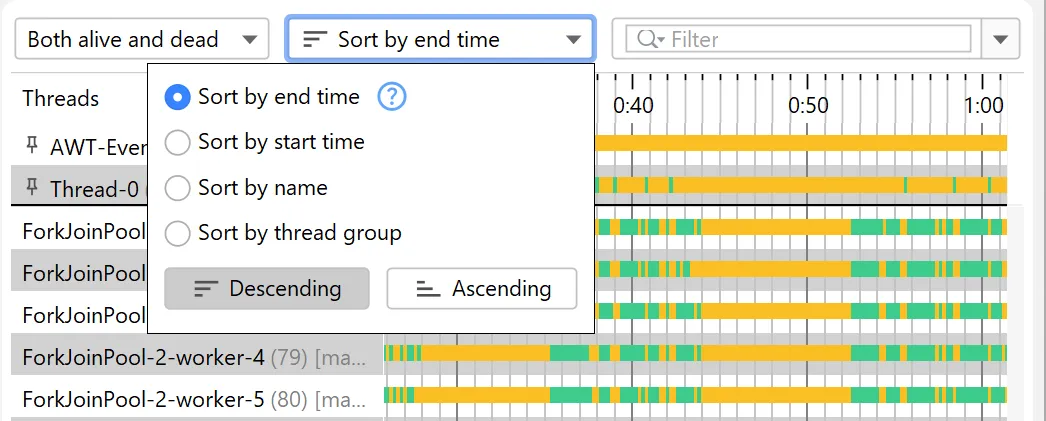
JProfiler 16에는 정렬 드롭다운도 도입되었습니다. 오름차순과 내림차순 정렬 방향을 제공하며, 오랫동안 활동한 활성 행을 먼저 표시하고 최근에 닫힌 행이 그 뒤를 따르는 새로운 기본 정렬 모드도 제공합니다.
JProfiler 16은 Java 26 프로파일링에 대한 완전한 지원을 추가합니다.
가상 스레드를 프로파일링하거나 JDK HTTP 클라이언트의 새로운 내장 HTTP/3 지원을 사용하는 경우 이 버전이 필수적입니다.