

JProfiler 16.1 で導入されたMCP サーバーは、AI コーディングエージェントに焦点を絞ったプロファイリングワークフローを提供していました。CPU データを記録し、ホットスポットを見つけてドリルダウンする、というものです。JProfiler 16.3 では、MCP サーバーはその当初の機能範囲をはるかに超えて拡張され、JProfiler の主要なサブシステムすべてをカバーするようになりました。これにより、エージェントは完全なプロファイリングと解析のワークフローを自律的に実行できます。MCP ツールリファレンスでは、利用可能なすべてのツールとリソースを詳しく説明しています。
JProfiler の新機能
すべての変更の詳細な一覧については、変更履歴をご覧ください。
新たにサポートされたサブシステムは次のとおりです。
- ヒープダンプ解析:ライブセッションでヒープダンプを取得できるほか、新規および既存のスナップショットを、クラスヒストグラム、最大オブジェクト、値フィルター付きインスタンス照会、参照チェーン、GC ルートへのパス、ドミネーターチェーン、自動ヒープ検査を用いて解析できます。フィルタリングやカスタムグループ化には、ヒープウォーカーのスクリプトも利用できます。
- プローブイベント:バックトレース、イベントヒストグラム、イベントタイムラインを伴う個別イベントを照会できます。また、JDBC 接続などのオープン状態の制御オブジェクトは、オープン呼び出しのスタックトレースとともに、リーク解析用に一覧表示されます。
- モニターとロック:モニタ統計、競合タイムライン、ロック履歴、ロックグラフが利用でき、デッドロック解析のための稼働中 JVM のモニタダンプも取得できます。
- スレッドダンプを取得できます。仮想スレッドの階層構造も含まれます。
- GC データ:原因、一時停止時間、フェーズ、ヒープ使用量を伴う個々のガベージコレクションと、GC 設定およびフラグ。
- MBean スナップショット:現在の JMX MBean 属性値を、必要に応じて、または定期的にキャプチャできます。
- テレメトリー:CPU やヒープ使用量からプローブのテレメトリーまで、すべてのテレメトリーデータセットを利用できます。
- アロケーション記録:アロケーションのホットスポットとコールツリーに、呼び出しサイトごとの割り当てクラスとバイト数が表示されます。すでにガベージコレクション済みのオブジェクトも含まれます。
- メソッド複雑度分析:スクリプトが各メソッド呼び出しの複雑度(入力コレクションのサイズなど)を定義し、測定された実行時間を一般的な big-O 複雑度に曲線フィッティングで対応付けます。
- JavaScript の発生元追跡:プロファイリング対象アプリケーションにおける XHR リクエストのブラウザ呼び出しスタック。
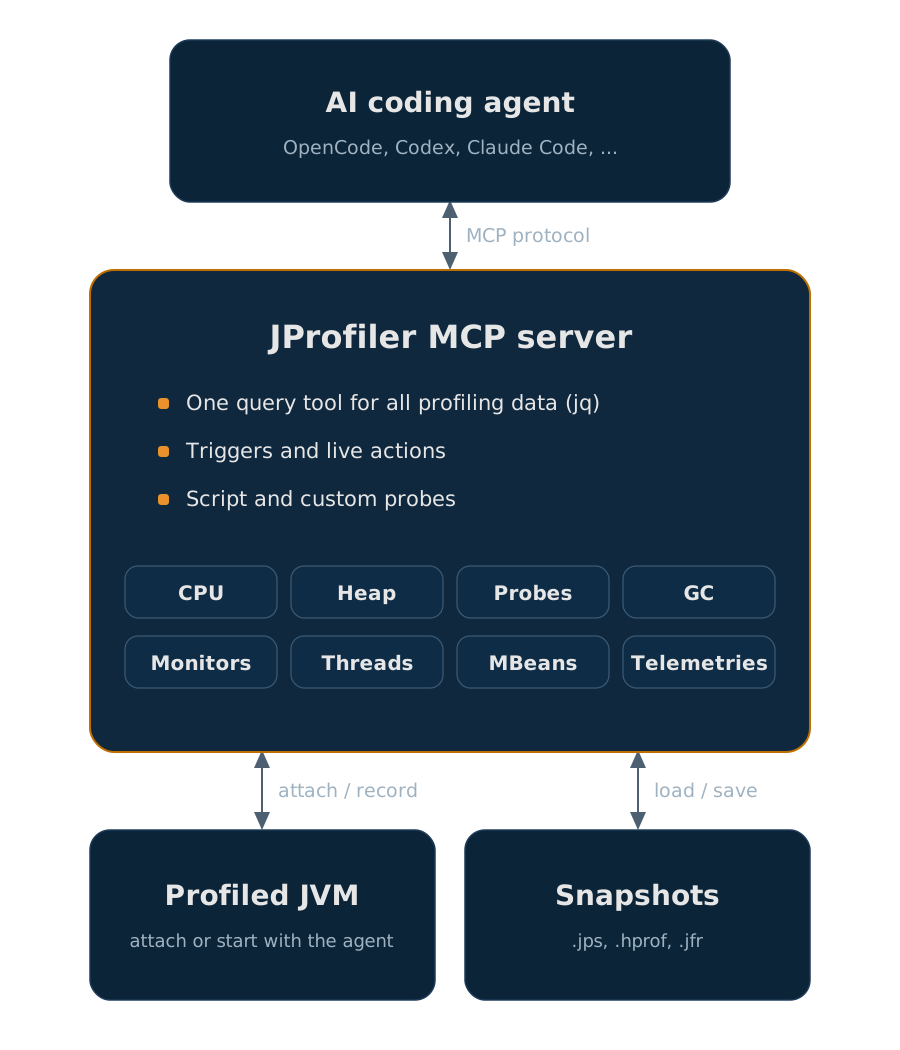
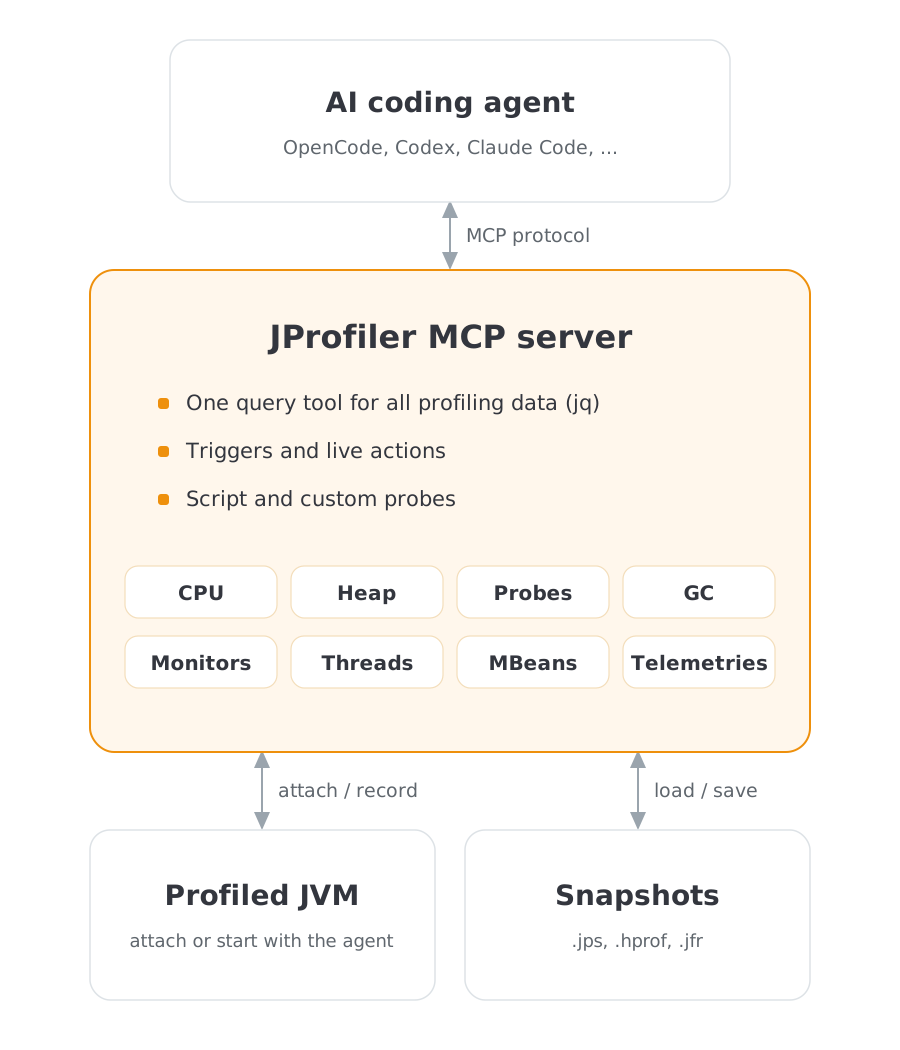
CPU 解析も拡張されました。エージェントは、スレッドやスレッドグループの選択、スレッド状態によるフィルタリング、ホットスポットやコールツリーノードの個別スレッドへの帰属が可能になったほか、外れ値検出と例外的メソッド記録により、散発的に遅くなる呼び出しを突き止められるようになりました。
トリガーを使用すると、対話型のツール呼び出しでは捉えられないデータをエージェントがキャプチャできます。スレッドダンプ、ヒープダンプ、MBean スナップショットなどのアクションは、タイマー、ヒープや CPU のしきい値の超過、特定のメソッドの呼び出しをきっかけに自動的に実行できます。これにより、JVM 起動時からの記録や、ヒープの急増のような一時的な状態に備えた長時間実行セッションの監視が可能になります。同じアクションは、稼働中の JVM に対してライブアクションとして直接実行することもできます。
スクリプトプローブを使用すると、エージェントはその場でまったく新しいプローブを定義できます。スクリプトプローブは Java コードのスニペットで選択されたメソッドをインターセプトし、デプロイ手順なしで、標準プローブと同じように結果を記録します。永続的なインストゥルメンテーションには、プロファイリング対象アプリケーションの一部となるカスタムプローブをエージェントが作成でき、最も手軽なのは組み込みプローブ API を使用する組み込みプローブの形式です。カスタムプローブは標準プローブと同じ方法で記録・解析されます。また、プローブ設定やスクリプトプローブ、カスタムプローブの API は MCP リソースとして公開されているため、エージェントは作業中にそれらを参照できます。
すべてのデータは、以前のバージョンの多数の特殊用途ツールに置き換わるjq 式による単一の照会ツールを通じて取得されます。小型で統一されたツールセットにより、エージェントの動作はより安定します。プロファイリングデータのフィルタリング、集計、ドリルダウンの方法は 1 つしかなく、それがすべてのサブシステムで同じように機能するからです。
セットアップ方法は変わりません。JProfiler の UI からエージェントを設定するか、MCP セットアップページの手順に従ってください。
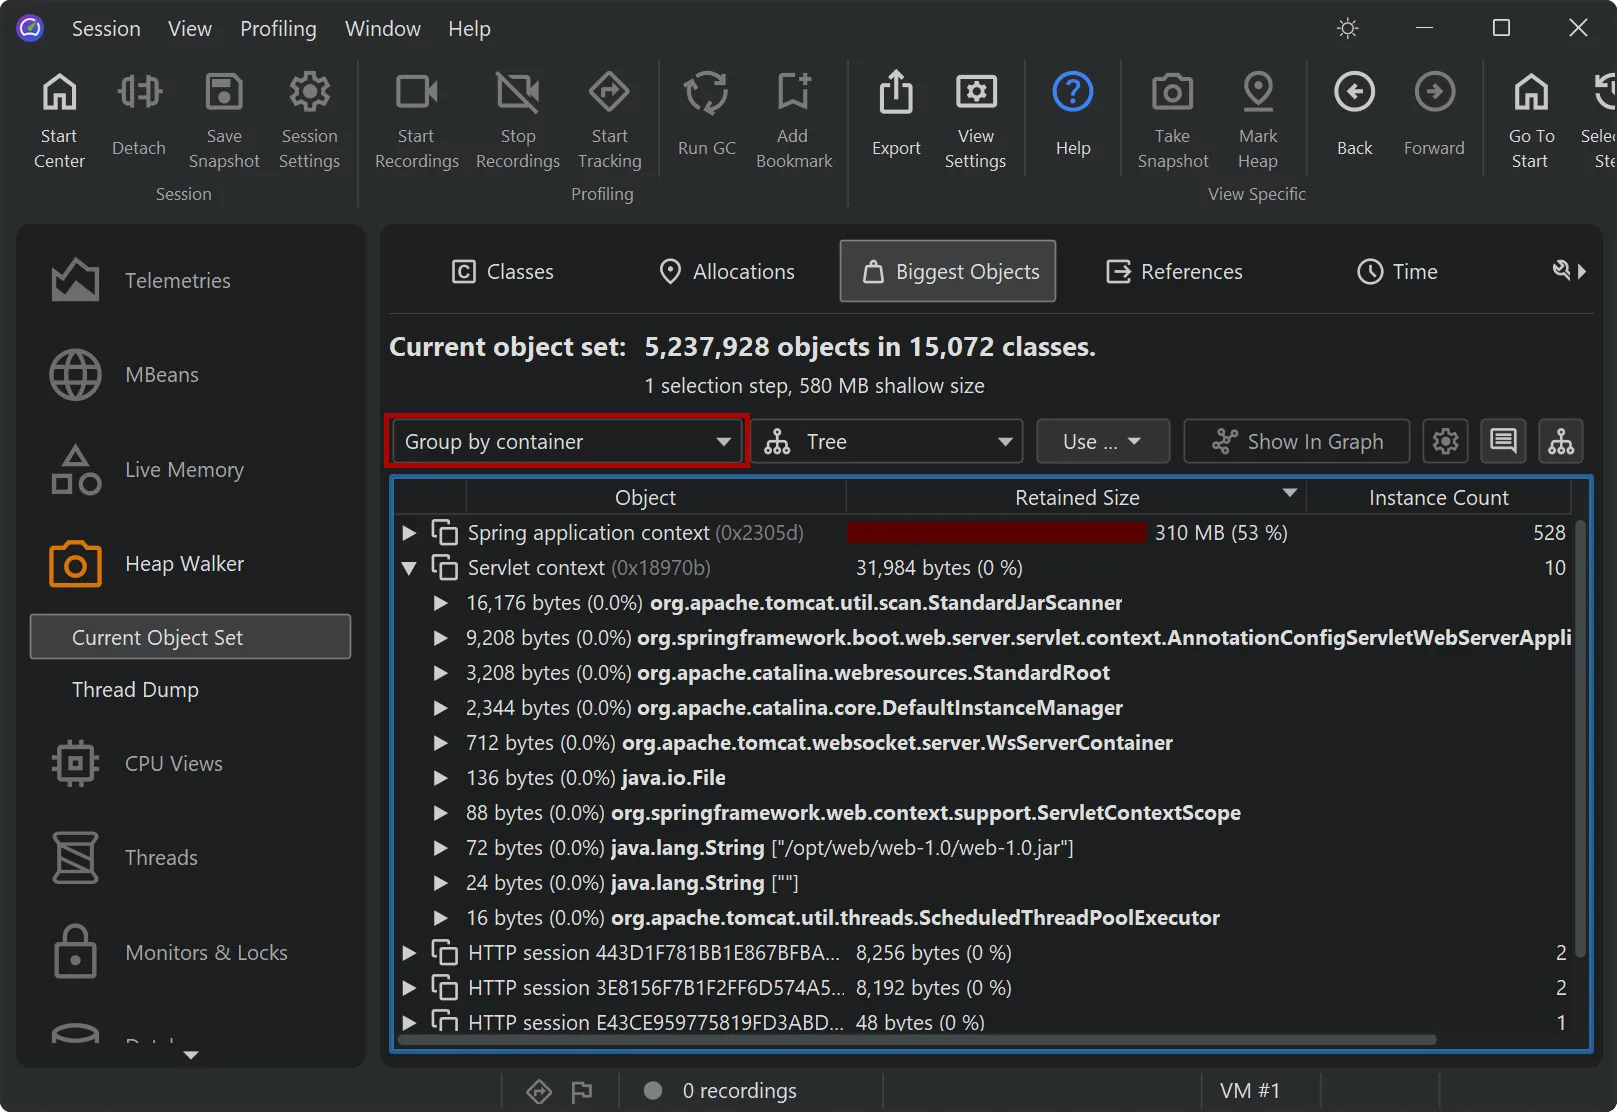
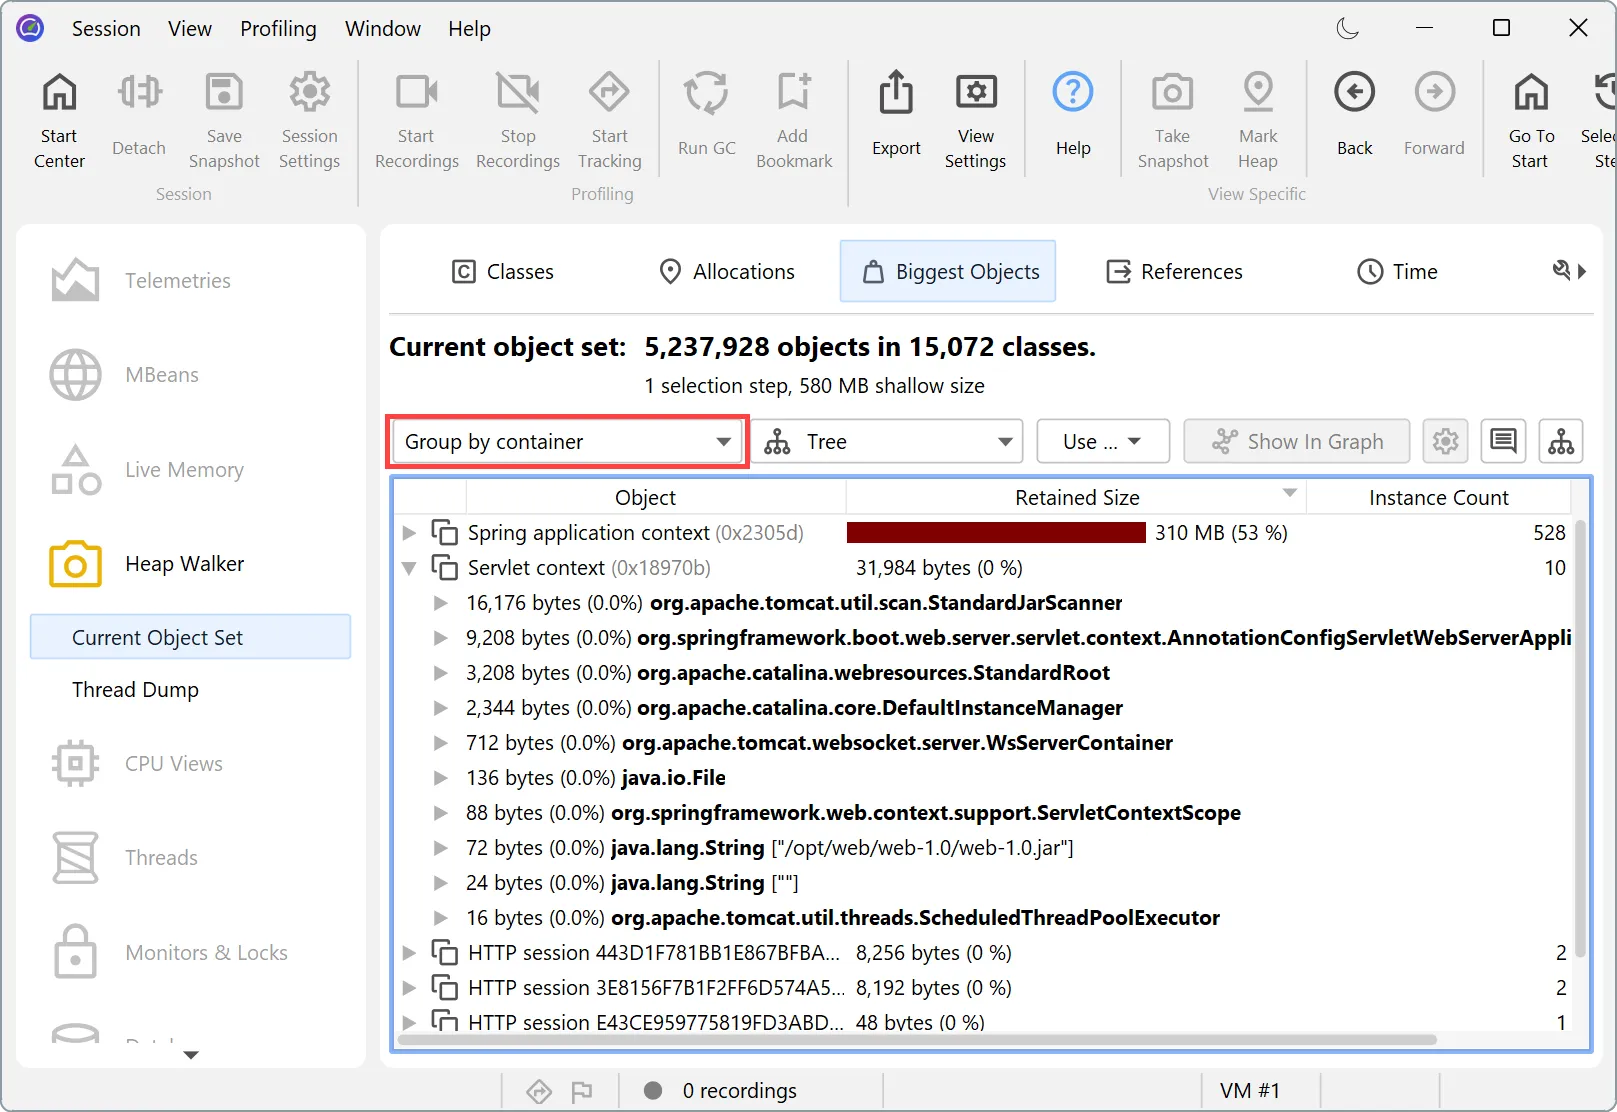
ヒープウォーカーの最大オブジェクトビューは、一般的なフレームワークのセマンティクスを理解するようになりました。新しい「コンテナでグループ化」グルーピングでは、オブジェクトはそれぞれが所属するフレームワークコンテナ別にグループ化されます。トップレベルには、Spring アプリケーションコンテキスト、サーブレットセッション、サーブレットコンテキスト、Hibernate 永続化コンテキストのラベル付きコンテナノードが、それぞれの管理対象オブジェクトの合計保持サイズとともに表示されます。
コンテナを展開すると、フレームワークのレジストリ内部をたどる参照チェーンを挟まずに、管理対象オブジェクトが直接表示されます。「どのサーブレットセッションが最も多くのメモリを保持しているのか」「このオブジェクトはどの Spring アプリケーションコンテキストに属しているのか」といった疑問に、最大オブジェクトビューで直接答えられるようになりました。
JProfiler にMaven プラグインが同梱されるようになり、既存の Gradle プラグインと Ant タスクとの差が埋まりました。profile ゴールは、プロファイリングエージェントをアタッチしてプロジェクトのメインクラスを実行します。
mvn com.jprofiler:jprofiler-maven:16.3:profile -Djprofiler.mainClass=com.example.Main
または、POM でプラグインを設定することもできます。
<plugin>
  <groupId>com.jprofiler</groupId>
  <artifactId>jprofiler-maven</artifactId>
  <version>16.3</version>
  <configuration>
    <mainClass>com.example.Main</mainClass>
  </configuration>
</plugin>
その後は mvn jprofiler:profile だけで十分です。CI 環境でのヘッドレス作業をサポートするゴールもさらに用意されています。export、compare、analyze はコマンドラインからスナップショットを処理し、set-agentpath-property は他のプラグインで利用できるように、-agentpath VM パラメータを含むプロパティを準備します。詳細はMaven ゴールのドキュメントを参照してください。
Gradle タスクと新しい Maven ゴールは、ビルドマシンに JProfiler のインストールが設定されていない場合、JProfiler のインストールを自動的にダウンロードできるようになりました。これにより、CI パイプラインでのプロファイリングが格段に簡単になります。事前にビルドエージェントへ JProfiler をインストールしておく必要はなく、ビルド統合が要求されたバージョンを必要に応じてプロビジョニングします。
Gradle では、インストールディレクトリを省略するだけで十分です。
jprofiler {
    // installDir = file('/opt/jprofiler')
}
installDir を指定しない場合、プラグインはプラグインのバージョンに一致する JProfiler ディストリビューションをダウンロードし、Gradle ユーザーのホームディレクトリにキャッシュします。Maven ゴールも同じように機能します。
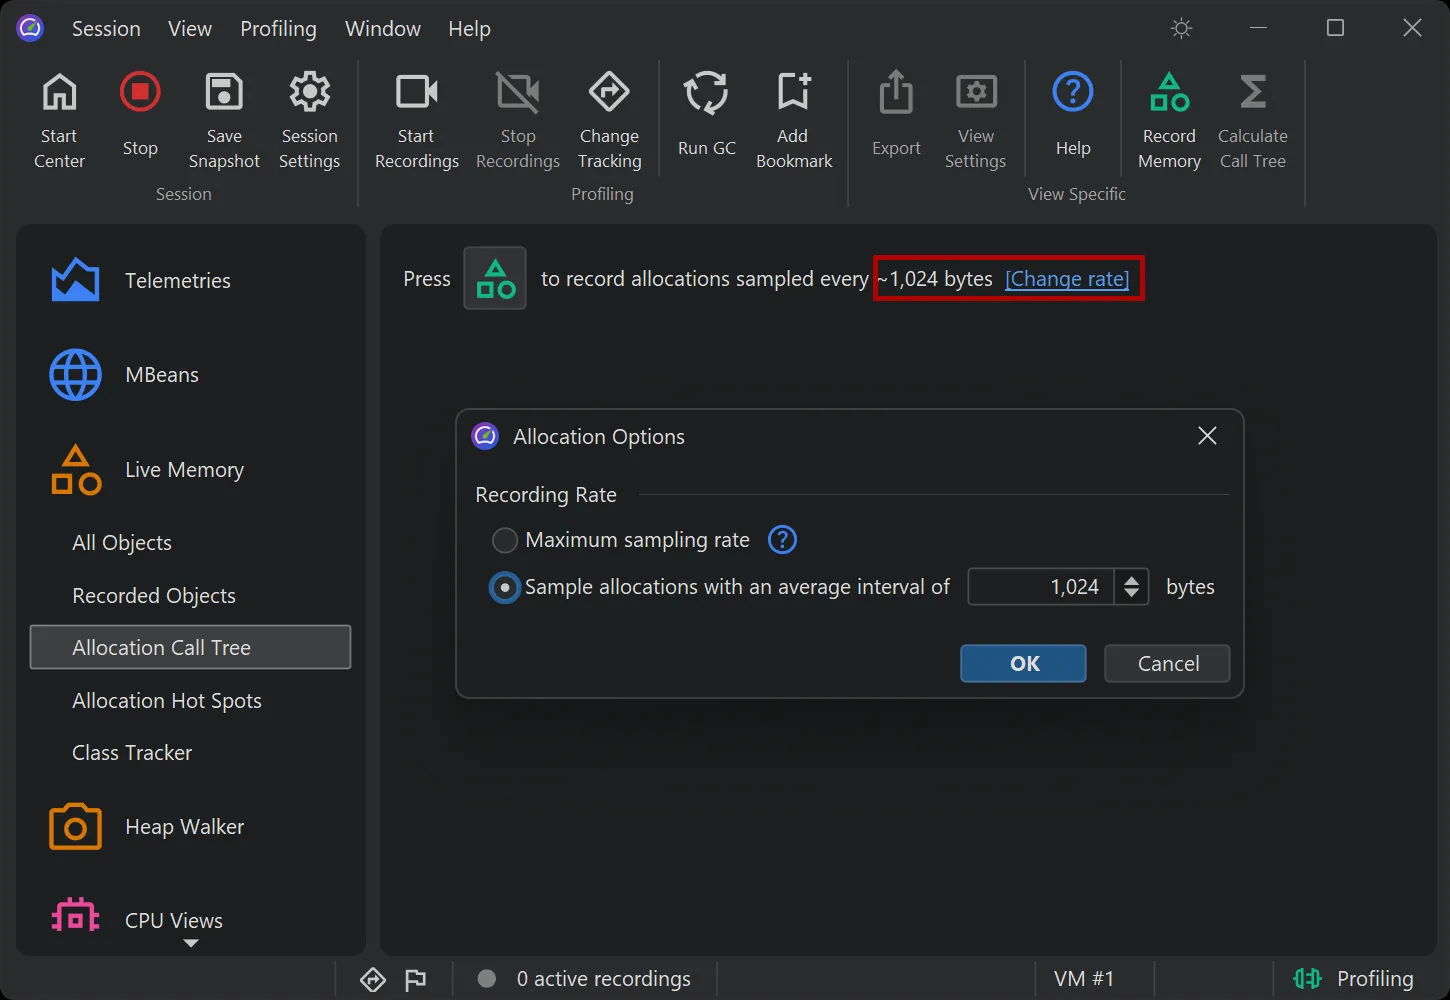
アロケーション記録は、Java 11 以降ではデフォルトで、オーバーヘッドの低い JVMTI アロケーションサンプリング機構(JEP 331)によるバイトインターバルサンプリングを使用するようになりました。コンストラクタをインストゥルメントして n 個ごとのオブジェクトを記録する代わりに、プロファイリングエージェントは、割り当て N バイトごとのサンプリング済みアロケーションイベントを JVM から受け取ります。
これにより、HotSpot JIT のエスケープ解析を無効化しかねなかった、コンストラクタのインストゥルメンテーションによる測定の歪みがすべて取り除かれます。同時に、記録のオーバーヘッドも低くなります。
サンプリング間隔はバイト単位で設定されるようになり、デフォルトは 1024 です。Java 8 や JVMTI サンプリング機能を持たない JVM では、従来のインストゥルメンテーションベースの記録が自動的に使用されます。
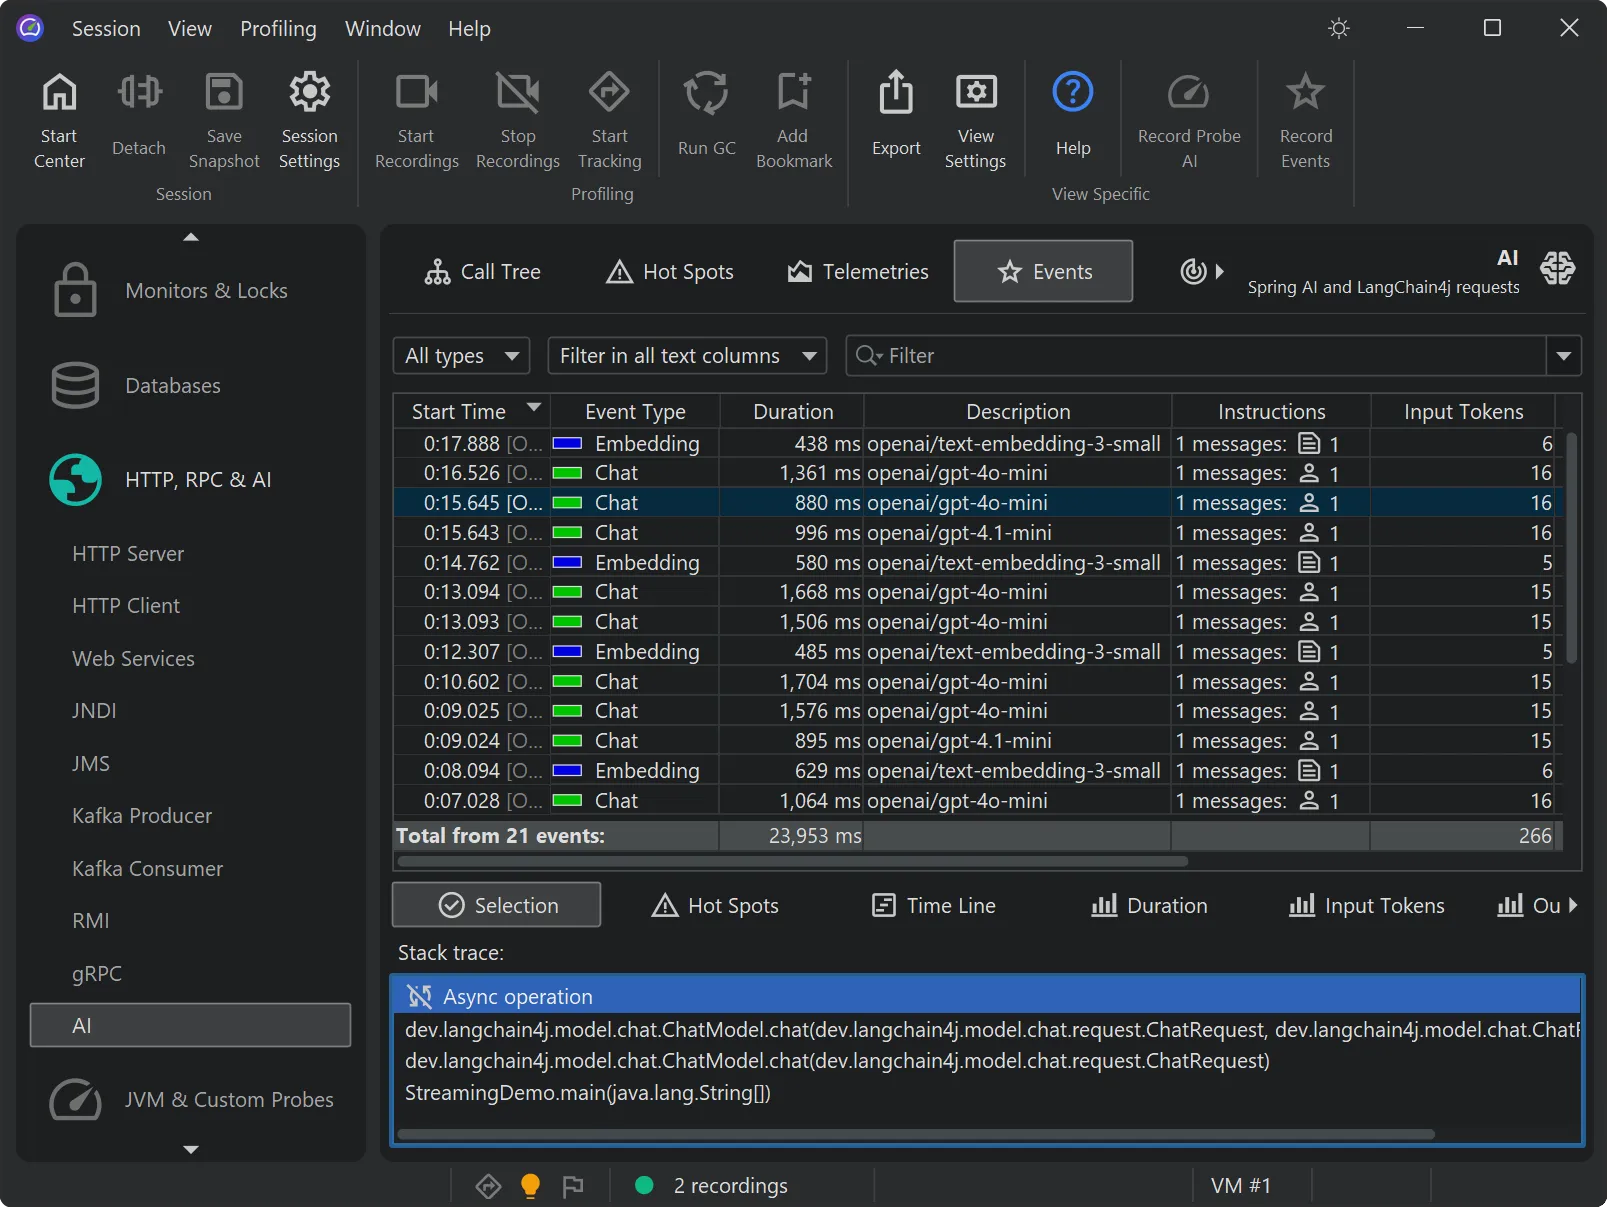
AI プローブが LangChain4j の非同期およびストリーミングリクエストをサポートするようになり、LangChain4j のすべての LLM インタラクションパターンがカバーされるようになりました。
ストリーミング応答は完全な応答へと組み立てられ、同期呼び出しと同様に、トークン使用量と総所要時間が記録されます。非同期リクエストは完了、キャンセル、タイムアウトのいずれかになるまで追跡されるため、イベント、ホットスポット、テレメトリーにはそのすべてについて正しいデータが表示されます。
オフラインプロファイリングを、JProfilerの設定ファイルなしで-agentpath VMパラメータに直接記述できるようになりました。以前のオフラインモードでは、まずJProfilerのUIからセッション設定をエクスポートする必要がありました。
最もよく使われるプロファイリング設定はインラインで指定できます。コールツリーの収集モードはcallTreeModeで、プロファイル対象・コンパクト・無視の各パッケージフィルターはprofile、compact、ignoreで指定します。さらに、完全な自動記録シーケンスを追加できます。これは、API呼び出しやjpcontrollerを使わずに、snapshot、recording、duration、delayの各オプションを使ってスナップショットを保存するものです。
例えば、次のパラメータを指定すると
-agentpath:...=offline,callTreeMode=sampling,profile=com.mycorp.,\
    snapshot=/tmp/snapshot.jps,recording=cpu:allocation,duration=10m
CPUデータとアロケーションデータが10分間記録され、その後にスナップショットが保存されます。
同じインライン設定と記録オプションは、すでに実行中のJVMにプロファイリングエージェントをアタッチするjpenableコマンドラインツールでも利用できます。オフラインモードを選択すると、jpenableが対話型のリッチコンソールで設定を順に案内します。
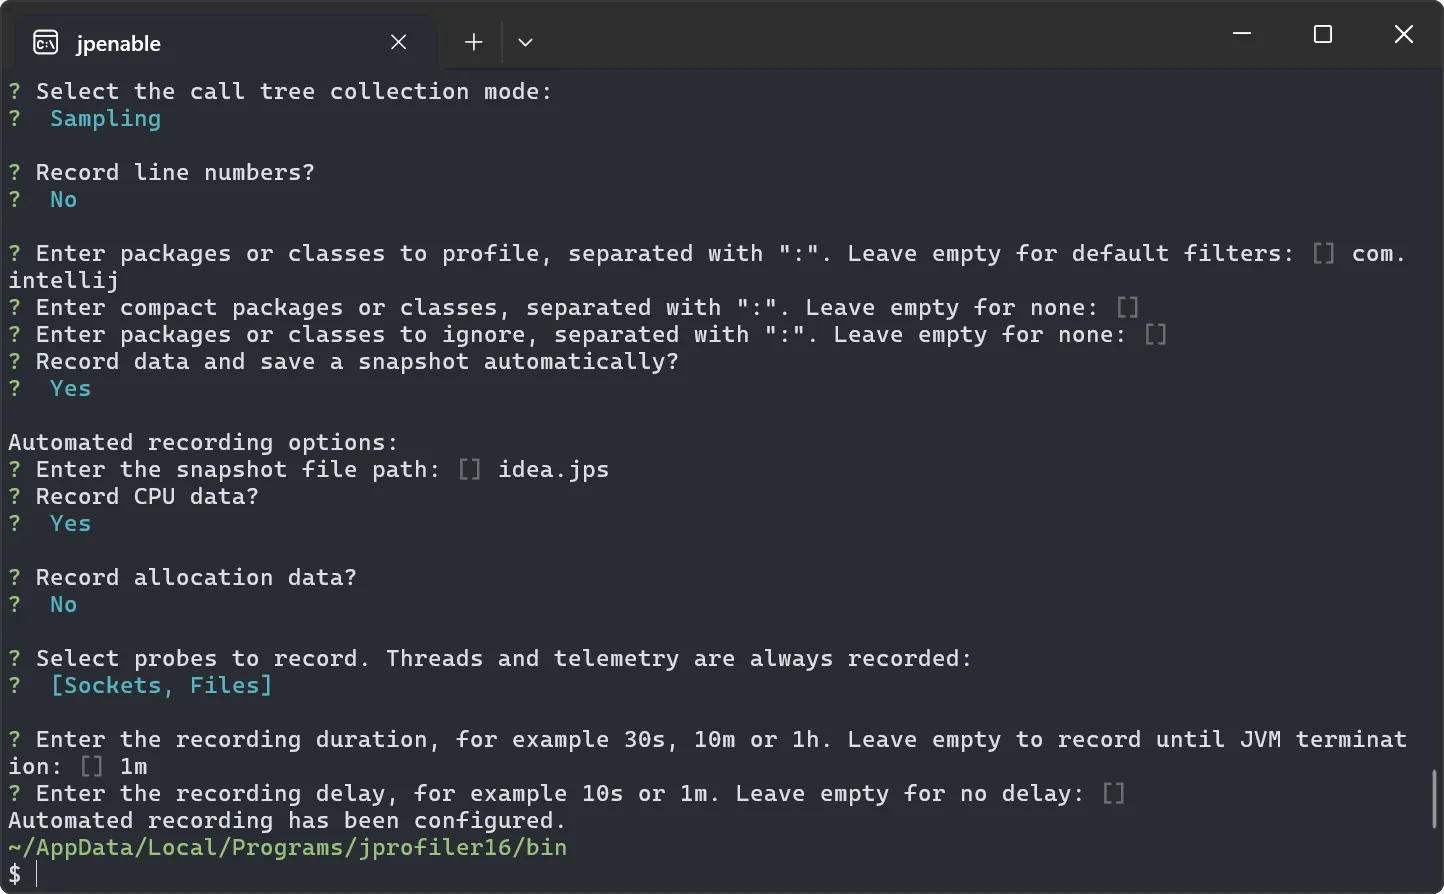
または、CIパイプラインでの非対話的な利用のために、--call-tree-mode、--profile、--line-numbers、--snapshot、--recording、--durationなどのオプションで設定をコマンドラインから指定することもできます。
GradleとAntのプロファイリングタスクも、タスク属性を通じて同じ機能を提供します。ビルドスクリプトの中で直接、オフラインプロファイリングと自動記録シーケンスを設定できます。
JProfiler 16.1で導入されたMCPサーバーを改良しました。性能の低いモデルでも確実に動作するようになり、プロファイリングワークフローをより堅牢に実行します。対応AIコーディングツールとしてAntigravityを追加しました。
JProfilerに、AIコーディングエージェントがお客様のJavaアプリケーションをプロファイリングし、その結果を分析して対処まで行えるMCP(Model Context Protocol)サーバーが搭載されました。Claude Code、Cursor、Codex、Gemini CLIをはじめとする、MCP互換のすべてのAIコーディングツールで利用できます。
これまで、プロファイリングはGUIで行う作業でした。セッションを開始し、ビューを操作し、データを解釈します。MCPサーバーがあれば、エージェントはこの一連の流れを自力で完結できます。アプリケーションをプロファイリングしてJDBCクエリが実行時間の大半を占めていることを突き止め、冗長なデータベース呼び出しを排除するためにコードを修正し、改善を検証するために再プロファイリングを行い、具体的な数値による修正前後の比較を提示します。
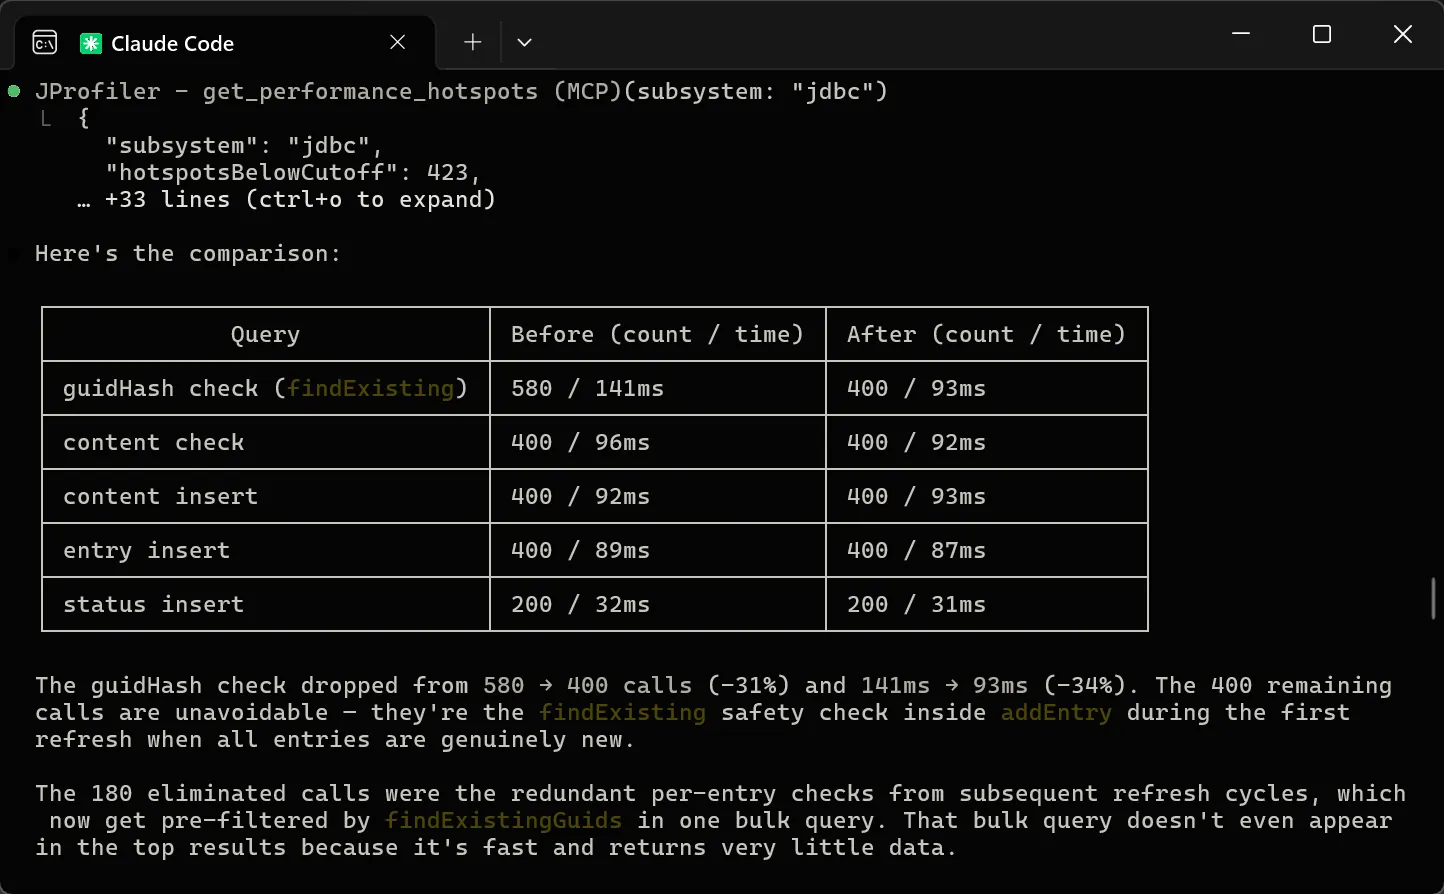
MCPサーバーが公開するツールは、エージェントが専門家がJProfilerを使うのと同じ流れのプロファイリングワークフローに確実に沿って進むよう、入念に設計・テストされています。エージェントはまず、対象アプリケーションのプロファイリングをセットアップします。テスト実行が完了すると、データが利用可能になっているかを確認し、時間がどこで消費されているかを把握するために、最初の集約ホットスポットビューを取得します。そこから、個々のホットスポットを掘り下げ、呼び出しチェーンをたどって根本原因に至ります。
各ステップのデータは入念にフィルタリングされており、CPUホットスポット、JDBCとJPAのクエリ、HTTP呼び出し、MongoDB操作、ヒープダンプのいずれを分析している場合でも、エージェントが重要な情報だけを見て、大量のデータに圧倒されないようになっています。ローカルおよびコンテナ化されたJVMのライブプロファイリングに加えて、既存のJProfiler、HPROF、JFRスナップショットを読み込んで分析することもできます。
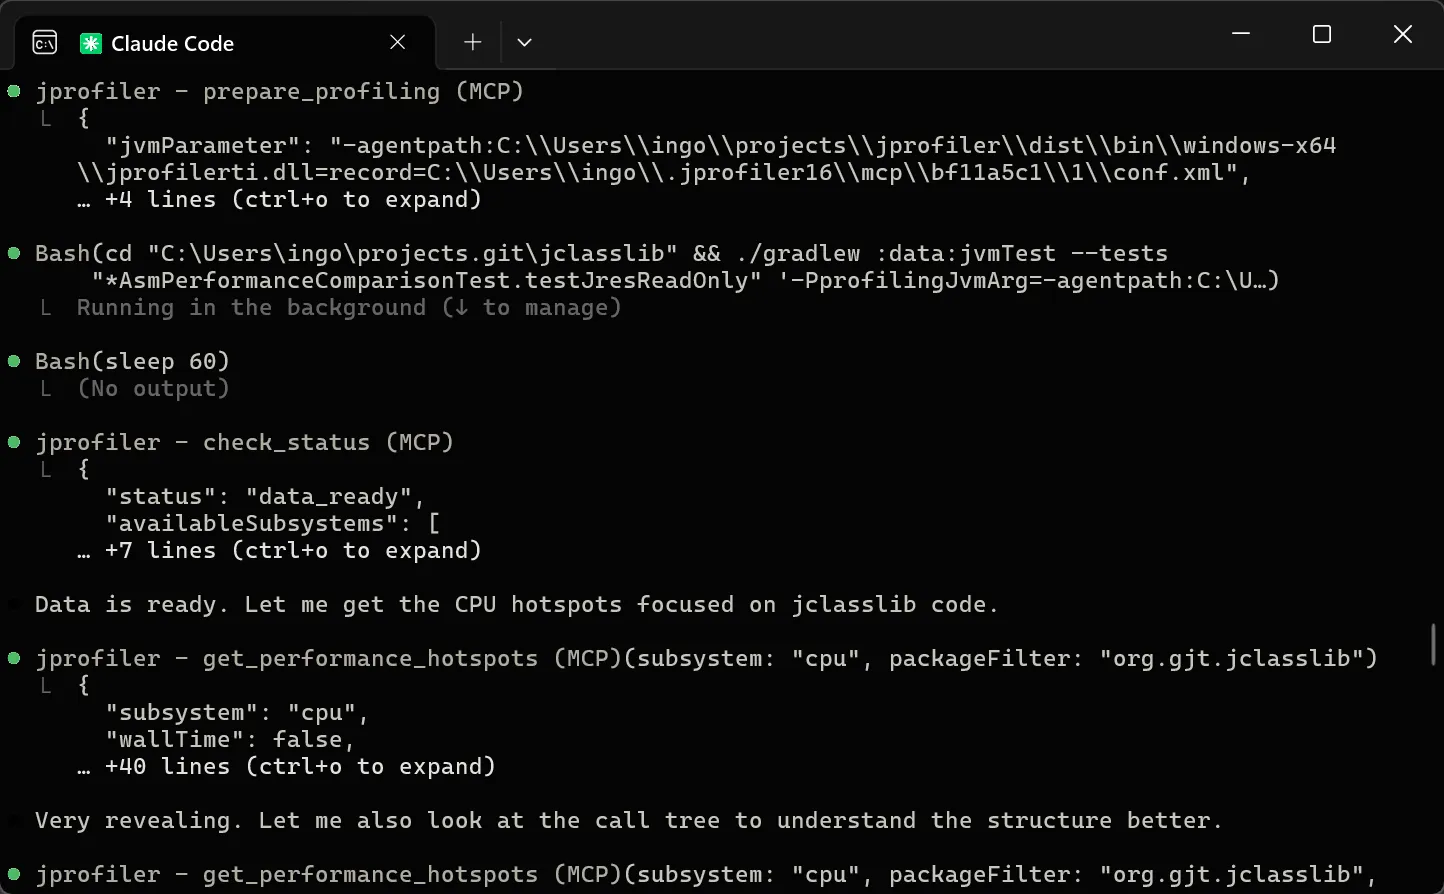
セットアップは手間ゼロです。MCPサーバーは、初回使用時にJProfilerバイナリを自動的にインストールし、ライセンスもMCPプロトコル経由で処理します。エージェントのセットアップはJProfilerのUIから直接行えるほか、MCPセットアップページの手順に従うこともできます。このリリースの全容については、発表ブログ記事をご覧ください。
JProfiler 16ではAIプローブを導入しました。このプローブは、LangChain4jおよびSpring AIを介したLLMとのやり取りを測定します。
チャットリクエストと埋め込みがサポートされており、それぞれ異なるイベントタイプとしてイベントビューに表示されます。
処理された指示の詳細は、指示列のホバーボタンで開けるノード詳細ダイアログで確認できます。指示列には、ユーザーメッセージ、アシスタントメッセージ、ツールメッセージといった各指示タイプの統計が表示されます。
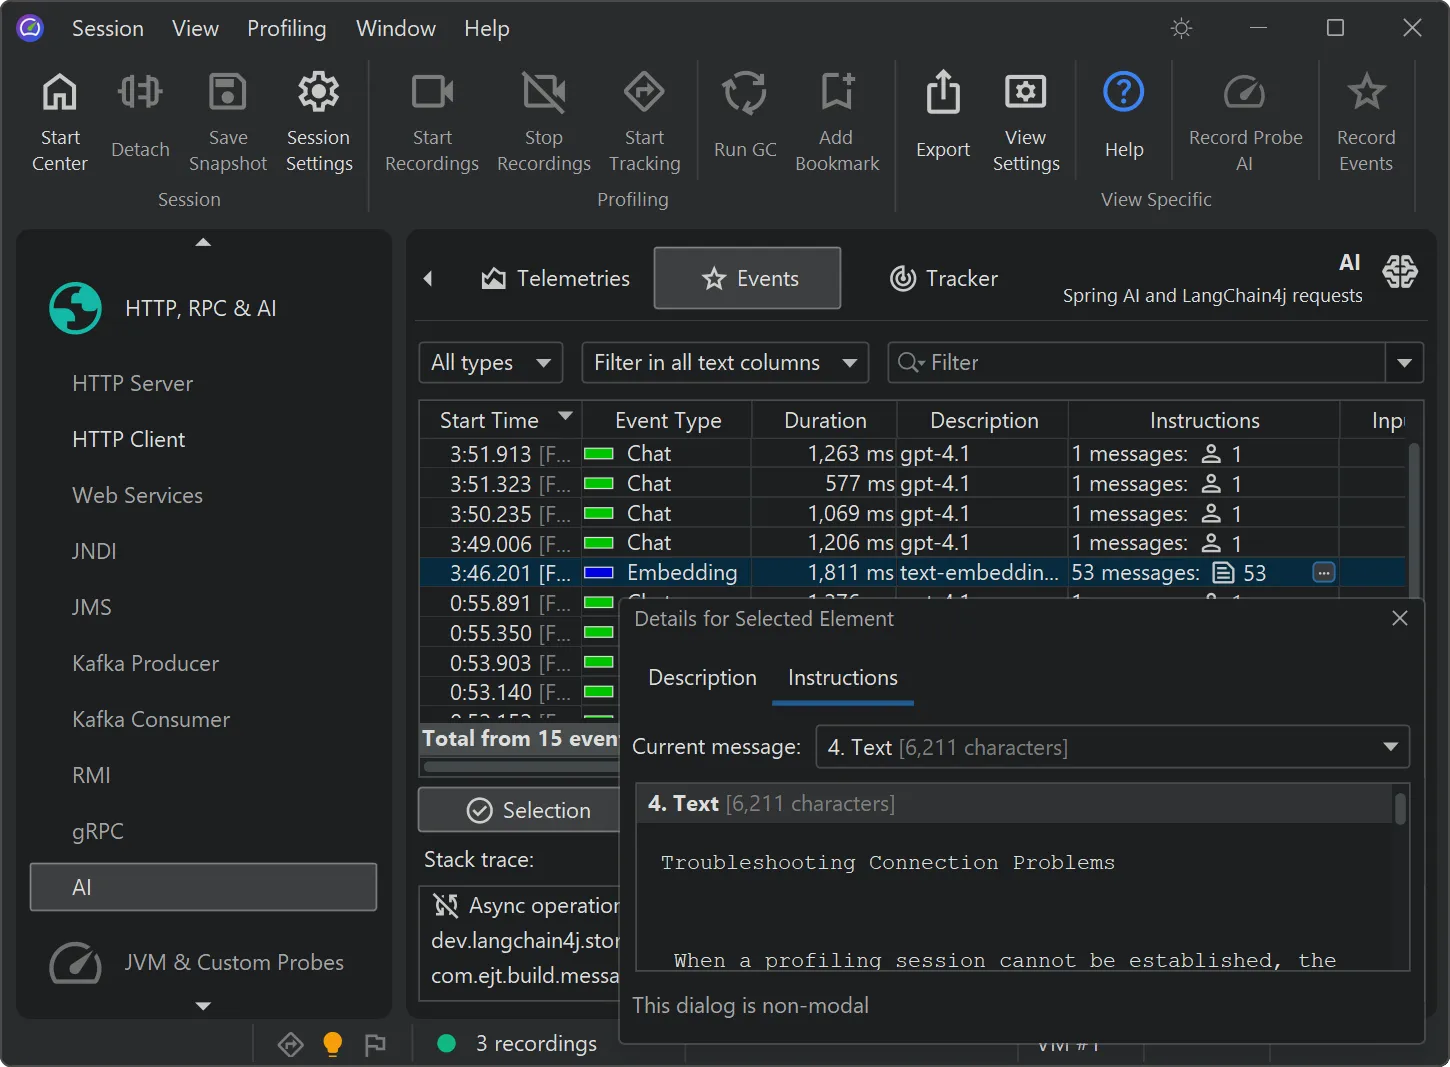
AIプローブはイベントを中心とした構成になっています。記録されたイベントのサブセットを扱う方法は2つあります。1つ目は、複数のイベントを選択すると、下部の選択パネルに現在の選択対象に関するCPUホットスポット、プローブホットスポット、プローブコールツリーが表示されるというものです。
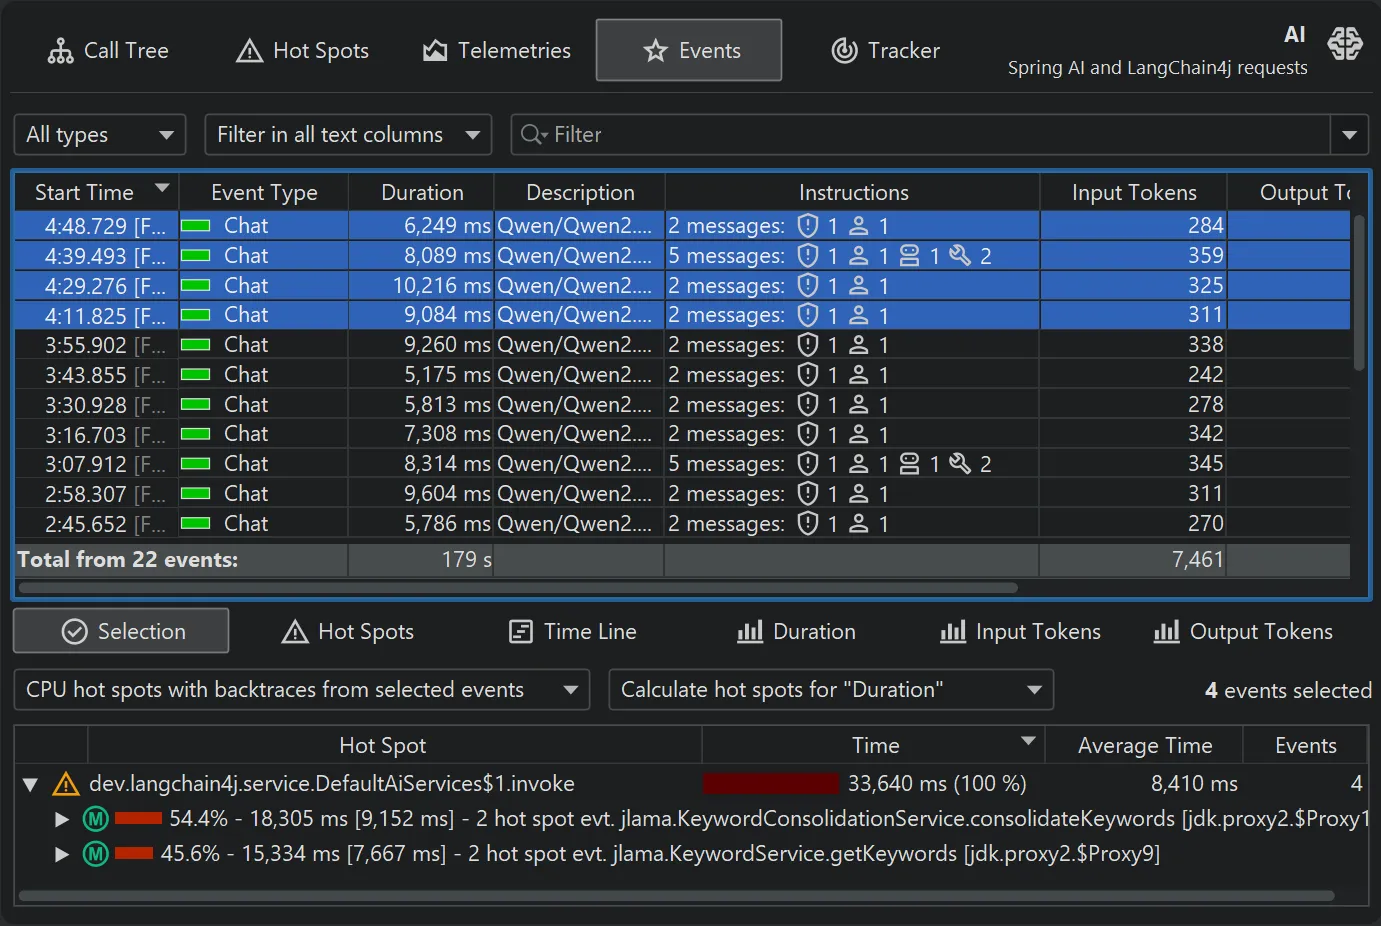
より詳細な調査には、上部のフィルタセレクタと下部の各タブを使用して、メインテーブルおよび関連ビューに表示されるイベントの集合を絞り込むことができます。
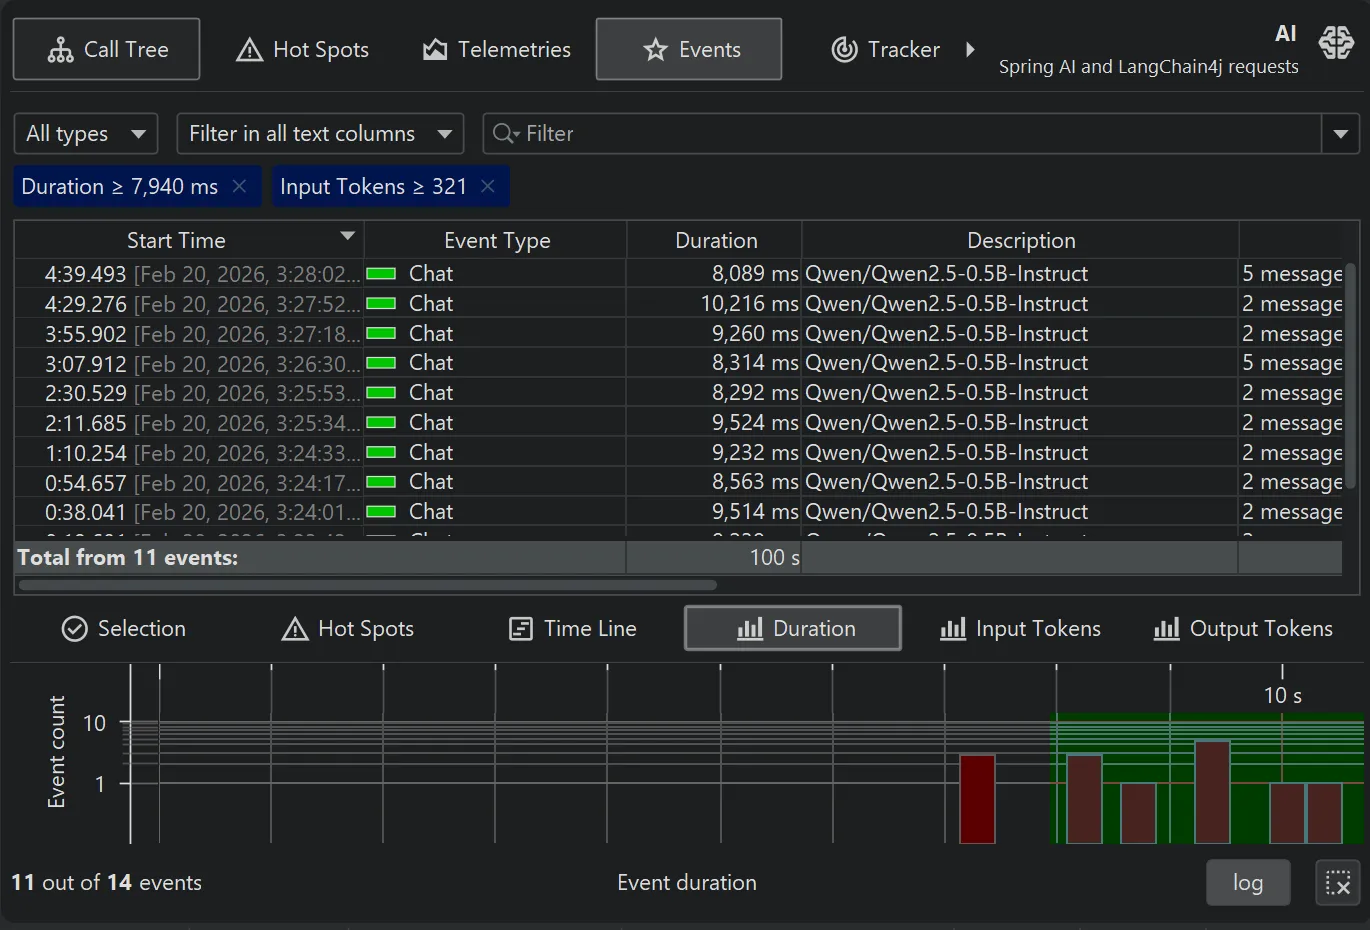
デフォルトでは、AIプローブはリクエストを処理した具体的なモデル名に基づいてホットスポットを特定します。このデータは、イベントを記録していなくても、イベントビューだけでなくAIプローブのホットスポットビューでも参照できます。
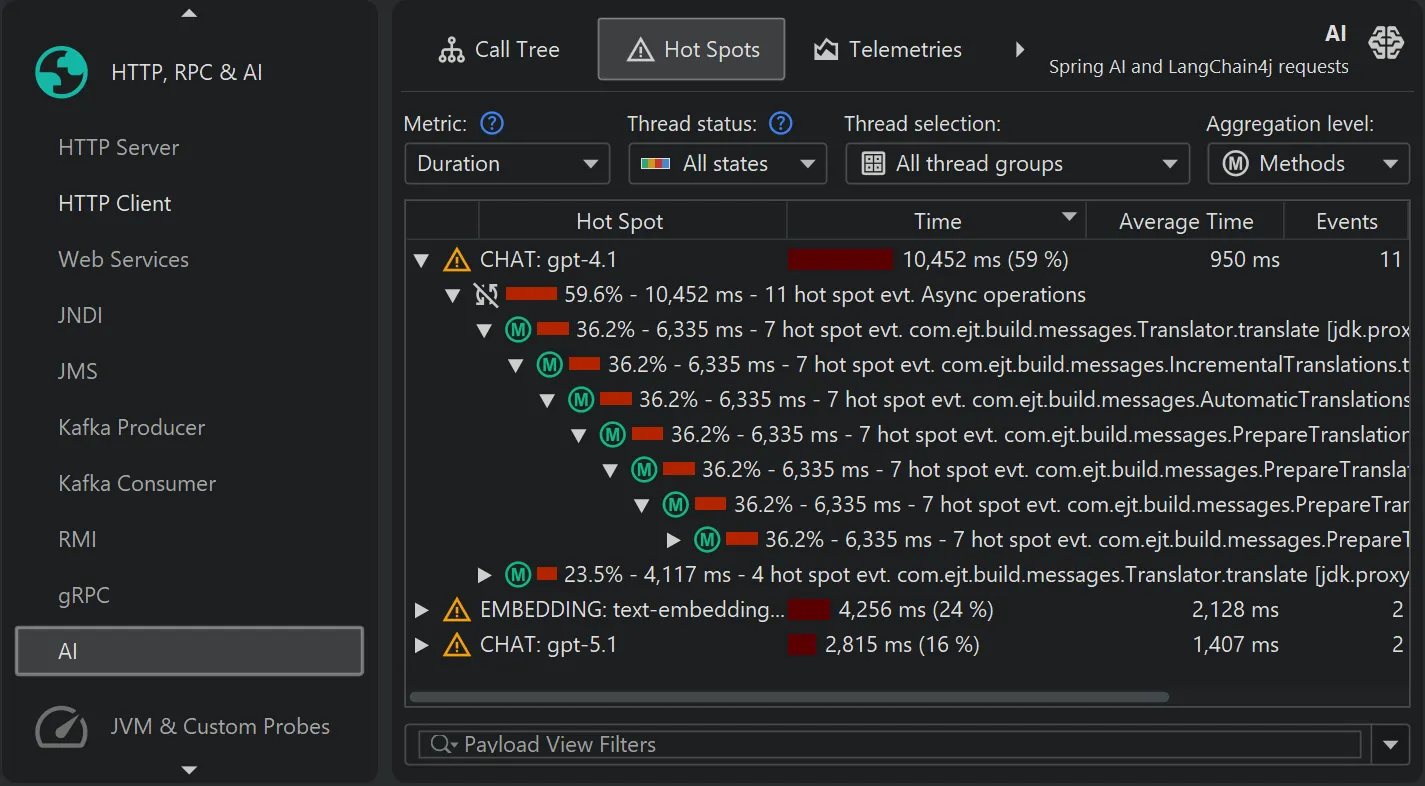
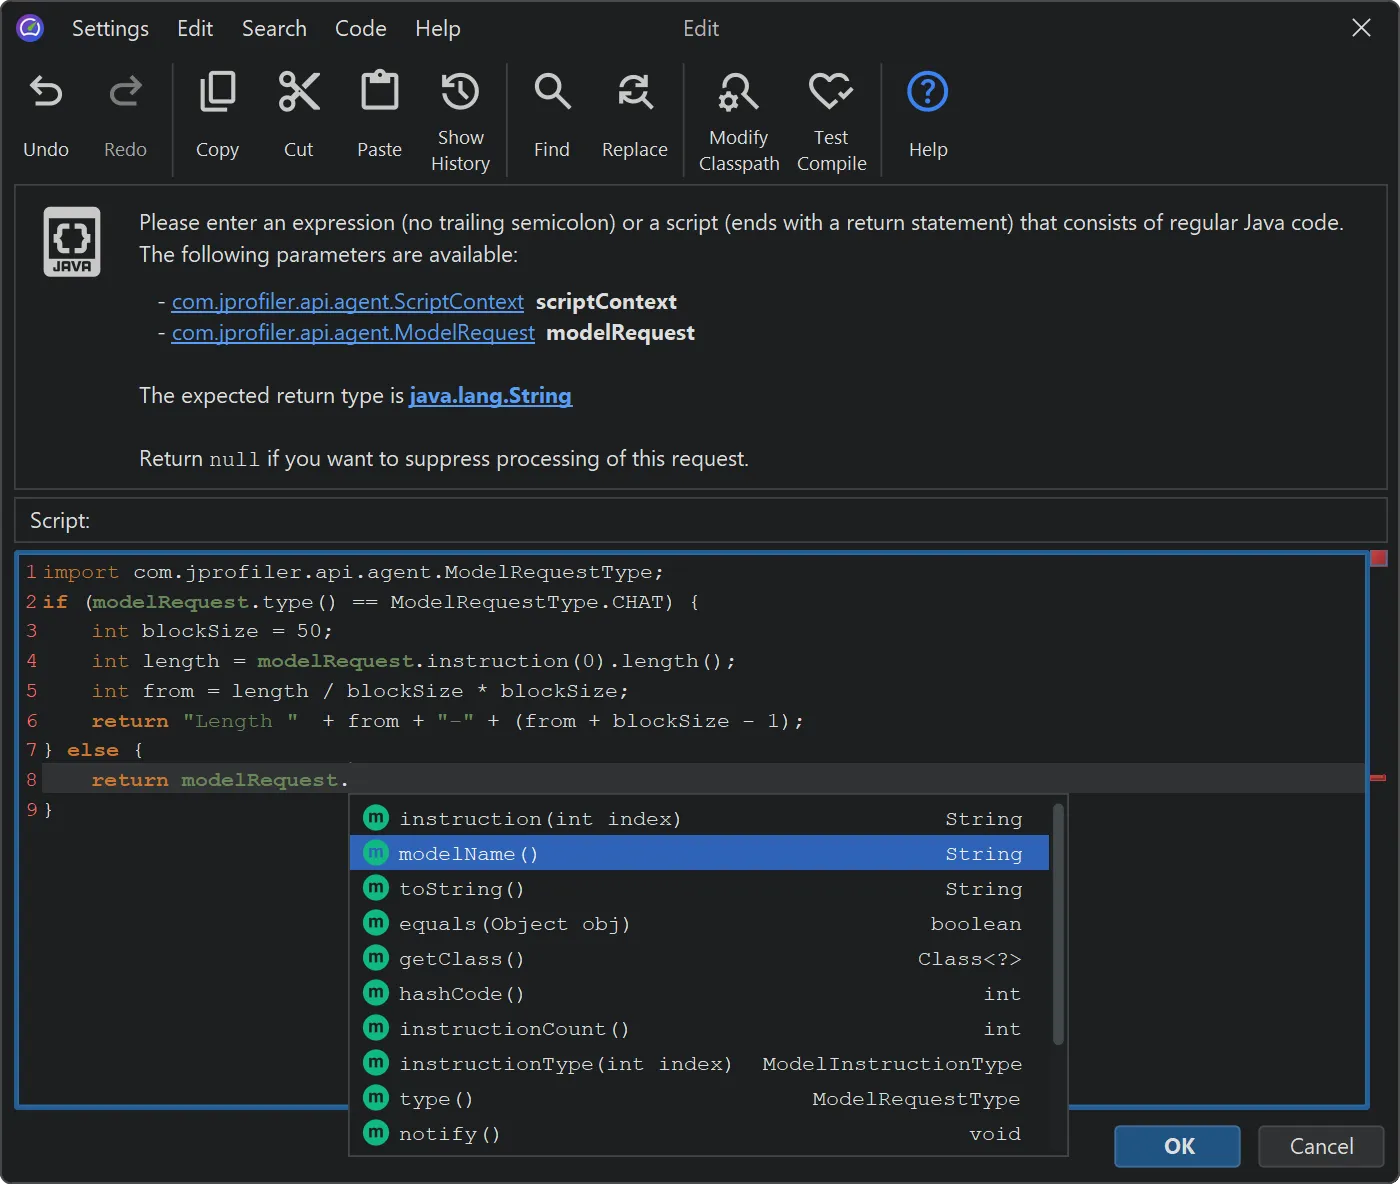
モデル名によるホットスポットは、興味深いホットスポットのタイプの1つにすぎません。プローブ設定では、JProfilerの強力なスクリプトエディタにJavaコードを入力して、ユーザー定義のタイプのホットスポットを計算するスクリプトを設定できます。
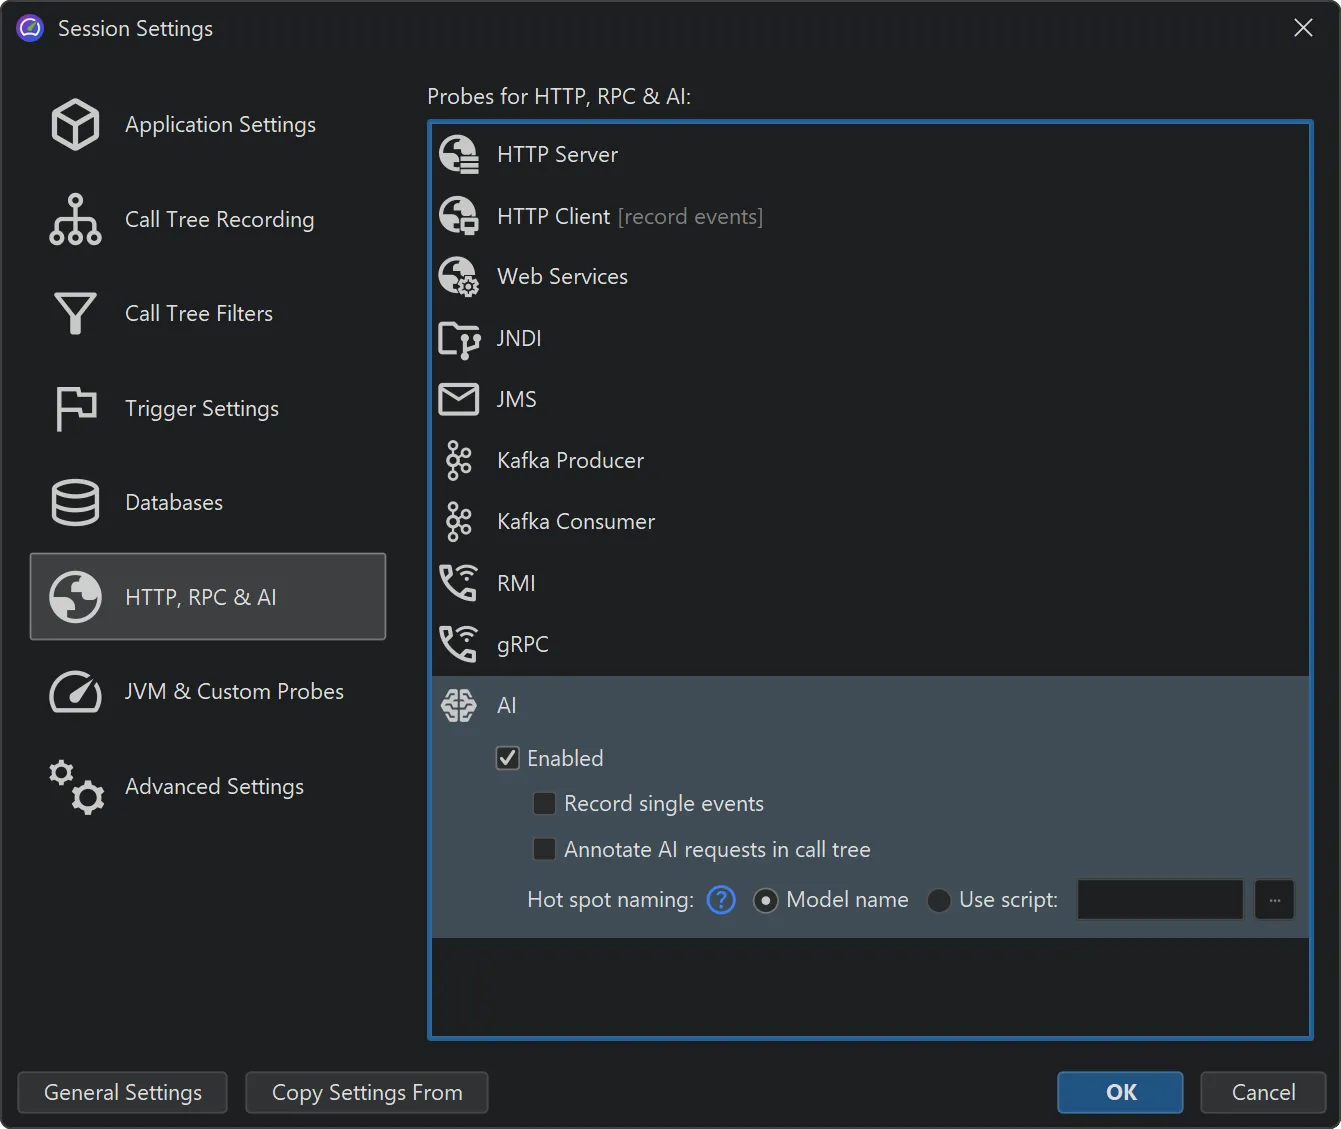
AIプローブのイベントが記録されると、JProfilerはこのスクリプトをModelRequestパラメータ付きで呼び出します。このパラメータから、リクエストタイプ、モデル名、および各指示タイプを伴うすべての指示にアクセスできます。
例えば、プロンプト長を50文字単位のバケットにグループ化してホットスポットを定義することもできます。以下の例は、その方法を示したものです。
JProfilerは記録中もデータをライブで表示するため、プロファイリング中にこれらの設定を変更すると、その効果をすぐに確認できます。
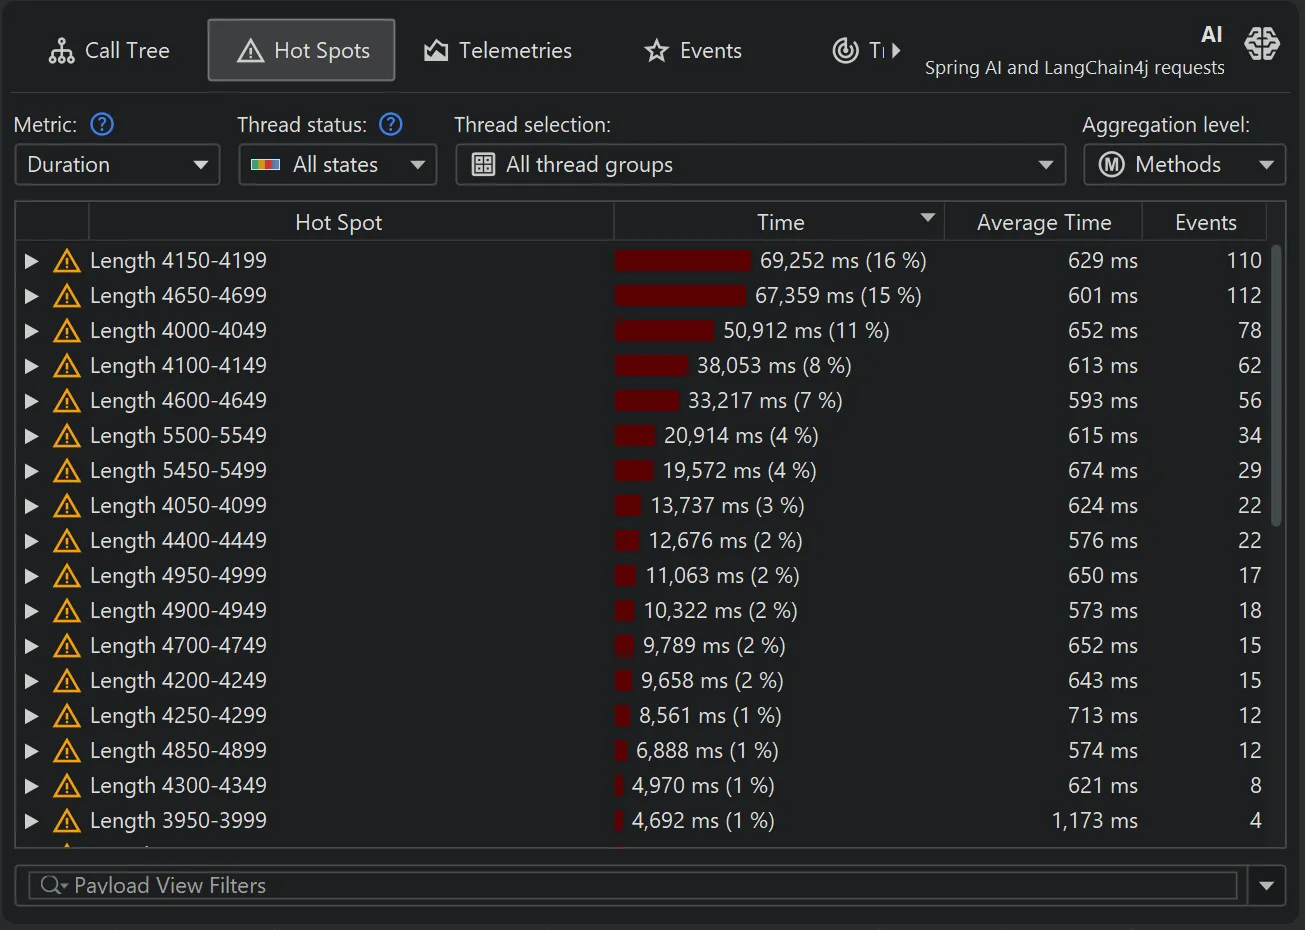
上記のスクリプトを使用すると、新しいホットスポットは次のように表示されます。
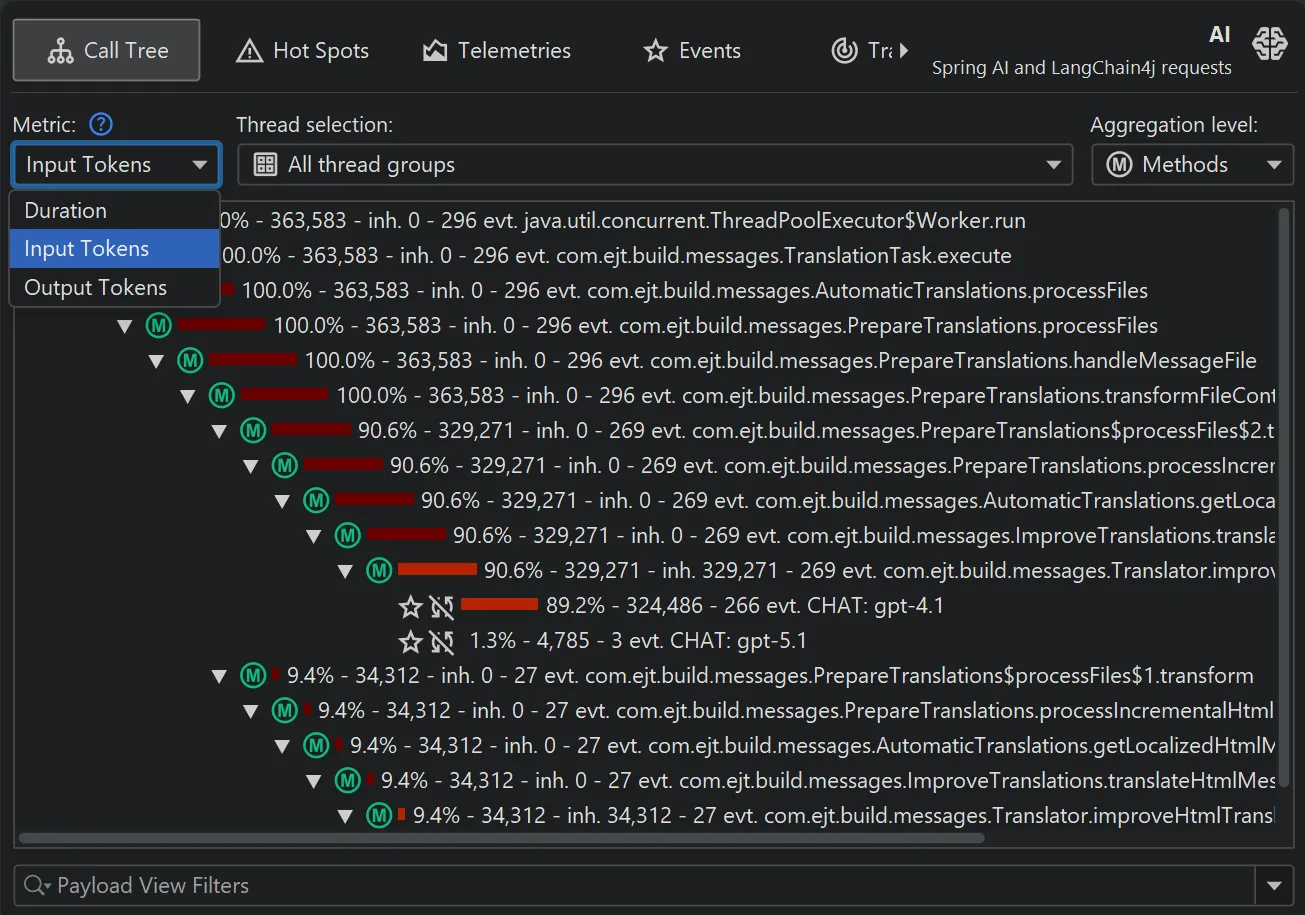
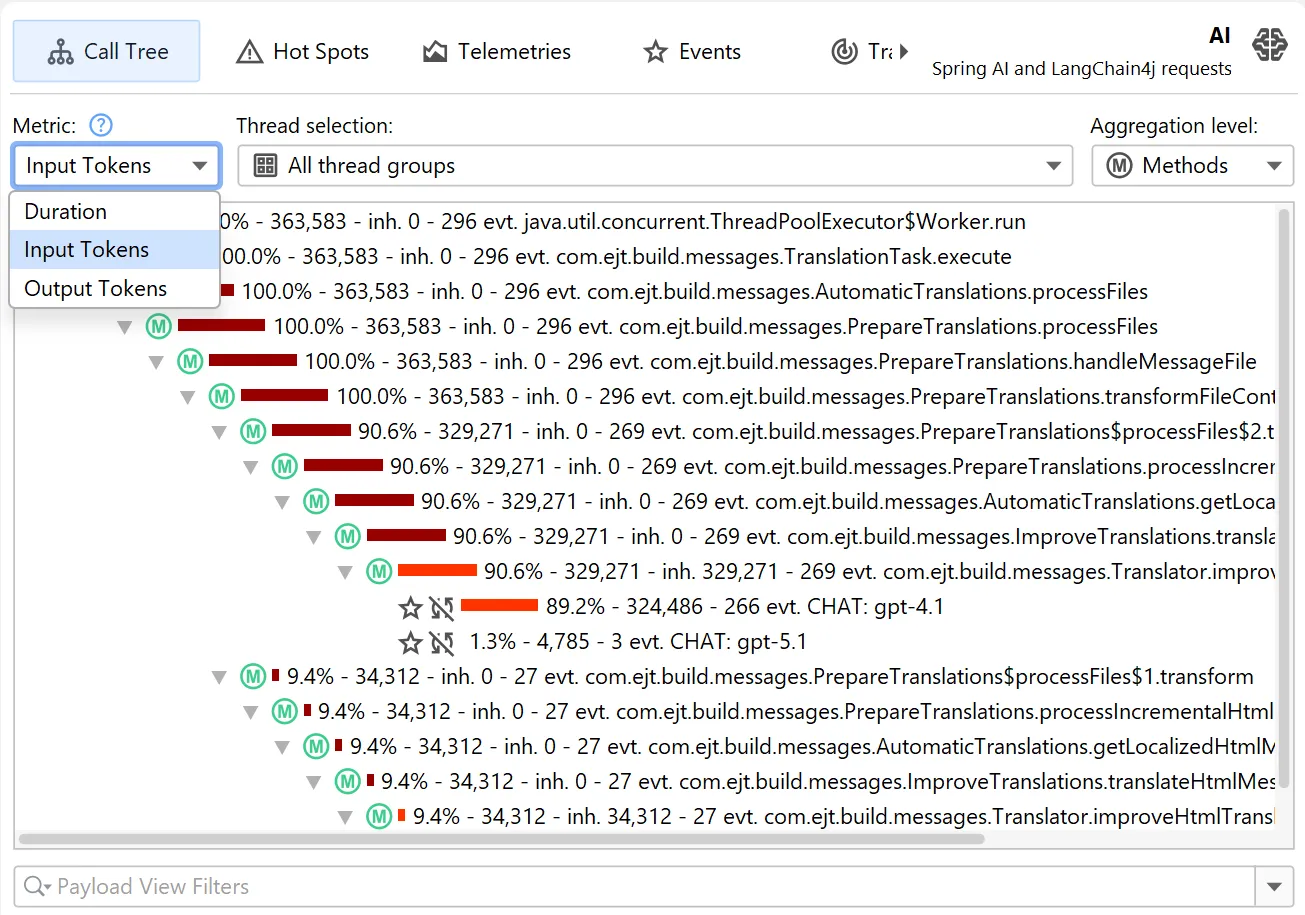
デフォルトではホットスポットはリクエストの所要時間に着目しますが、主要な測定値を入力トークンや出力トークンに切り替えることもできます。
この切り替えは、プローブホットスポットビューとプローブコールツリービューの両方で可能です。プローブコールツリービューには、メソッド呼び出しをプローブペイロードに結び付けるトップダウンビューが表示されます。
AIプローブのプローブテレメトリには、リクエスト数、平均リクエスト時間、入力/出力トークンを組み合わせたグラフが、チャットリクエストと埋め込みリクエストに分けて表示されます。
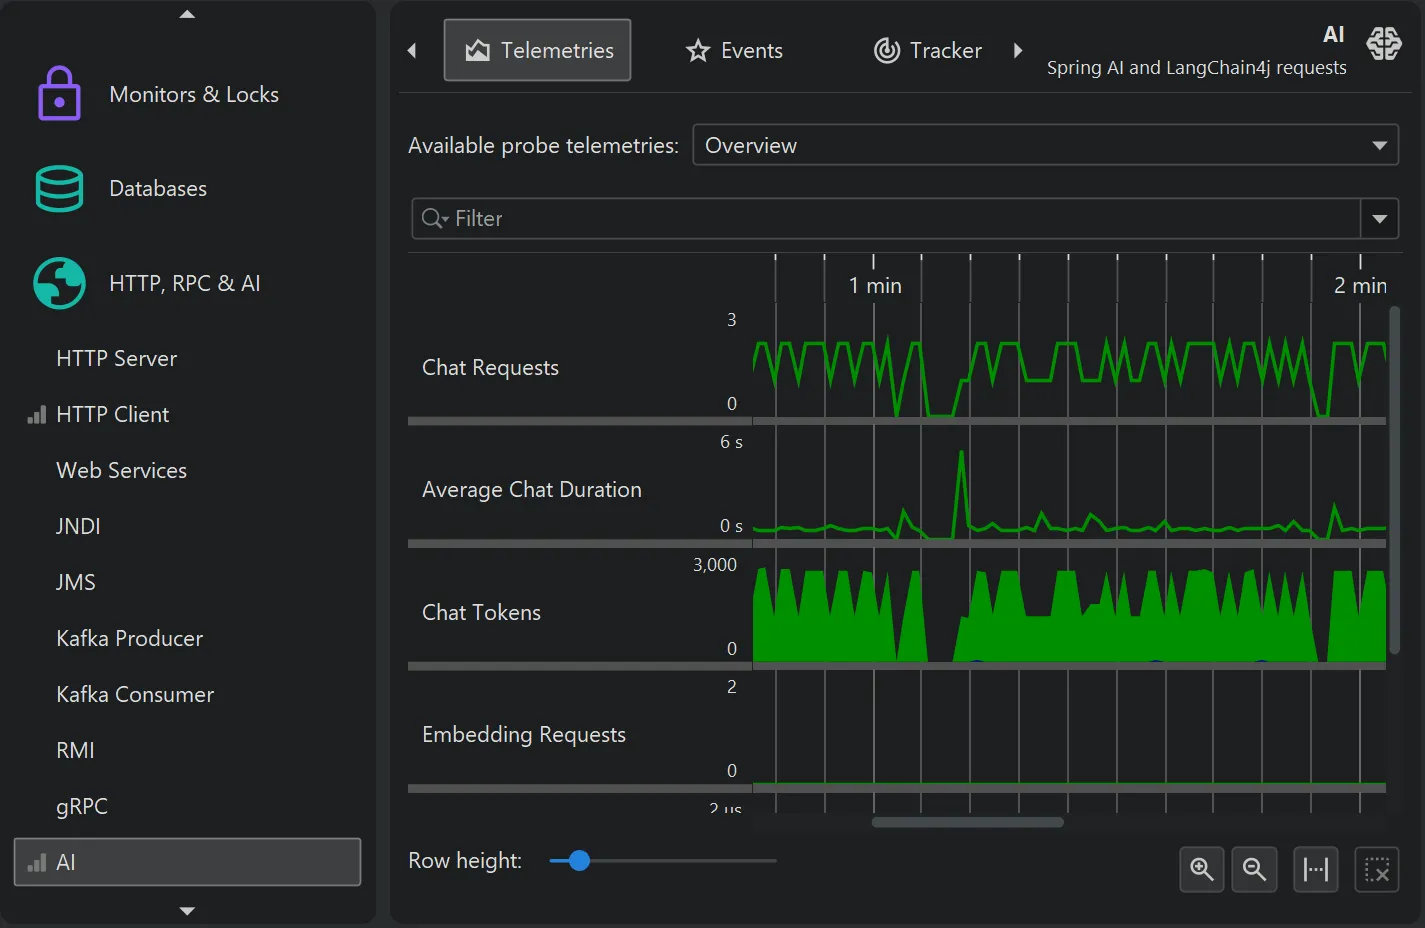
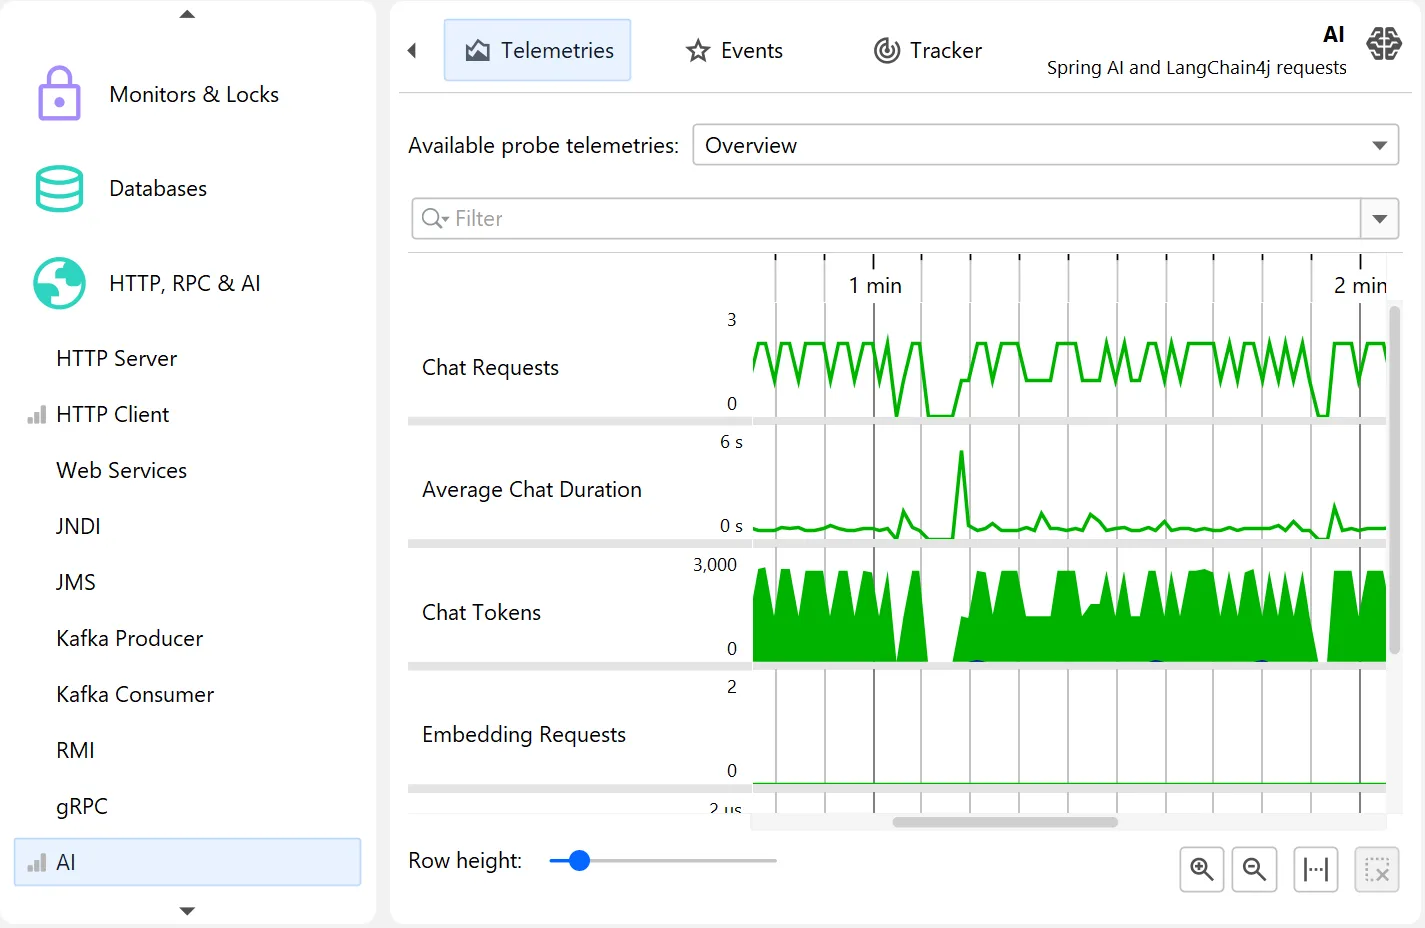
各テレメトリは個別に表示でき、特定の関心領域のイベントを選択するために使用できます。
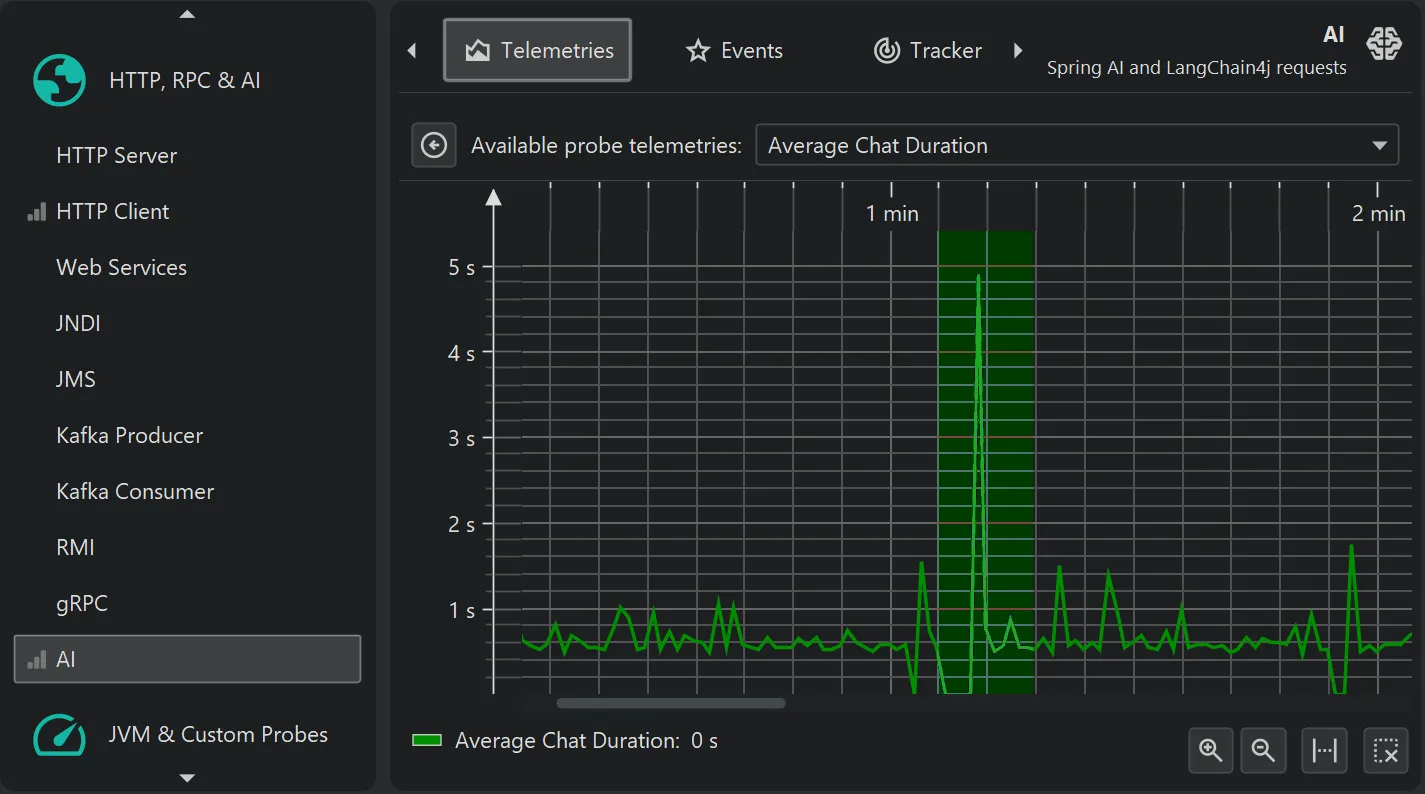
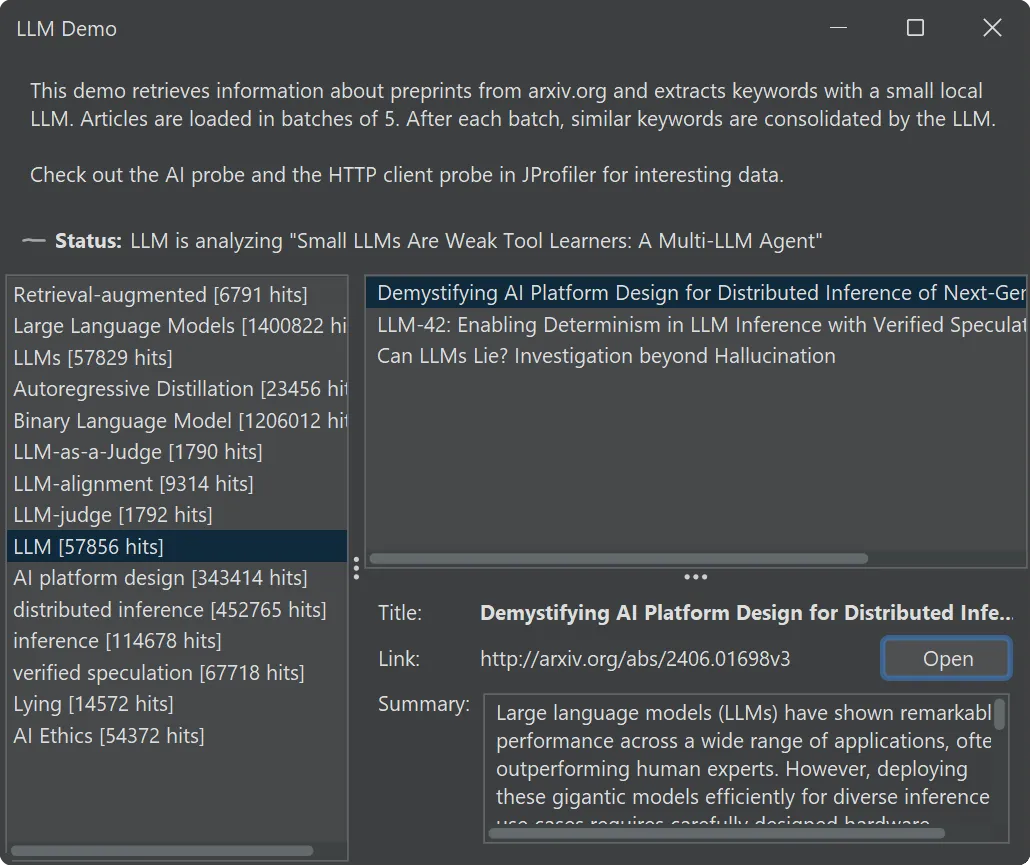
AIプローブを試していただけるよう、JProfilerには「LLMデモ」セッションが同梱されるようになりました。
このデモは、Java 21以降で動作するクロスプラットフォームの推論エンジンであるJlamaを使用し、Hugging Faceから5億パラメータのモデルをダウンロードして、arXivのLLM関連のプレプリントを分類します。
このデモには、LLMが生成したキーワードが次々と挿入されていくUIが用意されており、右側で関連する研究論文を調べることができます。
JProfilerには、モダンな外観と新しいアイコンを備えた新しいUIが搭載されました。気に入っていただければ幸いです。ライトテーマとダークテーマを用意しています。このページ上部のダークモードスイッチを切り替えると、それぞれのスクリーンショットをご覧いただけます。
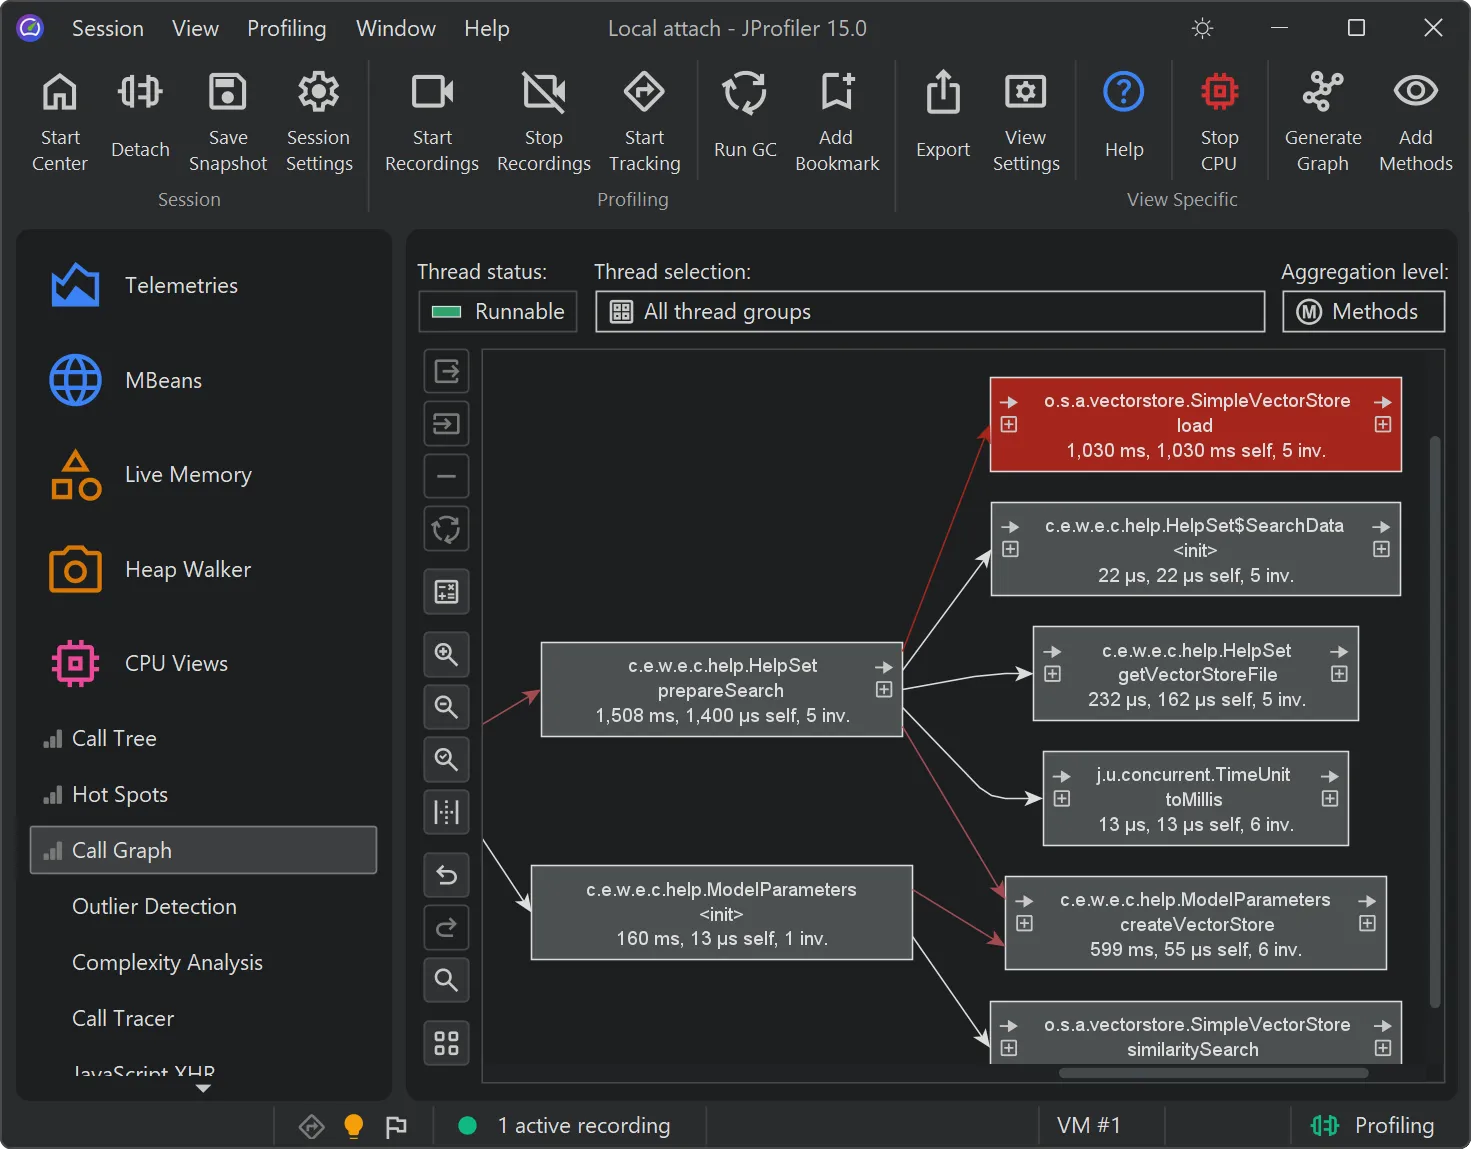
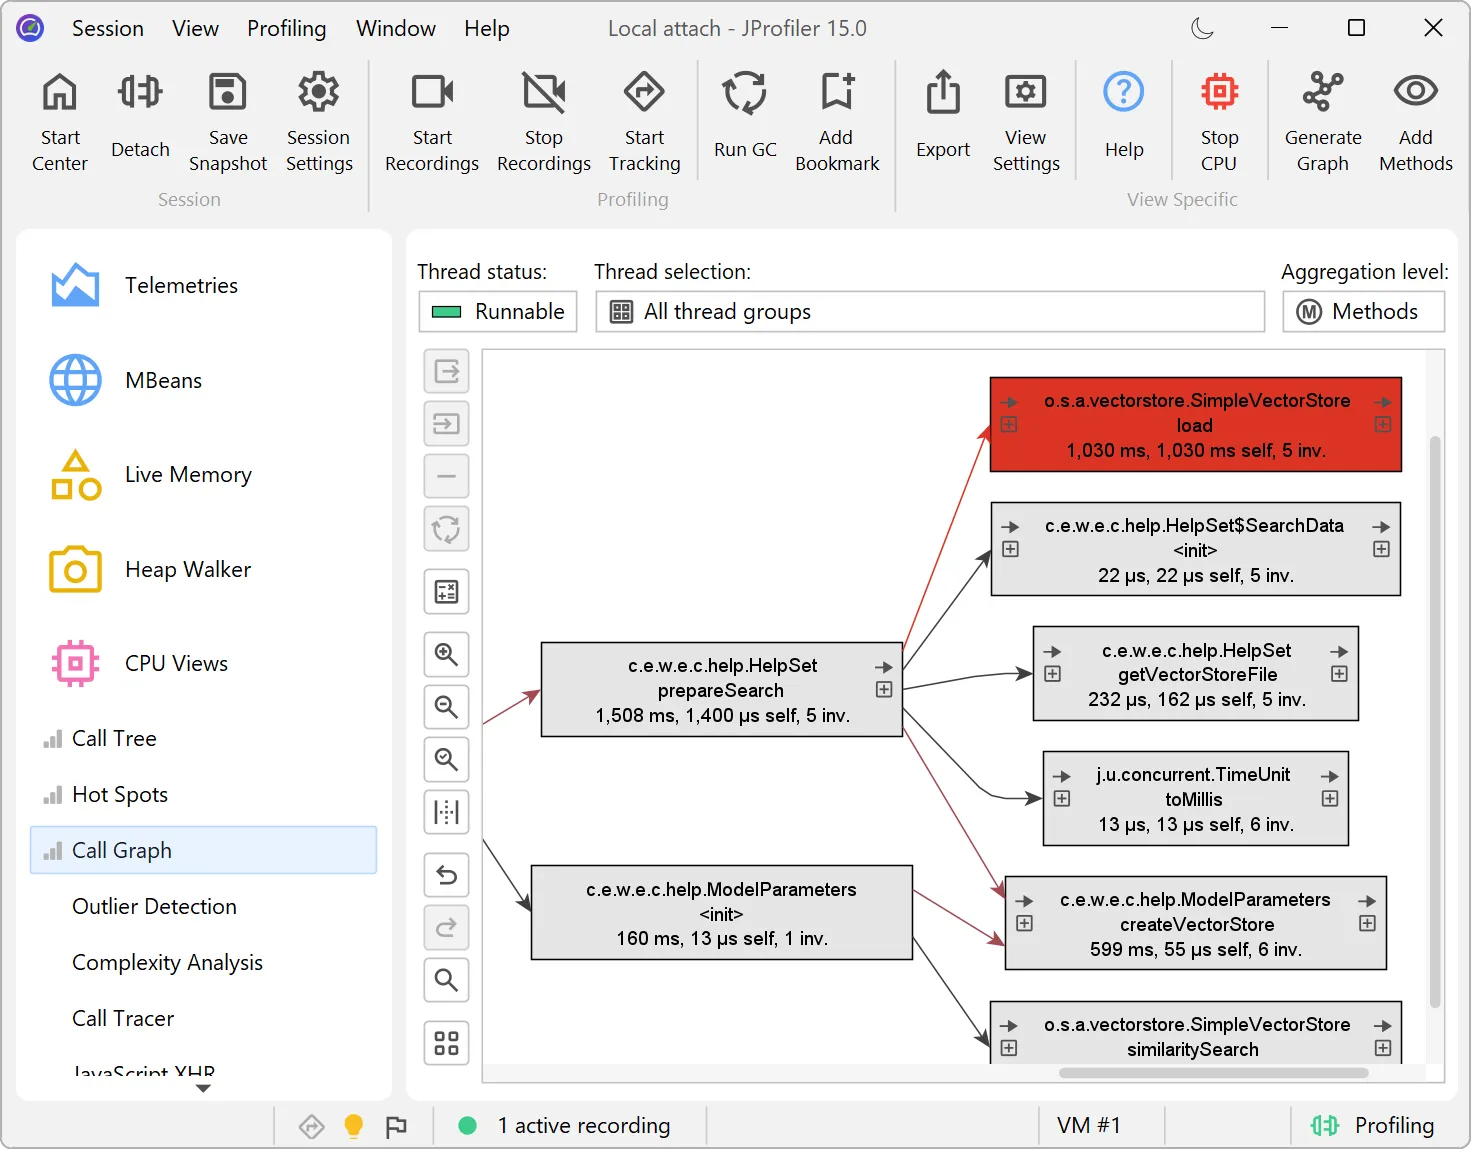
さらに、UIが完全にスケーラブルになりました。一般設定では、スケールファクタをパーセントで設定するか、任意のサイズのカスタムUIフォントを設定できます。UIはその設定に応じて拡大・縮小されます。
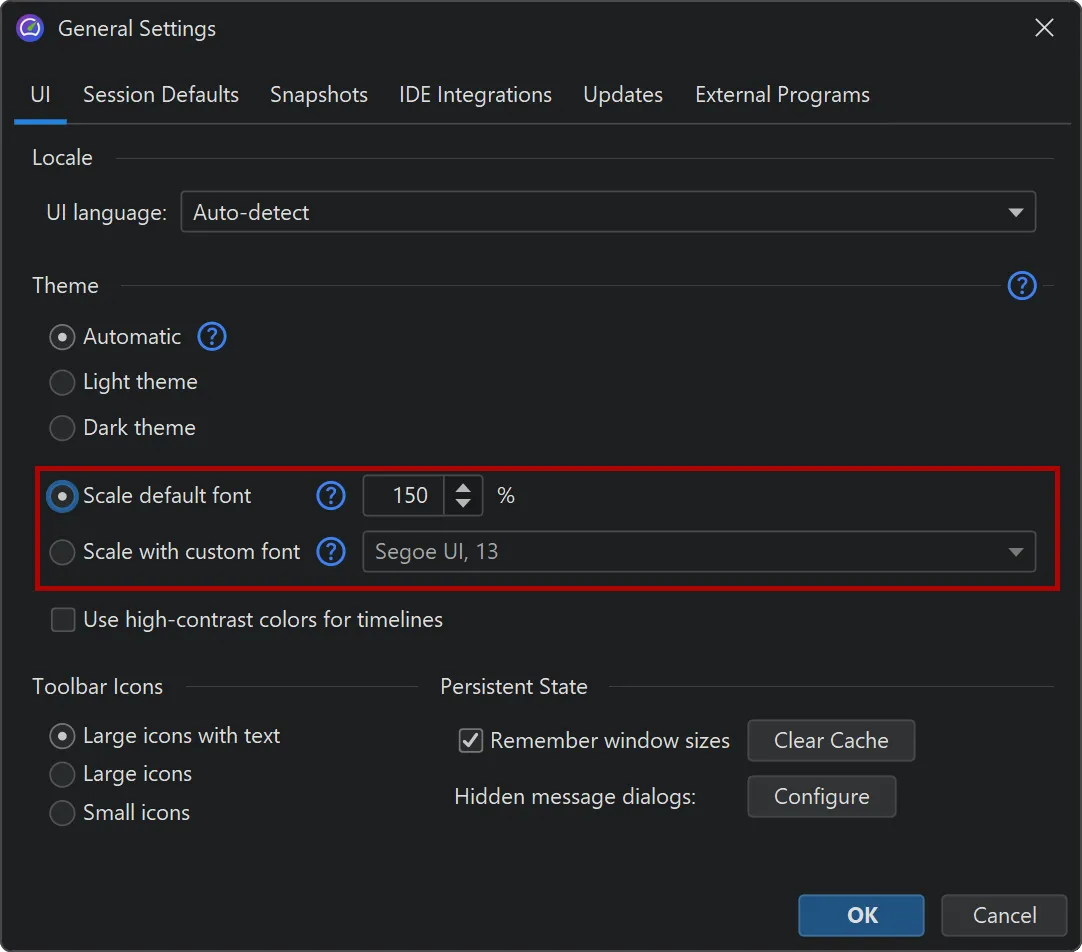
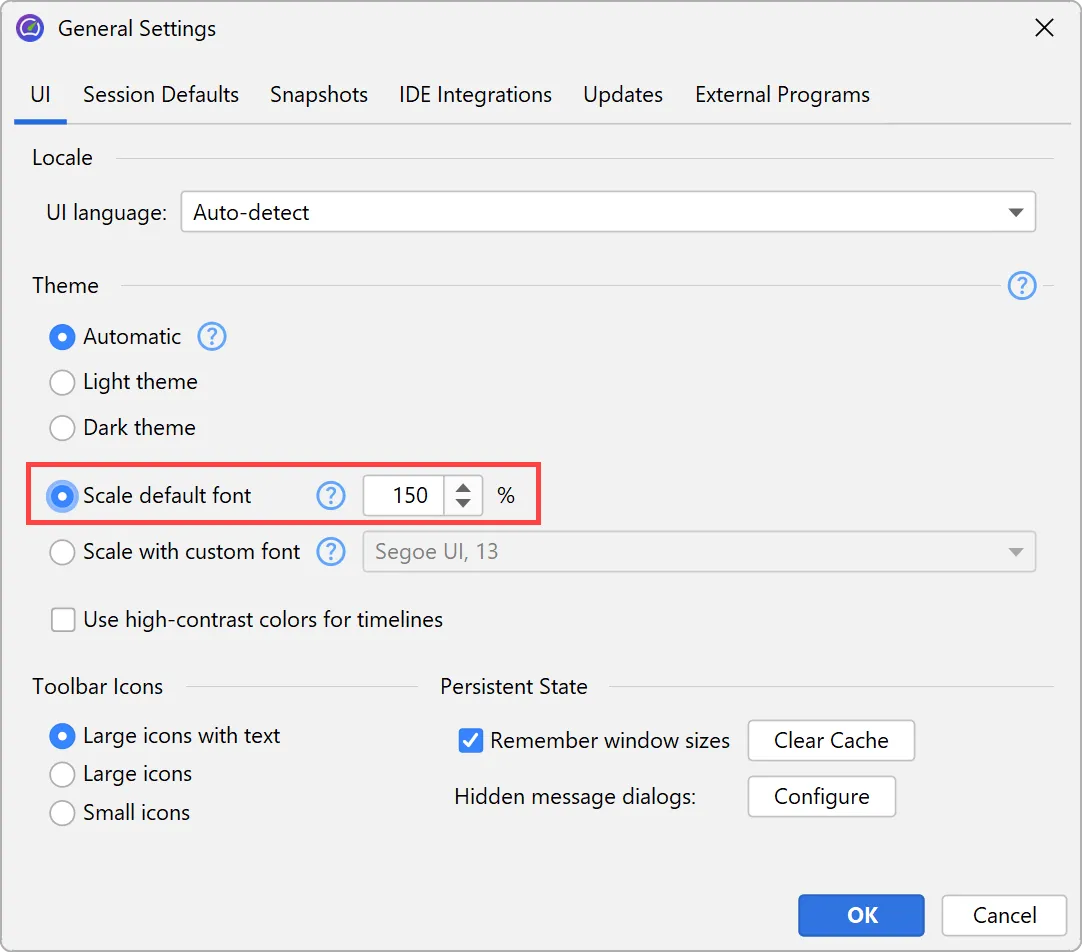
この機能により、JProfilerのUIをLinux上ですべてのOpenJDKバリアント、すべてのHiDPI解像度で実行できるようになりました。以前は、HiDPI解像度のLinuxではJetBrainsランタイムのみがサポートされていました。
JProfilerのインストーラーをモダン化しました。デフォルトの実行モードも簡素化されています。デフォルトでは、カスタマイズ実行モードですべてのユーザー向けにインストールを選択しない限り、管理者権限は要求されません。
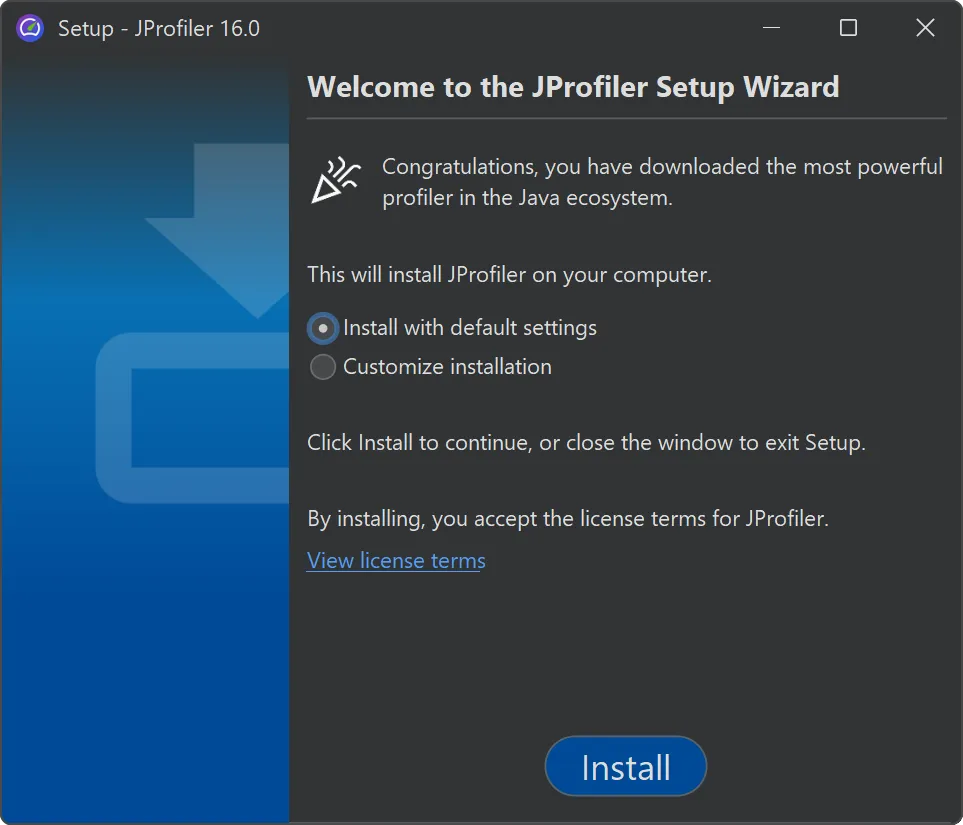
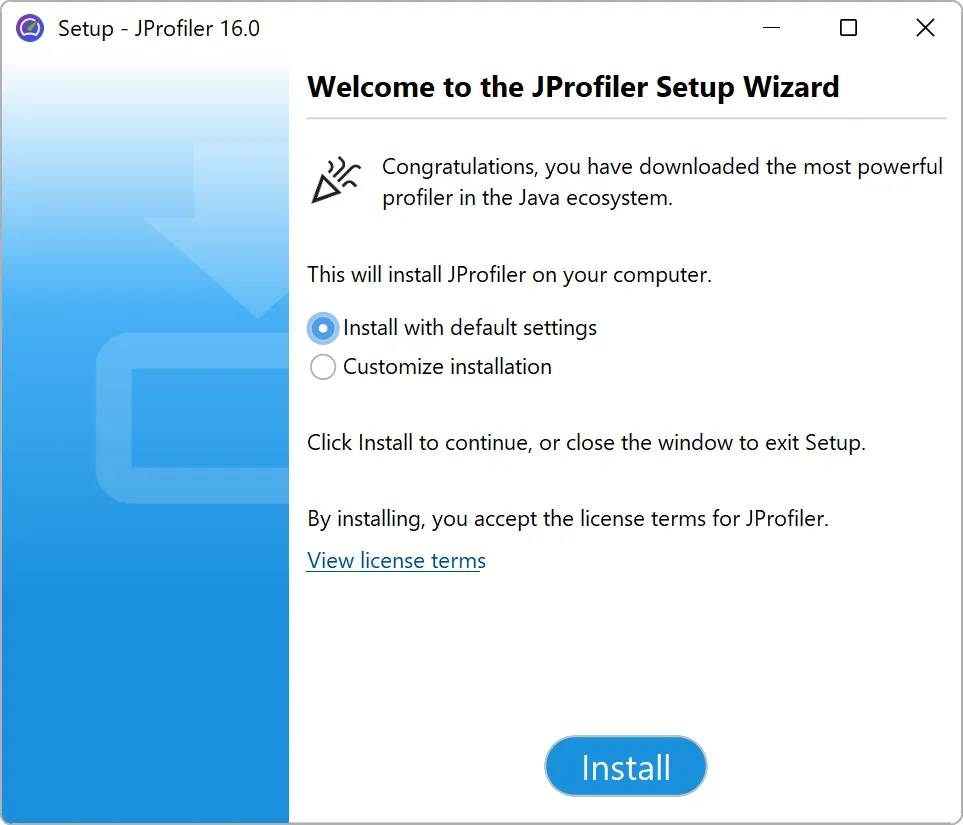
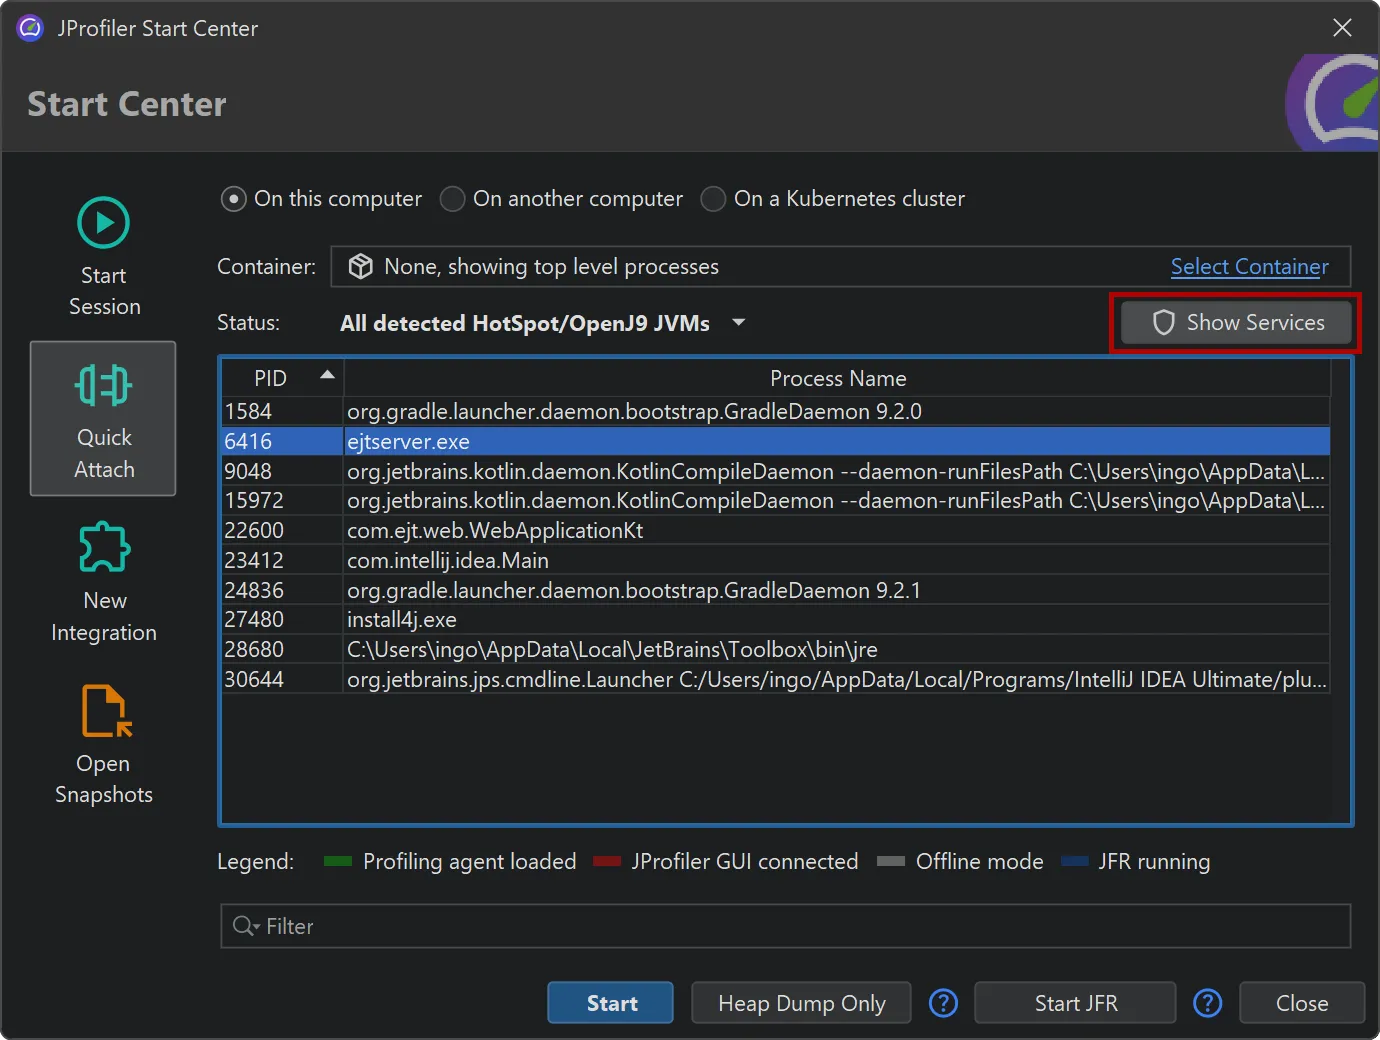
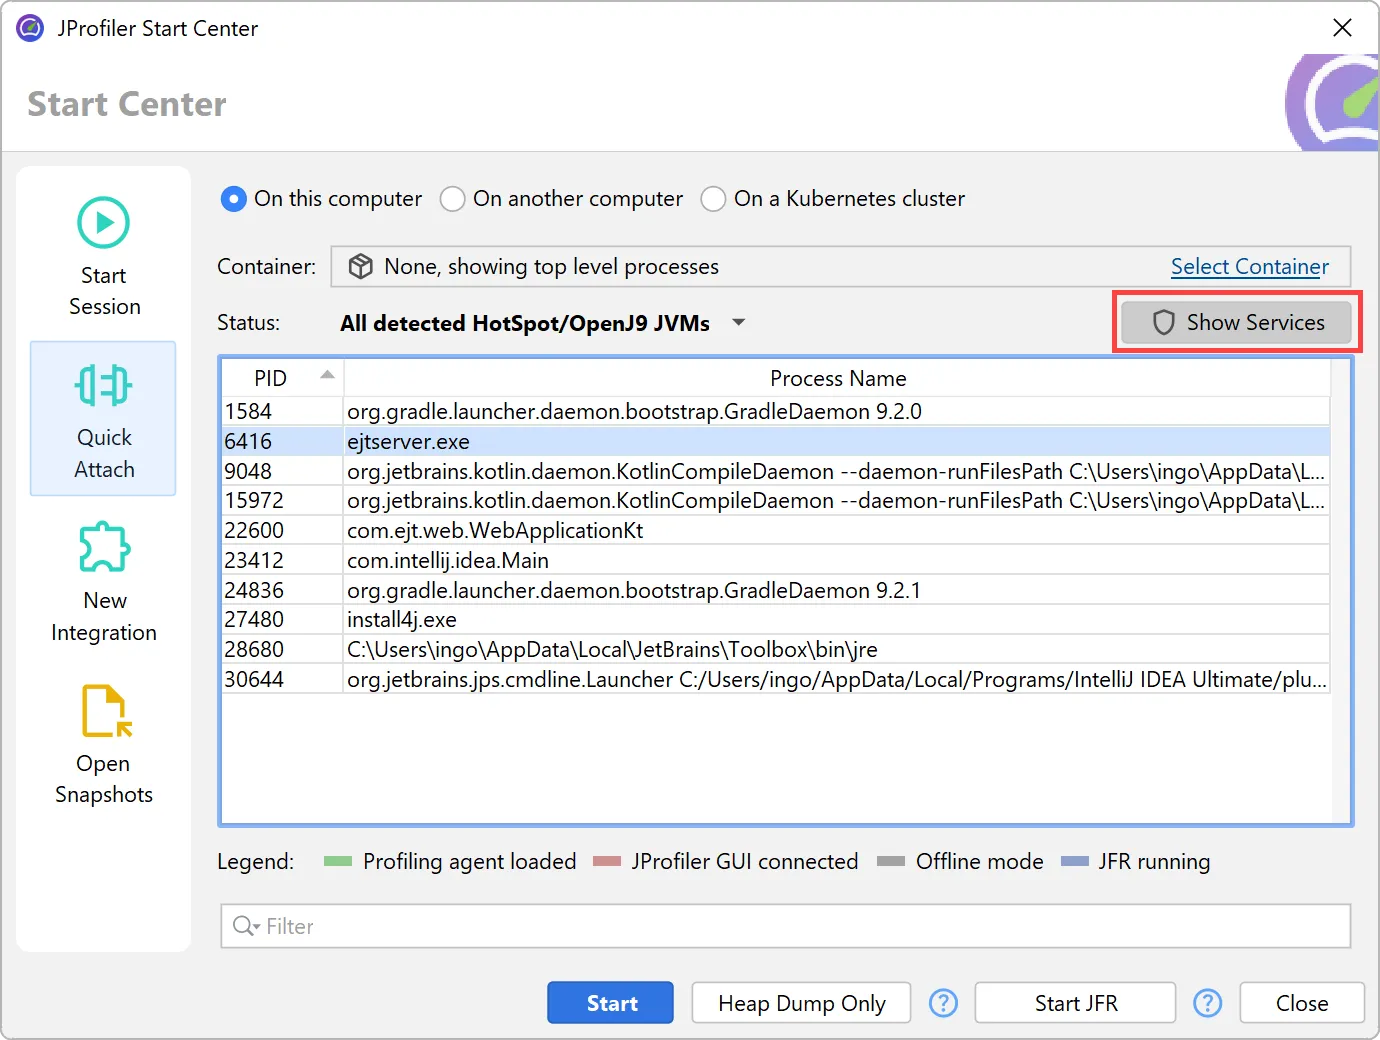
これに関連する改良として、別のユーザーとして実行されているWindowsプロセスへのアタッチが、JProfilerがそれらのプロセスから読み取り可能なディレクトリにインストールされていない場合でも可能になりました。これは特にWindowsサービスへのアタッチにおいて重要です。
JProfilerのプローブイベント記録を再実装しました。これにより、数百万規模のイベントに対応するスケーラビリティと、多くの新機能が実現しています。
プローブがJProfiler 7で導入された当初は、ホットスポットやテレメトリのような集計データが中心でした。個別のイベントは問題をデバッグするためのツールとして利用できましたが、すべてメモリに保持されるため、イベント数は比較的少ない範囲に制限されていました。
しかし、すべてのイベントを保持することで、集計データだけでは実現できない高度なフィルタリングが可能になります。新しいファイルベースのバックエンドは高スループットの記録をサポートし、以前は処理できなかった大規模なイベント集合に対する複雑なクエリを可能にします。
イベントビュー下部の新しいタイムラインタブには、記録されたすべてのイベントのヒストグラムが表示され、フィルタリング対象の時間範囲を選択できます。
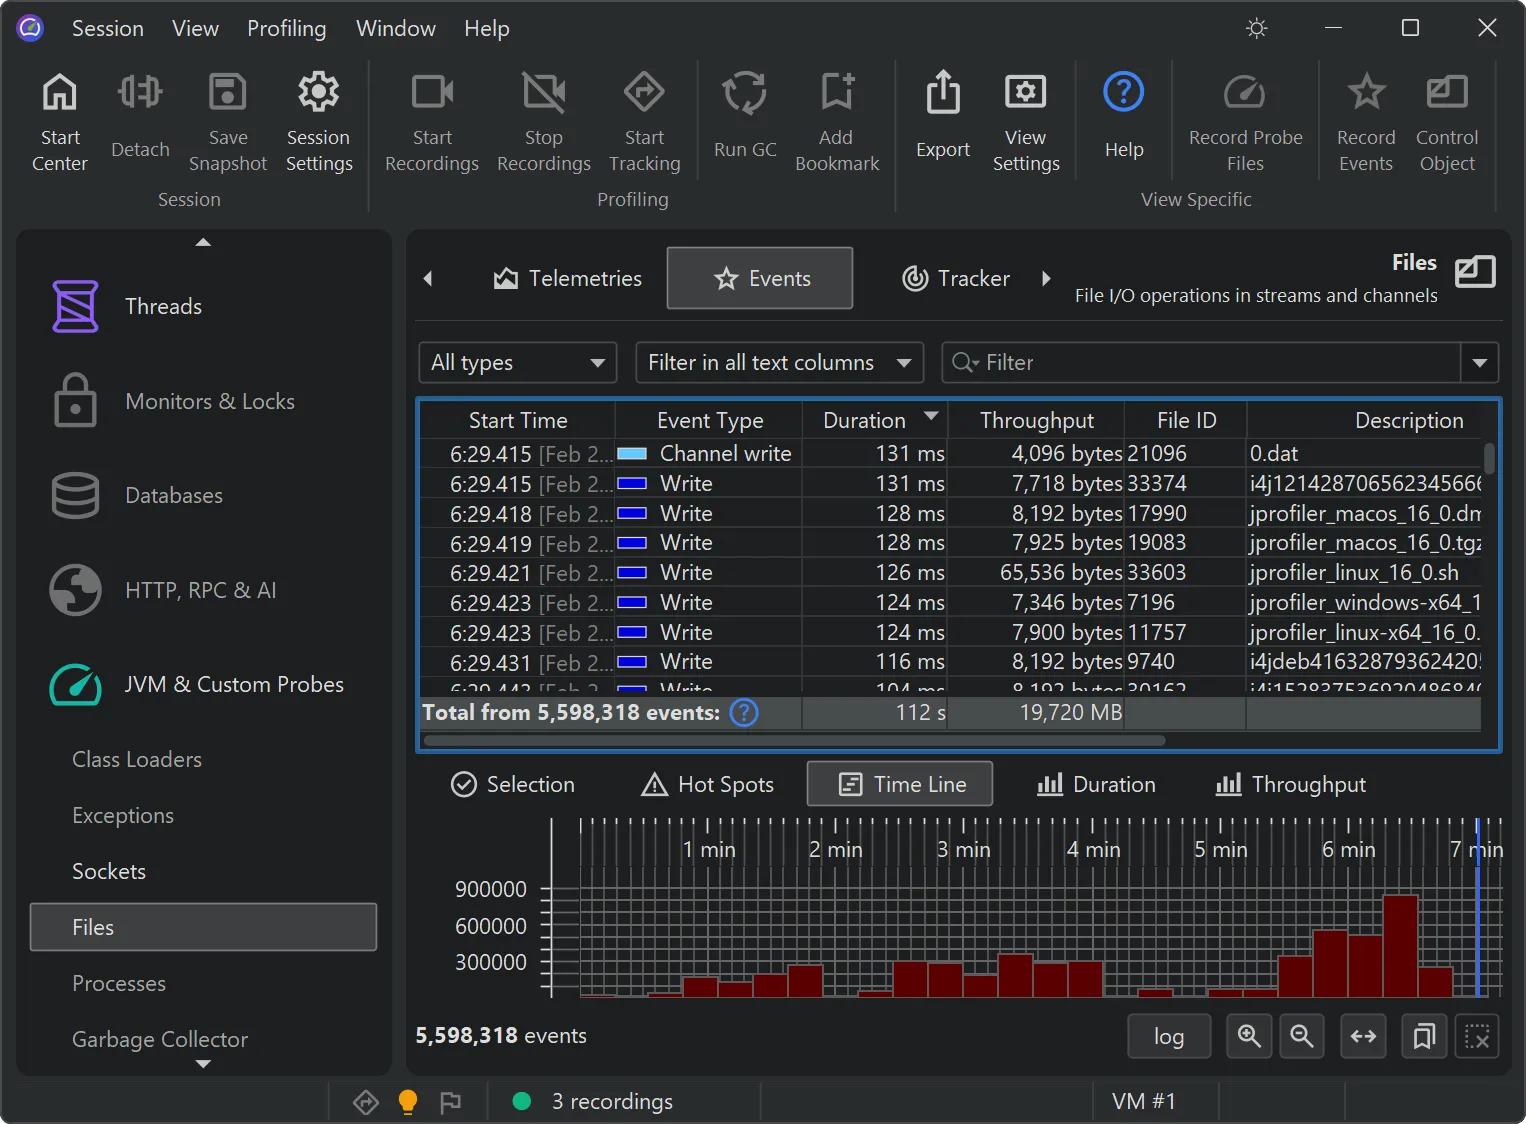
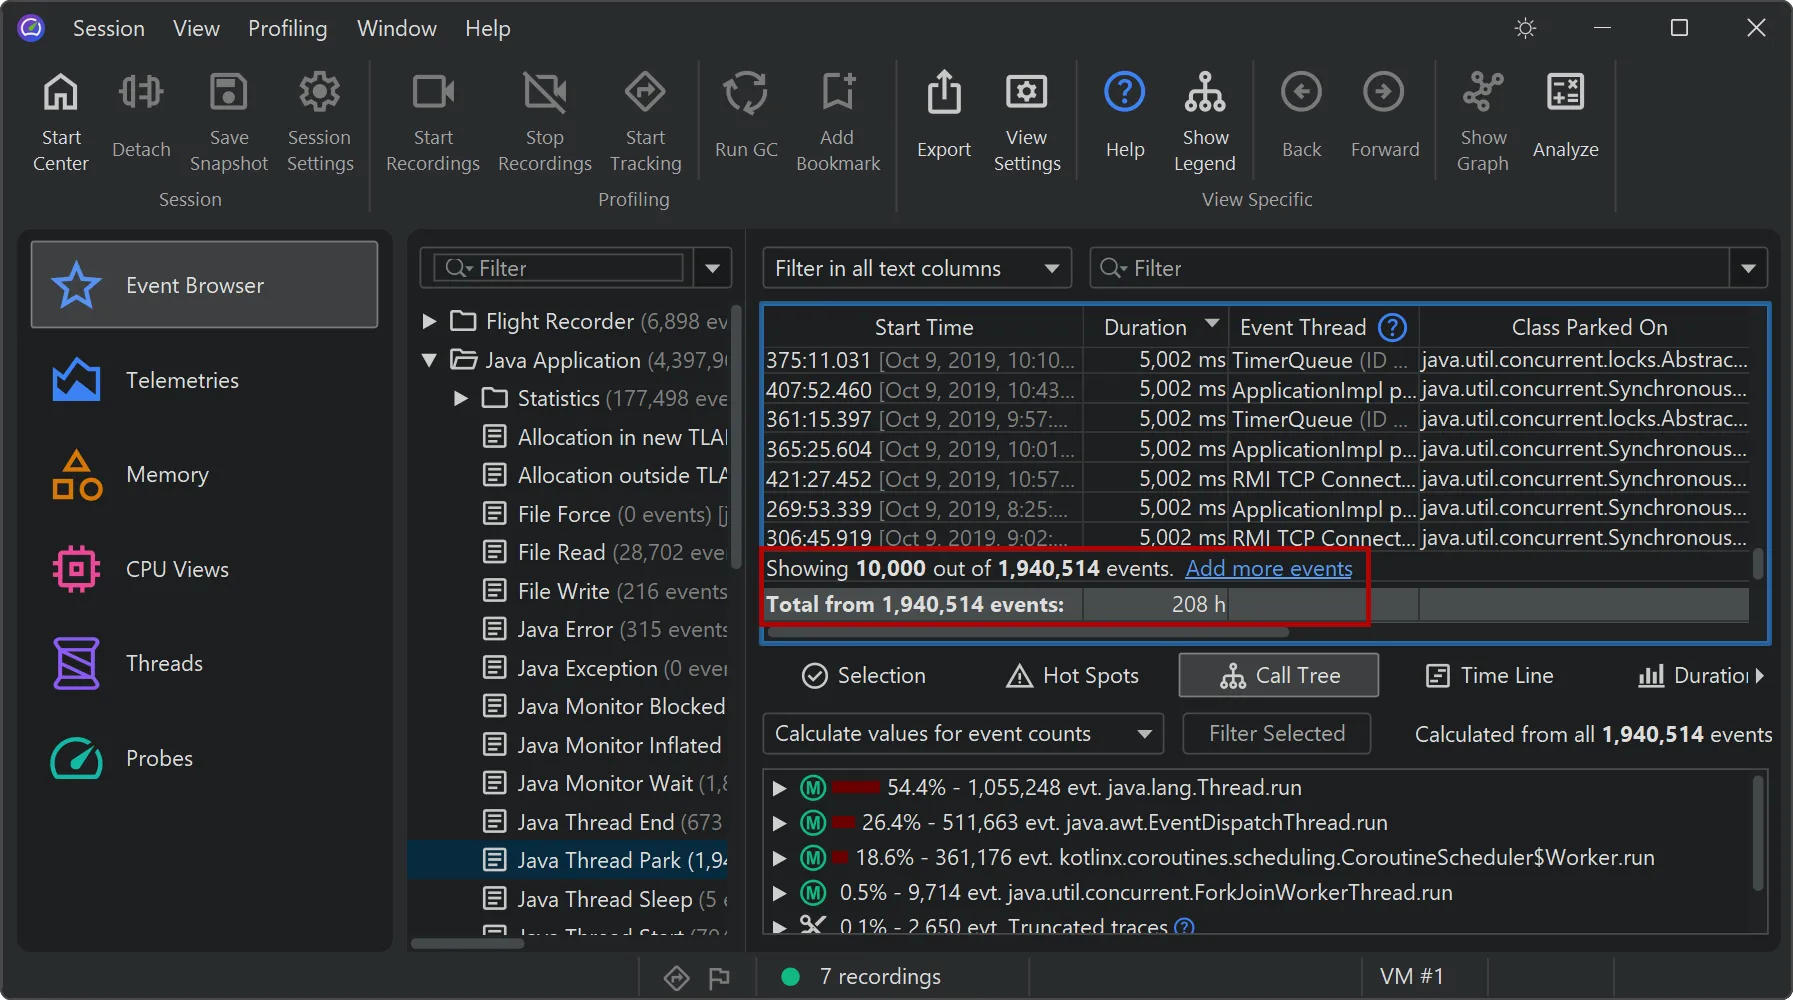
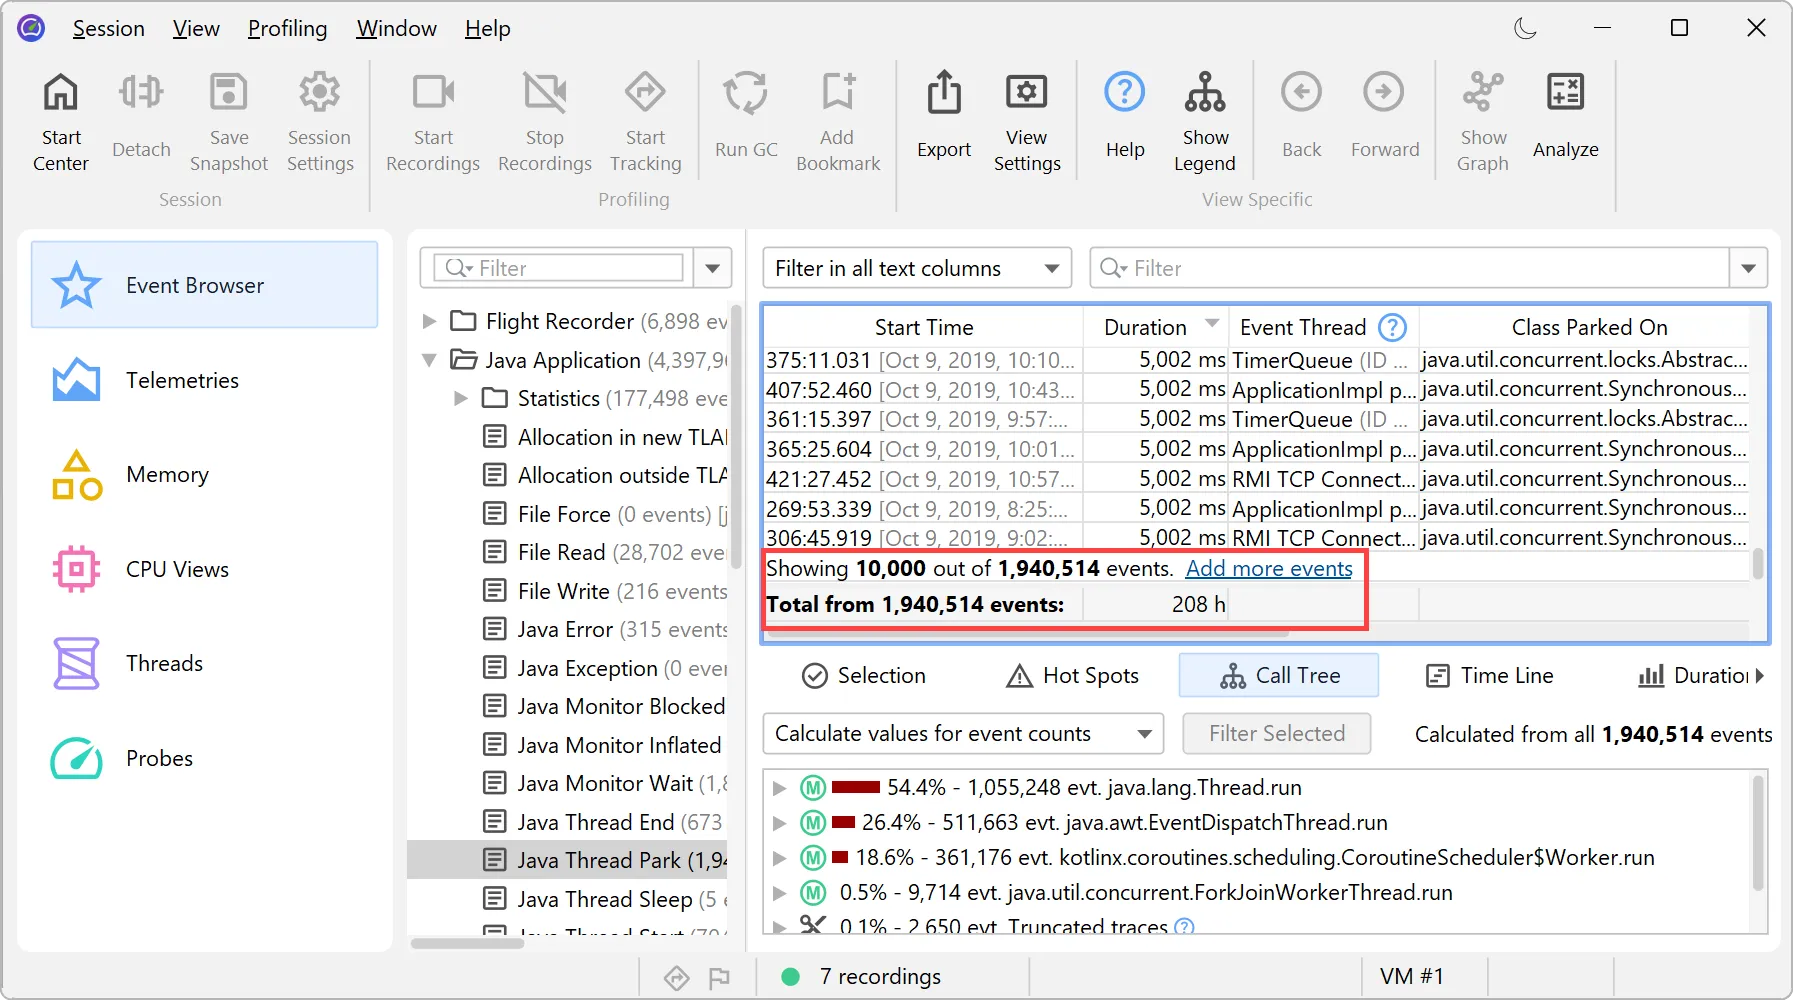
テーブルに表示されるイベントの数は限られていますが、最下部までスクロールするとイベントを追加表示できます。列でソートする際には、現在表示されている行だけでなく、フィルタ済みイベントの全集合が対象になります。
テーブルの合計値も、フィルタ済みイベントの全集合について計算されます。
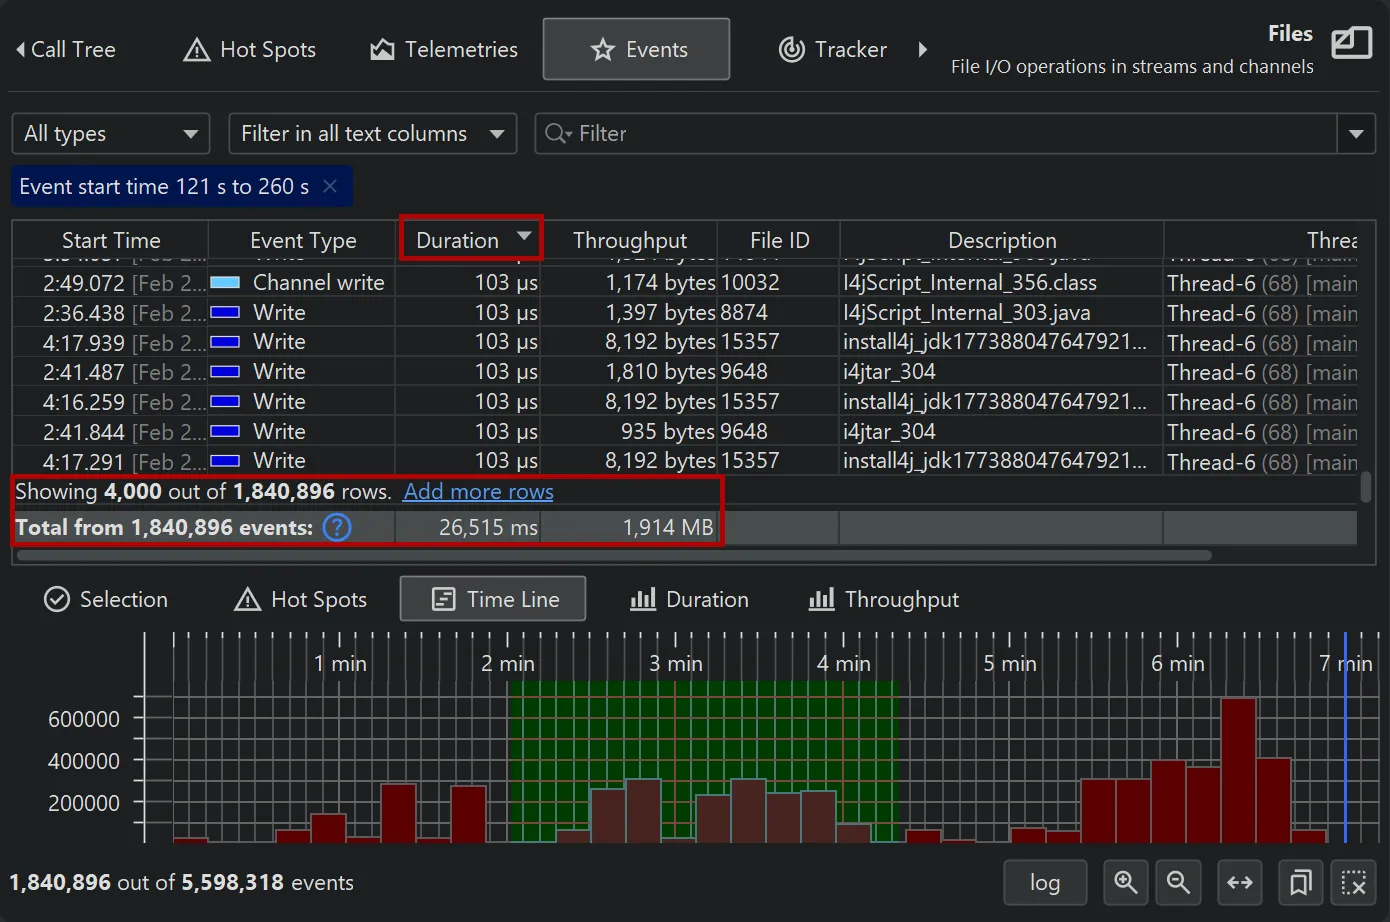
下部の「ホットスポット」タブには、CPUホットスポットビュー、プローブホットスポットビュー、プローブコールツリーが含まれます。「選択」タブと似ていますが、選択された行ではなくフィルタ済みの全イベントを対象に計算されます。
これらのビューではそれぞれ、フィルタボタンを使用して、メインのイベントテーブルと下部の他のすべてのビューに表示されるイベントを絞り込めます。以下はプローブコールツリーでのコールスタックフィルタの例で、フィルタされたノードにはフィルタアイコンが付きます。
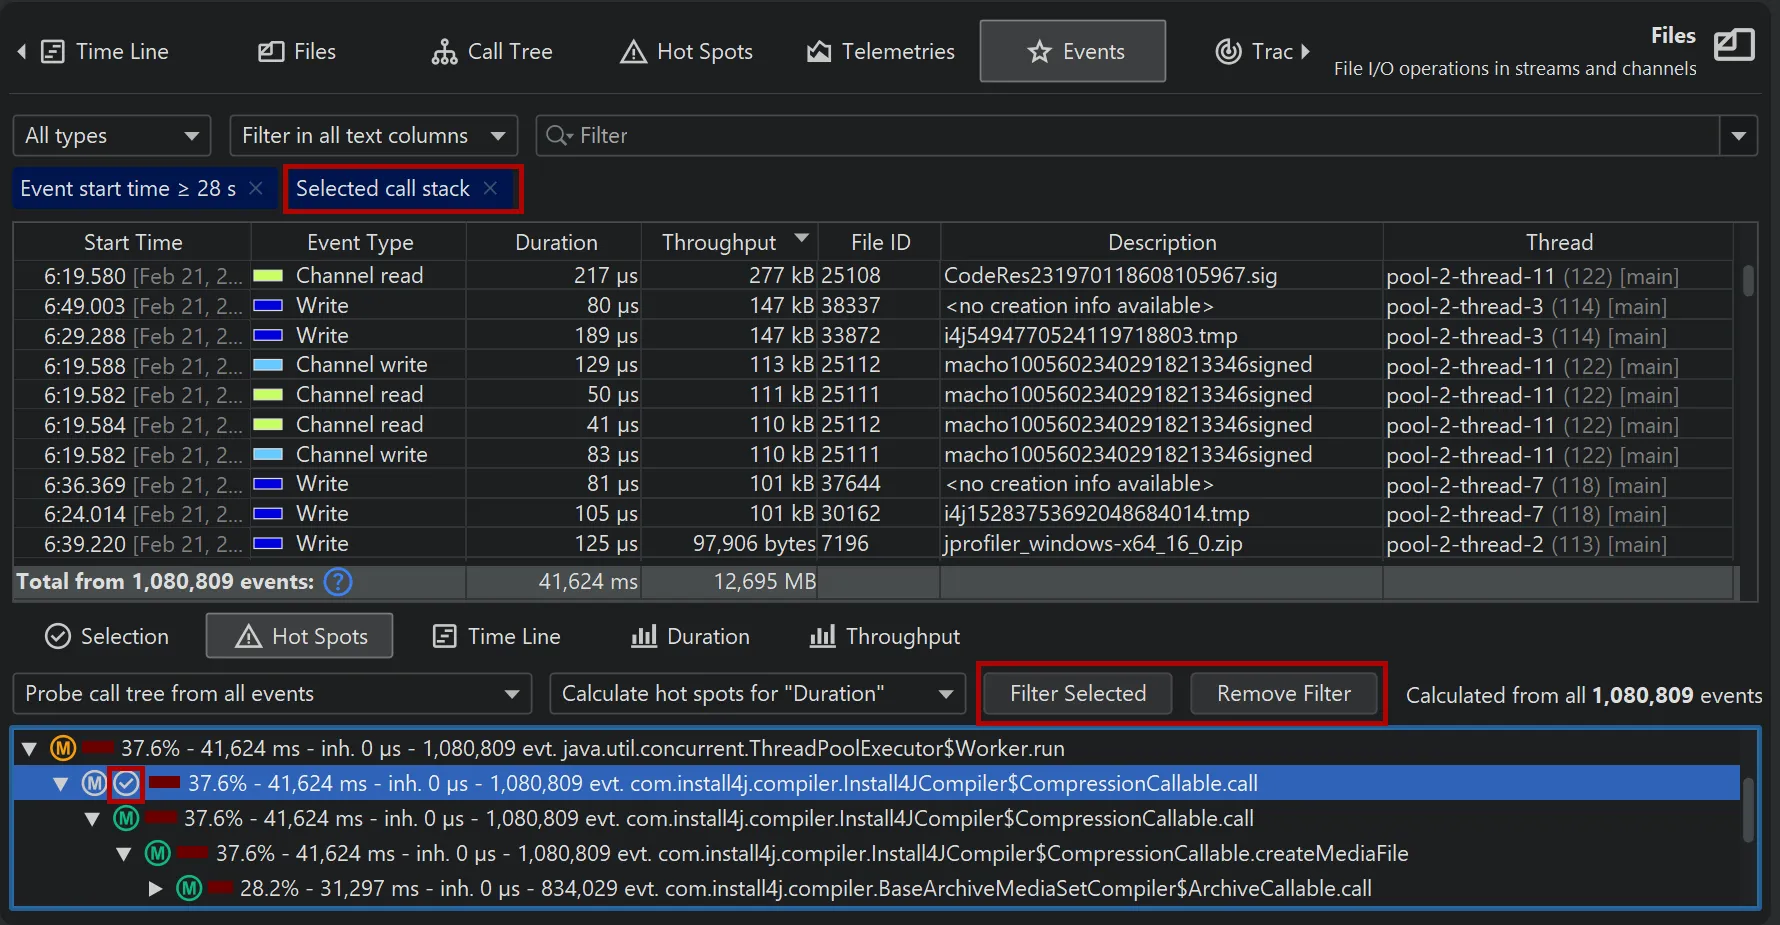
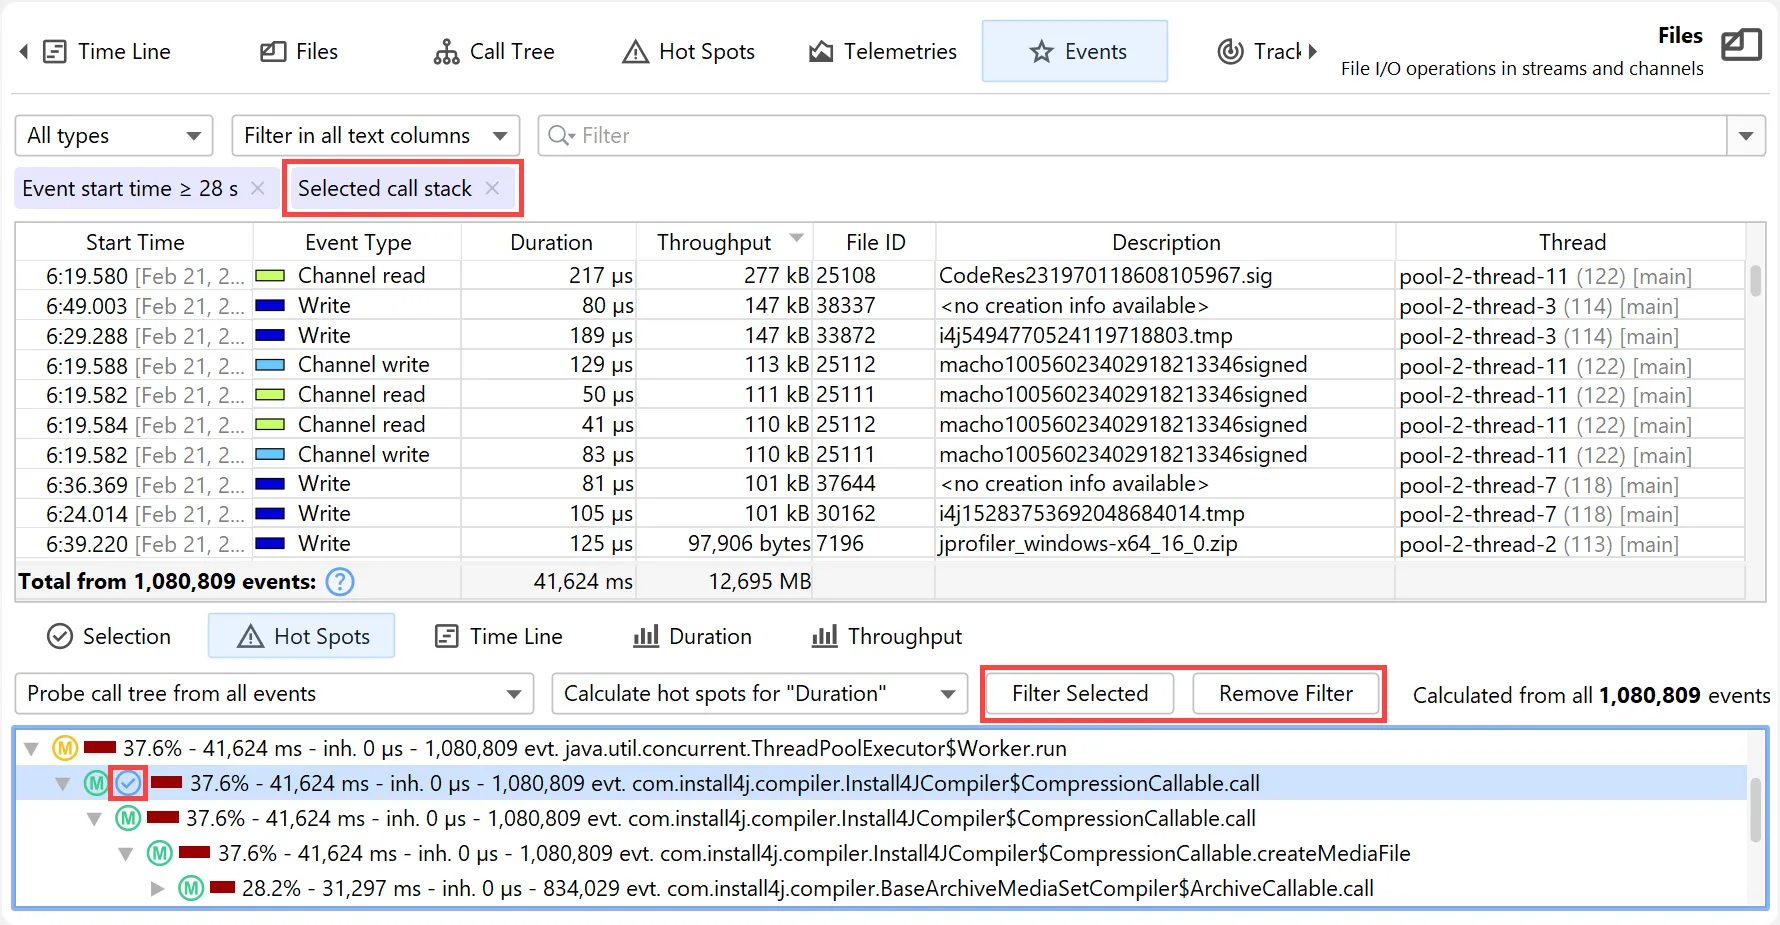
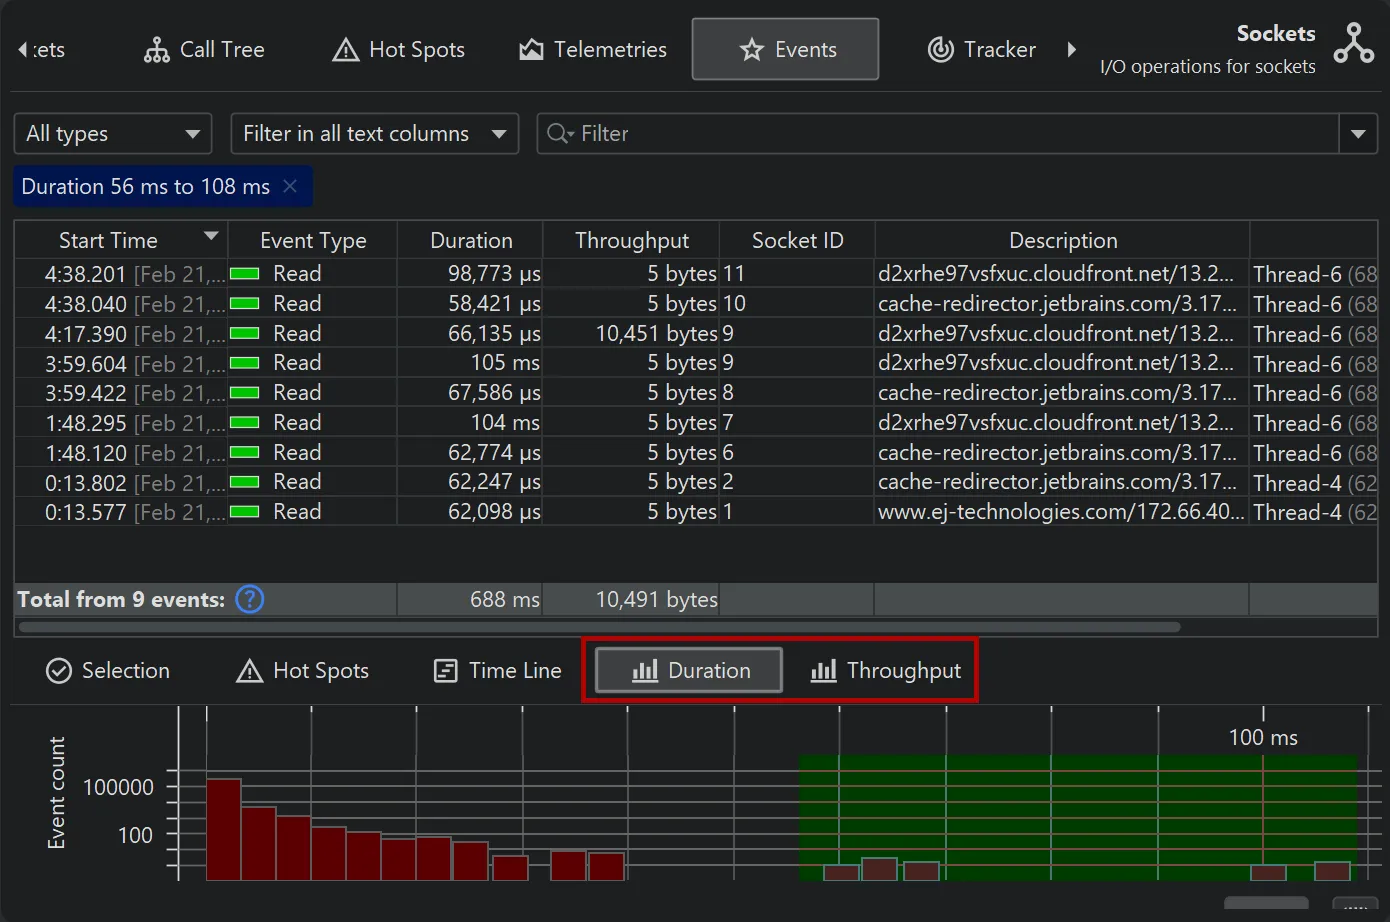
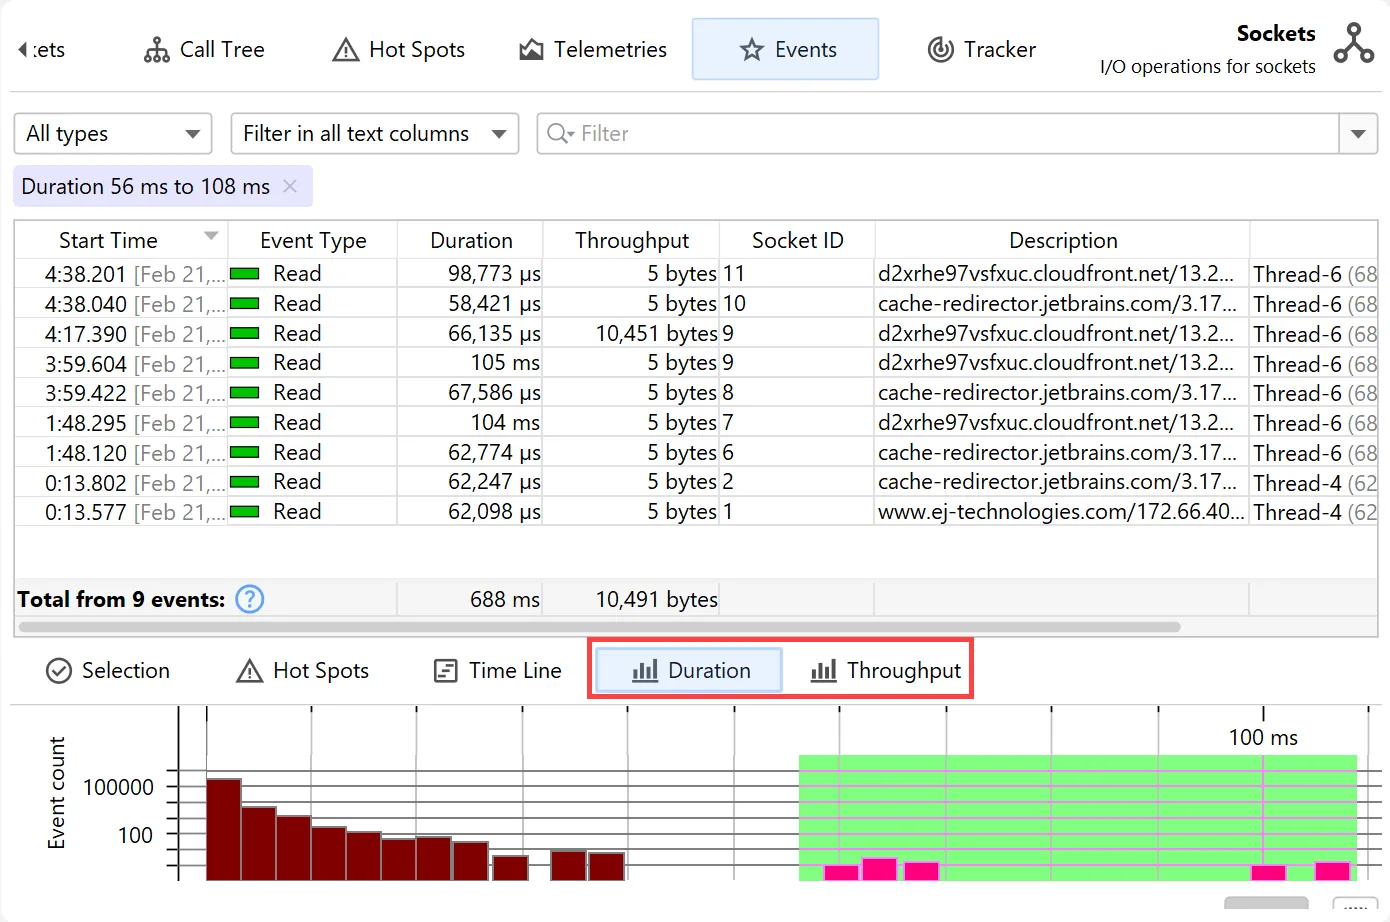
プローブが実行する測定に応じて、下部に追加のヒストグラムビューが表示されます。「ファイル」プローブと「ソケット」プローブの場合は「所要時間」と「スループット」です。
ヒストグラムは対数Y軸で表示できるほか、マウスで範囲をドラッグしてフィルタリングできます。
最後に、イベントビューにスマートな列管理を実装しました。すべての列の幅と利用可能なビューポートの幅に基づいて、JProfilerは列をビューポートに収めるか、水平スクロールを有効にするかを判断します。列を手動でリサイズすると「ビューポートに合わせる」モードは無効になりますが、テーブルの合計幅がビューポートより小さくなると自動的に再有効化されます。
プローブがイベント時間以外の測定も行っている場合、プローブコールツリービューとプローブホットスポットビューにメトリクスセレクタが表示されるようになりました。例えば、「ファイル」プローブと「ソケット」プローブでは「読み取りスループット」と「書き込みスループット」も選択できます。スループットメトリクスを選択すると、ビューは自動的に「読み取り」または「書き込み」イベントに絞られます。
メトリクスを変更すると、ホットスポットが再計算され、プローブコールツリー内のホットパスが更新されます。
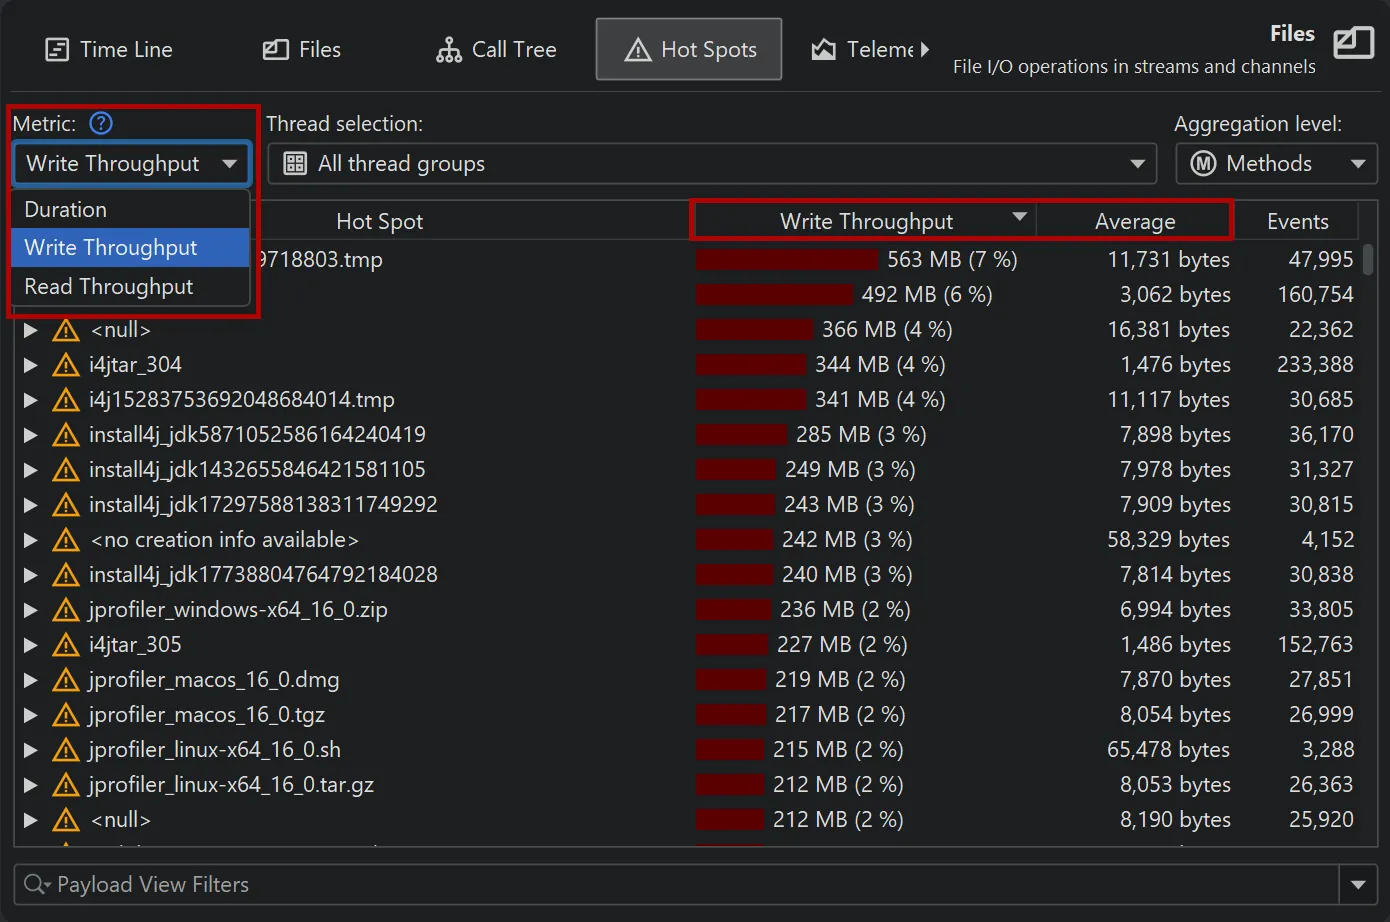
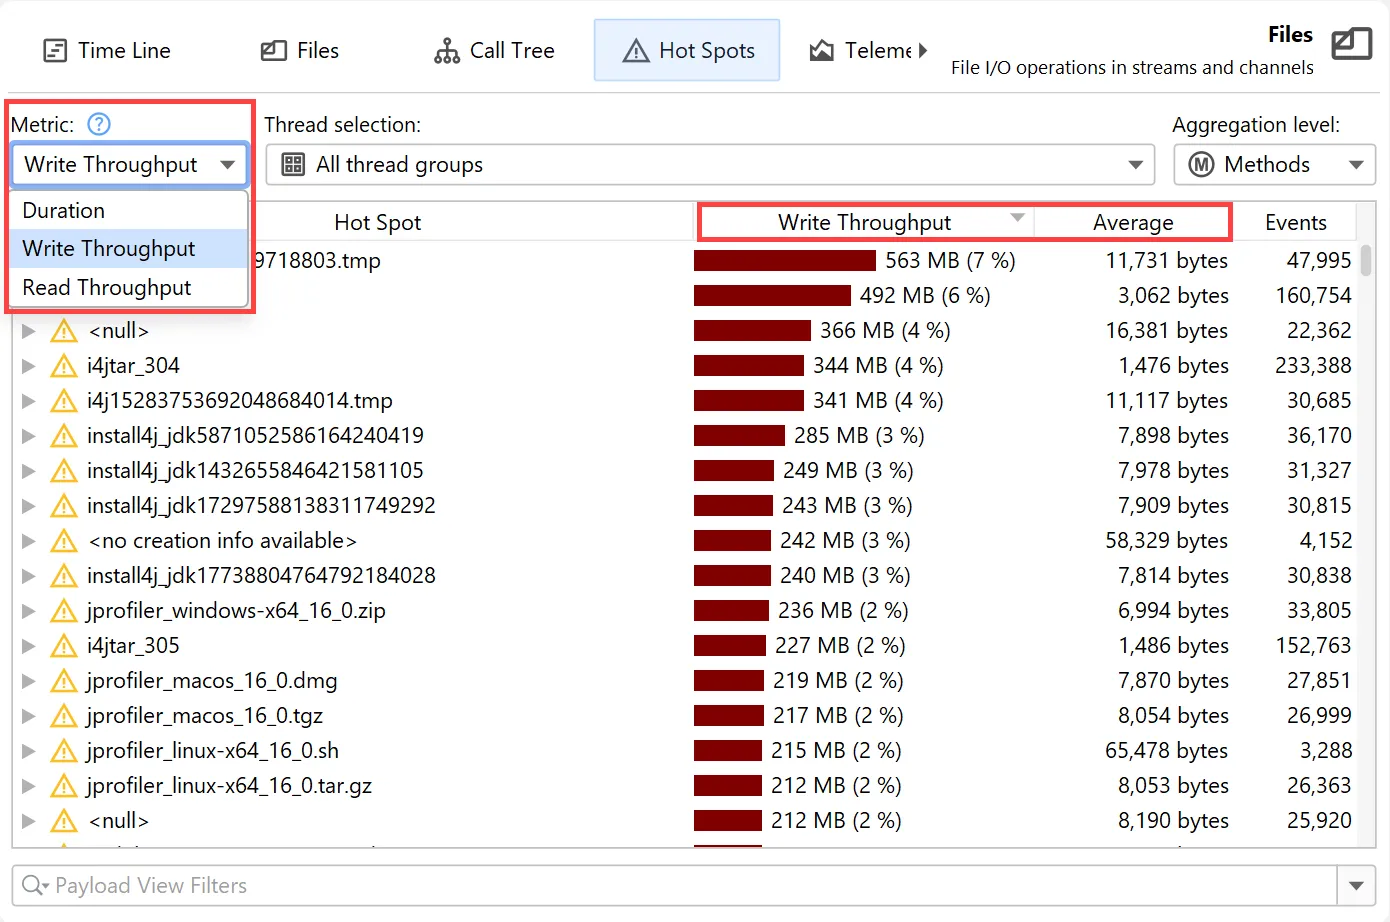
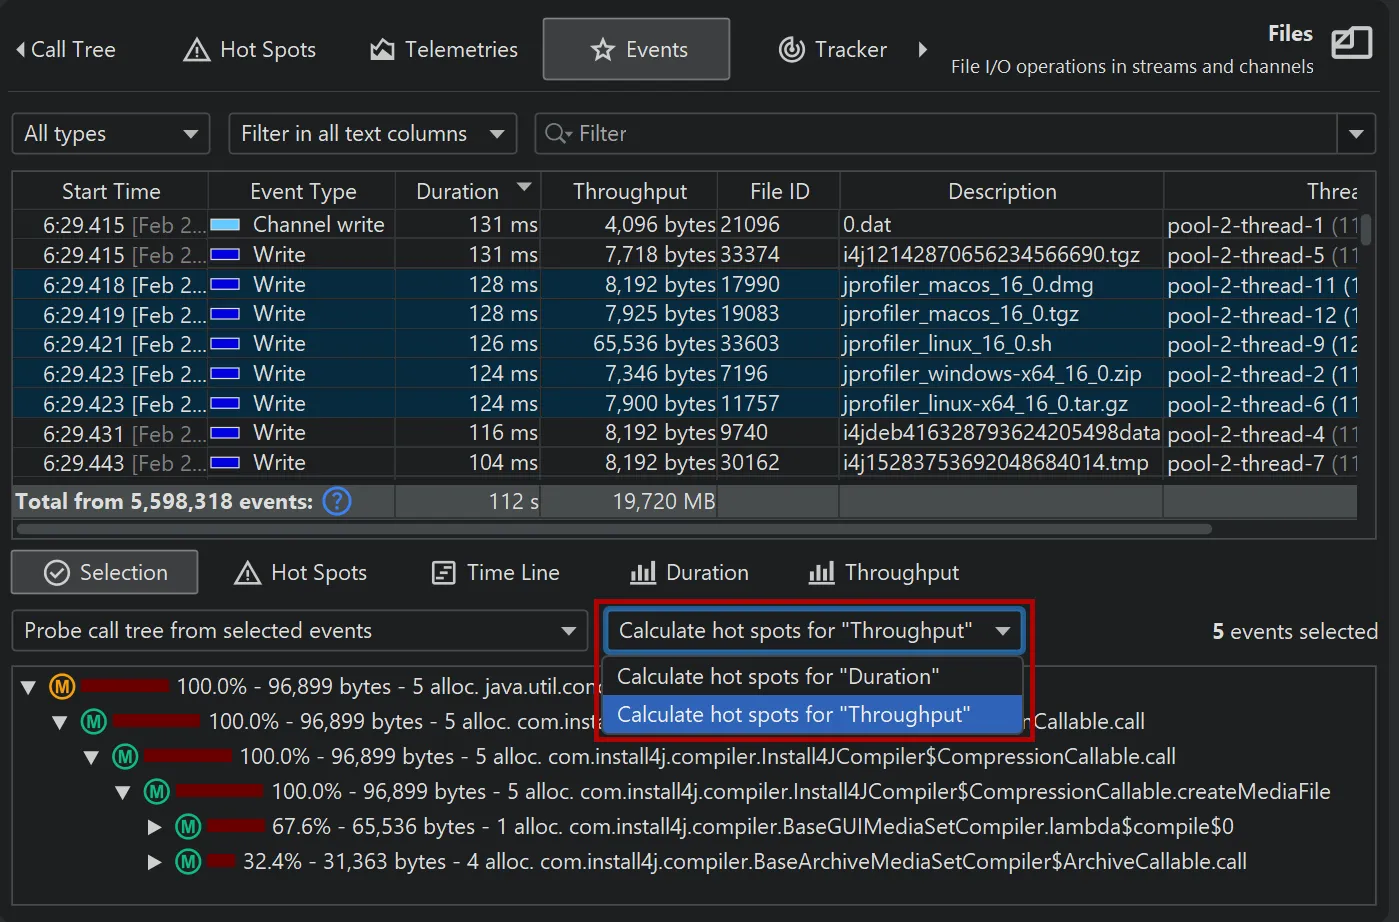
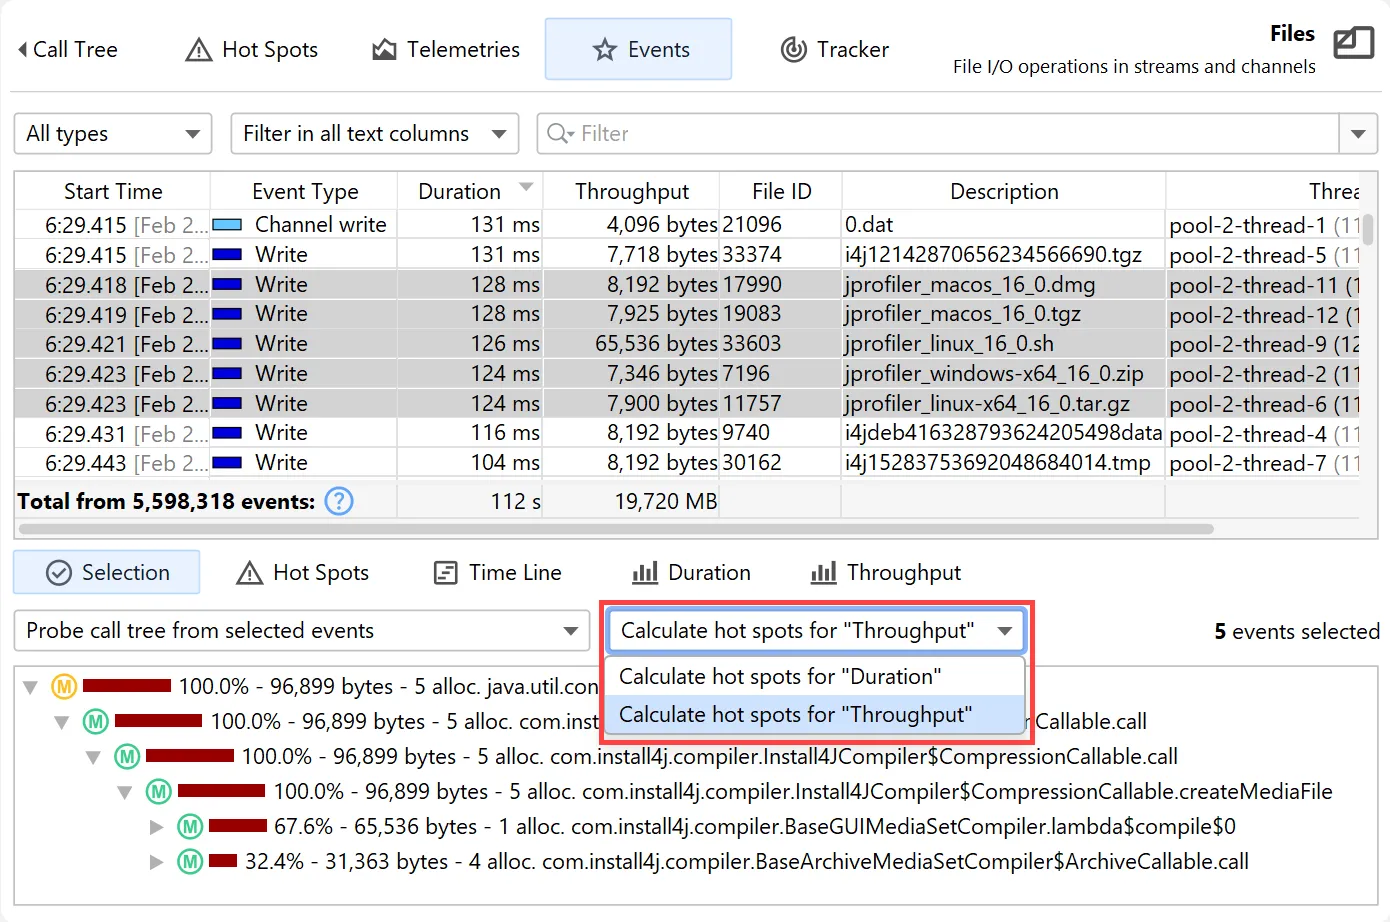
メトリクスセレクタは、プローブイベントビューの「選択」タブと「ホットスポット」タブでも利用できるようになりました。イベントビューでは「読み取り」イベントと「書き込み」イベントを個別にフィルタできるため、ここでは1つに統合された「スループット」測定のみが提供されます。
JProfiler 16では、JFRサポートに多くの改良を加えました。
- 下部ビューのデータを事前計算することで、イベント数が多い場合のイベントブラウザの応答性が向上しました。
- 以前のバージョンのJProfilerでは、イベントテーブルで扱えるイベント数に上限がありました。現在は、最下部までスクロールすることで追加のイベントを読み込めます。さらに、テーブルをソートする際には、表示中のサブセットだけでなくフィルタ済みの全イベントが対象になります。
- イベントテーブルの合計値も、現在表示されているイベントだけでなく、フィルタ済みの全イベントを対象に計算されるようになりました。
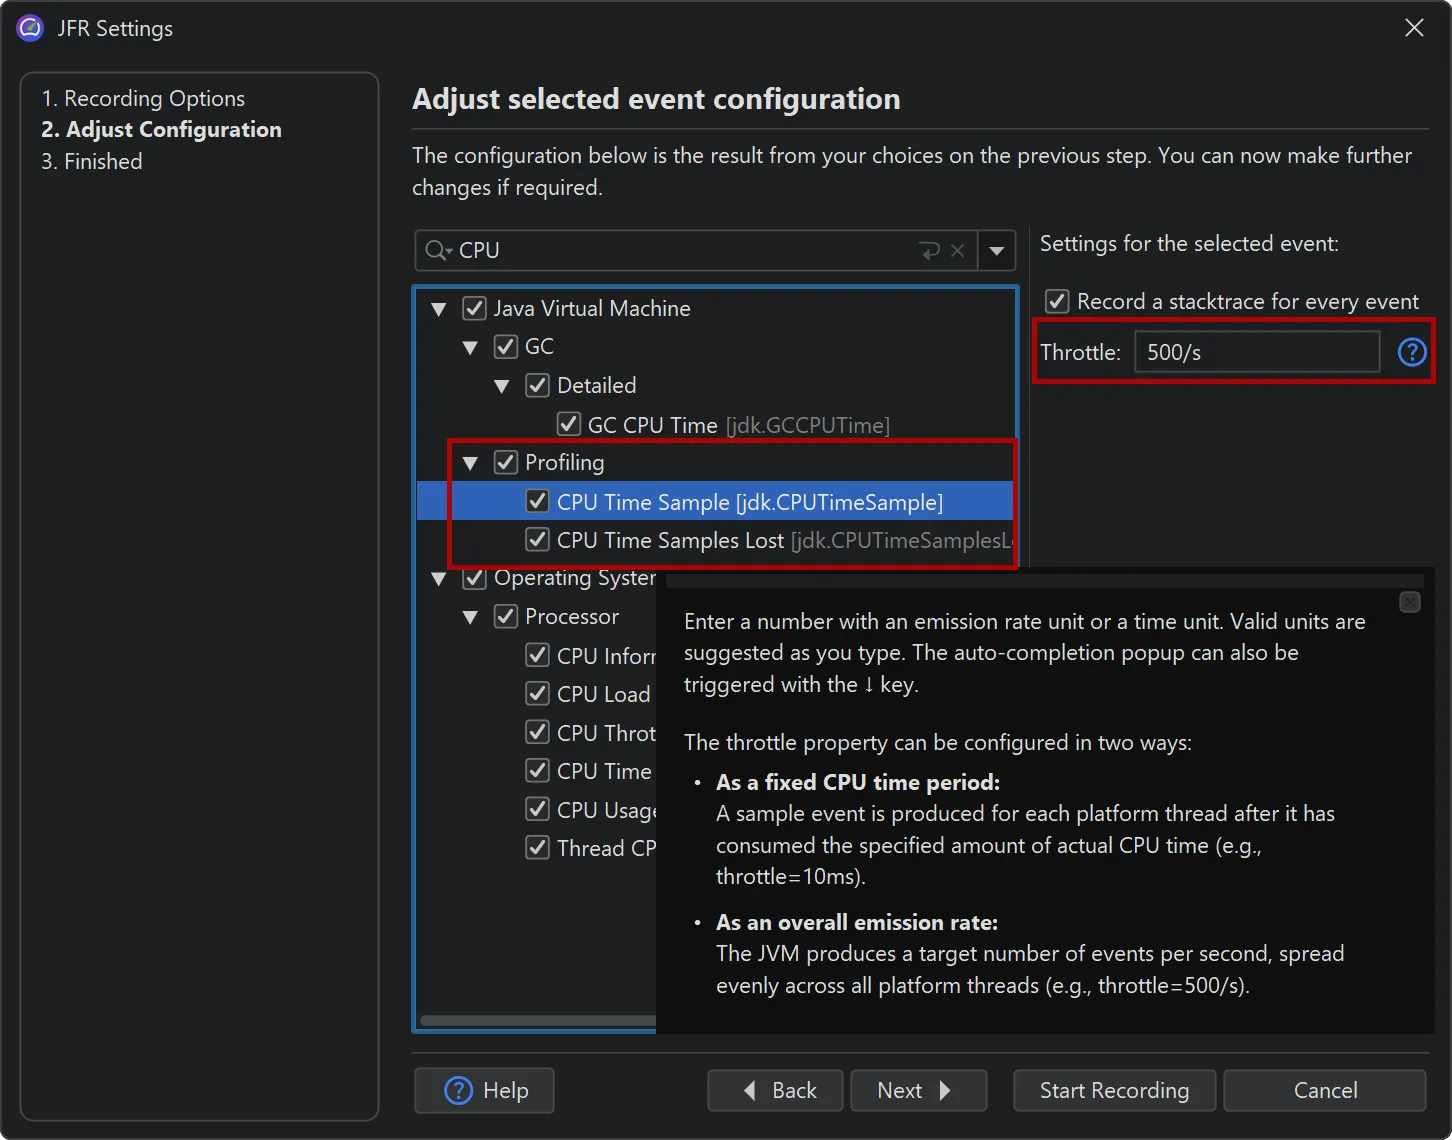
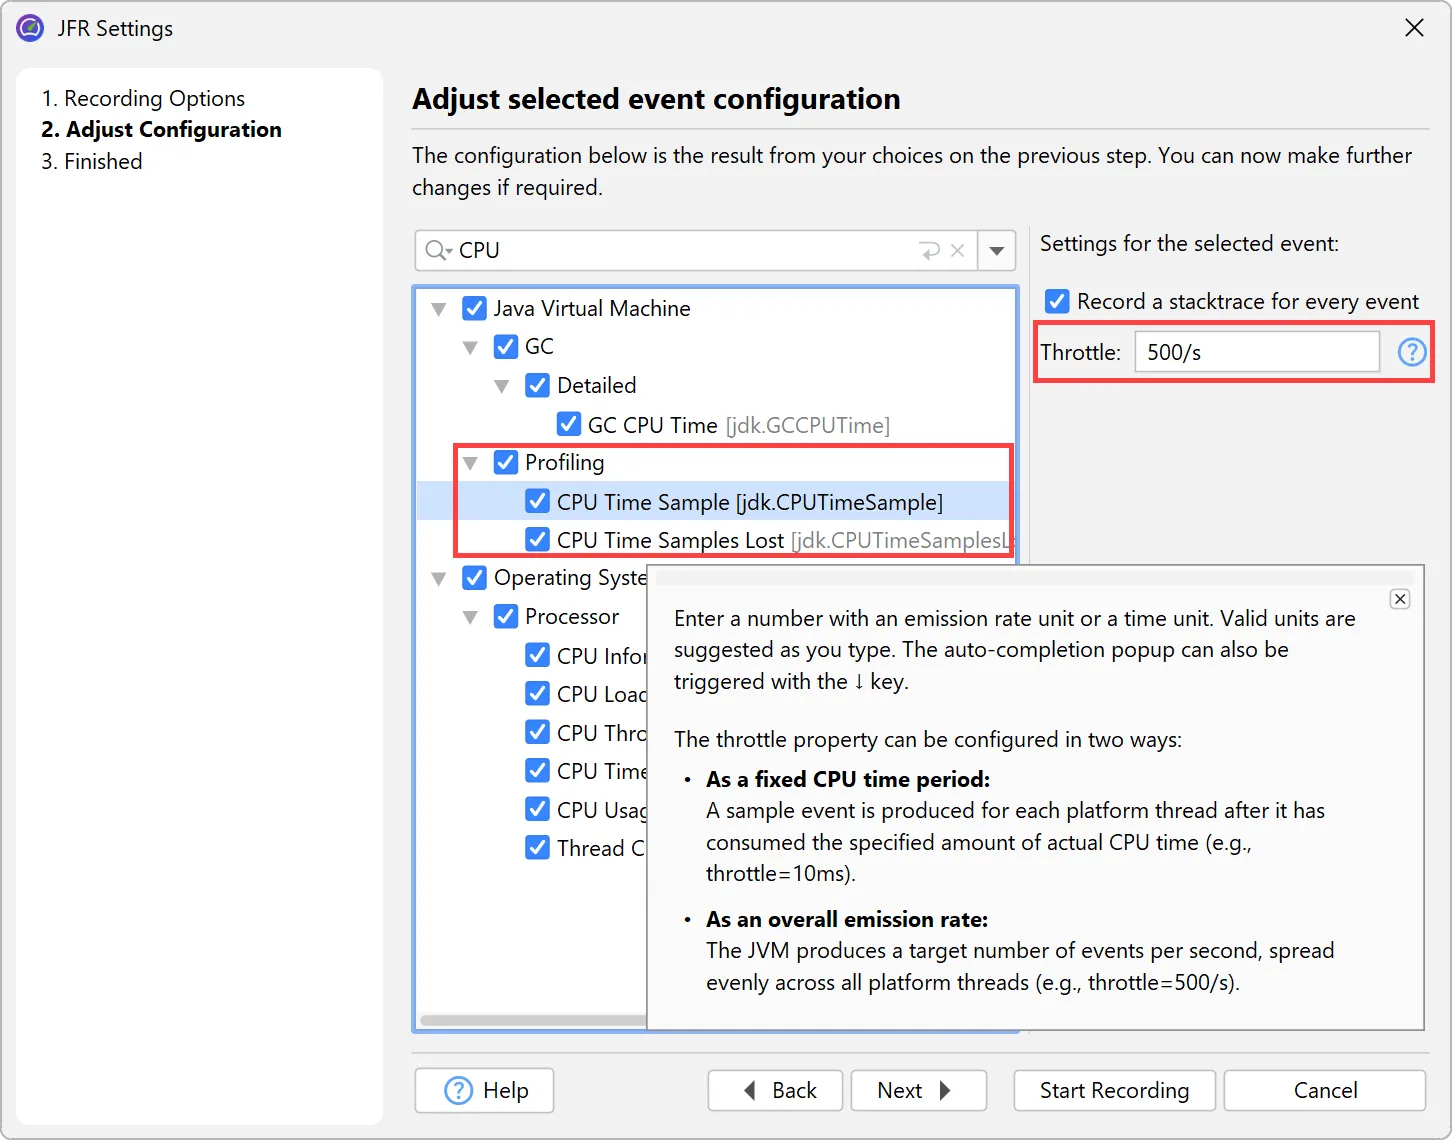
JFR記録ウィザードにスロットリング設定のサポートが追加されました。例えば、Java 25の新しいjdk.CPUTimeSampleイベントは、スロットリングによって設定されます。あるいは、期間または/s単位のエミッションレートを入力することもできます。
スロットリング設定は、CPUビューのスレッド状態セレクタの隣にも表示されます。
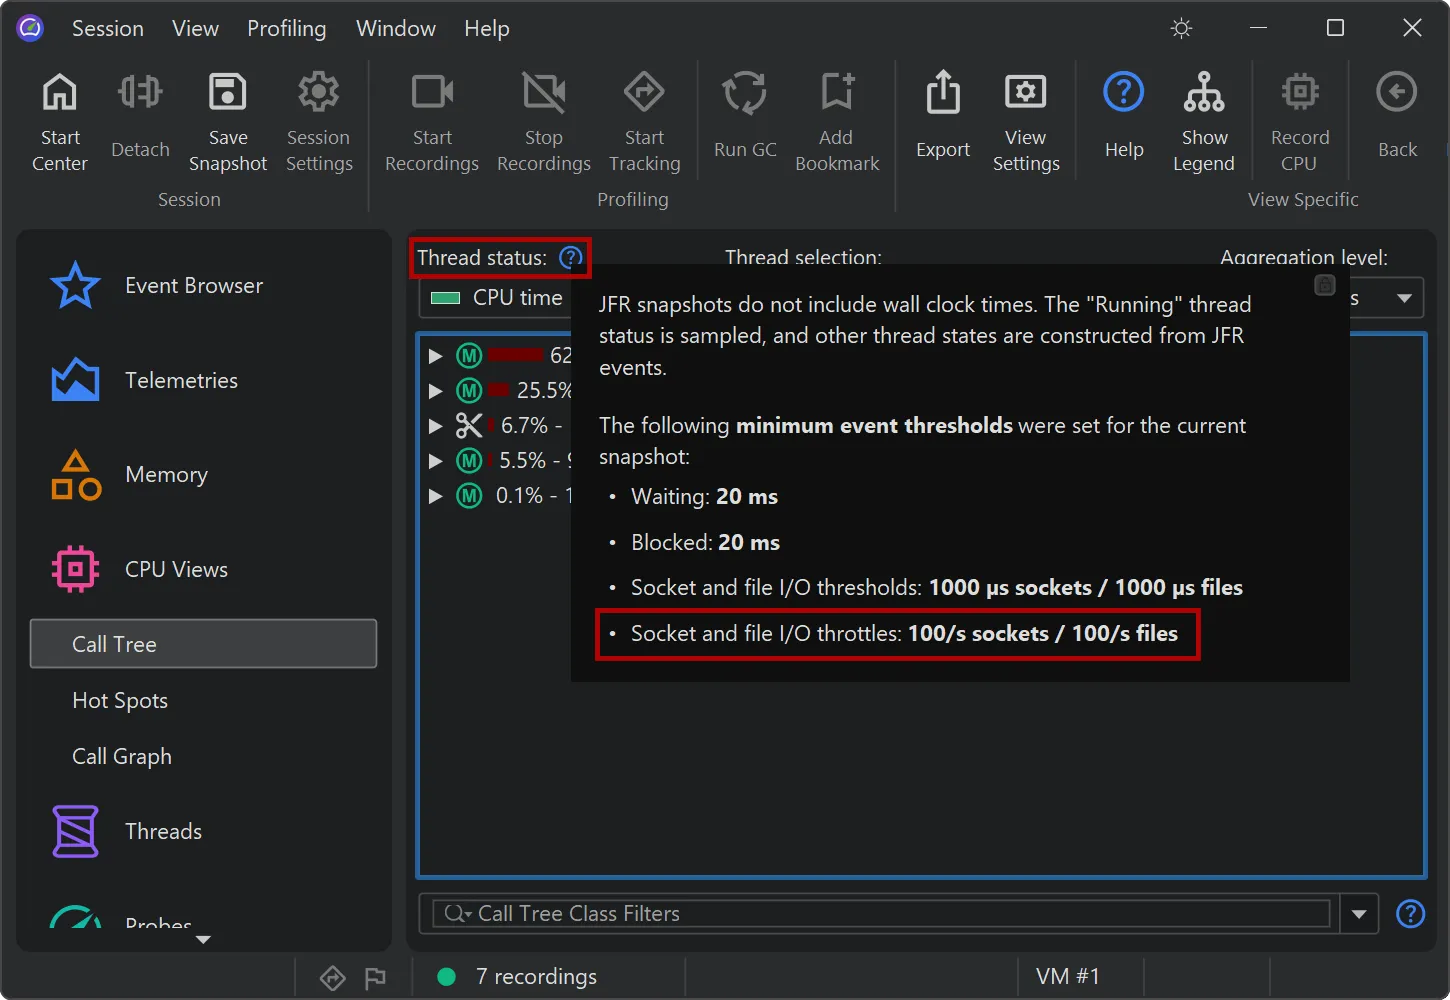
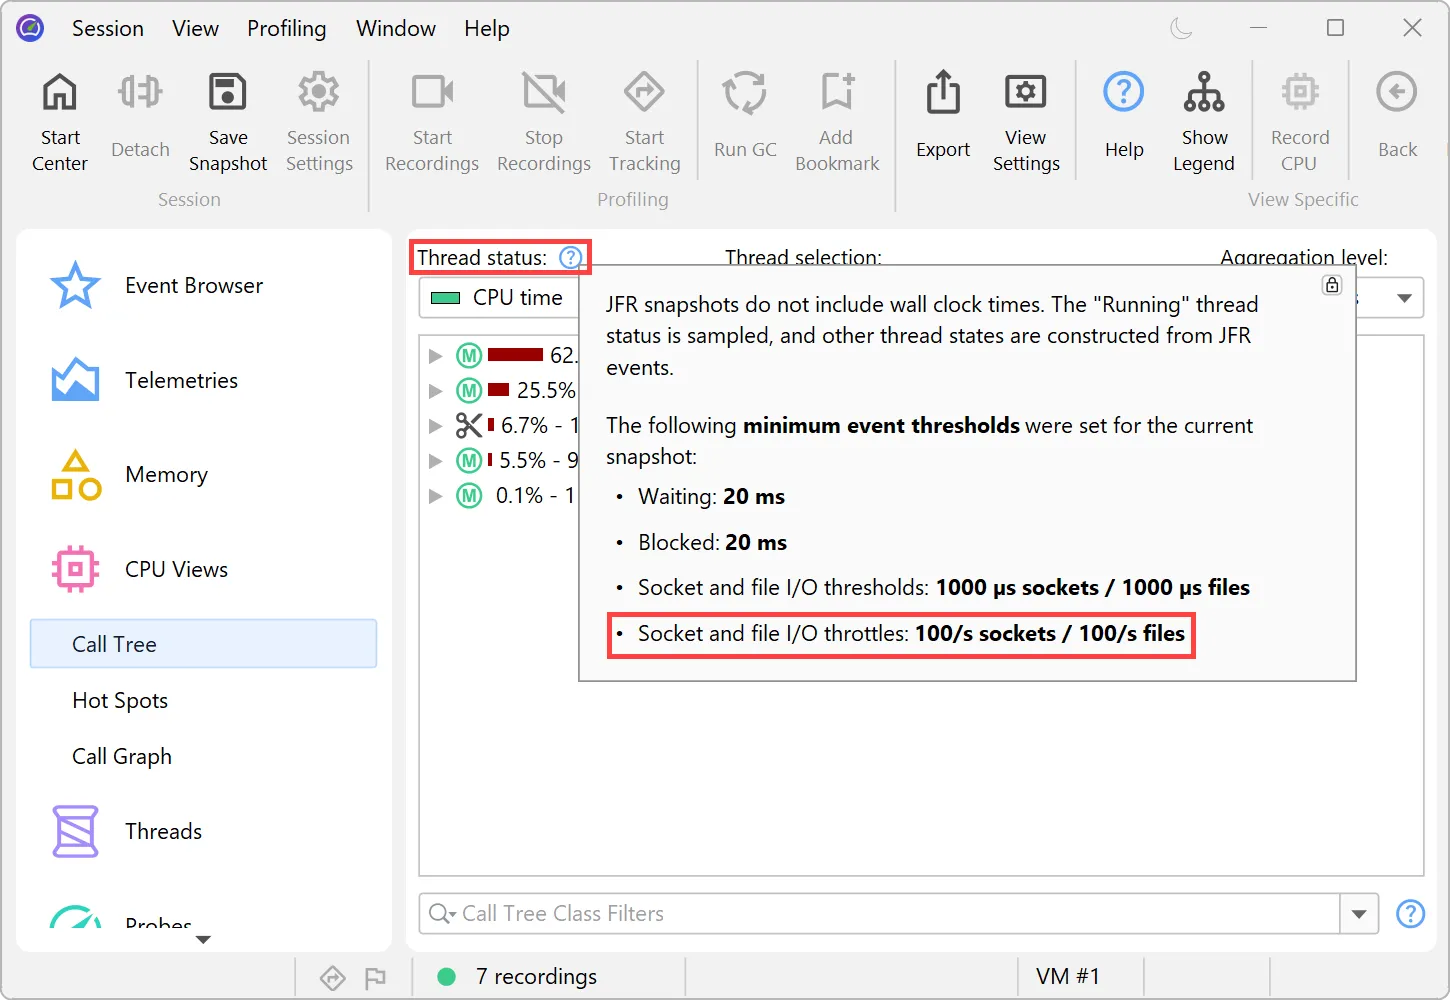
CPUセクションのデータの計算では、古いjdk.ExecutionSampleイベントの代わりに、記録されている場合はLinux専用の新しいjdk.CPUTimeSampleイベント(Java 25以降)が使用されるようになりました。jdk.ExecutionSampleはすべてのプラットフォームで動作しますが、サンプリング対象のスレッド数とCPU使用率の精度に制限があります。それとは異なり、jdk.CPUTimeSampleはLinuxカーネルからのCPU時間イベントを使用してデータを収集します。
このイベントにより、JVMTIエージェントのロードが許可されていない本番システムでも、JFRによるCPUプロファイリングが実用的なCPUメトリクスを提供できるようになりました。
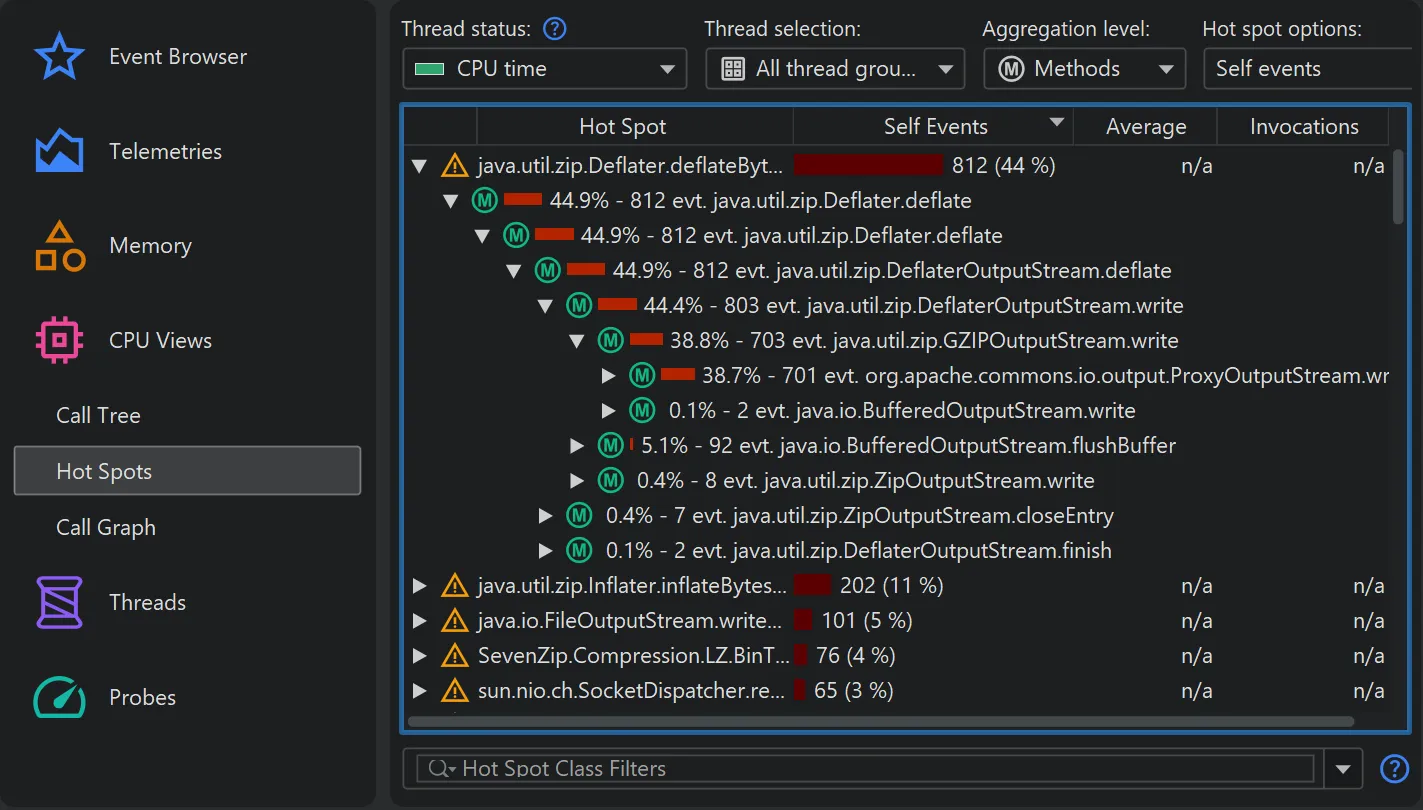
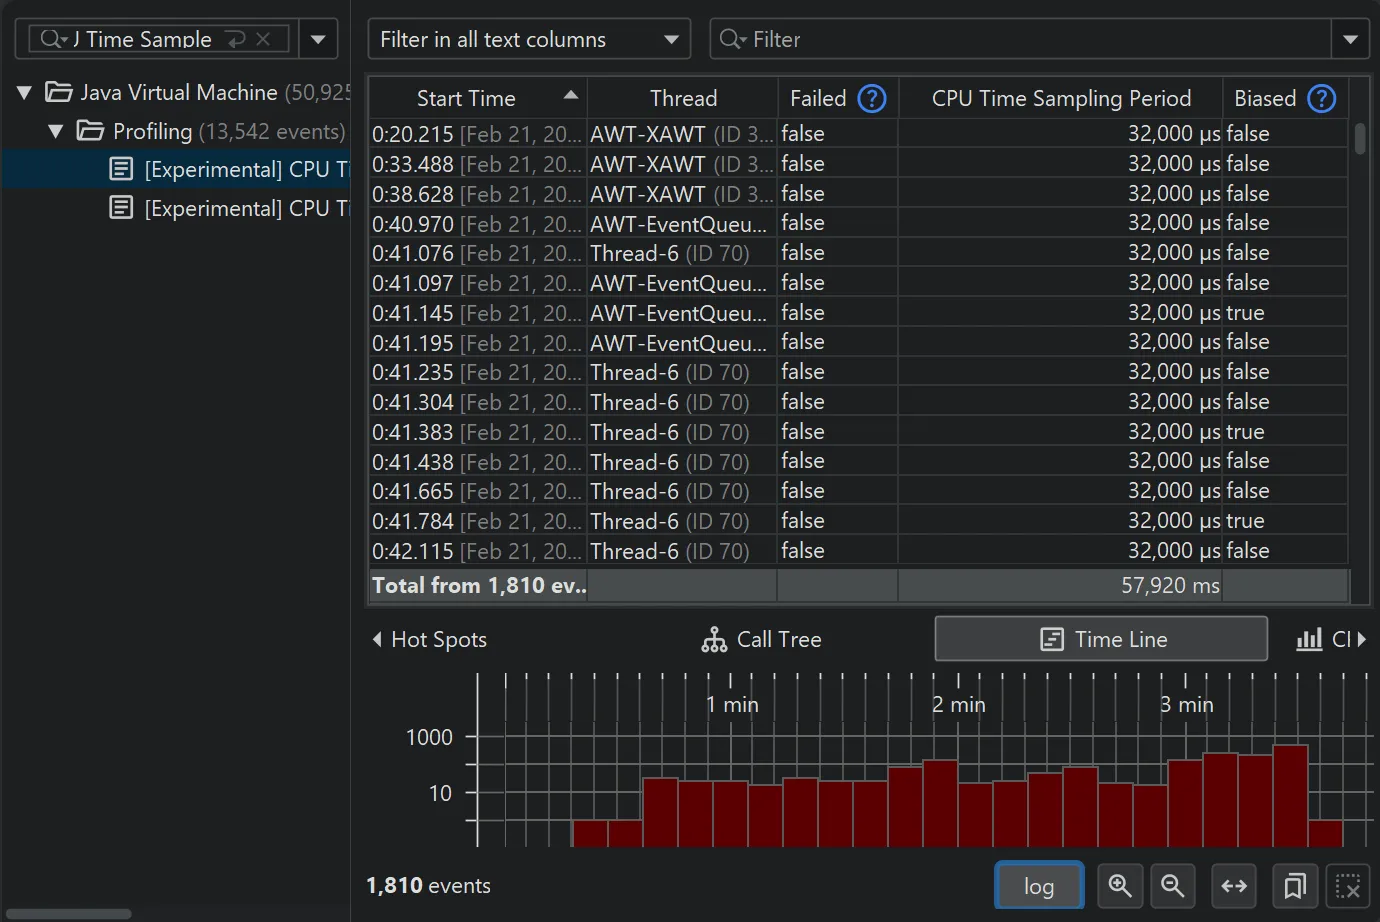
JProfiler 16以降では、すべての実験的なJFRイベントがイベントブラウザに表示されるようになりました。例えば、jdk.CPUTimeSampleイベントなどです。
JProfiler 16では、仮想スレッドダンプのサポートを導入しました。
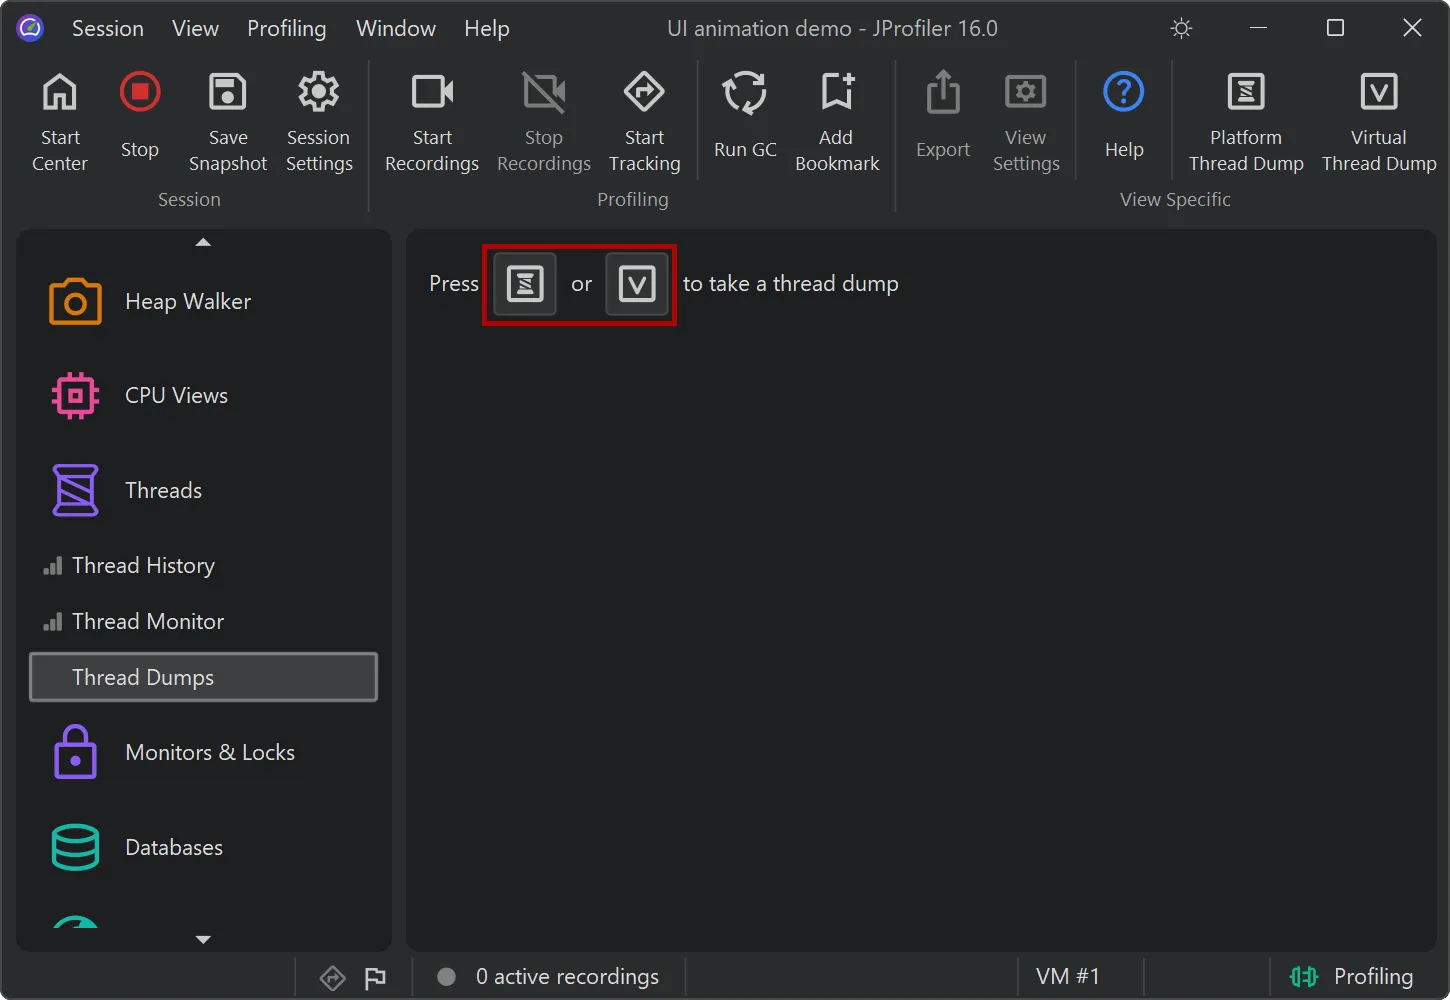
スレッドダンプビューには、プラットフォームスレッドダンプ用と仮想スレッドダンプ用の2つの異なるアクションが追加されています。
仮想スレッドダンプにもプラットフォームスレッドは含まれますが、これは非同期で実行されるため、仮想スレッドを使用していない場合は、同期的なプラットフォームスレッドダンプの方が適しています。
仮想スレッドは、スレッドコンテナ内で階層的に整理されています。これは、Java 25の時点でまだプレビュー機能である構造化並行性を使用する場合に重要です。
構造化並行性では、各スコープが対応するスレッドコンテナを作成します。ダンプには、深くネストされたコンテナ内の数百万の仮想スレッドが含まれる可能性があるため、仮想スレッドダンプはプラットフォームスレッドダンプよりも大幅に大きくなることがあります。
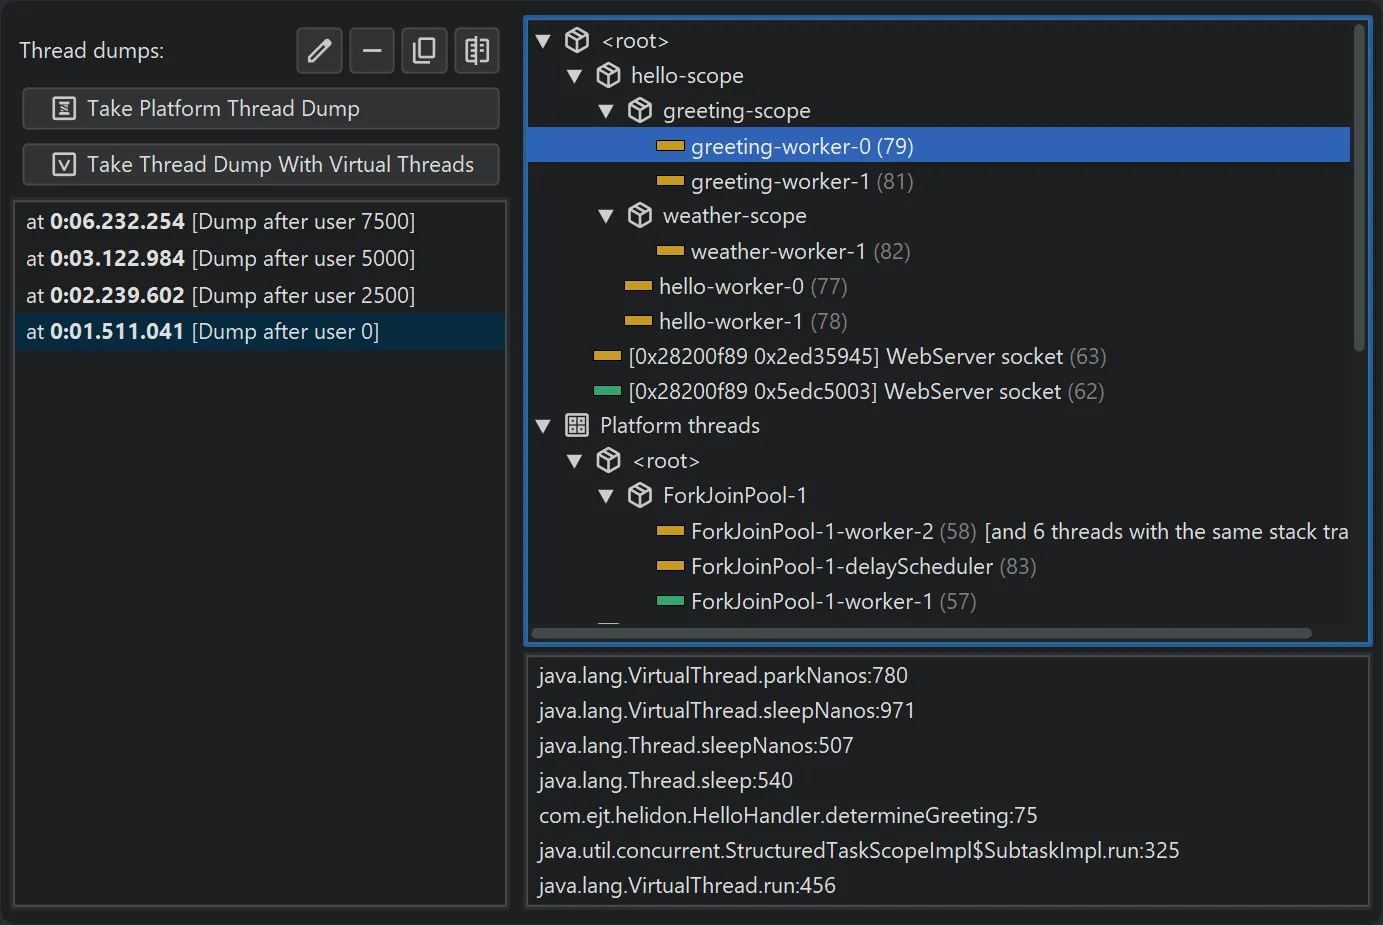
2つの個別の仮想スレッドまたは2つのスレッドダンプ全体を比較するには、それらを選択して、コンテキストメニューから比較アクションを選びます。
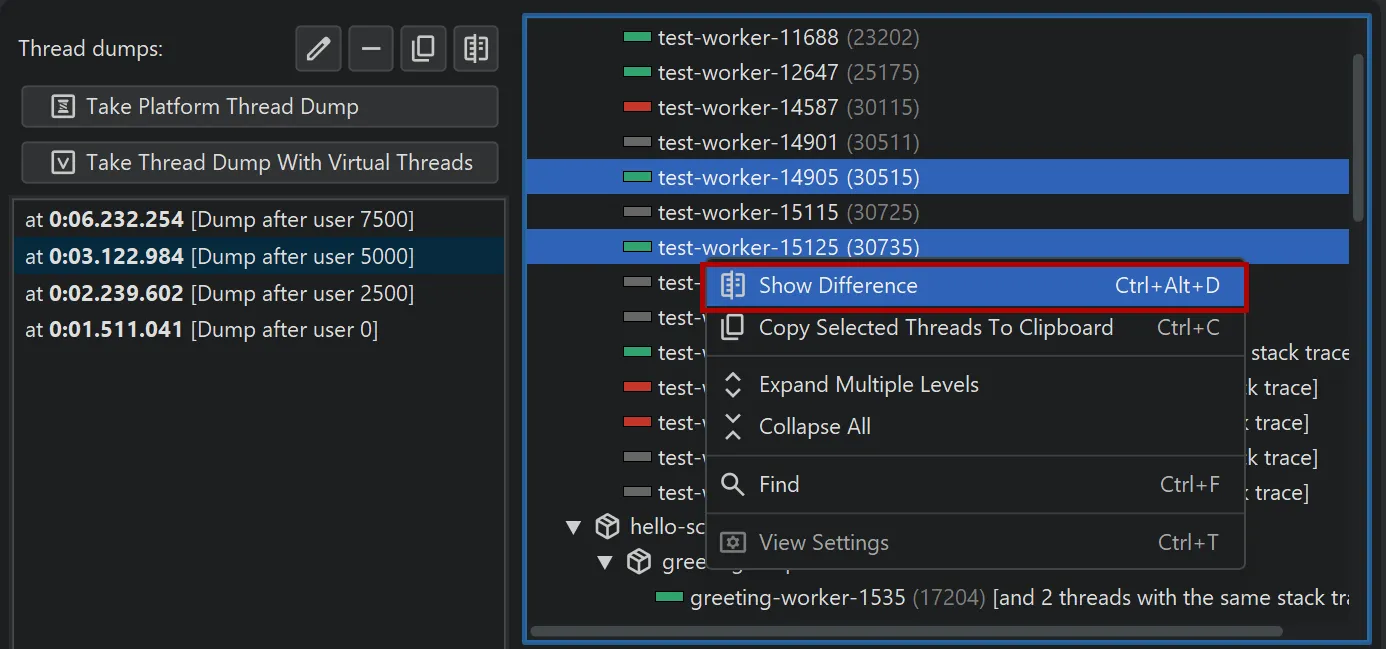
比較結果は、別のウィンドウの差分ビューアーに表示されます。
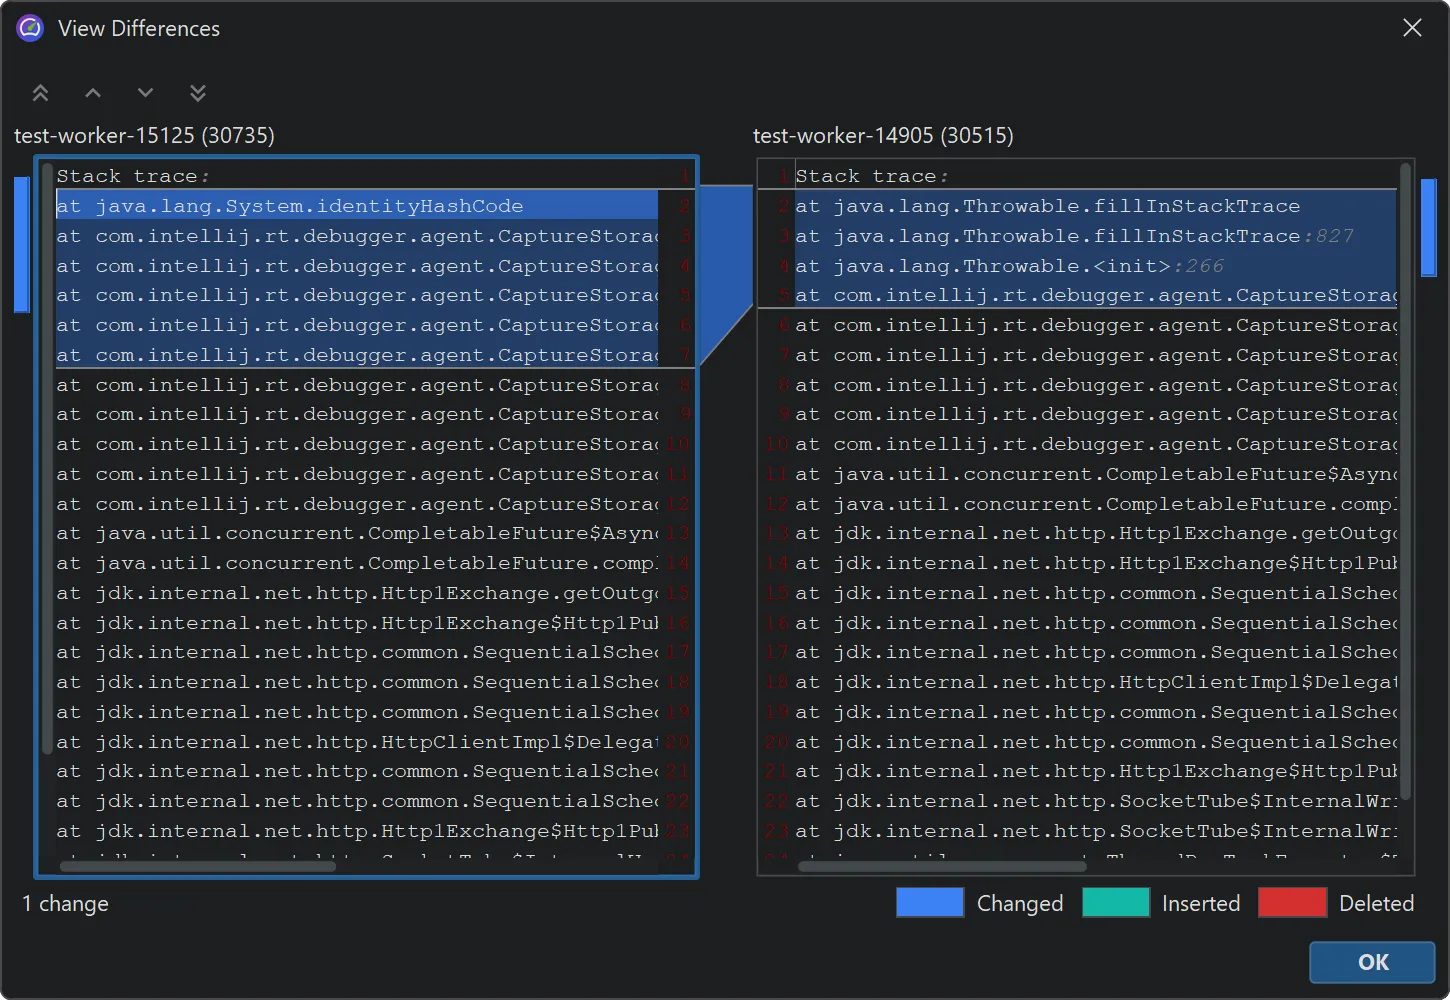
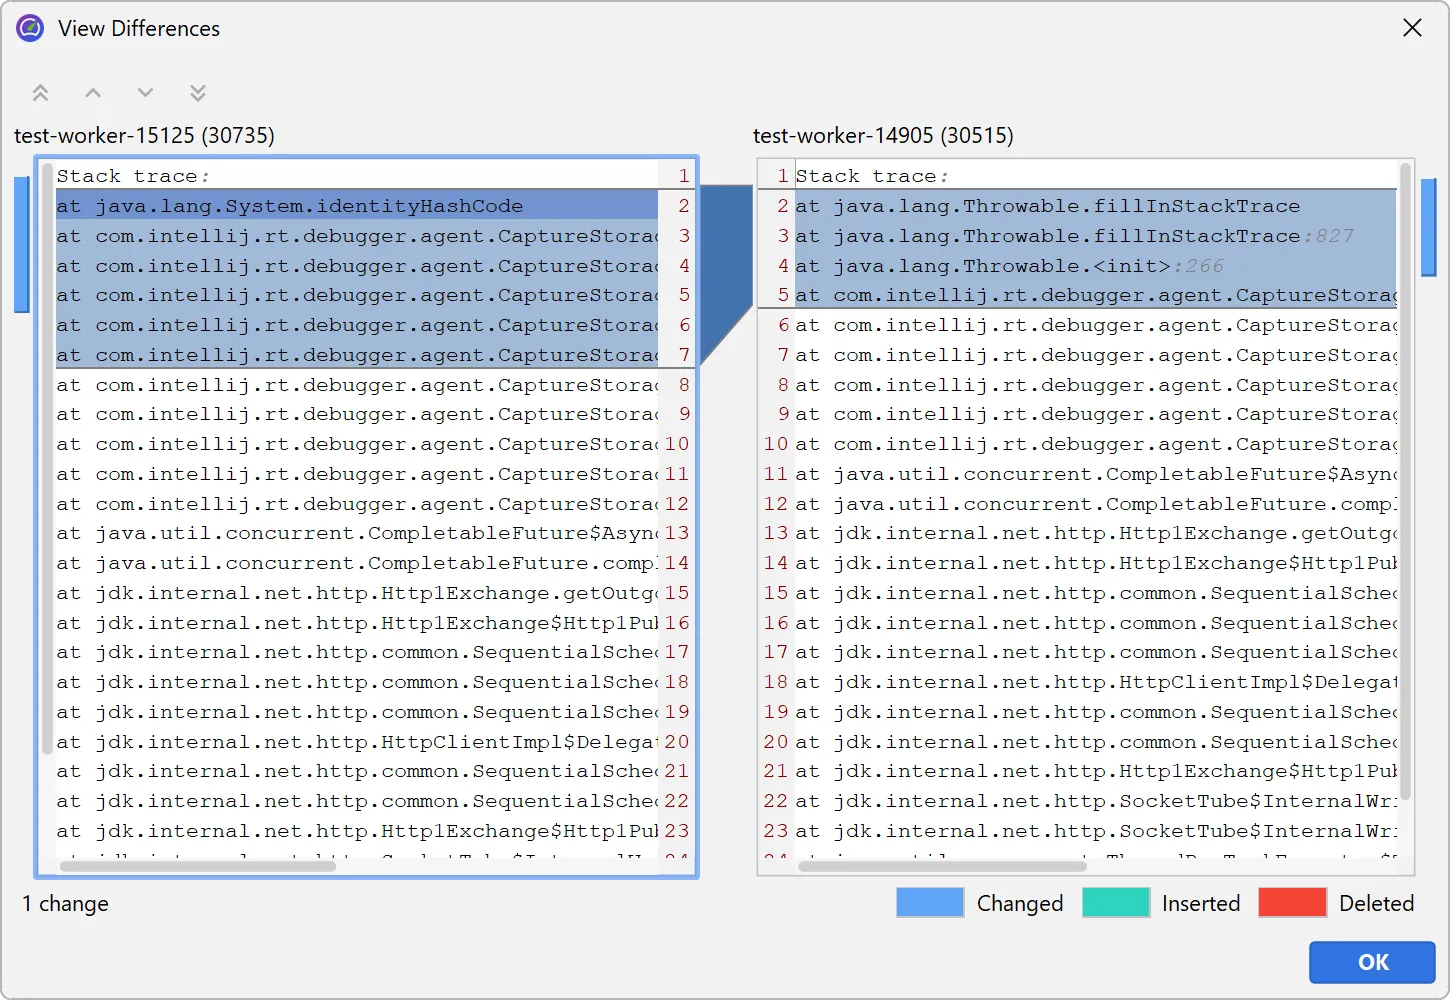
個別のスレッド、複数のスレッド、またはスレッドダンプ全体をクリップボードにコピーするには、コンテキストメニューの対応するアクションを使用します。
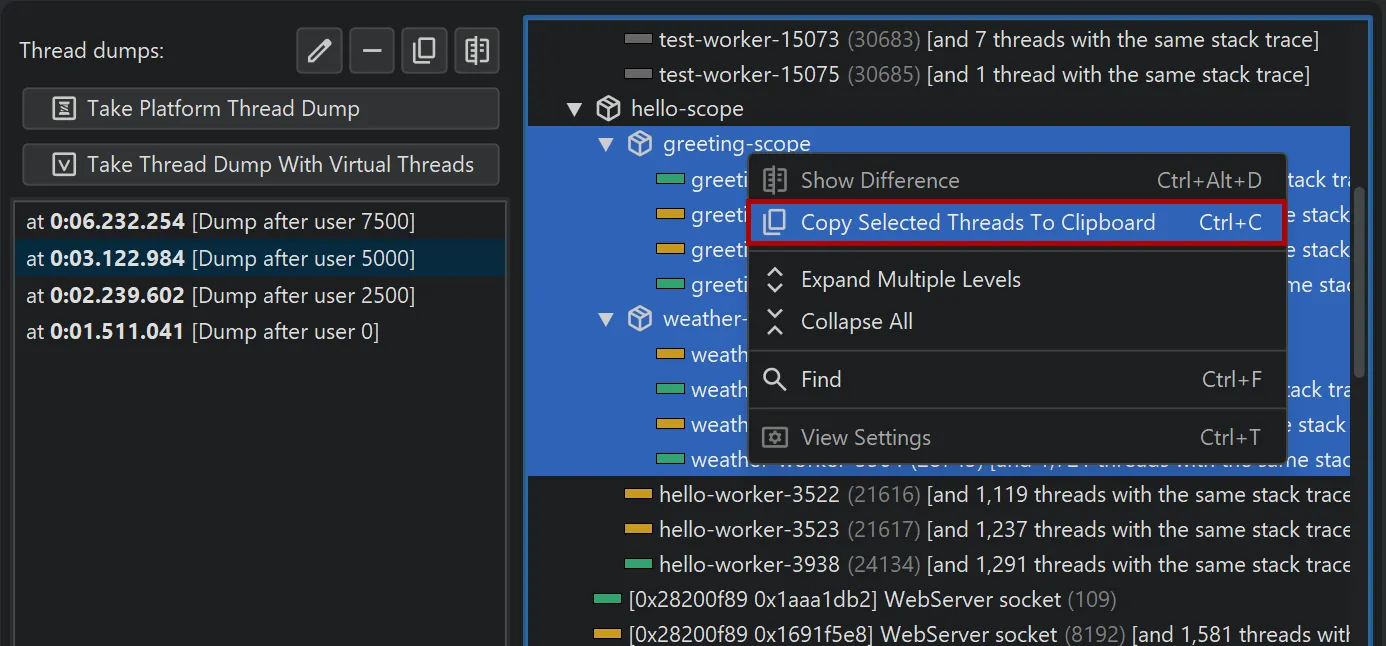
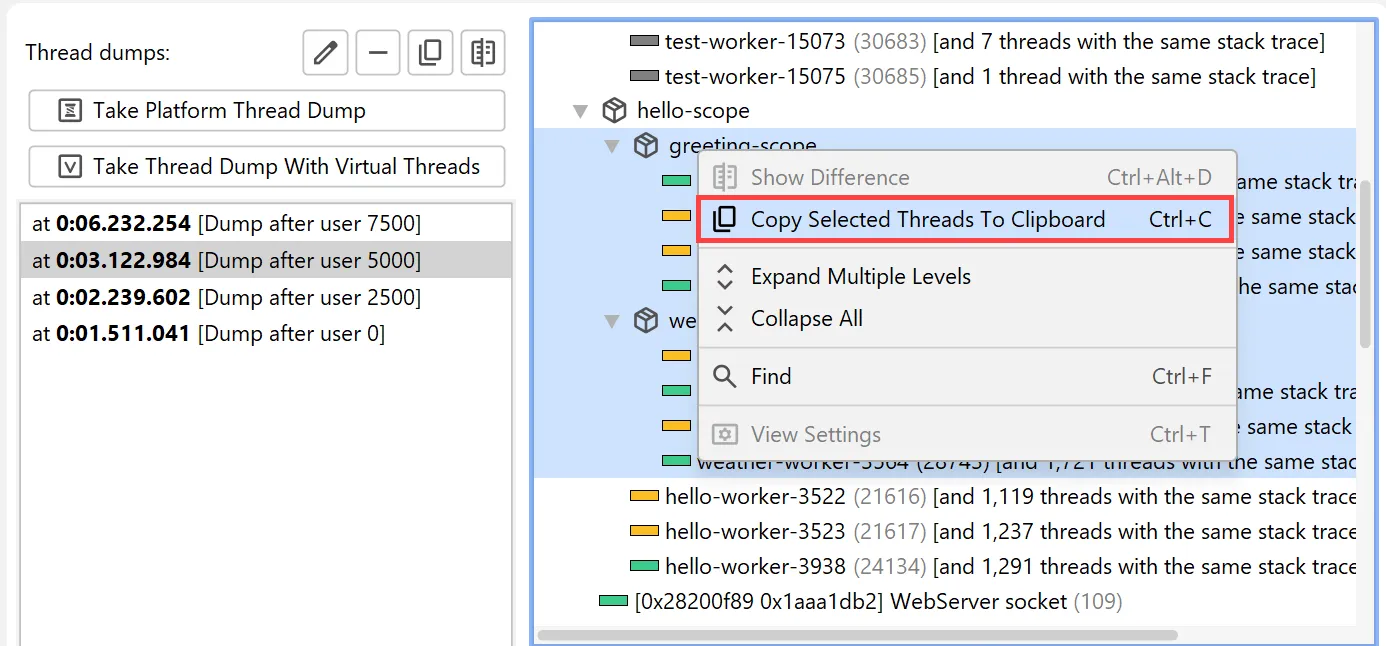
仮想スレッドダンプでは、同じ階層位置にある同一のスタックトレースを持つスレッドをグループ化して、1つのノードにまとめます。
コンテキストメニューには、グループ化されたすべてのスレッド名を表示するアクションが用意されています。
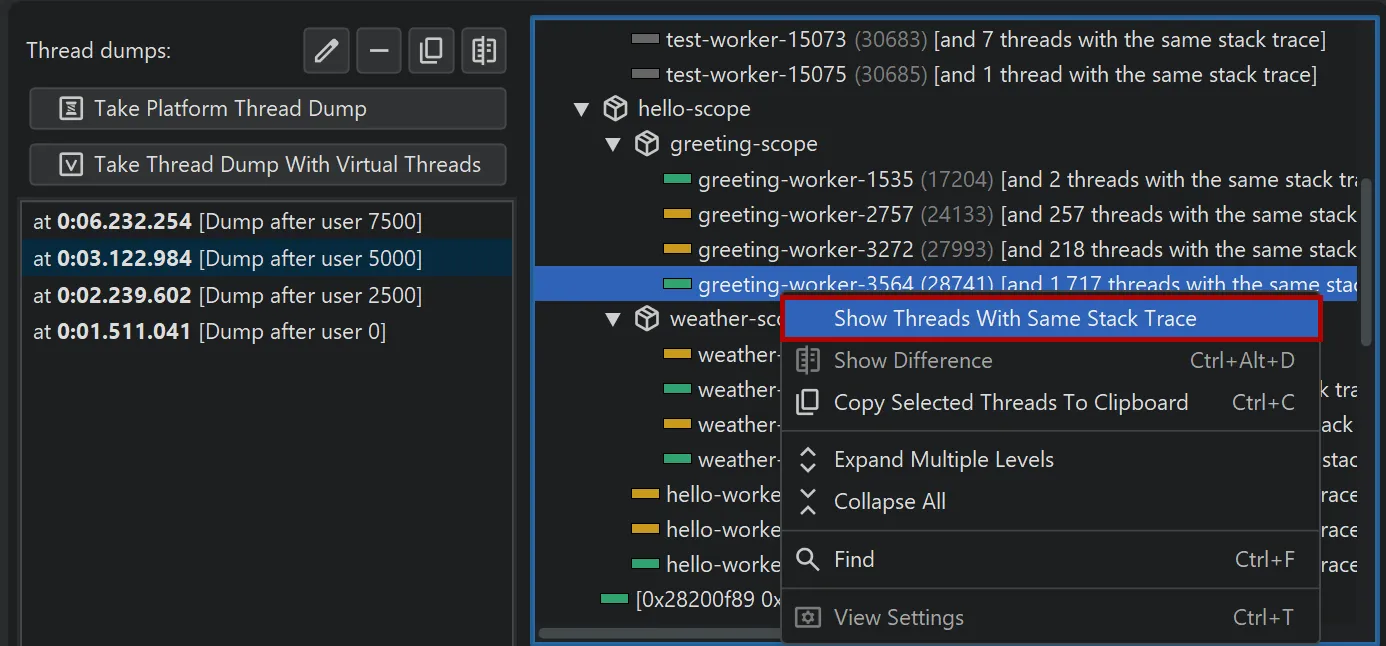
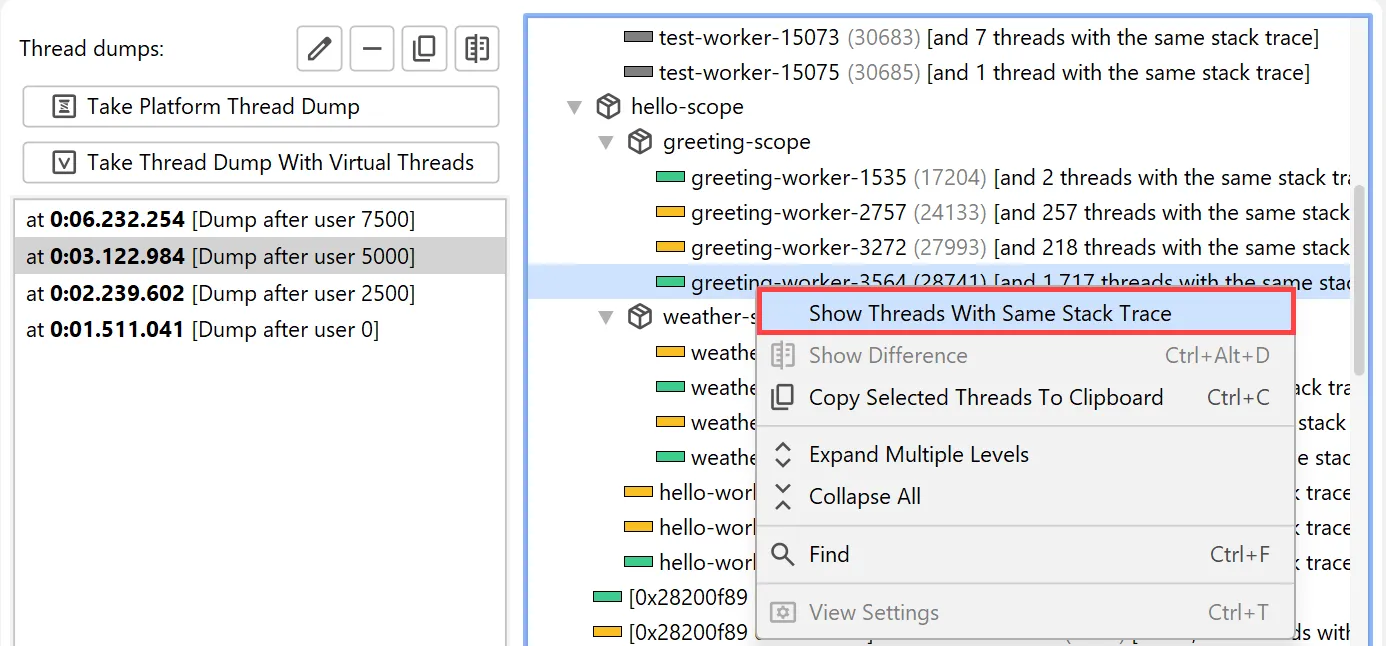
グループ化されたスレッドの名前は別のウィンドウに表示され、関心のあるスレッド名でフィルタできます。
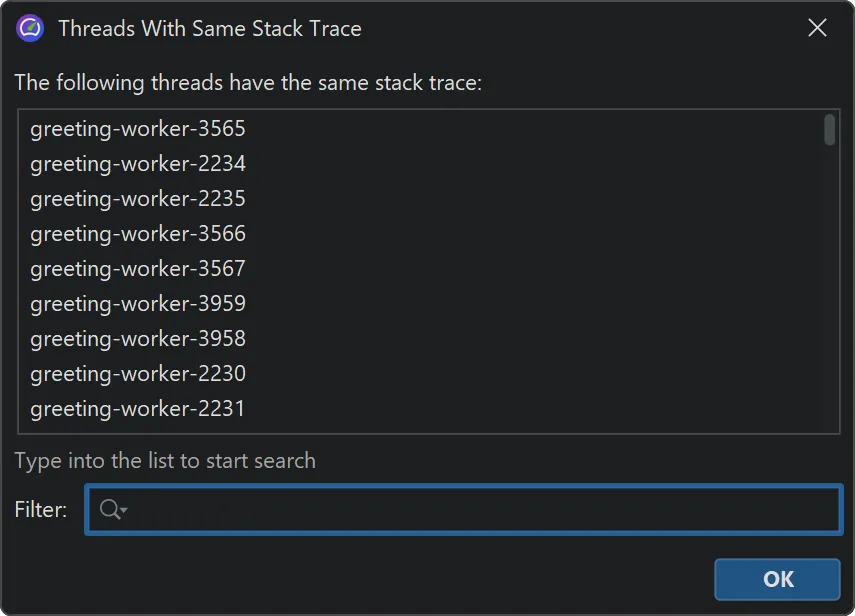
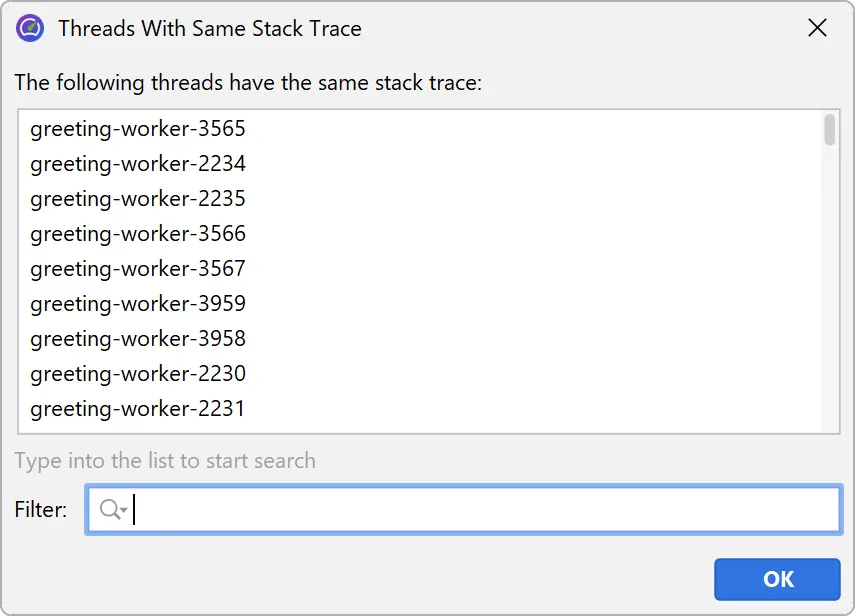
スレッドのグループ化は、プラットフォームスレッドダンプでもサポートされています。
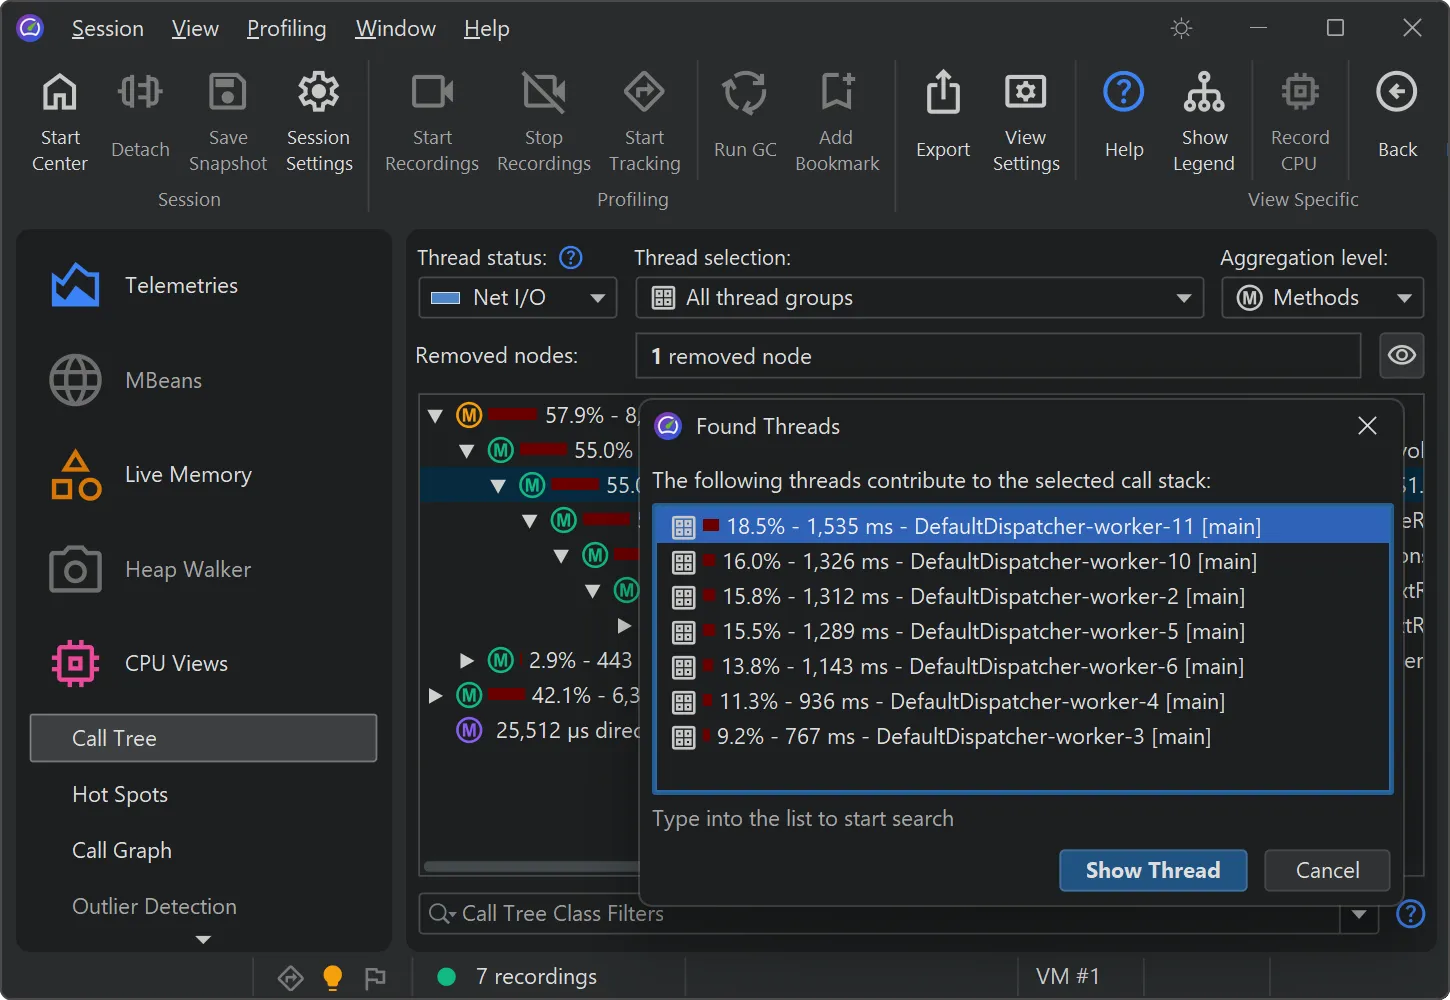
集計コールツリーにおける個々のスレッドの寄与を分析できるようになりました。コールツリービューで、コンテキストメニューから「スレッドを表示」を選択すると、選択したノードについてこのデータが計算されます。
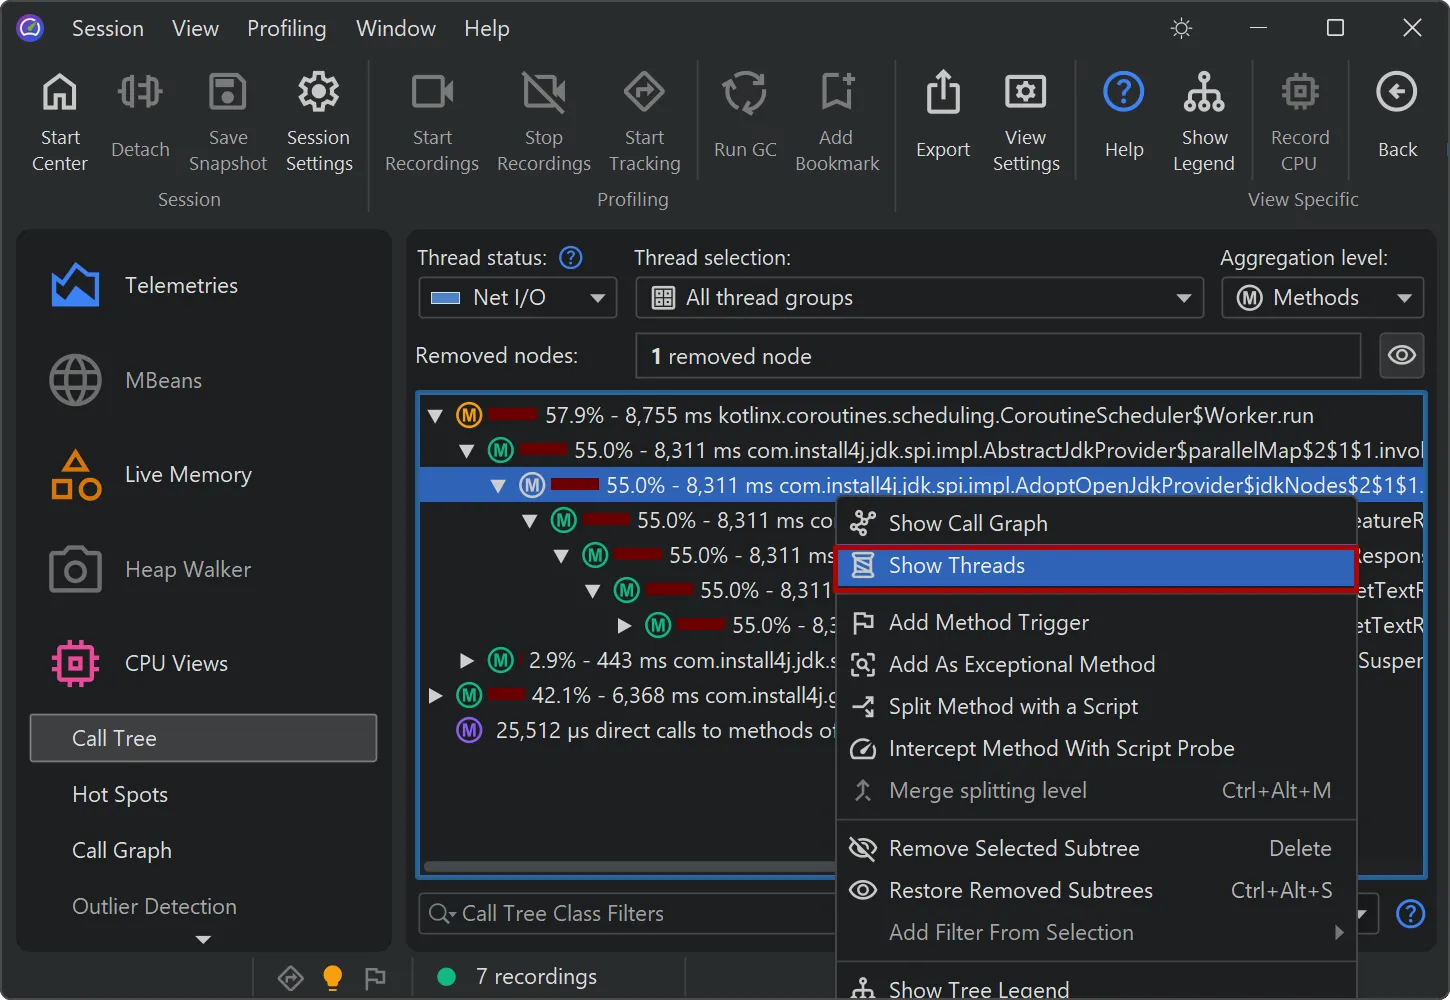
寄与しているすべてのスレッドの内訳をパーセンテージで示す別のダイアログが表示されます。必要に応じて1つのスレッドを選択し、コールツリービューでそのスレッドのコールツリーに切り替えることもできます。
この機能は、スレッド固有のパフォーマンス問題の特定に役立ちます。例えば、スレッドプールの中から異常な動作をしているスレッドを切り分けたい場合などに使用できます。
ノード詳細ダイアログが複数の点で改良されました。
ノード詳細ダイアログは、選択した要素の詳細情報を表示するための重要なツールで、「ビュー」メニューまたはコンテキストメニューから利用できます。
ホットスポットビューで複数のノードを選択すると、選択範囲の集計統計が表示されるようになりました。
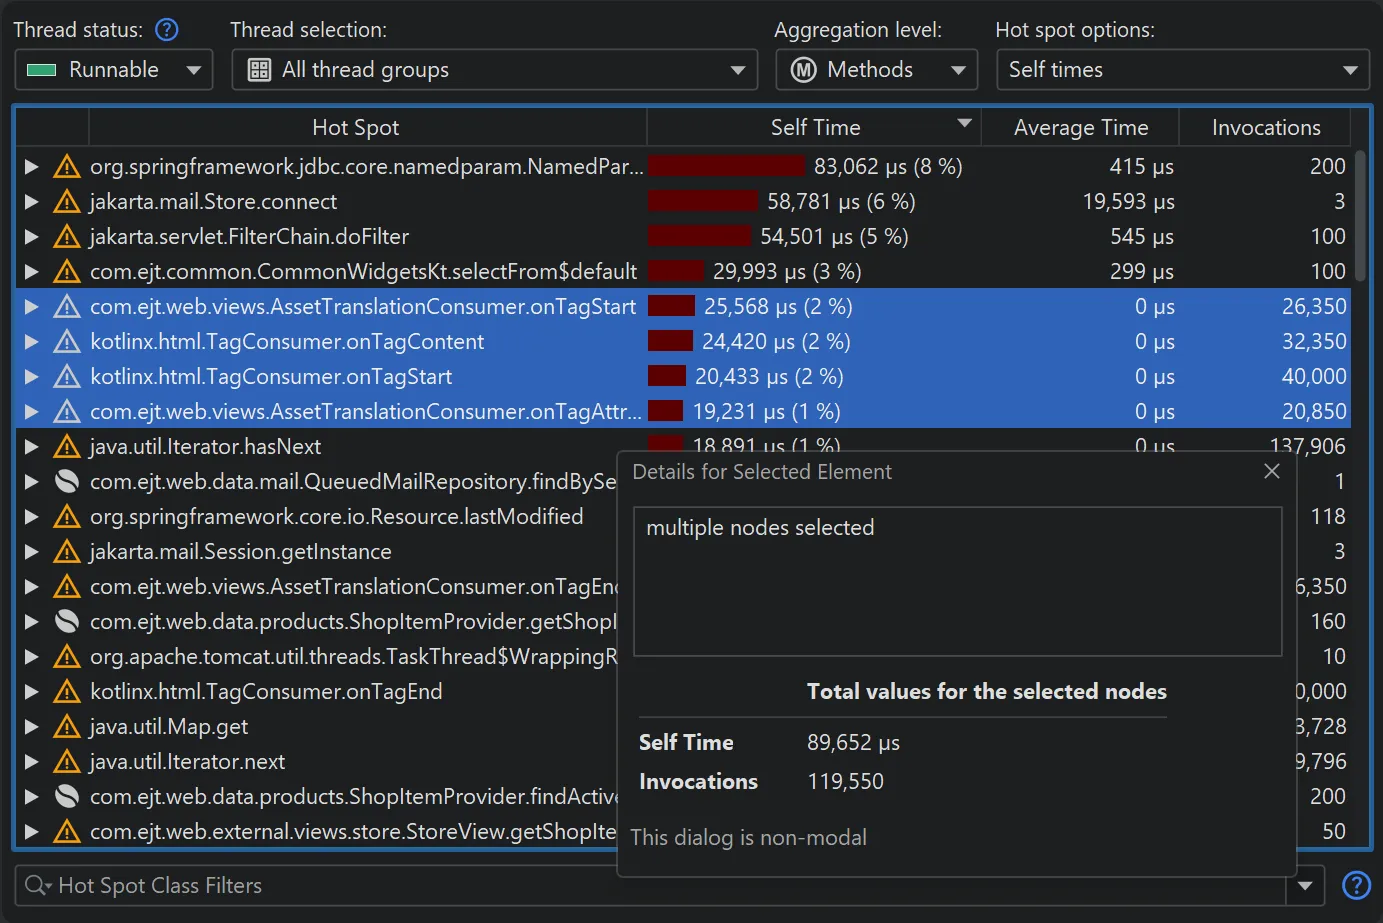
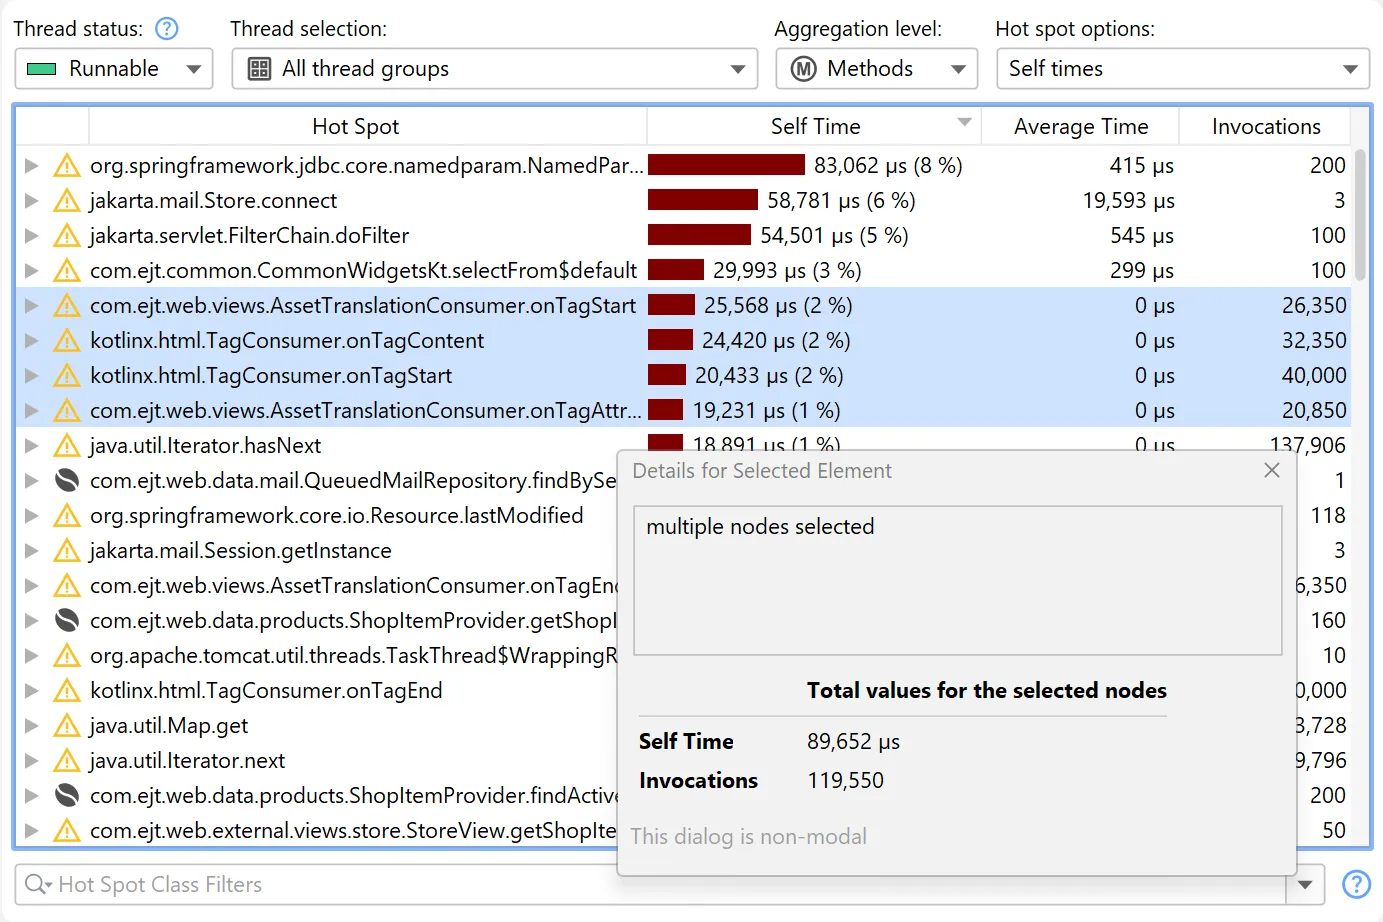
JProfilerの多くのテーブルには、列幅を超える長いテキストを含む列があります。このような場合、ノード詳細ダイアログに完全なテキストが表示されます。JProfiler 16以降では、ホバーボタンによりノード詳細ダイアログを直接開くことができ、テーブルに長いテキストの列が複数ある場合には正しいタブが自動的にアクティブになります。
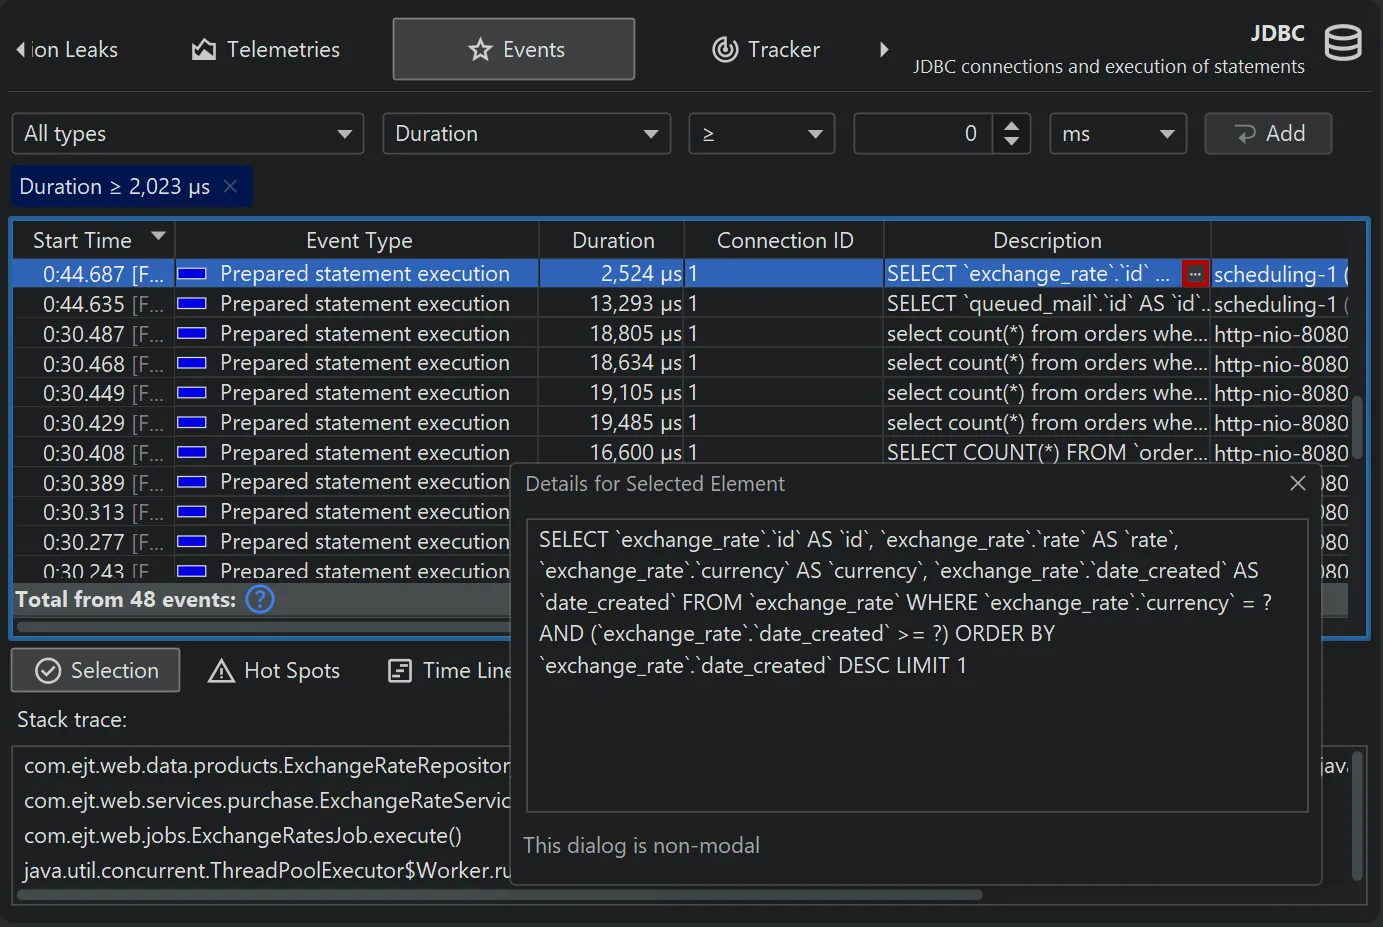
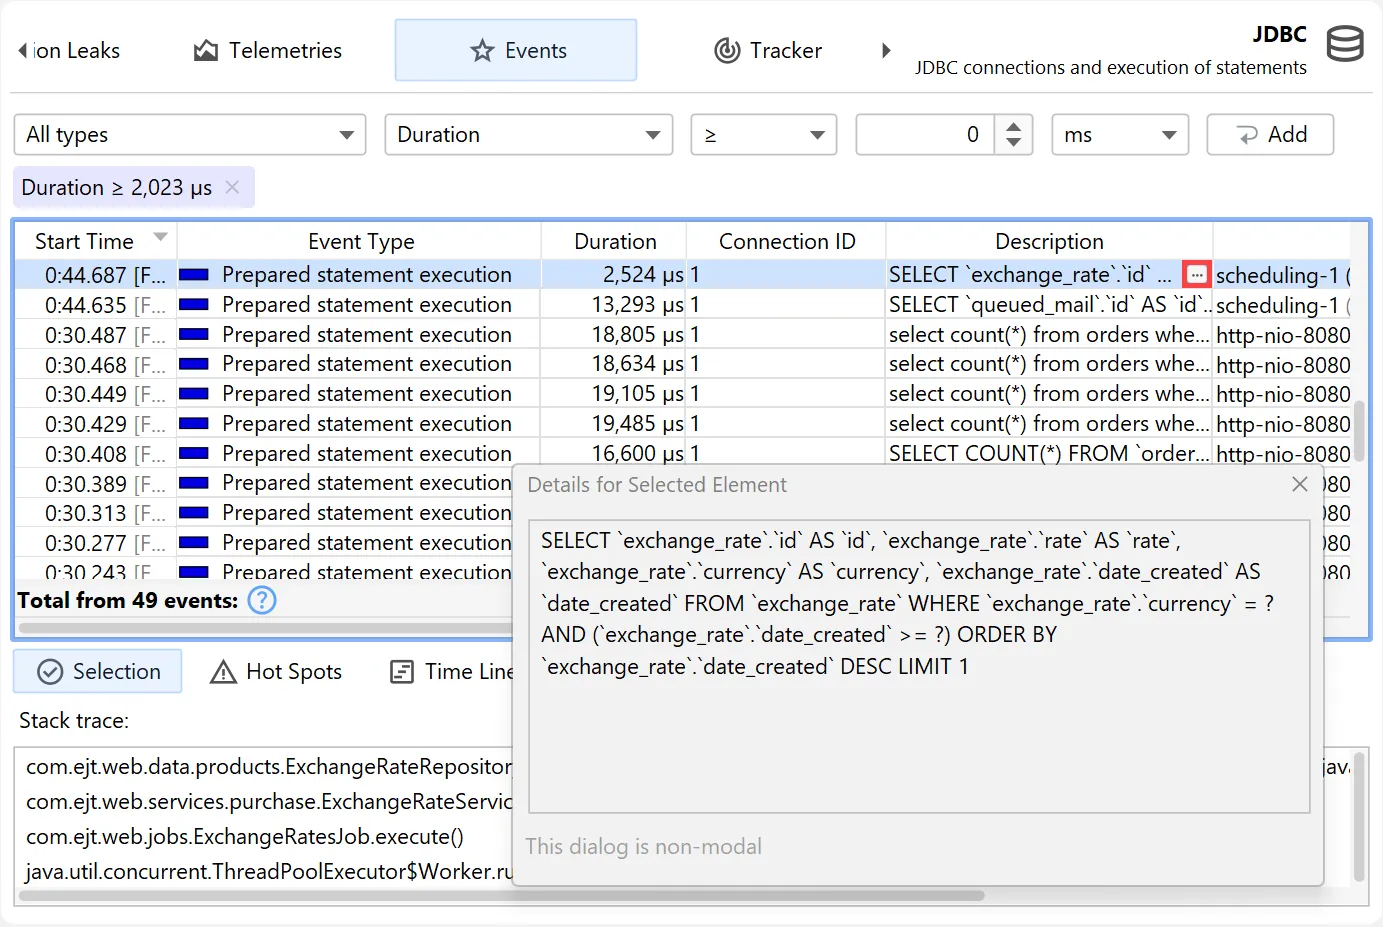
ヒープウォーカーでは、ノード詳細ダイアログに参照ビュー内の文字列値の完全な値が表示されるようになり、表示上の切り詰められたプレビュー文字列だけではなくなりました。
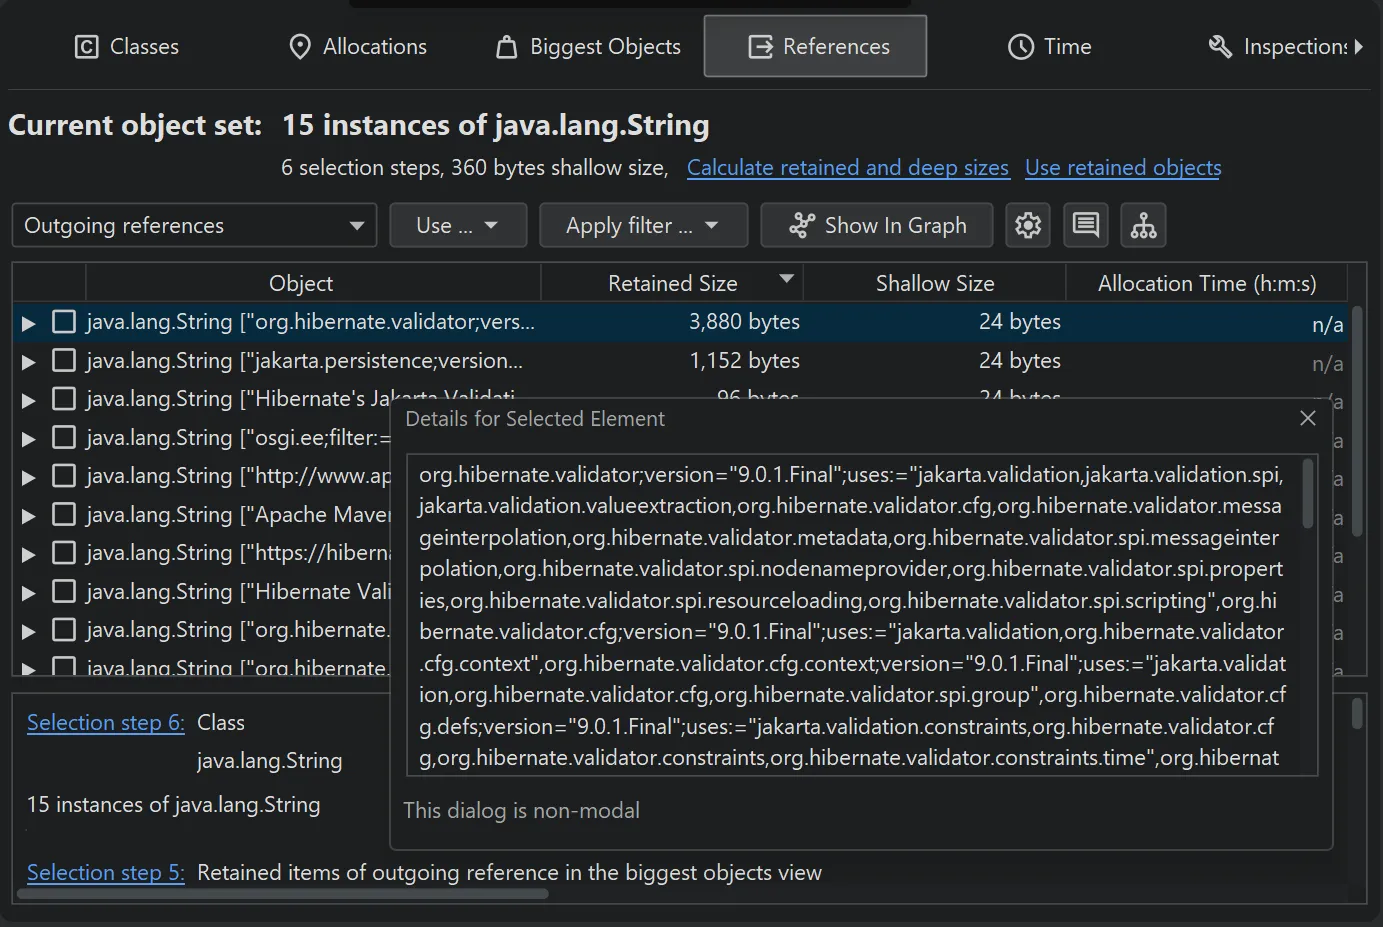
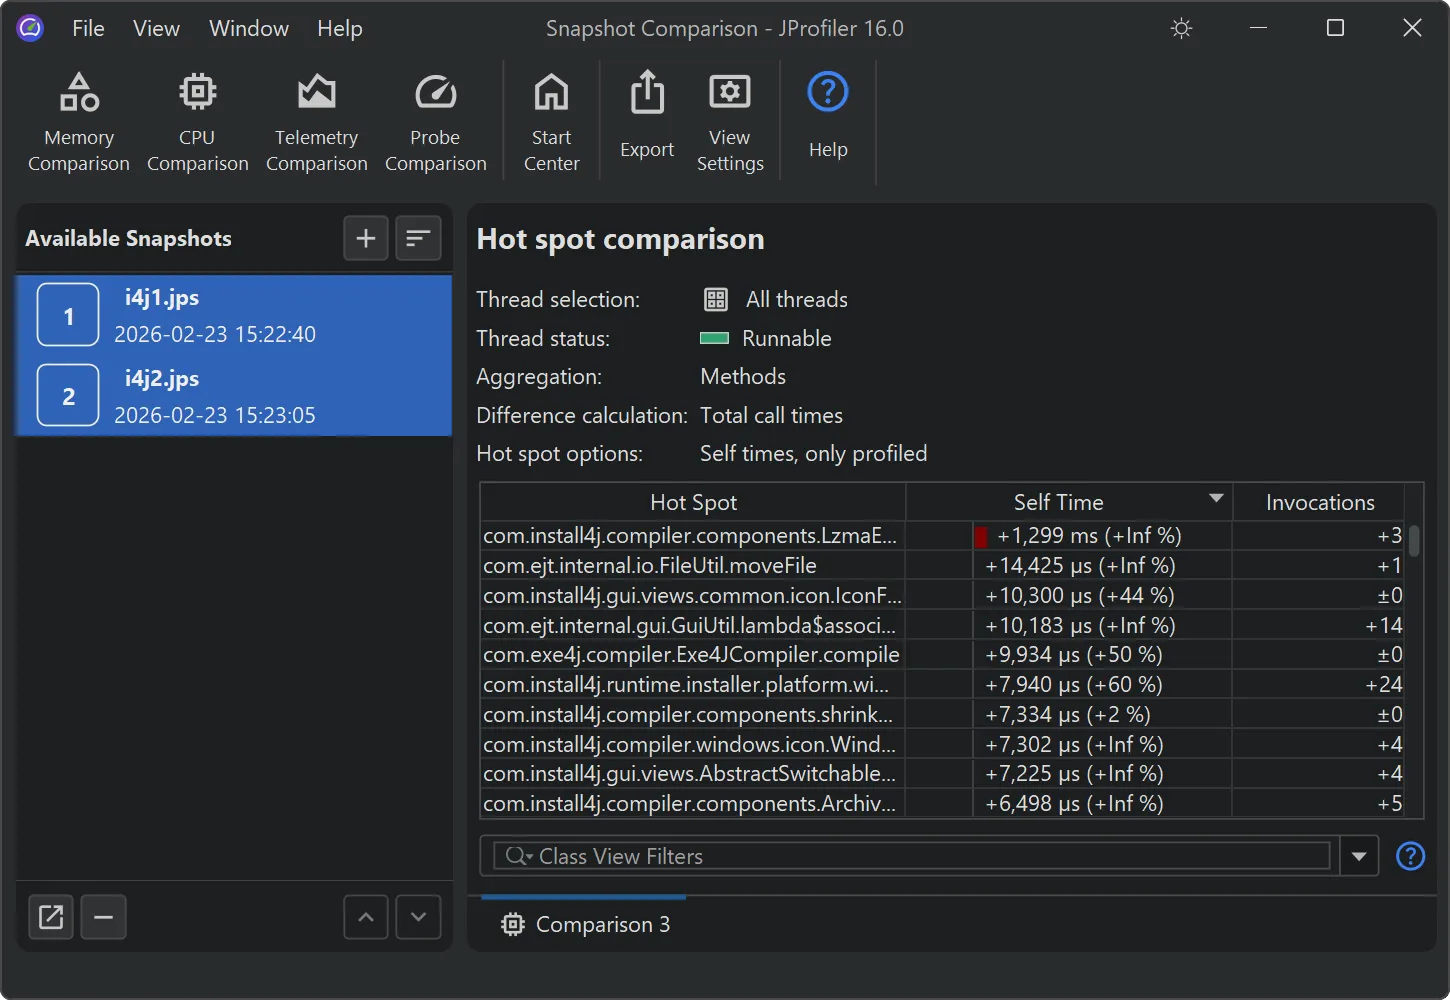
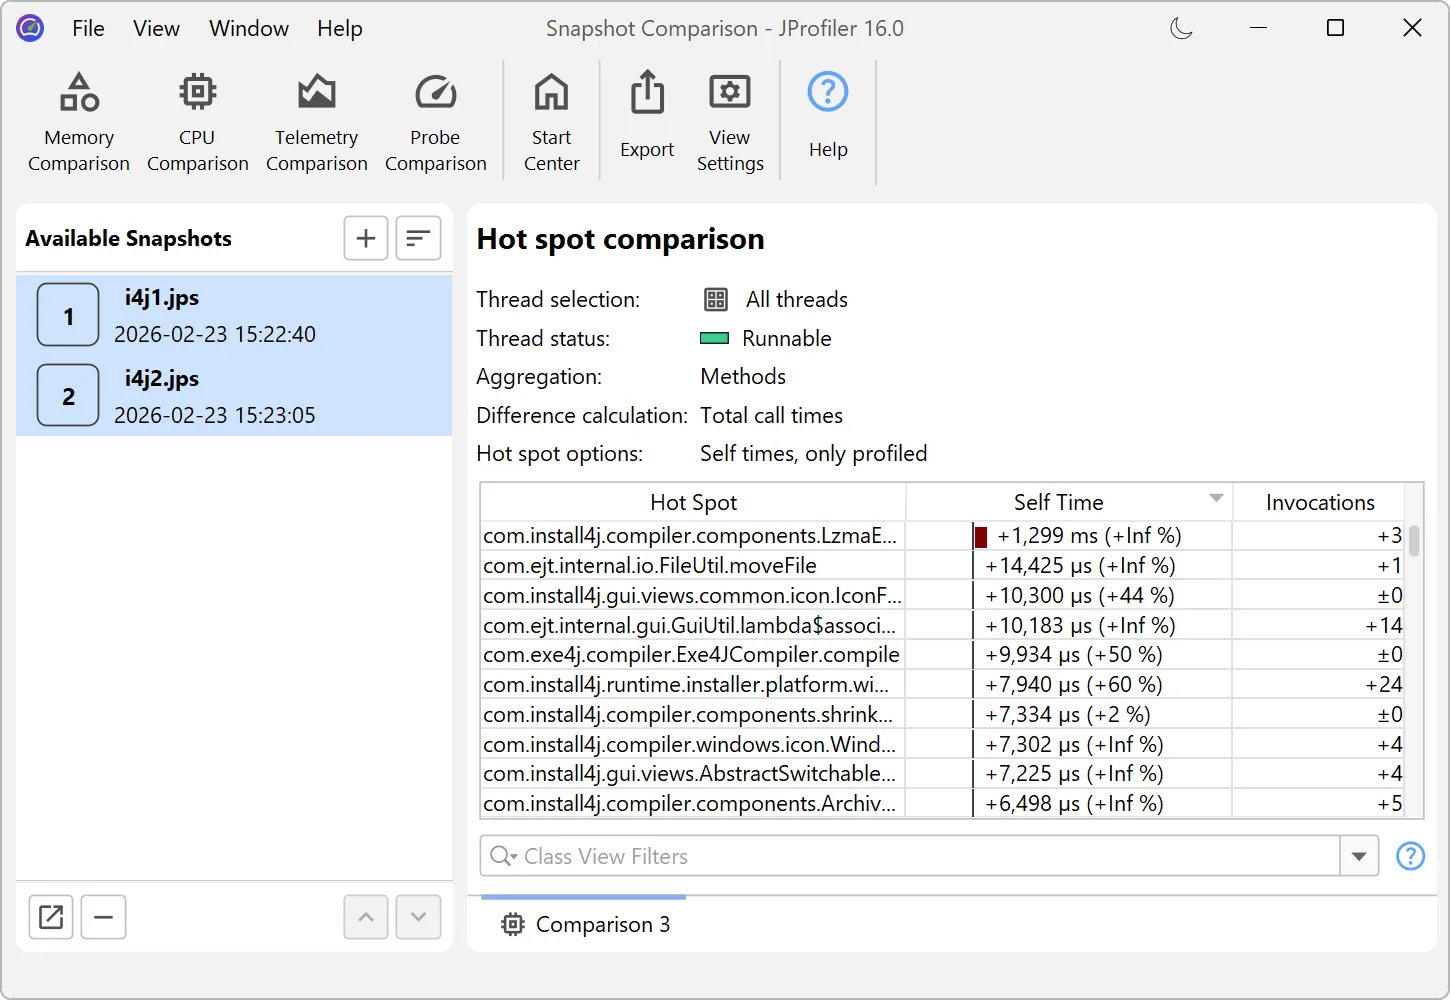
JProfilerはスナップショット比較の難読化解除をサポートするようになりました。
以前は、難読化されたアプリケーションのスナップショットを比較する際に、クラス名やメソッド名を難読化解除する方法がありませんでした。以下は、難読化された名前を使用した比較の例です。
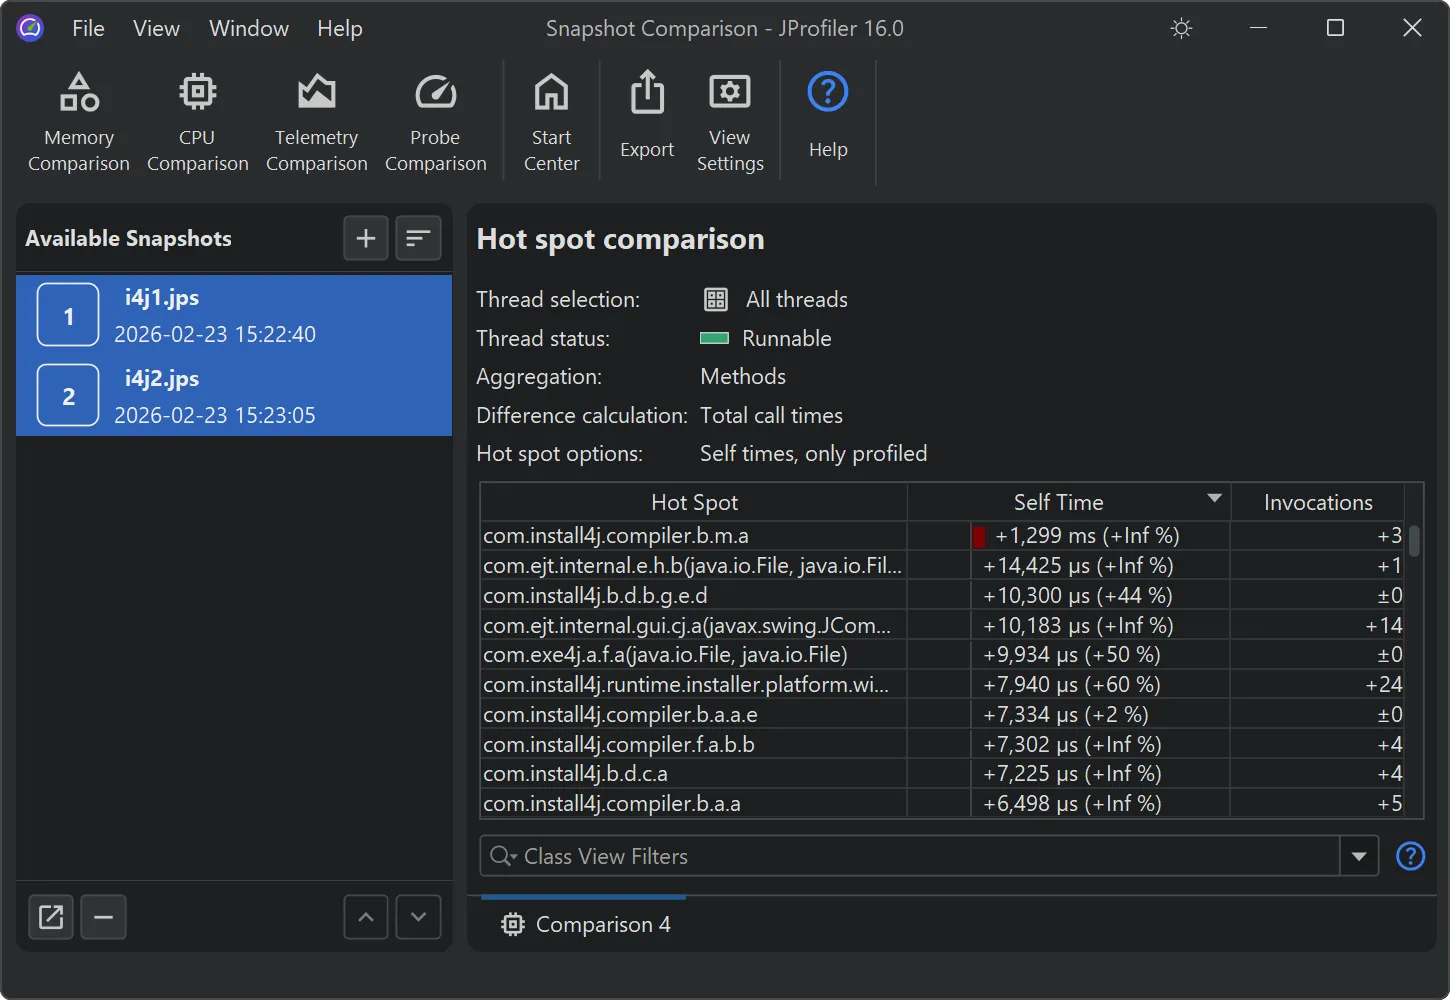
スナップショットを開く際の既存の難読化解除サポートと同様に、比較ウィンドウにスナップショットを追加する際には、ファイル選択ダイアログに「難読化解除」チェックボックスが表示されるようになりました。
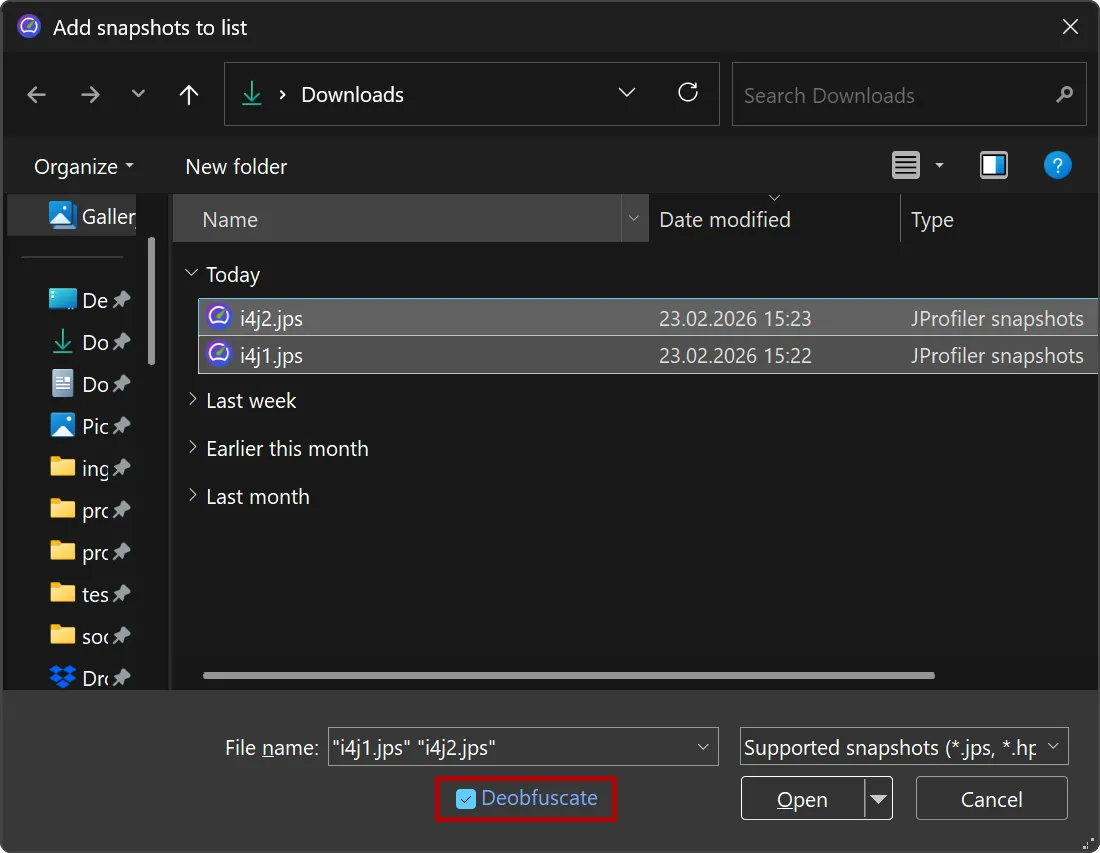
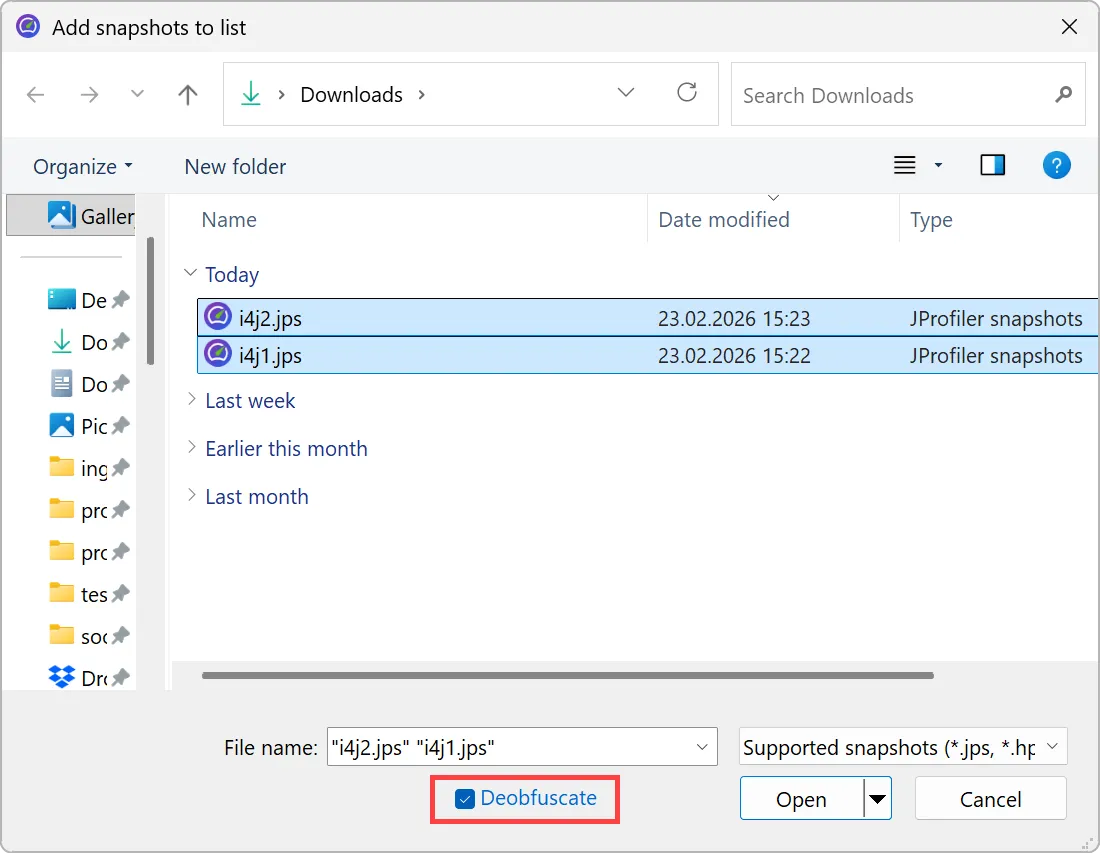
チェックすると、サポートされている難読化ツールを選択するドロップダウンとマッピングファイルのパスを入力するフィールドを備えたダイアログが表示されます。
スナップショットファイルごとに異なるマッピングファイルを使用する場合は、スナップショットを個別に追加できます。
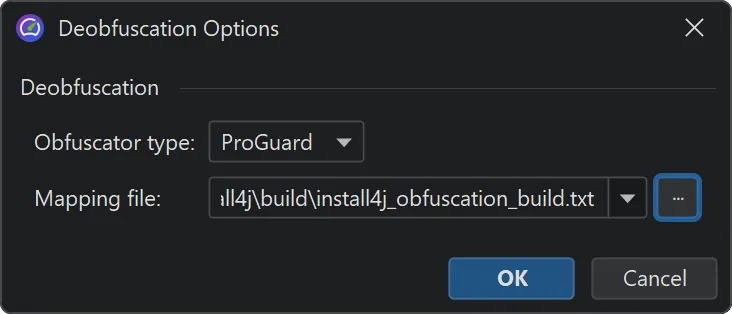
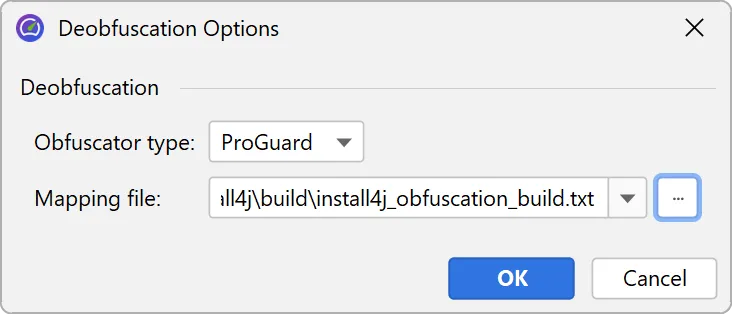
マッピングファイルを適用すると、JProfilerのすべての比較で元のクラス名とメソッド名が表示されるようになります。
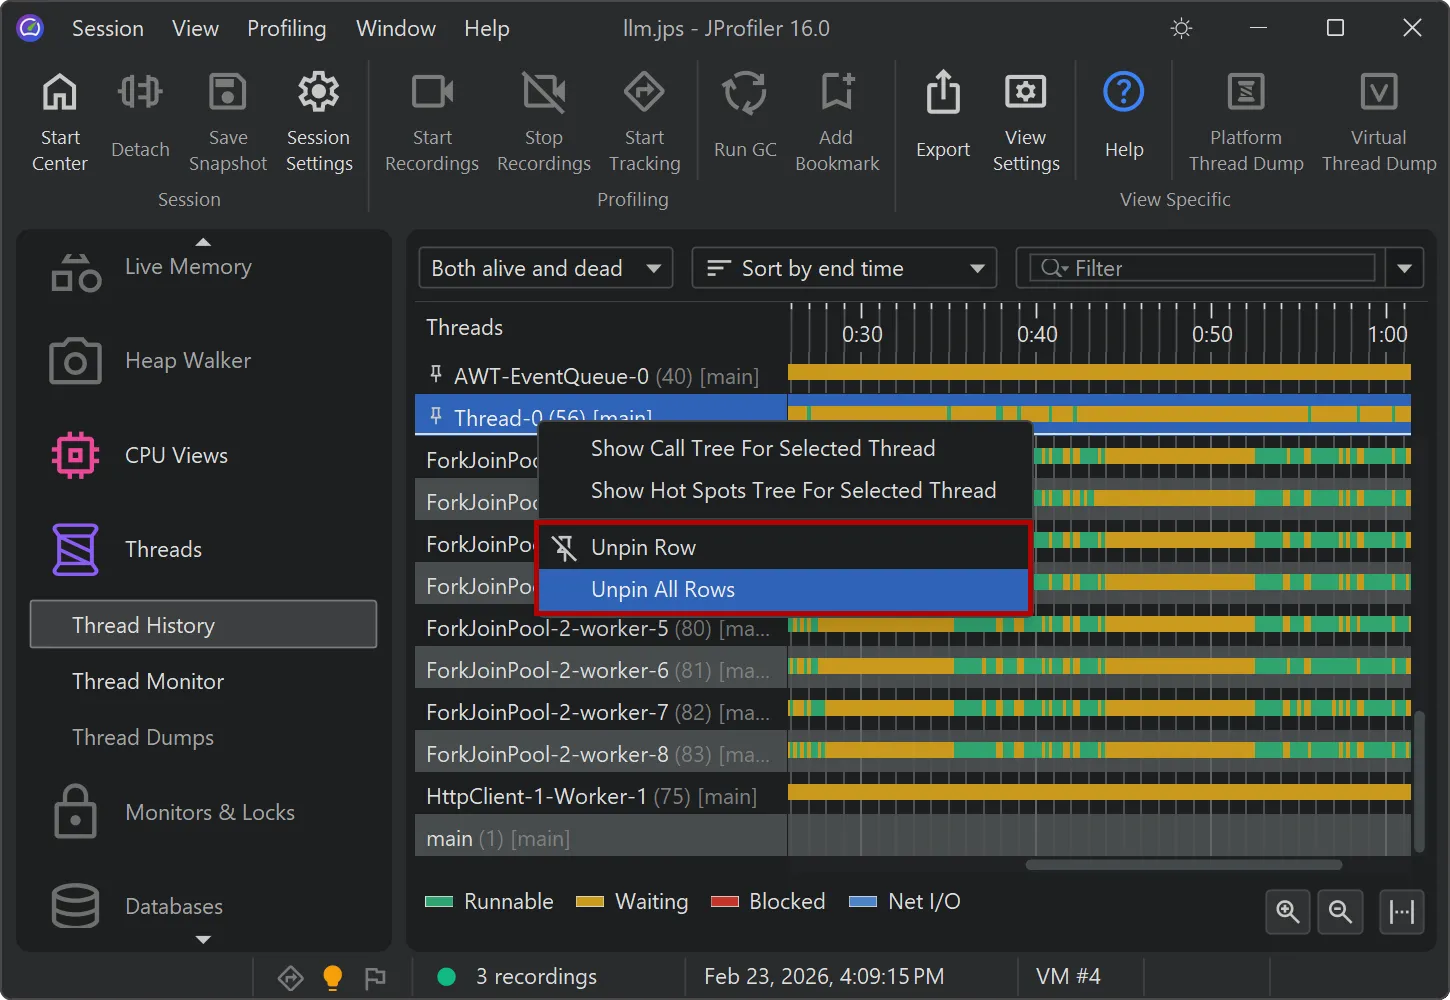
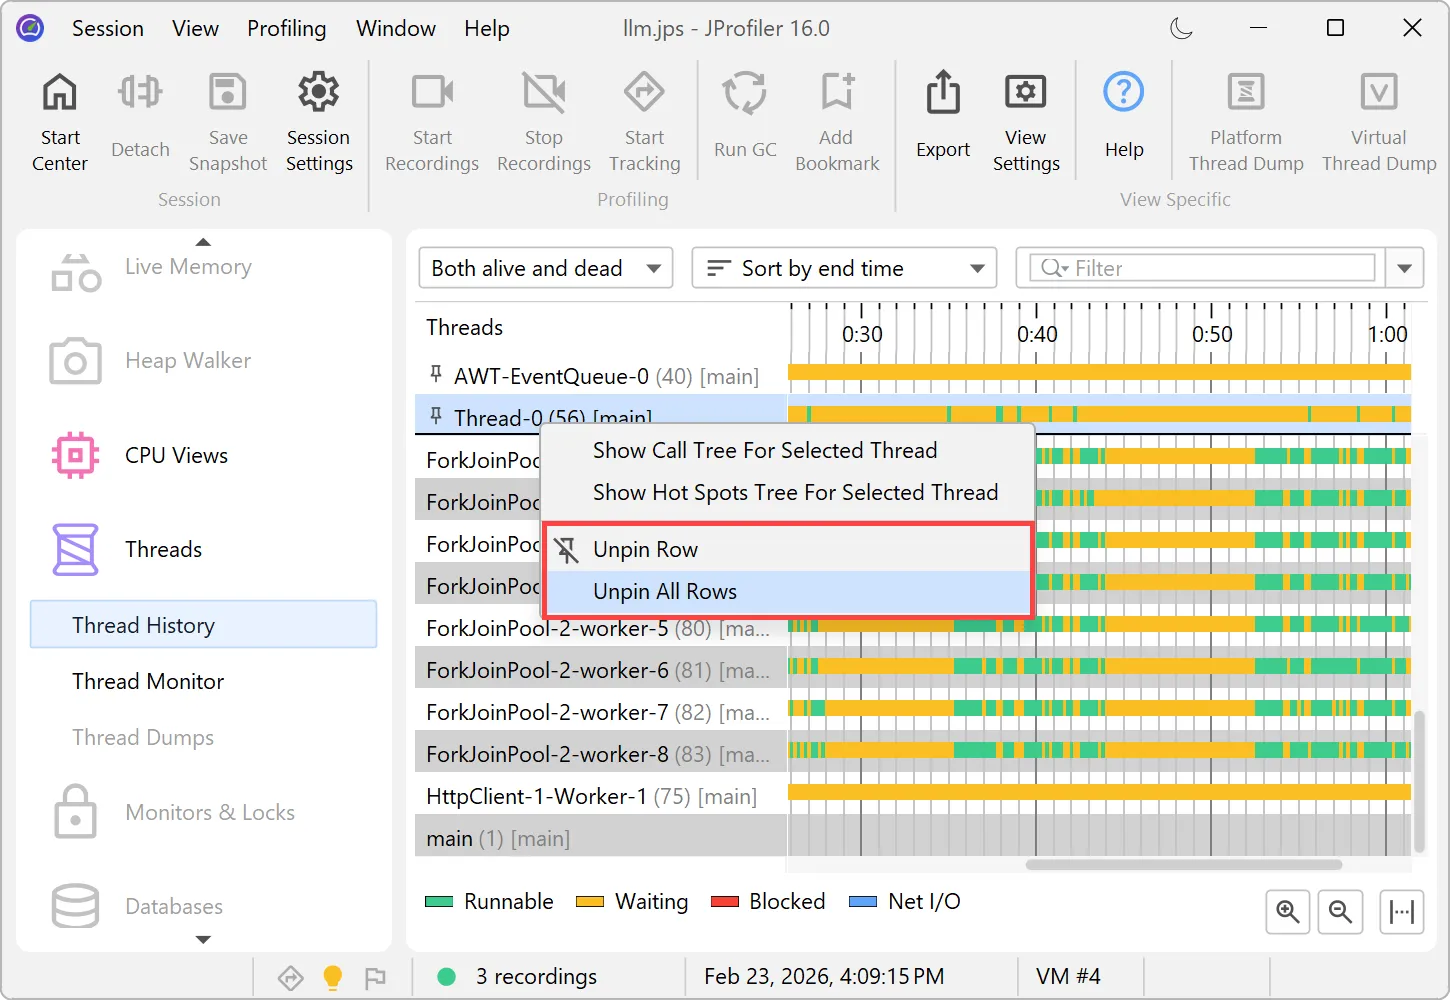
タイムラインビューで行のピン留めをサポートしました。
スレッド履歴ビューおよびすべてのプローブタイムラインビューでは、コンテキストメニューから選択した行をピン留めできます。ピン留めされた行は上部の独立した領域に表示され、ドラッグ&ドロップで順序を変更できます。
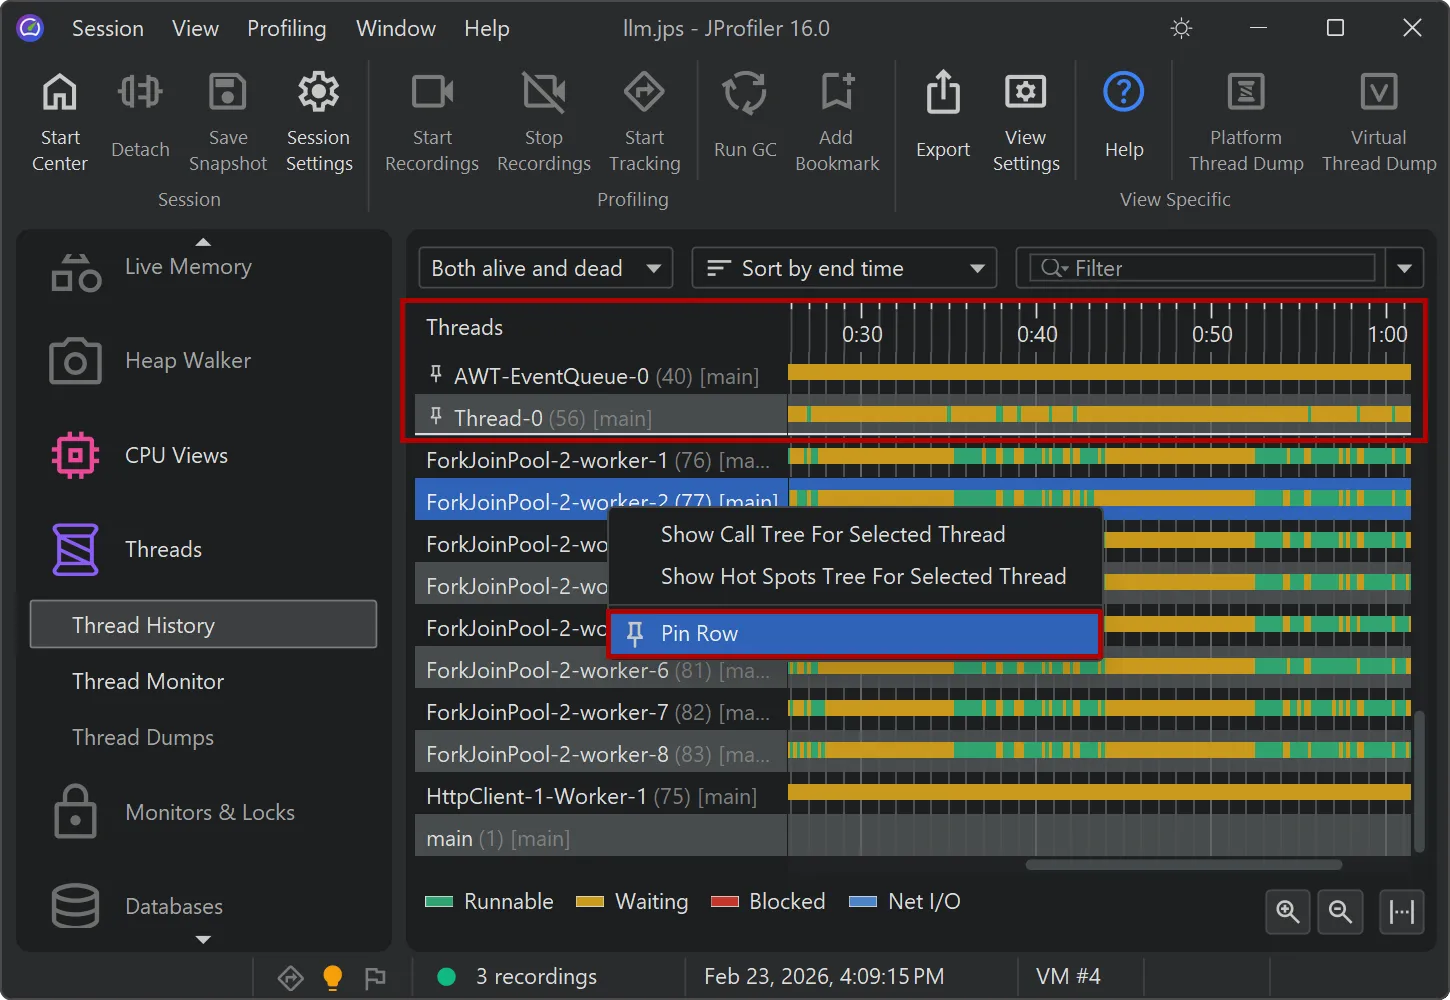
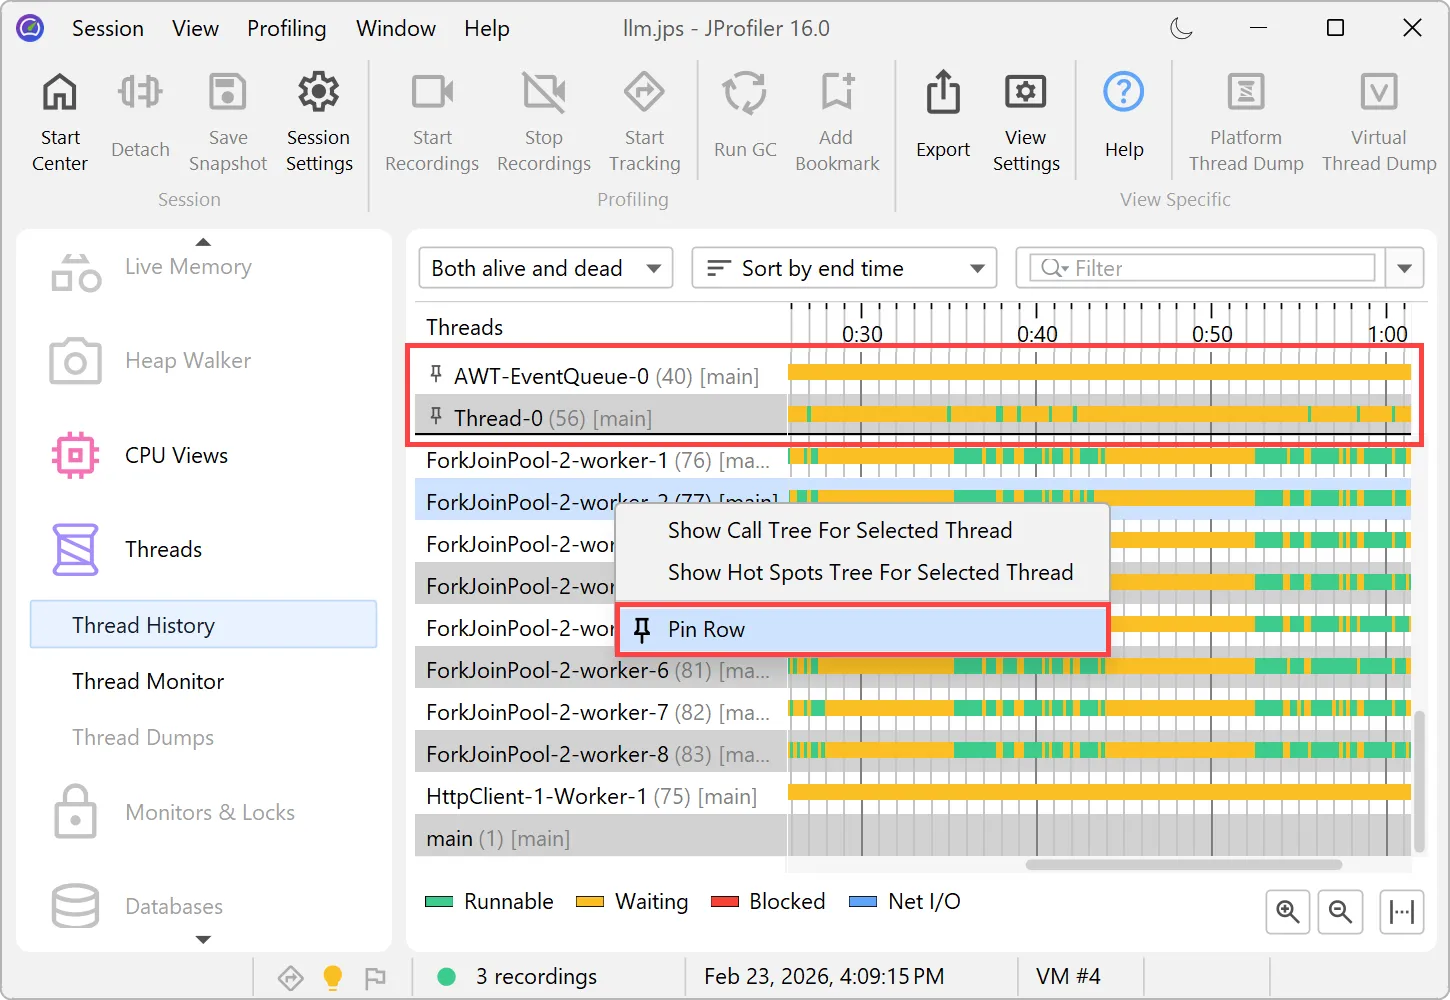
ピン留めされた行は、個別に、または一括でピン留め解除できます。
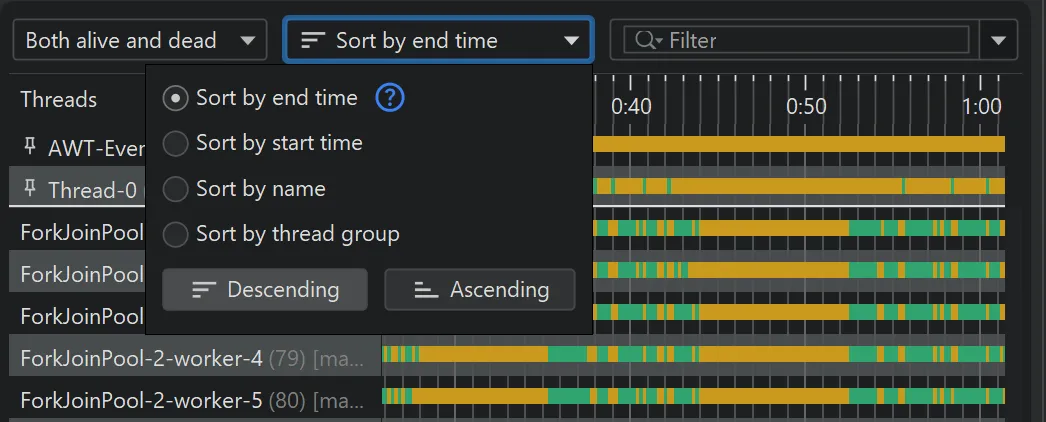
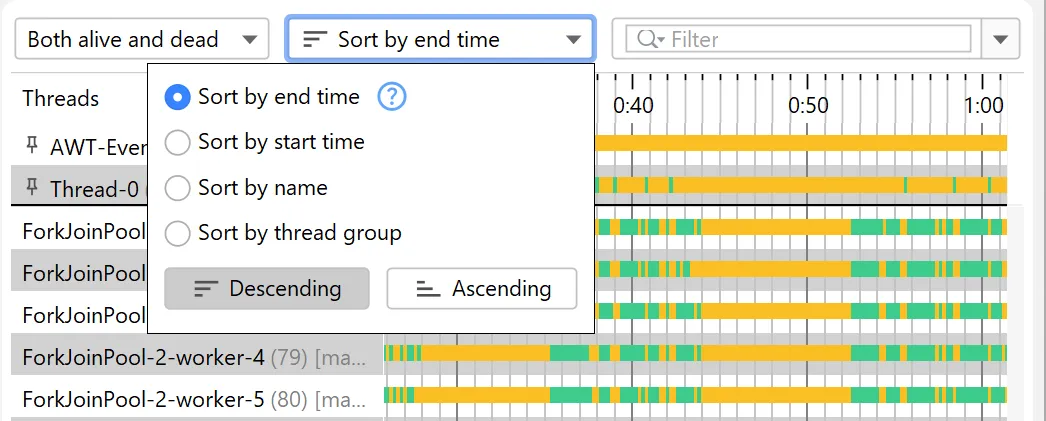
JProfiler 16では、昇順と降順のソート方向を選択できるソート用ドロップダウンも新たに導入されました。新しいデフォルトのソートモードでは、現在も実行中の長寿命の行が先頭に表示され、その後に最近終了した行が続きます。
JProfiler 16では、Java 26のプロファイリングを完全にサポートしました。
仮想スレッドをプロファイリングする場合や、JDK HTTPクライアントの新しく組み込まれたHTTP/3サポートを使用する場合には、このバージョンが不可欠です。