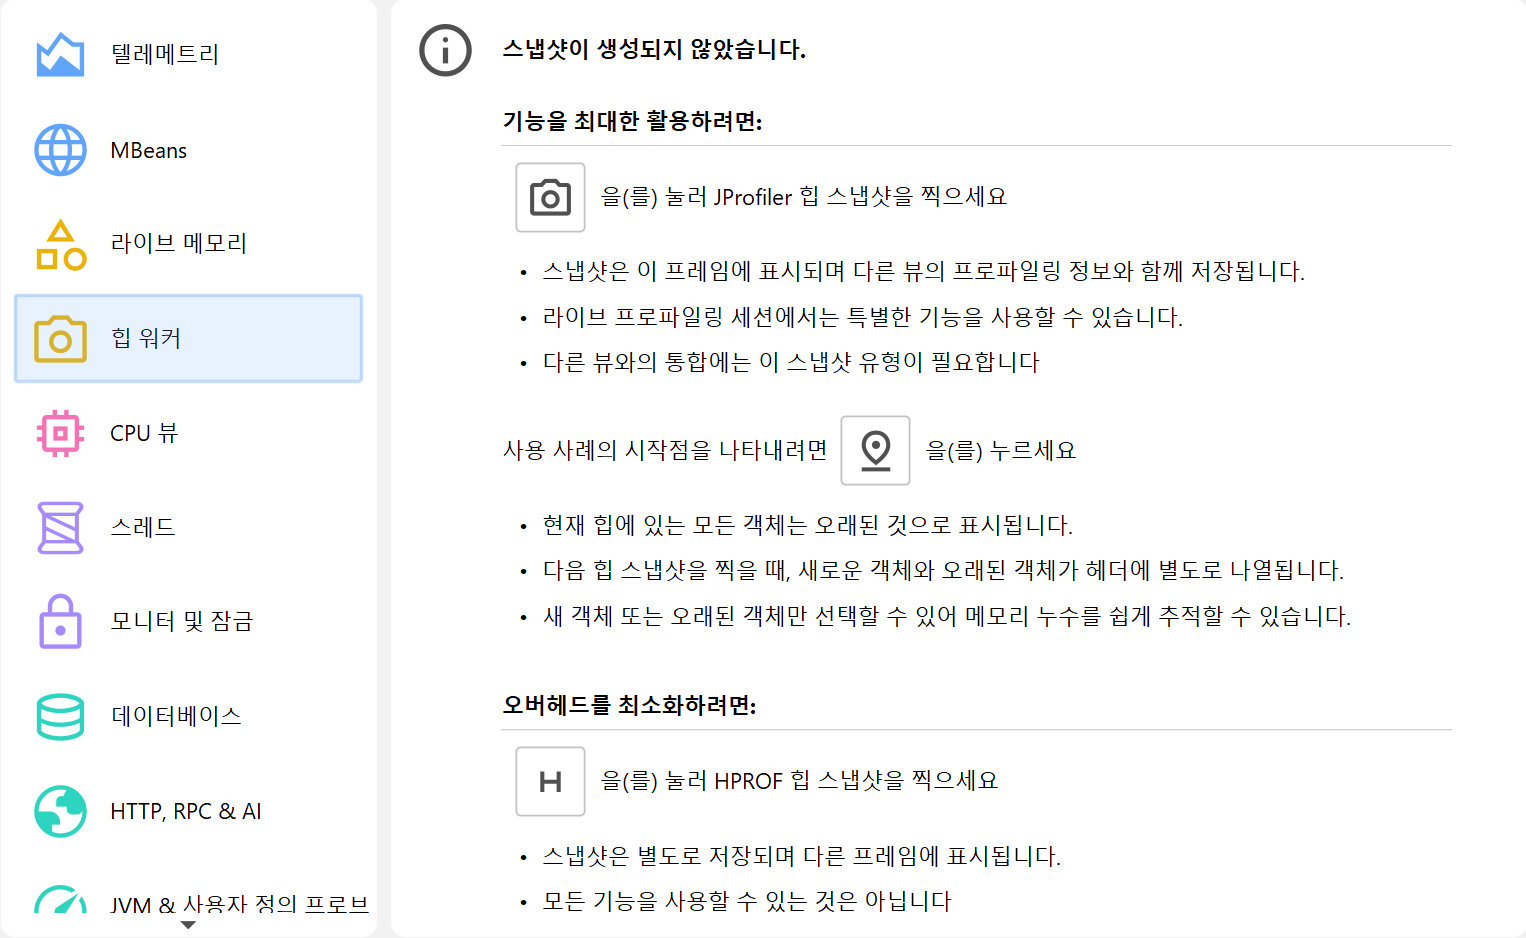
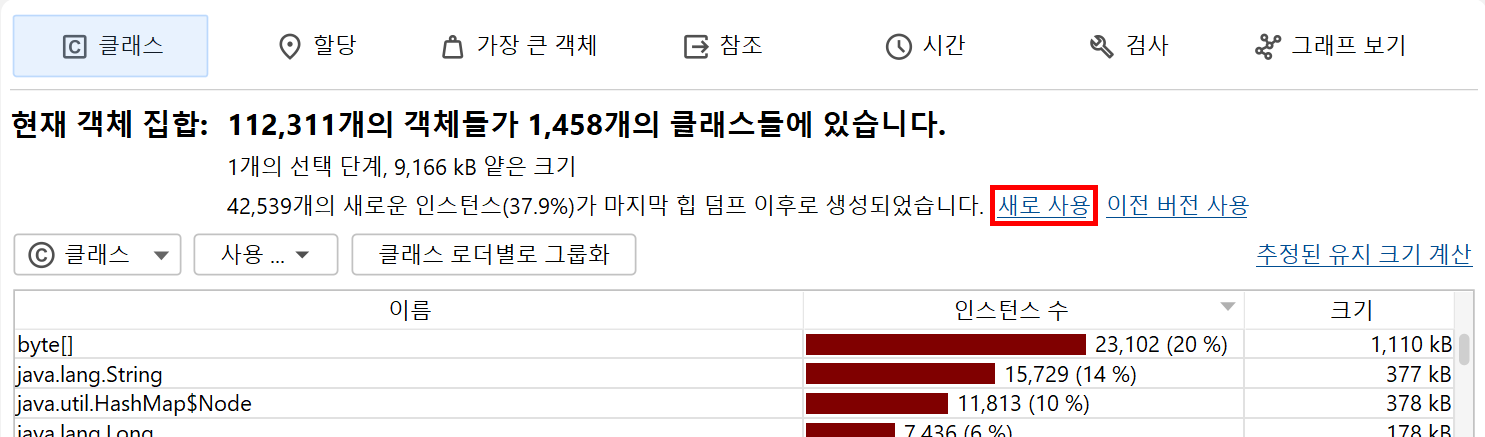
힙 스냅샷
객체 간의 참조와 관련된 모든 힙 분석에는 힙 스냅샷이 필요합니다. JVM에 특정 객체로 들어오는 참조가 무엇인지 직접 질의할 수 없기 때문입니다. 이 질문에 답하려면 전체 힙을 반복 탐색해야 합니다. JProfiler는 이 힙 스냅샷으로부터 힙 워커의 뷰를 제공하는 데 필요한 데이터를 생성하도록 최적화된 내부 데이터베이스를 구축합니다.
힙 스냅샷의 소스에는 JProfiler 힙 스냅샷과 HPROF/PHD 힙 스냅샷 두 가지가 있습니다. JProfiler 힙 스냅샷은 힙 워커에서 제공하는 모든 기능을 지원합니다. 프로파일링 에이전트는 프로파일링 인터페이스인 JVMTI를 사용하여 모든 참조를 반복 탐색합니다. 프로파일된 JVM이 다른 머신에서 실행 중인 경우 모든 정보가 로컬 머신으로 전송되고 추가 계산은 로컬 머신에서 수행됩니다. HPROF/PHD 스냅샷은 JVM의 내장 메커니즘을 통해 생성되며 JProfiler가 읽을 수 있는 표준 형식으로 디스크에 기록됩니다. HotSpot JVM은 HPROF 스냅샷을 생성할 수 있으며, Eclipse OpenJ9 JVM은 PHD 스냅샷을 제공합니다.
힙 워커의 개요 페이지에서 JProfiler 힙 스냅샷을 생성할지 HPROF/PHD 힙 스냅샷을 생성할지 선택할 수 있습니다. 기본적으로는 JProfiler 힙 스냅샷이 권장됩니다. HPROF/PHD 힙 스냅샷은 다른 장에서 다루는 특별한 상황에서 유용합니다.
선택 단계
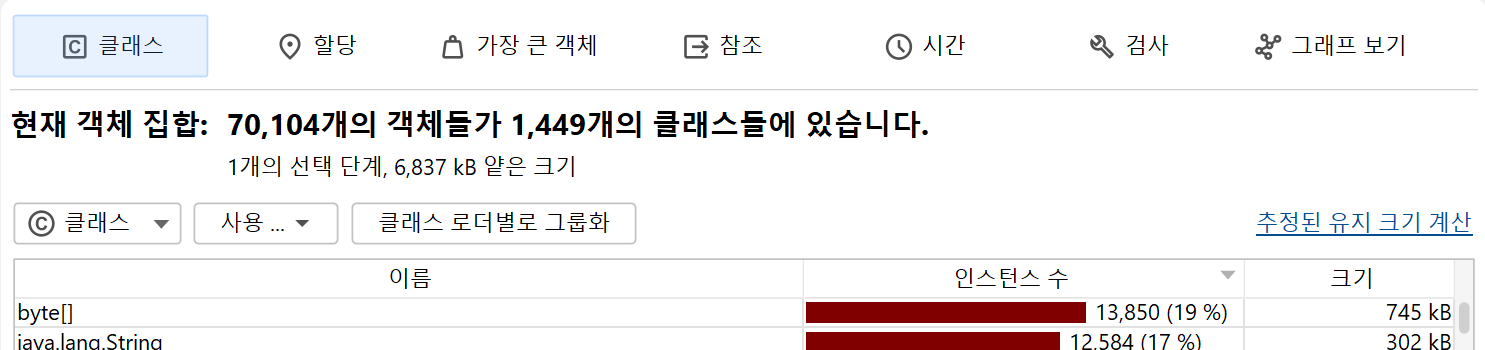
힙 워커는 선택된 객체 집합의 다양한 측면을 보여주는 여러 뷰로 구성되어 있습니다. 힙 스냅샷을 찍은 직후에는 힙의 모든 객체를 보게 됩니다. 각 뷰에는 선택한 일부 객체를 현재 객체 집합으로 전환하기 위한 탐색 액션이 있습니다. 힙 워커의 헤더 영역에는 현재 객체 집합에 몇 개의 객체가 포함되어 있는지에 대한 정보가 표시됩니다.
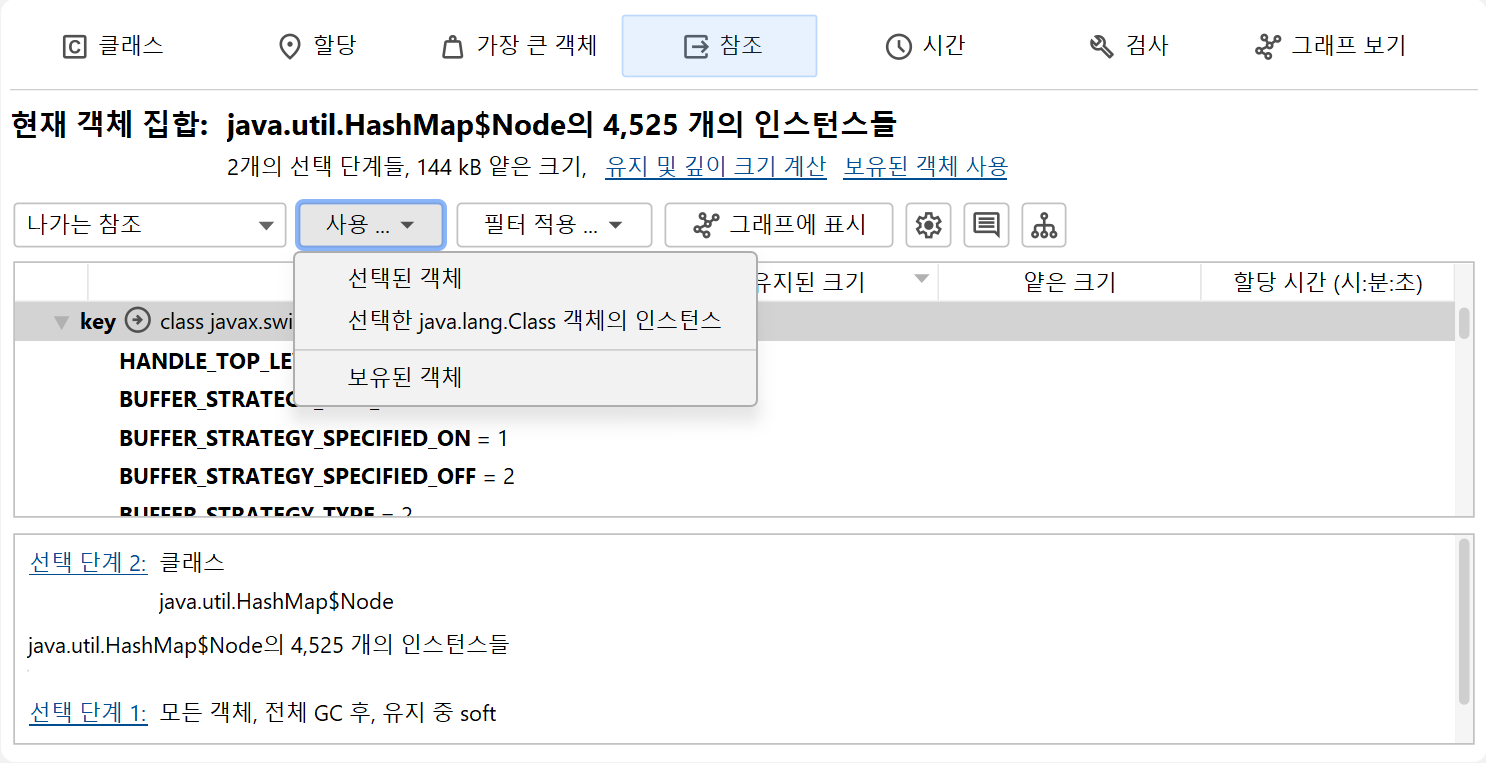
처음에는 라이브 메모리 섹션의 "All objects" 뷰와 유사한 "Classes" 뷰를 보게 됩니다. 클래스를 선택하고 Use→Selected Instances를 호출하면 해당 클래스의 인스턴스만 포함하는 새 객체 집합이 생성됩니다. 힙 워커에서 "사용(using)"은 항상 새 객체 집합을 생성함을 의미합니다.
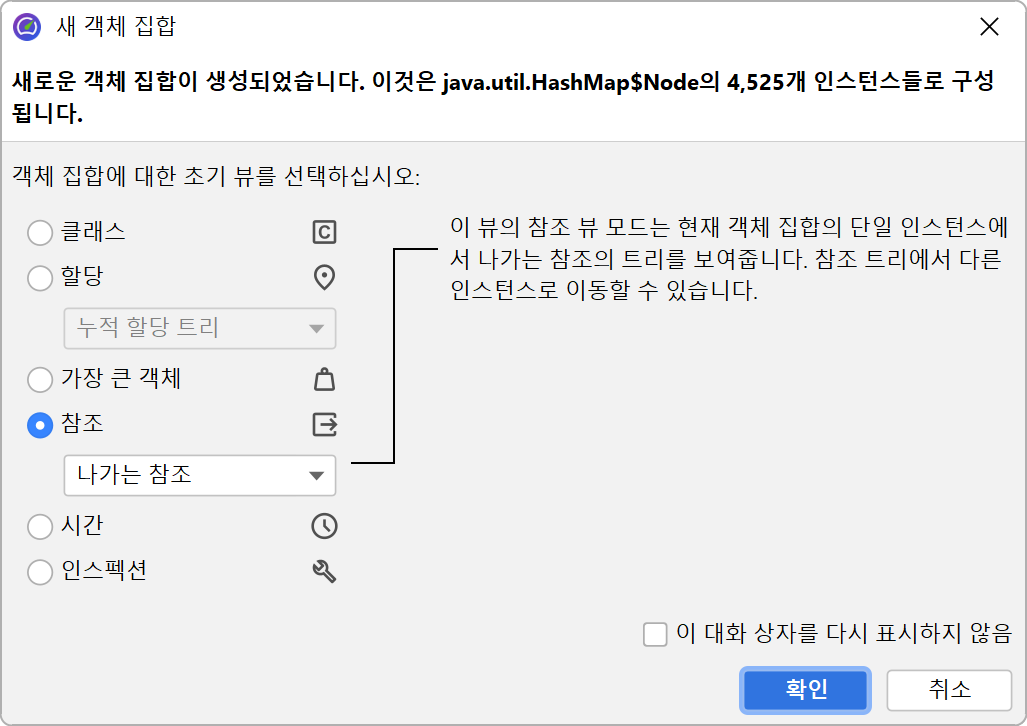
새 객체 집합에 대해 힙 워커의 클래스 뷰를 표시하는 것은 사실상 이전에 선택한 클래스로 테이블을 필터링하는 것에 불과하므로 큰 의미가 없습니다. 대신 JProfiler는 "New object set" 대화상자를 통해 다른 뷰를 제안합니다. 이 대화상자를 취소하면 새 객체 집합을 버리고 이전 뷰로 돌아갈 수 있습니다. 기본적으로 나가는 참조 뷰가 제안되지만 다른 뷰를 선택할 수도 있습니다. 이는 처음에 표시되는 뷰에만 해당하며 나중에 힙 워커의 뷰 선택기에서 뷰를 전환할 수 있습니다.
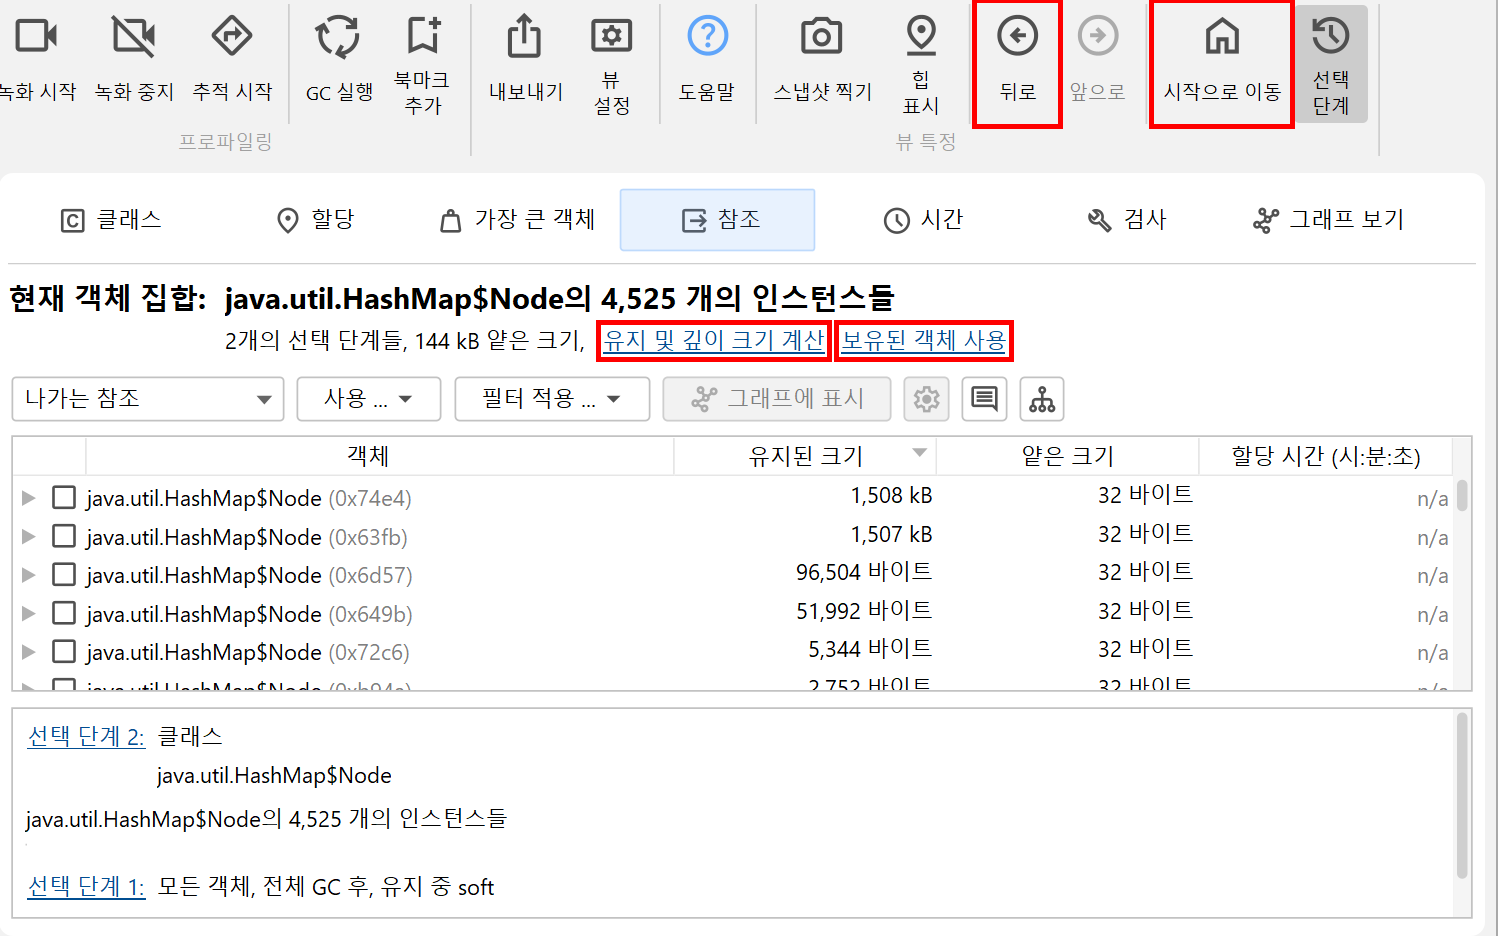
이제 헤더 영역에는 두 개의 선택 단계가 있음을 알려주며, 보존 크기(retained size) 및 딥 크기(deep size)를 계산하거나 현재 객체 집합에 의해 보존된 모든 객체를 사용하기 위한 링크가 포함됩니다. 후자의 경우 해당 객체 집합에 여러 클래스가 포함될 가능성이 높기 때문에 다른 선택 단계를 추가하고 클래스 뷰를 제안합니다.
힙 워커의 하단에는 지금까지의 선택 단계가 나열됩니다. 하이퍼링크를 클릭하면 이전의 어느 선택 단계로든 돌아갈 수 있습니다. 툴바의 Go To Start 버튼을 사용해 첫 번째 데이터 세트로 이동할 수도 있습니다. 툴바의 뒤로 가기 및 앞으로 가기 버튼은 분석 중에 이전 단계를 되짚어가야 할 때 유용합니다.
Classes 뷰
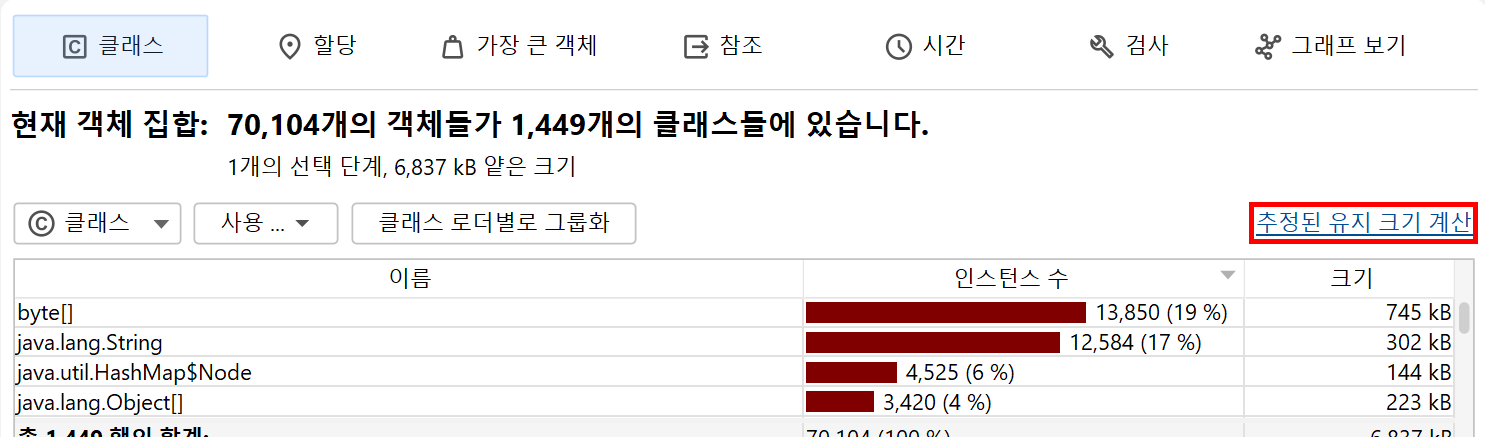
힙 워커 상단의 뷰 선택기에는 현재 객체 집합에 대한 서로 다른 정보를 보여주는 5개의 뷰가 있습니다. 그중 첫 번째가 "Classes" 뷰입니다.
클래스 뷰는 라이브 메모리 섹션의 "All objects" 뷰와 유사하며 클래스를 패키지로 그룹화할 수 있는 집계 수준 선택기를 제공합니다. 또한 클래스의 예상 보존 크기를 표시할 수 있습니다. 이는 클래스의 모든 인스턴스가 힙에서 제거될 경우 해제될 메모리 양입니다. Calculate estimated retained sizes 하이퍼링크를 클릭하면 새로운 Retained Size 열이 추가됩니다. 표시되는 보존 크기는 추정된 하한값이며, 정확한 수치를 계산하는 것은 너무 느릴 수 있습니다. 정확한 수치가 꼭 필요하다면 관심 있는 클래스나 패키지를 선택하고 새 객체 집합의 헤더에 있는 Calculate retained and deep sizes 하이퍼링크를 사용하십시오.
하나 이상의 클래스 또는 패키지를 선택한 상태에서 인스턴스 자체, 연관된 java.lang.Class 객체,
또는 모든 보존된 객체를 선택할 수 있습니다. 더블 클릭은 가장 빠른 선택 모드로, 선택한 인스턴스를 사용합니다.
이 경우처럼 여러 선택 모드를 사용할 수 있는 경우 뷰 상단에 Use 드롭다운 메뉴가 표시됩니다.
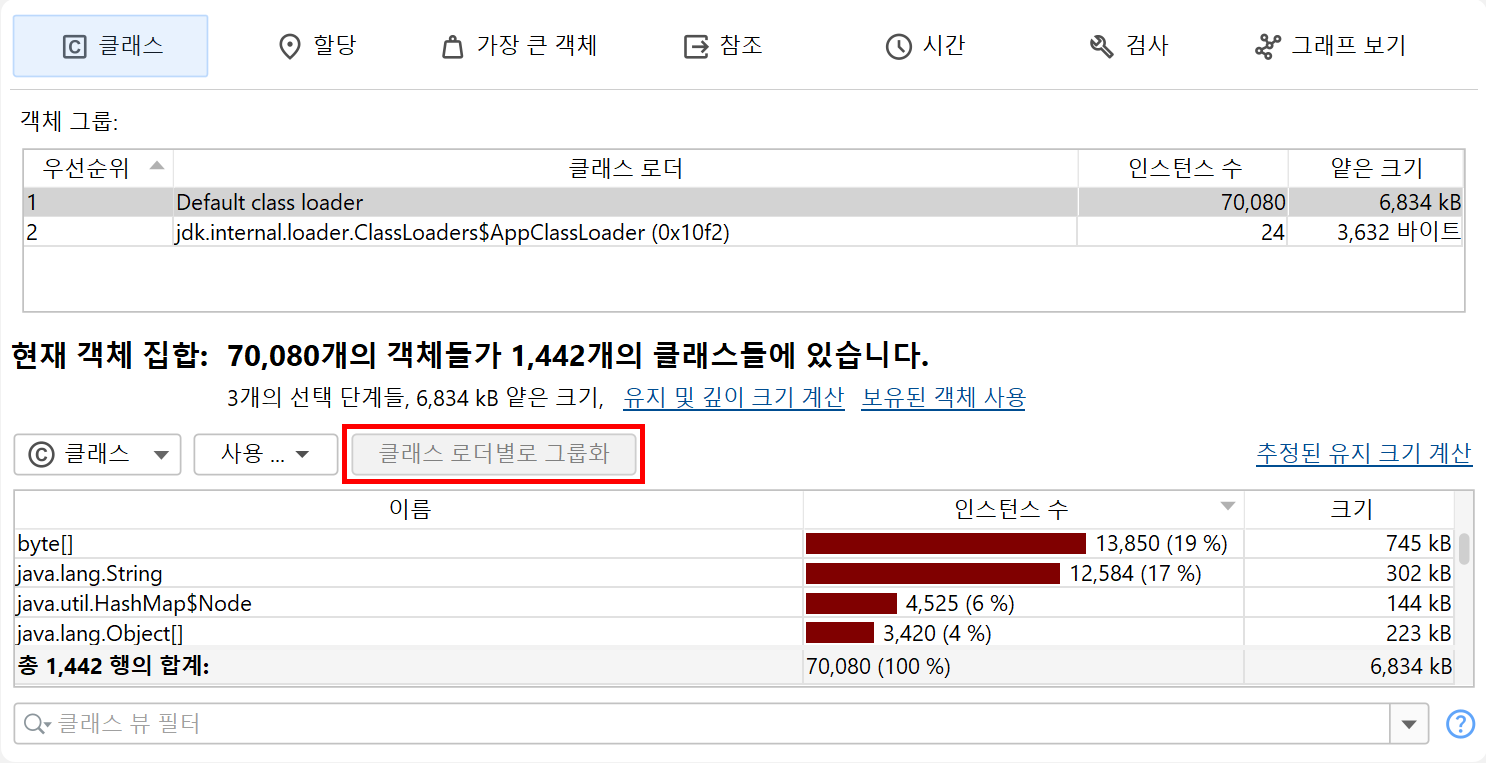
클래스로더 관련 문제를 해결할 때는 인스턴스를 클래스로더별로 그룹화해야 하는 경우가 많습니다. Inspections 탭에서는 해당 컨텍스트에서 특히 중요하기 때문에 클래스 뷰에서도 사용할 수 있도록 제공되는 "Group by class loaders" 검사를 제공합니다. 이 분석을 실행하면 상단의 그룹화 테이블에 모든 클래스로더가 표시됩니다. 클래스로더를 선택하면 하단 뷰의 데이터가 그에 맞게 필터링됩니다. 그룹화 테이블은 다른 선택 단계를 수행할 때까지 힙 워커의 다른 뷰로 전환해도 그대로 유지됩니다. 이후 다른 선택 단계를 수행하면 클래스로더 선택이 해당 선택 단계의 일부가 됩니다.
할당 기록 뷰
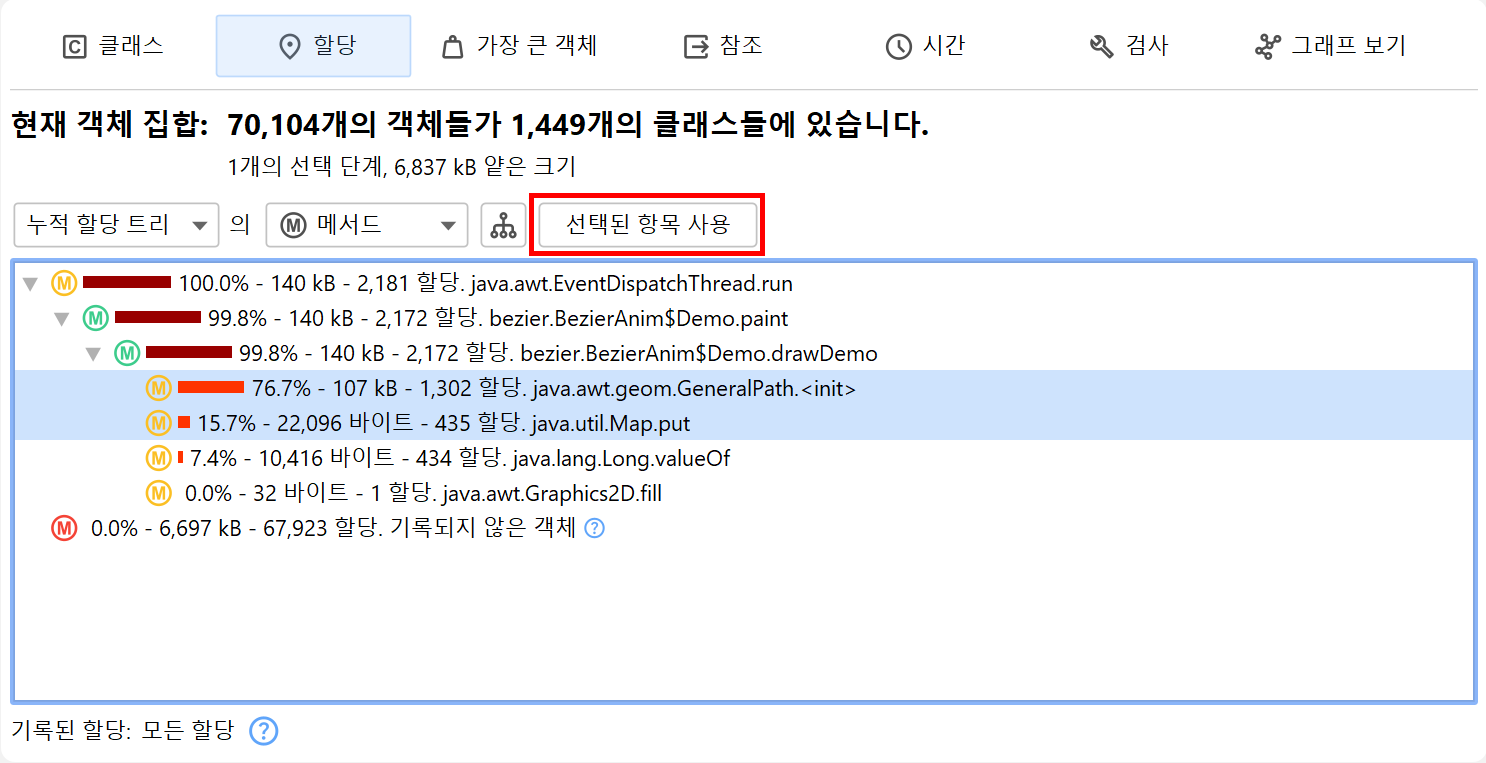
객체가 어디에서 할당되었는지에 대한 정보는 메모리 누수 원인을 좁히거나 메모리 소비를 줄이고자 할 때 중요할 수 있습니다. JProfiler 힙 스냅샷의 경우 "Allocations" 뷰는 할당이 기록된 객체에 대한 할당 호출 트리와 할당 핫스팟을 보여줍니다. 그 외의 객체는 할당 호출 트리의 "unrecorded objects" 노드로 그룹화됩니다. HPROF/PHD 스냅샷의 경우 이 뷰를 사용할 수 없습니다.
클래스 뷰와 마찬가지로 여러 노드를 선택하고 상단의 Use Selected 버튼을 사용하여 새 선택 단계를 생성할 수 있습니다. "Allocation hot spots" 뷰 모드에서는 백트레이스 내의 노드를 선택할 수도 있습니다. 이렇게 하면 선택한 백트레이스로 끝나는 호출 스택에서 할당된 연관 최상위 핫스팟의 객체만 선택됩니다.
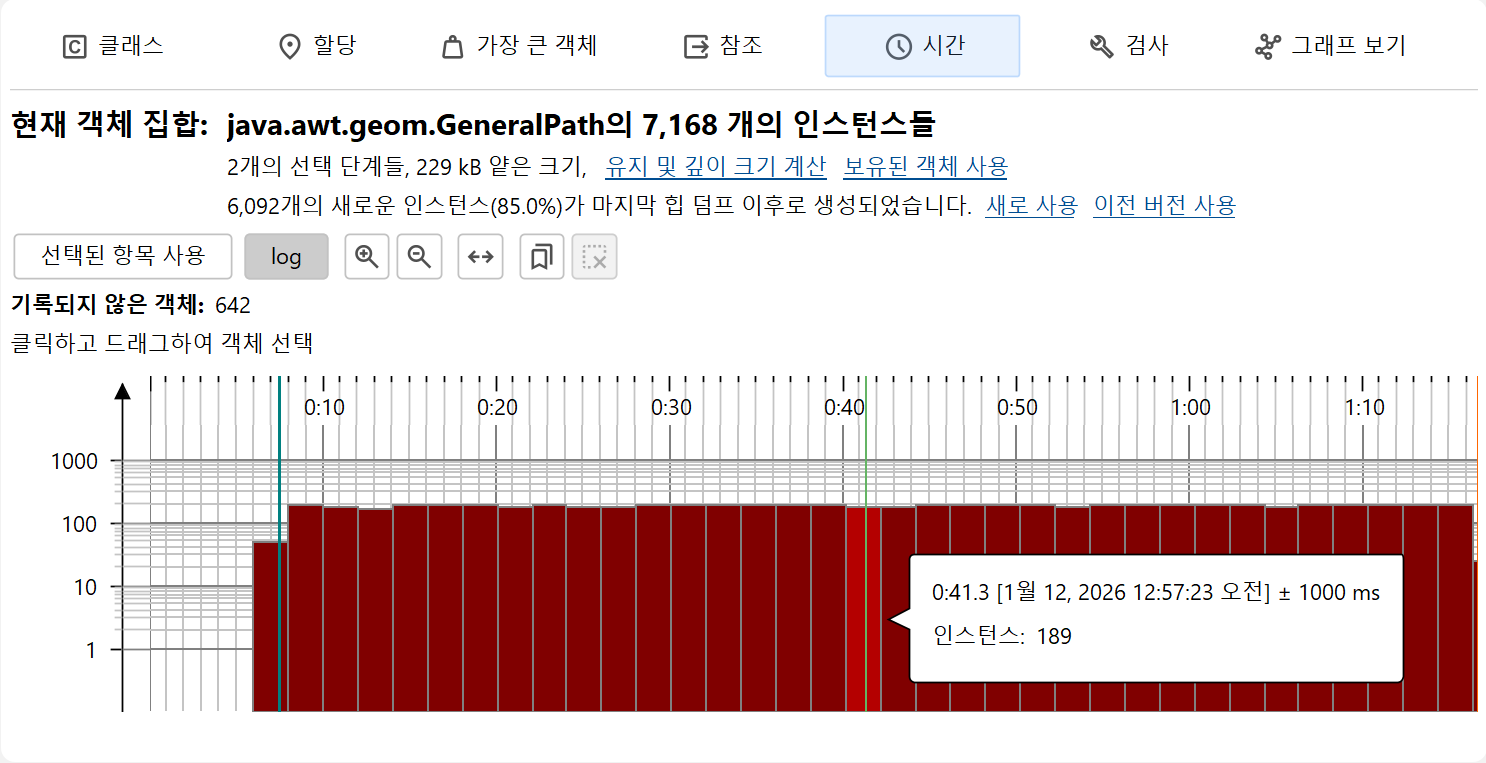
할당을 기록할 때 JProfiler가 저장할 수 있는 또 다른 정보는 객체가 할당된 시간입니다. 힙 워커의 "Time" 뷰는 현재 객체 집합에서 기록된 모든 인스턴스의 할당 시간 히스토그램을 보여줍니다. 클릭 앤 드래그로 하나 이상의 구간을 선택한 후 Use Selected 버튼을 클릭하여 새 객체 집합을 생성할 수 있습니다.
시간 구간을 보다 정밀하게 선택하기 위해 북마크 범위를 지정할 수 있습니다. 그러면 처음과 마지막으로 선택한 북마크 사이의 모든 객체가 표시됩니다.
시간 뷰 외에도 할당 시간은 참조 뷰에서 별도의 열로 표시됩니다. 하지만 할당 시간 기록은 기본적으로 활성화되어 있지 않습니다. 시간 뷰에서 직접 켜거나 세션 설정 대화상자의 Advanced Settings -> Memory Profiling에서 설정을 수정할 수 있습니다.
Biggest objects 뷰
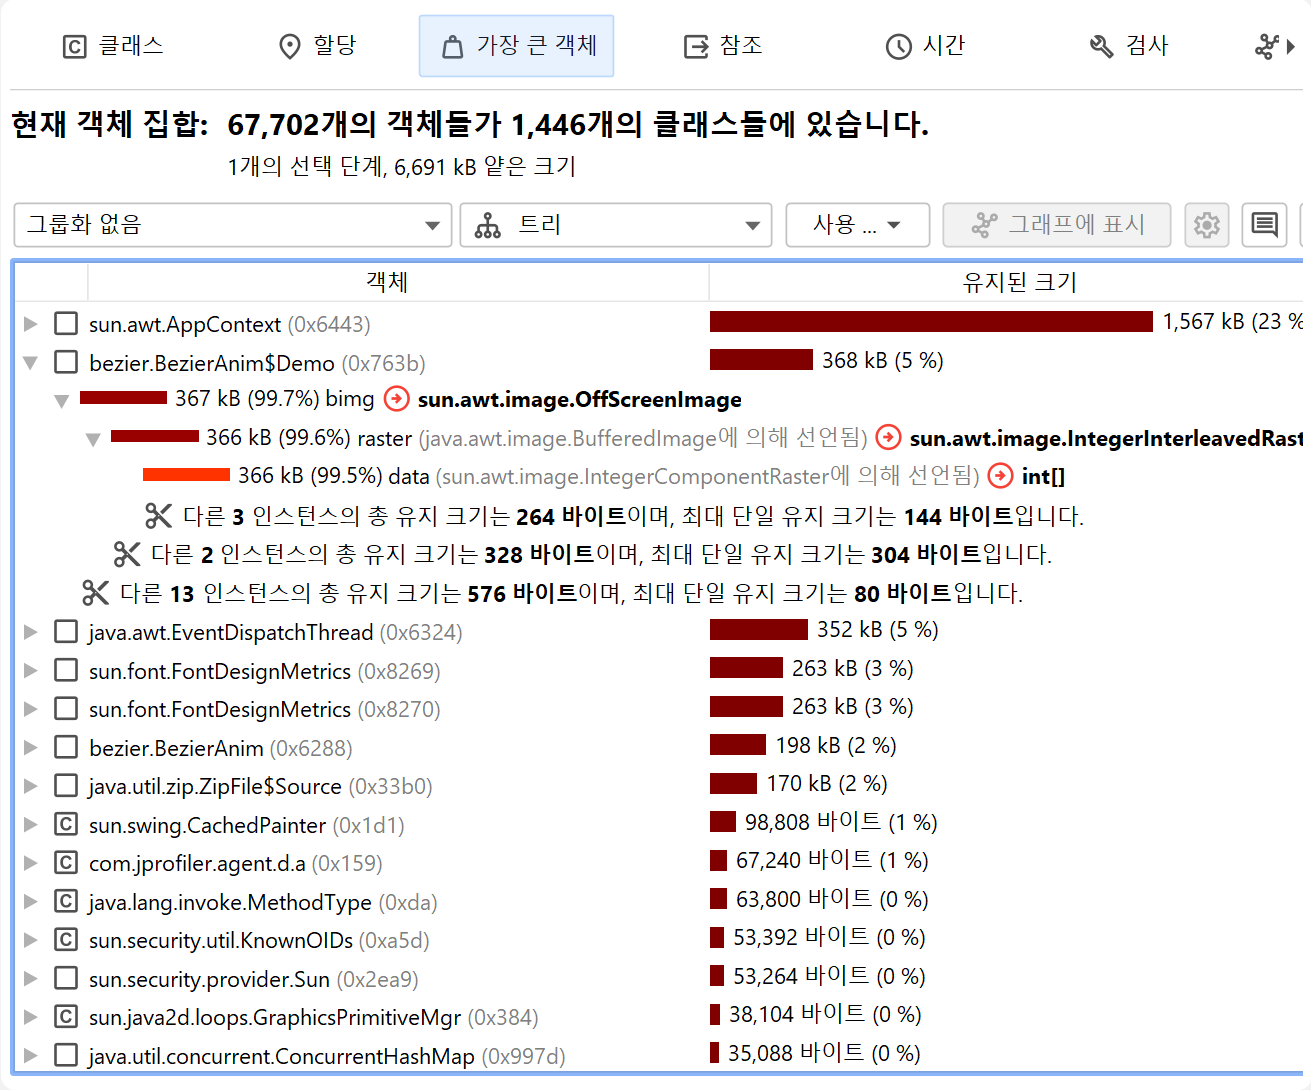
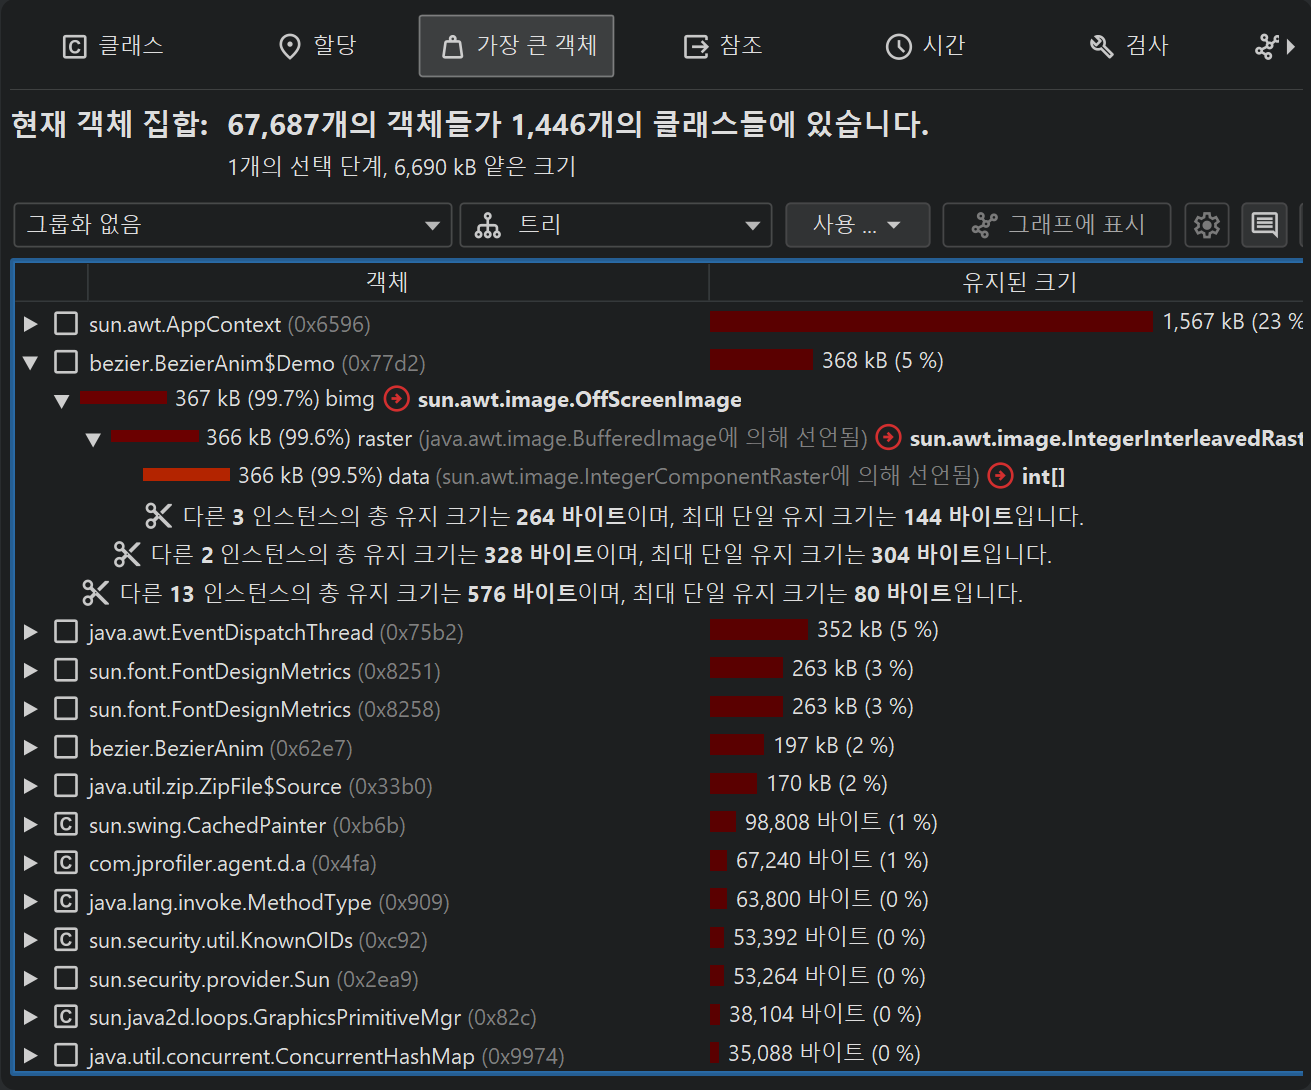
Biggest objects 뷰는 현재 객체 집합에서 가장 중요한 객체 목록을 보여줍니다. 여기서 "가장 큰(Biggest)"이라는 의미는 힙에서 제거될 경우 가장 많은 메모리를 해제할 수 있는 객체를 의미합니다. 그 크기를 보존 크기(retained size)라고 합니다. 반면에 딥 크기(deep size)는 강한 참조(strong reference)를 통해 도달할 수 있는 모든 객체의 총 크기입니다.
각 객체를 확장하여 이 객체에 의해 보존되는 다른 객체로의 나가는 참조를 확인할 수 있습니다. 이런 방식으로 상위 객체 중 하나가 제거될 경우 가비지 컬렉션될 보존 객체 트리를 재귀적으로 확장할 수 있습니다. 이러한 트리를 "도미네이터 트리(dominator tree)"라고 합니다. 이 트리에서 각 객체에 대해 표시되는 정보는 지배하는 참조만 표시된다는 점을 제외하면 나가는 참조 뷰와 유사합니다.
모든 지배되는 객체가 지배자(dominator)에 의해 직접 참조되는 것은 아닙니다. 예를 들어 다음 그림의 참조 관계를 살펴보십시오.
객체 A는 객체 B1과 B2를 지배하며, 객체 C에 대한 직접적인 참조는 가지고 있지 않습니다. B1과 B2는 모두 C를 참조합니다. B1도 B2도 C를 지배하지 못하지만 A는 C를 지배합니다. 이 경우 도미네이터 트리에서 B1, B2 및 C는 A의 직속 하위 항목으로 나열되며, C는 B1과 B2의 하위 항목으로 나열되지 않습니다. B1 및 B2의 경우 A에서 이들을 참조하고 있는 필드 이름이 표시됩니다. C의 경우 참조 노드에 "[transitive reference]"가 표시됩니다.
도미네이터 트리의 각 참조 노드 왼쪽에는 최상위 객체의 보존 크기 중 대상 객체에 의해 여전히 보존되는 비율(%)을 나타내는 크기 막대가 표시됩니다. 트리를 더 깊이 탐색할수록 수치는 감소합니다. 뷰 설정에서 백분율 기준을 전체 힙 크기로 변경할 수 있습니다.
도미네이터 트리에는 부모 객체의 보존 크기의 0.5% 미만인 보존 크기를 가진 모든 객체를 제외하는 컷오프(cutoff) 기능이 내장되어 있습니다. 컷오프 임계값 미만으로 떨어지더라도 최소 20개의 객체는 항상 표시됩니다. 이는 중요 객체에 집중하지 못하게 방해하는 작고 지배되는 객체들의 목록이 지나치게 길어지는 것을 방지하기 위함입니다. 이러한 컷오프가 발생하면 해당 레벨에서 표시되지 않은 객체 수, 총 보존 크기, 개별 객체의 최대 보존 크기를 알려주는 특별한 "cutoff" 하위 노드가 표시됩니다.
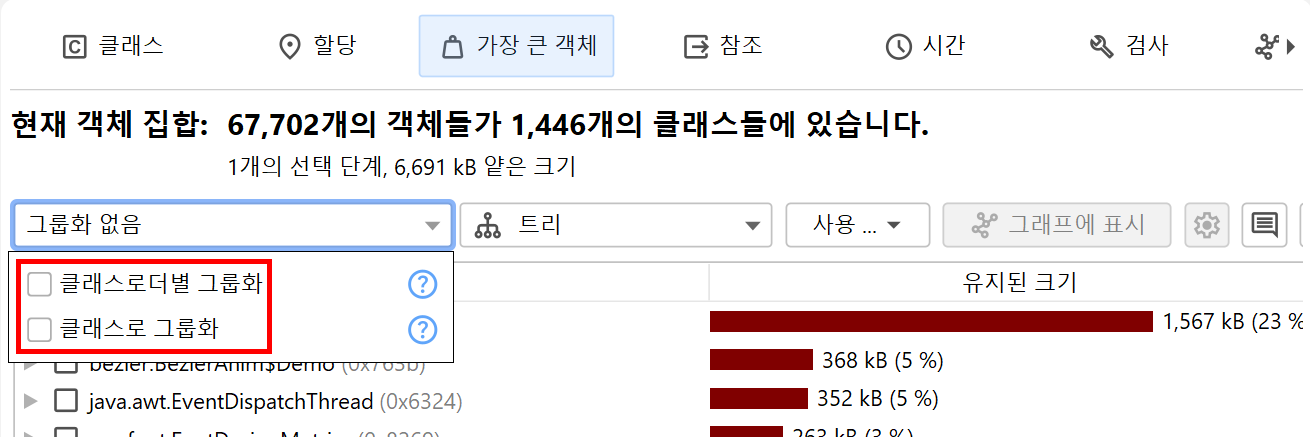
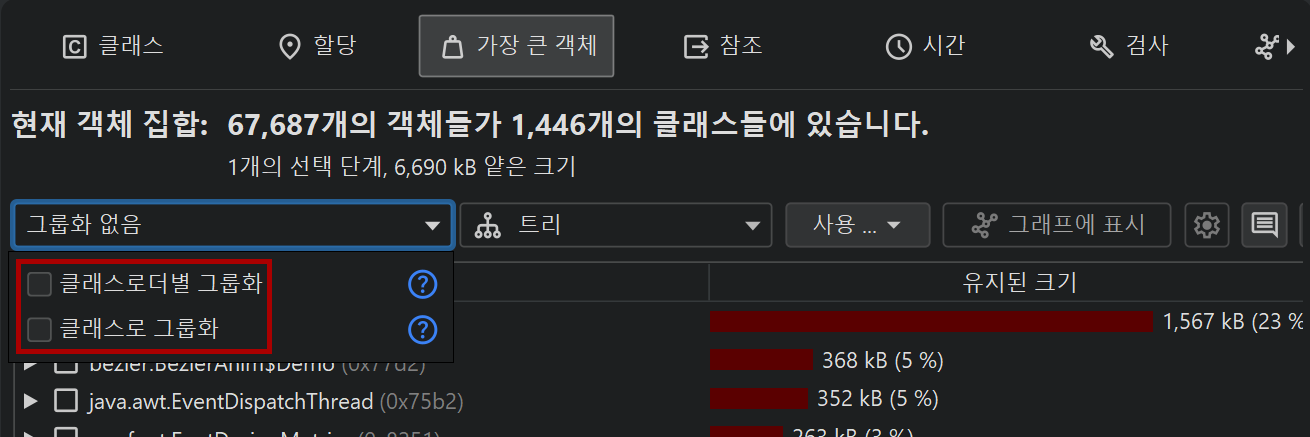
도미네이터 트리는 개별 객체를 표시하는 대신 가장 큰 객체들을 클래스별로 그룹화할 수도 있습니다. 뷰 상단의 그룹화 드롭다운에는 이 표시 모드를 활성화하는 체크박스가 있습니다. 또한 최상위 레벨에 클래스로더 그룹화를 추가할 수 있습니다. 클래스로더 그룹화는 가장 큰 객체들이 계산된 후에 적용되며 가장 큰 객체들의 클래스를 로드한 주체를 보여줍니다. 대신 특정 클래스로더에 대한 가장 큰 객체를 분석하려면 "Group by class loaders" 검사를 먼저 사용할 수 있습니다.
그룹화 드롭다운에는 가장 큰 객체를 소유한 프레임워크 컨테이너별로 그룹화하는 Group by container 체크박스가 있습니다. 이를 선택하면 최상위 레벨에 현재 객체 집합에서 감지된 컨테이너(예: Spring application context 또는 HTTP session)에 대한 컨테이너 그룹 노드만 표시되며, 해당 컨테이너가 관리하는 객체의 누적 보존 크기가 함께 표시됩니다. 지원되는 컨테이너가 감지되지 않으면 뷰는 비어 있습니다. 컨테이너는 중첩되거나 동일한 객체를 관리할 수 있으므로, 각 컨테이너의 보존 크기는 개별 풋프린트를 나타내며 반드시 단순 합산되는 것은 아닙니다.
컨테이너 노드를 확장하면 각각 고유한 보존 크기를 가진 관리 객체(예: Spring bean 또는 세션 속성)를 직접 볼 수 있습니다. 관리 객체를 확장하면 그 아래에 일반적인 도미네이터 트리가 표시됩니다.
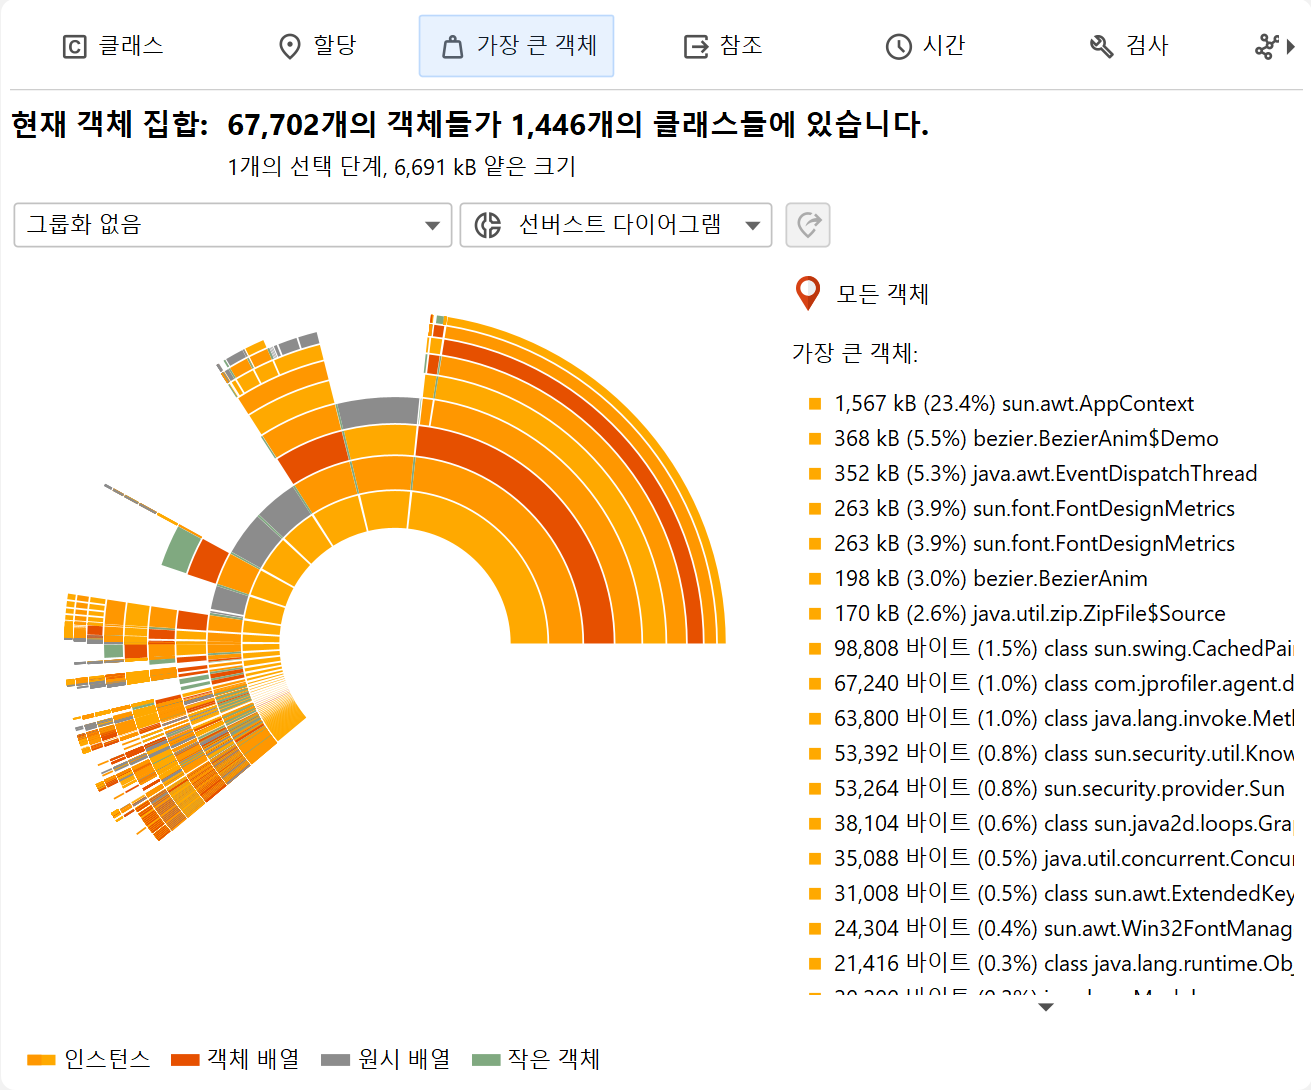
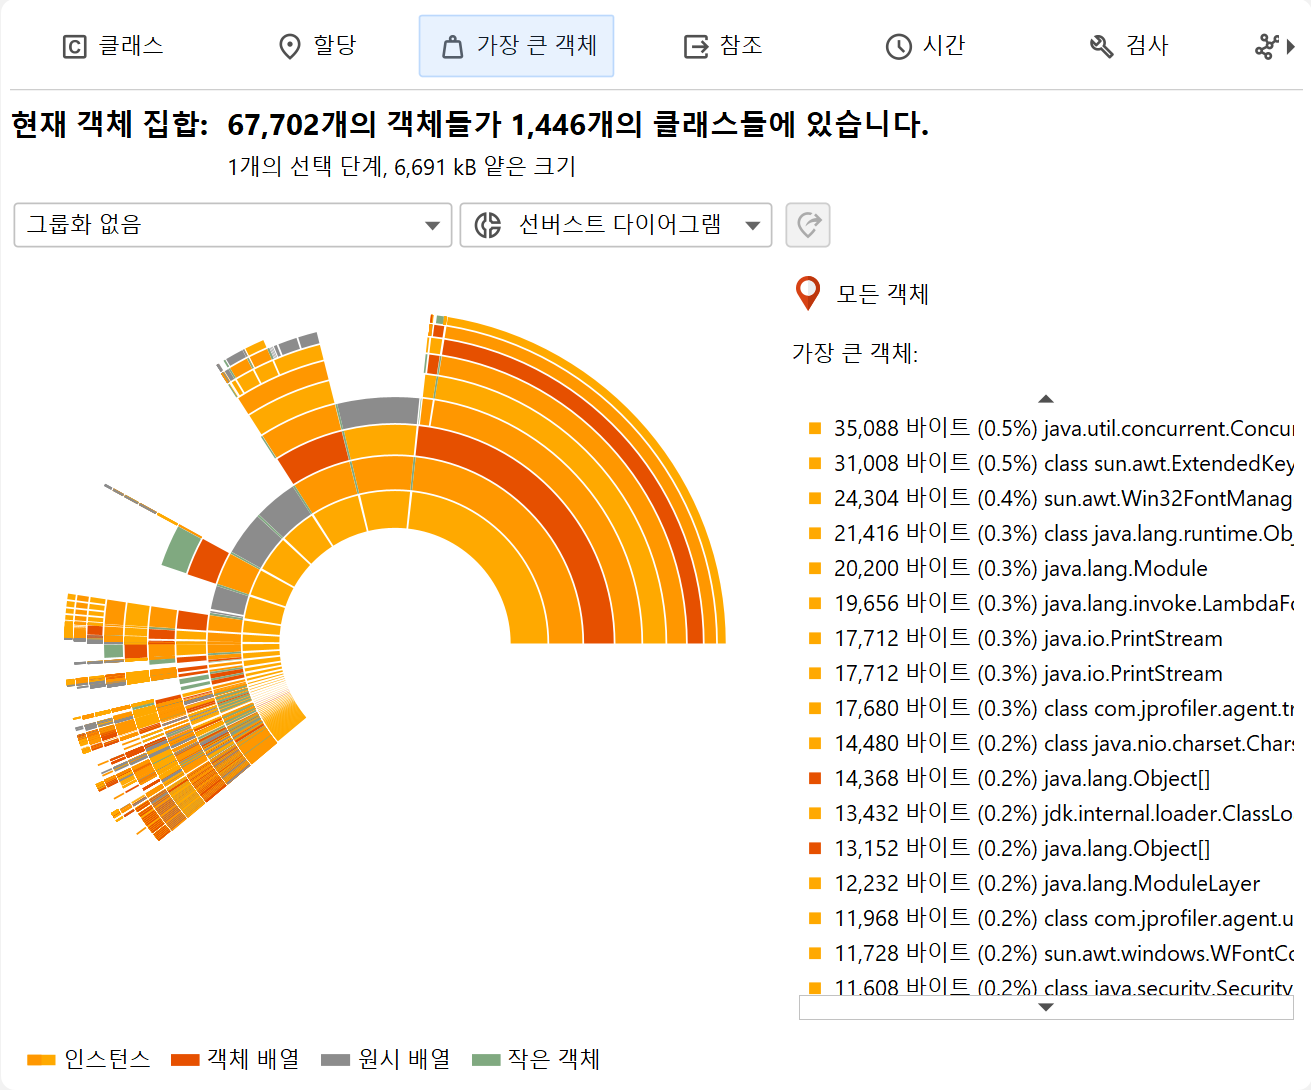
Biggest objects 뷰 상단의 뷰 모드 선택기를 사용하여 선버스트 다이어그램으로 전환할 수 있습니다. 이 다이어그램은 일련의 동심원 분할 링으로 구성되며, 도미네이터 트리의 전체 콘텐츠를 최대 깊이까지 단일 이미지로 보여줍니다. 참조는 가장 안쪽 링에서 시작하여 원의 바깥쪽 가장자리로 전파됩니다. 이러한 시각화는 정보 밀도가 높은 평면화된 관점을 제공하여 참조 패턴을 발견하고 특수 색상 코딩을 통해 큰 기본형 배열 및 객체 배열을 한눈에 확인할 수 있게 해줍니다.
현재 객체 집합이 전체 힙이고 컨테이너 그룹화가 활성화되지 않은 경우, 원의 전체 둘레는 사용된 힙 크기에 해당합니다. Biggest object 뷰는 전체 힙의 0.1% 이상을 보존하는 객체만 표시하므로, 이러한 가장 큰 객체들에 의해 보존되지 않는 모든 객체에 해당하는 상당한 부채꼴 영역이 비어 있게 됩니다. 컨테이너 그룹화를 사용하는 경우 전체 둘레는 표시된 모든 컨테이너 풋프린트의 합에 해당합니다. 컨테이너는 중첩될 수 있으므로 이 합계는 사용된 힙 크기를 초과할 수 있습니다. 이 모드에서는 표시된 컨테이너 외부의 객체에 대한 빈 부채꼴 영역이 표시되지 않습니다.
임의의 링 세그먼트를 클릭하면 원의 새 루트가 설정되어 다이어그램에서 볼 수 있는 최대 깊이가 확장됩니다. 다이어그램의 빈 중앙을 클릭하면 이전 루트로 복원됩니다. 새 루트가 설정된 경우 원의 전체 둘레는 루트 객체의 보존 크기에 해당합니다. 컨테이너 루트의 경우 관리되는 객체의 누적 보존 크기에 해당합니다. 빈 부채꼴 영역은 일반 루트 객체의 자체 크기(self-size)와 가장 큰 보존 객체 목록에 없는 추가 객체를 나타냅니다. 현재 객체 집합이 전체 힙이 아니고 새 루트가 설정되지 않은 경우 전체 둘레는 표시된 모든 가장 큰 객체의 합에 해당하며 빈 부채꼴 영역은 표시되지 않습니다. 컨테이너 루트 역시 그 크기가 표시된 관리 객체의 합이므로 빈 부채꼴 영역이 없습니다.
마우스를 올리면 인스턴스와 직접 보존된 객체에 대한 추가 정보가 다이어그램 오른쪽에 표시됩니다. 컨테이너의 경우 측면 패널에 관리되는 객체가 대신 표시됩니다. 마우스가 링 세그먼트 바깥에 있을 때 오른쪽 목록에는 가장 안쪽 링의 가장 큰 객체들이 표시됩니다. 해당 목록 위에 마우스를 올리면 해당하는 링 세그먼트가 강조 표시되고, 목록 항목을 클릭하면 다이어그램의 새 루트가 설정됩니다. 새 객체 집합을 생성하려면 링 세그먼트와 목록 항목 모두에서 컨텍스트 메뉴의 액션을 선택할 수 있습니다.
참조 뷰
이전 뷰들과 달리 참조 뷰는 최소한 하나의 선택 단계를 수행한 경우에만 사용할 수 있습니다. 들어오는 참조 뷰와 나가는 참조 뷰는 모든 개별 객체를 표시하고 병합된 참조 뷰는 집중된 객체 집합에 대해서만 해석될 수 있으므로 초기 객체 집합에 대해서는 이러한 뷰가 유용하지 않습니다.
나가는 참조 뷰는 IDE에서 디버거가 보여주는 뷰와 유사합니다. 객체를 열면 기본형 데이터와 다른 객체로의 참조를
볼 수 있습니다. 모든 참조 유형을 새 객체 집합으로 선택할 수 있으며 여러 객체를 한 번에 선택할 수도 있습니다.
클래스 뷰에서와 마찬가지로 보존된 객체 또는 연관된 java.lang.Class 객체를 선택할 수 있습니다.
선택한 객체가 표준 컬렉션인 경우 한 번의 액션으로 포함된 모든 요소를 선택할 수도 있습니다. 클래스로더 객체의 경우
로드된 모든 인스턴스를 선택하는 옵션이 있습니다.
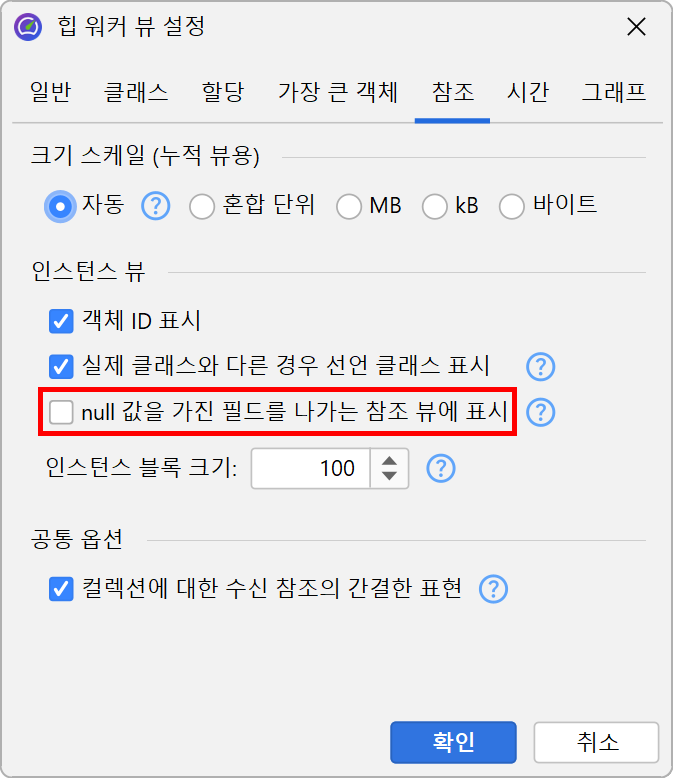
null 참조가 있는 필드는 메모리 분석에 방해가 될 수 있으므로 기본적으로 표시되지 않습니다. 디버깅 목적으로 모든 필드를 보려면 뷰 설정에서 이 동작을 변경할 수 있습니다.
표시된 인스턴스의 단순한 선택 외에도 나가는 참조 뷰에는 강력한 필터링 기능이 있습니다. 라이브 세션의 경우 나가는 참조 뷰와 들어오는 참조 뷰 모두 고급 조작 및 표시 기능을 제공하며, 이는 동일한 장에서 설명합니다.
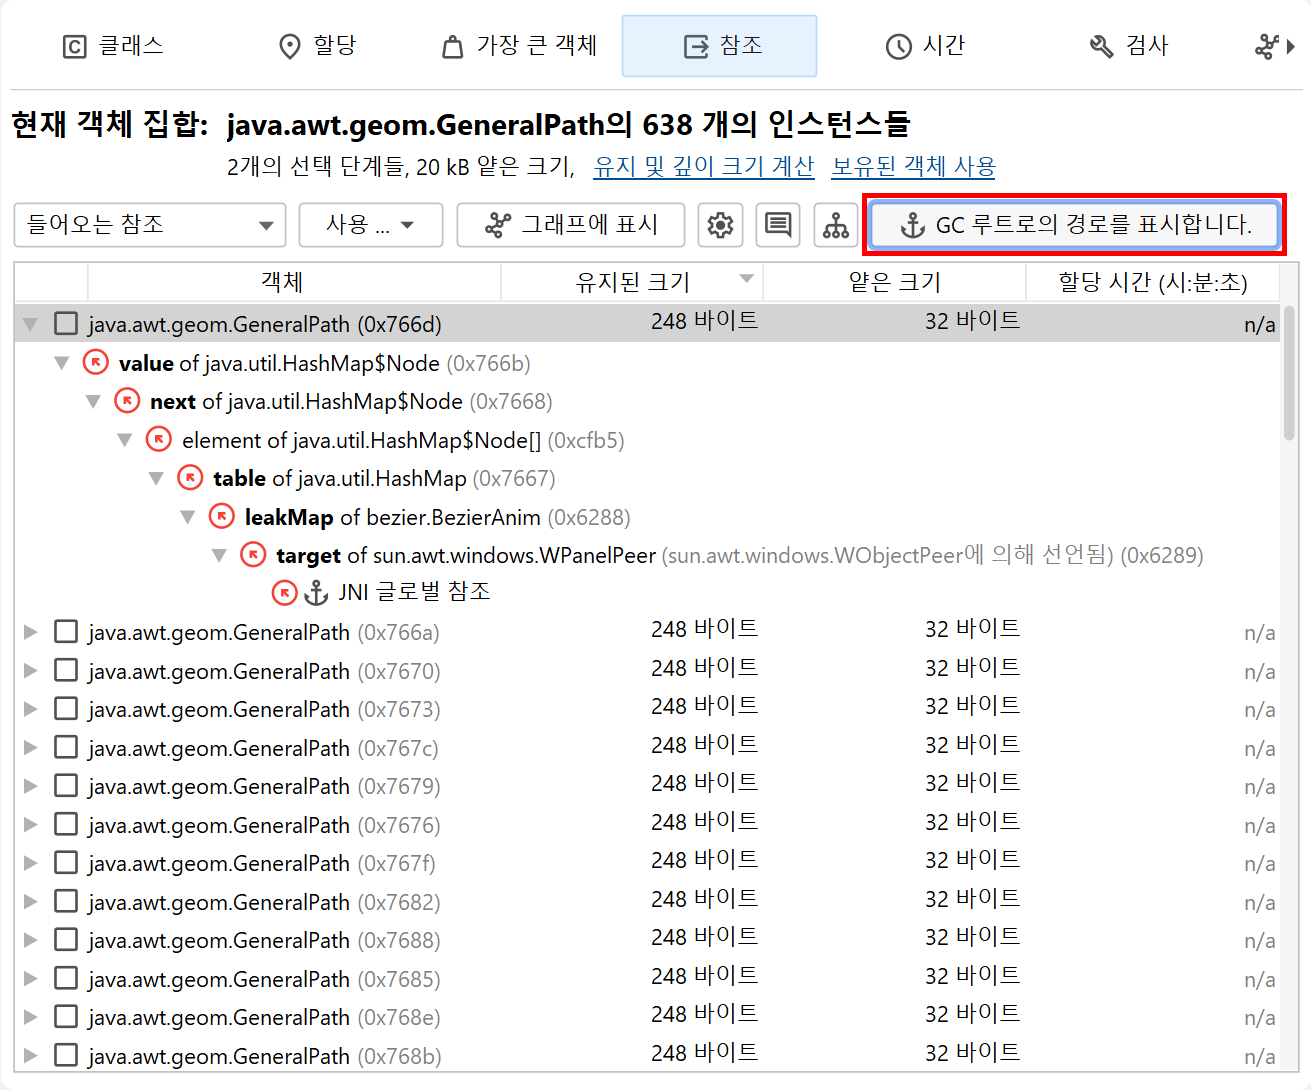
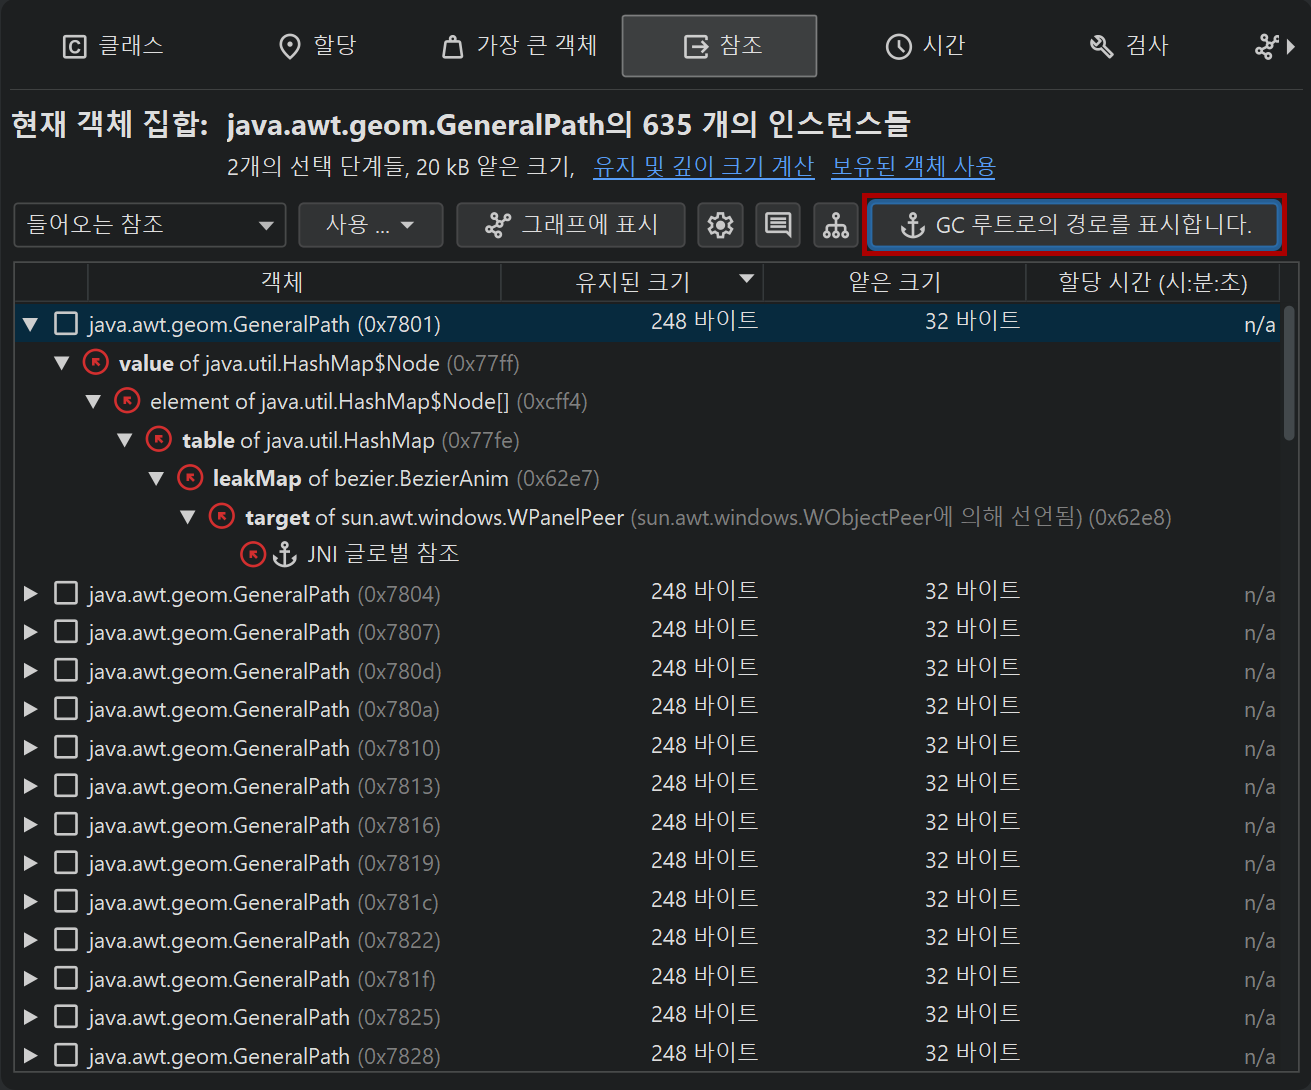
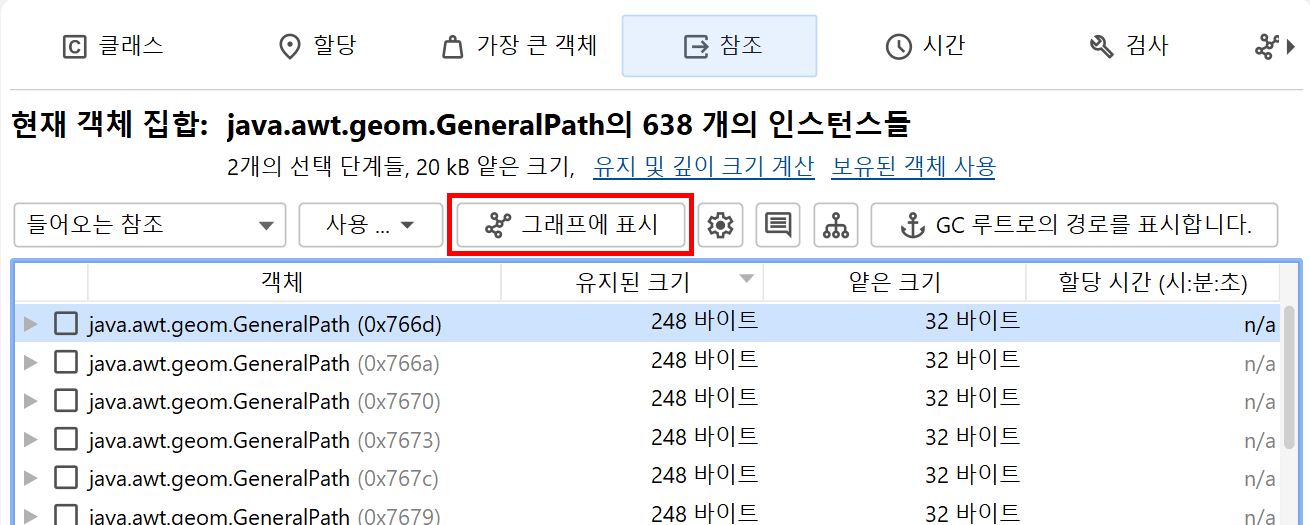
들어오는 참조 뷰는 메모리 누수를 해결하기 위한 주요 도구입니다. 객체가 왜 가비지 컬렉션되지 않는지 확인하려면 Show Paths To GC Root 버튼을 통해 가비지 컬렉터 루트로 이어지는 참조 체인을 찾을 수 있습니다. 메모리 누수에 관한 장에서 이 중요한 주제에 대한 자세한 정보를 제공합니다.
병합된 참조
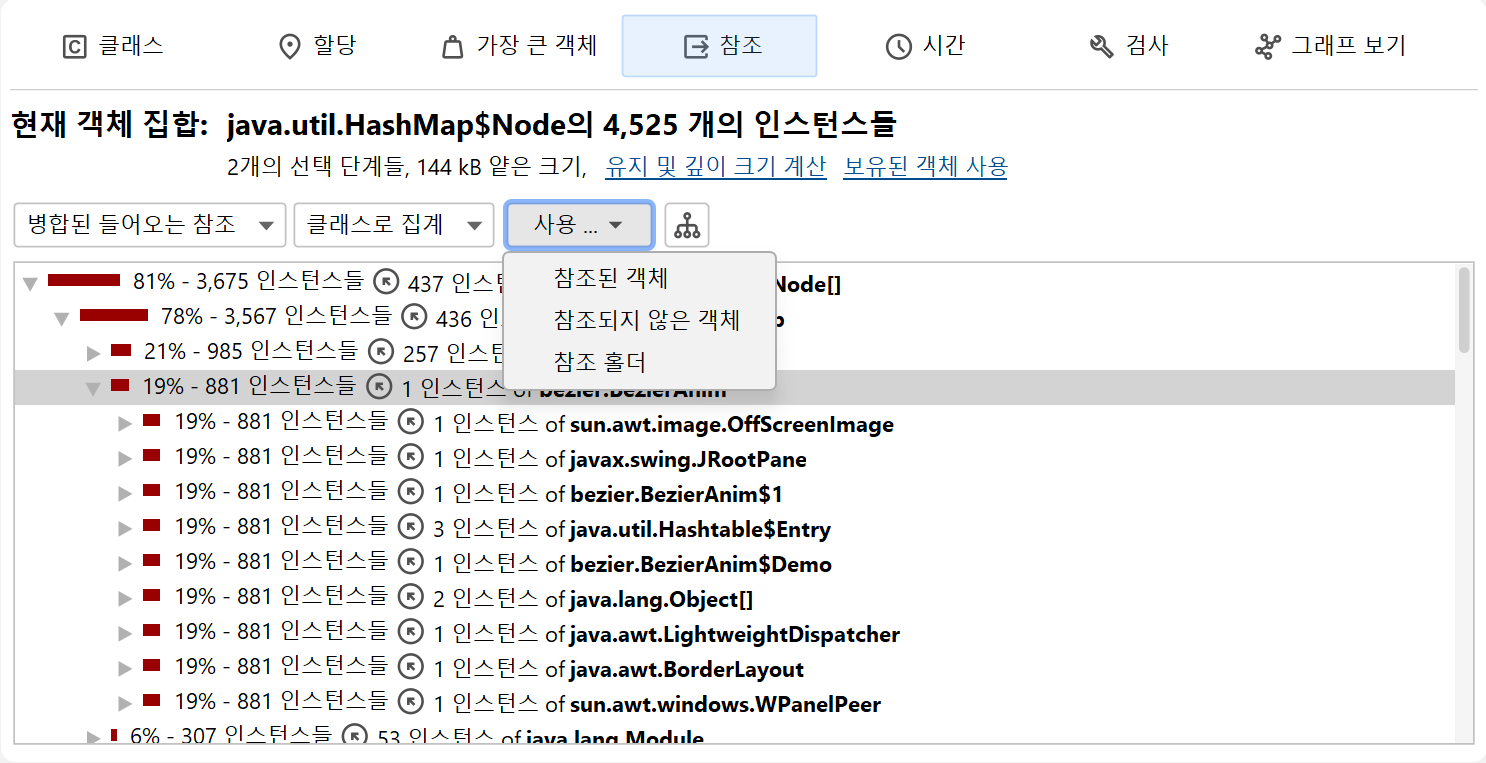
수많은 다양한 객체에 대한 참조를 확인하는 것은 번거로운 작업일 수 있으므로, JProfiler는 현재 객체 집합에 있는 모든 객체의 병합된 나가는 참조 및 들어오는 참조를 보여줄 수 있습니다. 기본적으로 참조는 클래스별로 집계됩니다. 어떤 클래스의 인스턴스가 동일한 클래스의 다른 인스턴스에 의해 참조되는 경우, 원래 인스턴스와 이러한 클래스 재귀적 참조의 인스턴스를 함께 보여주는 특별 노드가 삽입됩니다. 이 메커니즘은 연결 리스트와 같은 일반적인 데이터 구조에서 내부 참조 체인을 자동으로 축소합니다.
병합된 참조를 필드별로 그룹화하여 표시하도록 선택할 수도 있습니다. 이 경우 각 노드는 클래스의 특정 필드나 배열의 내용과 같은 참조 유형이 됩니다. 표준 컬렉션의 경우 누적을 깨뜨릴 수 있는 내부 참조 체인이 압축되므로 "map value of java.util.HashMap"과 같은 참조 유형을 볼 수 있습니다. 클래스 집계와 달리 이 메커니즘은 JRE의 표준 라이브러리에서 명시적으로 지원되는 컬렉션에 대해서만 작동합니다.
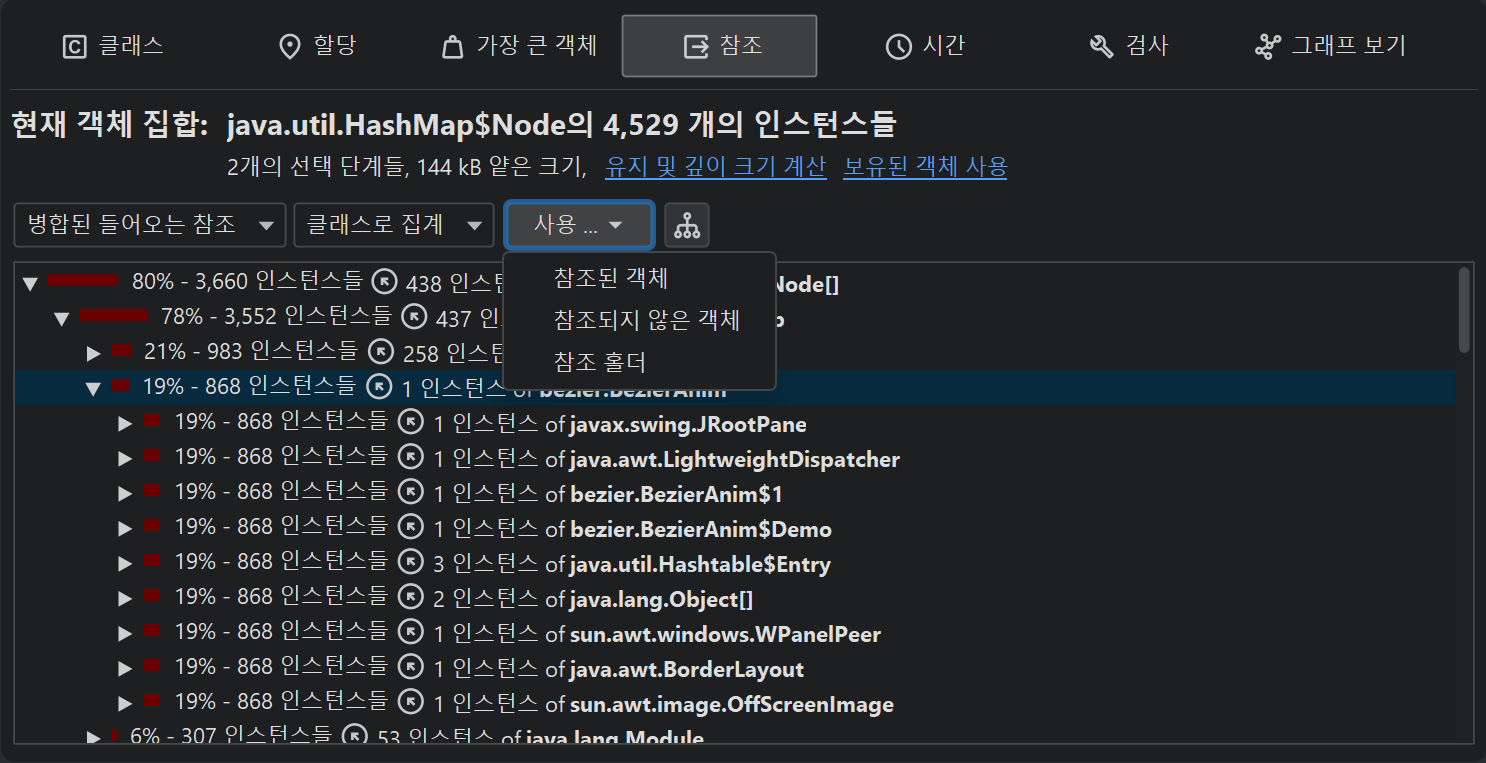
"Merged outgoing references" 뷰에서 인스턴스 수는 참조된 객체를 가리킵니다. "Merged incoming references" 뷰에서는 각 행에 두 개의 인스턴스 수가 표시됩니다. 첫 번째 인스턴스 수는 현재 객체 집합에서 이 경로를 따라 참조되는 인스턴스 수를 나타냅니다. 노드 왼쪽의 막대 아이콘은 이 비율을 시각화합니다. 화살표 아이콘 뒤의 두 번째 인스턴스 수는 상위 노드에 대한 참조를 보유한 객체를 나타냅니다. 선택 단계를 수행할 때 선택된 방식으로 참조되는 현재 객체 집합의 객체를 선택할지, 아니면 선택된 참조를 가진 객체(참조 보유자)에 관심이 있는지 선택할 수 있습니다.
"Merged dominating references" 뷰를 사용하면 현재 객체 집합의 일부 또는 모든 객체가 가비지 컬렉션될 수 있도록 제거해야 하는 참조가 무엇인지 확인할 수 있습니다. 지배 참조 트리는 클래스별로 집계된 Biggest objects 뷰의 도미네이터 트리의 병합된 역(inverse)으로 해석할 수 있습니다. 참조 화살표는 두 클래스 간의 직접적인 참조를 나타내지 않을 수도 있으며 그 사이에 비지배(non-dominating) 참조를 보유한 다른 클래스가 있을 수 있습니다. 가비지 컬렉터 루트가 여러 개인 경우 현재 객체 집합의 일부 또는 전체 객체에 대해 지배 참조가 존재하지 않을 수 있습니다.
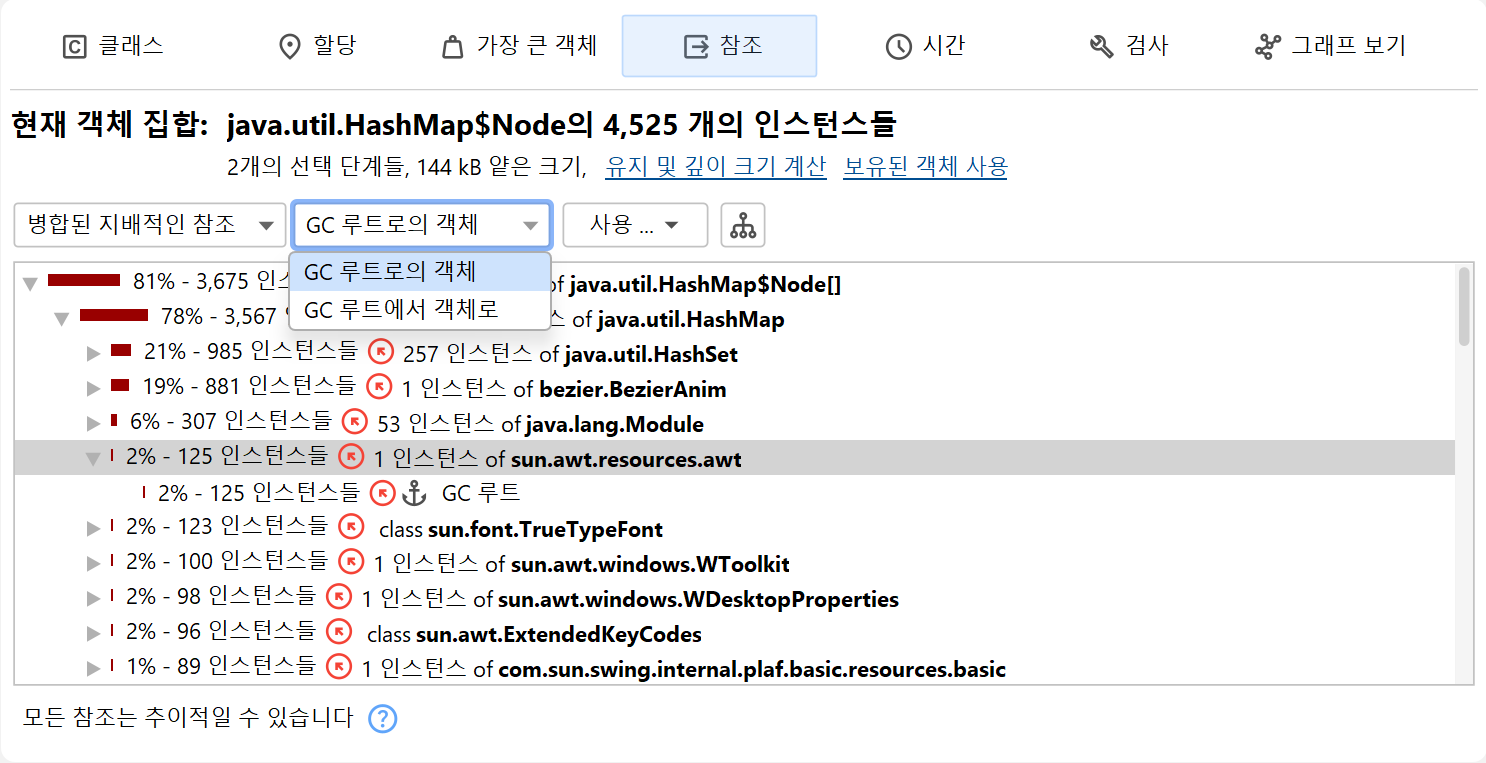
기본적으로 "Merged dominating references" 뷰는 들어오는 지배 참조를 보여주며 트리를 열어 GC 루트에 의해 유지되는 객체에 도달할 수 있습니다. 때로는 참조 트리가 여러 다른 경로를 따라 동일한 루트 객체로 이어질 수도 있습니다. 뷰 상단의 드롭다운에서 "GC roots to objects" 뷰 모드를 선택하면 루트가 최상위 레벨에 있고 현재 객체 집합의 객체가 리프 노드에 있는 반대 관점을 볼 수 있습니다. 이 경우 참조는 최상위 레벨에서 리프 노드 방향으로 진행됩니다. 제거하려는 참조가 현재 객체 집합에 가까운지 아니면 GC 루트에 가까운지에 따라 어느 관점이 더 좋은지 결정됩니다.
검사
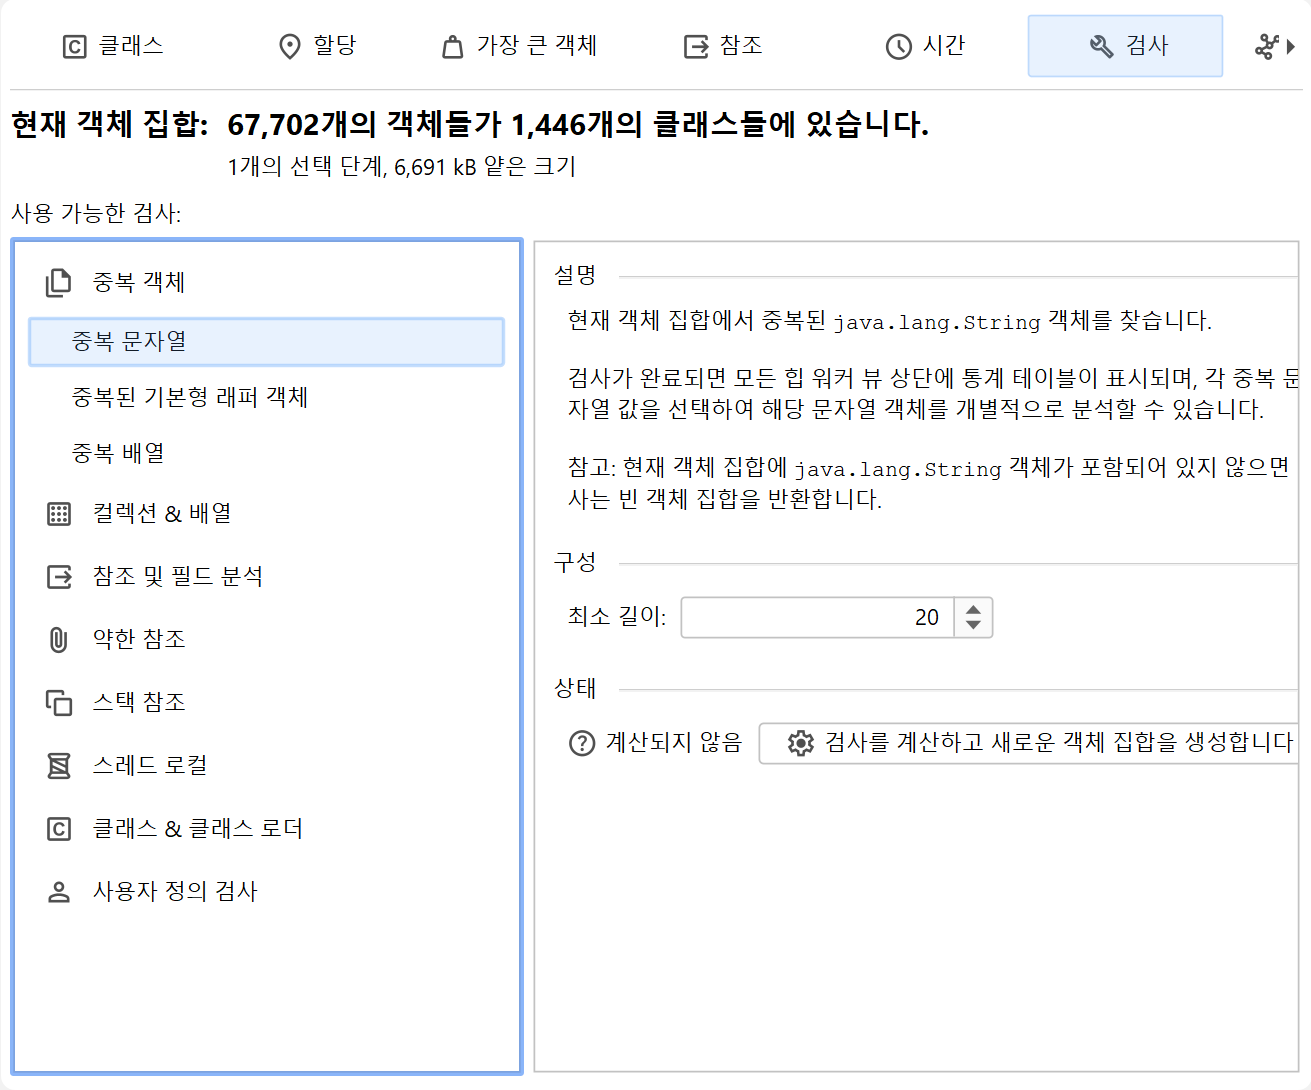
"Inspections" 뷰는 자체적으로 데이터를 표시하지 않습니다. 대신 다른 뷰에서는 제공되지 않는 규칙에 따라 새 객체 집합을 생성하는 다양한 힙 분석을 제공합니다. 예를 들어 스레드 로컬(thread local)에 의해 보존되는 모든 객체를 확인하고 싶을 수 있습니다. 이는 참조 뷰에서는 불가능합니다. 검사는 여러 범주로 그룹화되어 있으며 각 설명에 자세히 안내되어 있습니다.
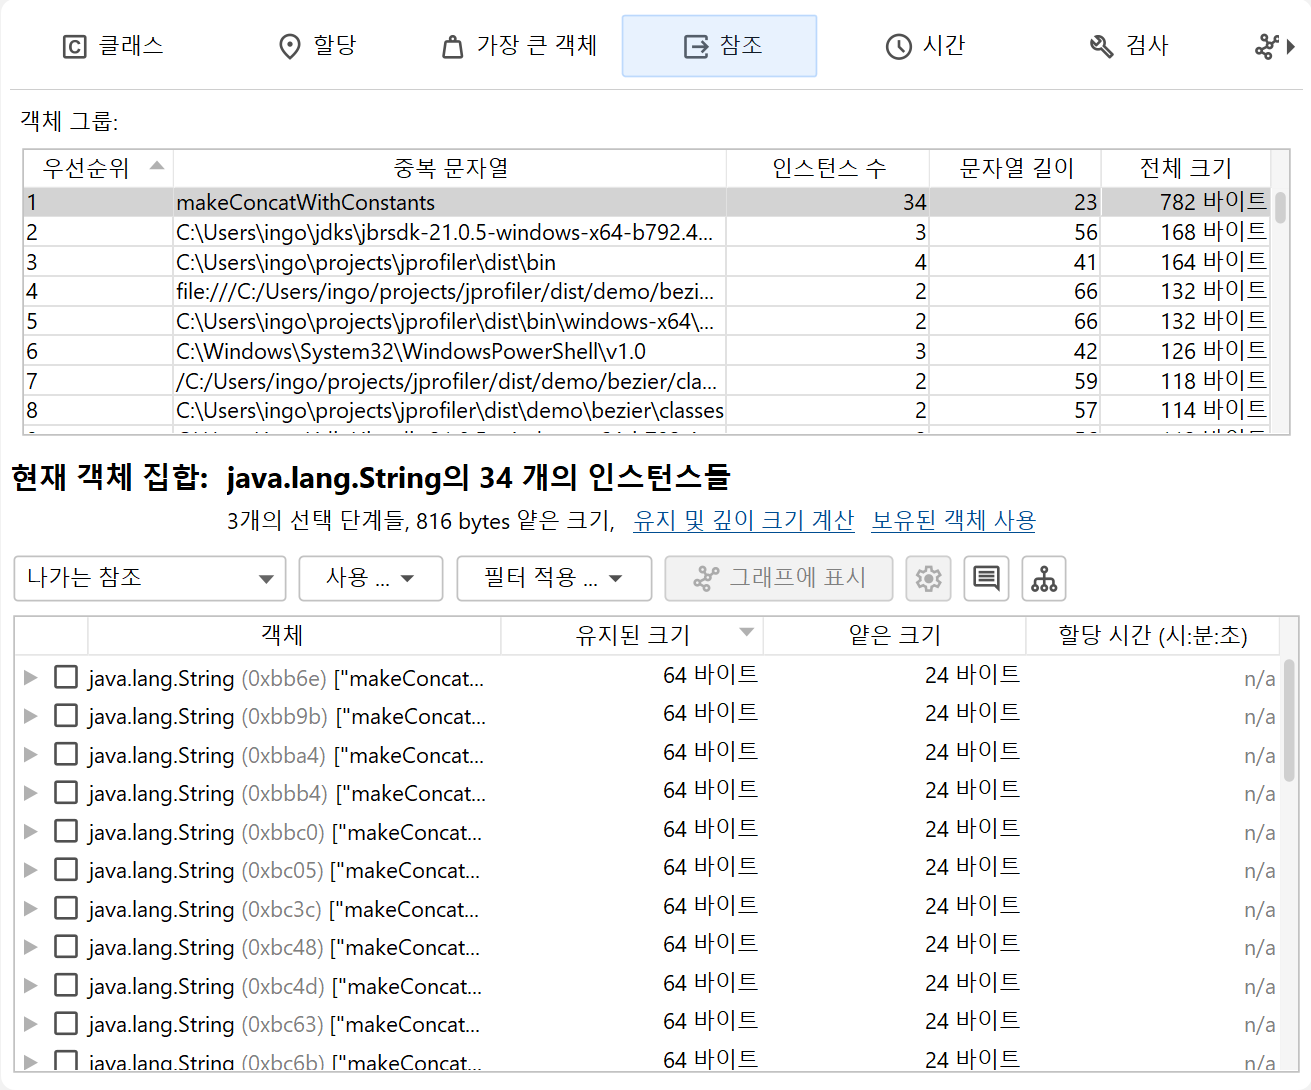
검사는 계산된 객체 집합을 여러 그룹으로 나눌 수 있습니다. 그룹은 힙 워커 상단의 테이블에 표시됩니다.
예를 들어 "Duplicate strings" 검사는 중복된 문자열 값을 그룹으로 표시합니다. 참조 뷰에 있는 경우 아래에서
선택한 문자열 값을 가진 java.lang.String 인스턴스를 볼 수 있습니다. 처음에는 그룹 테이블의
첫 번째 행이 선택되어 있습니다. 선택을 변경하면 현재 객체 집합이 변경됩니다. 그룹 테이블의 Instance Count 및
Size 열은 행을 선택했을 때 현재 객체 집합의 크기가 얼마나 될지 알려줍니다.
그룹 선택은 힙 워커에서 별도의 선택 단계가 아니라 검사에 의해 생성된 선택 단계의 일부가 됩니다. 하단의 선택 단계 창에서 그룹 선택을 확인할 수 있습니다. 그룹 선택을 변경하면 선택 단계 창이 즉시 업데이트됩니다.
그룹을 생성하는 각 검사는 해당 검사의 맥락에서 어떤 그룹이 가장 중요한지 결정합니다. 이것이 다른 열 중 하나의 자연스러운 정렬 순서와 항상 일치하지는 않으므로, 그룹 테이블의 Priority 열에는 검사에 대한 정렬 순서를 강제하는 숫자 값이 포함됩니다.
대용량 힙의 경우 검사 계산 비용이 많이 들 수 있으므로 결과가 캐시됩니다. 이를 통해 기다릴 필요 없이 히스토리에서 뒤로 이동하여 이전에 계산된 검사 결과를 확인할 수 있습니다.
힙 워커 그래프
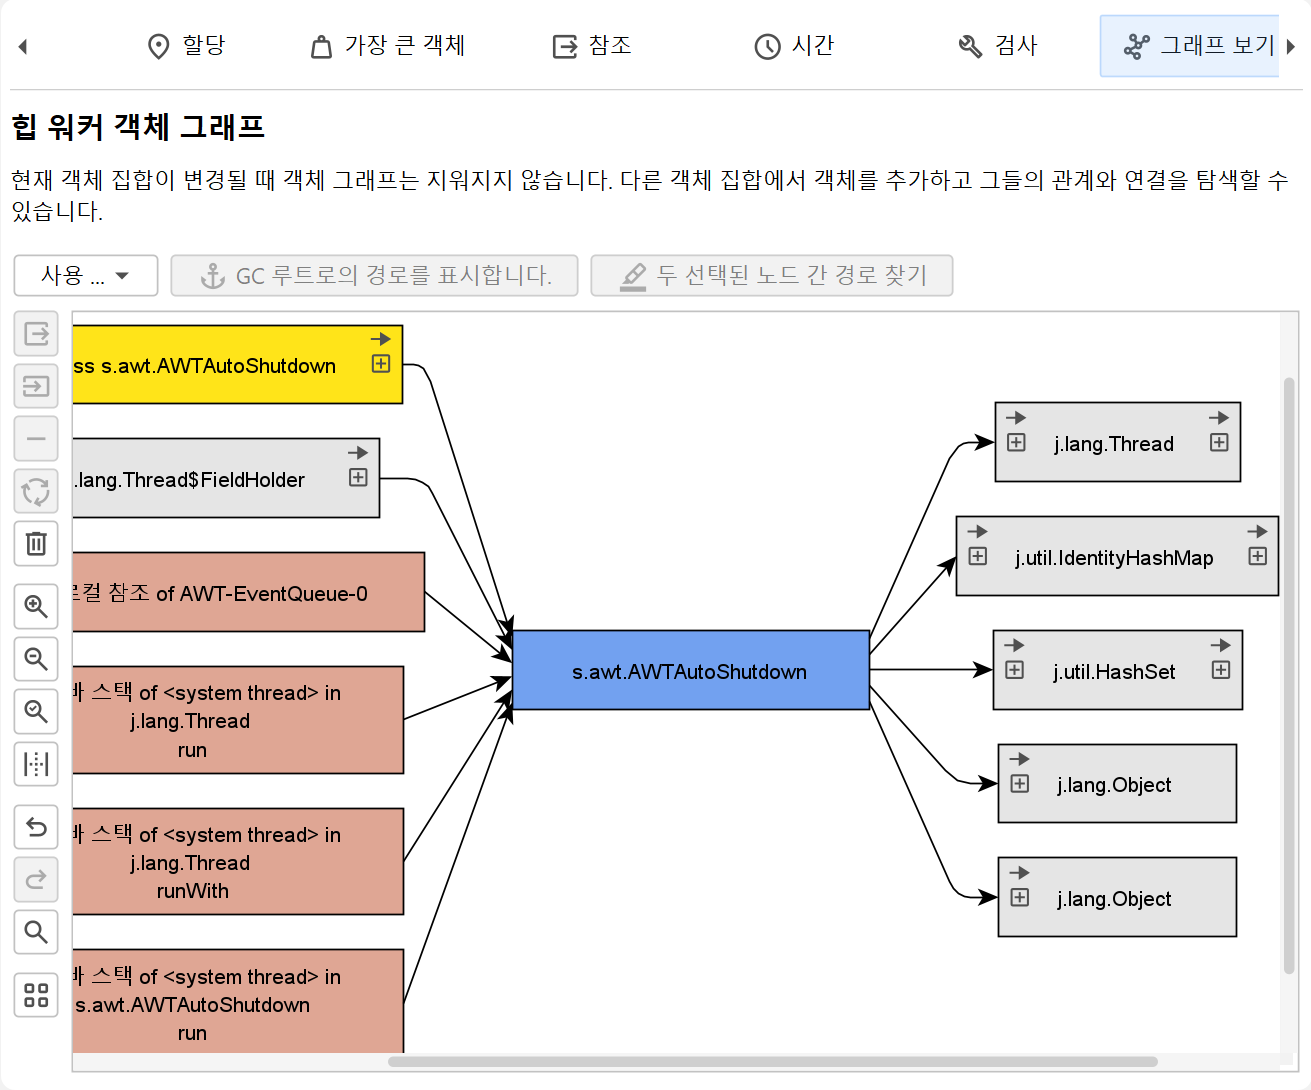
참조와 함께 인스턴스를 가장 현실적으로 표현하는 방법은 그래프입니다. 그래프는 시각적 밀도가 낮고 일부 유형의 분석에는 실용적이지 않지만, 객체 간의 관계를 시각화하는 데에는 여전히 최선의 방법입니다. 예를 들어 순환 참조는 트리 구조에서는 해석하기 어렵지만 그래프에서는 즉시 명확하게 드러납니다. 또한 들어오는 참조와 나가는 참조를 함께 볼 수 있다는 장점도 있는데, 둘 중 하나만 볼 수 있는 트리 구조에서는 이것이 불가능합니다.
힙 워커 그래프는 현재 객체 집합의 객체를 자동으로 표시하지 않으며, 현재 객체 집합을 변경해도 지워지지 않습니다. 나가는 참조 뷰, 들어오는 참조 뷰 또는 Biggest objects 뷰에서 하나 이상의 인스턴스를 선택하고 Show In Graph 액션을 사용하여 선택한 객체를 그래프에 수동으로 추가합니다.
그래프의 패키지 이름은 기본적으로 축약되어 표시됩니다. CPU 호출 그래프와 마찬가지로 뷰 설정에서 전체 표시를 활성화할 수 있습니다. 참조는 화살표로 그려집니다. 참조 위에 마우스를 올리면 해당 참조에 대한 세부 정보를 보여주는 툴팁 창이 표시됩니다. 참조 뷰에서 수동으로 추가된 인스턴스는 파란색 배경을 갖습니다. 인스턴스가 더 최근에 추가되었을수록 배경색이 더 어두워집니다. 가비지 컬렉터 루트는 빨간색 배경을 가지며, 클래스는 노란색 배경을 가집니다.
기본적으로 참조 그래프는 현재 인스턴스의 직접적인 들어오는 참조 및 나가는 참조만 표시합니다. 아무 객체나 더블 클릭하여 그래프를 확장할 수 있습니다. 이렇게 하면 이동하는 방향에 따라 해당 객체의 직접적인 들어오는 참조 또는 직접적인 나가는 참조가 확장됩니다. 인스턴스의 왼쪽과 오른쪽에 있는 확장 컨트롤을 사용하면 들어오는 참조와 나가는 참조를 선택적으로 열 수 있습니다. 단계를 되짚어가야 하는 경우 실행 취소(undo) 기능을 사용하여 그래프의 이전 상태를 복원함으로써 너무 많은 노드로 인해 혼란스러워지는 것을 방지할 수 있습니다. 그래프를 정리하기 위해 연결되지 않은 모든 노드를 제거하거나 모든 객체를 제거하는 액션도 제공됩니다.
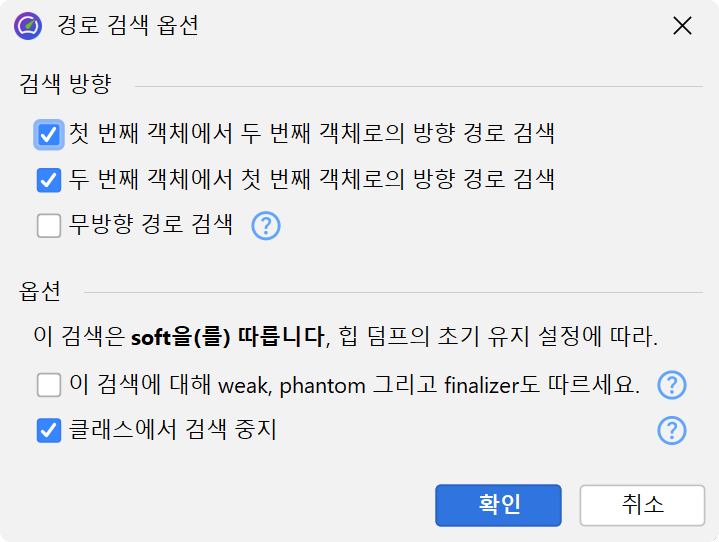
들어오는 참조 뷰와 마찬가지로 그래프에는 사용 가능한 경우 가비지 컬렉터 루트로 이어지는 하나 이상의 참조 체인을 확장하는 Show Paths To GC Root 버튼이 있습니다. 또한 두 인스턴스가 선택되었을 때 활성화되는 Find Path Between Two Selected Nodes 액션도 있습니다. 이 액션은 방향성 경로 및 무방향성 경로를 검색할 수 있으며 선택적으로 약한 참조를 따라서도 검색할 수 있습니다. 적합한 경로가 발견되면 빨간색으로 표시됩니다.
초기 객체 집합
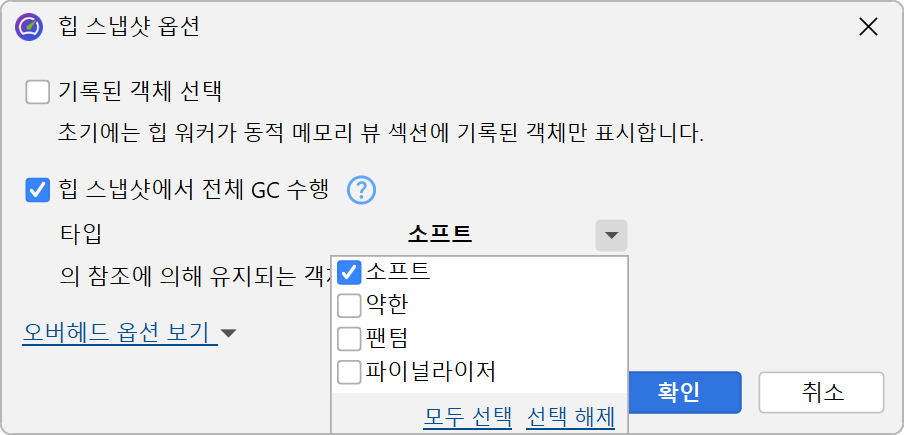
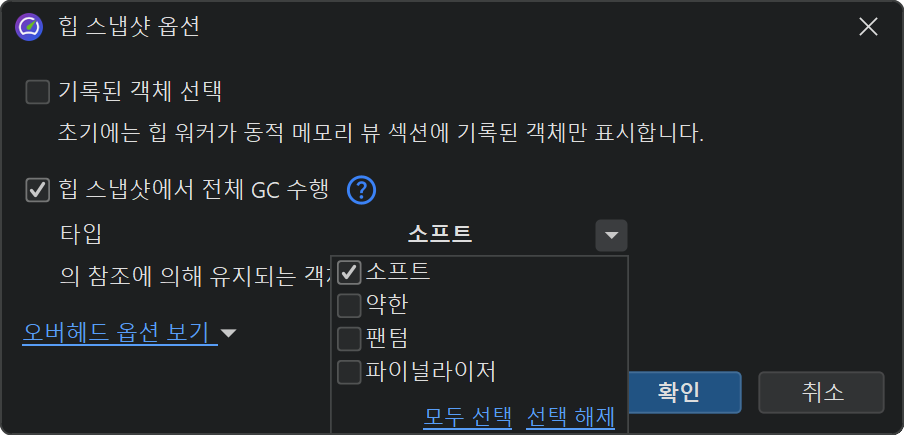
힙 스냅샷을 찍을 때 초기 객체 집합을 제어하는 옵션을 지정할 수 있습니다. 할당을 기록한 경우, Select recorded objects 체크박스를 통해 처음에 표시되는 객체를 기록된 객체로 제한합니다. 힙 워커에 의해 참조되지 않는 객체가 제거되므로 이 수치는 일반적으로 라이브 메모리 뷰의 수치와 다릅니다. 기록되지 않은 객체도 힙 스냅샷에 여전히 존재하며, 초기 객체 집합에만 표시되지 않을 뿐입니다. 추가 선택 단계를 통해 기록되지 않은 객체에 도달할 수 있습니다.
또한 힙 워커는 가비지 컬렉션을 수행하고 소프트 참조(soft reference)를 제외한 약하게 참조된 객체를 제거합니다. 강하게 참조된 객체만 관련된 메모리 누수를 찾을 때 약하게 참조된 객체는 방해가 되므로 이는 일반적으로 바람직합니다. 그러나 약하게 참조된 객체에 관심이 있는 경우, 힙 워커에 해당 객체를 유지하도록 지정할 수 있습니다. JVM의 4가지 약한 참조 유형은 "soft", "weak", "phantom", "finalizer"이며, 힙 스냅샷에서 객체를 유지하기에 충분한 참조 유형을 선택할 수 있습니다.
약하게 참조된 객체가 있는 경우, 힙 워커의 "Weak reference" 검사를 사용하여 현재 객체 집합에서 이를 선택하거나 제거할 수 있습니다.
힙 마킹
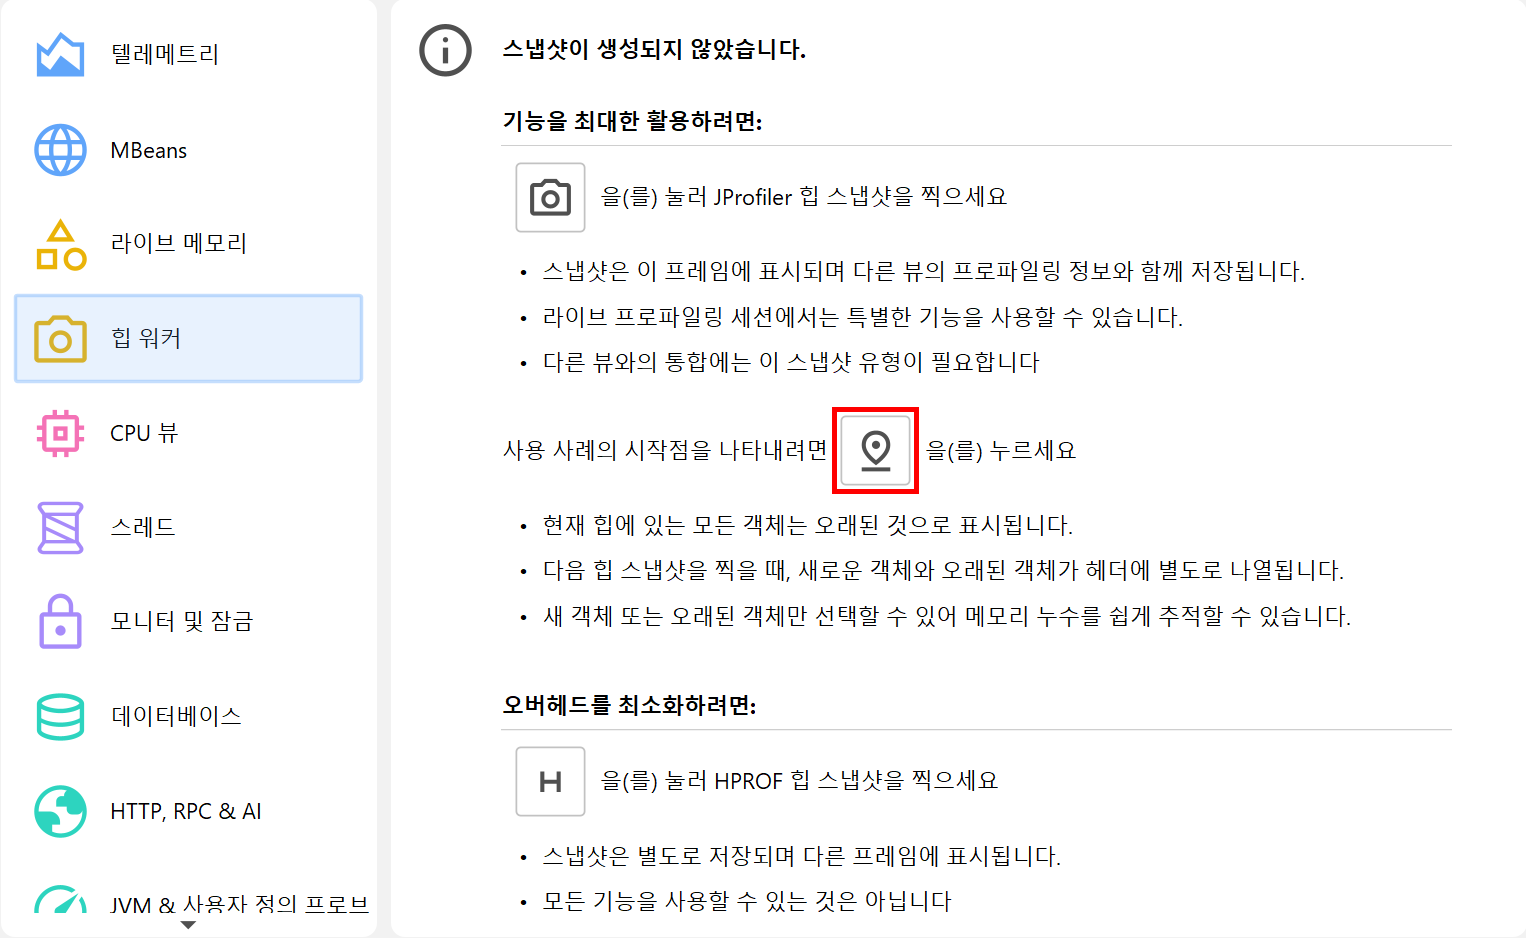
특정 유스케이스를 위해 할당된 객체를 확인하고 싶을 때가 많습니다. 해당 유스케이스 전후로 할당 기록을 시작하고 중지하여 이를 수행할 수도 있지만, 오버헤드가 훨씬 적고 다른 용도를 위해 할당 기록 기능을 보존할 수 있는 훨씬 더 나은 방법이 있습니다. 힙 워커 개요에서 안내되며 Profiling 메뉴나 트리거 액션으로도 사용할 수 있는 Mark Heap 액션은 힙의 모든 객체를 "오래된(old)" 객체로 표시합니다. 다음 힙 스냅샷을 찍을 때 어떤 객체가 "새로운(new)" 객체인지 명확해집니다.
이전 힙 스냅샷이 있거나 힙 마크가 호출된 적이 있는 경우, 힙 워커의 제목 영역에는 새로운 인스턴스 수와 해당 시점 이후에 할당된 인스턴스 또는 그 이전에 할당되어 살아남은 인스턴스를 선택할 수 있는 Use new 및 Use old라는 두 개의 링크가 표시됩니다. 이 정보는 각 객체 집합에 대해 제공되므로 먼저 드릴다운한 후 나중에 새 인스턴스 또는 오래된 인스턴스를 선택할 수 있습니다.